Skip to content

典型策略提升方法:TRPO+PPO+DPO+GRPO

📅 发表于 2025/09/01
🔄 更新于 2026/08/05
👁️ — 次访问
📝 13108 字
⏳ 40 分钟
rl-theory
#重要性采样
#重要性采样策略梯度
#KL约束
#信任区域
#GAE
#n步优势估计
#TRPO
#PPO
#优势策略梯度
#PPO-Clip
#PPO-Penalty
#Reward Model
#Pairwise loss
#KL负奖励
#Critic学习目标
#Critic Loss
#TD Error
#Critic Value Clip
#踩坑经验
#DPO
#标准RLHF目标
#DPO显示最优解
#DPO Loss
#DPO缺点
#GRPO
#相对组优势
必备知识 ​

重要性采样 ​

基本概念 ​

重要性采样

问题

  • 函数f(x),需从目标分布 p(x)中采样计算期望值,但从p(x)中采样很难

间接采样法

  • 从容易分布q(x)采样 (采样分布),间接达到从困难分布p(x)的采样效果。·
Ex∼p(x)[f(x)]=∫p(x)f(x) dx=∫q(x)⋅p(x)q(x)f(x) dx=Ex∼q(x)[p(x)q(x)f(x)]
  • 核心公式
Ex∼p[f(x)]=Ex∼q[p(x)q(x)f(x)]=1N∑ip(xi)q(xi)f(xi)
  • 重要性权重:用来修正采样的偏差,即两个分布之间的差异p(x)q(x)

IS是特殊MC采样

  • 重要性采样也是一种特殊MC采样
  • 允许从简单分布采样,避免直接从困难分布采样的问题。

重要性采样的缺点 ​

重要性采样缺点

差异大时方差大

  • 采样分布 q(x)和目标分布 p(x)差异大时,方差很大,尽管期望相同。

差异大时依赖足够多的采样

  • 当q和p差异大时,

    • 如果采样次数不够多,期望会有很大差异
    • 需通过大量采样,抵消差异对期望的影响
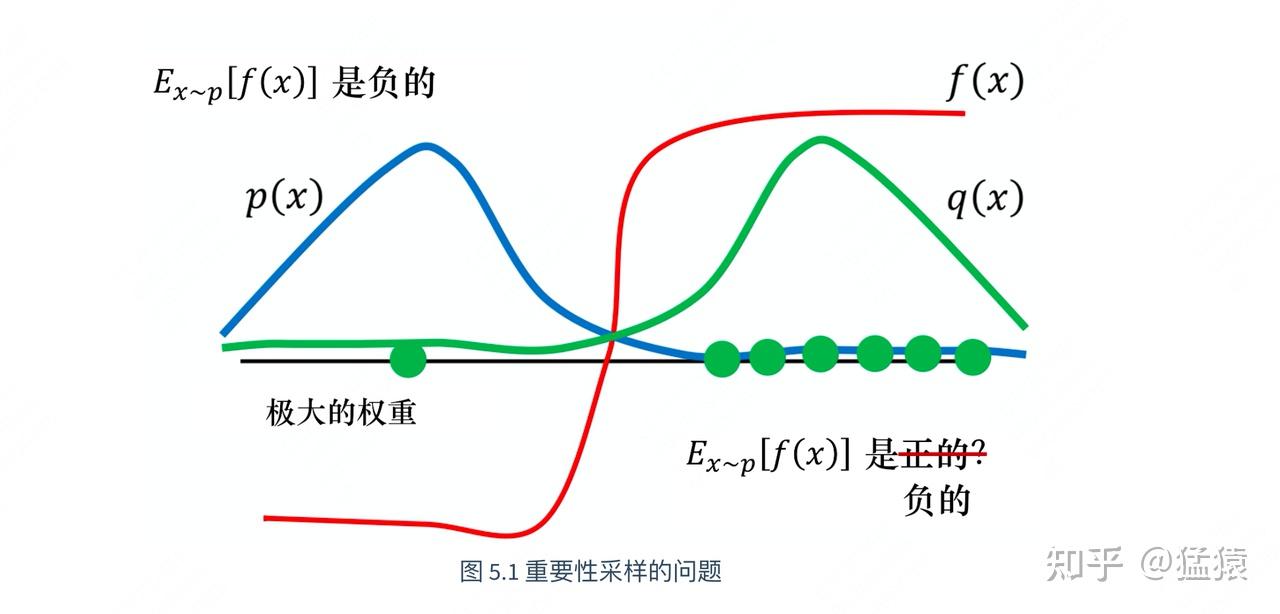
  • 如下图,Ex∼p[f(x)] 本身为负

    • 但由于q和p差异大,大部分q只能采样到正的,导致期望不对

      Ex∼p[f(x)]≠Ex∼q[p(x)q(x)f(x)]
    • 需足够多的采样,才能采到左边点,并给其大权重,才能保证期望一致。

采样具有随机性

  • 如果突然采到方差大的样本,可能朝着错误方向更新。
q和p分布差异大、采样数量不够多怎么办?

核心思想

  • 增加约束信任条件

TRPO KL约束

  • KL约束(TRPO):把πθ和πθold 的相似性 作为J(πθ)的约束条件,信任区域。

PPO CLIP

  • CLIP(PPO):把相似性约束条件,直接放回到目标函数J(πθ)中。

重要性采样在RL中的作用 ​

重要性采样在RL中的作用

核心作用

  • 可实现off-policy,从而降低RL采样成本,解决采样效率问题,提升训练效率。
    • on-policy:采样策略和学习策略相同
      • 即产出数据的策略和用这批数据做更新的策略是同1个。
  • 更加谨慎地更新模型。

使用方法

  • 从πold开始,用πold和环境交互,得到一批回合数据。
  • 把这批回合数据 重复使用k次去更新模型( off-policy过程)
    • 第1次,喂给:πold→πθ1
    • 第2次,喂给:πθ1→πθ2
    • ...
    • 第k次,喂给:πθk−1→πθk
    • k次更新后:πold=πθk

策略梯度发生变化

  • 原始策略梯度
∇J(θ)=E(st,at)∼πθ[Aπθ(st,at)⏟动作a的权重⋅∇log⁡pθ(at∣st)⏟动作a的梯度]
  • 引入重要性采样后的梯度:τ∼πθold,训练数据是从旧策略采样出来的。
∇J(θ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⏟重要性权重⋅Aπθold(st,at)⏟动作a的权重⋅∇log⁡pθ(at∣st)⏟动作a的梯度]
  • 重要性权重

    rt(θ)=πθ(at∣st)πθold(at∣st)=πθ(yt∣x,y<t)πθold(yt∣x,y<t)ri,t(θ)=πθ(yi,t∣x,yi,<t)πθold(yi,t∣x,yi,<t)
  • 目标函数

arg⁡maxπθJ(πθ)=Eτ∼πold[πθ(at∣st)πθold(at∣st)⋅AtGAE(γ,λ)(st,at)]

重要性采样策略梯度推导 ​

策略梯度推导过程

重要性采样策略梯度推导

从定义到期望形式

∇J(θ)=∑τR(τ)⋅∇pθ(τ)=∑τR(τ)⋅pθ(τ)⋅∇log⁡pθ(τ)=Eτ∼pθ(τ)[R(τ)⋅∇log⁡pθ(τ)]

转换成优势策略梯度

∇J(θ)=Eτ∼pθ(τ)[R(τ)⋅∇log⁡pθ(τ)]=E(st,at)∼πθ[A(st,at)⋅∇log⁡πθ(at∣st)]

代入重要性采样

  • 推导过程
∇J(θ)=E(st,at)∼πθold[pθ(at∣st)pθold(at∣st)⋅A(st,at)⋅∇log⁡pθ(at∣st)]=E(st,at)∼πθold[Aθold(st,at)⋅pθ(at∣st)pθold(at∣st)⋅1pθ(at∣st)⋅∇pθ(at∣st)]=E(st,at)∼pθold[Aθold(st,at)⋅1pθold(at∣st)⋅∇pθ(at∣st)]=E(st,at)∼pθold[Aθold(st,at)⋅∇pθ(at∣st)pθold(at∣st)]≈1N∑n=1N∑t=1TnAθold(st,at)⋅∇pθ(at∣st)pθold(at∣st)
  • 推导结果
∇J(θ)≈1N∑n=1N∑t=1TnAθold(st,at)⋅∇pθ(at∣st)pθold(at∣st)
重要性权重与逆采样概率修正

核心等式

  • 两个公式完全等价,只是观察视角不同
Atrt(θ)∇θlog⁡πθ(at∣st)=Atπθ(at∣st)πθold(at∣st)∇θlog⁡πθ(at∣st)=At∇θπθ(at∣st)πθold(at∣st)
  • 其中
rt(θ)=π(at∣st)πθold(at∣st),∇πθ=πθ∇θlog⁡πθ

重要性权重视角

Atπθ(at∣st)πθold(at∣st)⏟重要性权重rt(θ)∇log⁡πθ(at∣st)
  • 样本由旧策略 πθold 生成,但我们希望更新当前策略 πθ。
  • 使用重要性权重rt(θ) 修正新旧策略的动作分布差异:
    • rt>1:当前策略比旧策略 更偏好该动作;
    • rt<1:当前策略比旧策略 更不偏好该动作。

逆采样概率修正视角

At1πθold(at∣st)⏟逆采样概率修正因子∇πθ(at∣st)
  • 给定状态 st,动作在数据中出现频率 由旧策略决定:

    • 旧策略概率小:动作很少被采到,每次出现时修正因子较大;

    • 旧策略概率大:动作经常被采到,每次出现时修正因子较小。

  • 在期望上,采样频率与逆采样概率修正因子 相互抵消:

πθold(a∣s)⏟动作出现频率⋅1πθold(a∣s)⏟逆采样概率修正=1
  • 当前策略概率 πθ包含在概率梯度中:
∇θπθ(a∣s)=πθ(a∣s)∇θlog⁡πθ(a∣s)At∇πθπold=1πold⏟逆采样概率修正因子At∇πθ=πθπold⏟重要性权重rtAt∇log⁡πθ

重要性采样和KL散度的区别 ​

重要性权重 vs KL 散度

KL 散度

  • KL散度笔记

    • 第1个参数q:分子,真实分布,参考分布,旧策略,从分子采样
    • 第2个参数p:分母,近似分布,模型分布,新策略,
    DKL(q||p)=Ex∼q(x)[log⁡q(x)p(x)]=∑x∼q(x)q(x)log⁡q(x)p(x)=∑x∼q(x)log⁡πold(oi,t|q,oi,<t)πθ(oi,t|q,oi,<t)Eπold[log⁡πoldπθ]
  • 两种情况

    • 旧策略/当前策略,旧策略 看作真实分布
    • ref策略/当前策略, ref策略 看作真实分布
  • KL值变大的含义

    • πold 认为概率高,但πθ认为概率低,模型发生巨大变化,πθ看旧数据,令其惊讶。
    log⁡πoldπθ大→πold↑,πθ↓
  • KL 作用

    • 衡量2个分布之间的差异、衡量距离,判断off-policy 数据 是否已到 需丢弃的程度。

IS 权重

  • 衡量新旧策略的更新幅度,自然是用 当前策略/旧策略,用于修正梯度ri,t(θ)=πθ(oi,t|q,oi,<t)πold(oi,t|q,oi,<t)
重要性权重和KL散度对比示例

KL 散度示例

  • 学习策略和参考策略

    DKL(πθ||πref)=Ex∼πθ[logπθ(oi,t∣q,oi,<t)πref(oi,t∣q,oi,<t)]
  • 采样策略和学习策略

    DKL(πold||πθ)=Ex∼πold[logπold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)]
  • 真实和近似

    DKL(真实||近似)=∑x∼真实(x)真实(x)⋅log真实(x)近似(x)=Ex∼真实(x)[log真实(x)近似(x)]

重要性权重

  • 重要性权重

    rt(θ)=πθ(at∣st)πθold(at∣st)=πθ(yt∣x,y<t)πθold(yt∣x,y<t)ri,t(θ)=πθ(yi,t∣x,yi,<t)πθold(yi,t∣x,yi,<t)
  • 目标函数

arg⁡maxπθJ(πθ)=Eτ∼πold[πθ(at∣st)πθold(at∣st)⋅AtGAE(γ,λ)(st,at)]

广义优势估计 ​

TD(λ) 简介 ​

TD(λ)

背景

  • MC:无偏估计,低偏差、高方差。TD:有偏估计,高偏差、低方差。
  • A2C引入优势函数来缓解了方差,但TD存在高偏差。需要平衡方差和偏差。

TD(λ)

  • 一个n步回报 Gt:t+n:采样n步,再做自举估计。
Gt:t+n=rt+1+γrt+2+γ2rt+3+⋯+γn−1rt+n+γnV(st+n)
  • 对多个n步回报估计量进行加权平均,λ 平衡了TD偏差和MC方差。
    • λ接近1,接近MC估计,偏差小、方差大。
    • λ接近0,接近单步TD,偏差大、方差小。
  • Gtλ 定义
Gt:Tλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+λT−t−1⋅GtGtλ=(1−λ)∑n=1∞λn−1⋅Gt:t+nV(st)←V(st)+α⋅(Gt:t+n−V(st))V(st)←V(st)+α⋅((1−λ)∑n=1∞λn−1⋅Gt:t+n⏟λ回报,多个n步回报,做平均−V(st))

GAE n步优势估计 ​

GAE n步优势估计

1. 朴素 TD Error 定义

  • 时刻t,步长为1、步长为2 的 TD Error定义
    • 注意:t时刻的即时奖励下标为t,这里rt和 前面文章 rt+1其实一样的
δt=rt+γV(st+1)−V(st)δt+1=rt+1+γV(st+2)−V(st+1)
  • 时刻t、步长为l 的 TD Error 定义
δt+l=rt+l+γV(st+l+1)−V(st+l)

2. n步优势估计 定义

At(1)=Gt:t+1−V(st)=rt+γV(st+1)−V(st)At(2)=Gt:t+2−V(st)=rt+γrt+1+γ2V(st+2)−V(st)At(3)=Gt:t+3−V(st)=rt+γrt+1+γ2rt+2+γ3V(st+3)−V(st)⋮At(n)=Gt:t+n−V(st)=rt+γrt+1+γ2rt+2+⋯γnV(st+n)−V(st)⋮At(∞)=Gt:t+∞−V(st)=rt+γrt+1+γ2rt+2+⋯γTrT+0+0+⋯−V(st)
  • n步优势估计 定义公式
    • 步长 n=∞
At(∞)=Gt:t+∞−V(st)=∑l=0∞γl⋅rt+l−V(st)

3. n步优势估计 迭代计算公式

  • 推导 At(2)
At(2)=rt+γrt+1+γ2V(st+2)−V(st)=(rt+γV(st+1)−V(st))+(γrt+1+γ2V(st+2)−γV(st+1))=δt+γ⋅δt+1
  • n步优势估计 迭代计算公式

    • 步长2、3、4
    At(2)=δt+γ⋅δt+1At(3)=δt+γ⋅δt+1+γ2⋅δt+2At(4)=δt+γ⋅δt+1+γ2⋅δt+2+γ3⋅δt+3
    • 步长为n、∞
At(n)=∑l=0n−1γl⋅δt+lAt(∞)=∑l=0∞γl⋅δt+l

4. 总结 n步优势 定义及计算公式

At(∞)=Gt:t+∞−V(st)=∑l=0∞γl⋅rt+l−V(st)=∑l=0∞γl⋅δt+lAt(n)=Gt:t+n−V(st)=∑l=0n−1γl⋅rt+l−V(st)=∑l=0n−1γl⋅δt+l

GAE 多个n步优势估计做加权平均 ​

GAE 多个n步估计做加权

0. 背景

1. GAE 定义公式

  • 对多个n步优势估计量,进行加权平均(步数从1到n到无穷),引入λ做方差、偏差平衡
AtGAE(γ,λ)(st,at)=(1−λ)(λ0⋅At(1)+λ⋅At(2)+λ2⋅At(3)+⋯)AtGAE(γ,λ)(st,at)=(1−λ)(λ0⋅δt+λ⋅(δt+γδt+1)+λ2⋅(δt+γδt+1+γ2δt+2)+⋯)

2. GAE 推导过程

AtGAE(γ,λ)(st,at)=(1−λ)(λ0⋅At(1)+λ⋅At(2)+λ2⋅At(3)+⋯)=(1−λ)(δt+λ⋅(δt+γδt+1)+λ2⋅(δt+γδt+1+γ2δt+2)+⋯)=(1−λ)(δt⋅(1+λ+λ2+⋯)+γδt+1(λ+λ2+⋯)+γ2δt+2(λ2+λ3+⋯)+⋯)=(1−λ)(δt⋅11−λ+γδt+1λ1−λ+γ2δt+2λ21−λ+⋯)=δt+γλ⋅δt+1+γ2λ2⋅δt+2+γ3λ3⋅δt+3+⋯=∑l=0∞(γλ)l⋅δt+l=∑l=0∞(γλ)l⋅(rt+l+γV(st+l+1)−V(st+l))

3. GAE 推导结果

AtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅δt+lAtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅(rt+l+γV(st+l+1)−V(st+l))AtGAE(γ,λ)(st,at)=∑l=0T−t−1(γλ)l⋅(rt+l+γV(st+l+1)−V(st+l))

4. GAE估计 vs 单个n步估计

  • n步优势估计:1次采样n步``估计优势
At(n)=∑l=0n−1(γ)l⋅δt+l
  • GAE 优势估计:多个n步优势估计 加权求平均A^tGAE=∑l=0T−t−1(λγ)l⋅δt+l

4. GAE 反向递推公式

  • 从最后一个时间步开始,反向遍历,提高GAE计算效率
AtGAE(st,at)=δt+γλAt+1GAE(st+1,at+1)

5. λ=0时,退化单步TD估计

  • 高偏差、低方差
AtGAE(γ,0)(st,at)=(1−0)(λ0⋅At(1)+0⋅At(2)+02⋅At(3)+⋯)AtGAE(γ,0)(st,at)=At(1)=Gt:t+1−V(st)=rt+γV(st+1)−V(st)AtGAE(γ,0)(st,at)=rt+γV(st+1)−V(st)

6. λ=1时,退化完全MC采样估计

  • 低偏差、高方差
AtGAE(γ,1)(st,at)=∑l=0∞γl⋅(rt+l+γV(st+l+1)−V(st+l))=(rt+γV(st+1)−V(st))+γ⋅(rt+1+γV(st+2)−V(st+1))+γ2⋅(rt+2+γV(st+3)−V(st+2))+⋯=rt+γrt+1+γ2rt+2+⋯+γnrt+n+⋯−V(st)=∑l=0∞γl⋅rt+l−V(st)=Gt:t+∞−V(st)=At(∞)(st,at)AtGAE(γ,1)(st,at)=rt+γrt+1+γ2rt+2+⋯+γnrt+n+⋯−V(st)

GAE中的奖励衰减(LLM) ​

奖励衰减

在LLM任务中

  • 对最后token,仅rT=rEOS≠0
  • 对前面的token,环境奖励rt=0,均为0。RM即时奖励

TD Error

  • 对中间步t<T

    δt=0+V(st+1)−V(st)=V(st+1)−V(st)
  • 对于最后一步t=T

δT=rT+V(sT+1)−V(sT)=rT−V(sT)

GAE 优势估计

  • 推导过程
A^t=∑l=0T−t(λγ)l⋅δt+l=δt+(λγ)1δt+1+(λγ)2δt+2+⋯+(λγ)T−t−1δT−1+(λγ)T−tδT=(λγ)T−t(rT−V(sT))+(V(st+1)−V(st))+(λγ)1(V(st+2)−V(st+1))+(λγ)2(V(st+3)−V(st+2))+⋯+(λγ)T−t−1(V(sT)−V(sT−1))=(λγ)T−trT⏟真实奖励信号+(一堆只包含V(s)的项)⏟来自价值函数估计的信号
  • 推导结果
A^t=(λγ)T−trT⏟真实奖励信号+(一堆只包含V(s)的项)⏟来自价值函数估计的信号
  • 当λ=1,γ=1时,退回MC估计
A^t=rT−V(st)

奖励衰减

  • 从公式可看出,真实外部奖励信号 rT 传播回第t个token时,会乘以权重 (λγ)T−t、(λ)T−t
  • 当λ<1 且 T-t 很大时
    • 前面token 收不到任何有效奖励信号。
    • 价值模型 就无法学习到它们真正的贡献。

λ=1 vs λ<1

  • λ<1
    • 在传统RL任务,每一步都有奖励,方差很大, 使用λ<1来降低方差,很有效
    • 在LLM任务,奖励稀疏,Vtarget 依赖自己自举
      • 如果一开始估计不准,就会导致错上加错,训练不稳定。
      • 带来的偏差危害(奖励信号衰减) 远远大于在降方差方面的好处。
  • λ=1:
    • MC无偏估计,Vtarget 只依赖环境奖励
    • 价值模型学习变成简单的监督学习,非常稳定的梯度下降过程。

GAE 方差公式 ​

GAE 方差公式

基础方差公式

Var[aX]=a2Var(X)Var[X+Y]=Var[X]+Var[Y]+2Cov(X,Y)

GAE 方差推导

A^tλ=λ0δt+λ1δt+1+λ2δt+2+⋯+λT−t−1δT−1Var(A^tλ)=Var[∑l=0T−t−1λl⋅δt+l]=∑l=0T−t−1λ2l⋅Var[δt+l]+2∑i=0T−t−1∑j=i+1T−t−1λi+j⋅Cov(δt+i,δt+j)
  • 方差:由每一项自身方差和项与项之间的协方差共同决定。
  • 减小λ会给这些项,更小的权重(尤其是后面的项),从而降低总方差。

GAE 总结 ​

GAE 总结

1. 时刻t、步长为l 的 TD Error 定义

δt+l=rt+l+γV(st+l+1)−V(st+l)

2. n步优势估计定义

At(n)=Gt:t+n−V(st)=∑l=0n−1γl⋅rt+l−V(st)=∑l=0n−1γl⋅δt+l

3. GAE定义

  • 对多个n步优势加权平均
AtGAE(γ,λ)(st,at)=(1−λ)(λ0⋅At(1)+λ⋅At(2)+λ2⋅At(3)+⋯)AtGAE(γ,λ)(st,at)=(1−λ)(λ0⋅δt+λ⋅(δt+γδt+1)+λ2⋅(δt+γδt+1+γ2δt+2)+⋯)

4. GAE 计算推导结果

AtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅δt+lAtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅(rt+l+γV(st+l+1)−V(st+l))

5. GAE 反向递推公式 (实际代码计算用此公式)

AtGAE(st,at)=δt+γλAt+1GAE(st+1,at+1)

6. λ=0/1

  • λ=0时,GAE退化为单步TD估计
AtGAE(γ,0)(st,at)=rt+γV(st+1)−V(st)
  • λ=1时,GAE退化完全MC采样
AtGAE(γ,1)(st,at)=rt+γrt+1+γ2rt+2+⋯+γnrt+n+⋯−V(st)
  • TD(λ)/TD(0)/TD(1)
    • λ越小,偏差越大、方差越小 (TD)
    • λ越大,偏差越小、方差越大 (MC)

GAE 作用 ​

GAE 作用

优点/作用

  • 平衡了单步优势估计中的MC-高方差和 TD-高偏差。

RL 优化目标

∇J(θ)=1N∑n=1N∑t=0TnΨt⏟权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度
  • 引入GAE后的策略梯度
∇J(θ)=1N∑n=1N∑t=0TnAtGAE(γ,λ)(st,at)⏟GAE作权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度
  • 引入GAE + 重要性采样后的策略梯度
∇J(θ)=1N∑n=1N∑t=0Tnπθ(at∣st)πθold(at∣st)⏟重要性采样AtGAE(γ,λ)(st,at)⏟GAE作权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度
  • 优化目标
arg⁡maxπθJ(πθ)=Eτ∼πold[πθ(at∣st)πθold(at∣st)⋅AtGAE(γ,λ)(st,at)]

GAE 实现代码 ​

python
@register_adv_est(AdvantageEstimator.GAE) 
def compute_gae_advantage_return(
    token_level_rewards: torch.Tensor,
    values: torch.Tensor,
    response_mask: torch.Tensor,
    gamma: torch.Tensor,
    lam: torch.Tensor,
):
    """Adapted from https://github.com/huggingface/trl/blob/main/trl/trainer/ppo_trainer.py

    Args:
        token_level_rewards: `(torch.Tensor)`
            shape is (bs, response_length)
        values: `(torch.Tensor)`
            shape is (bs, response_length)
        response_mask: `(torch.Tensor)`
            shape is (bs, response_length). [EOS] mask. The token after [EOS] have mask zero.
        gamma is `(float)`
            discounted factor used in RL
        lam: `(float)`
            lambda value when computing Generalized Advantage Estimation (https://arxiv.org/abs/1506.02438)

    Returns:
        advantages: `(torch.Tensor)`
            shape: (bs, response_length)
        Returns: `(torch.Tensor)`
            shape: (bs, response_length)

    """
    with torch.no_grad():
        nextvalues = 0
        lastgaelam = 0
        advantages_reversed = []
        gen_len = token_level_rewards.shape[-1]

        for t in reversed(range(gen_len)):
            delta = token_level_rewards[:, t] + gamma * nextvalues - values[:, t]
            lastgaelam_ = delta + gamma * lam * lastgaelam

            # skip values and TD-error on observation tokens
            nextvalues = values[:, t] * response_mask[:, t] + (1 - response_mask[:, t]) * nextvalues
            lastgaelam = lastgaelam_ * response_mask[:, t] + (1 - response_mask[:, t]) * lastgaelam

            advantages_reversed.append(lastgaelam)
        advantages = torch.stack(advantages_reversed[::-1], dim=1)

        returns = advantages + values
        advantages = verl_F.masked_whiten(advantages, response_mask)
    return advantages, returns

TRPO ​

Trust region policy optimization

ActorCritic 缺点 ​

ActorCritic思想

Actor-Critic 核心思想

  • 目标:找到θ∗=arg⁡maxθJ(θ),沿∇θJ(θ)方向迭代更新策略参数
J(θ)=Es0[Vπθ(s0)]=Eπθ[∑t=0∞γt⋅r(st,at)]∇J(θ)=1N∑n=1N∑t=0Tn(rtn+γVπ(st+1n)−Vπ(stn))⏟权重,优势值⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度
  • 参数更新
θ←θ+α⋅∇J(θ)

Actor-Critic缺点

Actor-Critic 缺点

存在步长选择困难症

  • 学习率太大:导致策略更新幅度太大,可能使策略性能下降,甚至崩溃。
  • 学习率太小:导致策略更新速度太慢,训练效率低下。
  • 虽然简单直观,但训练不稳定
  • 解法:KL 约束

每次梯度更新都需对πθ做若干回合采样

  • 采样效率低,训练过程比较慢
  • 采样具有随机性,可能偶然采样到方差大的样本;如果直接信任,可能朝着错误方向更新
  • 解法:重要性采样
    • 降低采样成本,提升训练效率
    • 同时更加谨慎的更新模型
  • 重要性采样也需要两个分布差异不能太大
    • πθ和πold分布差异较大 且 采样轨迹数量不够大时,对J(θ)的估计不准
    • 解法:KL约束

TD Error 估计优势函数是有偏的

TRPO 提出背景
  • 解决步长选择困难症
    • 通过引入约束或限制,确保每次策略更新不会太大。
    • 避免策略崩溃,且保证策略能持续提升。
  • 引入GAE 平衡偏差和方差
  • 使用重要性采样 解决错误方向问题

信任区域 ​

信任区域

信任区域作用理解

  • 在策略空间中,策略的近似线性模型能够比较准确预测策略性能。

    • 在信任区域,可信任策略梯度,进行策略更新。
    • 离开信任区域,需重新评估策略性能,并调整更新方向。
  • 解决重要性采样需要两个分布接近的缺点

    • πθ和πold 分布差异较大 且 采样轨迹数量不够大时,对J(θ)的估计不准。
    • 使用信任区域做限制。
  • 信任区域是悟空给唐僧画的安全区

    • 在圈内,活动是绝对安全的。
    • 若要移动,需重新画圈圈,确保每一步走的安全、稳健。

信任区域定义 (KL约束条件)

  • 其实是定义了一个KL约束,策略空间中的一个KL球,

  • 保证新策略不会偏离旧策略太远,从而保证策略的单调提升

    maxθ Lθk(θ),s.t.  Est∼ρπθk[DKL(πθk(⋅∣s)⏟旧策略,  πθ(⋅∣s)⏟新策略)]≤δ

目标函数理解 maxθ Lθk(θ)

  • 通过调整策略参数θ使目标最大化
    • θ:正在优化的新策略,是需要寻找的参数
    • θk:旧策略、已知的策略参数,第k次迭代
  • L 目标函数,代理优势函数,衡量了新策略πθ比旧策略πθk有多好
    • L 通过重要性采样计算,利用旧策略 πθk采样的数据,来评估新策略 πθ的表现。
    • L > 0:说明新策略比旧策略好

约束条件理解

Est∼ρπθk[DKL(πθk(⋅∣s)⏟旧策略,  πθ(⋅∣s)⏟新策略)]≤δ
  • KL 散度 :衡量两个概率分布的差异
    • DKL(πθk,πθ)=0:两个策略在状态s下完全一样
    • DKL(πθk,πθ) 越大,说明新策略比旧策略变化越大。
  • 所有状态st上的平均KL散度 需 Est∼ρπθk≤δ,
    • 平均差异不能太大,限制在半径为δ的小范围/信任区域内,如0.01,信赖域大小
    • st∼ρπθk:状态访问分布,访问各状态的概率是多少。
      • 根据旧策略访问这些状态的频率分布ρπθk来加权,关注重要状态的策略变化

策略目标 ​

TRPO 策略目标
JTRPO(πθ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⋅Aπθold(st,at)],  KL(πold,πθ)≤δ
TRPO 策略目标推导过程

核心目标

  • 期望借助当前θ找到一个更优θ′,使得J(θ′)≥J(θ)

    • θ、θ′:旧策略、新策略。
    • θk、θ:旧策略、新策略。两种符号表示。
  • 只要找到一个新策略,使Est∼vπθ′Ea∼πθ′(⋅∣st)[Aπθ(st,at)]≥0,就能保证策略性能单调递增,推导过程见下文

J(θ′)−J(θ)=11−λEst∼ρπθ′Ea∼πθ′(⋅∣st)[Aπθ(st,at)]Aπθ(st,at)=r(st,at)+γVπθ(st+1)−Vπθ(st)

难点

  • 直接求解该式非常困难 Est∼ρπθ′,πθ′ 是需要求解的新策略
    • 既用新策略收集样本数据,把所有可能的新策略都拿来收集数据
    • 然后判断哪个新策略符合上述条件,显然是不现实的。
  • 解法:直接使用旧策略πθ 的状态分布
    • 新旧策略接近时,状态访问分布变化小,近似是合理的
Est∼ρπθ′→Est∼ρπθ

目标优化

  • 直接采用旧策略πθ的状态分布,忽略两个策略的状态访问分布
Lθ(θ′)=J(θ)+11−λEst∼ρπθEa∼πθ′(⋅∣st)[Aπθ(st,at)]
  • 动作仍用新策略采样得到,用重要性采样做处理。
    • 这样就能基于旧策略πθ 采样出的数据,来估计并优化 新策略πθ′
Lθ(θ′)=J(θ)+Est∼ρπθEa∼πθ′(⋅∣st)[πθ′(a∣s)πθ(a∣s)⋅Aπθ(st,at)]

KL 约束 (上文信任域空间)

  • 增加KL约束,保证新旧策略足够近
maxθ′ Lθ(θ′),s.t.  Est∼vπθk[DKL(πθk(⋅∣s),  πθ(⋅∣s))]≤δ
  • 信任区域:不等式约束定义了策略空间中的一个KL球。
  • 在信任区域中
    • 学习策略和环境交互的状态分布,与上一轮策略最后采样的状态分布一致
    • 可以基于一步行动的重要性采样使当前学习策略稳定提升

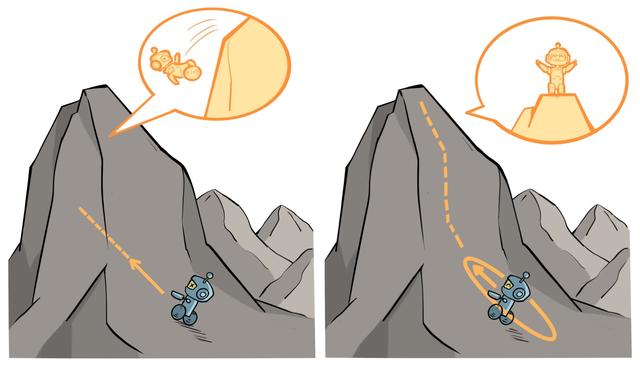
信任区域示意图:左侧无信任区域,梯度更新可能导致性能骤降;右侧有信任区域,每次梯度更新都能带来稳定提升。

目标推导过程

J(θ) 另一种形式

J(θ)=Es0[Vπθ(s0)]=Eπθ′[∑t=0∞γt⋅Vπθ(st)−∑t=1∞γt⋅Vπθ(st)]=−Eπθ′[∑t=0∞γt⋅(γVπθ(st+1)−Vπθ(st))]

J(θ′)−J(θ)推导过程

J(θ′)−J(θ)=Es0[Vπθ′(s0)]−Es0[Vπθ(s0)]=Eπθ′[∑t=0∞γt⋅r(st,at)]+Eπθ′[∑t=0∞γt⋅(γVπθ(st+1)−Vπθ(st))]=Eπθ′[∑t=0∞γt⋅(r(st,at)+γVπθ(st+1)−Vπθ(st))]=Eπθ′[∑t=0∞γt⋅Aπθ(st,at)]=∑t=0∞γt⋅Est∼vπθ′Ea∼πθ′(⋅∣st)[Aπθ(st,at)]=11−λEst∼vπθ′Ea∼πθ′(⋅∣st)[Aπθ(st,at)]

广义优势估计 ​

GAE 笔记

GAE
  • 对不同TD步数的优势估计进行指数加权平均,平衡方差和偏差
δt+l=rt+l+γV(st+l+1)−V(st+l)AtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅δt+lAtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅(rt+l+γV(st+l+1)−V(st+l))
python
def compute_advantage(gamma, lmbda, td_delta):
    td_delta = td_delta.detach().numpy()
    advantage_list = []
    advantage = 0.0
    for delta in td_delta[::-1]:
        advantage = gamma * lmbda * advantage + delta
        advantage_list.append(advantage)
    advantage_list.reverse()
    return torch.tensor(advantage_list, dtype=torch.float)

PPO ​

核心思想 ​

PPO 背景

背景

  • TRPO计算复杂, 每步更新运算量非常大。
  • PPO基于TRPO思想,但实现更简单。能学的一样好、甚至更快。
PPO核心思想

1.引入GAE

  • 解决单步优势的方差-偏差平衡问题。

2.引入重要性采样

  • 使用重要性权重 修正分布差异
  • 达成可使用off-Policy,提高采样效率,解决效率问题。

3.引入Clip或Penalty

  • 解决采样方差大& 重要性采样分布差异大+采样数量不足面临的问题
  • 使用Clip或Penalty 增强训练稳定性
  • 把πθ和πθold的相似性 作为J(πθ)的约束条件。
    • TRPO:用KL约束做一个信任区域
    • PPO:把约束条件放到J(πθ)中做优化,CLIP 或 Penalty。

PPO-Clip ​

Clip 核心思想 ​

PPO-Clip 背景

引入IS和GAE后的优化目标

arg⁡maxπθJ(πθ)=Eτ∼πold[πθ(at∣st)πθold(at∣st)⋅AϕGAE(γ,λ)(st,at)]

为什么需要CLIP

  • 考虑采样不足的情况下,πθ和πθold 分布差异不能太大

  • 因此πθ(at∣st)πθold(at∣st)是有上限和下限的,需保证πθ(at∣st)πθold(at∣st) 在信任域内。

  • 不能一味轻信 AϕGAE(γ,λ)(st,at), 来提升或降低 πθ(at∣st)。

PPO Clip

CLIP 核心思想

  • 通过CLIP裁剪+MIN函数,限制策略更新幅度,来保证训练稳定性。
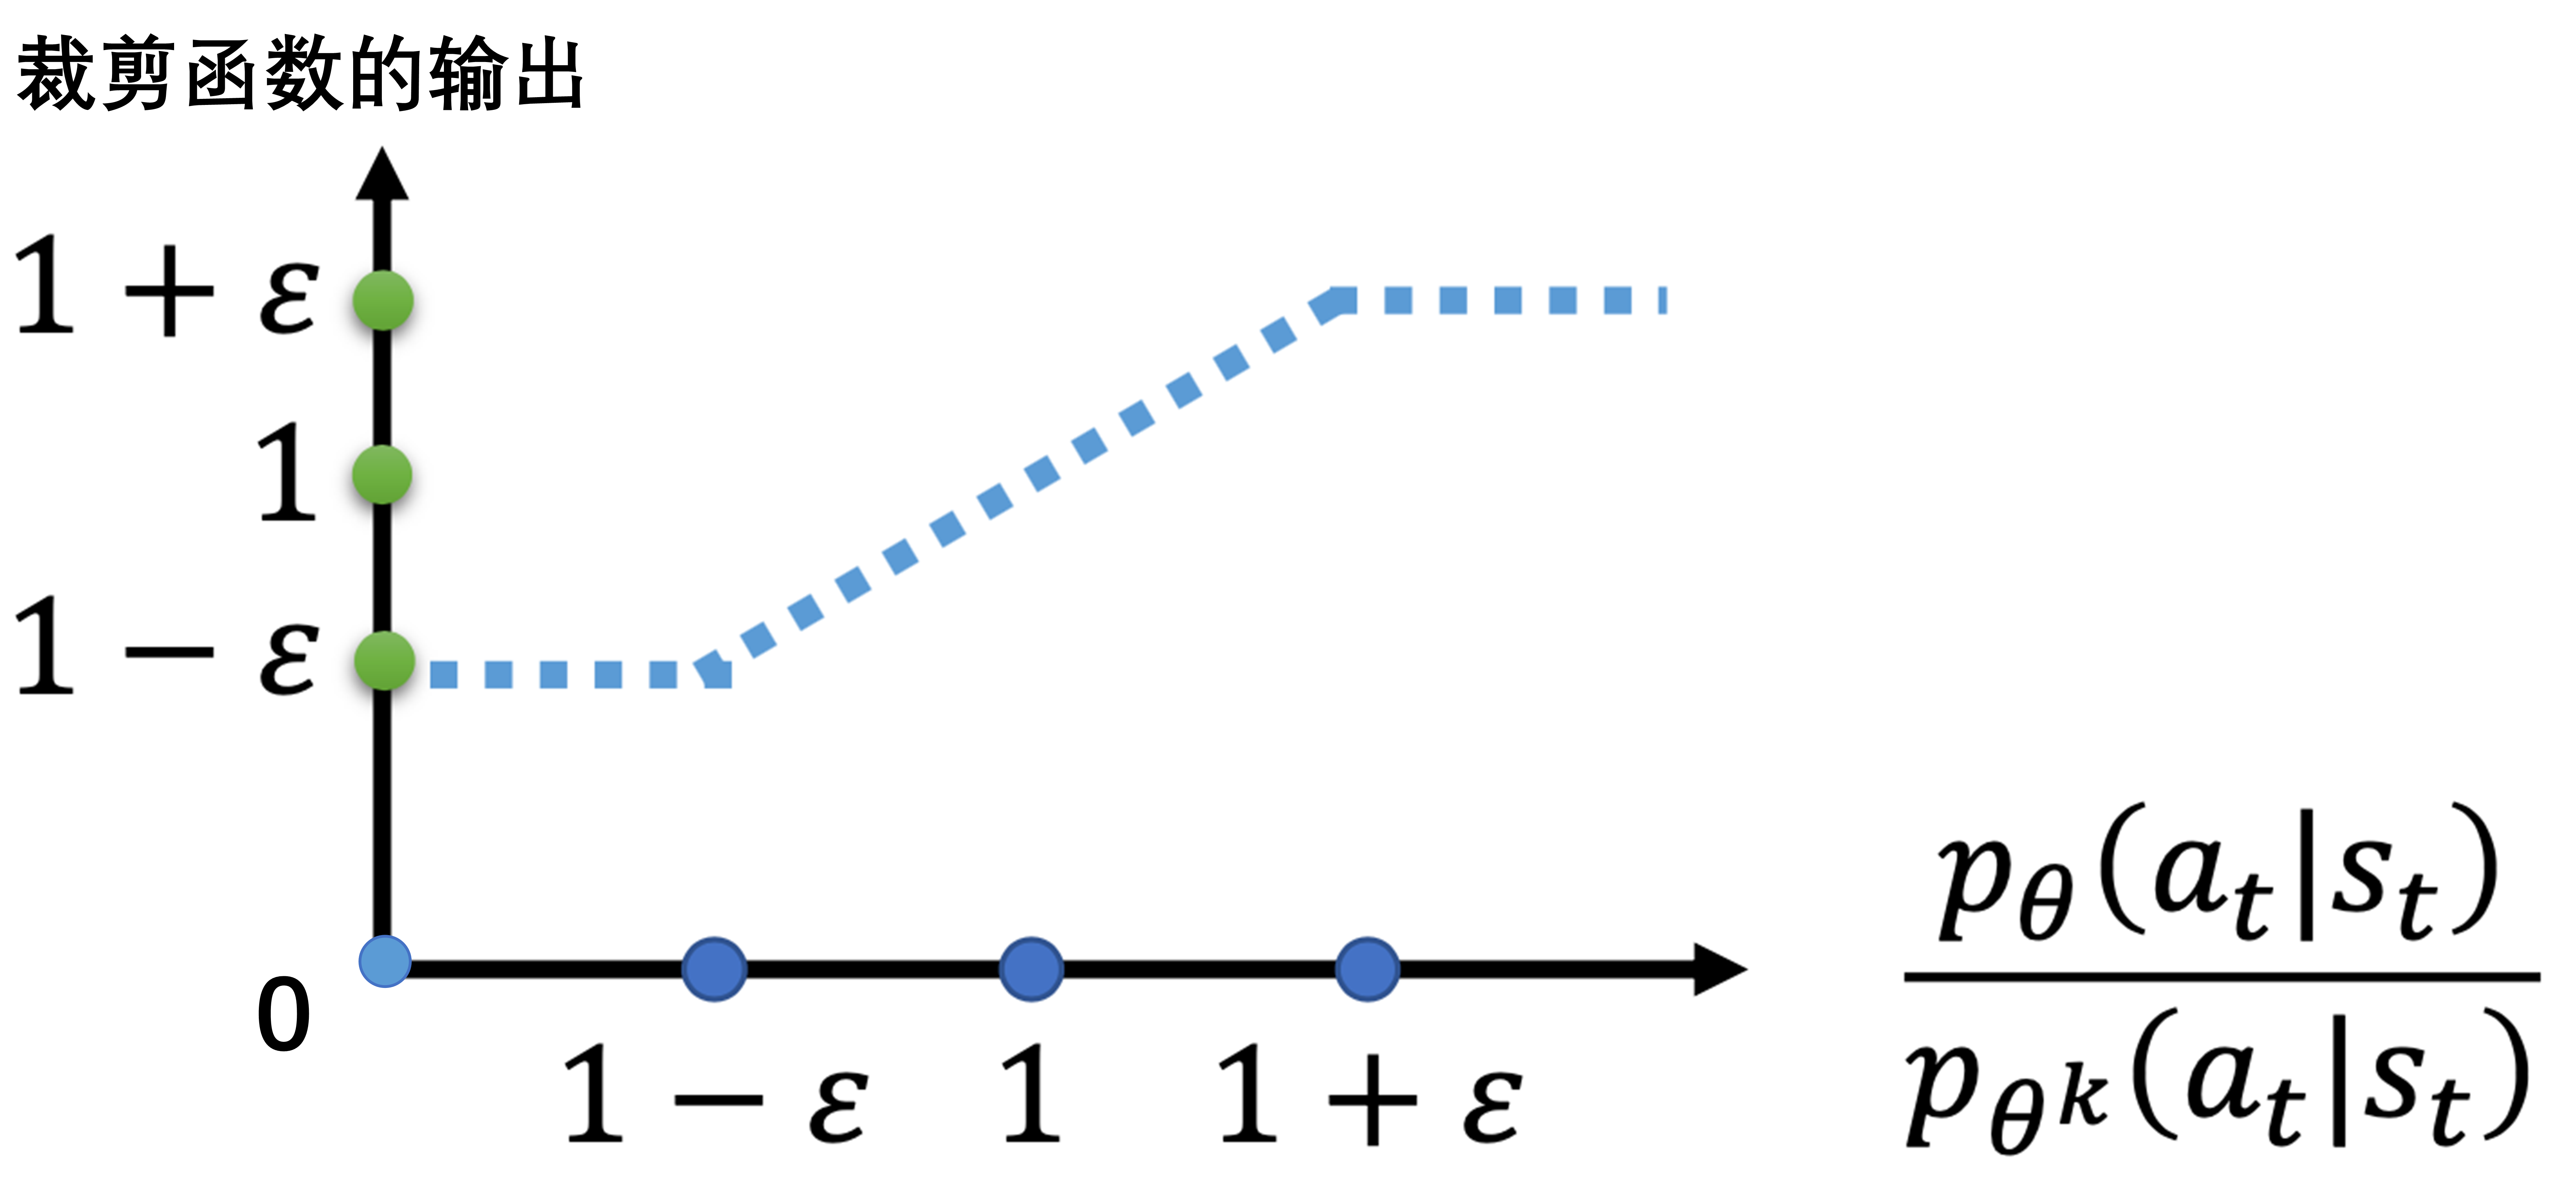
  • 限制重要性权重在一个信任域内,超出信任域就裁切。
    • 约束新旧策略πθ和πθold尽可能接近相似,限制更新幅度不要太大,保证训练稳定性
    • 希望采样策略和学习策略的差距不要太大。

CLIP 信任域

  • [1−ϵ,1+ϵ]
1−ϵ≤rt(θ)=πθ(at∣st)πθold(at∣st)≤1+ϵ

优化目标

  • 不做KL散度约束,直接把CLIP 信任域放到目标函数中
JPPOCLIP(πθ)=Eτ∼πθold[min(rt(θ)⋅Aϕπθold(st,at),clip(rt(θ),1−ϵ,1+ϵ)⋅Aϕπθold(st,at))]JPPOCLIP(πθ)=∑st,atmin(πθ(at∣st)πθold(at∣st)⋅Aϕπθold(st,at),clip(πθ(at∣st)πθold(at∣st),1−ϵ,1+ϵ)⋅Aϕπθold(st,at))

Clip 到底做了什么 ​

CLIP 到底做了什么

有无CLIP公式对比

  • 无限制的策略梯度目标:rt(θ)⋅A^t
  • 有限制的策略梯度目标:clip(rt(θ),1−ϵ,1+ϵ)⋅A^t,IS权重裁剪到[1−ϵ,1+ϵ]
Jclip(θ)=Et[min(rt(θ)⋅A^t,clip(rt(θ),1−ϵ,1+ϵ)⋅A^t)]
  • 比例rt(θ)一旦超出范围,变量就变为一个常数,对常数求导为0,导致梯度为0。

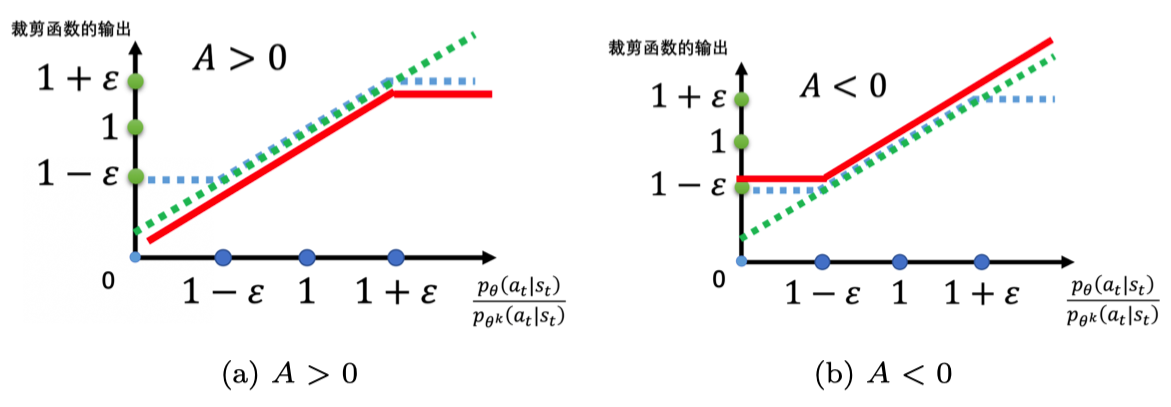
对于好动作 A^t>0

  • 目标:提高概率,即增大rt(θ)

  • 当rt(θ)≤1+ϵ时:一切正常

  • 当rt(θ)>1+ϵ时:变成(1+ϵ)⋅A^t

    min(rt(θ)⋅A^t,(1+ϵ)⋅A^t)=(1+ϵ)⋅A^t
  • (1+ϵ)⋅A^t,没有梯度

    • 旧策略计算出的常数,和当前优化参数θ 无关
    • 意味着IS差距大的token 梯度为0,无法进行梯度更新,该token被硬丢弃。

对于差动作 A^t<0

  • 目标:降低概率,即减小rt(θ)

  • 当rt(θ)<1−ϵ时:变成(1−ϵ)⋅A^t

    min(rt(θ)⋅A^t,(1−ϵ)⋅A^t)=(1−ϵ)⋅A^t
  • 同理,(1−ϵ)⋅A^t 没有梯度

    • IS差异大的token,无法进行梯度更新,该token被硬丢弃。
从梯度公式来理解

默认无clip

  • 策略梯度
∇θLppo=Et[rt(θ)⋅A^t(st,at)⋅∇log⁡π(at∣st)]=Et[rt(θ)⋅A^t⋅ϕ(st,at)]
  • 推导梯度项
∇log⁡π(at∣st)=∇log⁡(efθ(st,at)∑befθ(st,b))=∇log⁡efθ(st,at)−∇log⁡(∑b∈Aefθ(st,b))=∇fθ(st,at)−1∑b∈Aefθ(st,b)⋅∑b∈Aefθ(st,b)⋅∂fθ(st,b)∂θ=∂fθ(st,at)∂θ−1∑b∈Aefθ(st,b)⋅∑b∈Aefθ(st,b)⋅∂fθ(st,b)∂θ=∂fθ(st,at)∂θ−∑b∈Aefθ(st,b)∑b∈Aefθ(st,b)⋅∂fθ(st,b)∂θ=∂fθ(st,at)∂θ−∑b∈Aπθ(b|st)⋅∂fθ(st,b)∂θ
  • 项1:正向推力,提高at的logit分数
  • 项2:反向抑制,按概率加权 降低其他动作的logit分数

带clip的策略梯度

  • 比例rt(θ)一旦超出范围,变量就变为一个常数,对常数求导为0,导致梯度为0。

  • 在clip区域之外的 所有梯度均为0

    • At>0,在clip区域范围外,不会做提升
    • At<0,在clip区域范围外,不会做抑制

PPO-CLIP 梯度简洁写法

∇θLPPO−clip=Et[It⋅rt(θ)⋅A^t⋅ϕ(st,at)]It={1,rt(θ)⋅A^t≤clip(rt(θ),1−ϵ,1+ϵ)⋅A^t0,其他

Clip 和 Min ​

为什么需要min

1. 优势为正,r超出上界

  • clipped,梯度为0。好动作,概率已上升更多,停止过度梯度更新,不要过度乐观。
A>0,r>1+ϵ→rA>(1+ϵ)A→C=(1+ϵ)A

2. 优势为正,r低于下界

  • unclipped,梯度保留。好动作,概率被过度压低了,保留梯度回拉。
A>0,r<1−ϵ→rA<(1−ϵ)A→U=rA

3. 优势为负,r超出上界

  • unclipped,梯度保留。差动作,概率被错误增大,保留梯度纠错。
A<0,r>1+ϵ→rA<(1+ϵ)A→U=rA

4. 优势为负,r低于下界

  • clipped,梯度为0。差动作,概率已下降过多,停止过度梯度更新,不要过度乐观。
A<0,r<1−ϵ→rA>(1+ϵ)A→C=(1+ϵ)A

思想

  • clip:把重要性比率的定义数值限定在信任域,本身不区分更新方向的对错(优势正负)
  • min:引入非对称性,信任域变成单向门控,根据当前动作优势正负 决定是否启动信任域。
  • 如果只有clip 没有 min:策略走错方向时,梯度会被置为0,导致错误无法被纠正。
  • 1和4 朝有利方向过度更新,min选clipped,梯度归零,避免乐观更新,悲观。
  • 2和3 朝错误方向更新,min选unclipped,梯度保留,保持行为纠错的更新。

Clip 改进工作 ​

PPO-Penalty ​

PPO-Penalty 背景

背景

  • 直接把限制条件加入优化目标中,解决TRPO优化复杂的问题。
  • 限制条件被称为KL penalty

相关笔记

KL惩罚、自适应参数、优化目标

KL 惩罚约束行为距离

  • 使用KL散度 约束行为上的距离,而非参数上的距离,因此无法用L12范数等距离法。
JPPOπθold(θ)=Jπθold(πθ)−β⋅DKL(πθ,πθold)
  • 对KL散度设置阈值 [KLmin,KLmax]

自适应KL惩罚beta参数

  • 超参β的调整策略:自动调节自适应KL散度
  • KL(πθ,πθold)≥KLmax
    • πθ 新策略偏离旧策略太远 ,应该增大β,把分布拉回来
  • KL(πθ,πθold)≤KLmin
    • 新旧策略相近,可能只优化KL散度,不去优化优势相关的项。
    • 应该减小β,降低KL散度对目标的影响。

优化目标

  • 原始优化目标
arg⁡maxπθJ(πθ)=Eτ∼πold[πθ(at∣st)πθold(at∣st)⋅AϕGAE(γ,λ)(st,at)]
  • 引入KL 惩罚后的优化目标
arg⁡maxπθJPPOKL(πθ)=Eτ∼πold[πθ(at∣st)πθold(at∣st)⋅Aϕπold(st,at)−β⋅KL(πθold(⋅∣st),πθ(⋅∣st))]JPPOKL(θ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⋅Aϕπθold(st,at)]−β⋅KL(πold,πθ)

Actor ​

策略目标 ​

普通优势策略目标和TRPO策略目标

普通优势策略目标

J优势(πθ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⋅Aπθold(st,at)]

TRPO策略目标

JTRPO(πθ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⋅Aπθold(st,at)],  KL(πold,πθ)≤δ
PPO-CLIP Seq-Level

PPO-Clip Seq-Level 策略目标

JPPOCLIP(πθ)=Eτ∼πθold[min(rt(θ)⋅Aϕπθold(st,at),clip(rt(θ),1−ϵ,1+ϵ)⋅Aϕπθold(st,at))]JPPOCLIP(πθ)=∑st,atmin(πθ(at∣st)πθold(at∣st)⋅Aϕπθold(st,at),clip(πθ(at∣st)πθold(at∣st),1−ϵ,1+ϵ)⋅Aϕπθold(st,at))JPPOCLIP(πθ)=Eq,o∼πθold1|o|∑t=1|o|min(πθ(ot∣q,o<t)πθold(ot∣q,o<t)⋅At,clip(πθ(ot∣q,o<t)πθold(ot∣q,o<t),1−ϵ,1+ϵ)⋅At)

PPO-Clip Seq-level Loss

Lppo(θ)=−1G∑i=1G⏟样本间平均1|oi|∑t=1|ot|⏟序列内平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)
PPO-Clip, Token-Level

相关笔记

PPO-Clip Token-level 策略目标

JDAPO(θ)=E(q,a)∼D,{oi}i=1G∼πθold(⋅∣q)[1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)]

PPO-Clip Token-level Loss

  • 直接对所有Token做平均,每个token权重相同,不论来自长或短序列。
LDAPO(θ)=−1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵlow,1+ϵhigh)⋅A^i,t)
PPO-KL-Penalty 策略目标
JPPOKL(θ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⋅Aϕπθold(st,at)]−β⋅KL(πold,πθ)arg⁡maxπθJPPOKL(πθ)=Eτ∼πold[πθ(at∣st)πθold(at∣st)⋅Aϕπold(st,at)−β⋅KL(πθold(⋅∣st),πθ(⋅∣st))]

PPO Loss ​

Actor在PPO epoch中,使用同一批数据做迭代更新的。

PPO Loss

重要性权重/比率做Clip

  • 为了稳定性,会对重要性权重做CLIP截断
rt(θ)=πθ(at∣st)πθold(at∣st)rt(θ)=clip(rt(θ),min_r,max_r)
  • negative_approx_kl = log_prob - old_log_prob
  • negative_approx_kl = torch.clamp(negative_approx_kl, min=-20.0, max=20.0)

PPO Loss

LtPPO−std=−min(πθ(at∣st)πθold(at∣st)⋅Aϕπθold(st,at),clip(πθ(at∣st)πθold(at∣st),1−ϵ,1+ϵ)⋅Aϕπθold(st,at))Lppo(θ)=−1G∑i=1G⏟样本间平均1|oi|∑t=1|ot|⏟序列内平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)

PPO Dual-Clip Loss ​

Dual-Clip Loss

负优势IS大权重时CLIP失效

  • 当At<0且rt>1+ϵhigh时

  • MIN机制选择更小的负数,Loss变成绝对值巨大的负数,产生巨大梯度,导致训练不稳定

    L=−min(rt⋅At,clip(rt,1−ϵ,1+ϵ)⋅At)
  • 负优势+IS权重大时CLIP机制失效,惩罚太大 梯度无限制。如rt=10,At=−1

    L=−min(−10,clip(10,1−0.2,1+0.2)⋅(−1))=−10

Dual-Clip Loss

  • 在优势At<0时,额外增加一个裁剪
  • 负优势+IS权重偏差很大,限制惩罚力度
  • 这个token的loss,最大不能超过优势绝对值*clip_ratio_c=3
LtDual-Clip={−min(rtAt,clip(rt,1−ϵ,1+ϵ)At)At≥0min(−rtAt,−cAt)At<0

熵奖励 ​

熵奖励

相关笔记

背景

  • 熵是信息量的期望,衡量不确定性的程度。熵越大,不确定性越大。
  • RL容易陷入局部最优,停止探索。为了鼓励探索,增加熵奖励。

计算方法

  • 熵系数entropy_coef + 熵lossentropy_loss,response每个生成token熵的平均值
  • agg_loss(loss_mat=entropy, loss_mask=response_mask, loss_agg_mode=x)
  • 熵奖励:entropy_coeff * entropy_loss
Ltotal=Lppo−βH⋅Lentropy
python
if calculate_entropy:
  	entropy = output["entropy"][:, -response_length - 1 : -1].contiguous()
    entropy_loss = agg_loss(loss_mat=entropy, loss_mask=response_mask, ...)  
    entropy_coeff = meta_info["entropy_coeff"]
    # 核心:从PPO损失中减去熵损失(乘以一个系数)
    policy_loss = pg_loss - entropy_coeff * entropy_loss  

KL 惩罚 ​

KL Loss 背景

背景

  • RLHF中通常有一个SFT或基座的πref模型,有一定能力。
  • Reward Hacking:如果不约束πθ,模型可能会走捷径骗过RM,来获取高奖励。

KL Loss 正则化手段

KL Loss 惩罚

KL Loss

KLloss=−β⋅DKL(πθ,πθref)

自适应KL系数(PPO原论文)

  • 计算平均KL散度d,设置目标值dtarg

  • KL散度小于目标值,降低beta;否则,增大beta

    β={β/2,d<dtarg/1.5β×2,d>dtarg×1.5

K1

DKLt(πθ,πθref)=logπθ(oi,t∣q,oi,<t)πref(oi,t∣q,oi,<t)

K3

DKLt(πθ,πθref)=πref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−logπref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−1
python
if self.config.use_kl_loss:
    ref_log_prob = data["ref_log_prob"]
    # compute kl loss
    kld = kl_penalty(logprob=log_prob, ref_logprob=ref_log_prob, kl_penalty=self.config.kl_loss_type) 
    kl_loss = agg_loss(loss_mat=kld, loss_mask=response_mask, loss_agg_mode=self.config.loss_agg_mode) 
		# 核心:将KL损失(乘以一个系数)加到总损失上
    policy_loss = policy_loss + kl_loss * self.config.kl_loss_coef 
python
def kl_penalty(logprob: torch.FloatTensor, ref_logprob: torch.FloatTensor, kl_penalty) -> torch.FloatTensor:
    """Compute KL divergence given logprob and ref_logprob. Optionally using straight through to bind k2 on other
    kl penalty compute method for unbiased KL gradient estimation.
    See more description in http://joschu.net/blog/kl-approx.html

    Args:
        logprob:
        ref_logprob:

    Returns:
        kl_estimate
    """
    forward_score = kl_penalty_forward(logprob, ref_logprob, kl_penalty) 
    if not kl_penalty.endswith("+") or kl_penalty in ("mse", "k2"):
        return forward_score

    """
    The expectation of k1 and k3 estimator is the expected value of KL, but the expected gradient of k1 and k3
    estimator is not the expected gradient of KL. On the other hand k2 estimator gives right gradient estimator, 
    so we use a straight through trick here if the kl_penalty method ends with '+', e.g., k3+. 
    """
    backward_score = 0.5 * (logprob - ref_logprob).square()

    return backward_score - backward_score.detach() + forward_score.detach()
python
def kl_penalty_forward(logprob: torch.FloatTensor, ref_logprob: torch.FloatTensor, kl_penalty) -> torch.FloatTensor:
    """Compute KL divergence given logprob and ref_logprob.
    Copied from https://github.com/huggingface/trl/blob/main/trl/trainer/ppo_trainer.py#L1104
    See more description in http://joschu.net/blog/kl-approx.html

    Args:
        logprob:
        ref_logprob:

    Returns:
        kl_estimate
    """
    if kl_penalty in ("kl", "k1"):
        return logprob - ref_logprob  

    if kl_penalty == "abs":
        return (logprob - ref_logprob).abs()

    if kl_penalty in ("mse", "k2"):
        return 0.5 * (logprob - ref_logprob).square()  

    # J. Schulman. Approximating kl divergence, 2020.
    # # URL http://joschu.net/blog/kl-approx.html.
    if kl_penalty in ("low_var_kl", "k3"):
        kl = ref_logprob - logprob 
        # For numerical stability
        kl = torch.clamp(kl, min=-20, max=20)
        ratio = torch.exp(kl)
        kld = (ratio - kl - 1).contiguous()
        return torch.clamp(kld, min=-10, max=10)

    if kl_penalty == "full":
        # so, here logprob and ref_logprob should contain the logits for every token in vocabulary
        raise NotImplementedError

    raise NotImplementedError

PG Loss 代码及实现过程 ​

PPO PG Loss 核心部件

核心思想

  • 优势 * 重要性权重,PPO-Clip,PPO-Dual-Clip
  • Loss 聚合类型:token-mean、seq-mean-token-mean 等。
  • 入参:old_log_prob、log_prob、advantages、response_mask、loss_agg_mode等

相关笔记

PG Loss 计算过程

1. 重要性权重

  • IS ratio=torch.exp(log_prob - old_log_prob)ri,t(θ)=πθ(oi,t|q,oi,<t)πold(oi,t|q,oi,<t)

2. 新旧策略PPO_KL监控指标

  • -(log_prob - old_log_prob),近似KL,作为观测指标

  • 数据采样策略:πold;当前学习策略:πθ。Response做Mask,求mean

    DKL(πold||πθ)=Ex∼πold[logπold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)]

3. 朴素无clip的 PG Loss

  • pg_losses1 = -advantages * ratioJ优势(πθ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⋅Aπθold(st,at)]

4. PPO-CLIP PG Loss 计算

  • 根据clip_range(low和high),对IS权重做clip,再乘以优势,计算pg_losses2

    • pg_losses2= -advantages * torch.clamp(ratio, 1 - cliprange_low, 1 + cliprange_high)
  • pg_losses1和pg_losses2 选大的,loss已有负号,应选大的

    • clip_pg_losses1 = torch.maximum(pg_losses1, pg_losses2)
    LDAPO(θ)=−1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵlow,1+ϵhigh)⋅A^i,t)
  • 计算pg_clipfrac比例,监控指标,有多少比例的token 被clip掉

    • pg_clipfrac = verl_F.masked_mean(torch.gt(pg_losses2, pg_losses1).float(), response_mask)

5. PPO-Dual CLIP Loss 计算

  • clip_pg_losses2:针对负优势,使用clip_ratio_c=3.0做clip。
  • pg_losses3 = -advantages * clip_ratio_c
  • clip_pg_losses2 = torch.min(pg_losses3, clip_pg_losses1)

6. 最终clip_pg_losses

  • 在优势小于0的token,选择clip_pg_losses2;其余仍选择clip_pg_losses1
    • pg_losses = torch.where(advantages < 0, clip_pg_losses2, clip_pg_losses1)
  • 根据loss_agg_mode 做loss聚合
python
@register_policy_loss("vanilla")  # type: ignore[arg-type]
def compute_policy_loss_vanilla(
    old_log_prob: torch.Tensor,
    log_prob: torch.Tensor,
    advantages: torch.Tensor,
    response_mask: torch.Tensor,
    loss_agg_mode: str = "token-mean",
    config: Optional[DictConfig | AlgoConfig] = None,
    rollout_is_weights: torch.Tensor | None = None,
) -> tuple[torch.Tensor, dict[str, Any]]:
    """
    Compute the clipped policy objective and related metrics for PPO.

    Adapted from
    https://github.com/huggingface/trl/blob/main/trl/trainer/ppo_trainer.py#L1122

    Args:
        old_log_prob (torch.Tensor):
            Log-probabilities of actions under the old policy, shape (batch_size, response_length).
        log_prob (torch.Tensor):
            Log-probabilities of actions under the current policy, shape (batch_size, response_length).
        advantages (torch.Tensor):
            Advantage estimates for each action, shape (batch_size, response_length).
        response_mask (torch.Tensor):
            Mask indicating which tokens to include in the loss, shape (batch_size, response_length).
        loss_agg_mode (str, optional):
            Aggregation mode for `agg_loss`. Defaults to "token-mean".
        config: `(verl.trainer.config.ActorConfig)`:
            config for the actor.
        rollout_log_probs: `(torch.Tensor)`:
            log probabilities of actions under the rollout policy, shape (batch_size, response_length).
    """

    assert config is not None
    assert not isinstance(config, AlgoConfig)
    clip_ratio = config.clip_ratio  # Clipping parameter ε for standard PPO. See https://arxiv.org/abs/1707.06347.
    clip_ratio_low = config.clip_ratio_low if config.clip_ratio_low is not None else clip_ratio
    clip_ratio_high = config.clip_ratio_high if config.clip_ratio_high is not None else clip_ratio
    clip_ratio_c = config.get(  # Lower bound of the ratio for dual-clip PPO. See https://arxiv.org/pdf/1912.09729.
        "clip_ratio_c", 3.0
    )

    cliprange = clip_ratio
    cliprange_low = clip_ratio_low
    cliprange_high = clip_ratio_high

    assert clip_ratio_c > 1.0, (
        "The lower bound of the clip_ratio_c for dual-clip PPO should be greater than 1.0,"
        + f" but get the value: {clip_ratio_c}."
    )
    negative_approx_kl = log_prob - old_log_prob
    # KL做CLIP
    negative_approx_kl = torch.clamp(negative_approx_kl, min=-20.0, max=20.0)
    # IS 重要性权重
    ratio = torch.exp(negative_approx_kl) 
    # old_logprob-logprob,old-采样,logprob-学习,PPO_KL近似KL散度,监控指标
    ppo_kl = verl_F.masked_mean(-negative_approx_kl, response_mask)
    # 朴素无clip的pg_loss,-优势*重要性权重
    pg_losses1 = -advantages * ratio  
    if cliprange_low is None:
        cliprange_low = cliprange
    if cliprange_high is None:
        cliprange_high = cliprange
    # ppo-clip 第二项,对ratio做clip,乘以advantages
    pg_losses2 = -advantages * torch.clamp(ratio, 1 - cliprange_low, 1 + cliprange_high)  # - clip(ratio, 1-cliprange, 1+cliprange) * A  #
    # max(-ratio * A, -clip(ratio, 1-cliprange, 1+cliprange) * A)
    # ppo clip loss
    clip_pg_losses1 = torch.maximum(pg_losses1, pg_losses2)    
    # ppo clip 比例,有多少loss2 > loss1的
    pg_clipfrac = verl_F.masked_mean(torch.gt(pg_losses2, pg_losses1).float(), response_mask)
    
    # dual ppo clip,在优势小于0时,额外增加clip
    pg_losses3 = -advantages * clip_ratio_c 
    clip_pg_losses2 = torch.min(pg_losses3, clip_pg_losses1) 
    # dual ppo clip 比例
    pg_clipfrac_lower = verl_F.masked_mean(
        torch.gt(clip_pg_losses1, pg_losses3) * (advantages < 0).float(), response_mask
    )
    # dual ppo clip,在优势小于0时,额外增加一个裁剪
    pg_losses = torch.where(advantages < 0, clip_pg_losses2, clip_pg_losses1)  

    # Apply rollout correction weights if provided
    if rollout_is_weights is not None:
        pg_losses = pg_losses * rollout_is_weights

    pg_loss = agg_loss(loss_mat=pg_losses, loss_mask=response_mask, loss_agg_mode=loss_agg_mode)  

    pg_metrics = {
        "actor/pg_clipfrac": pg_clipfrac.detach().item(),
        "actor/ppo_kl": ppo_kl.detach().item(),
        "actor/pg_clipfrac_lower": pg_clipfrac_lower.detach().item(),
    }
    return pg_loss, pg_metrics

总Policy Loss 及代码 ​

总Policy Loss

相关笔记

核心思想

  • Policy loss = PPO损失 - 熵奖励 + KL 惩罚

  • policy_loss = pg_loss - entropy_coeff * entropy_loss + kl_loss_coef * kl_loss

Policy Loss 增加 Entropy和KL loss

python
policy_loss = pg_loss

if calculate_entropy:
  entropy = output["entropy"][:, -response_length - 1 : -1].contiguous()
  if not forward_only:
      entropy_loss = agg_loss(loss_mat=entropy, loss_mask=response_mask, loss_agg_mode=loss_agg_mode)
      entropy_coeff = meta_info["entropy_coeff"]
      policy_loss = pg_loss - entropy_coeff * entropy_loss 
  else:
      ret_entropy = entropy

if forward_only:
  policy_loss = torch.tensor(1.0, device=device)
else:
  if self.config.use_kl_loss:
      ref_log_prob = data["ref_log_prob"]
      # compute kl loss
      kld = kl_penalty(logprob=log_prob, ref_logprob=ref_log_prob, kl_penalty=self.config.kl_loss_type)
      kl_loss = agg_loss(loss_mat=kld, loss_mask=response_mask, loss_agg_mode=self.config.loss_agg_mode)

      policy_loss = policy_loss + kl_loss * self.config.kl_loss_coef
      metrics["actor/kl_loss"] = kl_loss.detach().item()
      metrics["actor/kl_coef"] = self.config.kl_loss_coef

Verl 训练观测指标 ​

监控指标

pg_loss

  • 优势*权重+PPO-Clip+PPO-Dual-Clip后的最终pg_loss。LDAPO(θ)=−1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵlow,1+ϵhigh)⋅A^i,t)

ppo_kl

  • 采样策略πold和学习策略πθ之间的KL距离。DKL(πold||πθ)=Ex∼πold[logπold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)]

pg_clipfrac

  • IS权重 被PPO-Clip区间 [1−ϵlow,1+ϵhigh] 裁剪的比例

pg_clipfrac_lower

  • PPO-Clip后,被PPO-Dual-Clip针对负优势,裁剪的比例。LtDual-Clip={LtPPO−stdAt≥0min(LtPPO−std,−c⋅At)At<0

Reward ​

Reward Model 训练 ​

Reward Model 训练

目标

  • 给 (Prompt, Response) 打分,输出1个标量。

偏好数据收集

  • 1个Prompt,输出多个Response,人类排序
  • 偏好数据:(prompt, chosen_response, rejected_response)

训练目标

  • 好回复的分数比差回复的分数 高
RM(prompt,chosen_response)>RM(prompt,rejected_response)

Pairwise Loss

  • scorechosen−scorereject:原始分数差;目标:最大化原始分数差
  • Sigmoid:模型认为 Chosen比Reject分数好的概率;目标:把概率推向1
  • −log:交叉熵loss,对错误概率进行惩罚;目标:最小化惩罚
loss=−log(σ(R(yc∣x)−R(yr∣x)))loss=−log(σ(scorechosen−scorereject))

Reward Model 即时奖励 ​

Reward

RM 打分

  • 在NLP中,RM仅对整个Response打1个分,仅最后一个token才有奖励rT,其余设为0。

    • 下文Critic目标之一:使最后一个token的回报 接近RM给的奖励 rTVϕ(sT)↔rT
  • 打分模型:训练过的Reward Model 或者 Rule-Based Func 或 LLM as Judge 等。

  • 充当环境的作用,给每一步 即时奖励。

环境奖励信号

  • 环境奖励rtenv={00≤t≤T−1无奖励rTt=T最终奖励

最终奖励

  • 最终每一步的奖励 = 环境奖励 -KL约束,KL 奖励约束见下文
rttotal=rtenv−β⋅DKLt(πθ,πref)=rtenv−β⋅logπθ(ot∣q,o<t)πref(ot∣q,o<t)
  • 由于KL约束非负,除rT,其余token的奖励rt 要么是0、要么是负数。

奖励加入KL散度项 ​

奖励加入KL散度

目的

  • 确保 PolicyModel 不会偏离 ReferenceModel 太远。
  • 如果偏离越大, 负的KL散度奖励,对策略的抑制也越大。

核心思想

  • 对Policy和Reference模型的token预测分布,加入KL项。
  • KL 负奖励
DKLt(πθ,πref)=logπθ(ot∣q,o<t)πref(ot∣q,o<t)

最终奖励

  • 最终奖励 = 环境奖励 - KL约束
rttotal=rtenv−β⋅DKLt(πθ,πref)=rtenv−β⋅logπθ(ot∣q,o<t)πref(ot∣q,o<t)rt=rφ(q,o≤t)−β⋅logπθ(ot∣q,o<t)πref(ot∣q,o<t)r(x,y)=rϕ(x,y)−β⋅(log⁡πθ(y∣x)−log⁡πref(y∣x))
  • 由于KL约束非负,除rT,其余token的奖励rt 要么是0、要么是负数。

Critic ​

Critic 目标 ​

Critic 目标

Critic 核心目标

  • 评估策略效果,Actor更新后,需新的Critic来衡量新策略的价值。

  • 优化价值函数V(s), 学习真实目标值

    • 让 V(s)预测 尽可能更接近 真实的未来总回报。类比TD Error 定义
      • 预测当前策略,从状态s出发,未来总回报的期望值。
      • 是状态st的价值,不是即时奖励rt。
  • 但我们并不知上帝视角的真实目标值

    • 只能通过MC采样轨迹来估计,也就是Target Value,Vtarget,t。
  • 使最后一个token的回报 接近RM给的奖励 rT

Critic 核心作用

  • 通过不断“预测-验证-修正”的过程,Critic 的价值评估能力越来越强。
  • 从而能为 Actor 提供 更准确、更稳定的优势信号,最终引导 Actor 学会更好的策略

稀疏的监督信号

  • 在LLM RL中,仅最后一个token 有RM给的奖励。
  • 其他token 奖励都为0,其他token缺乏合适的奖励信号。
  • 导致Critic Model非常难以训练 ‼️。

Critic 学习过程 ​

Critic 学习过程

标准的监督学习

  • 输入:状态s、 st
  • 预测:Vϕ(s)、Vθ(st)、V(st)、Vnew(st)
    • Critic网络 在时间步t对状态st 的价值预测。
    • ϕ是Critic 网络参数
  • 目标:Vtarget、Vtarget,t、Rt
    • 在时间步t,根据实际获得奖励 对真实回报的估计值。
    • 这是最核心内容,在下文详细介绍计算。
  • Loss:预测值和目标值之间的差距,MSE loss。

算法流程

  • 采样数据:Actor和环境交互,收集1个batch的轨迹数据

  • 计算旧价值预测 Vold(st):

    • 用当前Critic为每一个状态st 预测价值得Vold(st),作为固定值
  • 计算 TD Error

    • 对每个时间步t 计算TD Error
    δt=rt+1+γVπ(st+1)−Vπ(st)
    • rt+1 是环境给的即时奖励,可通过Reward Model 或 Reward Func给出
  • 计算 GAE 优势估计

    • GAE 公式

      AtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅δt+l
    • 从最后一个时间步开始,反向遍历,提高GAE计算效率

      AtGAE(st,at)=δt+γλAt+1GAE(st+1,at+1)
  • 计算 Critic 目标值:利用GAE优势 + 旧价值预测 Vold(st)

Vtarget,t=AtGAE(γ,λ)(st,at)+Vold(st)
  • 计算 Critic Loss (见下文详细说明)

    • 在PPO多个优化子周期(epoch)里,对batch中每个数据点 (st,Vold(st))

      • 把st输入到正在更新的Critic网络,得到新预测值 Vϕ(st)

      • 利用Critic 目标值 和 Critic 最新预测值,计算 MSE Loss

        Lcritic=(Vϕ(st)−Vtarget,t)2
      • 根据Critic Loss调整Critic网络,争取下次预测的更准。

Critic Loss ​

Critic Loss 函数

Loss函数

  • 实际训练中,从收集到的数据,取batch,计算batch上所有时间步的 平均loss
Lcritic=(Vtarget,t−Vθ(st))2Lcritic=1N∑t=1N(Vtarget,t−Vϕ(st))2δt=rt+1+γV(st+1)⏟目标值−V(st)⏟预测值Lcritic=(Vtarget,t⏟目标值−Vnew(st)⏟预测值)2Lcritic=(Rt⏟目标值−Vθ(st)⏟预测值)2
Critic 目标值计算

Critic目标值/真实回报目标值计算 Vtarget,t、Rt

  • 最核心部分, Vtarget,t 计算方法直接影响Critic的学习效率和稳定性

  • 优势函数计算

  • Vtarget,t 计算 ‼️

    • 目标回报Q值 = 优势值 + V值

      Aπ(st,at)=Qπ(st,at)−Vπ(st)→Qπ(st,at)=Aπ(st,at)+Vπ(st)
    • Critic 学习目标是真实回报,可以看作是Qt的一个估计,得到

      Vtarget,t=AtGAE(st,at)+Vold(st)
    • 请注意

      • Vold(st):用当时旧的Critic网络预测并记录下来旧的、固定的值,在GAE之前

        • 当做常数,不参与梯度计算。
      • AtGAE(γ,λ)(st,at):Vold值计算出来的。

    • Vtarget,t理解

      • 基于旧价值函数的估计 + 这个估计的修正量(优势值) = 得到 更精确的回报估计。

Critic Loss 深入理解 ​

Critic Loss TD Error 类比

TD Error

δt=rt+1+γV(st+1)⏟目标值−V(st)⏟预测值

Critic Loss

Lcritic=(Vtarget,t⏟目标值−Vnew(st)⏟预测值)2

TD Error 类比

Lcritic=(Rt⏟目标值−Vθ(st)⏟预测值)2
  • Vtarget,t、Rt :类比 TD 目标值

  • Vnew(st)、Vϕ(st):类比TD Error中的需要优化的价值函数,当前网络的预测值

  • Loss 类比 TD Error

Critic Loss 再深入理解

GAE 优势 推导

  • 反向递推公式
AtGAE(st,at)=δt+γλAt+1GAE(st+1,at+1)=rt+1+γVold(st+1)−Vold(st)+γλAt+1GAE(st+1,at+1)
  • 推导结果
AtGAE(st,at)=rt+1+γVold(st+1)−Vold(st)+γλAt+1GAE(st+1,at+1)

目标回报值 推导

  • R = A + V
Rt=Vtarget,t=AtGAE(st,at)+Vold(st)=rt+1+γVold(st+1)−Vold(st)+γλAt+1GAE(st+1,at+1)+Vold(st)=rt+1+γVold(st+1)+γλAt+1GAE(st+1,at+1)Rt=Vtarget,t=rt+1+γVold(st+1)+γλAt+1GAE(st+1,at+1)

代入计算Loss

Lcritic=(Rt−Vnew(st))2=(rt+1+γVold(st+1)+γλAt+1GAE(st+1,at+1)⏟TD目标,增加GAE−Vnew(st)⏟最新网络预测值)2Lcritic=(rt+1+γVold(st+1)+γλAt+1GAE(st+1,at+1)⏟TD目标,增加GAE−Vnew(st)⏟最新网络预测值)2

Critic Value Clip ​

Value Function Clip

背景

  • 稳定训练技巧,防止Critic网络更新过大,对新价值预测做裁剪。

价值更新裁剪

  • ϵ是超参 例如(0.2),和Actor Loss 裁剪范围通常相同。Vclipped(st)=clip(Vθ(st),Vold(st)−ϵ,Vold(st)+ϵ)

计算未裁剪和裁剪后的2个loss

  • 未裁剪

    Lunclipped=(Vnew(st)−Vtarget,t)2
  • 裁剪后

Lclipped=(Vclipped(st)−Vtarget,t)2

最终Critic Loss 取较大者

Lcritic=max(Lunclipped,Lclipped)

具体稳定训练过程思考

  • 建立信任区域

    • 围绕旧值Vold(st)建立信任区域,相信旧价值预测大体上是正确的。

      [Vold(st)−ϵ,Vold(st)+ϵ]
    • 确保新价值预测Vnew(st)不会离旧价值预测Vold(st) 太远。

    • 预测价值本该朝向目标回报靠近,但若预测价值超出信任区域,则应该Clip。

      Vnew(st)→Rt
  • 防止因目标值不准而过度更新

    • Vtarget,t 是由GAE计算出来的,是估计值,存在方差。
  • 保持 Actor和Critic 更新步调一致

    • PPO核心是限制策略更新幅度,为Actor提供指导信号的Critic也应该限制更新幅度。
    • 防止Critic剧烈变化导致下一轮优势估计出现波动,导致Actor训练不稳定。

重要性采样 ​

PPO 重要性采样

策略梯度

  • 交互策略πθold:与环境交互,采集大量数据来训练πθ
  • 学习策略πθ:要训练学习的网络
  • πθ更新多次后,再去更新πθold
∇J(θ)=Eτ∼pθold(τ)[pθ(τ)pθold(τ)R(τ)∇log⁡pθ(τ)]

优势策略梯度

  • 优势作权重
∇J(θ)=E(st,at)∼πθ[Aπθ(st,at)⏟动作a的权重⋅∇log⁡πθ(at∣st)⏟动作a的梯度]
  • 引入重要性采样
∇J(θ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⏟重要性权重⋅Aπθ(st,at)⏟动作a的权重⋅∇log⁡πθ(at∣st)⏟动作a的梯度]
  • 优势应是演员和环境交互 计算出来的
∇J(θ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⏟重要性权重⋅Aπθold(st,at)⏟动作a的权重⋅∇log⁡pθ(at∣st)⏟动作a的梯度]

目标函数

J(θ)=E(st,at)∼πθold[πθ(at∣st)πθold(at∣st)⏟重要性权重⋅Aπθold(st,at)⏟动作a的权重]

优点

  • 可通过重要性采样把同策略换成异策略

GAE ​

GAE 笔记

GAE
  • 对不同步数的TD优势估计进行指数加权平均,平衡方差和偏差
δt+l=rt+l+γV(st+l+1)−V(st+l)AtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅δt+lAtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅(rt+l+γV(st+l+1)−V(st+l))

算法流程 ​

算法流程

PPO算法流程

  • 初始策略参数θ0
  • 每次迭代
    • 用旧策略θk 和环境交互,采样大量(s,a)对
    • 根据θk交互结果,估计Aπθk(st,at)
    • 采样到这组数据后,最大化目标函数
    • 可以让θ更新很多次
JPPOθk(θ)=Jθk(θ)−β⋅KL(θ,θk)

PPO 调参踩坑经验 ​

PPO 主要注意点

主要坑点

  • Critic初始化
    • 要用预训练权重, 随机初始化基本gg
  • KL散度监控
    • 超过0.02就要降学习率,不然策略会崩
  • 内存管理
    • 内存需求爆炸,双网络+梯度存储
  • 超参数敏感
    • 学习率、裁切范围,都很敏感

部分参数

  • learning_rate:3e-4直接爆炸,降到1.5e-5才稳定
  • batch_size:小于128,训练震荡严重
  • clip_range:跳到0.4后,策略变化太激进

来自 知乎 PPO vs GRPO

json
# 稳定的PPO配置(13B模型)
ppo_config = {
    "learning_rate": 1.5e-5,  # 别用太大,容易崩
    "clip_range": 0.2,        # 经典值,基本不用改
    "batch_size": 256,        # 越大越稳定
    "gae_lambda": 0.95,       # GAE参数
    "value_loss_coef": 0.5,   # 价值损失权重
    "entropy_coef": 0.01,     # 探索系数
    "max_grad_norm": 1.0,     # 梯度剪切
    "n_epochs": 4,            # 数据重用次数
}

缺点不足 ​

PPO不足

GAE带来的计算开销大、训练不稳定

  • GAE 主要依赖于单步时序误差
δ=rt+γV(st+1)−V(st)
  • 计算TDError之前,需为每个token计算奖励和价值
    • 每个token的价值:需由独立的Critic模型计算得到
    • Critic通常和策略模型同架构和大小,Critic计算开销非常大,且训练不稳定导致 无法提供准确的价值信号

DPO ​

标准RLHF目标 ​

标准RLHF目标

标准RLHF目标-tradeoff

  • 最大化奖励:πθ 生成的回答y,从奖励模型尽可能获得高分
  • 不要偏离太远:约束策略πθ和参考策略πref 保持一定相似性。πsft
maxπθEx∼D,y∼πθ(y∣x)[rϕ(x,y)−β⋅DKL(πθ(y∣x),πref(y∣x))]
  • 奖励函数
r(x,y)=rϕ(x,y)−β⋅(log⁡πθ(y∣x)−log⁡πref(y∣x))

标准RLHF训练流程

  • 先训rewad model

    maxrϕE(x,yw,yl)∼D[log⁡σ(rϕ(x,yw)−rϕ(x,yl))]
  • 再通过PPO训Actor Model

    maxπθEx∼D,y∼πθ(y∣x)[rϕ(x,y)−β⋅DKL(πθ(y∣x),πref(y∣x))]

PPO缺点 & DPO动机 ​

PPO缺点 & DPO动机

PPO 缺点

  • 计算复杂、成本高
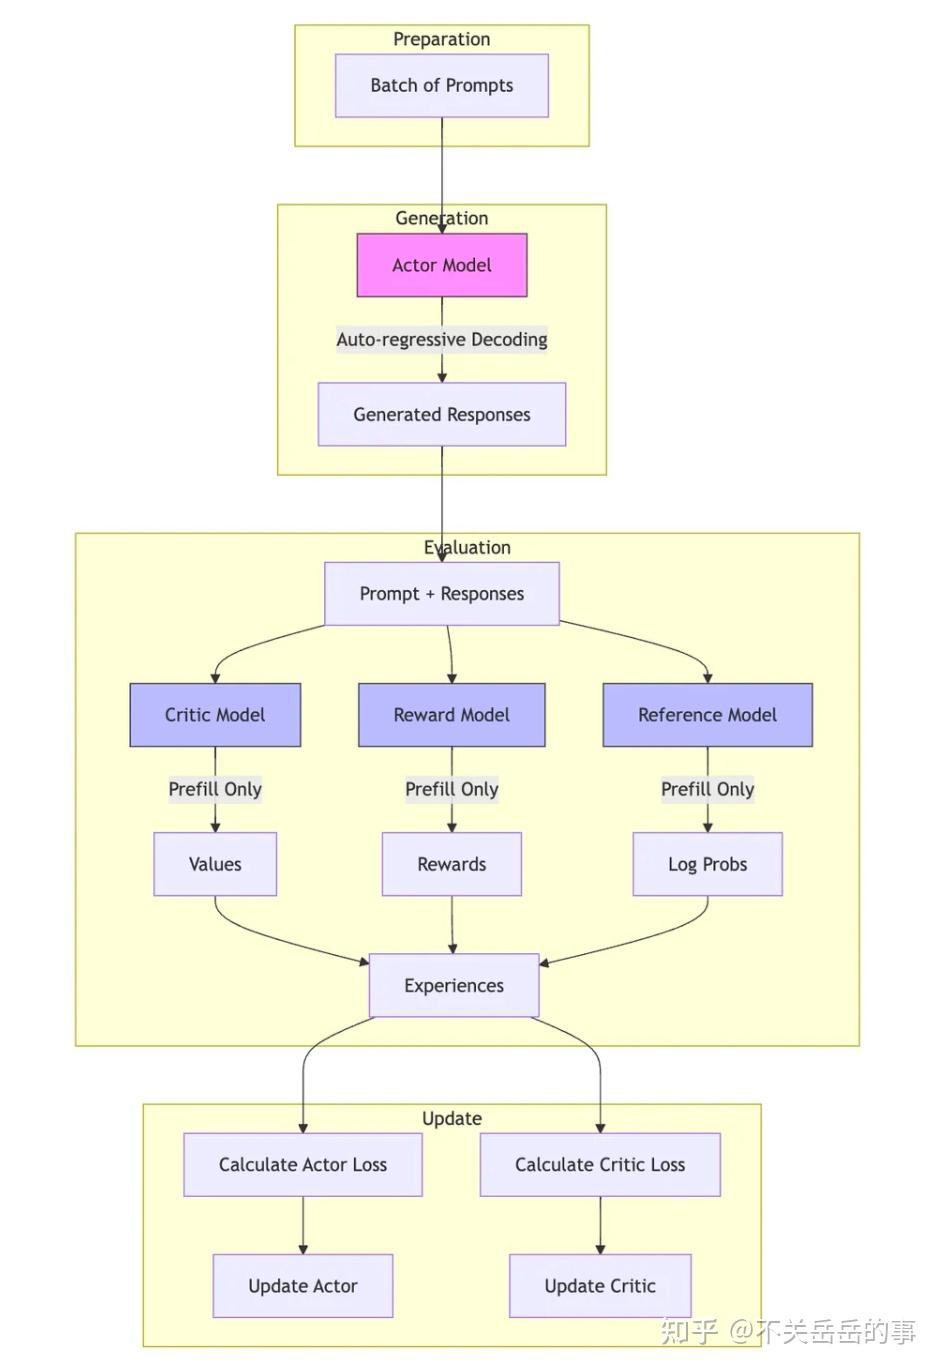
    • Actor、CriticModel(估计价值,降低梯度估计中的方差)、RewardModel(奖励信号)、SFTModel (KL散度)
  • 训练不稳定
    • 奖励稀疏、梯度更新不稳定、收敛困难、参数敏感等
  • Reward Hacking
    • RM从有限的人类偏好数据中学习的,不可避免存在缺陷和偏差。
    • 策略在优化过程中,发现并利用RM的漏洞获得高分 但实际不符合人类预期的输出。
    • 把复杂抽象的人类价值观,压缩成简单的标量信号,是很困难的。

DPO 动机

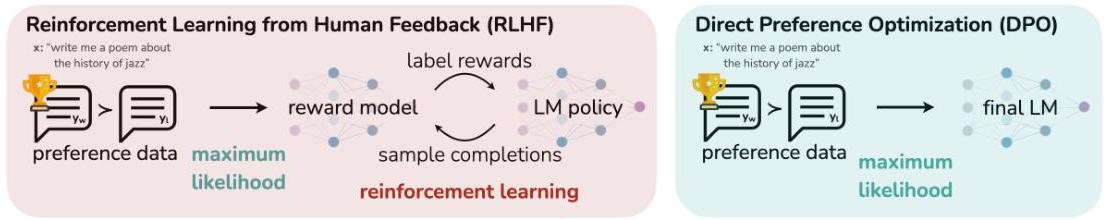
  • 把带有KL约束最大化奖励目标,等价替换成简单的直接在偏好数据上进行优化的分类问题。
  • 把对齐问题重定义为最大似然估计问题,简单二元交叉熵loss,直接对偏好Pair数据优化。
  • 完全绕过 显示奖励模型训练和复杂RL训练。这两个恰好是RLHF中最贵和不稳定的环节。
  • 并非性能上超越RLHF,而是工程上的成功。更稳定、更轻量、更容易实现。

理论基础 ​

显示最优解 ​

显示最优解推导过程

PPO式子理论存在显示最优解

  • 理论最优解:通过完美奖励函数 计算出完美策略模型,不需要迭代式的强化学习。
  • 最优策略、参考策略、奖励函数之间的确定性关系。
πr∗(y∣x)=1Z(x)⋅πref(y∣x)⋅exp(1βr(x,y))
  • Z(x):归一化因子、分配函数,确保给定x,所有y概率加起来等于1
Z(x)=∑yπref(y∣x)exp(1βr(x,y))

显示最优解推导过程 ​

显示最优解推导过程

显示最优解推导过程

  • 推导1
maxπθJ(θ)=maxπθEx∼D,y∼πθ(y∣x)[rϕ(x,y)−β⋅DKL(πθ(y∣x),πref(y∣x))]=maxπθEx∼D,y∼πθ(y∣x)[rϕ(x,y)−β⋅log⁡πθ(y∣x)πref(y∣x)]=minπθEx∼D,y∼πθ(y∣x)[log⁡πθ(y∣x)πref(y∣x)−1β⋅rϕ(x,y)]=minπθEx∼D,y∼πθ(y∣x)[log⁡πθ(y∣x)πref(y∣x)−log⁡erϕ(x,y)β]=minπθEx∼D,y∼πθ(y∣x)[log⁡πθ(y∣x)πref(y∣x)⋅erϕ(x,y)/β]
  • 归一化分母,构建Z(x),以及新的概率分布π∗(y∣x)

    Z(x)=∑yπref(y∣x)⋅erϕ(x,y)/βπ∗(y∣x)=πref(y∣x)⋅erϕ(x,y)/βZ(x)
  • 代入目标式子,得到KL散度

maxπθJ(θ)=minπθEx∼D,y∼πθ(y∣x)[log⁡πθ(y∣x)πref(y∣x)⋅erϕ(x,y)/βZ(x)⋅Z(x)]=minπθEx∼D,y∼πθ(y∣x)[log⁡πθ(y∣x)π∗(y∣x)−log⁡Z(x)⏟与πθ无关]=minπθEx∼D,y∼πθ(y∣x)[log⁡πθ(y∣x)π∗(y∣x)]=minπθEx∼DDKL(πθ(y∣x),π∗(y∣x))
  • KL散度在2个分布相等时取最小值,因此RLHF训练希望得到的最优概率分布就是π∗(y∣x)
π∗(y∣x)=πref(y∣x)⋅erϕ(x,y)/βZ(x)

反解奖励函数 ​

反解奖励函数

反解奖励函数

  • 直接转换π∗(y∣x)定义,反解出隐式奖励函数rϕ(x,y)
π∗(y∣x)πref(y∣x)⋅Z(x)=erϕ(x,y)/ββ⋅log⁡π∗(y∣x)πref(y∣x)⋅Z(x)=rϕ(x,y)rϕ(x,y)=β⋅log⁡π∗(y∣x)πref(y∣x)+β⋅log⁡Z(x)

DPO和RM目标loss一致 ​

RM&DPO 目标loss一致

奖励函数带入奖励loss

  • RewardModel 训练目标 和 DPO 训练目标一致
JRM=maxrϕE(x,yw,yl)∼D[log⁡σ(rϕ(x,yw)−rϕ(x,yl))]=maxπ∗E(x,yw,yl)∼D[log⁡σ(β⋅log⁡π∗(yw∣x)πref(yw∣x)+β⋅log⁡Z(x)−β⋅log⁡π∗(yl∣x)πref(yl∣x)−β⋅log⁡Z(x))]=maxπ∗E(x,yw,yl)∼D[log⁡σ(β⋅log⁡π∗(yw∣x)πref(yw∣x)−β⋅log⁡π∗(yl∣x)πref(yl∣x))]=JDPO

DPO目标和Reward Model一致

  • DPO对标的是RewardModel
    • 训练数据一致、loss函数一致,局限性也一致。
JDPO=JRM

DPO和RM不同点

  • 架构不同
    • RM:有单独的Value Head,输出分值
    • DPO:无Value Head,直接优化token概率
  • 优化手段/目标不同
    • RM:优化偏序打分目标
    • DPO:优化生成目标。

DPO和RM 联系

  • RM可以给DPO扩充数据
  • 理论上,RM也可以做生成,DPO也可以做打分,只是没这么试过。

DPO 核心思想 ​

DPO 核心思想

通过πθ,πold反解出奖励函数

  • 逆向运用理论最优解关系。
  • 不再采用老策略:先学习奖励函数、再利用奖励函数优化策略。
  • 假设LLM隐式定义一个奖励函数,从策略πθ和参考策略πref中反解出隐式奖励函数
rϕ(x,y)=β⋅log⁡πθ(y∣x)πref(y∣x)+β⋅log⁡Z(x)

偏好建模

  • winner > loser, chosen > reject
  • 人类偏好yw而不是yl的概率 p(yw>yl∣x)
p(yw>yl∣x)=σ(r(x,yw)−r(x,yl))=σ(β⋅log⁡(πθ(yw∣x)πref(yw∣x))+β⋅log⁡(Z(x))−β⋅log⁡(πθ(yl∣x)πref(yl∣x))−β⋅log⁡(Z(x)))=σ(β⋅log⁡(πθ(yw∣x)πref(yw∣x))−β⋅log⁡(πθ(yl∣x)πref(yl∣x)))

DPO 目标函数

  • 最小化目标函数

    • −log:交叉熵loss,对错误概率进行惩罚;目标:最小化惩罚
    LDPO(πθ;πref)=−E(x,yw,yl)∼D[log⁡σ(β⋅log⁡(πθ(yw∣x)πref(yw∣x))−β⋅log⁡(πθ(yl∣x)πref(yl∣x)))]
  • 最大化以下目标

    • 生成正样本的概率 比参考模型高,生成负样本的概率 比参考模型低。
maxθlog⁡σ(β⋅log⁡πθ(yw∣x)πref(yw∣x)−β⋅log⁡πθ(yl∣x)πref(yl∣x))

从loss理解其弊端

  • Loss转换过程
maxθJDPO(θ)=maxθlog⁡σ(β⋅log⁡πθ(yw∣x)πref(yw∣x)−β⋅log⁡πθ(yl∣x)πref(yl∣x))=maxθlog⁡σ(βlog⁡πθ(yw∣x)−βlog⁡πref(yw∣x)−βlog⁡πθ(yl∣x)+βlog⁡πref(yl∣x))=maxθlog⁡σ(βlog⁡πθ(yw∣x)πθ(yl∣x)− βlogπref(yw∣x)πref(yl∣x))
  • Loss转换结果

    • 生成正负样本的比例,要目标策略的比例比参考策略的比例 高,loss就可下降。
    maxθlog⁡σ(βlog⁡πθ(yw∣x)πθ(yl∣x)−βlog⁡πref(yw∣x)πref(yl∣x))
    • 比如参考策略:0.50.25=2,目标策略 0.30.1=3,

      • 虽然loss下降、负样本概率下降,但是正样本概率也下降了。
      • 正负样本概率都下降,自然一些奇奇怪怪的输出概率就提高了。
      πref:0.50.25=2→πθ:0.30.1=3

梯度更新

∇θLDPO(πθ;πref)=−β⋅E(x,yw,yl)∼D[σ(r^θ(x,yl)−r^θ(x,yw)⏟权重:模型犯错越大,权重越高)⋅(∇θlog⁡π(yw∣x)−∇θlog⁡π(yl∣x))⏟方向:增加yw似然,降低yl似然]r^θ(x,y)=β⋅logπθ(y∣x)πref(y∣x)

算法机制

  • 数据:离线静态的偏好数据
  • 参考模型作用:πθ和πref=πsft不要偏离太远
  • 超参数β:控制2部分权重
    • 一是:最大化chosen和reject之间的概率差
    • 二是:保持与参考模型的相似性

DPO 缺点 ​

简洁性是其最大优点,但也是其最大缺点。

DPO 缺陷

1. 离线模式缺乏在线采样数据

  • 策略模型在进化,但静态偏好数据一成不变

    • 数据集无法代表 新策略潜在的失败模式,导致模型无法从新的错误中学习。

    • DPO离线特性限制了模型的探索能力。

      • 只有evaluate,没有generate
    • PPO/GRPO 会一直和环境交互采样数据,用当前策略采样新数据 来学习提升。

      • generate + evaluate + generate + evaluate + ...

2. DPO Loss 导致优化过程不稳定

maxθlog⁡σ(βlog⁡πθ(yw∣x)πθ(yl∣x)−βlog⁡πref(yw∣x)πref(yl∣x))
  • 正样本概率、负样本概率 都可能会下降。 回答抑制模式,正负似然都下降。

  • 奇怪输出概率会上升,特别在遇见未见内容时。

  • 负样本概率下降比正样本概率提升 快得多。

    • 大力惩罚已知坏样本,擅长学习不做什么,而非做什么。
    • 不是探索奖励好样本。
  • 过拟合/RewardHacking

    • Loss对所有偏好对一视同仁,不会做权重区分,强行拉开他们的概率差距
    • 缺乏鲁棒性:可能拟合数据噪声,而非真实人类偏好。

3. 依赖SFT模型和数据质量

  • 对SFT模型质量很敏感
    • 最终性能取决于初始化SFT模型。
    • 起点差了,就很难摆脱。而在线学习能通过采样自我学习迭代来摆脱。
  • 数据质量敏感
    • 需要高质量偏好数据
    • 可能学习多数群体的偏好、而忽略少数群体的观点,引入偏见。

GRPO ​

PPO缺点&GRPO动机 ​

PPO 缺点 & GRPO 动机

PPO 核心思想

  • Actor Model
JPPOCLIP(πθ)=Eq,o∼πθold1|o|∑t=1|o|min(πθ(ot∣q,o<t)πθold(ot∣q,o<t)⋅At,clip(πθ(ot∣q,o<t)πθold(ot∣q,o<t),1−ϵ,1+ϵ)⋅At)
  • Critic Model
Lcritic=(rt+1+γVold(st+1)+γλAt+1GAE(st+1,at+1)⏟TD目标,增加GAE−Vnew(st)⏟最新网络预测值)2
  • Reward Model (不参与训练,或 Rule Based Reward)
rttotal=rtenv−KLt(πθ,πref)=rtenv−β⋅logπθ(ot∣q,o<t)πref(ot∣q,o<t)

PPO 缺点

  • 资源开销大
    • 需要训Critic Model(通常和Actor同尺寸),增加了额外的内存和计算开销。
    • 每个Token都需要由Critic 去估计价值, At 依赖Critic。
  • 训练复杂/不好训

GRPO 动机

  • 解决PPO Critic资源开销大、训练复杂的问题。

GRPO核心思想 ​

GRPO 核心思想

核心思想

  • 抛弃Critic Model,降低资源开销和 训练复杂度。

  • 分组采样:每个Prompt采样1组答案(G=64)。

  • 组内计算优势

    • 好的答案,加大权重;差的答案,降低权重。
    • 使用组内平均分作为基线
    • 每个答案,得分减去平均分,作为自身优势,作为策略梯度优化信号。
  • 自适应加权的对比学习。

MC采样思想

  • 和REINOFRCE 算法挺像,主要依赖MC采样,不用TD估计优势。
  • 但MC采样方差大,没有TD去平衡方差,怎么解呢?
    • 使用组内标准化奖励,一定程度降低了策略梯度估计方差。

组内相对优势 ​

优势计算

分组采样

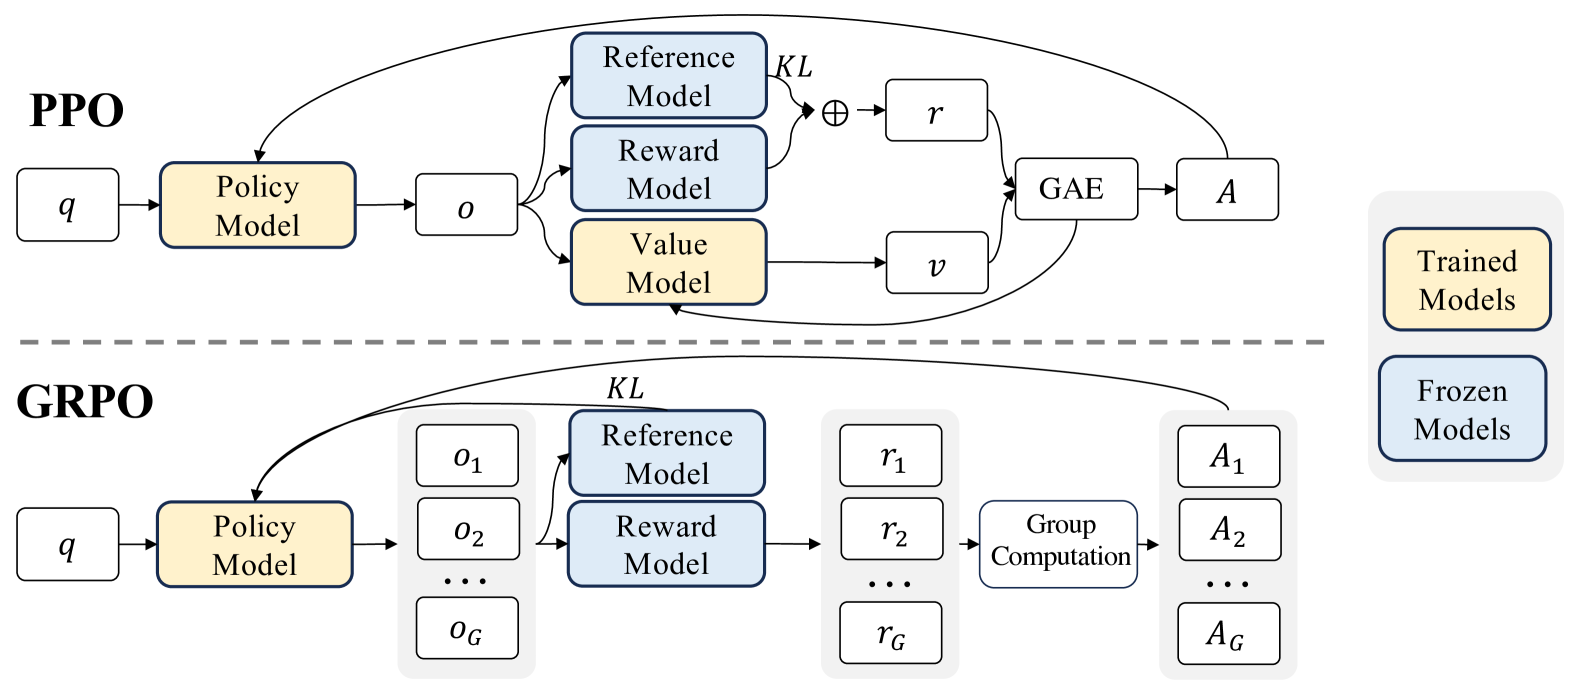
  • 对每个query,采样1组输出,RewardModel 为每个输出打分,给出奖励。
q→o={o1,o2,⋯,oG}→r={r1,r2,⋯,rG}
  • 组内基线计算:组内平均奖励/奖励标准差
mean(r),std(r)

相对组优势计算

  • 为每个输出oi,计算组内的相对得分,作为组内的相对优势
r^i=ri−mean(r)std(r)→A^i=r^iA^i,t=A^i=r^i=ri−mean(r)std(r)

GRPO策略目标 ​

GRPO 策略目标

优化目标-PPO核心差异

  • 使用组内优势来替代GAE优势。
  • 把πθ和πθref的KL约束放入目标函数。
    • PPO是放在每个Token的即时奖励信号 rt里的
      • rttotal=rtenv−β⋅DKLt(πθ,πref)
  • 同PPO一样,使用CLIP信任域来保证新旧策略分布差异不太大。

GRPO 优化目标公式

JGRPO(πθ)=Eq,{oi}i=1G∼πθold1G∑i=1G1|oi|∑t=1|oi|(min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1+ϵ,1−ϵ)⋅A^i,t)−β⋅DKL(πθ,πθref))∇θJGRPO(θ)=Ex∈D,{yi}i=1G∼πθold(⋅|x)[1G∑i=1G1|yi|∑t=1|yi|⏟序列内平均πθ(yi,t|x,yi,<t)πθold(yi,t|x,yi,<t)⏟token重要性权重⋅A^i,t⏟token优势⋅∇θlog⁡πθ(yi,t|x,yi,<t)⏟token梯度]

GRPO ref KL 约束

  • K3 KL,无偏且低方差
DKLt(πθ,πθref)=πref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−logπref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−1

GRPO调参踩坑经验 ​

GRPO 关键点

主要坑点

  • 采样基础设施:需高效的推理系统,SGLANG/VLLM
  • Group大小:太小(<32)统计不稳定,太大计算贵
  • Beta调参:非常关键,需要仔细调
  • 奖励设计:需要奖励信号有足够的区分度
GRPO 关键参数

Beta 参数

  • 0.05:学习太慢、收敛慢
  • 0.1:大多数任务的甜点
  • 0.2:有时候会过拟合
  • 0.3+:基本上会发散

Group_size

  • 16:统计不稳定、方差大
  • 32:勉强能用
  • 64:比较稳定的选择
  • 128:更稳定、但计算成本高

GRPO 标准配置

json
# 我的GRPO标准配置
grpo_config = {
    "learning_rate": 8e-7,    # 比PPO小很多
    "beta": 0.1,              # KL系数,最关键
    "group_size": 64,         # 群体大小
    "temperature": 0.7,       # 生成多样性
    "top_p": 0.9,             # 核采样
    "max_length": 2048,       # 最大长度
}

PPO vs GRPO ​

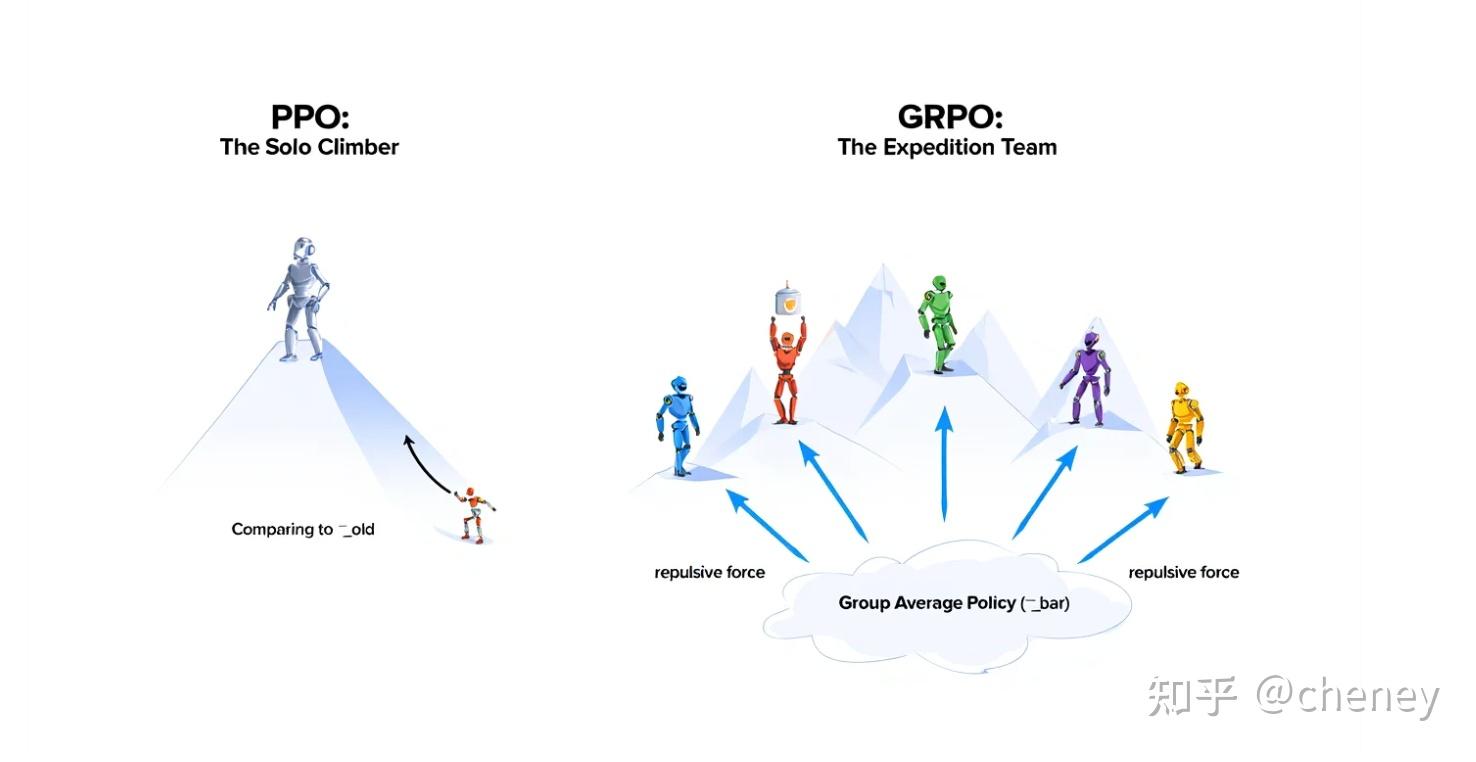
GRPO算法和PPO算法本质区别是什么

核心目标思想差异 ​

PPO vs GRPO 核心目标

PPO

  • 找到一个最大化奖励的最优策略。
  • 解决问题:策略更新的稳定性。

GRPO

  • 找到一组高质量且多样化的策略。
  • 解决问题:策略发现的多样性。
PPO vs GRPO 核心思想

PPO

  • 拥有历史数据库的教练,追求绝对最优,学习绝对期望值。
  • 过程
    • 策略模型(1个运动员)完成1次表现,奖励模型给出最终成绩。
    • 价值模型基于历史数据,在运动员跑到中间点时,预测最终成绩;
  • 优势:
    • 最终成绩-历史预测成绩 。超预期,就获得正向奖励。
    • 参照物:过去的自己,πθold。超越昨天的自己。
  • 学习信号/优势信号

GRPO

  • 组织小组赛的教练,追求相对领先,直接使用相对的、动态的平均值。
  • 过程
    • 策略模型(1组运动员)同时完成表现,生成G个回答。奖励模型为每位运动员给出最终成绩。
    • 没有历史数据,直接算出这组运动员的平均成绩。
  • 优势:
    • 组内相对优势,个人成绩-小组平均成绩。超平均水平,就获得正向奖励。
    • 参照物:团队平均策略,π¯。超越团队平均。
  • 学习信号/优势信号
    • Response-Level,Trajectory-Level
    • 轨迹级优势直接应用到序列的每个token,作为token-level优势。

技术实现差异 ​

PPO vs GRPO 技术实现差异

核心目标

  • PPO:找到一个最大化累积奖励的 单一最优策略。解决策略更新的稳定性问题。
  • GRPO:找到一组高质量且具备多样性的策略。解决策略发现的多样性和效率问题。

优化参照物

  • PPO:过去的自己πθold。和上一轮策略比较,在信任域内小步快跑,争取超过昨天的自己。
  • GRPO:小组的平均策略π¯。超过平均水平,则获得正向激励。

算法架构

  • PPO
    • Actor-Critic架构:Actor+Critic+RewardModel。
    • Critic 估计状态价值 V(s)、用于GAE计算优势。
    • MC 采样 + TD估计。
  • GRPO
    • 纯策略梯度:Actor+RewardModel。
    • 无Critic,价值基线通过统计得出。
    • MC 采样。

优势

  • PPO
    • GAE,依赖价值模型V(s),基于模型预测、学习的方法。
      • 对多个n步优势估计,加权平均,引入λ平衡方差和偏差
      • 结合了多步MC回报+Critic价值预测,MC采样+TD估计。
      • 依赖准确估计的Critic,这个往往是PPO的难点。
    • 优势获得条件
      • 实际得分比历史预测好,才获得正向奖励。
      • 基于绝对奖励+价值函数预测
    • 优势信号特点
      • 仅最后一个token有环境奖励,其余token为0。
      • 所有token都有KL惩罚奖励。
  • GRPO
    • 组相对优势,不依赖价值模型, 基于群体投票、统计的方法。
    • 优势获得条件
      • 个人比组平均成绩好,才获得正向奖励。
      • 组内相对排名和分数
    • 优势信号特点
      • 一条轨迹上所有token 共享相同的优势值,都为A^i,t

奖励信号利用

  • PPO

    • Token-Level
    • 间接利用环境奖励 用来训Critic;再由依赖Critic计算的GAE优势,指导Actor更新。
    • 有奖励KL惩罚。
    • 绝对奖励信号。
  • GRPO

    • Response-level
    • 直接利用奖励信号 用于计算相对优势,直接用于Actor优化。
    • 无奖励KL惩罚。
    • 标准化组相对奖励。

资源开销和训练复杂度差异 ​

PPO vs GRPO

1. 资源开销

  • PPO
    • 资源需求高。Actor和Critic 2个模型。
    • 内存需求:基础模型*3倍
      • Actor *1, Critc *1, 梯度+优化器 *1,旧策略缓存:部分参数。
      • 实际和bs、序列长度有关。
  • GRPO
    • 资源需求低,仅Actor模型。
    • 内存需求:基础模型*1.5倍
      • Actor *1,梯度+优化器 *0.5(单网络)。
      • 实际和bs、序列长度有关。
    • 无Critic,与PPO相比,显存需求降低25%。若使用规则,不用RewardModel,降低50%。

2. 训练复杂性

  • PPO
    • 复杂性:高。
    • 需同时训Actor和Critic,难度大。超参数敏感。
    • Critic本身难训练难收敛 导致优势估计不准,尤其在奖励稀疏的语言模型中。
  • GRPO:
    • 复杂性:低。
    • 只需训练Actor,调参更容易。
    • 基线是直接从组内得分统计出来的,而非学习来的。过程更简单稳定。

3. 训练稳定性

  • PPO
    • 相对稳定。
    • 通过CLIP信任域机制,限制策略更新幅度 防止学崩,保证训练稳定性。
    • GAE 在Critic训练良好的情况下,能有效平衡降低方差和偏差。
    • Critic若收敛 训练更稳定。
  • GRPO
    • 非常稳定。
    • 组内相对优势,天然对奖励绝对值不敏感,只关心排序,有效降低了方差。
    • 目标函数通样有KL约束,保证策略更新的稳定性。

优缺点对比 ​

PPO 优缺点

优点

  • 通用性强

  • 单样本更新对噪声容忍度较高。

缺点

  • 计算成本高,训练困难。
  • 对奖励缩放敏感。优势估计 受奖励绝对值影响。
GRPO 优缺点

优点

  • 无Critic模型 高效轻量,资源消耗低、训练快。

  • 训练过程更稳定,参数好调。

  • 与偏好奖励模型 (Reward Model) 的相对比较机制完美契合

缺点

  • 采样开销可能较高,每次更新需要采样G个输出。G太小,方差大。
  • 对G值敏感:会影响性能和开销平衡。
  • 依赖组内质量多样性:组内样本高度相似 标准差为0 优势估计失效,导致梯度为0更新失效。
为什么GRPO能work/在LLM下可能更优
  • GRPO规避了Critic训练难题
    • Critic 非常难训练:在LLM 稀疏奖励情况下,仅最后token有奖励信号。
  • GRPO和RewardModel很搭配。
    • RewardModel通过比较谁更好来训练,最擅长做出相对判断;
    • GRPO通过组内选出更好的,而非绝对分数。
    • 机制契合使奖励信号利用更高效。
  • 隐式课程学习
    • 同一个问题,组内样本质量有高有低。
    • 模型通过比较,可以同时学到好的和差的,学习信号更加丰富。
  • 高效且稳定。

适用场景对比 ​

PPO vs GRPO 适用场景

PPO

  • 通用RL,机器人控制、游戏AI等。
  • 主观评价。
  • 内存、计算资源充足。
  • 追求极致性能提升
  • 支持连续和离散动作空间。

GRPO

  • 针对LLM的RLHF:GRPO完美契合人类偏好训练的RewardModel。
  • 内存、计算资源有限。极致性价比。
  • 快速迭代。
  • 多样性任务。
  • 高效稳定。
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026