变化点
2026.07 · Kimi K3
- 扩展为原生多模态 MoE,结合 KDA、Gated MLA 与 AttnRes。
- 按领域和 effort 训练
9 个教师,再用 MOPD 合并能力。
2026.06 · Kimi K2.7 Code
- 基于 K2.6 强化代码任务,采用
Thinking-only + 256K,保留多轮思考与工具历史。 - 原生 INT4 部署;在统一 Kimi Code CLI 下评测仓库与程序任务。
2026.02 · Kimi K2.5
- 在 K2 上加入原生图文联合训练;Zero-Vision SFT 与多模态 RL 强化视觉工具使用。
- PARL 只训练调度 Agent,冻结 Subagent,以任务奖励与 Critical Steps 学习并行协作。
2025.11 · Kimi K2-Thinking
- 在 K2 基础上强化
思考 → 工具调用 → 再思考,支持连续多步任务。 - 引入
INT4 QAT,降低推理模型部署成本。
2025.10 · Kimi Linear(架构研究)
- 以
3:1 KDA / MLA混合注意力,兼顾有限状态记忆与精确历史访问。 - KDA 使用有限状态记忆,降低长上下文的 KV Cache 与解码开销。
2025.09 · Kimi-Dev
- 以 Qwen2.5-72B 为基础,代码 CPT、推理 SFT 与 Code-Edit RL 逐步强化仓库修复。
- 以课程学习和执行反馈训练修改能力,再用 Agent 轨迹 SFT 适配工具交互。
2025.07 · Kimi K2
- 扩大至
1T 总参数 / 32B 激活,MuonClip 稳定大规模预训练。 - 扩展 Agent 任务合成与 RL,从推理回答转向实际工具执行。
2025.06 · Kimi-Researcher
- 围绕搜索、浏览和代码工具做端到端 RL,训练多轮研究任务。
- 结合上下文管理与全异步 rollout,支持更长的工具交互。
2025.01 · Kimi k1.5
- 将长 CoT RL 扩展到文本与多模态推理,使用 Partial Rollout 复用长轨迹。
- 通过
Long2Short将长推理能力迁移到短回答。
(2607) Kimi K3 (2.78T MoE、9 教师 RL、MOPD)
🌺 论文摘要
参考链接
问题背景
- 长历史检索、大规模 MoE 优化与多预算 Agent 训练需要同时兼顾。
核心方法
- 架构优化:KDA + Gated MLA、AttnRes 与 Stable LatentMoE,兼顾长历史访问与训练稳定性。
- 数据与反馈:构建多模态、Agent 轨迹和可验证任务,用 Agentic GRM 检查任务产物。
- 领域 RL 与 MOPD:分领域、分预算训练
9个策略,再沿学生自身轨迹整合教师能力。
模型效果(Kimi K3,max)
- DeepSWE v1.1
67.5,Terminal-Bench 2.188.3,BrowseComp91.2。
重要结论
- 百万上下文仍需历史管理;BrowseComp 加压缩
91.2,不压缩为90.4。
核心贡献
- 把混合架构、多教师策略训练和长程 Agent 系统整合为原生多模态模型。
未来方向
- 改进 GUI 操作、研究级推理和长任务持续执行能力。
问题背景
- 计算成本:完整 attention 的历史缓存随长度增长,纯有限状态又难以保留所有可检索细节。
- 优化稳定性:更深网络、更多专家和低精度训练共同放大激活与负载波动。
- 预算适配:同一任务的低延迟回答和高预算研究需要不同策略,不能只把最长轨迹训好。
核心方法
架构与优化器
- KDA:
69层维护有限状态,按通道控制历史保留与更新。 - Gated MLA:
24层访问全局历史,补充有限状态难以保存的精确细节。 - KDA 对 log-forget 范围作限制,抑制低精度训练中的状态数值波动。
Block AttnRes
- 普通残差不断累加旧层输出;AttnRes 用可学习 query 对旧表示加权,按当前需要选择来源。
- 按
12 层分块,块内累加、块间选择;加上 embedding,共保留9份块级来源。
- 路由专家在
3584维空间计算,共享专家保留7168维通道;降低路由路径的计算与通信。 - 聚合后加 RMSNorm;SiTU-GLU 对乘法两支做 softcap,限制大数相乘带来的数值放大。
- QB 根据目标负载求路由偏置,并在下一步使用;推理时冻结偏置。
- 从头训练
0.4B、27层视觉 encoder,通过 MLP projector 接入 LLM。 - 图像和视频共享参数,分别计算帧内空间与帧间时间 attention。
- 时间 pooling 压缩视频,
2×2下采样将视觉 token 减少到1/4。 - 视觉模块使用 RMSNorm、去除投影 bias,改善联合训练稳定性。
- 将 Q/K/V 动量矩阵按 head 分块,各块独立进行 Newton–Schulz 正交化。
- 避免大梯度 head 主导整个矩阵更新,使不同 head 的更新尺度更均衡。
- 较小矩阵块还可减少优化器计算开销。
预训练与 Agent 数据
预训练与 SFT
- 文本覆盖 Web、代码、数学与知识;视觉覆盖 OCR、视频、图文交错和视觉代码。
- SVG、网页、CAD 等代码与渲染结果配对,让图像与可执行结构对应。
- 领域教师合成 Agent 轨迹,经过多阶段验证和人工参与,再统一交互格式。
RL
- 用知识图谱控制概念覆盖与粒度,检索真实材料后合成问题。
- Kernel 任务先检查数值正确性,再按速度给奖励;性能快但结果错不能得分。
- Agentic GRM:读取产物 → 制定 rubric → 逐项评分 → 写入 scorepad → 候选成对比较。
- 长度控制:超过冷启动基准长度指定倍数的候选直接输掉比较,抑制靠冗长回答获取奖励。
领域 RL、多教师蒸馏与执行系统
- 领域:通用任务、通用 Agent、Code Agent。
- 预算:每域分别训练
low / high / max,共9个策略;它们是整模型教师,不是 MoE 层内专家。 - 控制长度:以题目的基准预算为参照,超出指定比例时把任务奖励覆盖为
-1;先训练 max,再收紧预算。 - Partial Rollout:完成一部分轨迹后先更新,长轨迹暂停后续跑;同题响应收齐后再计算组内优化信号。
- 学生先生成自己的前缀,选择对应领域与 effort 的教师,获得逐 token 概率反馈。
- 优势:教师不只展示固定答案,还纠正学生真实会遇到的输出状态。
- 信号:教师与学生的 log 概率比经 stop-gradient 和 clip 后参与优化;限制极端反馈造成的更新。
- QAT:路由专家权重使用 MXFP4,其他关键模块保留较高精度;训练与 rollout 的量化设置保持一致。
- 缓存:KDA 状态与 MLA cache 在相同边界保存、卸载与预取;只命中其中一种仍不能直接续算。
- AgentENV:microVM 支持快照、暂停、恢复和 fork;奖励检查在副本执行,避免改动原任务状态。
- 任务构建:可组合 Harness、知识图谱引导合成、可验证搜索、Kernel 优化与长期助理任务。
实验设置(Kimi K3,预训练 + 9 教师 RL)
基础模型
2.78T总参数,104.2B激活;1M上下文。
训练任务与算法
- 文本、多模态预训练;SFT 后训练通用、通用 Agent、Code Agent 教师,再做 MOPD。
训练超参
- 预训练:cosine 日程,前
1%warmup,weight_decay=0.1;上下文8K → 64K。 - Cooldown:再扩到
256K → 1M,加入连贯长文、视频与跨距离合成任务。
评测任务与超参
- DeepSWE、Terminal-Bench、BrowseComp、OSWorld;Terminal 报告所测 Harness 中的最佳结果。
- 采样:
max effort, temperature=1.0;单步任务top_p=0.95,Agent 任务top_p=1.0。
关键结果(Kimi K3 + SFT/RL/MOPD)
Coding Agent
- DeepSWE v1.1 达
67.5,Terminal-Bench 2.1 达88.3。 - 仓库修改与终端执行同时有较强表现,覆盖多类实际工具任务。
搜索与 GUI
- BrowseComp 达
91.2;OSWorld 2.0 为58.3。 - GUI 中仍有较多失败任务,长程操作能力需要继续加强。
上下文管理仍有收益
- BrowseComp:
300K触发压缩得91.2,直接使用1M窗口为90.4。 - 更长窗口扩大可见信息,压缩策略则减少无关历史,两者作用不同。
架构与训练共同优化
- 论文拟合约
2.5 倍scaling 效率提升,来自架构、数据和训练配方共同变化。 - 从头训练视觉编码器在对照中更稳定,评测效果相当。
未来方向
- 复杂 GUI:提高页面状态理解与连续操作的成功率。
- 研究级任务:加强困难推理、验证和失败后的策略调整。
- 持续执行:减少长任务中的目标偏移、无效重复和执行纪律问题。
(2606) Kimi K2.7 Code (Thinking-only、256K)
核心内容
- 基于 K2.6 强化代码任务,采用
Thinking-only + 256K,保留多轮思考与工具历史。 - 原生 INT4 部署;在统一 Kimi Code CLI 下评测仓库与程序任务。
详细笔记
(2602) Kimi K2.5 (原生多模态、Zero-Vision SFT、PARL)
🌺 论文摘要
参考链接
问题背景
- 后期接入视觉容易冲击语言能力;手工视觉推理轨迹覆盖有限,难以泛化到复杂工具操作。
- 单 Agent 串行搜索与执行,任务越复杂,耗时与历史上下文越长。
核心方法
- 原生多模态预训练:K2 主干继续训练
15T图文 tokens;MoonViT-3D 共享图像、视频编码。 - SFT 与联合 RL:纯文本 SFT 激活视觉工具调用;图文按能力领域联合 RL,Toggle 交替优化质量与长度。
- Agent Swarm / PARL:冻结 Subagent,仅用 RL 训练 Orchestrator;学习任务拆分、并行调度与结果汇总。
- 训练系统:DEP 解耦视觉编码器与主干;统一 Agent 环境支持递归、异步和 Partial Rollout。
模型效果(Kimi K2.5 + SFT/RL)
- Coding:SWE-bench Verified
76.8,Terminal-Bench 2.050.8,LiveCodeBench v685.0。 - Agent Swarm:BrowseComp
60.6→78.4;WideSearch Item-F172.7→79.0。 - 执行效率:WideSearch 达到相同目标分数,Swarm 耗时缩短
3~4.5倍。
重要结论
- 跨模态迁移:视觉 RL 后,纯文本 GPQA-Diamond
84.3→86.4;视觉训练也能增强文本推理。 - 并行化与上下文管理协同:子任务独立保留历史,只回传结果,减少主 Agent 的上下文负担。
核心贡献
- 给出图文联合训练与可学习并行调度路线,公开 Kimi K2.5 后训练模型。
未来方向
- 继续结合图文智能与 Agent Swarm,扩展可部署的通用 Agent 系统。
问题背景
视觉训练容易形成能力割裂
- 晚期大量加入视觉数据,语言表示需要重新适配,文本能力先下降再恢复。
- 手工视觉 CoT 常局限于简单图形、裁剪和旋转,难以覆盖通用程序化视觉操作。
长任务执行成本持续增长
- 串行 Agent 逐步搜索、调用工具,宽搜索和多分支任务受执行时间与上下文限制。
- 固定长度奖励又容易让模型只适应短推理,增加预算时无法充分利用计算。
核心方法
原生多模态预训练
共享图像、视频编码
- 主干:Kimi K2 MoE,
1.04T总参数、32B激活参数;接入 MoonViT-3D 与 MLP Projector。 - 原生分辨率:沿用 NaViT Patch Packing,不同尺寸图片直接编码并打包训练。
- 视频编码:连续最多
4帧共同参与时空 Attention,随后按 Patch 做时间池化。 - 时间压缩:视觉 tokens 压缩
4倍,图像与视频完全共享编码器参数。
三阶段训练
- ViT 训练:从 SigLIP 初始化,用 Caption Cross-Entropy 对齐 Moonlight-16B-A3B;更新视觉编码器。
- 随后冻结 ViT 与语言主干,仅短暂训练 Projector,完成与 K2 主干的接入。
- 联合预训练:从接近训练完成的 K2 Checkpoint 出发,持续混合图文,增加 Code 数据权重。
- MidTrain:混入高质量数据、长文本、长视频与长 CoT,通过 YaRN 扩展上下文。
代码与视觉结构对齐
- Code:增加仓库级代码、Issue、Code Review、Commit 历史和技术文档,覆盖真实开发过程。
- 图像—代码对:HTML、React、SVG 与渲染截图配对,建立代码结构与视觉布局的对应。
- GUI:收集桌面、移动端、网页的截图与动作轨迹,加入人工演示。
多模态知识与感知
- 图文交错:书籍、网页、教程;OCR 覆盖多语言、密集版式与多页文档。
- STEM:定向检索学术材料;无显式问答的内容,通过 In-Context Learning 转成结构化题目。
- 视觉感知:加入框、点、轮廓分割标注;视频覆盖长视频理解与细粒度时空感知。
- 质量控制:过滤、去重、质量校验;限制合成 Caption 比例,减少幻觉污染。
SFT 与多模态联合 RL
纯文本激活视觉工具调用
- SFT 数据:由 K2、K2-Thinking 和内部领域专家生成候选,结合人工标注与多阶段验证。
- Zero-Vision SFT:冷启动阶段只使用文本 SFT 数据,学习推理、IPython 和精确工具调用。
- 能力迁移:联合预训练已建立图文对齐;文本中学到的程序操作迁移到视觉任务。
- 视觉操作:通过 IPython 实现二值化、像素计数、目标定位等,不限制为固定裁剪工具。
视觉 RL 与领域专家
- 任务选择:目标定位与计数、图表文档、必须依赖图片才能解答的 STEM 题。
- 过程迭代:先用结果奖励训练视觉能力,筛选成功轨迹做 RFT,再进入后续联合 RL。
- 领域划分:按知识、推理、Coding、Agent 能力组织专家,同一专家混合学习文本与视觉任务。
- 任务奖励:定位用软匹配 F1,分割用 IoU,OCR 用归一化编辑距离,计数按数量误差评分。
- GRM:补充可用性、相关性、产物美观与指令遵循;采用多套 Rubric,减少单一偏好过拟合。
Token 级策略更新
- 同题采样多条回答,以
Reward − 组内平均 Reward计算 Advantage。 - Log-Ratio:对“当前策略概率 / 采样策略概率”取对数,衡量 Token 级策略偏离。
- Log-Ratio 超出阈值时屏蔽该 Token 的 Policy Gradient,不依赖 Advantage 正负决定是否屏蔽。
- 加入平方 Log-Ratio 惩罚,按 Batch 总生成 tokens 归一化,使用 MuonClip 更新参数。
交替优化长度与解题质量
- 固定短预算的风险:模型过拟合短推理,即使允许更多 tokens,也难以继续提高质量。
- 预算阶段:同题平均正确率达到阈值后,超出该题预算的回答不保留任务奖励。
- 扩展阶段:取消上述长度约束,允许模型在最大输出长度内探索更完整的解法。
- 每
m轮交替;每题预算取训练初始正确回答长度的指定分位数,随后固定。
Agent Swarm 与 PARL
Orchestrator 与 Subagent 分工
- Orchestrator:创建角色、分配任务、汇总结果;拥有
create_subagent和assign_task工具。 - Subagent:从固定中间 Checkpoint 实例化,独立执行任务;训练期间冻结参数。
- RL 更新:只优化 Orchestrator,Subagent 轨迹不参与 Loss,返回值作为环境观测。
- 先用小 Subagent 训练,再切换大模型,减少调度策略探索成本。
训练任务构建
- 宽搜索:大量独立信息源;深搜索:多条推理分支,最后统一汇总。
- 加入长文档分析、批量下载等任务,使串行执行难以在步数预算内完成。
- Prompt 不直接要求并行,由任务分布与 RL 反馈驱动模型学习何时拆分。
抑制串行退化与无效并行
- 任务奖励:最终答案或产物的正确性、质量。
- 创建奖励:鼓励尝试 Subagent,避免始终退化成单 Agent。
- 完成奖励:检查子任务是否完成,抑制大量创建 Agent 却不做有效分工。
- 蓝色两项辅助奖励的权重逐渐退火到
0,最终优化任务本身。
按最长分支约束执行成本
- 每个阶段成本为主 Agent 步数,加上该组并行 Subagent 的最长执行分支。
- 训练与评测使用
Critical Steps约束,鼓励减少最长等待时间,而非单纯增加 Agent 数量。 - 子任务各自维护上下文,仅向主 Agent 回传相关结果,实现主动的上下文分片。
多模态与 Agent 训练系统
- 负载不均:图片数量与分辨率变化,使 Pipeline 第一个 Stage 的算力、显存波动。
- 视觉前向:各 GPU 复制小型视觉编码器,按 Patch 数均衡工作;只保留最终视觉特征。
- 主干训练:将特征汇入 Stage-0,沿用 K2 的并行方案完成主干前反向。
- 视觉反向:收到视觉特征梯度后,重算编码器前向,再更新视觉参数。
交互与采样
- Agent Loop:组合 Toolset、Sandbox、Judge 与 Prompt 增强模块,环境使用 Gym 风格接口。
- Rollout Manager:独立异步任务可递归调用子任务,支持 Partial Rollout 与环境池复用。
- Inference:采用 Token-in / Token-out,记录生成 tokens 与 Logprob,供 Trainer 纠正采样偏差。
外部环境接入
- 标准 LLM API 环境通过 LLM Gateway 代理,保存完整采样请求与响应。
- 调度器按 Orchestrator / Subagent 负载调整推理实例比例,提高集群利用率。
实验设置(Kimi K2.5,预训练 + SFT/RL/PARL)
模型与数据规模
- 基础模型 Kimi K2;ViT 对齐约
1T tokens,联合图文预训练15T tokens。 - ViT 与联合预训练长度
4K;MidTrain 分别训练500B、200B tokens,长度32K→256K。 - 训练使用 H800 集群;
PP=16, EP=16, ZeRO-1,结合选择性重算与激活卸载。
算法对照
- 图文融合消融:固定图文总 Token 预算,对比从
0% / 50% / 80%进度接入视觉。 - 对应图文比例为
10:90 / 20:80 / 50:50,比较视觉、文本和代码能力。 - Toggle:在 K2-Thinking 上做预算控制实验,训练任务为数学与编程。
- PARL:冻结执行 Subagent;对比单 Agent、Discard-all 与 Agent Swarm。
通用与 Coding
- 默认
temperature=1.0, top_p=0.95, context=256K;复杂推理max_completion=96K。 - AIME / HMMT Feb 2025 使用
Avg@64,GPQA 使用Avg@8。 - SWE-bench:内部最小工具 Harness,包含 Bash、文件查看、编辑与提交;使用
non-thinking。 - Terminal-Bench 2.0:Terminus-2,使用
non-thinking;Coding 任务统一Avg@5。
多模态与 Agent
- 图像、视频评测
max_tokens=64K, Avg@3;长视频采样2048帧。 - 搜索使用 Search、Browser、Python;BrowseComp 分别测无管理、Discard-all、Swarm。
- Swarm 步数:BrowseComp 主 Agent / Subagent 为
15 / 100;WideSearch 为100 / 100。 - OSWorld / WebArena 仅 GUI 动作,最多
100步,上下文保留最近3张截图与完整思考历史。
关键结果(Kimi K2.5 + SFT/RL,Agent Swarm)
单 Agent 能力
- SWE-bench Verified:
76.8,高于表中 DeepSeek-V3.2 的73.1,仍低于 Claude Opus 4.5 的80.9。 - Terminal-Bench 2.0:
50.8;LiveCodeBench v6:85.0,覆盖终端任务与算法编程。 - HLE-Full:不用工具
30.1,使用工具50.2;搜索与代码执行显著增强复杂解题能力。
视觉与 GUI
- MathVision
84.2、OCRBench92.3,兼顾视觉推理与精确文本读取。 - LongVideoBench
79.8、LVBench75.9,共享视频编码支持长视频理解。 - OSWorld-Verified
63.3,高于 Qwen3-VL-235B-A22B 的38.1,接近 Opus 4.5 的66.3。
任务完成质量
- BrowseComp:无上下文管理
60.6,Discard-all74.9,Agent Swarm78.4。 - WideSearch:单 Agent Item-F1
72.7→79.0;内部 Swarm Bench:41.6→58.3。 - 宽搜索与独立子任务获益明显;主 Agent 保留整体目标,Subagent 分担搜索历史与局部推理。
相同目标分数下的执行效率
- WideSearch 目标 Item-F1 从
30%提高到70%,Swarm 相比串行执行加速3~4.5倍。 - 更高目标下,单 Agent 耗时继续增长;并行拆分缩短关键路径,减轻连续工具调用的等待。
图文能力可以相互增强
- 固定图文预算时,早期低比例融合优于后期高比例接入,且避免语言能力突然下降。
- 视觉 RL 前后:MMLU-Pro
84.7→86.4,GPQA84.3→86.4,LongBench v256.7→58.9。 - 纯文本 SFT 足以冷启动视觉工具使用;报告中的图文 SFT 对照反而降低视觉 Agent 泛化。
长度优化需要保留扩展阶段
- K2-Thinking 的 Toggle 实验中,平均输出 tokens 减少
25%~30%,效果基本保持。 - 仅用数学、编程训练,也能缩短 GPQA 与 MMLU-Pro 输出;预算策略可跨领域迁移。
未来方向
- 继续结合图文联合优化与并行 Agent 执行,扩展复杂、多模态的真实任务能力。
- 基于开放 Checkpoint,支持社区研究、改进和部署可扩展的通用 Agent 系统。
(2511) Kimi K2-Thinking (交错推理、INT4 QAT)
参考链接
交错推理与量化
- 面向需要反复搜索、执行和验证的长程任务,支持
256K上下文。 - 模型生成思考 → 调用工具 → 读取新观察 → 继续决策,根据反馈调整计划。
- 后训练对 MoE 权重做
INT4 weight-only QAT,适应低精度部署的量化误差。
运行策略
- 部分搜索评测隐藏接近窗口上限的旧工具输出,保留推理和任务线索。
- Heavy 模式采样
8条轨迹,再反思、聚合结果,使用额外的并行推理预算。
INT4 版本结果
- SWE-bench Verified:SWE-Agent 派生框架、
5次平均,得分71.3。 - AIME 2025:无工具、
96K思考预算、avg@32,得分94.5。 - 量化发布版本同时保持较强的推理和仓库交互能力;长程结果与历史管理、轨迹预算共同相关。
(2510) Kimi Linear (KDA、48B-A3B、有限状态记忆)
🌺 论文摘要
参考链接
问题背景
- 全局 attention 的 KV 成本随上下文增长;线性注意力压缩历史后容易丢失细节。
核心方法
- KDA:逐通道遗忘旧状态,使用 delta rule 修正当前 key 对应的记忆。
- 3:1 KDA/MLA:大部分层使用有限状态,少数全局层保留精确历史访问。
- Chunkwise 计算:块内并行、块间递推,提高 GPU 执行效率。
模型效果(48B-A3B,同训练量对照)
- 相对纯 MLA,MMLU-Pro
47.2 → 51.0,128K RULER81.3 → 84.3。
重要结论
- 线性层比例需要平衡;增加到
15:1后,验证 PPL 反而劣于3:1。
核心贡献
- 提供具有细粒度记忆控制的 KDA,并验证混合架构的能力与效率。
未来方向
- 提升复杂长文推理能力,进一步研究有限状态与全局访问的分工。
问题背景
- 长序列 Attention 的 KV Cache 与计算成本持续增长,线性注意力的固定状态又容易损失精细历史信息。
- Kimi Linear 用通道级记忆更新与少量全局 Attention 兼顾效率和表达能力。
核心方法
KDA 混合注意力
选择性保留
- 用逐通道 gate 控制旧状态的衰减,分别决定不同记忆维度保留多少。
误差修正
- 当前 key 从状态读出预测 value,再按预测与目标 value 的差异更新状态。
- 只修正当前关联,减少反复写入相似信息造成的干扰。
- 简化算例:旧状态
2,遗忘后为1;目标3、更新强度0.25,新值为1.5。
块内并行
- 将逐 token 递推改写成块内矩阵运算,块间只传递状态。
- 保持因果依赖,同时提高训练吞吐。
全局层补充
- 每
3层 KDA 配1层 MLA,周期性读取完整历史。 - KDA 降低持续记忆成本,MLA 补充难以压缩的精确信息。
- MLA 层去掉显式 RoPE,采用 NoPE;KDA 的递推顺序和遗忘机制已提供位置偏置。
- 全局层专注内容检索,减少超长上下文下对位置外推设置的依赖。
预训练与后训练
预训练与 SFT
- 预训练采用 MuonClip + WSD;SFT 先学习通用任务,再提高推理数据比例。
推理 RL
- 数学、代码与 STEM 任务采用可验证奖励,沿用 Kimi k1.5 训练路线。
- 并行保留预训练与 SFT 信号,减轻通用能力退化。
- Truncated IS 控制训推概率差异,动态 KL 与 minibatch 稳定策略更新。
实验设置(48B-A3B,KDA/MLA 对照)
基础模型与数据
- 受控对照:
48B-A3B,训练1.4T tokens,比较 Kimi Linear、纯 MLA 与 GDN-H。 - 发布 checkpoint 训练至
5.7T tokens。
训练超参
lr=1.1e-3, batch=32M tokens, seq_len=4096,MuonClip + WSD。
评测与消融
- 通用知识、推理、长上下文:MMLU-Pro、RULER、LongBench v2 等。
- 对比不同 KDA/MLA 比例,并测量长上下文的 KV 占用与解码速度。
关键结果(Kimi Linear,1.4T 对照与推理效率)
同预算能力
- Base 对照:MMLU-Pro
47.2 → 51.0。 - 长上下文阶段的 128K RULER:
81.3 → 84.3。 - 混合架构降低历史成本的同时,保留了较强的知识与长上下文能力。
混合比例
- 验证 PPL:
3:1为5.65,纯 MLA5.77,15:1为5.82。 - 保留适量全局层更有效,不能单靠增加线性层获得更好的能力。
- KV 最多减少约
75%;在1M上下文、batch=1 下,解码约快2.2–2.3 倍。 - 更小的 KV 允许增大 batch,最大吞吐收益约
6.3 倍。 - 单请求加速和增大并发共同贡献整体吞吐收益。
未来方向
- 复杂长文任务:LongBench v2 等项目仍有提升空间。
- 混合比例:进一步平衡有限状态压缩与精确历史检索。
(2509) Kimi-Dev (Code CPT、SFT、Code-Edit RL)
核心内容
- 以 Qwen2.5-72B 为基础,代码 CPT、推理 SFT 与 Code-Edit RL 逐步强化仓库修复。
- 以课程学习和执行反馈训练修改能力,再用 Agent 轨迹 SFT 适配工具交互。
详细笔记
(2507) Kimi K2: Open Agentic Intelligence
- K2
❓问题背景
- 高质量预训练数据越来越少,需要提高学习效率 (RL自己探索)
- 后训练复杂:如何将预训练和知识转换为agent行为是一个挑战
📕核心方法
1. 模型架构
- MoE结构
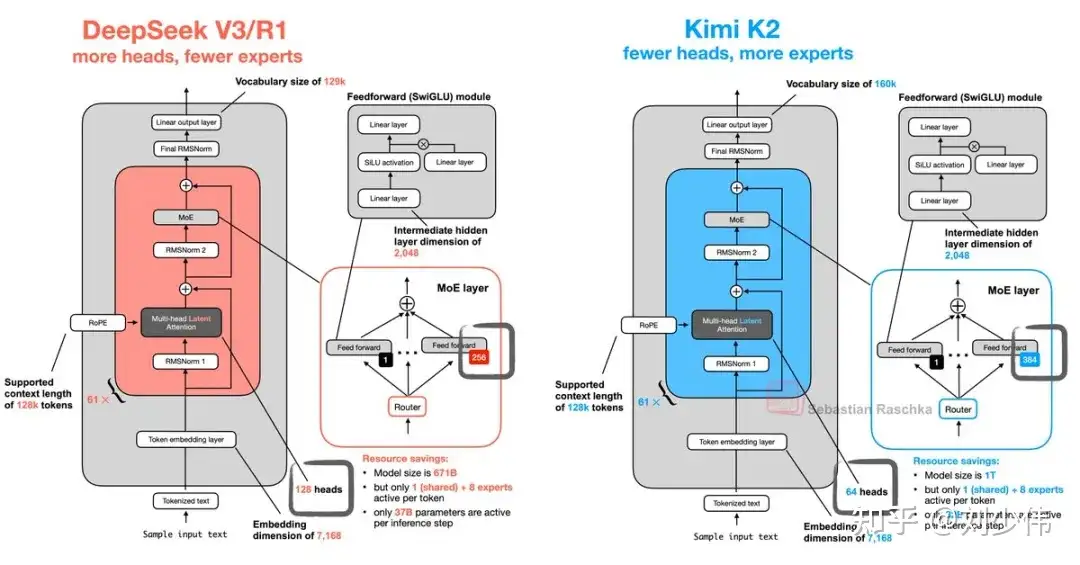
384个专家,每个token激活8个,激活参数32B,总参数1T高度稀疏设计,有性能且兼顾优化效率
- Multi-Head Latent Attention
- 压缩KV来提高效率,减少计算量和带宽压力
- 每层注意力头降至
64- 节省
83%FLOPS,降低推理资源消耗,更好处理长上下文
- 节省
2. MuonClip 优化器
Muon优化器- 目的:在相同计算资源和参数的条件下,尽可能多的学到信息。
- 优点:token效率高 ⭐
- 缺点:
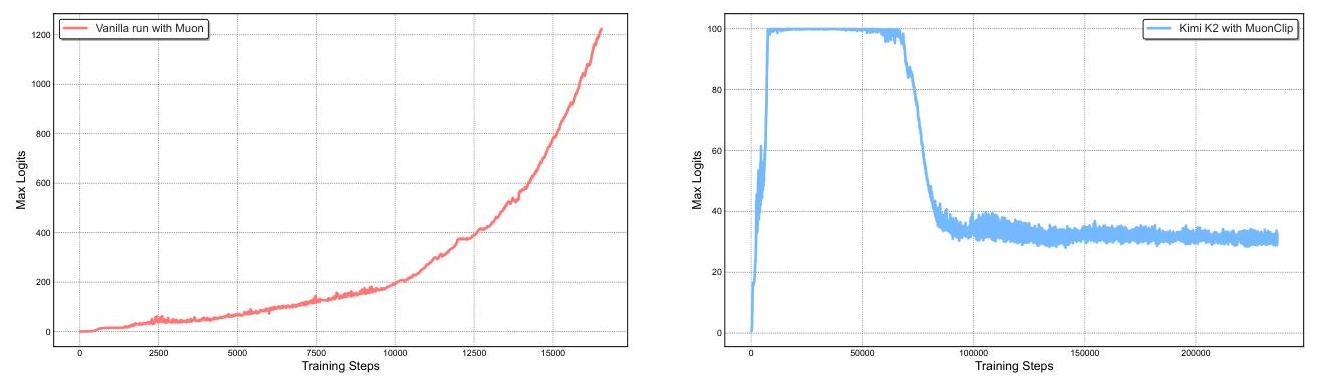
- 训练不稳定,容易出现
注意力logits爆炸现象😓- 经常到1000+,导致
loss spike(loss异常高)
- 经常到1000+,导致
- 本质是Query和Key的权
增长过快导致的。
- 训练不稳定,容易出现
QK-Clip- 核心
- 实时监控每个头的最大logit是否超过阈值
(论文是100) 按比例轻量化缩小超过阈值注意力头的权重⭐ ( query和key的权重矩阵)- 最小化per-head干预:只对超过的头采取,只有1小部分注意力头会爆炸💥
- 实时监控每个头的最大logit是否超过阈值
- 优点:解决了
注意力logits爆炸问题
- 核心
- 整体效果🔑
- 预训练数据
15.5Ttokens, 实现零loss spike,对收敛几乎无损(<0.1%) 👍
- 预训练数据


背景
- 15.5T Token有限,希望提高
token 效率,尽可能挖掘出更多信息供模型学习
🍎核心思想
- 基于
高质量数据做数据合成- 放大高质数据的价值
- 提高模型的令牌效用
token utility, 即模型从token中学到的知识量
- 需要避免过拟合风险‼️
🐱知识数据改写技术
- 背景:
知识密集型数据简单重复训练,会导致过拟合 - 步骤
多样化改写prompt:风格+视角多样化长文本分块改写:长文本切分成带上下文的小块,逐块改写再做合并 (chunk-wise 自回归改写)忠诚度校验(Fidelity verification):原文对比做质量控制,防止学到错误信息‼️
- 效果
- SimpleQA验证
- 原始数据训10次: 23.76%;1次改写训10次:27.39%;10次改写训1次:
28.94%💡
- 原始数据训10次: 23.76%;1次改写训10次:27.39%;10次改写训1次:
- SimpleQA验证
😻数学数据改写技术
- 背景:为增强
数学推理能力,对数学文档做改写 - 步骤:
- 转换成学习笔记风格:SwallowMath
- 多语言翻译:其他语言翻译成英语
背景
- 由于
成本/复杂/隐私等原因,agent交互很难在真实世界去做scale - 为agentic能力,构建
高质量合成数据模拟真实交互,来教模型遵循指令、使用工具。- 合成数据有潜力:ZeroSearch/ACEBench等。
核心思想
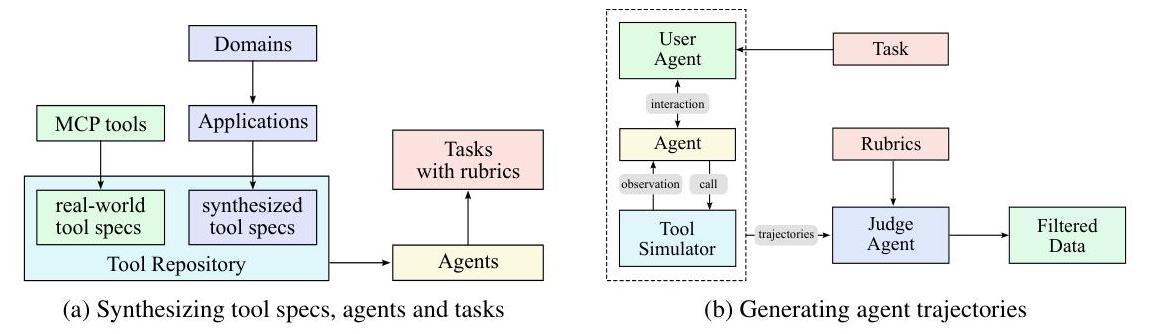
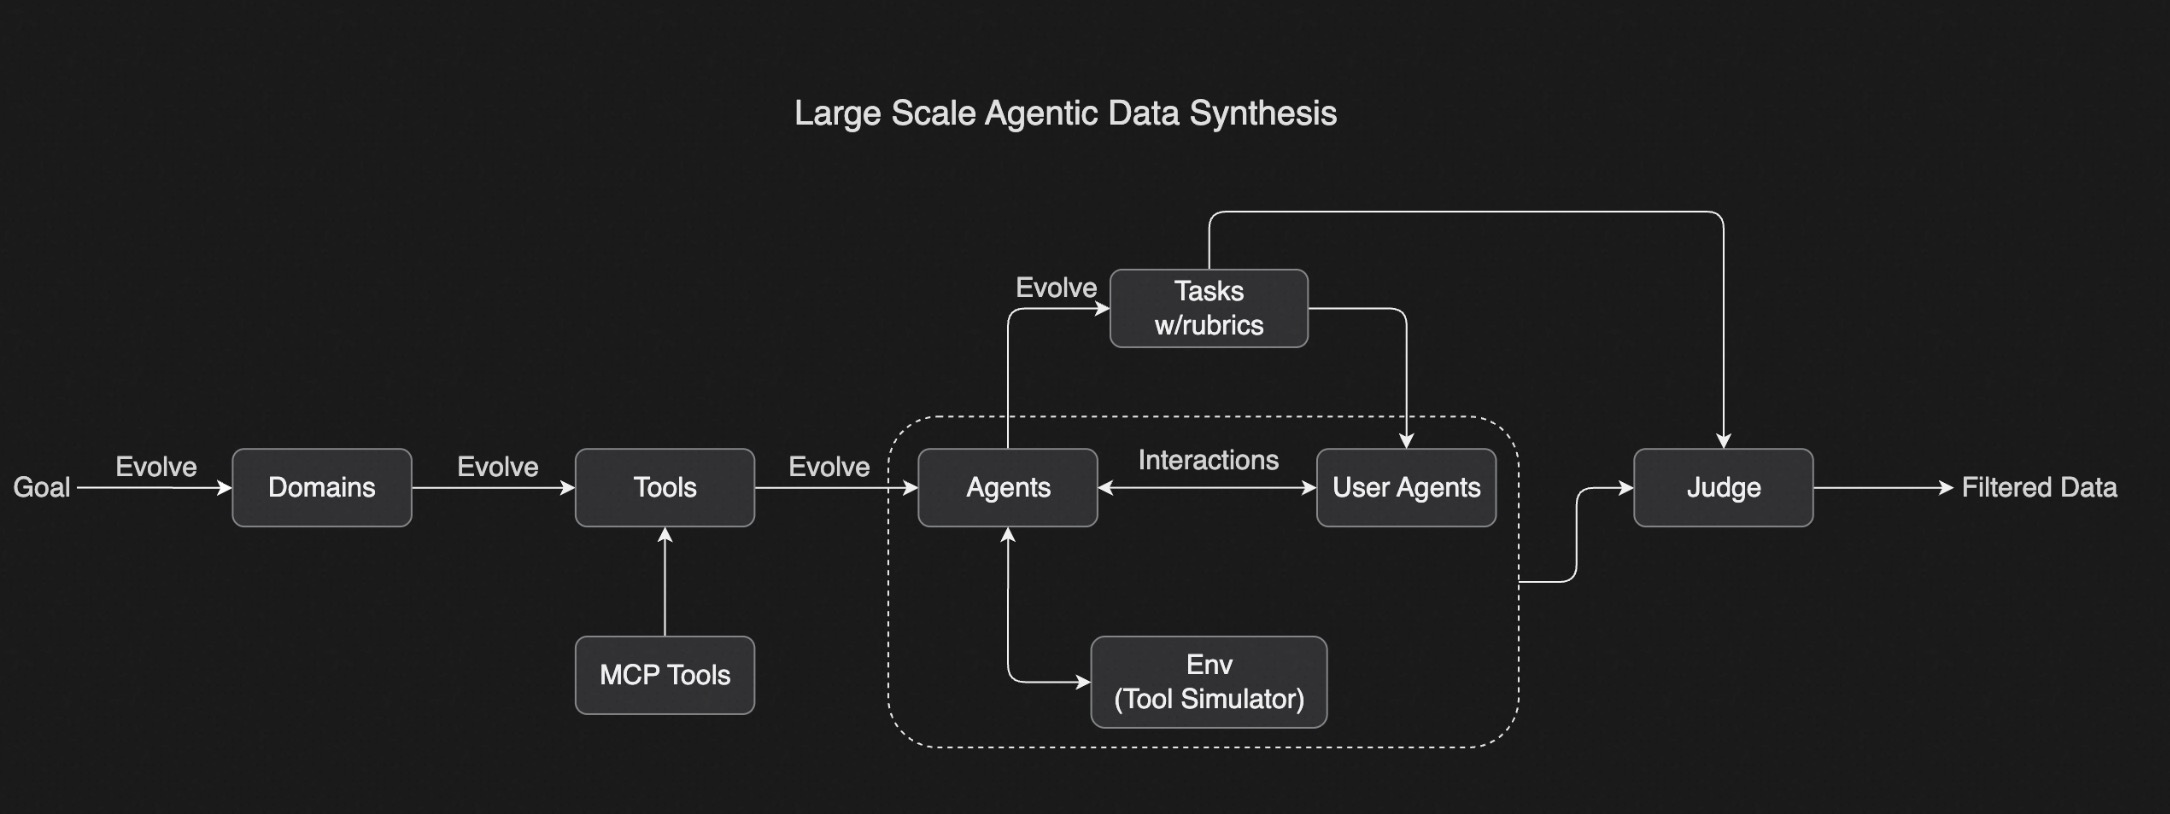
- 构建大型工具库,生成agent交互轨迹,通过拒绝采样做质量过滤,通过真实沙盒执行。
🛠️工具库构建
真实工具
3000真实MCP工具(从github抓取)- 缺点:分布不均衡‼️,网页开发等热门领域多,其他如机器人控制/生物等领域少。
合成工具
20000个合成工具,每个都有清晰的接口、描述和操作语义。层次合成策略:从大领域逐渐细分到子领域做合成,领域多样性非常好。
🤖Agent和任务构建
- Agent构建
1000+agent,覆盖多个领域- 不同的System Prompt(合成) + 不同工具组合
- 任务构建
Rubric-based‼️- 为每个Agent从简单到难构建多个任务
- 每个任务都有明确的评估标准⭐
怎样才算成功?应该用什么工具、顺序是什么?关键评估点是什么?
📚多轮轨迹数据采集
- 采集
- 用户:LLM扮演不同风格的用户,向agent提出问题、多轮交互;
- 模拟环境:
复杂的工具模拟器(类似世界模型),具体是啥❓- 执行工具调用,返回结果
- 有记忆
有状态:工具执行后会更新状态;有助于:持续影响的复杂多步交互推理 - 引入可控随机性:成功、部分失败、特殊情况。
- 过滤
LLM-as-Judge:只留下满足task-rubric的轨迹
🗺️混合环境(模拟+真实)
- 模拟:复杂工具模拟器;模拟多样性。
- 真实:代码、软件等;真实性验证。


背景
- RL具有更好的token效率和泛化性。
- 难在如何平衡客观事实和主观偏好,在
可评估和不可评估任务上进行RL学习
核心思想
- 统一可扩展的混合奖励框架
可验证的Rewards Gym
- 处理具有明确对错、客观可验证的任务:数学、编程、STEMP(科学/技术)、推理等。
- 五大场景
- 数学、STEM、逻辑任务:多样性、难度适中。
- 复杂指令遵循
- 混合验证:硬规定(规则) + 软规定(AI验证) + 防作弊机制
- 数据生成:AI生成 + AI抬杠出题(专属模型,攻击k2短板)
- 忠实性
- Code
- 安全性
自我批判的奖励(Self-Critic Rubric Reward)
- 背景:处理没有唯一正确答案、依赖主观偏好的任务,写作、对话、总结等。
- 核心思想:让模型学会自我评价,分为actor和critic
- 步骤
- Actor:生成多个回答;Critic:依据评分准则做两两比较打分,产生偏好;Actor根据偏好调整策略。
- 防止Critic跑偏
- Critic定期在可验证任务上进行校准,确保客观正确;使得主观任务能受益于客观任务。
RL 算法增强
- 预算控制:对长回答做乘法,提高推理性价比
- PTX loss:在RL训练中混入高质量SFT数据,防止灾难性遗忘
- 温度衰减:初期:高创造探索;后期:高质量稳定输出。
✍️实验设置
🍑关键结果
⛳未来方向
(2506) Kimi-Researcher: End-to-End RL Training for Emerging Agentic Capabilities
❓问题背景
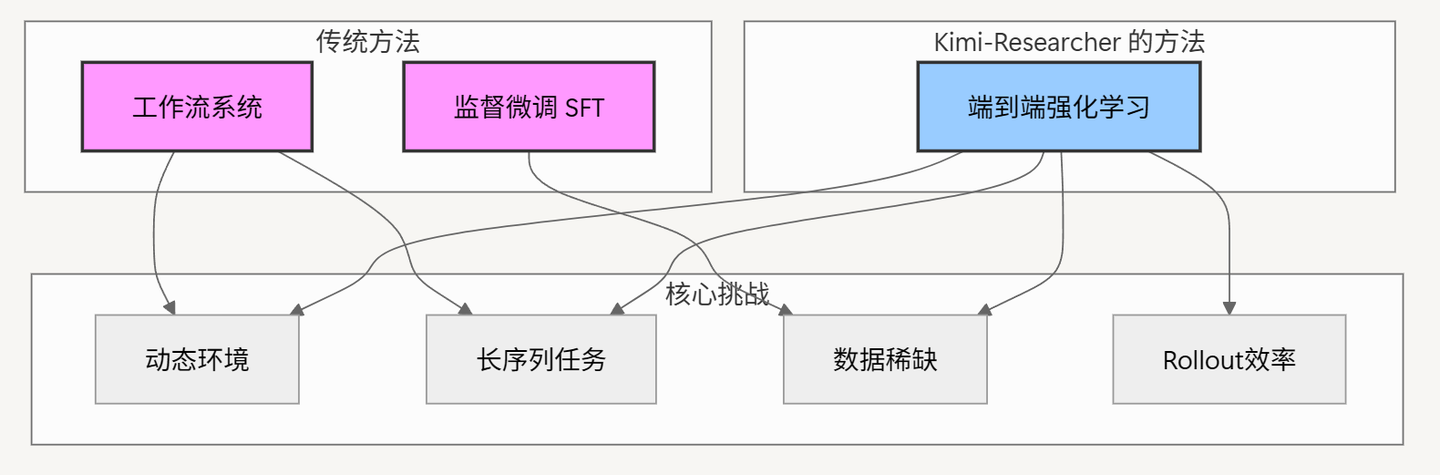
- 当前agent开发存在问题
- workflow方法:依赖人工设计和Prompt来,难以扩展适应动态环境。
- SFT方法:成本高、泛化弱。
- 端到端RL的挑战
- 适应动态环境:真实环境是变化的,agent需在变化环境保持稳定泛化
- 长序列任务:单任务可能超过70次搜索,上下文达10w token,需具备优秀记忆和长上下文能力
- 数据稀缺:agent问答高质量RL数据非常少,人工成本高,难以满足大规模训练
- Rollout效率慢:多轮推理和频繁工具调用,显著拖慢训练速度,成为瓶颈

📕核心方法
在Data、RL算法、上下文管理和Infra四个方面进行创新。
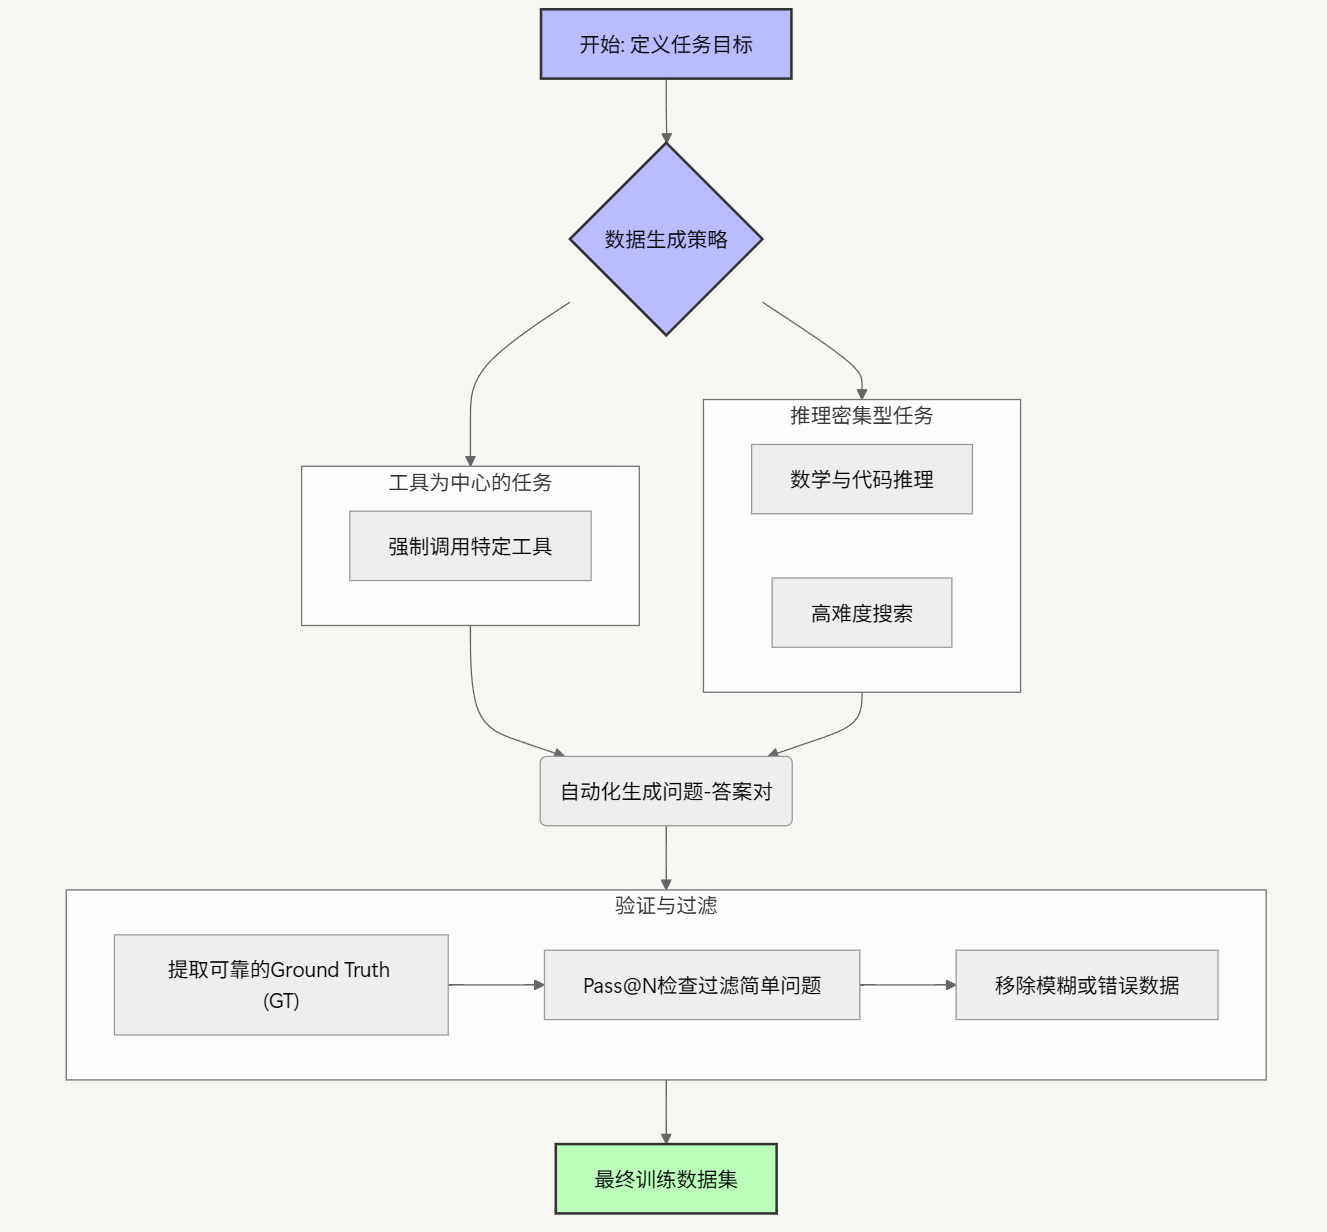
- 目的:解决数据稀疏问题。
- 核心:全自动数据生成及验证pipeline,保证规模、多样性及正确性。
- tool中心任务:
- 强调
必须使用工具才能解决问题 - 旨在训练agent学习 何时、有效协同使用工具。
- 强调
- 推理密集型任务:
- 数学代码:利用估计解决逻辑推理和算法问题
- 高难度搜索:上下文约束下进行迭代式搜索、信息综合和推理

Reinforce算法+关键策略来保证训练稳定性
- 严格的on-policy训练:
- 负样本控制:负样本降低模型输出概率可能导致熵崩溃,策略丢弃部分负样本,使模型能在长周期训练。
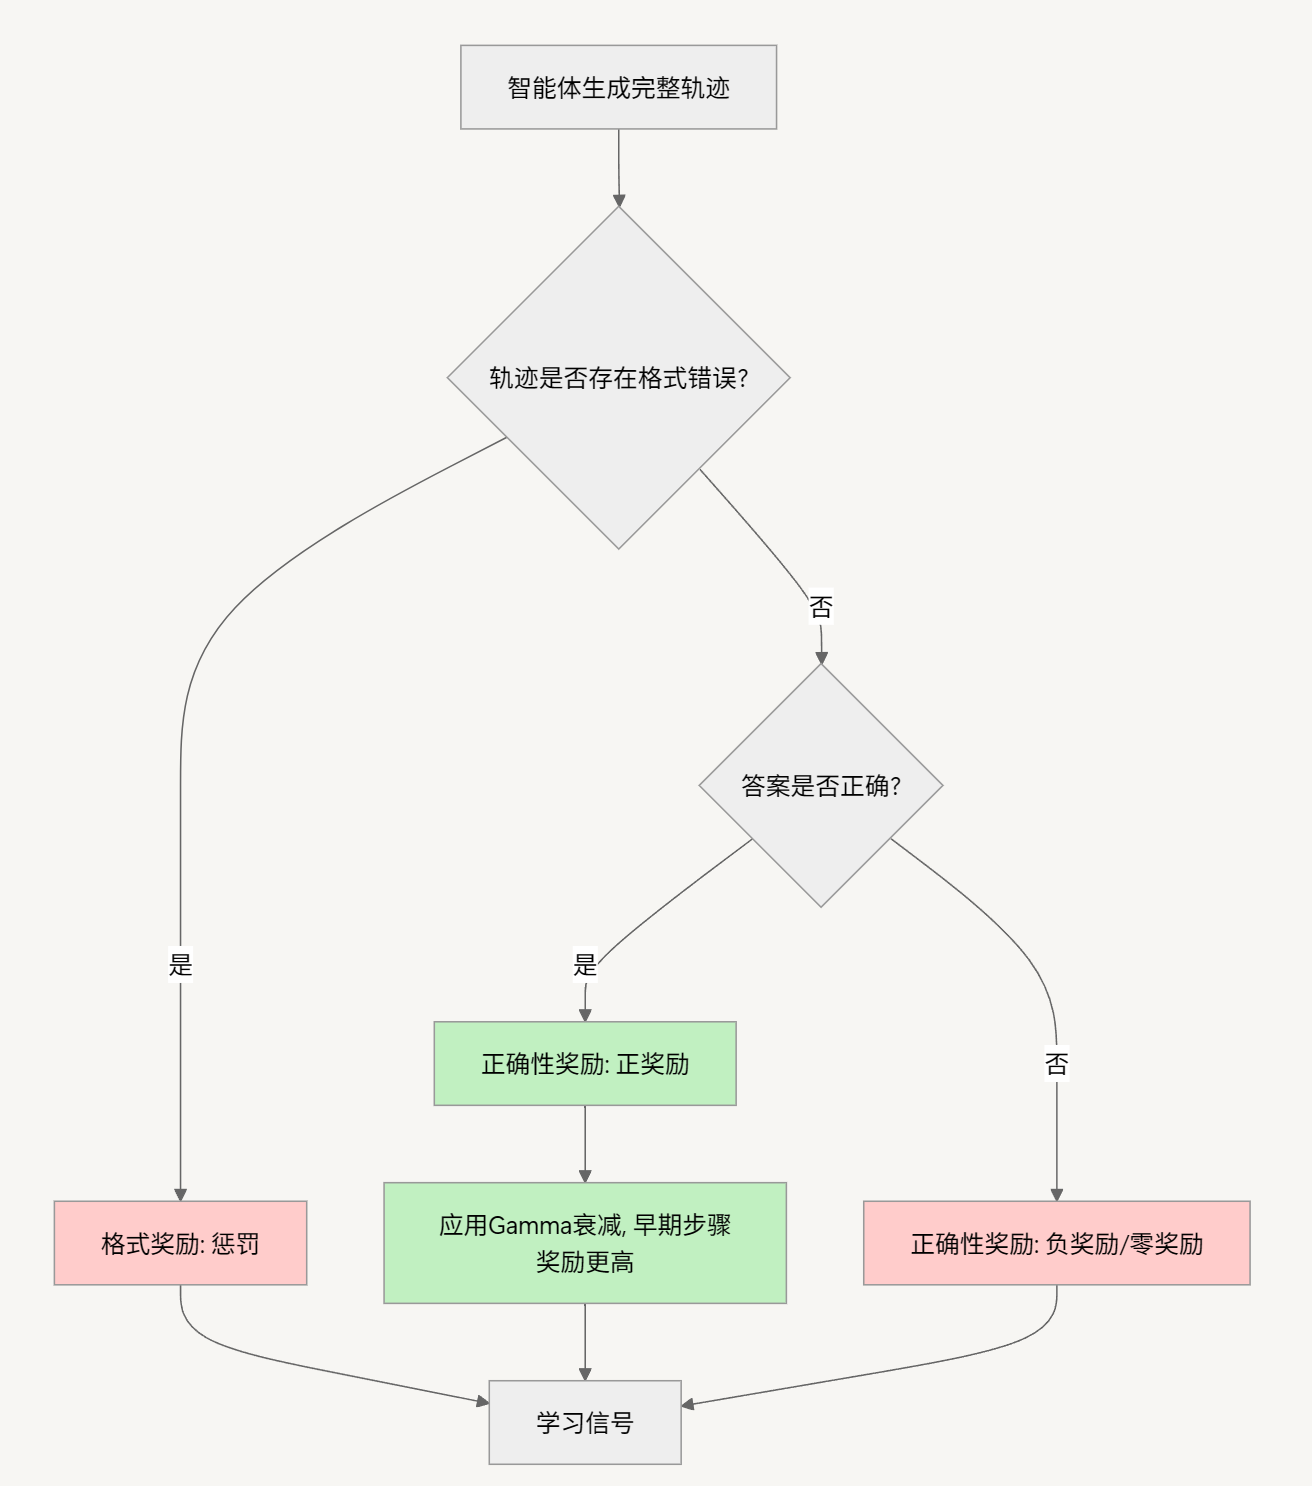
- 结果导向的奖励机制:格式奖励+正确性奖励。
- 效率激励:使用奖励衰减因子
,鼓励模型探索短且高效的路径。

- 背景:若无有效管理,一般10次agent迭代就可能超出上下文限制。
- 上下文管理机制:允许模型保留关键信息、丢弃不必要的稳定。
- 效果:单个rollout能扩展到50次迭代,模型迭代次数增加30%,能获取更多信息并提高性能。
解决RL训练中的效率和稳定性难题
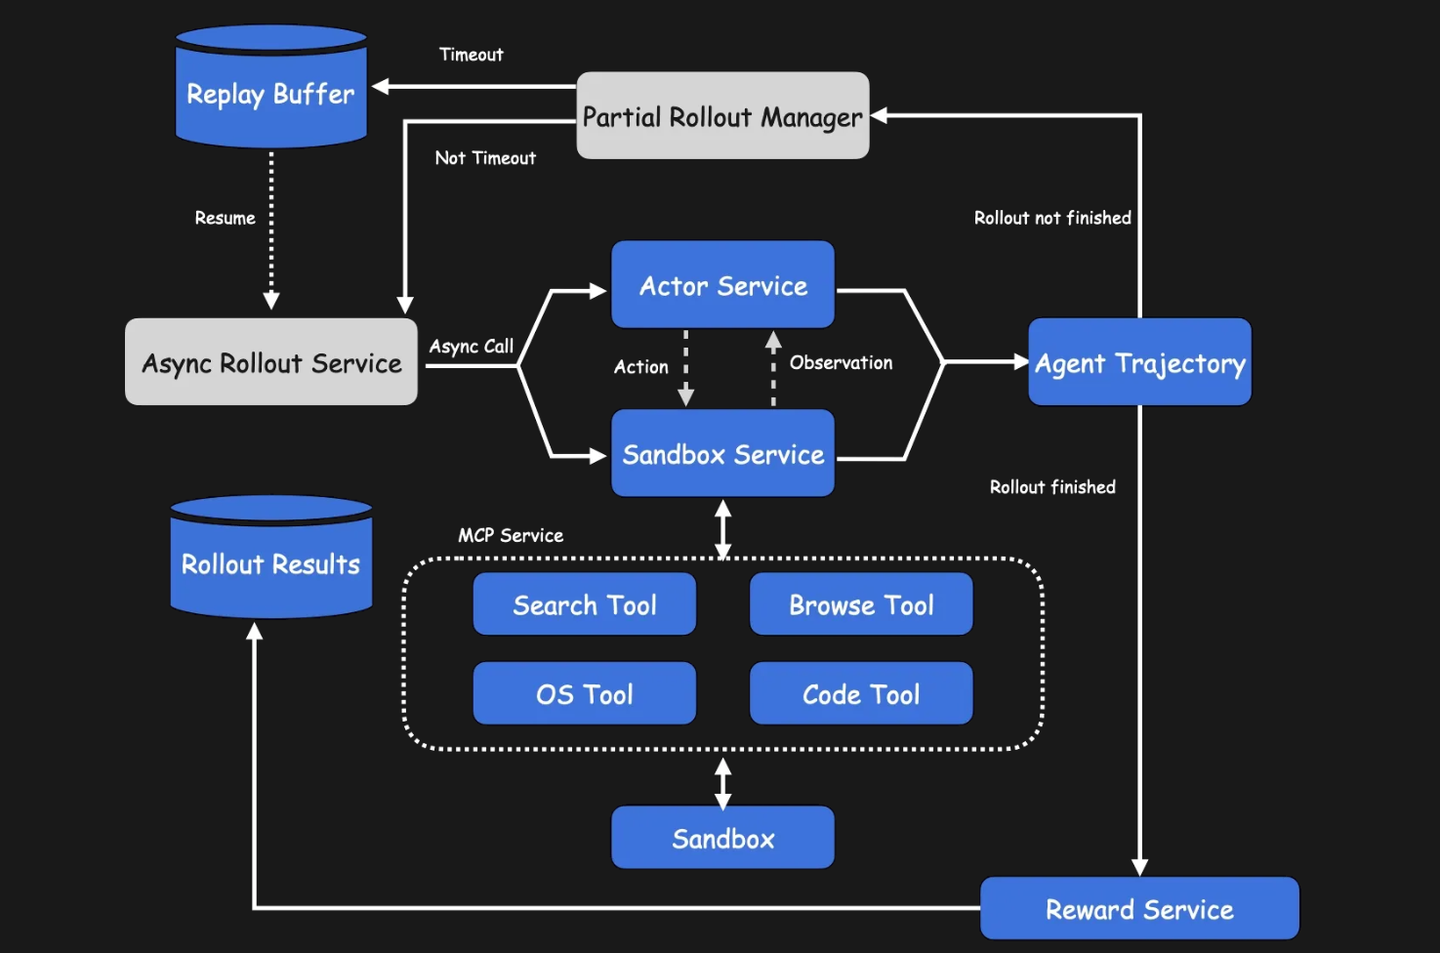
- 🚀全异步rollout
- 采用
服务器架构,并行调度rollout、环境交互和奖励计算; - 消除资源等待,效率远超同步系统🐮。
- 采用
- 回合级部分rollout
- 针对少数大量回合的长尾任务,设计部分rollout机制:超出时间放入缓冲区,后续迭代中使用新模型权重执行剩余的回合。
- 带来至少1.5倍rollout加速
- 鲁棒的沙盒环境
- 保证隔离型、消除容器间开销,基于kubernetes混合云架构,高可用和容错性。

✍️实验设置
🍑关键结果
- Kimi-Researcher
通过端到端RL学习涌现出高级agent能力。2个case- 🐮处理信息冲突和自我修正:多个信息源冲突时,迭代假设、自我验证来解决不一致性问题。
- 审慎严谨的交叉验证:简单问题也很严谨,主动额外搜索和交叉验证,而非轻率回答。
- 证明端到端agent-rl是一条路,涌现出复杂推理修正能力。
⛳未来方向
- 更多工具和领域扩展能力
- 优化底层RL技术设施和算法
(2501) Kimi k1.5(多模态推理): Scaling Reinforcement Learning with LLMs
- RL Prompt数据构建标准;通用预训练、通用SFT、LongCot SFT、RL训练这 四阶段预训练方法。
- PartialRollouts长上下文扩展技术, 改进的策略优化方法,long2short方法,简洁的infra。
❓问题背景
- 传统预训练方法(
NTP, Scaling Law) :受限于高质量预训练数据数量,难以进一步提升。⚠️ - RL方法:能通过
环境交互和奖励信号来生成自己的训练数据,摆脱静态数据依赖。 - 但之前的RL工作缺乏各基准都顶级的LLM,如何设计有效且可扩展的RL仍是一个挑战。
📕核心方法
- 质量和多样性对RL有效性很重要,能降低reward hacking和肤浅模式过拟合的风险。
- 🔑三大黄金标准
- 广泛覆盖:防止模型偏科,确保广泛适用性。如
STEM(科学/技术/工程/数学)、代码和通用推理等。 - 难度均衡:循序渐进,防止模型畏难或自满,避免对特定复杂问题过拟合。 覆盖
简单、中等、困难。 - ⭐准确的评估(最关键):需要
客观可靠的评估,需要真正理解而非蒙对获得奖励,避免作弊RewardHacking。
- 广泛覆盖:防止模型偏科,确保广泛适用性。如
- 🐮难度均衡妙招:模型自行判断
- 让模型自己去判断难易程度,同一个问题做10次,看它能做对几次。
- 🐯成功率低的是难题,高的是简单题。
- 🐼Reward Hacking应对方法
- 定义:模型找到获得奖励的捷径,但这捷径并不是真正学会了技能。
- 背景:数学题猜测也可能作弊,比如1。
- 方法:
- 💥去掉选择、判断等容易蒙对的题型,强制生成式回答。
- 🌟识别去掉模型易于破解的题目。不思考盲猜8次,如果都能猜对则去掉。
四阶段预训练方法
🐶阶段1:预训练
- 目的:让模型掌握世界知识、语言规律、图文关联能力。
- 方法:在巨大高质量多模态语料库上训练,
- 数据规模:
- 文本:覆盖英语/中文/代码/数学推理/知识等多领域。
- 多模态:Captin/图文混合/OCR/知识/QA等数据,让模型理解图像。
- 训练阶段
- Vision-Language预训练:vision tower在独立训练后逐渐和LLM集成
- Cooldown阶段:使用高质量精选和合成数据增强推理能力
- Long-Context激活阶段:上下文从4k逐步扩展至128k
🐱阶段2:通用任务微调
目的:预训练模型学会指令遵循。
数据规模
- 100w文本数据(50wQA/20w代码/20w数学科学/5k创意写作/2w长文本),
- 100w图文数据(图表/QA/对话/编码/推理等)。
数据方法
- 非推理任务(问答写作等):人工种子数据集->训练种子模型->收集提示->每个提示生成多个回答->人工答案排序->最好答案精修
- 推理任务(数学代码等):基于rule+奖励模型,利用拒绝采样来构建数据。
🐸 阶段3:LongCot微调
- 数据构建:
- 基于RLPrompt集合利用PE工程构建一个小、高质量、针对文本和图像的的warmup数据集。
- 数据包含人类认知,如规划、评估、反思、探索等。
- 轻量微调:使用数据集做轻量SFT。
- 效果:生成详尽、逻辑更连贯、推理任务效果提升等。
🐻阶段4:RL强化学习(最核心内容) ⭐
🔑1、长上下文扩展(重点)
- RL上下文扩展至128k,更长上下文能考虑更多,提升推理准确性和深度。
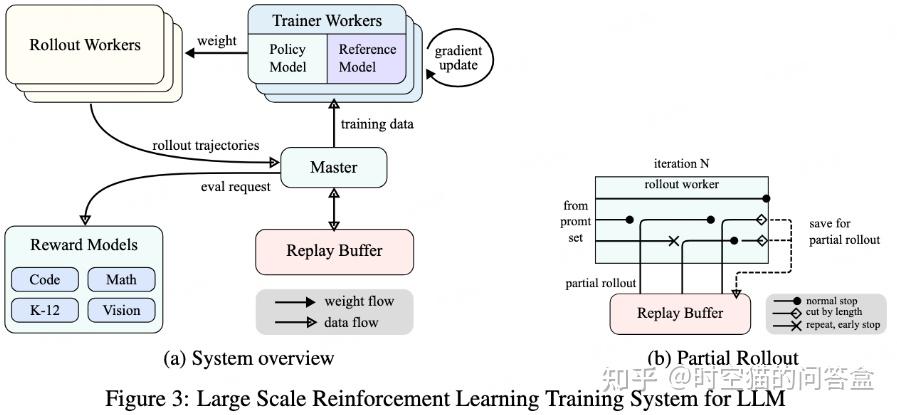
- 🐯Partial Rollouts 解决计算成本问题👍
- 思想:把长轨迹生成分割成多个迭代步骤,避免一次性生成整个轨迹,提高训练效率和节省资源
- 固定输出rollout tokens预算(如500),每次只生成部分轨迹
- 把生成的中间轨迹和模型状态保存到
relay buffer中 - 从replay buffer中读取中间轨迹继续生成新轨迹,多次迭代完成轨迹生成
- 选择性计算loss:可以当前片段或整个轨迹的loss,具体策略看实际情况

🔑2、改进的策略优化(重点)
- 训练算法:
Online Policy Mirror Descent的变体 - 🧠核心思想(待详细看一下):
- 每次迭代使用当前模型作为参考模型,优化相对熵正则化的策略优化问题,
- 通过正则化技术避免模型的推理过程偏离目标。
- 设计合适的奖励机制和梯度计算方法,使模型逐步优化推理路径解决复杂问题。
- 改进手段:长度惩罚、有效采样策略、训练数据优化等。
- 长度惩罚:避免过度思考且保证模型训练效率,采用渐进长度惩罚策略,缓解初期训练慢速问题、
- 有效采样:课程采样和优先采样策略,以利用问题难度标签和成功率来提高训练效率。
3、简洁的RL Infra(重点)
- 上下文足够长时,模型可以在上下文中进行隐式规划和搜索,无需依赖外部复杂组件(MCTS/价值网络等)。
- 迭代同步RL框架、Partial Rollout等技术。
- 系统通过中央主控、rollout工作人员、训练工作人员、奖励模型等组件协同工作。(见上图)
4、多模态训练
🔑1、longt2short方法(重点)
- 目的:long转为short cot,性能接近longcot。
- 主要方法
- 模型合并:longcot和shortcot模型权重平均,得到新模型。
- 最短拒绝采样:longcot生成多个回答,选择最短且正确的对shortcot模型做监督微调
- DPO:类似最短拒绝采用,把最短且正确的答案作为正样本,其余作为负样本做DPO训练。
- 🐮🍺long2short RL:标准RL之后,把性能和token最平衡的模型作为基础模型,接着做long2short rl训练。使用长度惩罚,减少不必要回答。
- Long2short RL效果最好,token少、效果好。
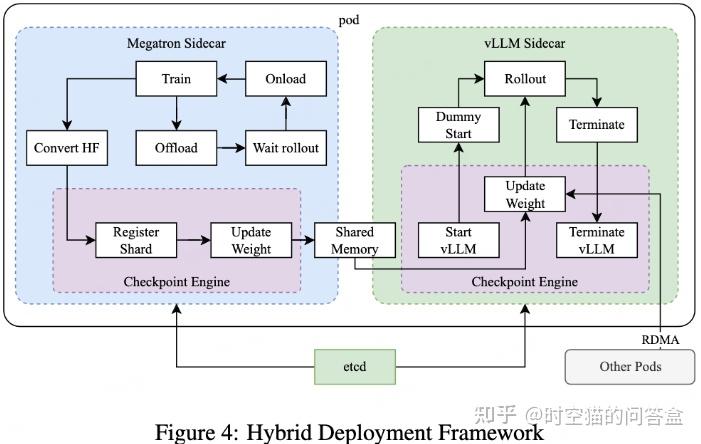
2、混合部署训练和推理(infra)
- 混合部署策略:把训练和推理任务集成在一起,实现更高效资源利用和动态扩展能力

✍️实验设置
🍑关键结果
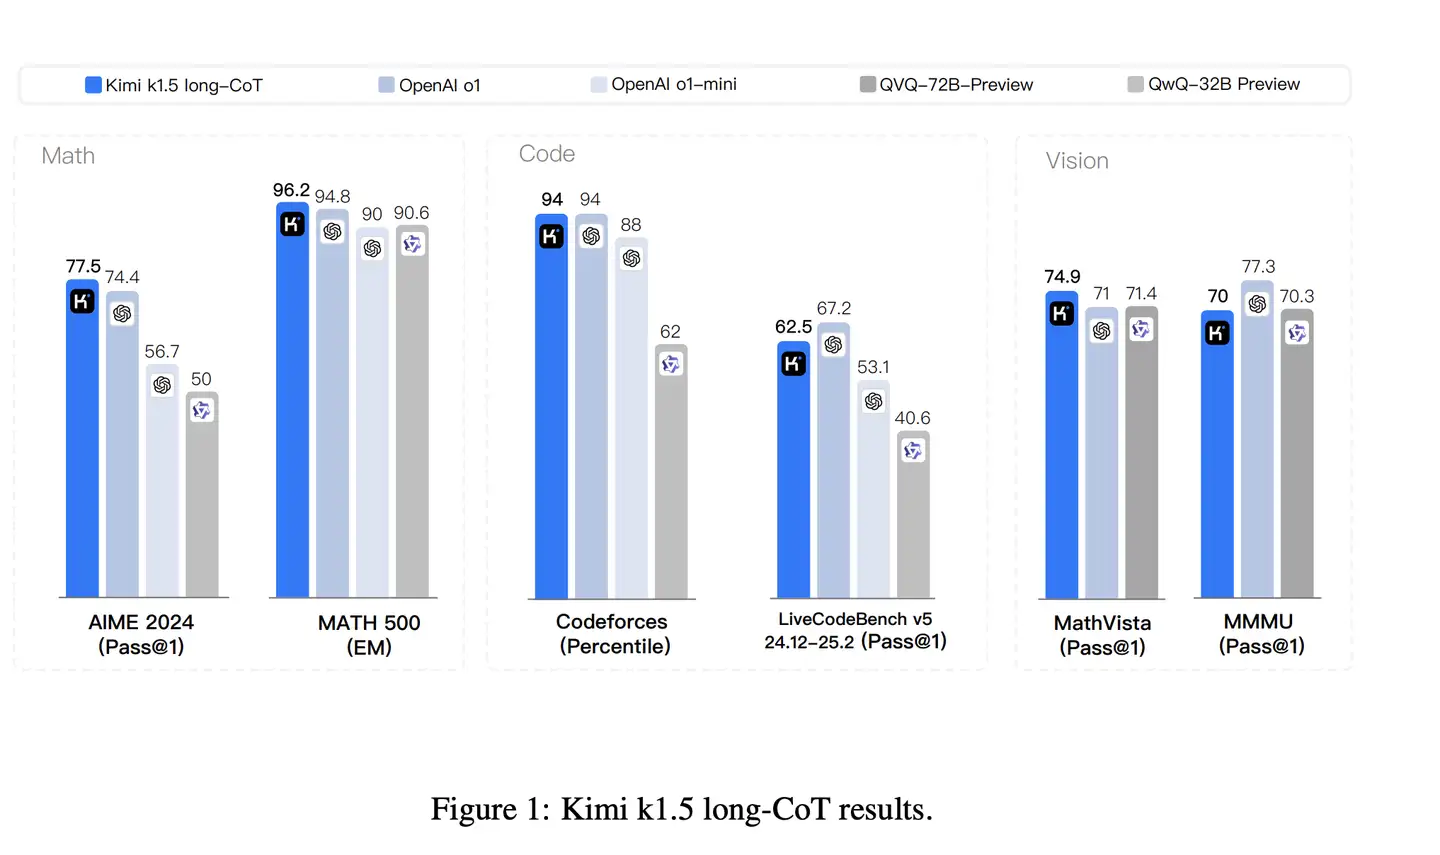
- LongCot能力有惊喜:六项里有四项(AIME/Math500等)超过o1。
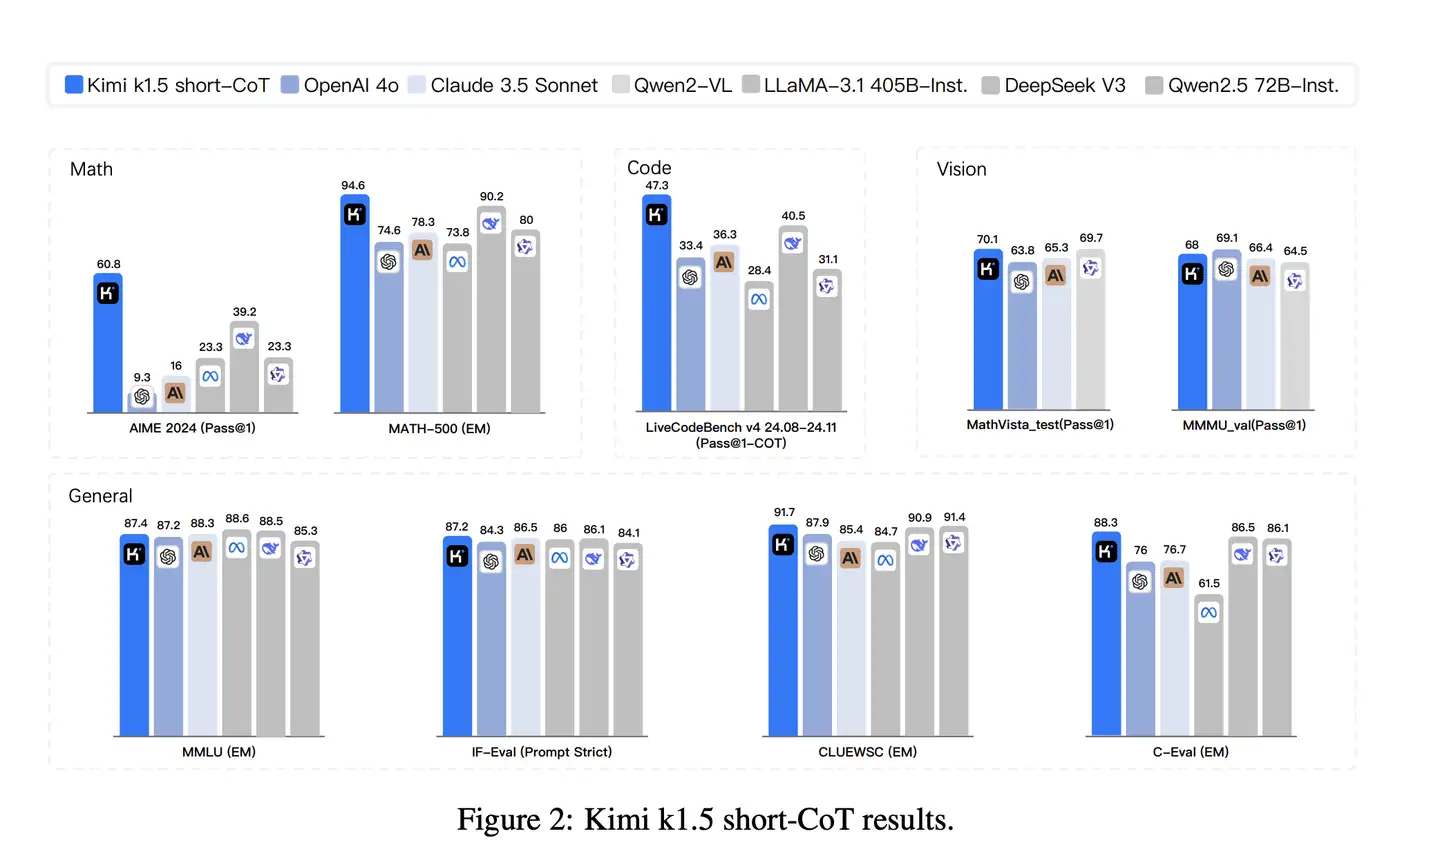
- ShortCot也不错,和o1旗鼓相当。


⛳未来方向
- 接着干推理模型,可能是短期的唯一方向?
- 为什么?
- 高情商:充分发挥大模型思维能力。
- 低情商:高质量数据用完了,scaling law暂时走不下去,得转换方向
- 为什么?
- 提升longcot RL的效率和可扩展性:进一步优化partial rollout。
- 改进信用分配和减少过度思考
- 迭代式long2short训练:long2short和long-rl结合起来训练,在预算范围内,进一步提升模型效果。