强化学习基本概念
📅 发表于 2025/08/18
🔄 更新于 2025/10/23
👁️ — 次访问
📝 5024 字
⏳ 15 分钟
rl
#试错学习
#智能体
#环境
#动作空间
#策略
#随机性策略
#确定性策略
#模型
#状态转移
#奖励
#回报
#价值
#序列决策
#规划
#学习
#Value-based RL
#Policy-based RL
#Model-based RL
#Model-free RL
#探索
#利用
监督学习
假设 训练样本无关联,独立同分布需告知正确标签上限为人类 😔模仿学习正例,数据来源人工标注或蒸馏。强化学习
序列数据,样本前后有关联哪些动作能带来更多奖励上限超人类‼️强化学习两个特点
奖励好的样本、惩罚差的样本当前模型在线产出的样本训练自身。 和环境进行交互当前RL训练数据是最新策略模型生成的。 更新n次,第一次为on-policy,后面都为off-policy试错探索:通过探索环境来获取对环境的理解从环境获得延迟奖励时间非常重要,时间关联的数据,而非独立同分布的数据影响它随后得到的数据需保持稳定,否则采集到的数据会非常糟糕如何让智能体动作稳定提升研究问题
智能体 如何在复杂、不确定的环境中,通过一次次决策,来最大化它能获得的回报。关键定义
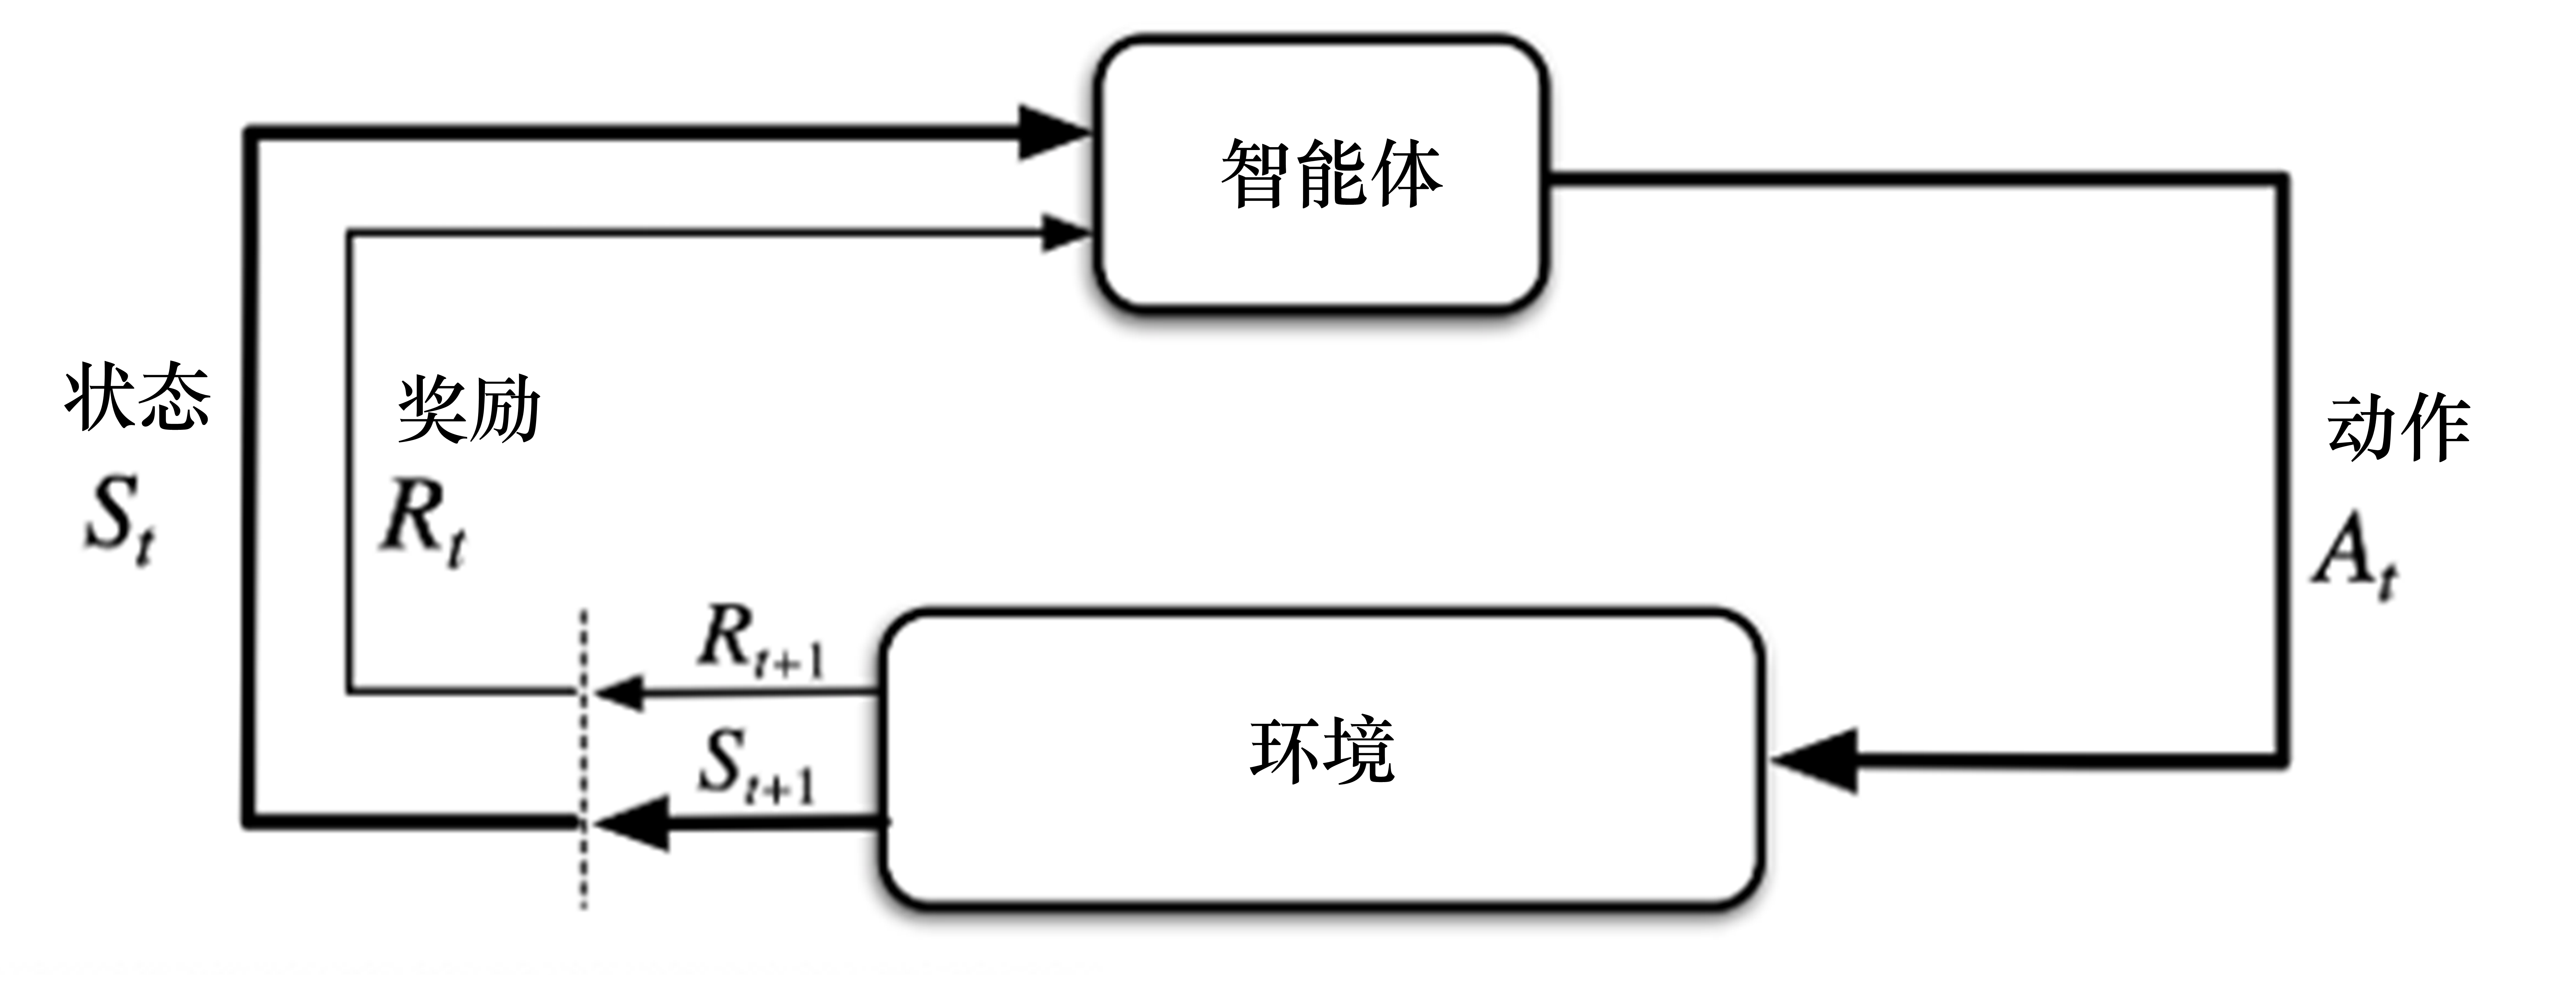
与环境交互,利用环境状态,采取动作输出 下一时刻状态 和反馈动作奖励。试错学习⭐
尝试和试错中学习到正确的策略一系列动作或行为过程中的错误,包括自身行为不当、环境不稳定等。积极或消极),都对下一次尝试产生影响。 奖励;差的结果:惩罚不断尝试和试错,逐渐积累经验更有利结果,在下一次尝试中做出更明智选择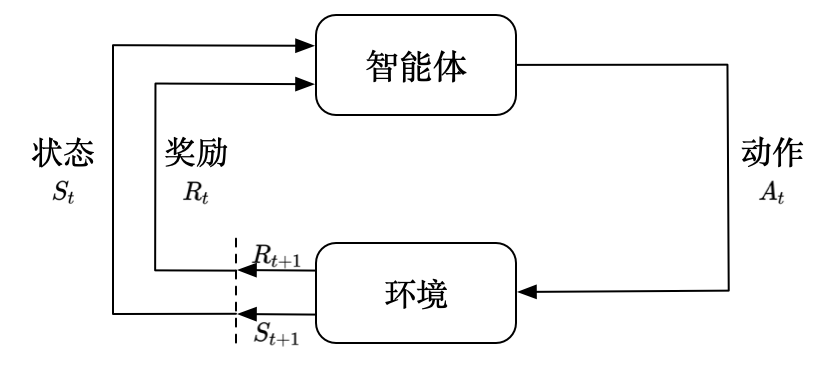
我们唯一需要做的就是调整演员的策略。
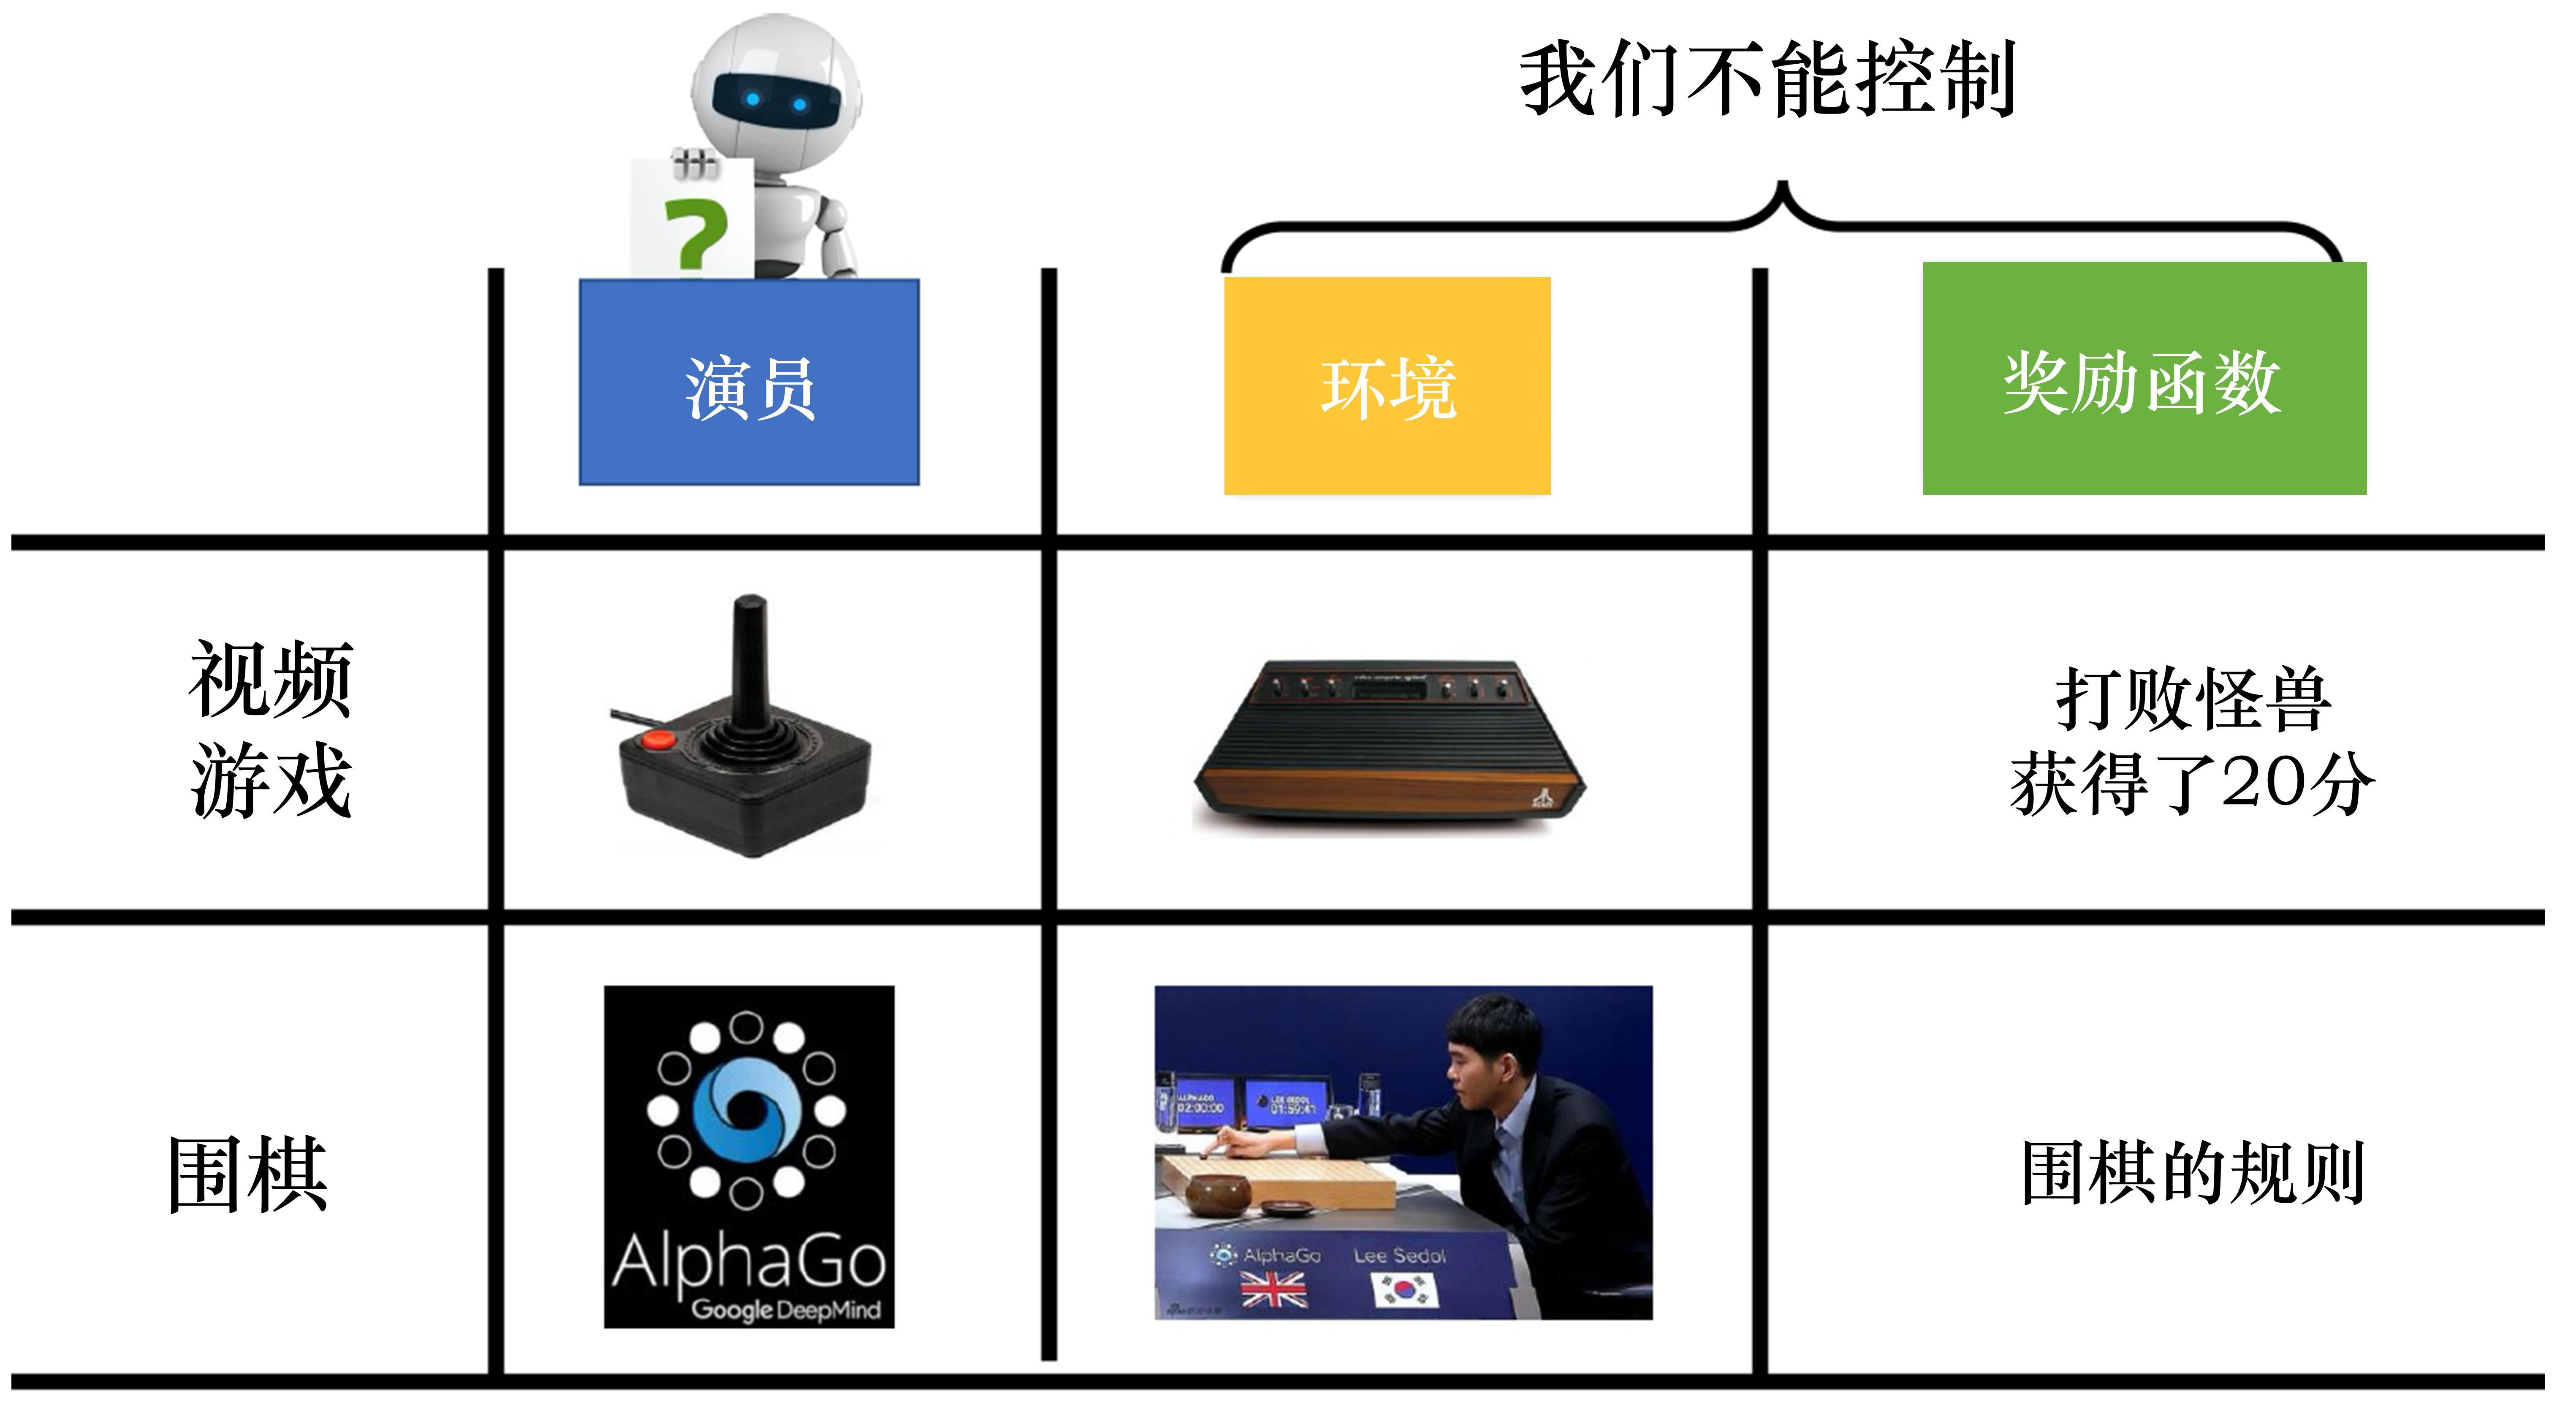
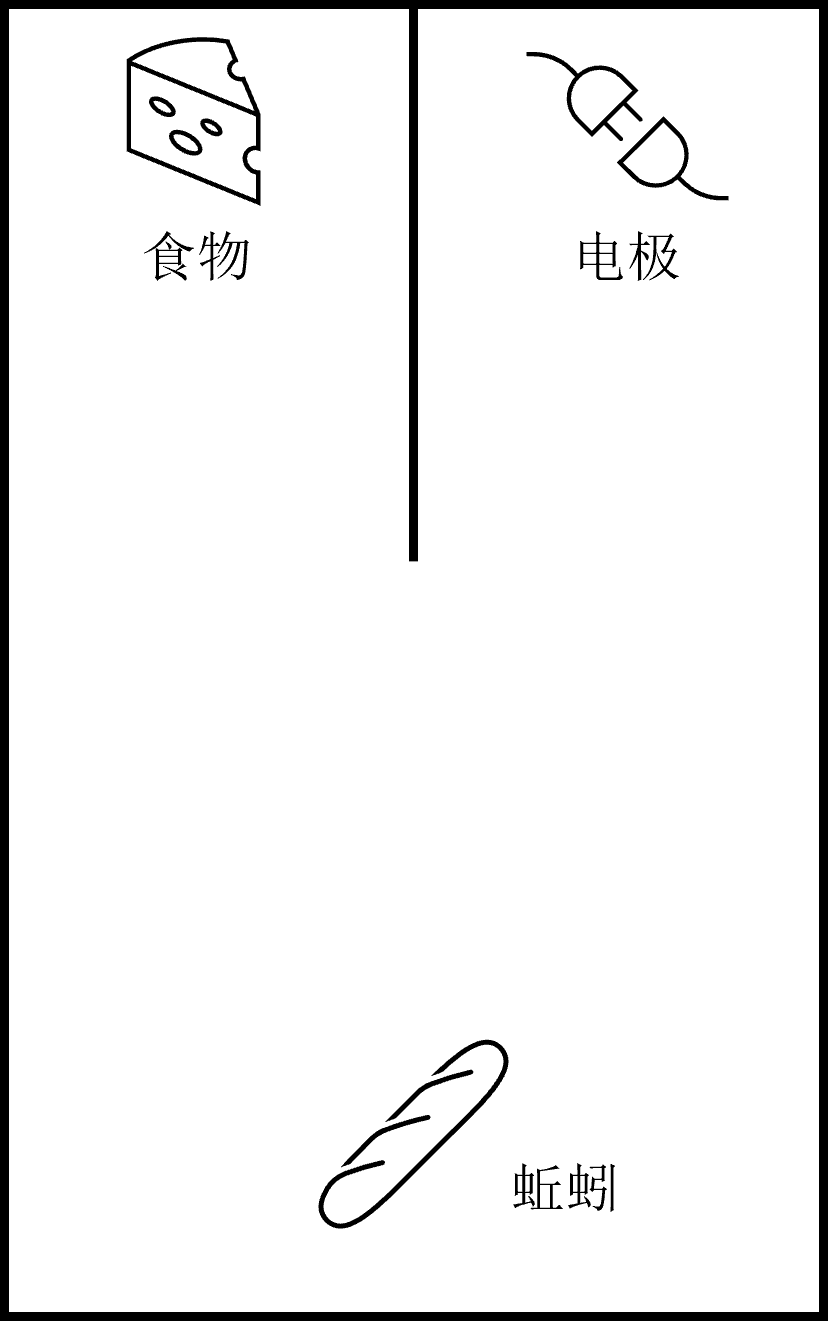
蚯蚓通过一次次实验,学会朝着有食物的方向爬行,而非电极方向。
智能体
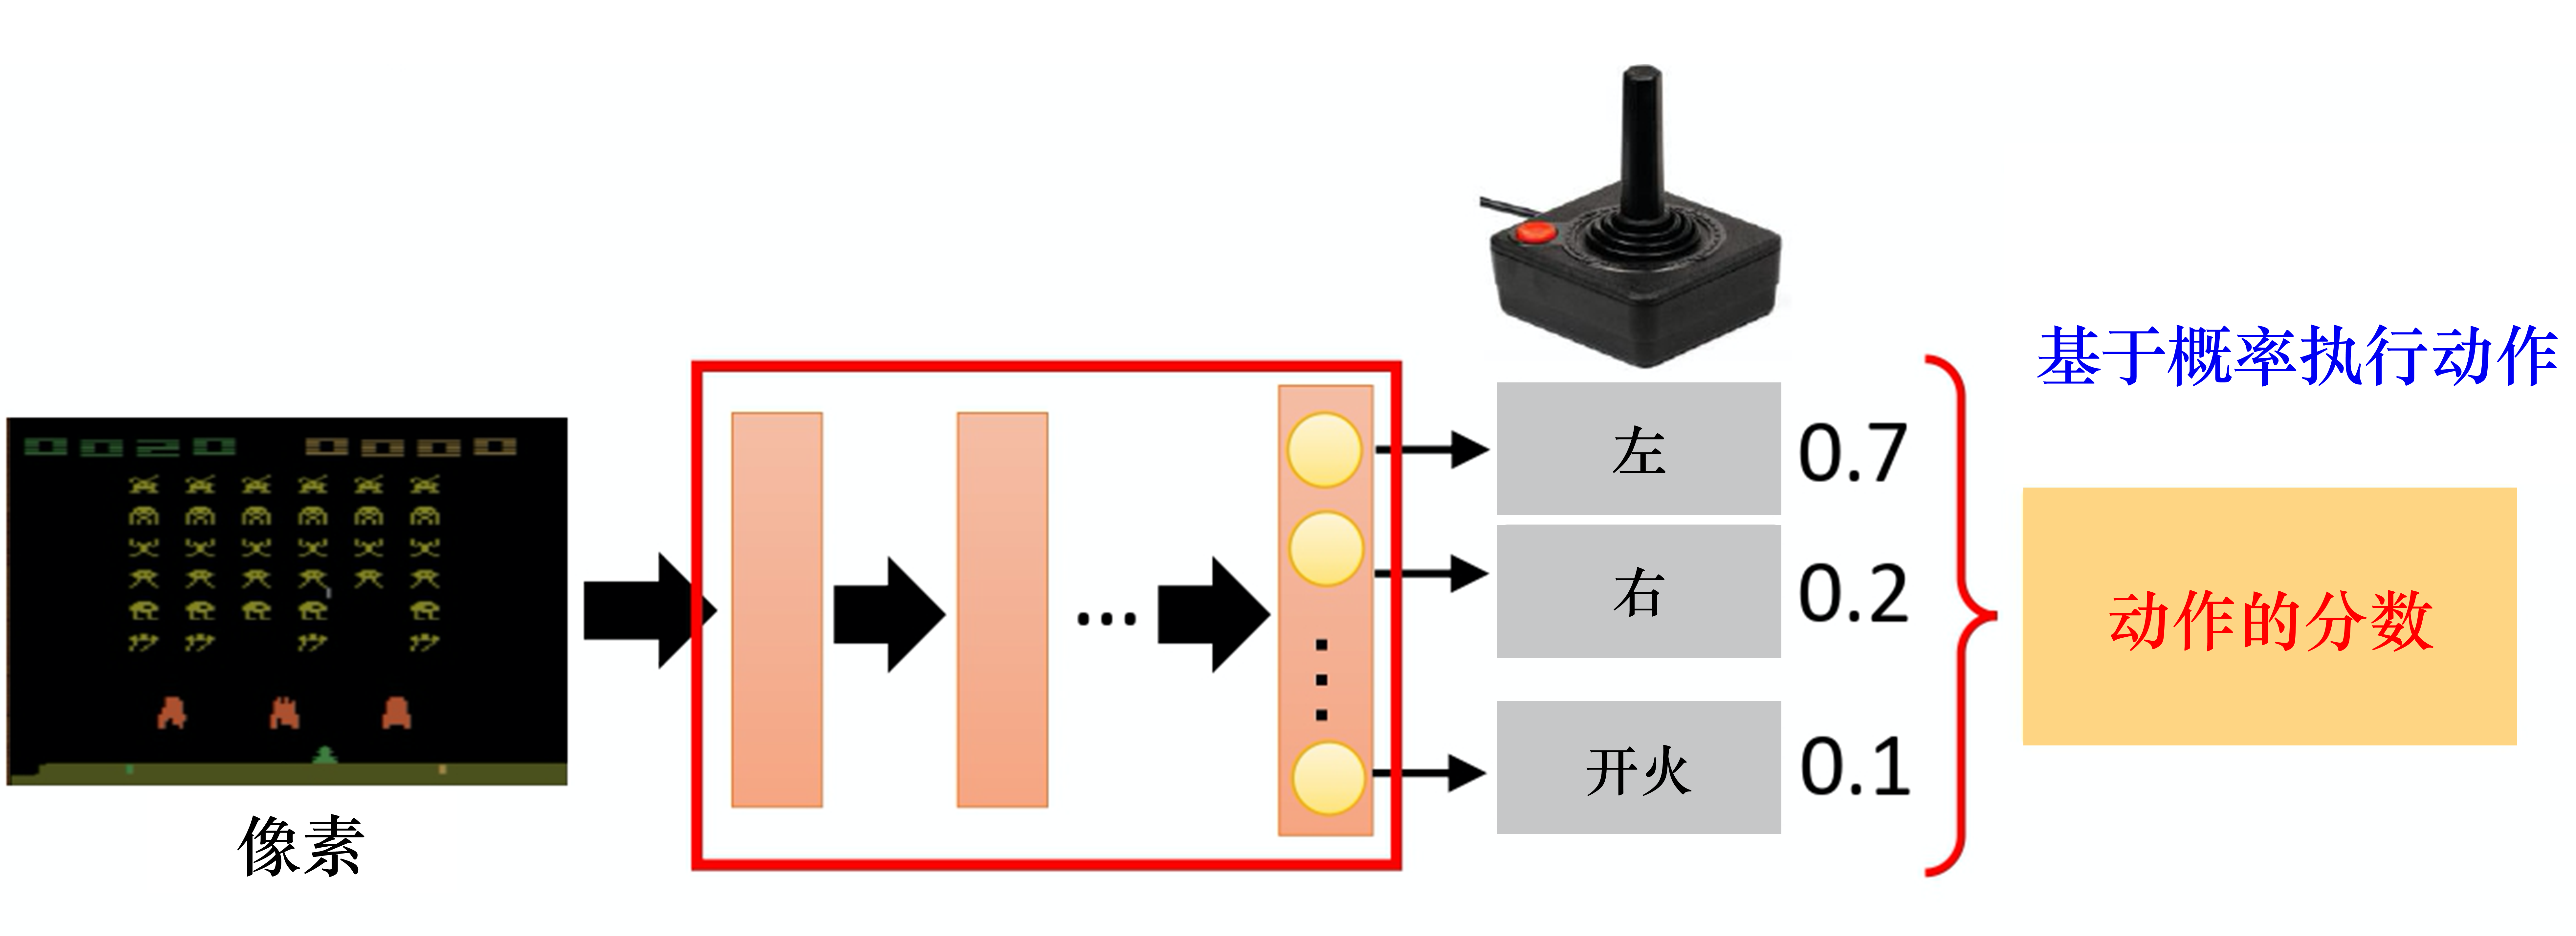
感知环境状态和奖励,输出动作选取一系列动作来最大化奖励,即学到最大化奖励的策略离散、连续动作空间策略
在当前状态s下,agent根据策略来选下一步动作
随机性策略:输出动作概率分布,根据概率选动作,0.7概率往左,0.3概率往右
确定性策略:直接选最有可能的动作,输出不变:
一般选择随机性策略👍,更好探索环境、动作具有多样性
除智能体以外 的其他内容,也可能是其他Agent感知智能体行为,状态改变、给出奖励状态转移概率、奖励函数。奖励
环境给的 标量反馈信号,显示智能体在某状态 采取某个策略的表现如何
如何平衡近期奖励与远期奖励?
回报
累计的奖励价值函数
对未来奖励的 预测
评估Agent进入某状态或采取某动作,预估 未来能获得多少奖励
演员的策略
序列决策
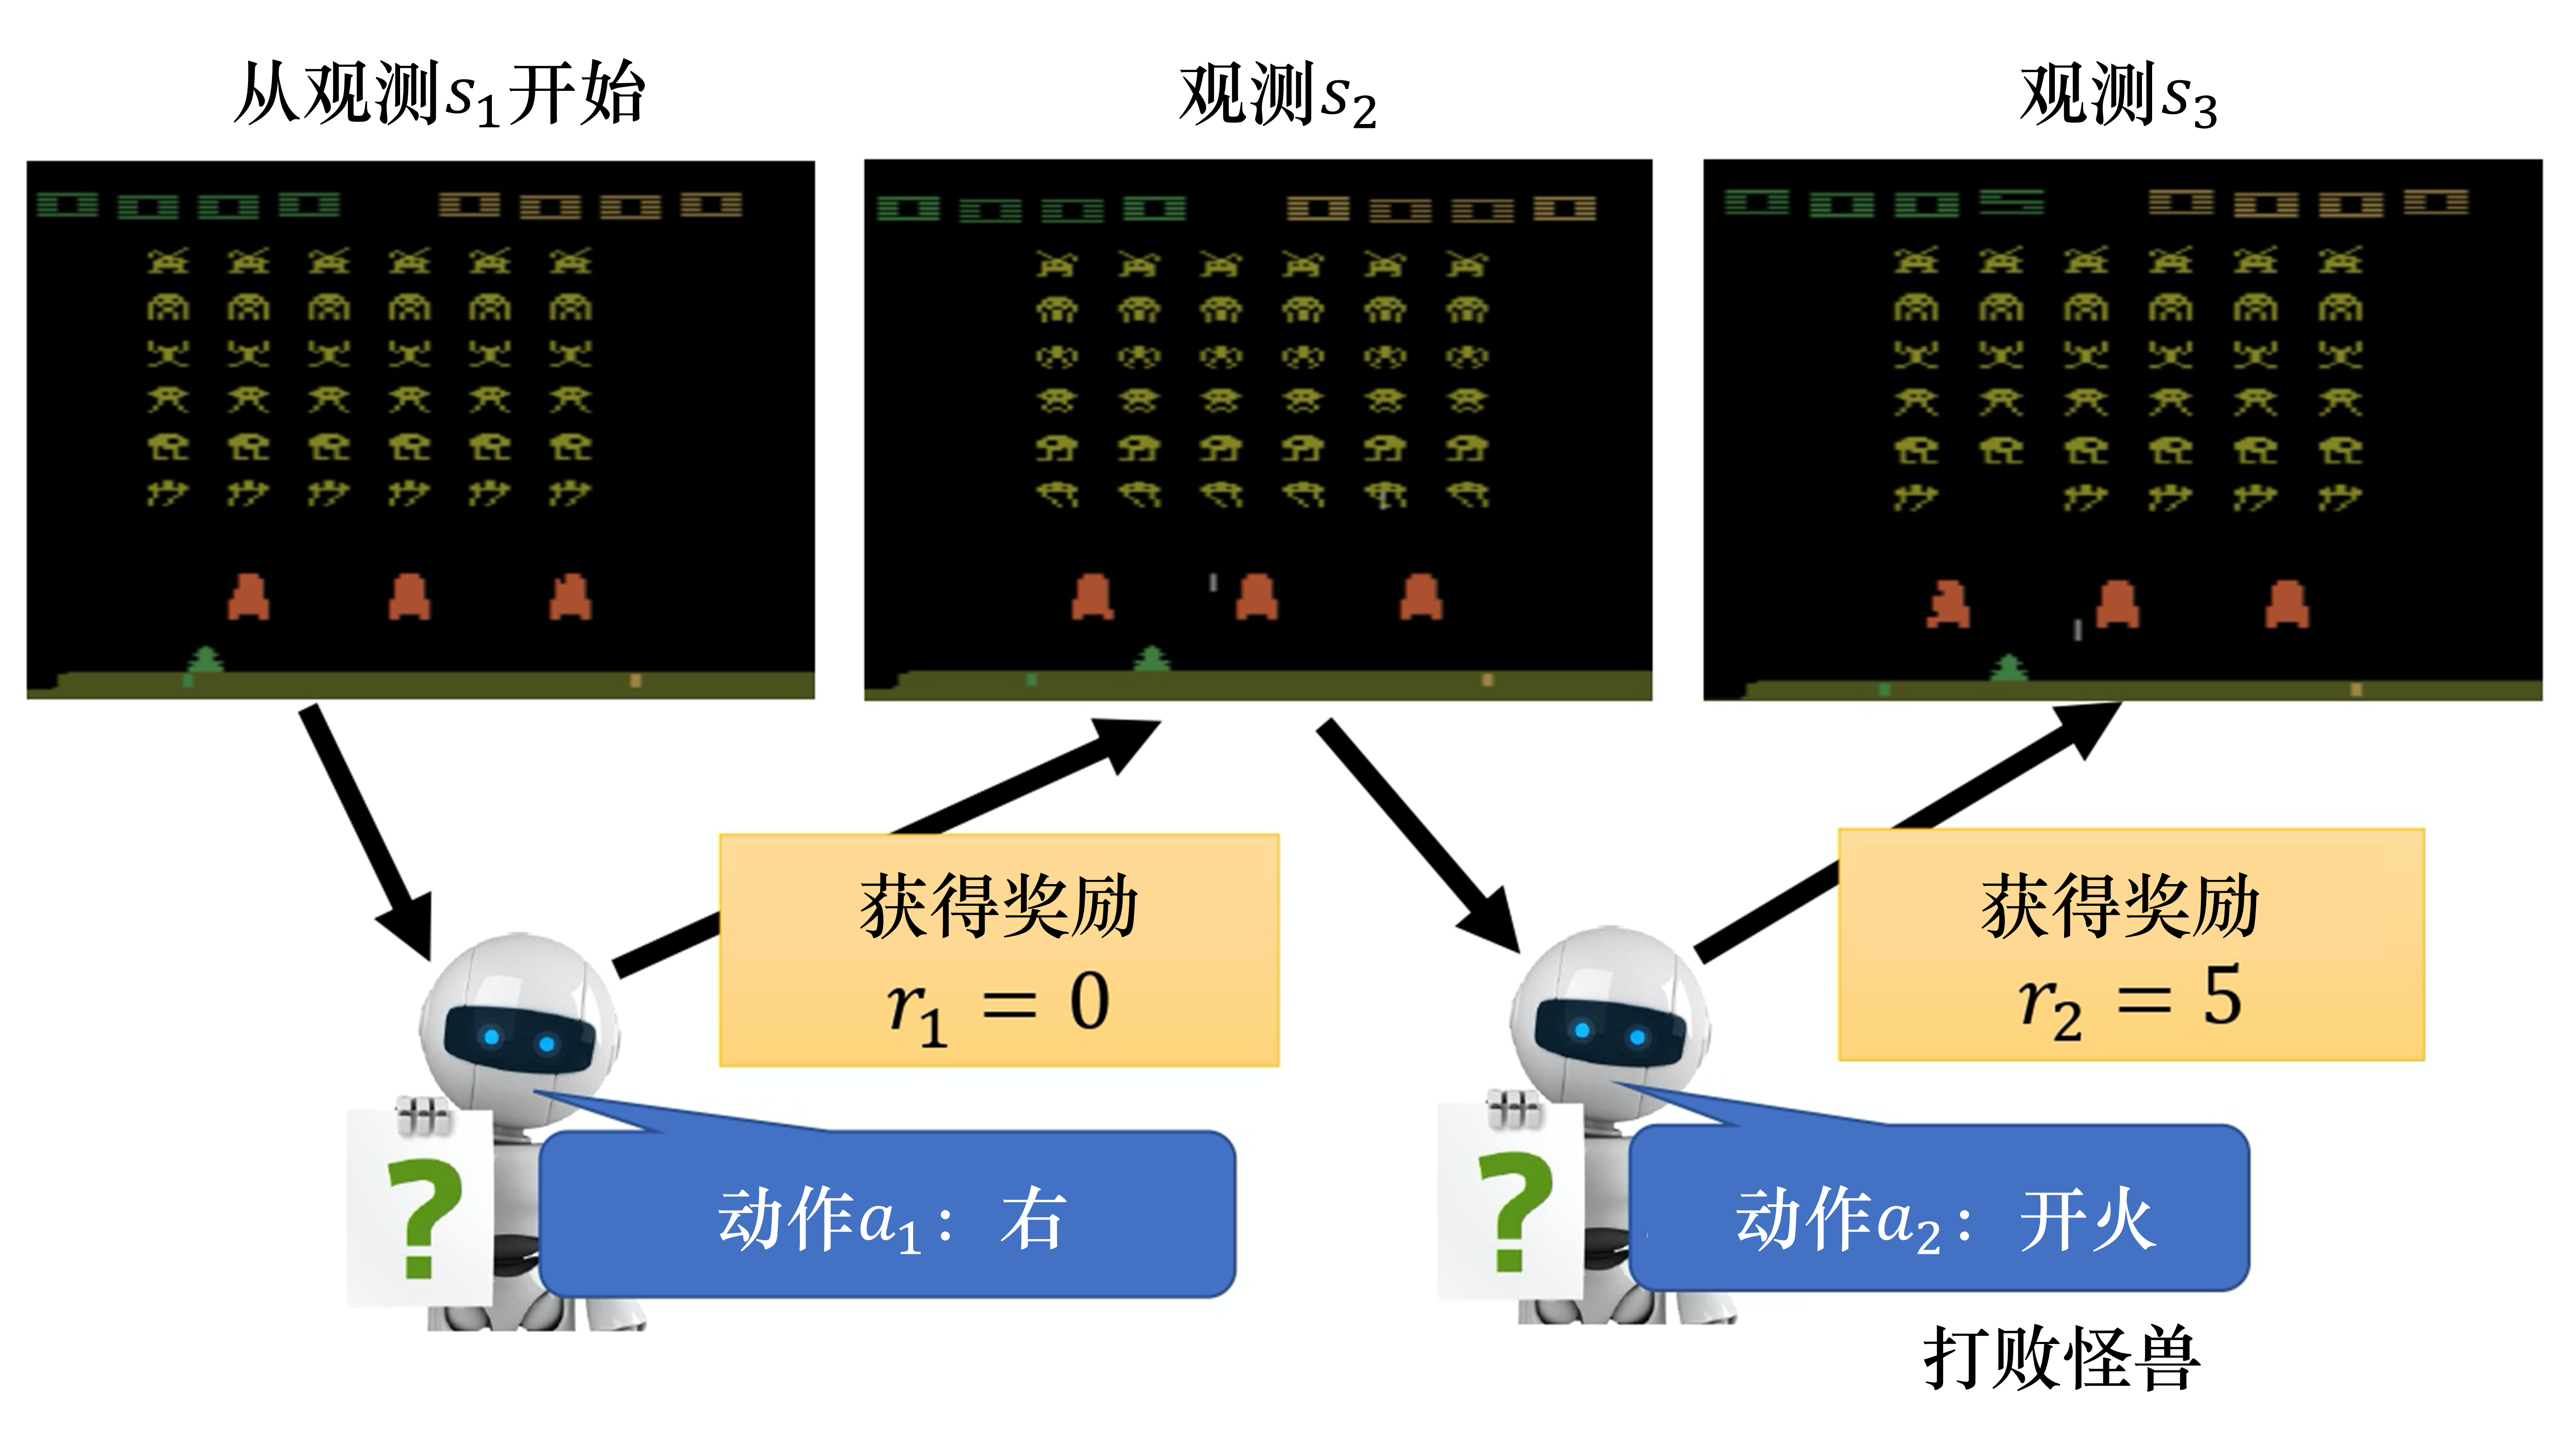
回报的例子
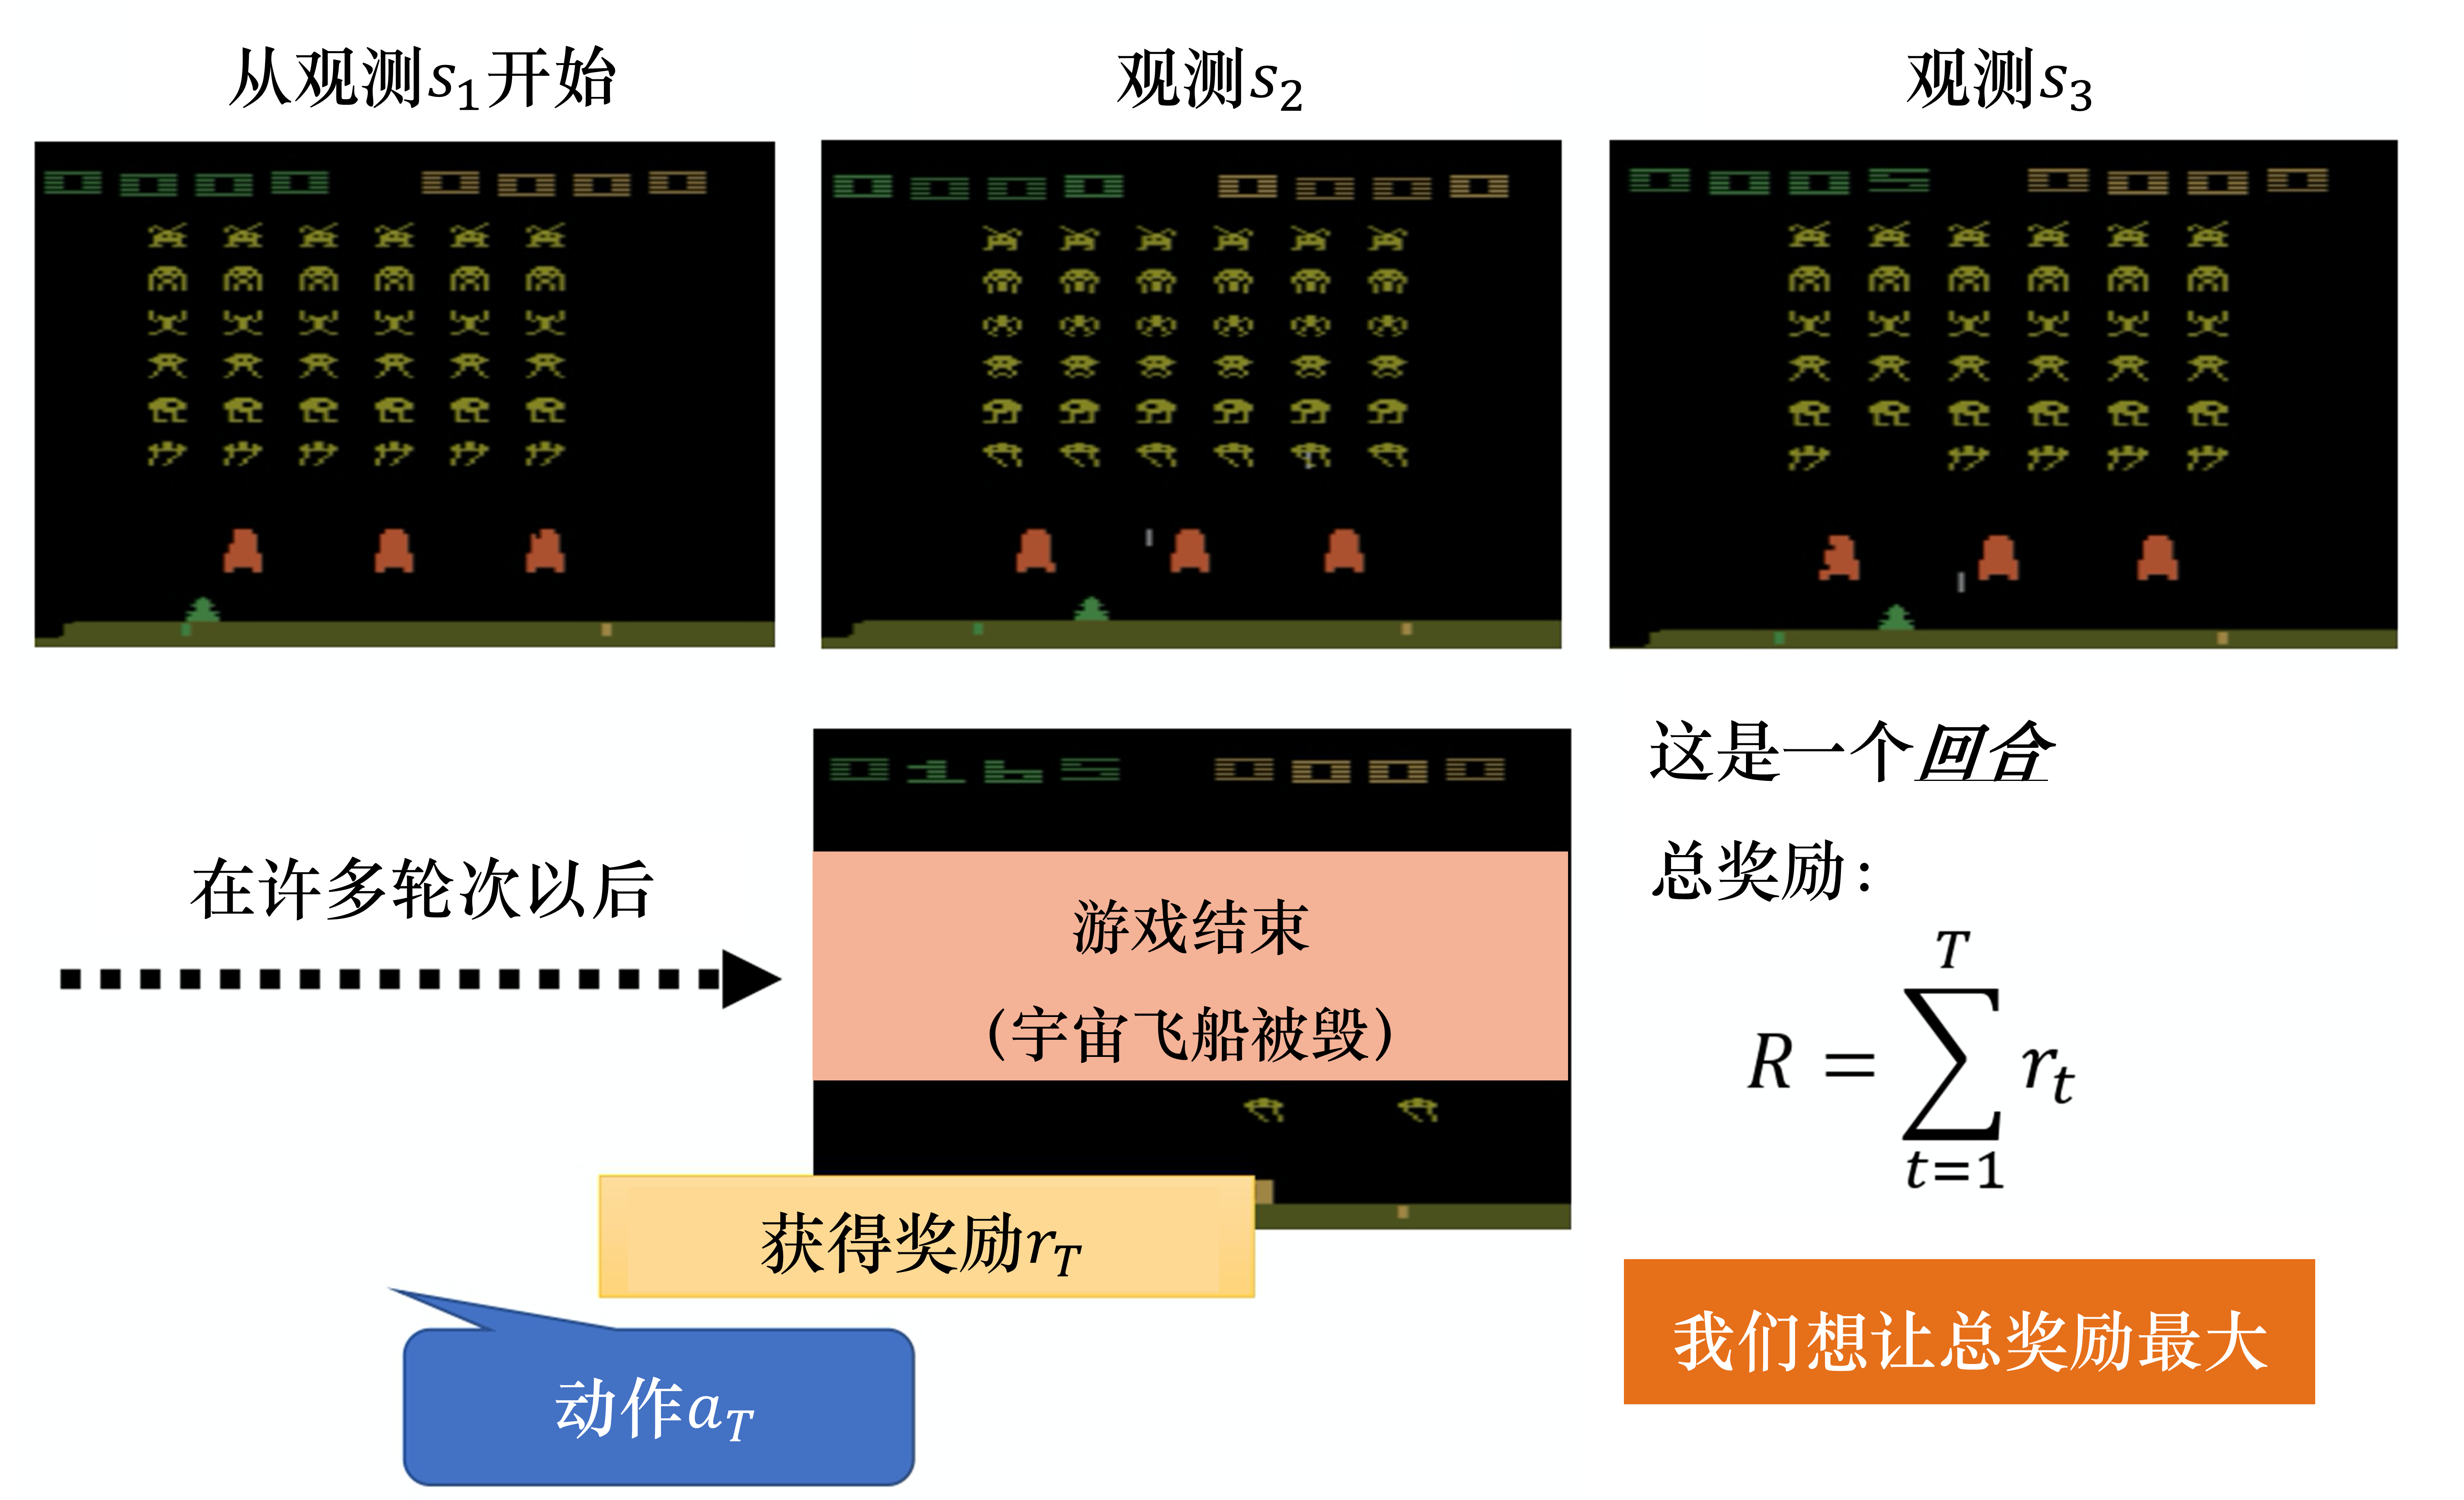
演员和环境
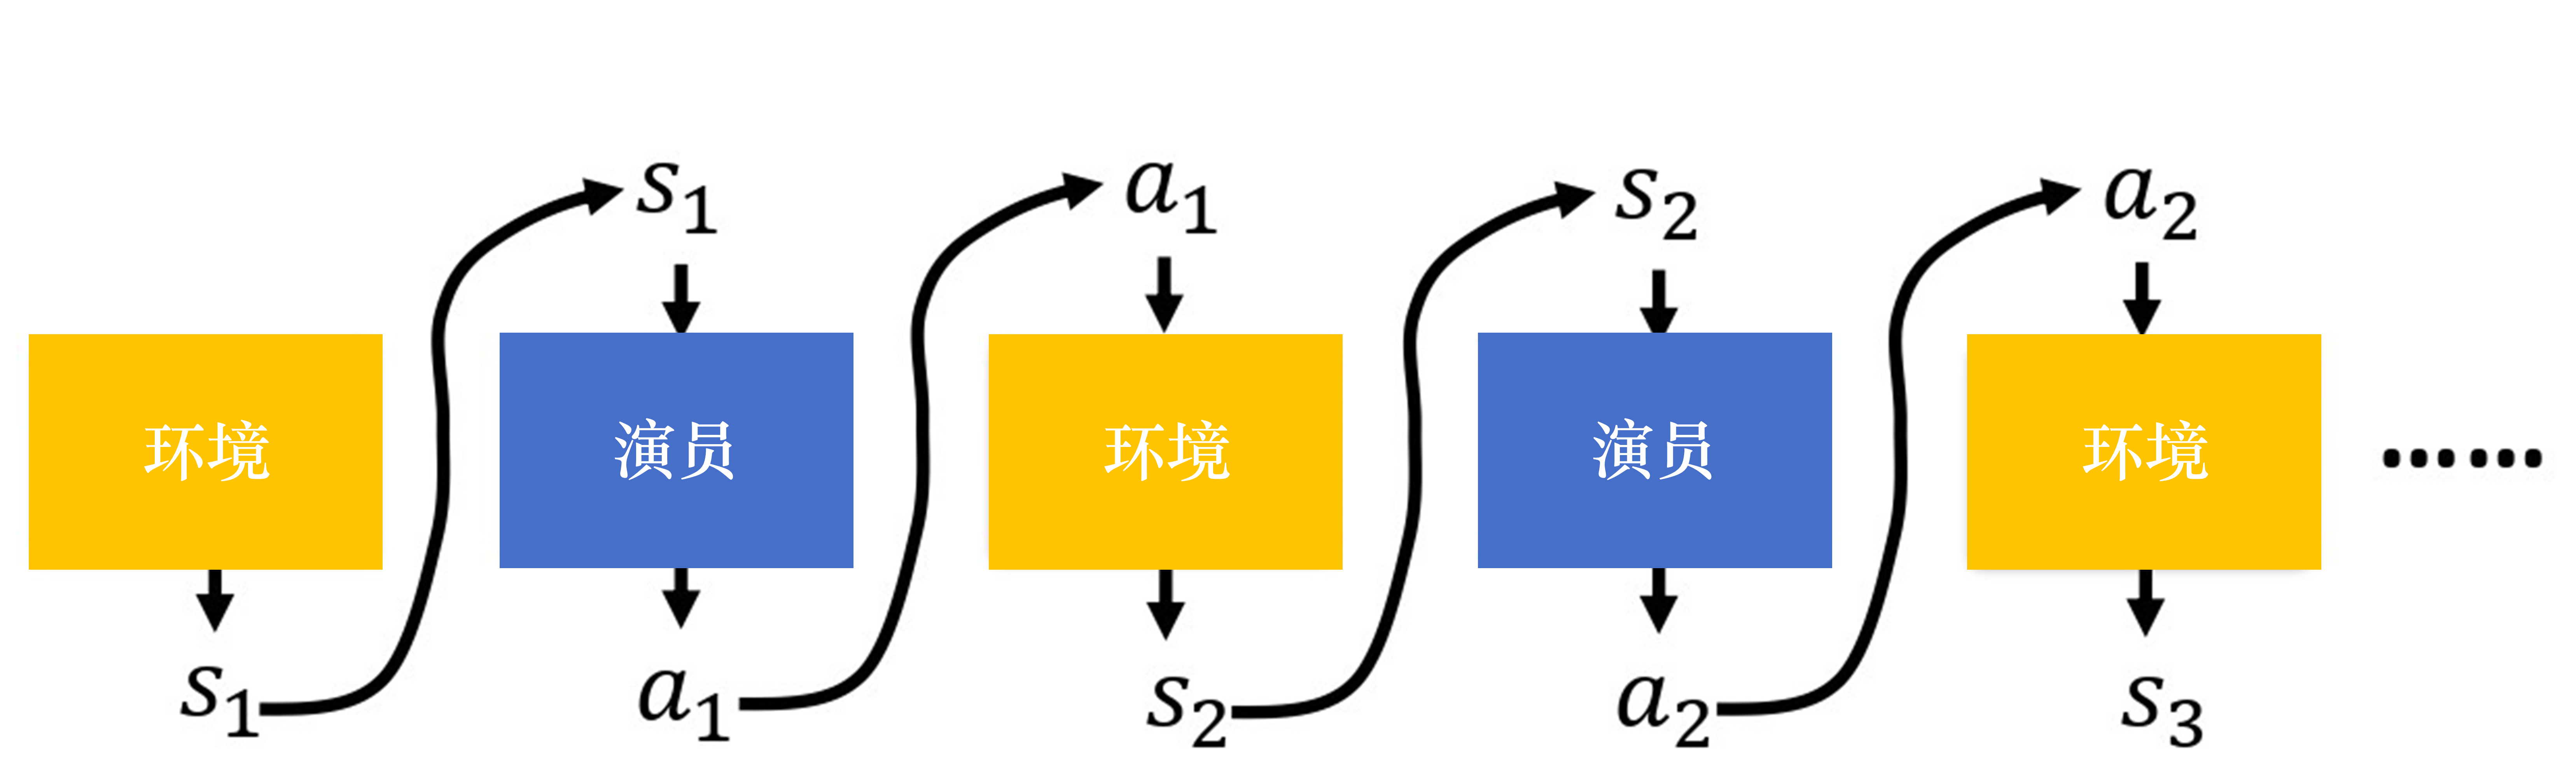
状态、观测、历史
完整描述。离散或连续部分描述,智能体会有很多观测。序列决策
选取一系列动作 来最大化奖励。完全可观测,智能体能看到环境所有状态,部分可观测,智能体只能看到部分状态学习(learning)
环境未知:智能体不知环境如何工作,通过不断和环境交互,逐渐改进策略规划(planning)
环境已知:无需和环境交互,只需当前状态,就能思考和寻找最优解有模型RL,已知状态转移和奖励函数,只需通过动态规划 寻找最优解即可。常用RL思路
学习:
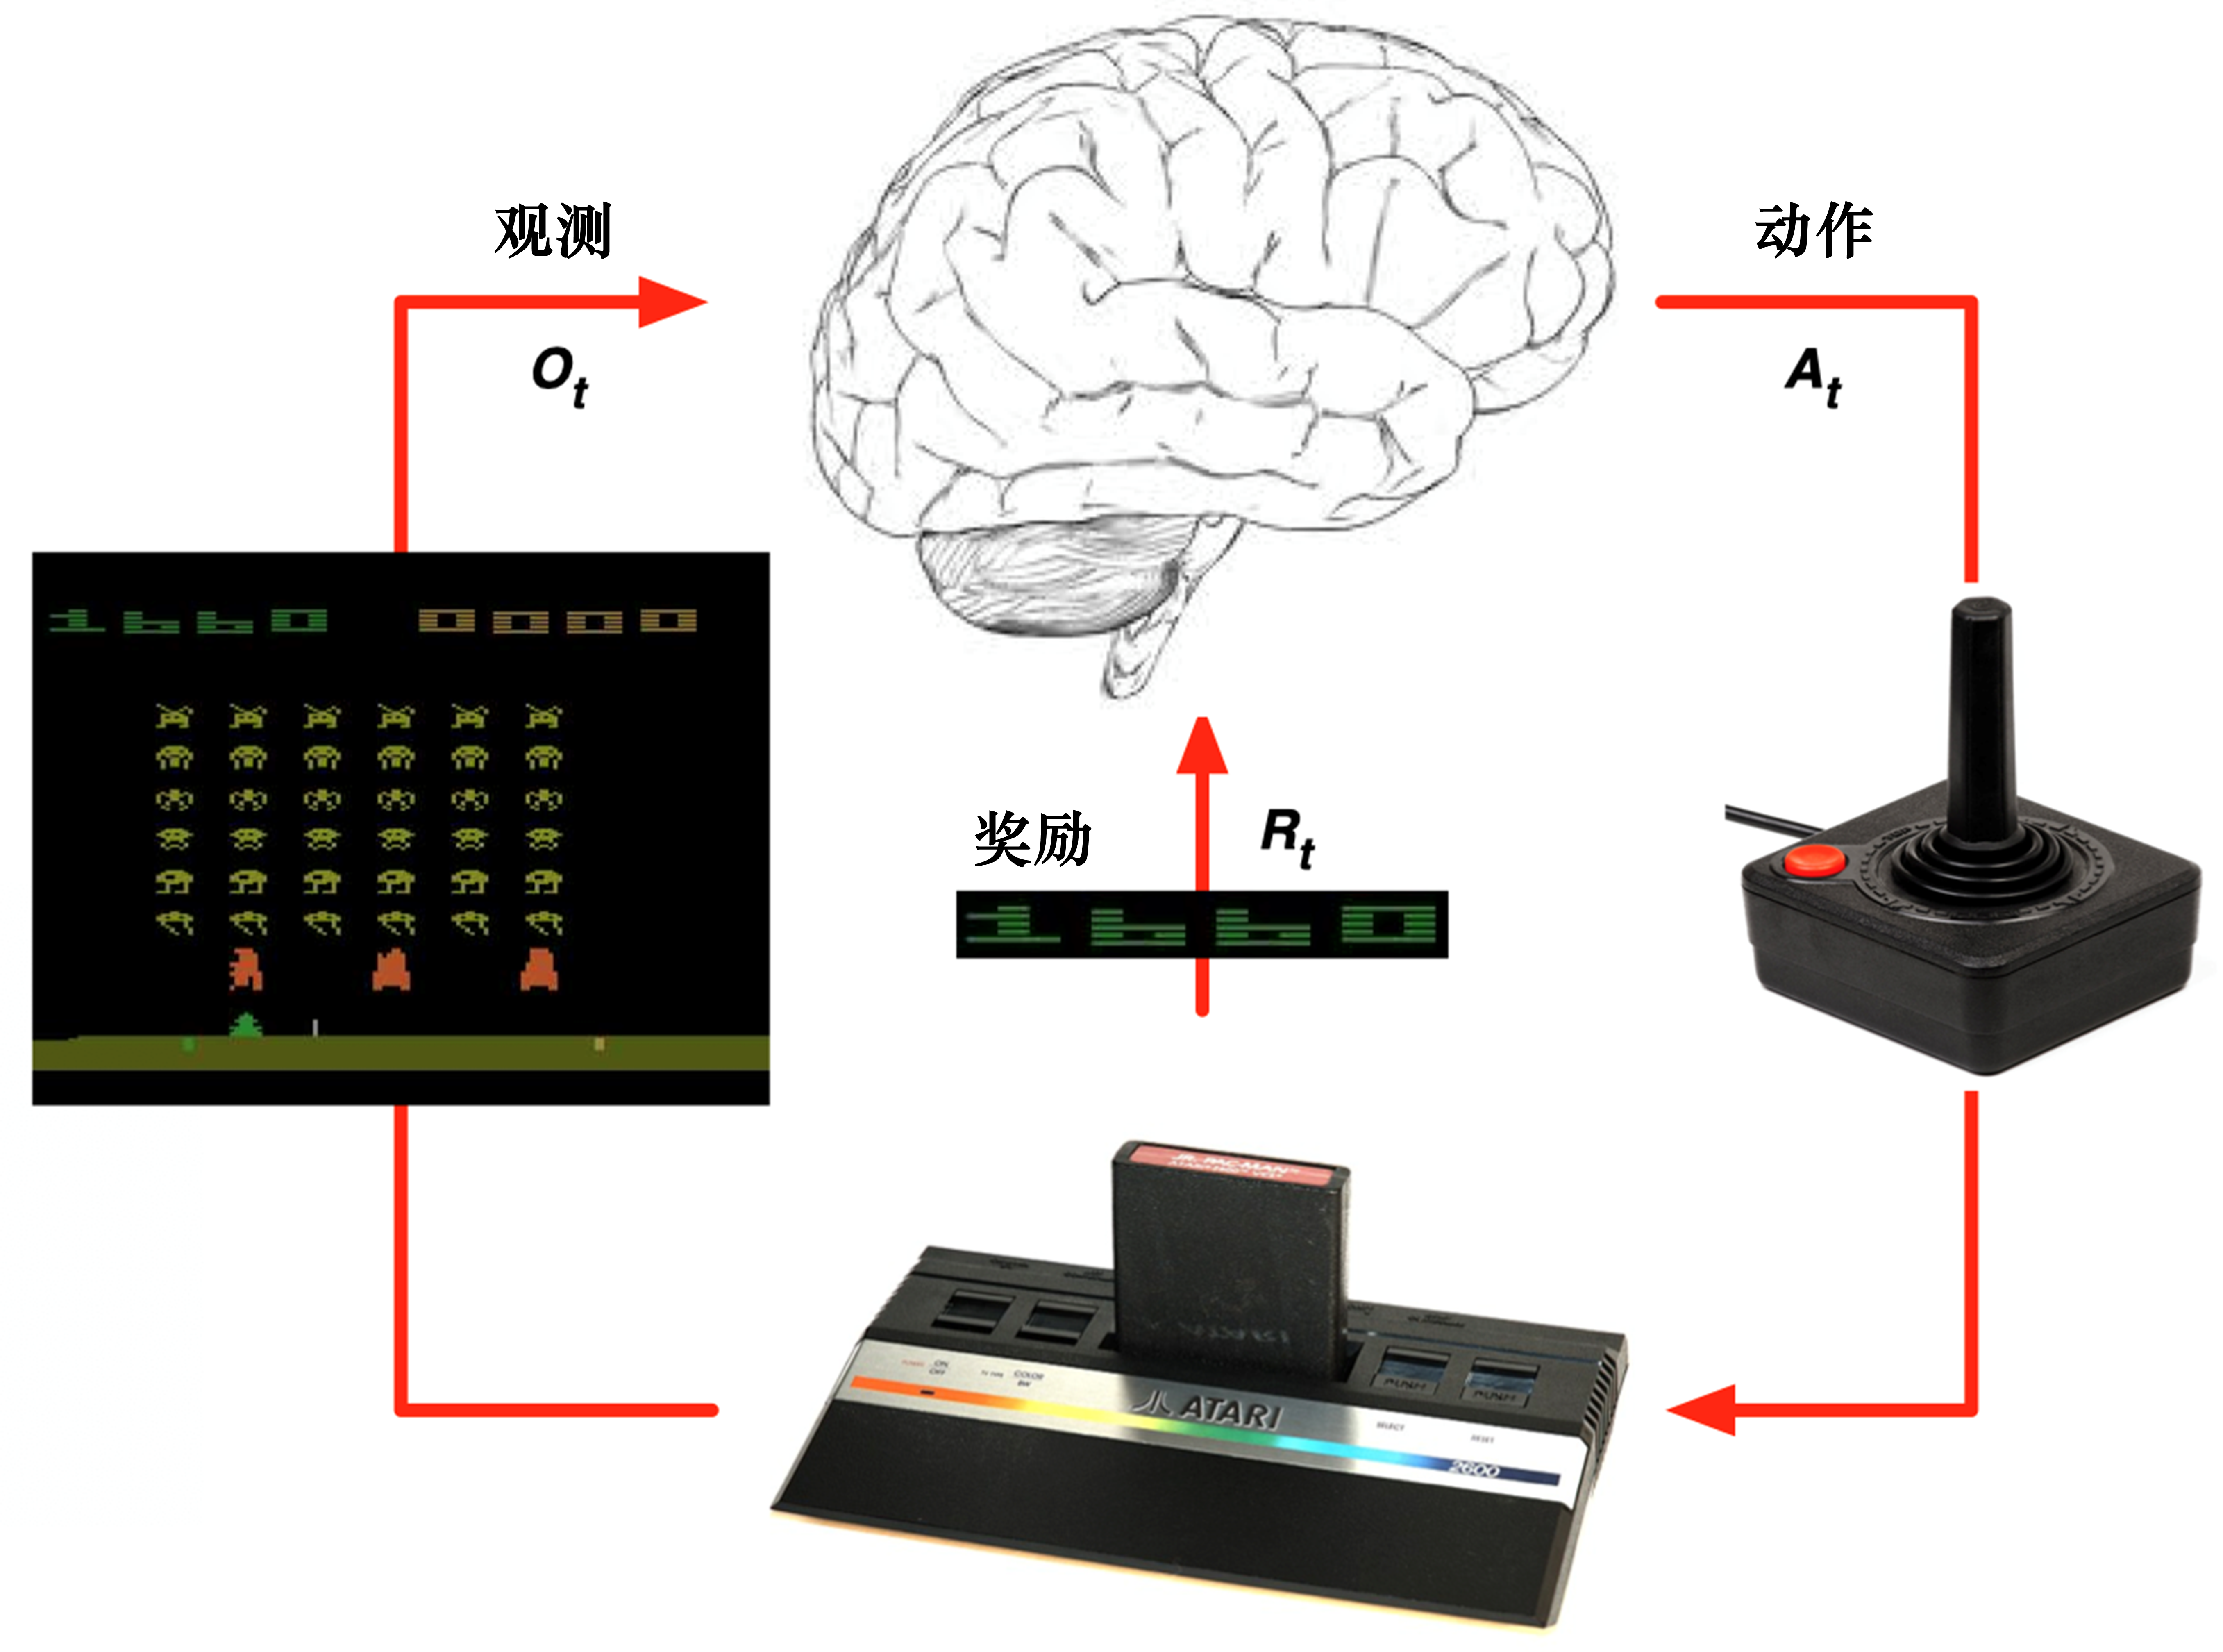
规划:
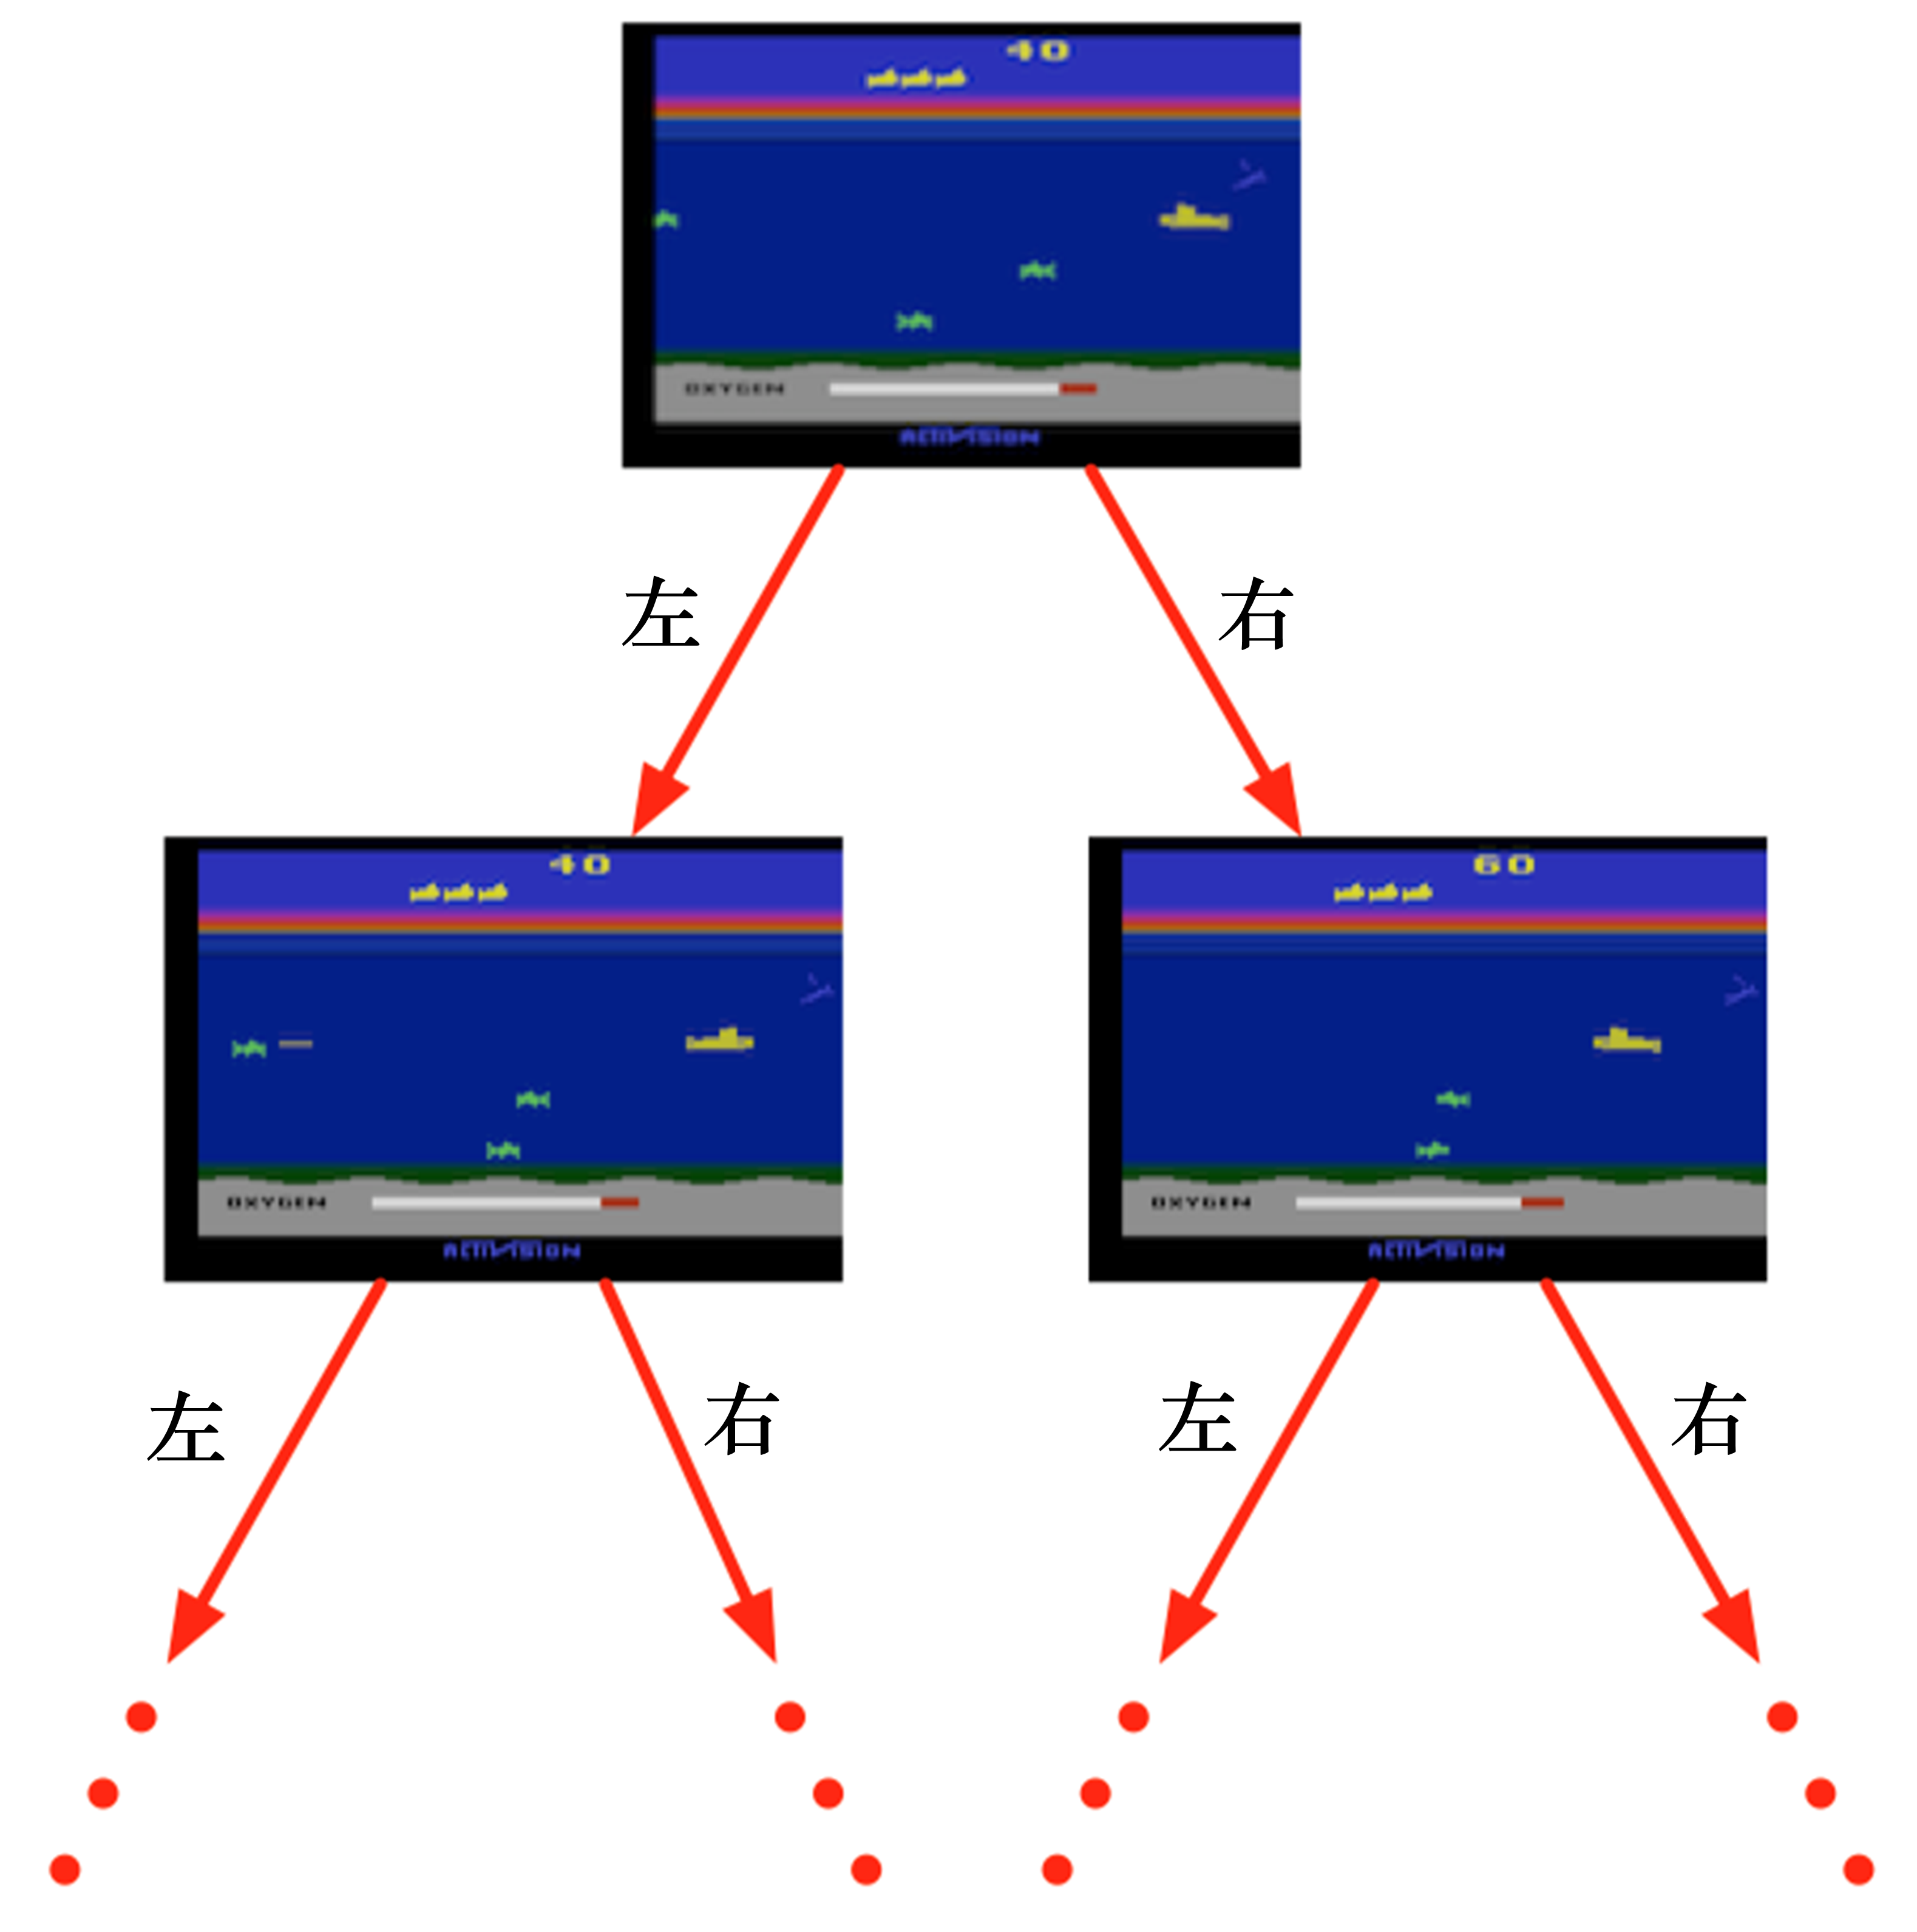
强化
下一状态的价值,可以不断强化影响(更新) 上一状态的价值强化次数越多,条件反射会越巩固有价值的格子会慢慢影响 附近格子的价值周围的格子状态就会被慢慢强化强化就是价值收敛到最优情况后,小黄球会自动往价值高的格子走采取更好的动作,来改进策略自举
其他估算值,来更新 当前估算值;用之前的估计量来估计 另一个量。现有的估计(目标值/时序差分目标)来计算 未来状态的价值一个状态的估计值,来更新 该状态的实际值。自举 依赖先前估计值,可能会导致估计出的价值函数 存在偏差动态规划
未来的价值来更新当前的价值巴普洛夫条件反射实验
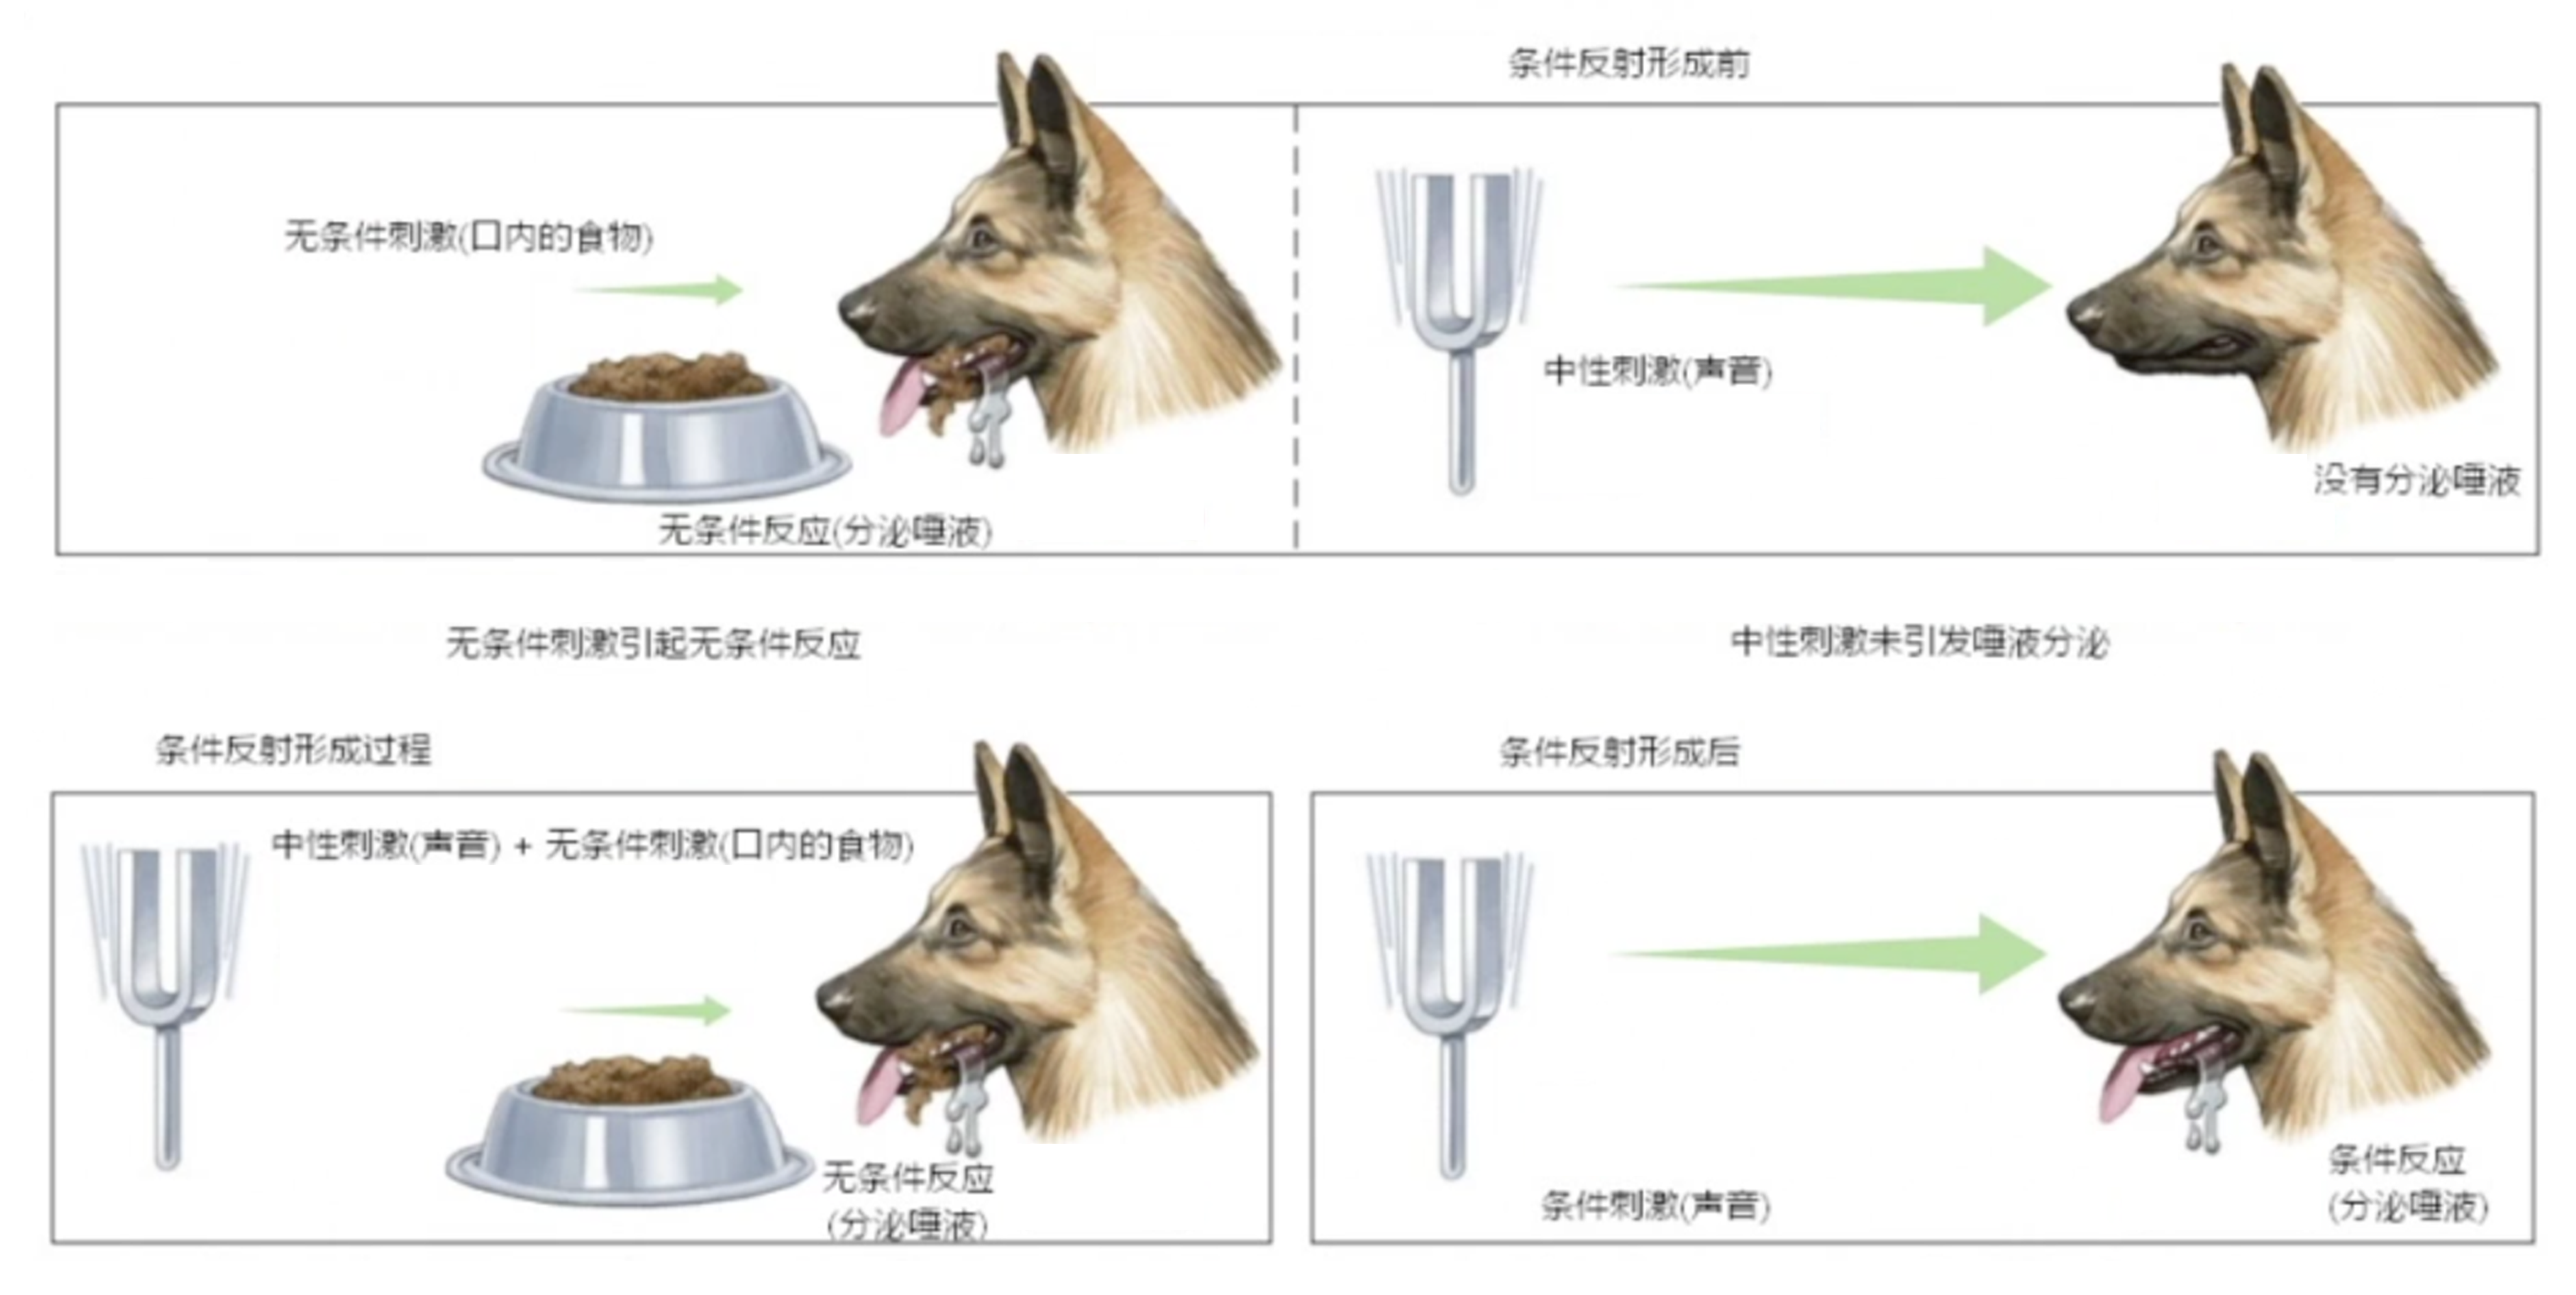
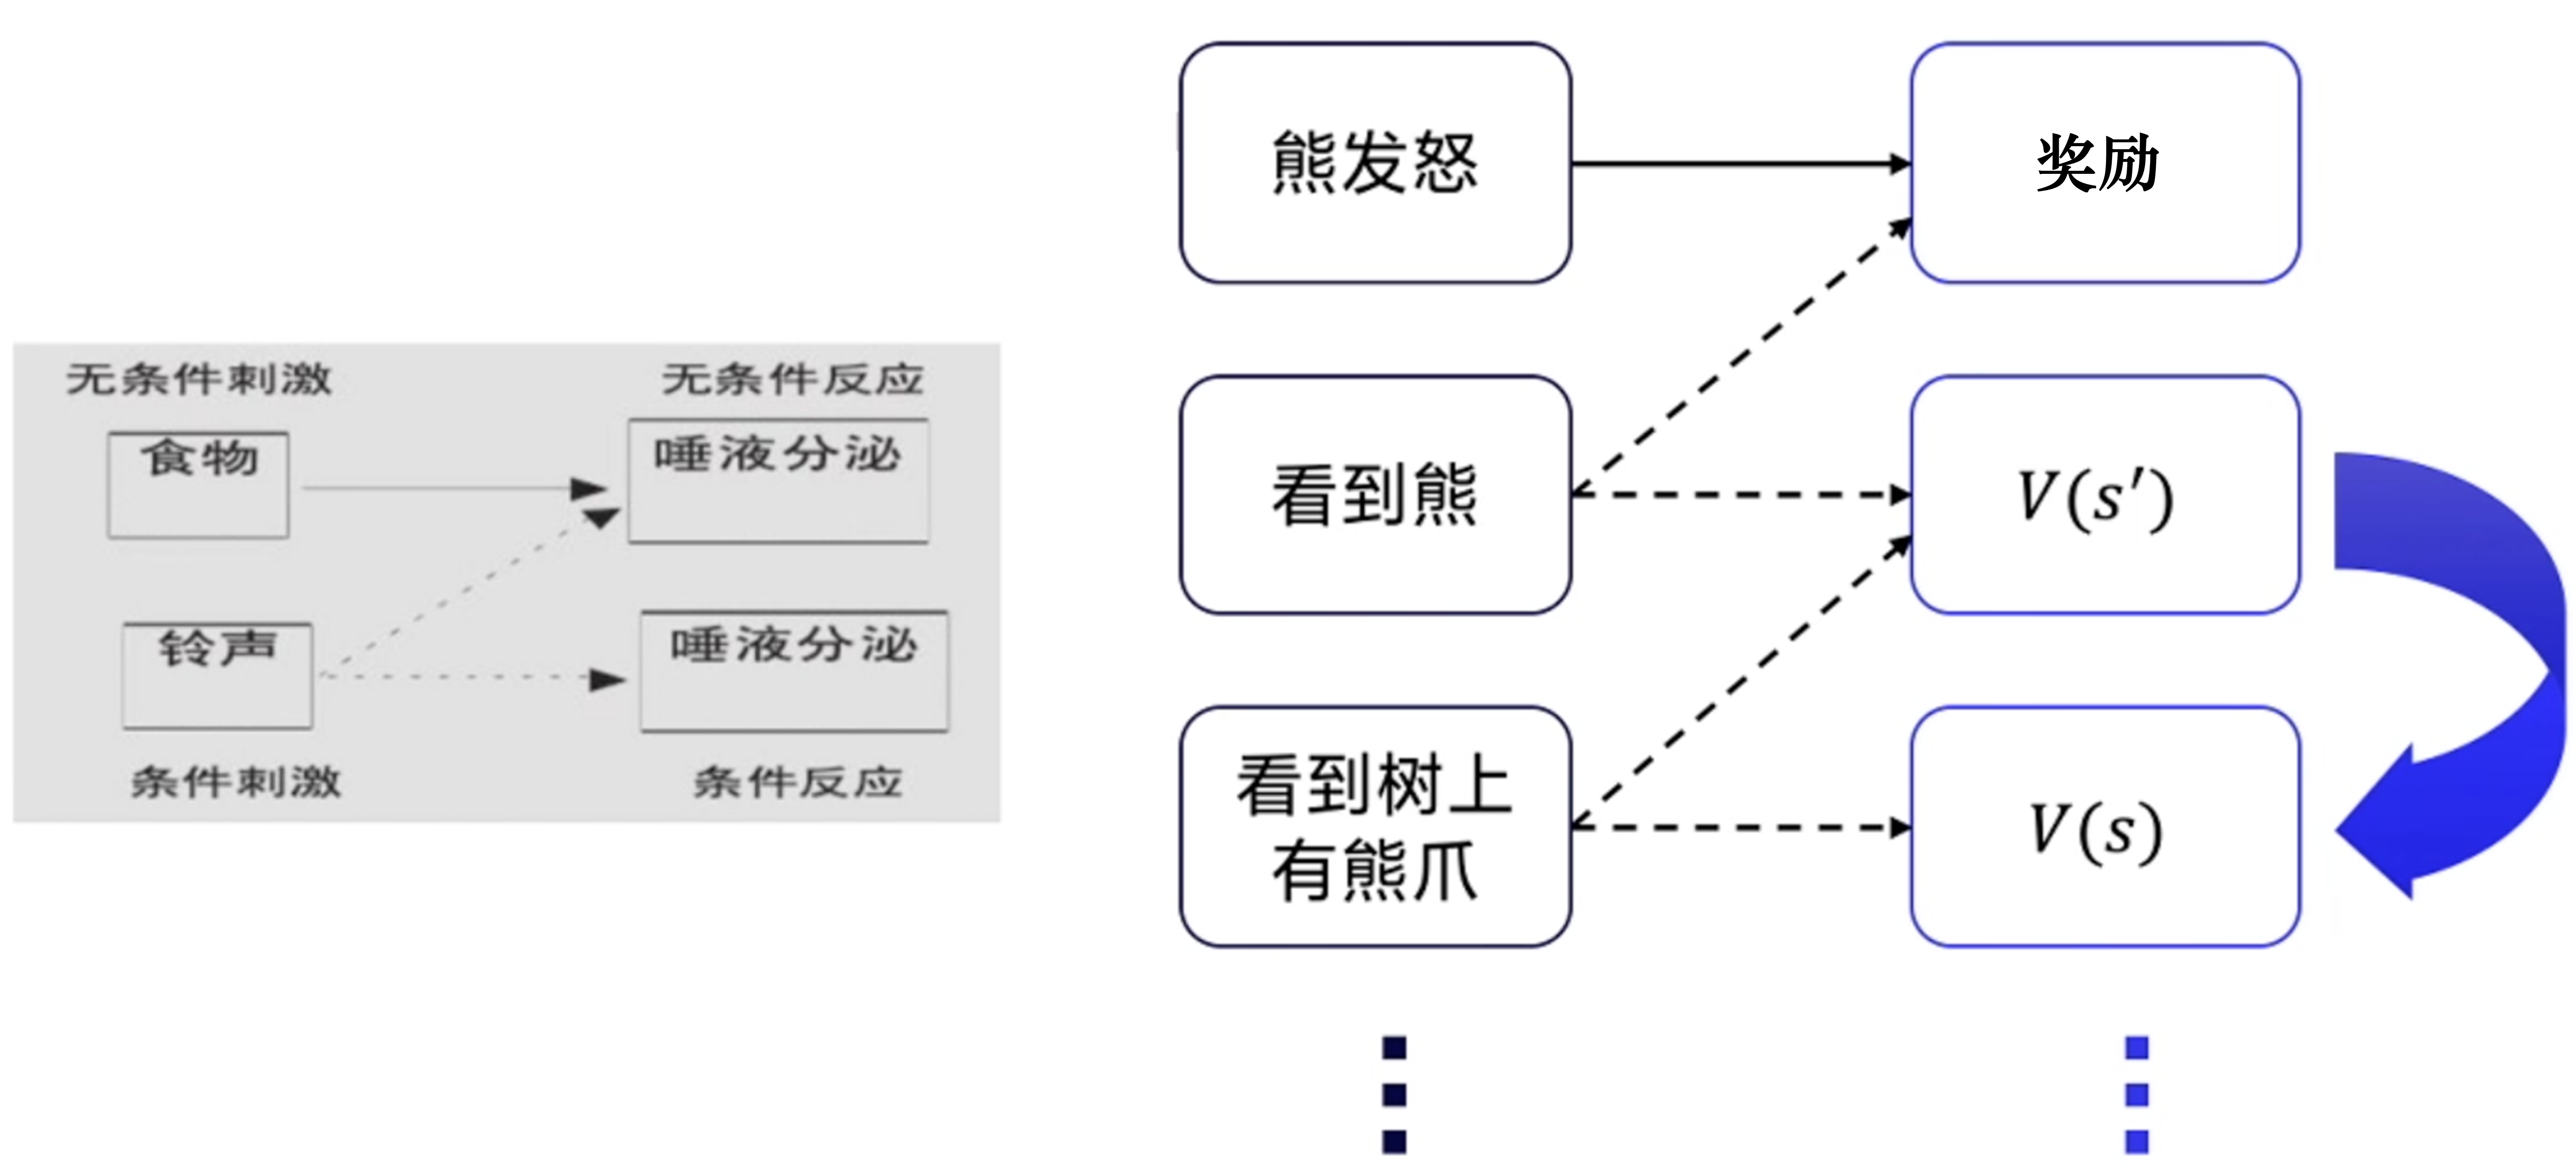
问题1:方差和偏差 / 如何提高对值函数估计
问题2:提高探索性以及平衡探索和利用的关系
偏差
预测值和真实值之间的差距方差
预测值的变化范围、离散程度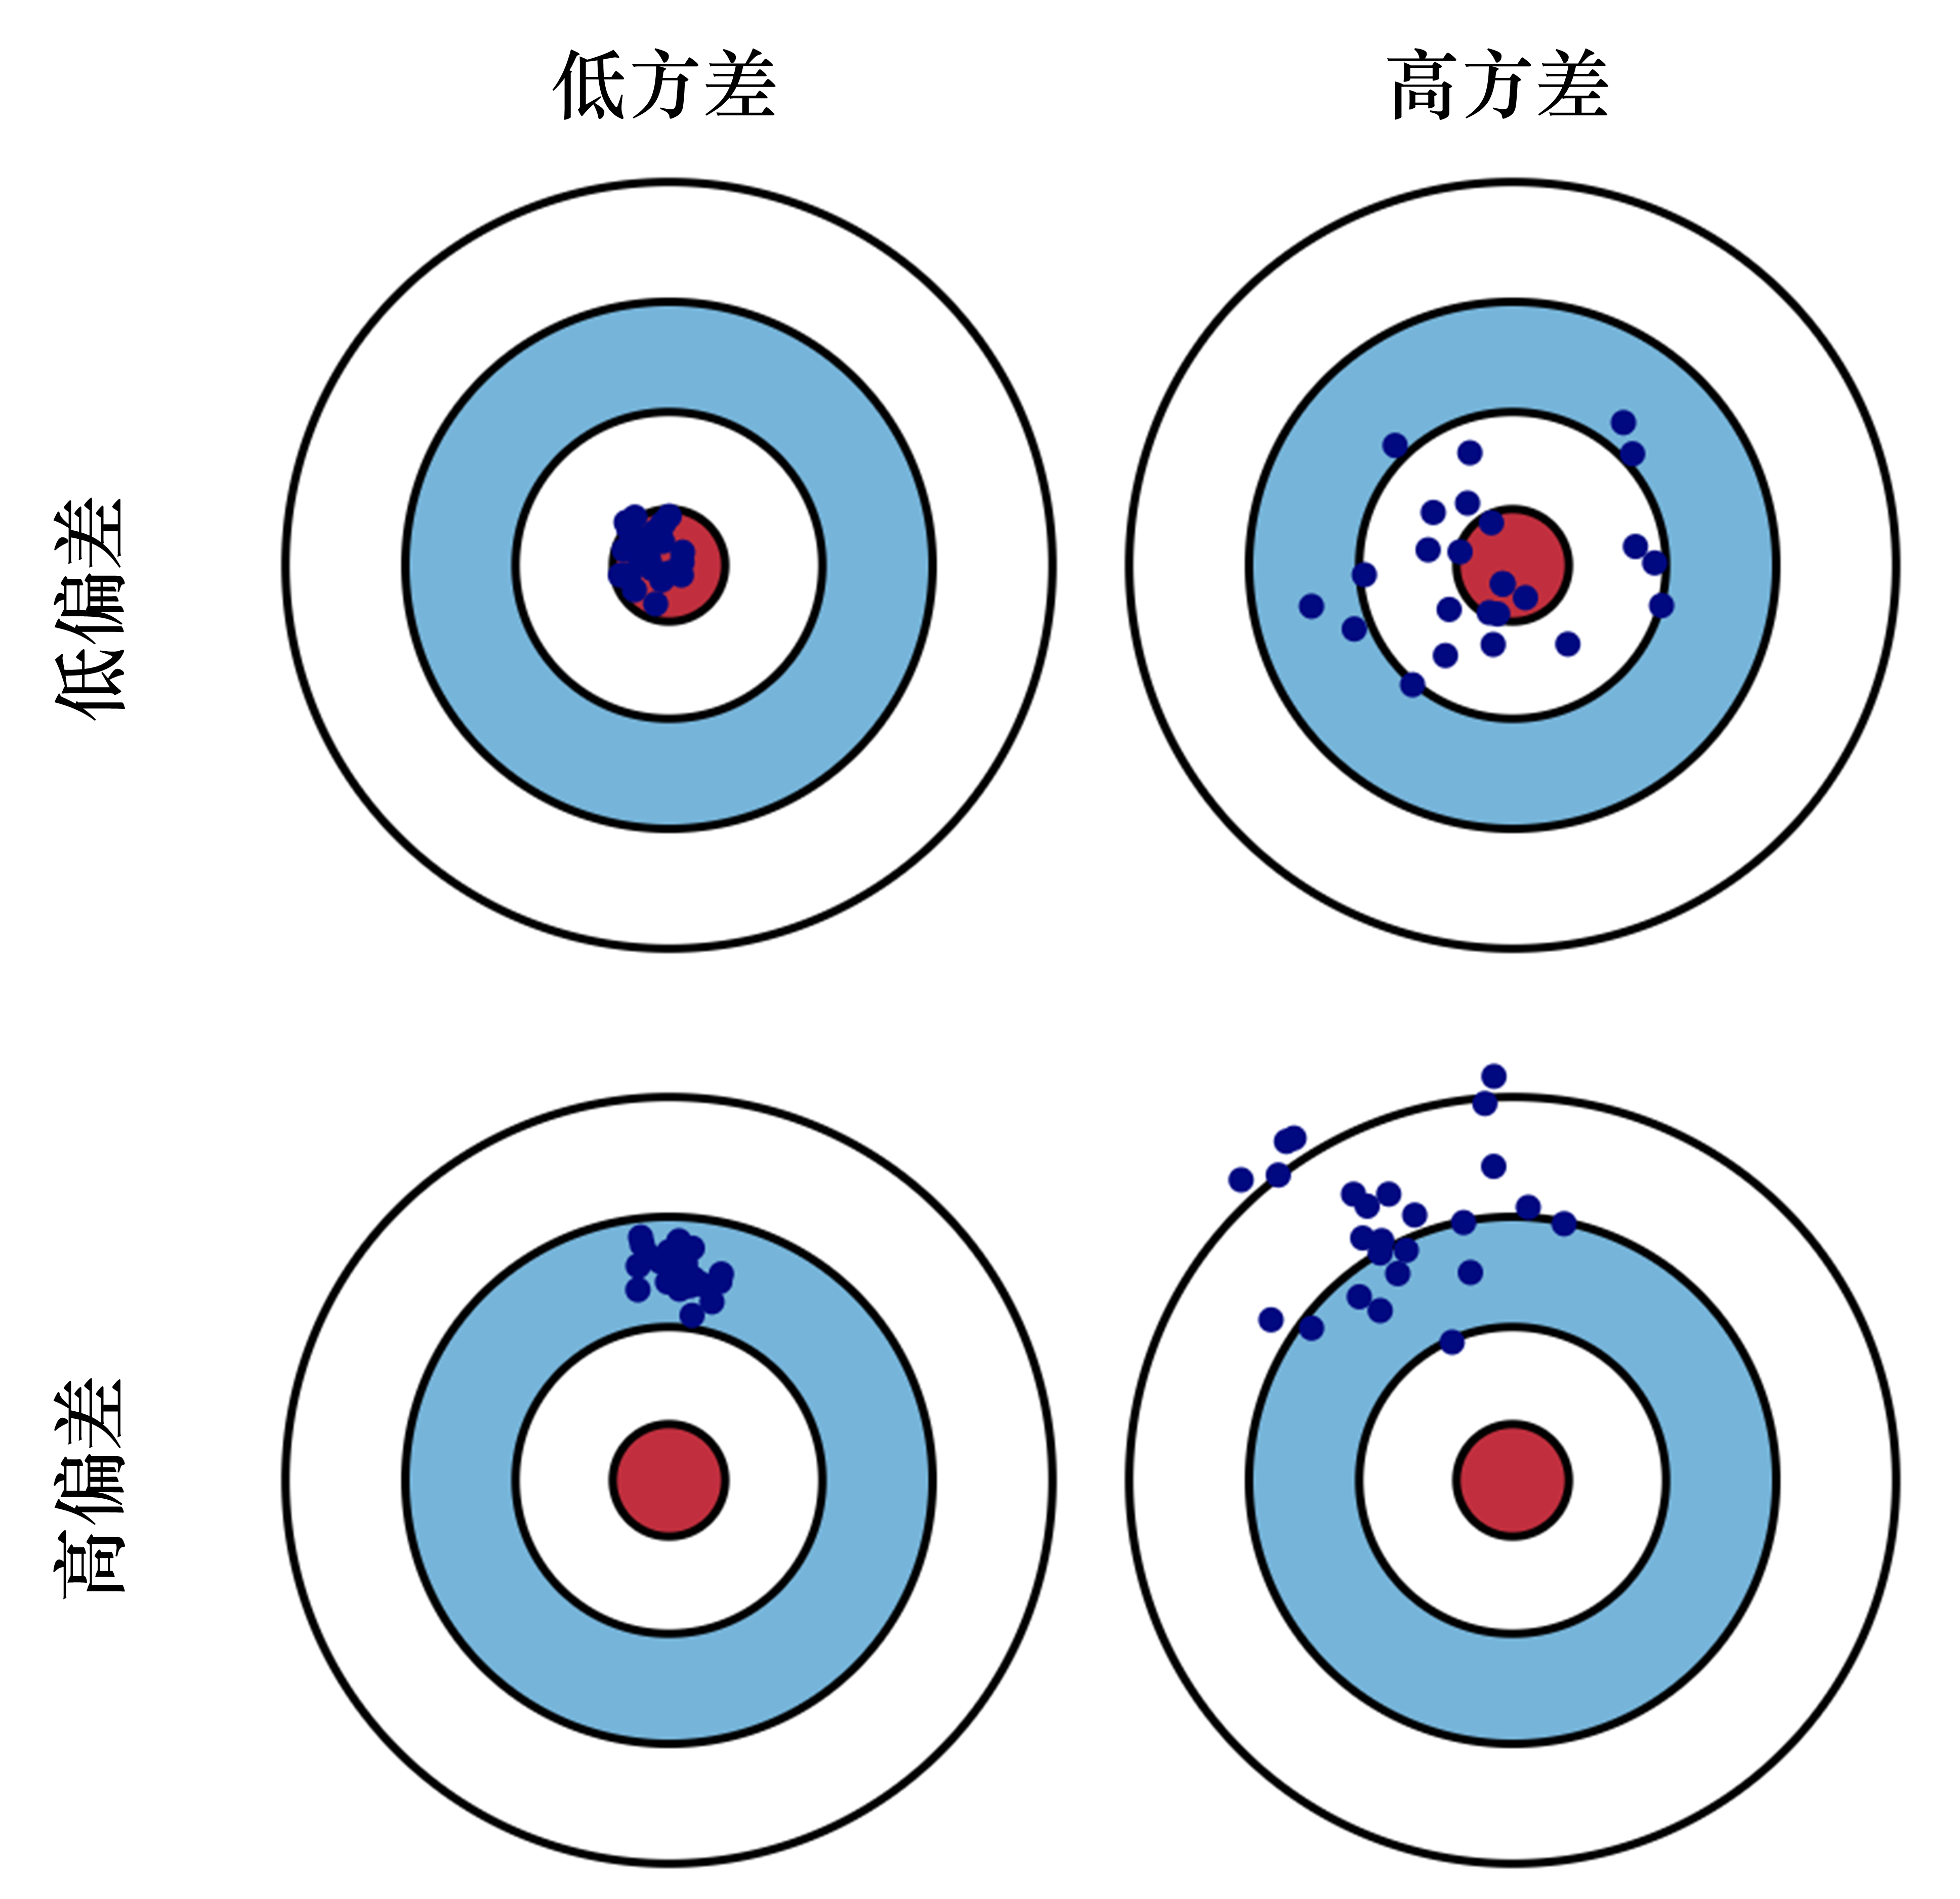
探索
尝试不同动作来得到最佳策略。试错探索,去理解 采取的动作 到底好不好一无所有,也可能小概率超过所有已知动作。仅探索
所有机会 平均分配给每个动作优点
K-臂赌博机示例)缺点
失去 选择最优动作的机会(最优臂)环境已知无需探索 (状态转移概率、奖励函数)
环境已知且可计算时,可通过planning直接求解最佳策略,无需RL,无需探索。
若环境已知但不可计算,环境仍然存在未知性。
在RL中环境大都具有未知性
仅利用
不尝试新动作,利用已有经验 采取最优动作,仅选最优动作。优点
缺点
可能错过更优动作,陷入局部最优。如无法很好估计每个摇臂的期望奖励。面临一个未知或部分已知的环境时
若不探索,就无从获得有价值的新信息若过度探索,则会浪费一些机会成本,不能稳定地得到高回报仅探索或仅利用,是矛盾的,加强一方会削弱另一方,都无法使最终累计奖励最大化
想要累计奖励最大,需要在探索和利用之间做好折中
Value-Based RL
价值函数来评估状态动作的好坏,根据价值函数指导的最佳动作来进行探索。探索策略
选择价值最大的动作,容易陷入局部最优随机选一个动作;前期偏探索,后期偏稳定。每次选择都可能偏离主线,这里做一点那里做一点,结果什么都学不好。并重复执行z步。 避免浅尝辄止、反复左右横跳。从概率分布中采样,本身就有随机性探索。UCB/乐观估计:面对不确定性时的乐观主义
对尚未充分估计的Q值 乐观一些,吸引智能体去尝试动作,收集信息,减少不确定性。
玩1台老虎机时,考虑这台机器过去的平均收益(利用) + 多大的不确定性(探索)。
但了解很少、玩的次数少,可能隐藏大奖 真实收益存在很大不确定性。不确定性本身吸引力就很高。为每台机器计算一个潜力得分/UCB,综合已知平均收益和不确定性带来的潜在收益。
UCB值 = 平均奖励 + 探索项,如下公式:
策略随机即探索
以概率分布输出动作,而非单一动作策略是随机的,天然就带有一定程度的探索。熵增强/Entropy Regularization
加入熵分布尽量平滑,防止过早收缩到单一动作,维持一定探索。降低熵系数,让策略集中于最佳动作。内在回报/Intrinsic Reward
给探索行为添加额外奖励,更新策略时自动倾向于未见过的状态。类比给自己的好奇心奖励。环境新颖度、状态不确定度等。先学习环境模型
先学习或使用一个环境模型,在模型内部规划/搜索/模拟,找到最优策略。
在模拟时主动探索位置区域,同时可利用大量已知部分做规划,兼顾速度和准确性。
在探索时探索
在模拟时探索
基于模型不确定性的鼓励
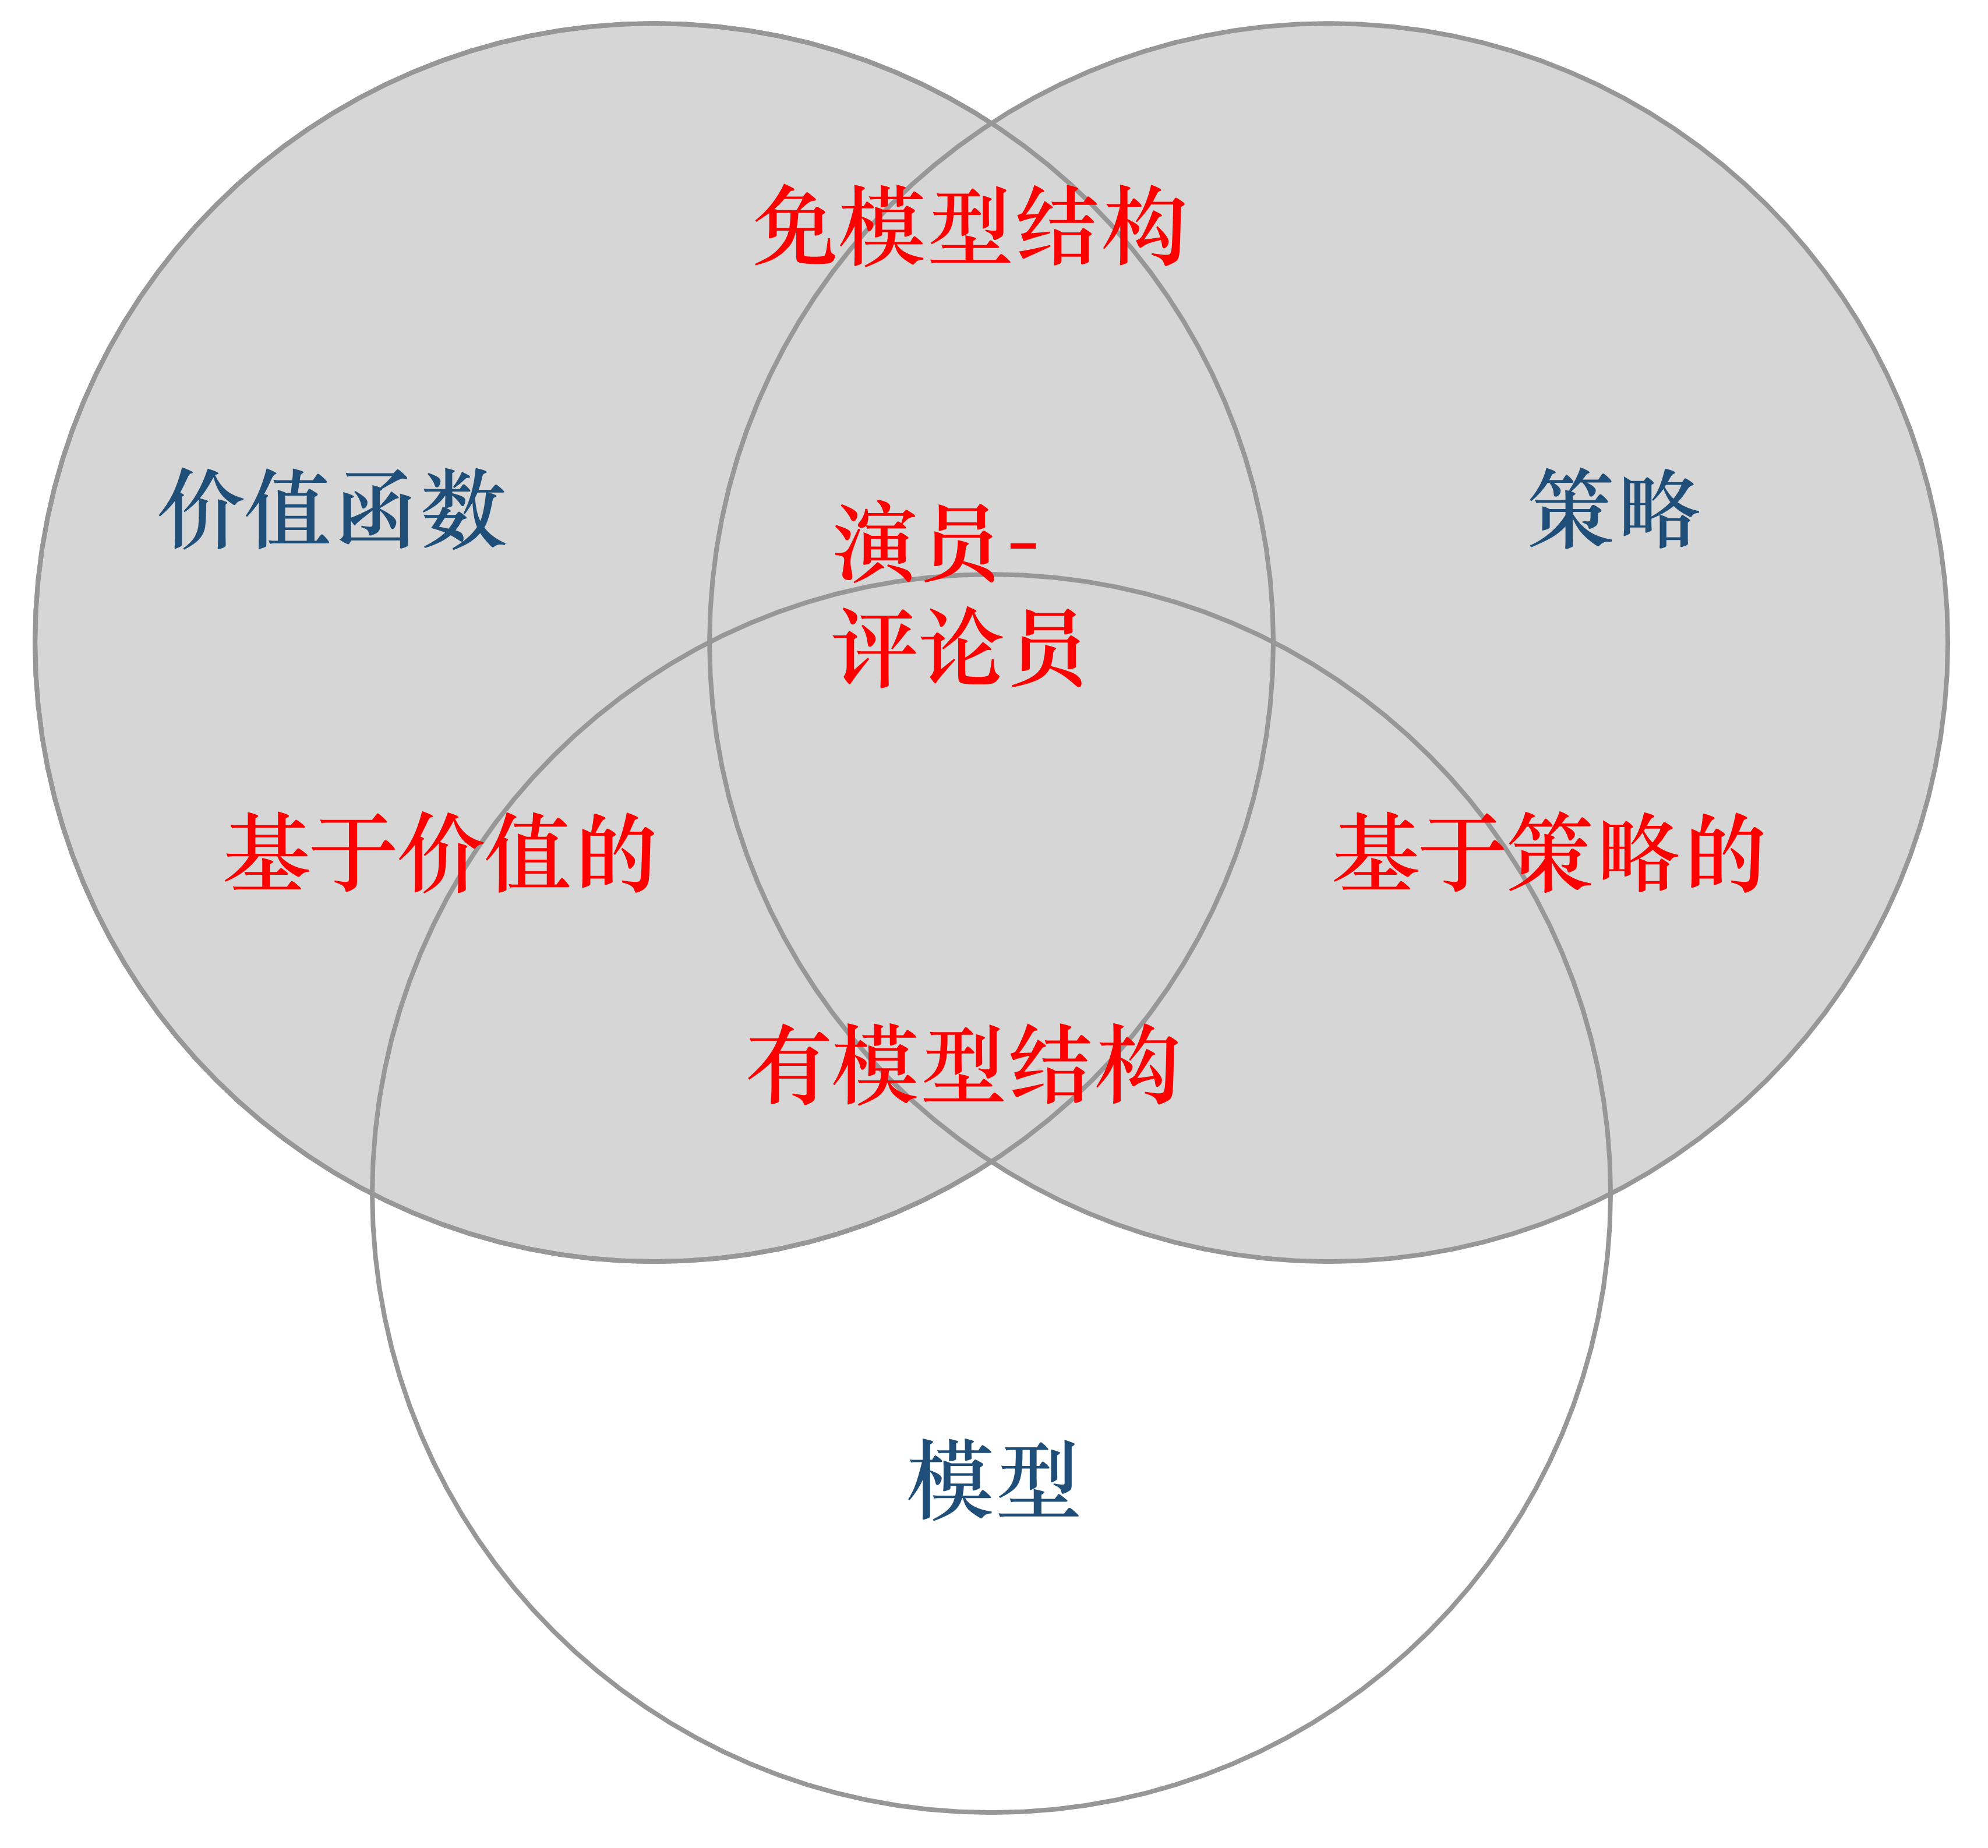
两个重要实体:策略 价值函数
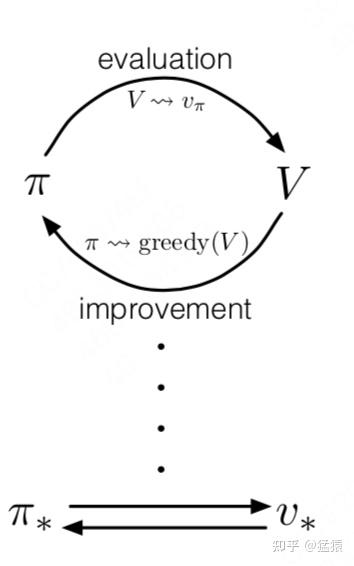
从决策方式来看,RL可以划分为基于价值的方法和基于策略的方法。
Value-based RL
只有价值实体,显示学习价值函数,利用价值函数来指导策略做决策
利用价值函数 衡量哪个状态/动作的价值最大。
隐式学习/制定策略,策略是根据价值函数推算出来的。
策略更新
MC采样+时序差分来估计价值函数;选择价值最大的动作 来更新策略。缺点
价值函数某步产生偏差时,会逐渐积累,导致估计价值 方差很高典型算法
核心思想
直接对策略进行优化,在每个状态输出最佳动作,使其获得最大奖励。不学习价值函数策略更新
通过策略和环境交互多次,采样足够多的轨迹数据,用这些数据 对策略的价值做评估。
根据轨迹的价值期望来确定策略迭代方向。
类比
驾驶员(策略),同时训练导航工具(价值函数)。价值函数只告诉策略当前方向对不对,不直接干涉驾驶员的决策。优点
价值函数(导航工具) 出现偏差时,策略(驾驶员) 结合经验可直接纠正策略(驾驶员) 决策出错时,价值函数(导航工具) 也可及时纠正错误典型算法
Actor-Critic (结合价值和策略)
策略价值函数。策略 做出动作,价值函数 对动作给出价值,在原本策略梯度上加速学习环境
智能体交互的对象,可以是物理世界、游戏、软件系统或仿真环境。环境模型:
用于预测 执行动作后,环境如何变化、获得什么奖励
核心包括:状态转移概率:奖励函数:
通常难以获得完整、准确的环境模型,可以通过交互数据或已有数据 学习近似模型。
分类依据
算法是否利用环境模型 进行规划或辅助学习,而非判断是否与真实环境交互。
这里的模型特指环境模型。拥有策略网络或价值网络,并不意味着属于 Model-Based。
定义特点
利用环境模型,预测动作的后果,进行规划、生成模拟经验 或辅助训练策略。预先已知的,例如游戏规则、物理方程;也可以是从数据中学习的。环境交互经验和模型生成的模拟经验,不要求完全脱离实际环境。收集数据 → 学习或更新环境模型 → 利用模型规划或训练 → 继续交互。优点
已有经验可同时用于学习策略+学习环境模型,进而生成更多模拟经验。可以预测 若采取某个动作 接下来可能发生什么,比较不同动作或动作序列。减少昂贵的实际交互。缺点
预测不准确时,可能导致错误的规划或策略更新。前面的预测偏差可能影响后续预测。增加计算开销。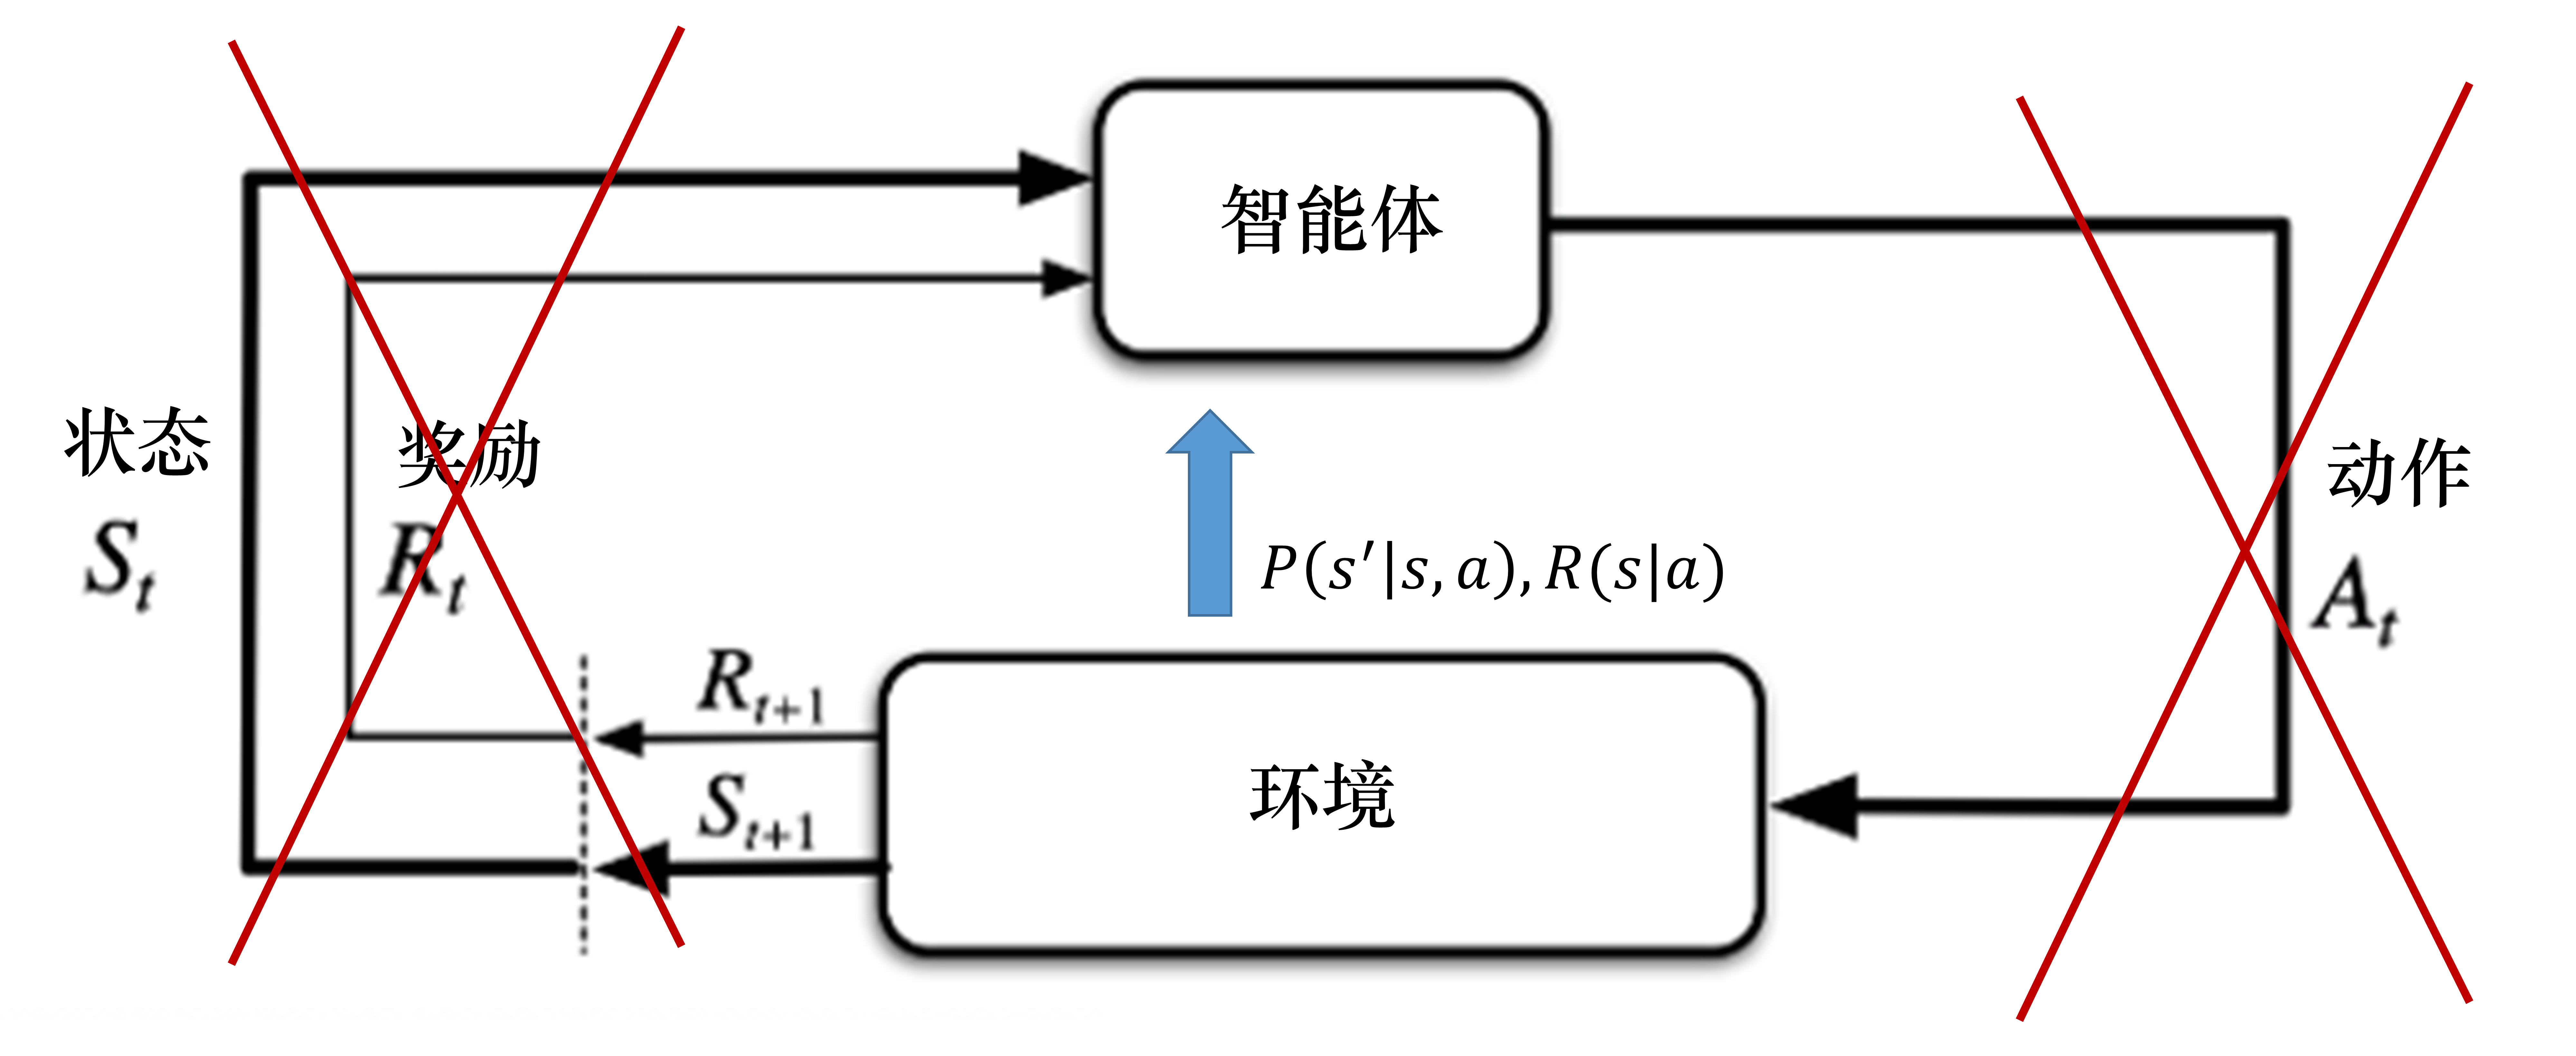
定义
利用经验数据 学习策略函数或价值函数,不依赖环境模型 来推演动作后果。状态、动作、奖励、下一状态,更新策略或价值估计,逐步改善表现。物理环境、游戏、仿真器,也可是已有的离线数据。特点
直接学习如何决策:学习应该选什么动作或 某个动作的长期收益有多大。足够的经验数据。用神经网络表示策略或价值函数;有神经网络 ≠ 有环境模型。优点
避免环境模型误差对规划的影响。方法成熟,通常较容易实现和使用。缺点
大量经验样本才能学到较好策略。无法直接利用环境模型推演尚未实际经历的动作结果数据稀缺、交互昂贵时,学习可能较困难。适用场景
环境难以准确建模,但能获取足够的交互数据或已有数据。不限于简单、确定的问题。Q-learning、DQN、PPO、SAC。免模型RL
多个agent的环境下进行强化学习,环境状态 受多个智能体共同影响通信信号问题:多个智能体如何高效通信。信用分配问题:合作任务中,如何确定每个Agent 对整体目标的贡献。模仿学习
奖励函数难定义或策略很难学的情况下,通过模仿人类行为来学习一个较好策略。
典型:行为克隆,把状态-动作视为一个训练样本,通过SFT来学习策略。
存在分布漂移(泛化性)的问题。
也就是26年流行的蒸馏?
逆强化学习
观察人类行为,来学习奖励函数,通过RL来学习策略。背景
思路1:离线强化学习
思路2:世界模型
世界模型,并部署到在线环境进行决策。世界模型:预测下一个状态控制器:根据当前状态来决策动作背景
思路1:联合训练
奖励进行加权求和,来学习一个策略。思路2:分层强化学习
当前任务当前任务的动作