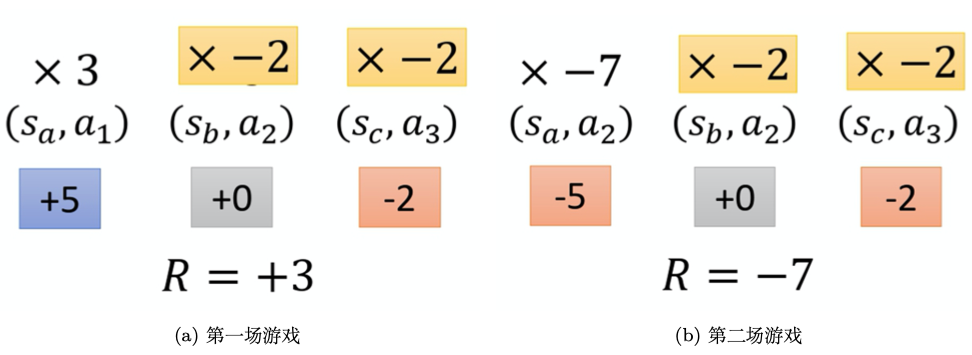Skip to content

策略梯度算法

📅 发表于 2025/08/30
🔄 更新于 2025/11/24
👁️ — 次访问
📝 2522 字
⏳ 9 分钟
rl-theory
#策略梯度
#轨迹概率
#轨迹回报
#对数微分技巧
#梯度上升法
#策略梯度目标函数
#策略梯度loss
#策略函数设计
#logits_p
#权重
#基线
#优势函数
#降低方差
#策略梯度分类
#蒙特卡洛策略梯度
#时序差分策略梯度
#REINFORCE算法
#REINOFRCE++

基于策略的算法 ​

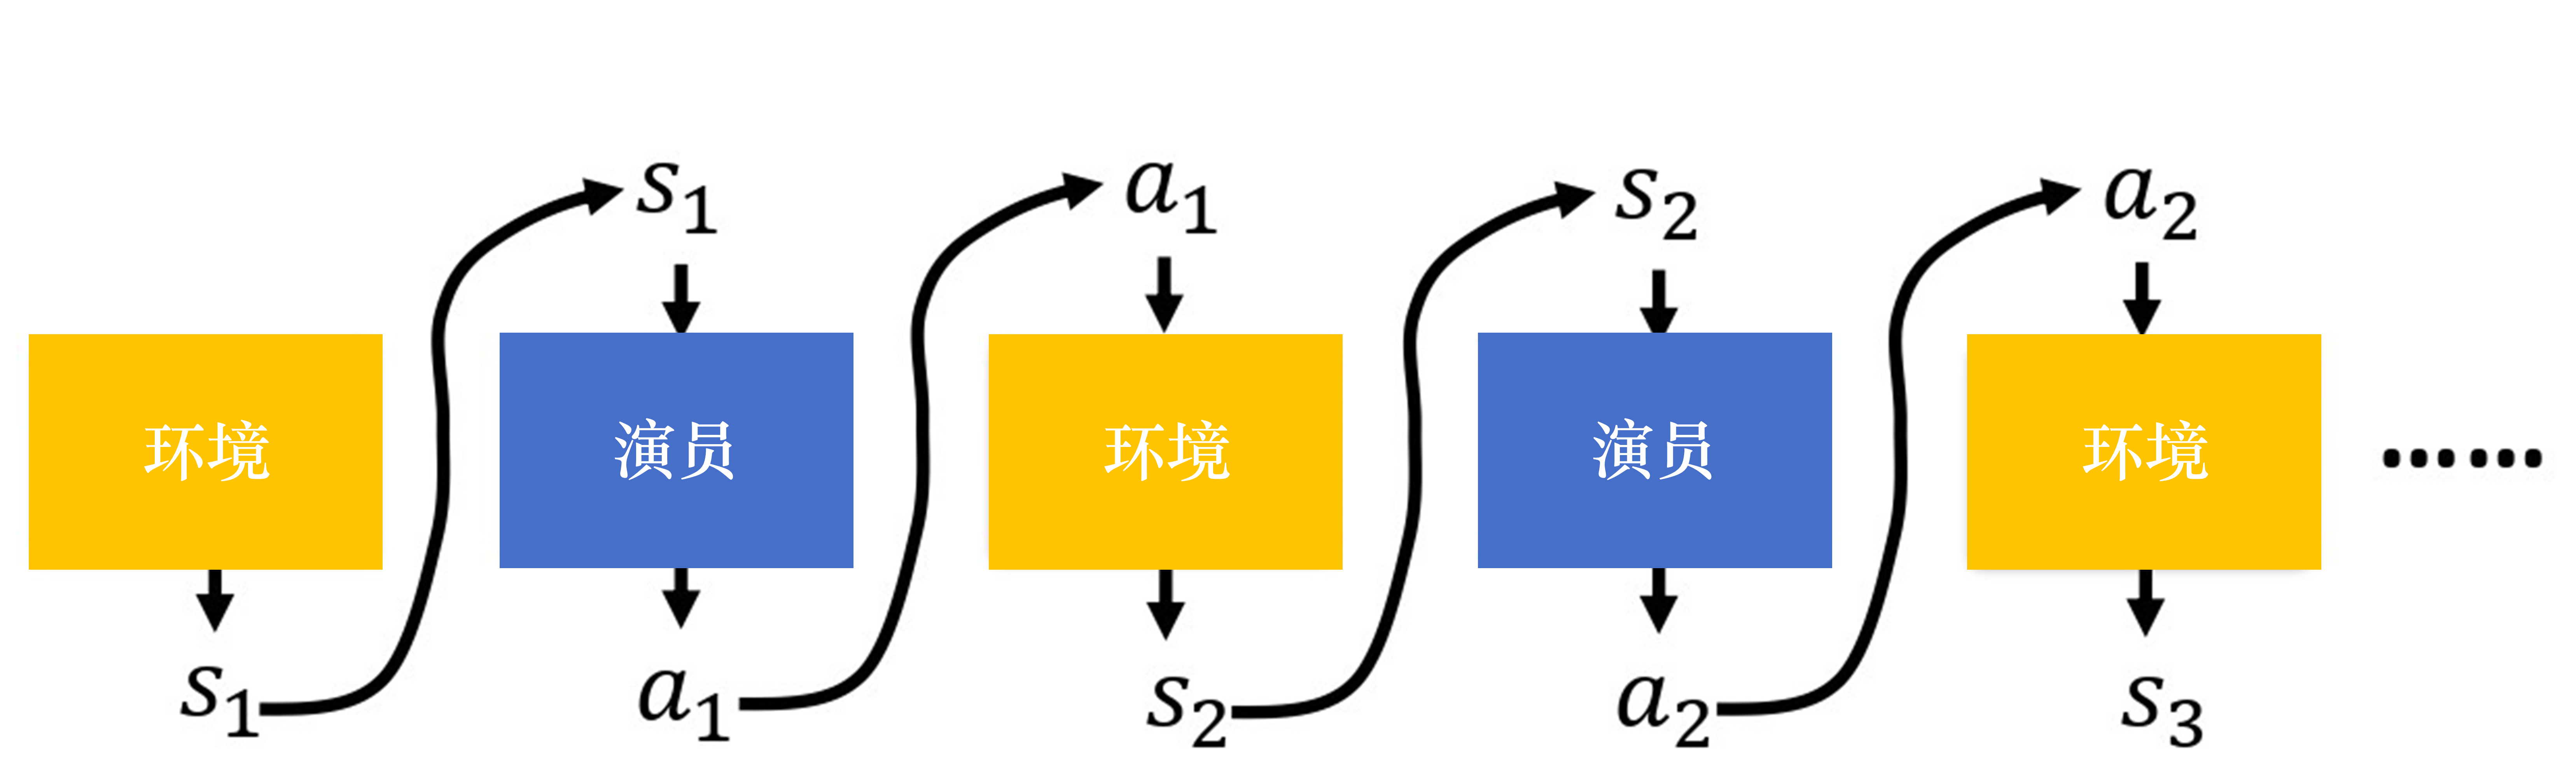
对策略参数化,直接对策略进行优化。

笔记

Value-based RL

  • 先学习价值函数V或Q,根据价值函数间接指导策略改进。

Policy-based RL

  • 对策略进行参数化,直接对策略进行优化。没有V或Q做中间商。
  • 优点
    • 可处理连续动作空间
    • 直接使用神经网络进行建模

策略梯度算法 ​

假设策略πθ(a∣s),是关于θ的连续可微函数;用梯度上升算法 直接对策略参数θ进行优化。

使目标函数J(θ)最大,J(θ)是该策略下所有轨迹回报的期望值。

J(θ)=Eτ∼pθ(τ)[R(τ)]=∑τpθ(τ)⋅R(τ)

目标函数 ​

目标函数

轨迹概率pθ(τ)

pθ(τ)=p(s0)⋅πθ(a0∣s0)p(s1∣s0,a0)⋅πθ(a1∣s1)p(s2∣s1,a1)⋯=p(s0)∏t=0Tpθ(at∣st)⏟选择动作⋅p(st+1∣st,at)⏟状态转移

目标函数J(θ)

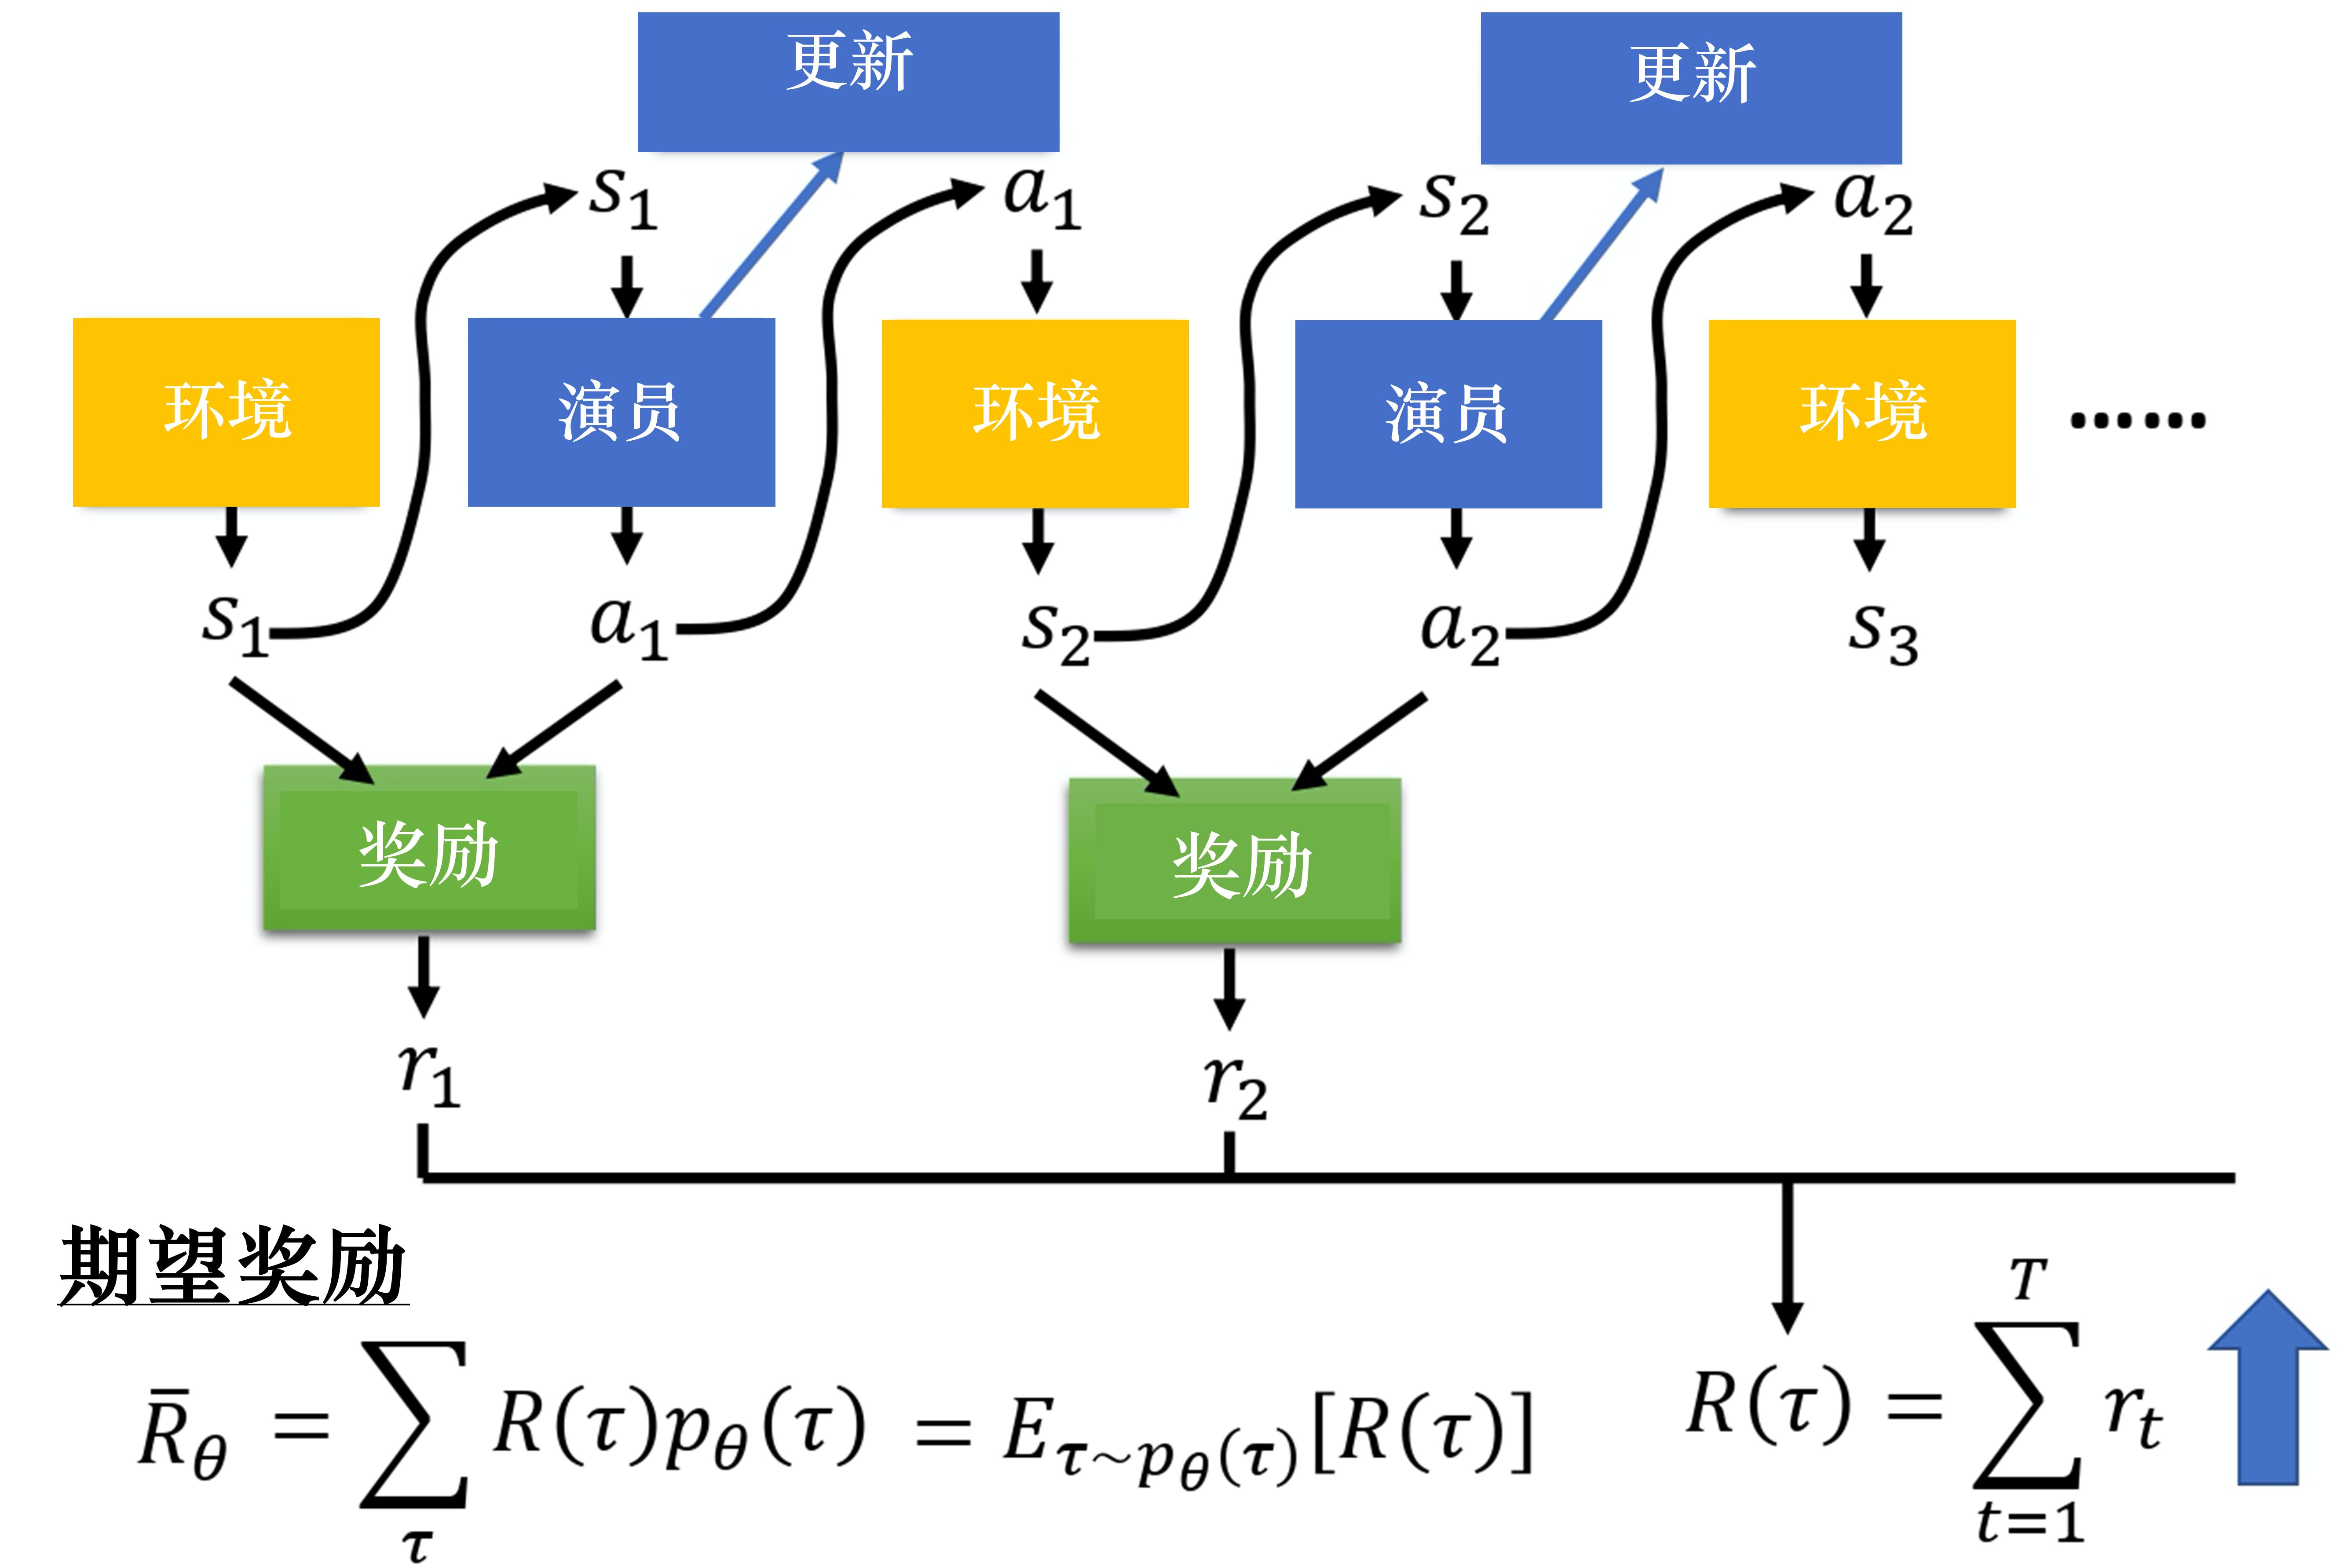
  • 策略的价值期望/期望奖励,所有轨迹回报的期望值。

  • 调整演员内部参数θ,使得Rθ的期望值最大

J(θ)=R¯πθ=Eτ∼pθ(τ)[R(τ)]=∑τpθ(τ)⋅R(τ)

轨迹奖励回报 ​

轨迹奖励回报

R(τ),Gt,Gtn

  • R(τ) 是一个随机变量,非标量,和策略参数θ无关。
  • 在同一状态下 采取的动作不一定相同,策略依概率选择,有随机性
R(τ)=G(τ)=r0+γr1+⋯γTrT=∑t=1Tγt−1rt
  • Gt:某条轨迹从时刻t开始到结束的 累计奖励
Gt=∑k=t+1Tγk−t−1⋅rk=rt+1+γ⋅Gt+1
  • Gt:t+n:时刻t到t+n的n步累积奖励。

    Gt:t+n=rt+1+γrt+2+γ2rt+3+⋯+γn−1rt+n+γnV(st+n)
  • Gtn:第n条轨迹 从t时刻到结束的 累计奖励

Gtn=∑k=t+1Tnγk−t−1⋅rkn=rkn+γGt+1n

轨迹

目标函数,期望奖励

策略梯度定义 ​

策略梯度定义

目标函数

J(θ)=∑τR(τ)⋅pθ(τ)=Eτ∼pθ(τ)[R(τ)]

策略梯度

∇J(θ)=∑τR(τ)⋅∇pθ(τ)

策略梯度推导结果

∇J(θ)=1N∑n=1N∑t=0TnG(τn)⋅∇log⁡pθ(atn∣stn)∇J(θ)=1N∑n=1N∑t=0TnG(τn)⏟权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度

两个对数技巧 ​

两个对数技巧

对数定义

  • 对数定义:log⁡(x)=loge⁡(x),国际新标log是以e为底的对数
y=log⁡(x)→ey=x
  • 对数导数
f(x)=log⁡(x)→f′(x)=log′⁡(x)=1x

导数链式法则

g(x)=log⁡f(x)  →  g′(x)=log′⁡(f(x))=1f(x)⋅f′(x)

对数乘法公式

log⁡(ab)=log⁡a+log⁡b

对数微分技巧‼️

∂log⁡f(x)∂x=1f(x)⋅f′(x)  →  ∇log⁡f(x)=1f(x)⋅∇f(x)∇f(x)=f(x)⋅∇log⁡f(x)

策略梯度推导过程 ​

策略梯度推导过程

1. 对数拆解梯度∇pθ(τ)

  • 对数微分,拆解为期望形式
∇J(θ)=∑τR(τ)⋅∇pθ(τ)=∑τR(τ)⋅pθ(τ)⋅∇log⁡pθ(τ)=Eτ∼pθ(τ)[R(τ)⋅∇log⁡pθ(τ)]
  • 推导结果
∇J(θ)=Eτ∼pθ(τ)[R(τ)⋅∇log⁡pθ(τ)]

2. 细拆轨迹概率梯度 ∇log⁡pθ(τ)

  • 代入轨迹概率的 动作策略π和状态转移概率 p,去掉无关项
∇log⁡pθ(τ)=∇log⁡(p(s0)∏t=0Tπ(at∣st)⋅p(st+1∣st,at))=∇(log⁡p(s0)+∑t=0Tlog⁡pθ(at∣st)+∑t=0Tlog⁡p(st+1∣st,at))=∇log⁡p(s0)⏟θ无关, 0+∇∑t=0Tlog⁡pθ(at∣st)⏟θ有关, 非0+∇∑t=0Tlog⁡p(st+1∣st,at)⏟θ无关,0=∑t=0T∇log⁡pθ(at∣st)
  • 推导结果
∇log⁡pθ(τ)=∑t=0T∇log⁡pθ(at∣st)

3. 采样计算策略梯度

  • 采样N条轨迹、代回细拆项求解最终公式
∇J(θ)=Eτ∼pθ(τ)[R(τ)⋅∇log⁡pθ(τ)]=1N∑n=1NR(τ)⋅∇log⁡pθ(τ)=1N∑n=1NR(τn)⋅∑t=0Tn∇log⁡pθ(atn∣stn)=1N∑n=1N∑t=0TnG(τn)⋅∇log⁡pθ(atn∣stn)
  • 推导结果
∇J(θ)=1N∑n=1N∑t=0TnG(τn)⋅∇log⁡pθ(atn∣stn)

参数学习过程 ​

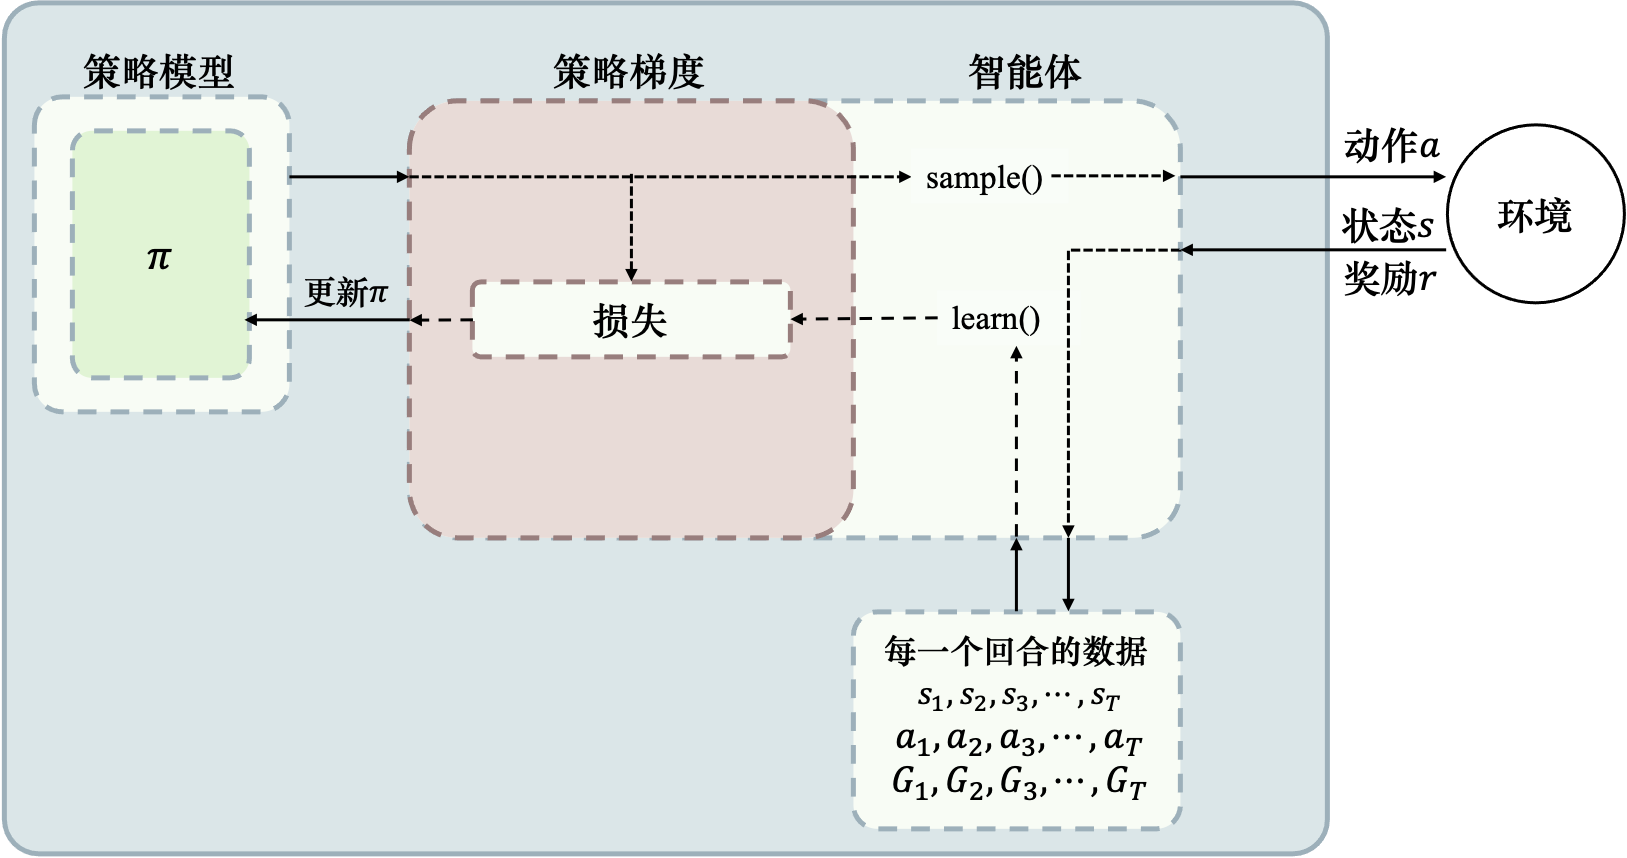
策略梯度学习过程

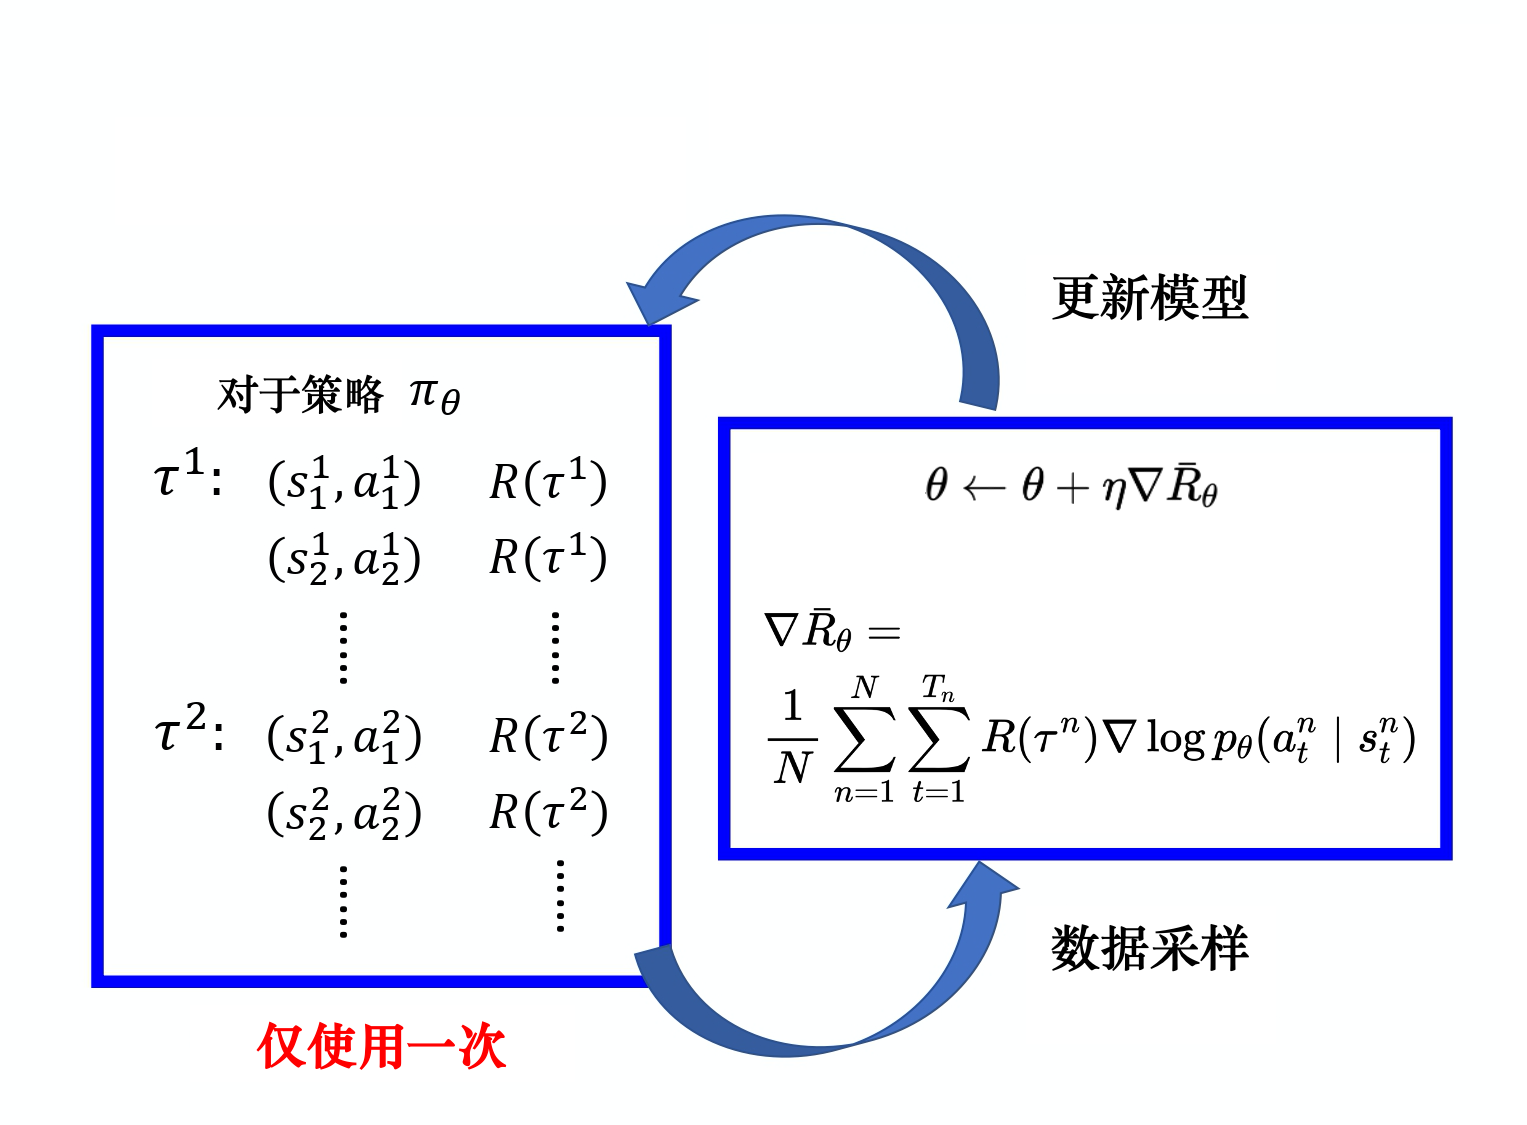
数据采样

  • 利用θ参数的actor和环境交互,采集n条样本,收集每条样本的奖励。
  • 每个样本只使用一次:模型更新完成后 ,需重新采样才能更新模型。

梯度计算

  • 为每一对(s,a)
    • 计算对数概率 log⁡pθ(atn∣stn),
    • 为对数概率取梯度,并乘以权重 ,即回报G(τn)
  • 代入策略梯度函数,求出整体梯度
∇J(θ)=1N∑n=1N∑t=0TnG(τn)⋅∇log⁡pθ(atn∣stn)

梯度上升法做参数更新

  • 最大化目标函数 J(θ)
θ←θ+α⋅∇J(θ)

策略梯度loss ​

策略梯度loss

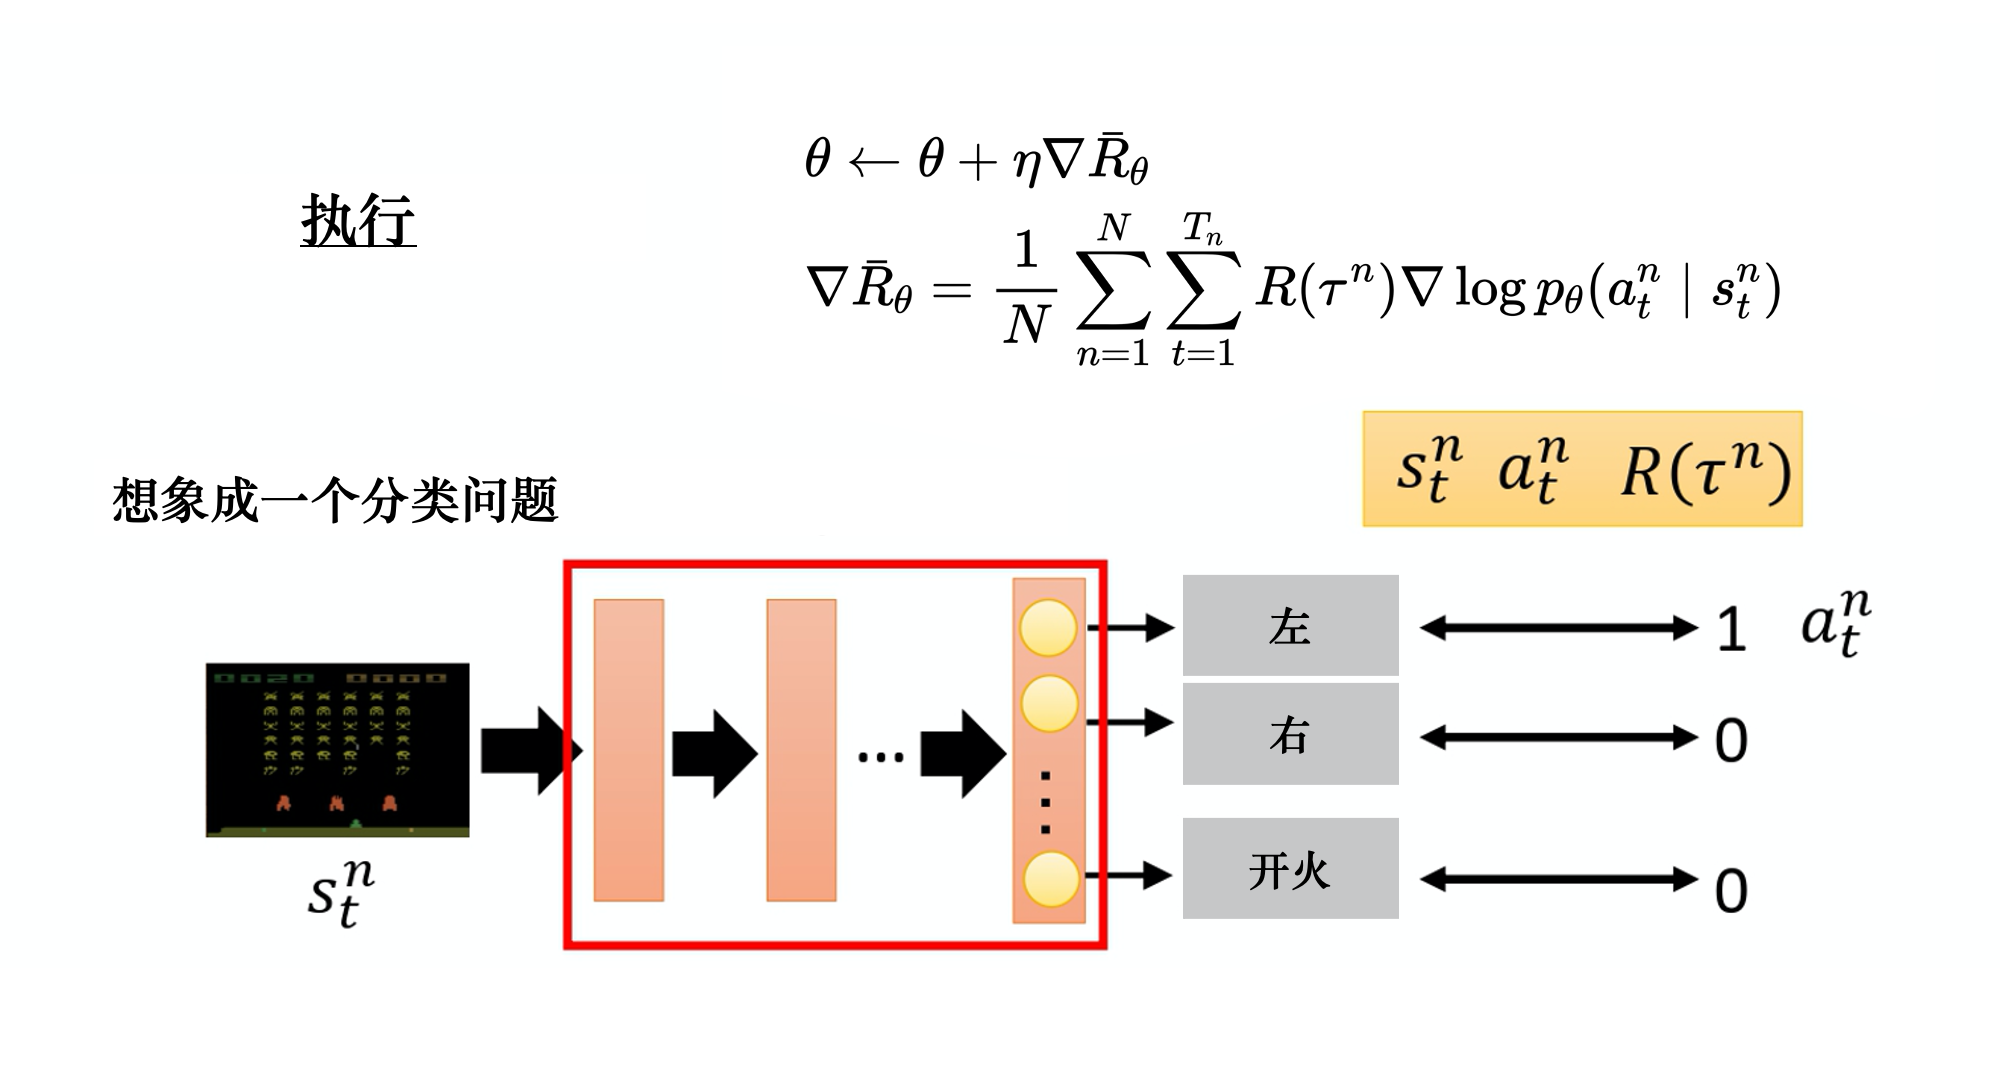
传统交叉熵/监督学习loss

  • 预测值,有真实值,做交叉熵评判准确程度
H(q,p)=−∑x∈Xq(x)⋅log⁡p(x)H(y′,y)=−∑iyi,真实′⋅log⁡yi,预测H(y′,y)=−∑ilog⁡yi,预测

策略梯度loss-轨迹粒度

  • 轨迹回报越高、希望轨迹概率也越高,即二者同分布,使用交叉熵来衡量,非常合适
  • R(τ)代表实际回报,代替真实分布
L(θ)=−∑τ∼pθ(τ)R(τ)⋅log⁡pθ(τ)

策略梯度loss-动作粒度

  • 预测动作,但并没有真实动作 作为参考
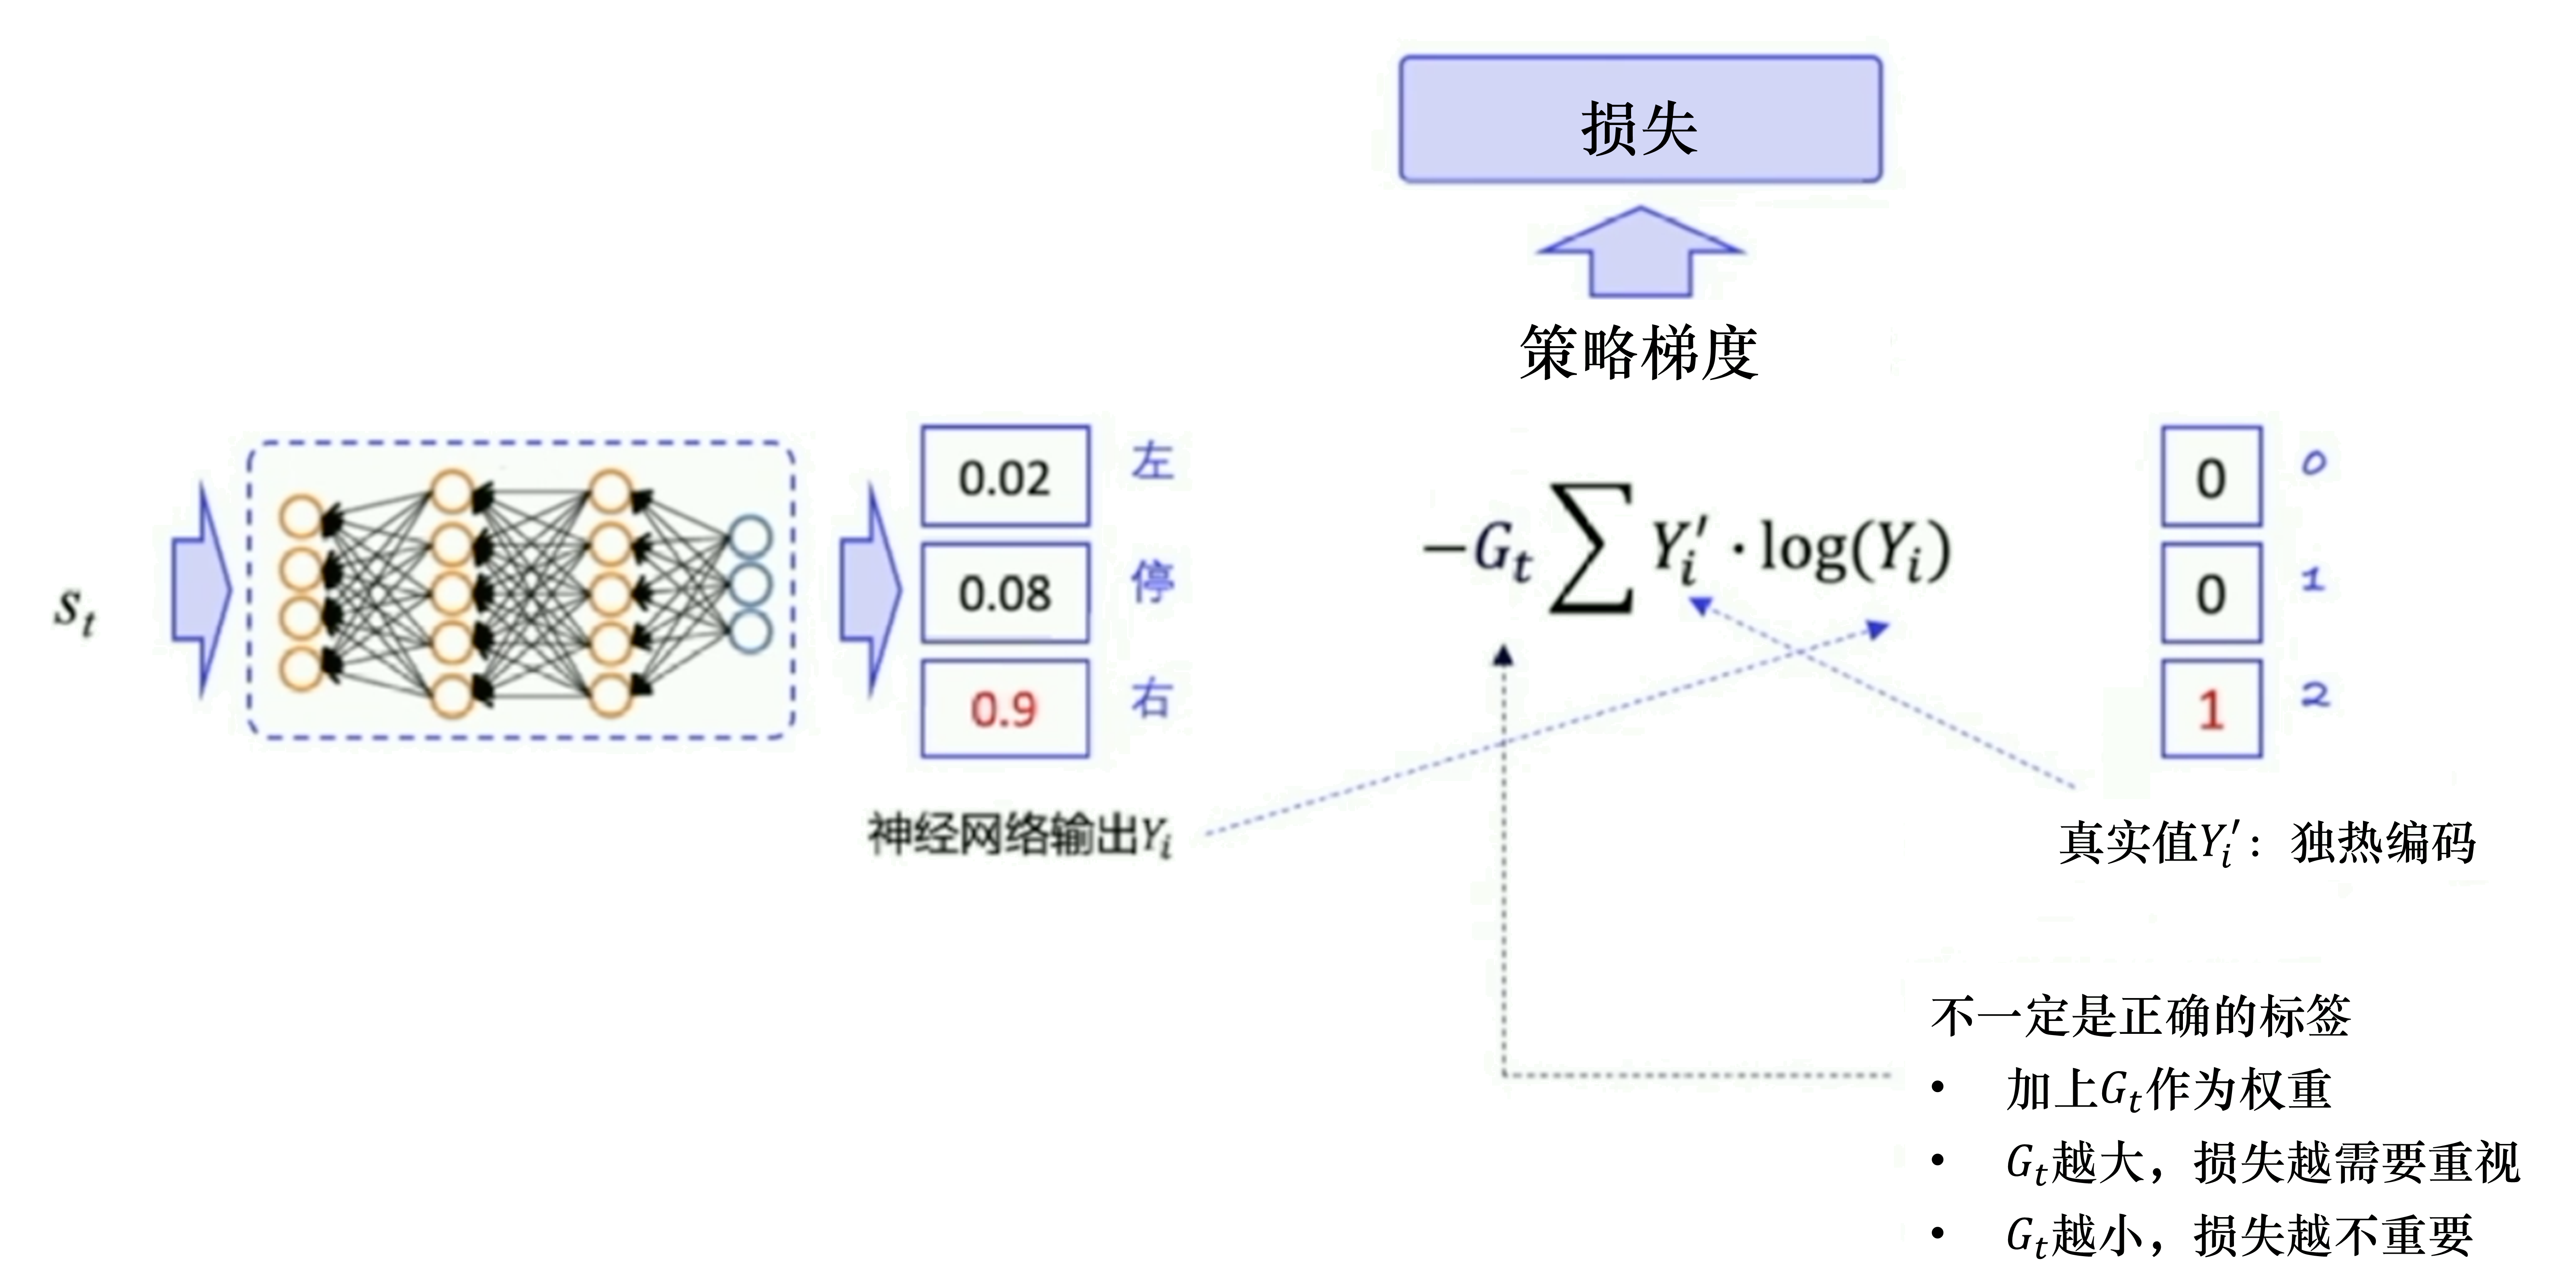
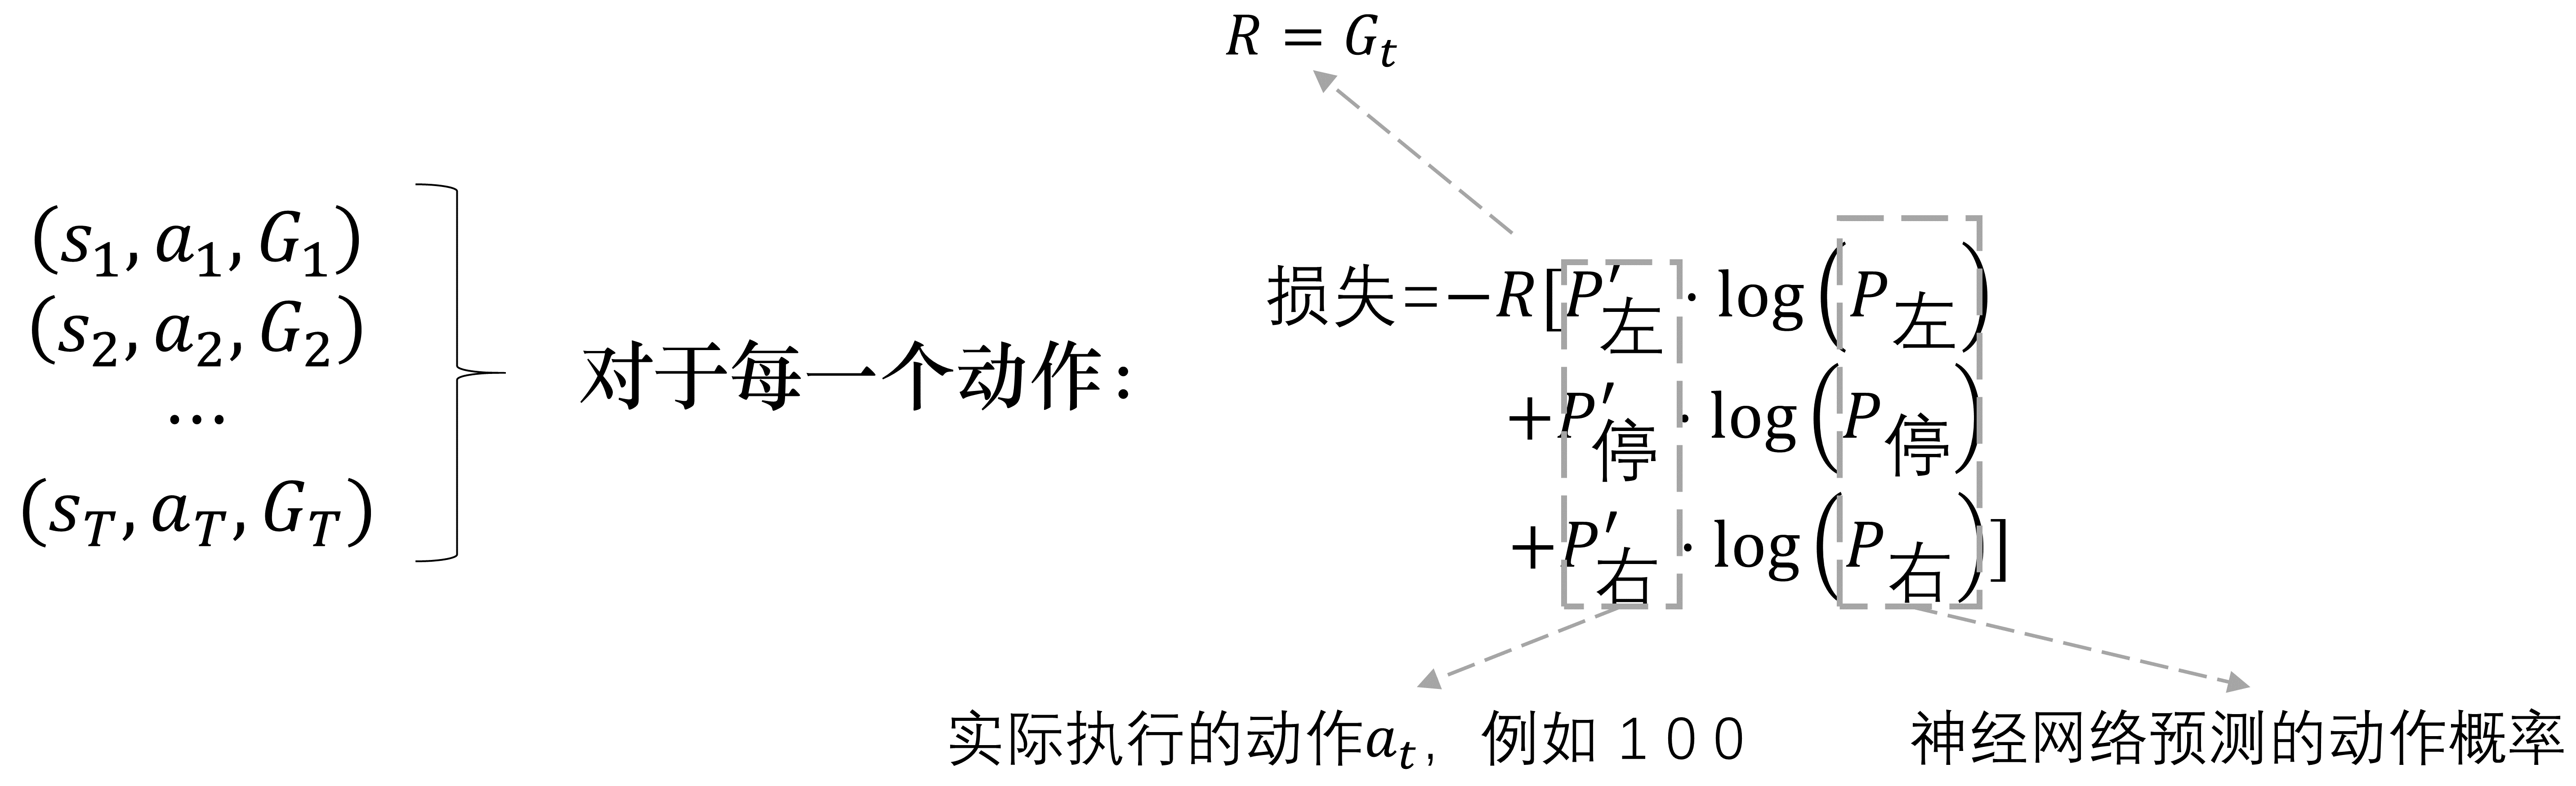
  • 所以使用奖励回报/优势函数等作为权重,表示动作的好坏。
    • 动作回报越小,表明动作at不好,loss权重应该降低,优化粒度小一点
    • 动作回报越大,表明动作at较好,loss权重应该增加,优化粒度大一点
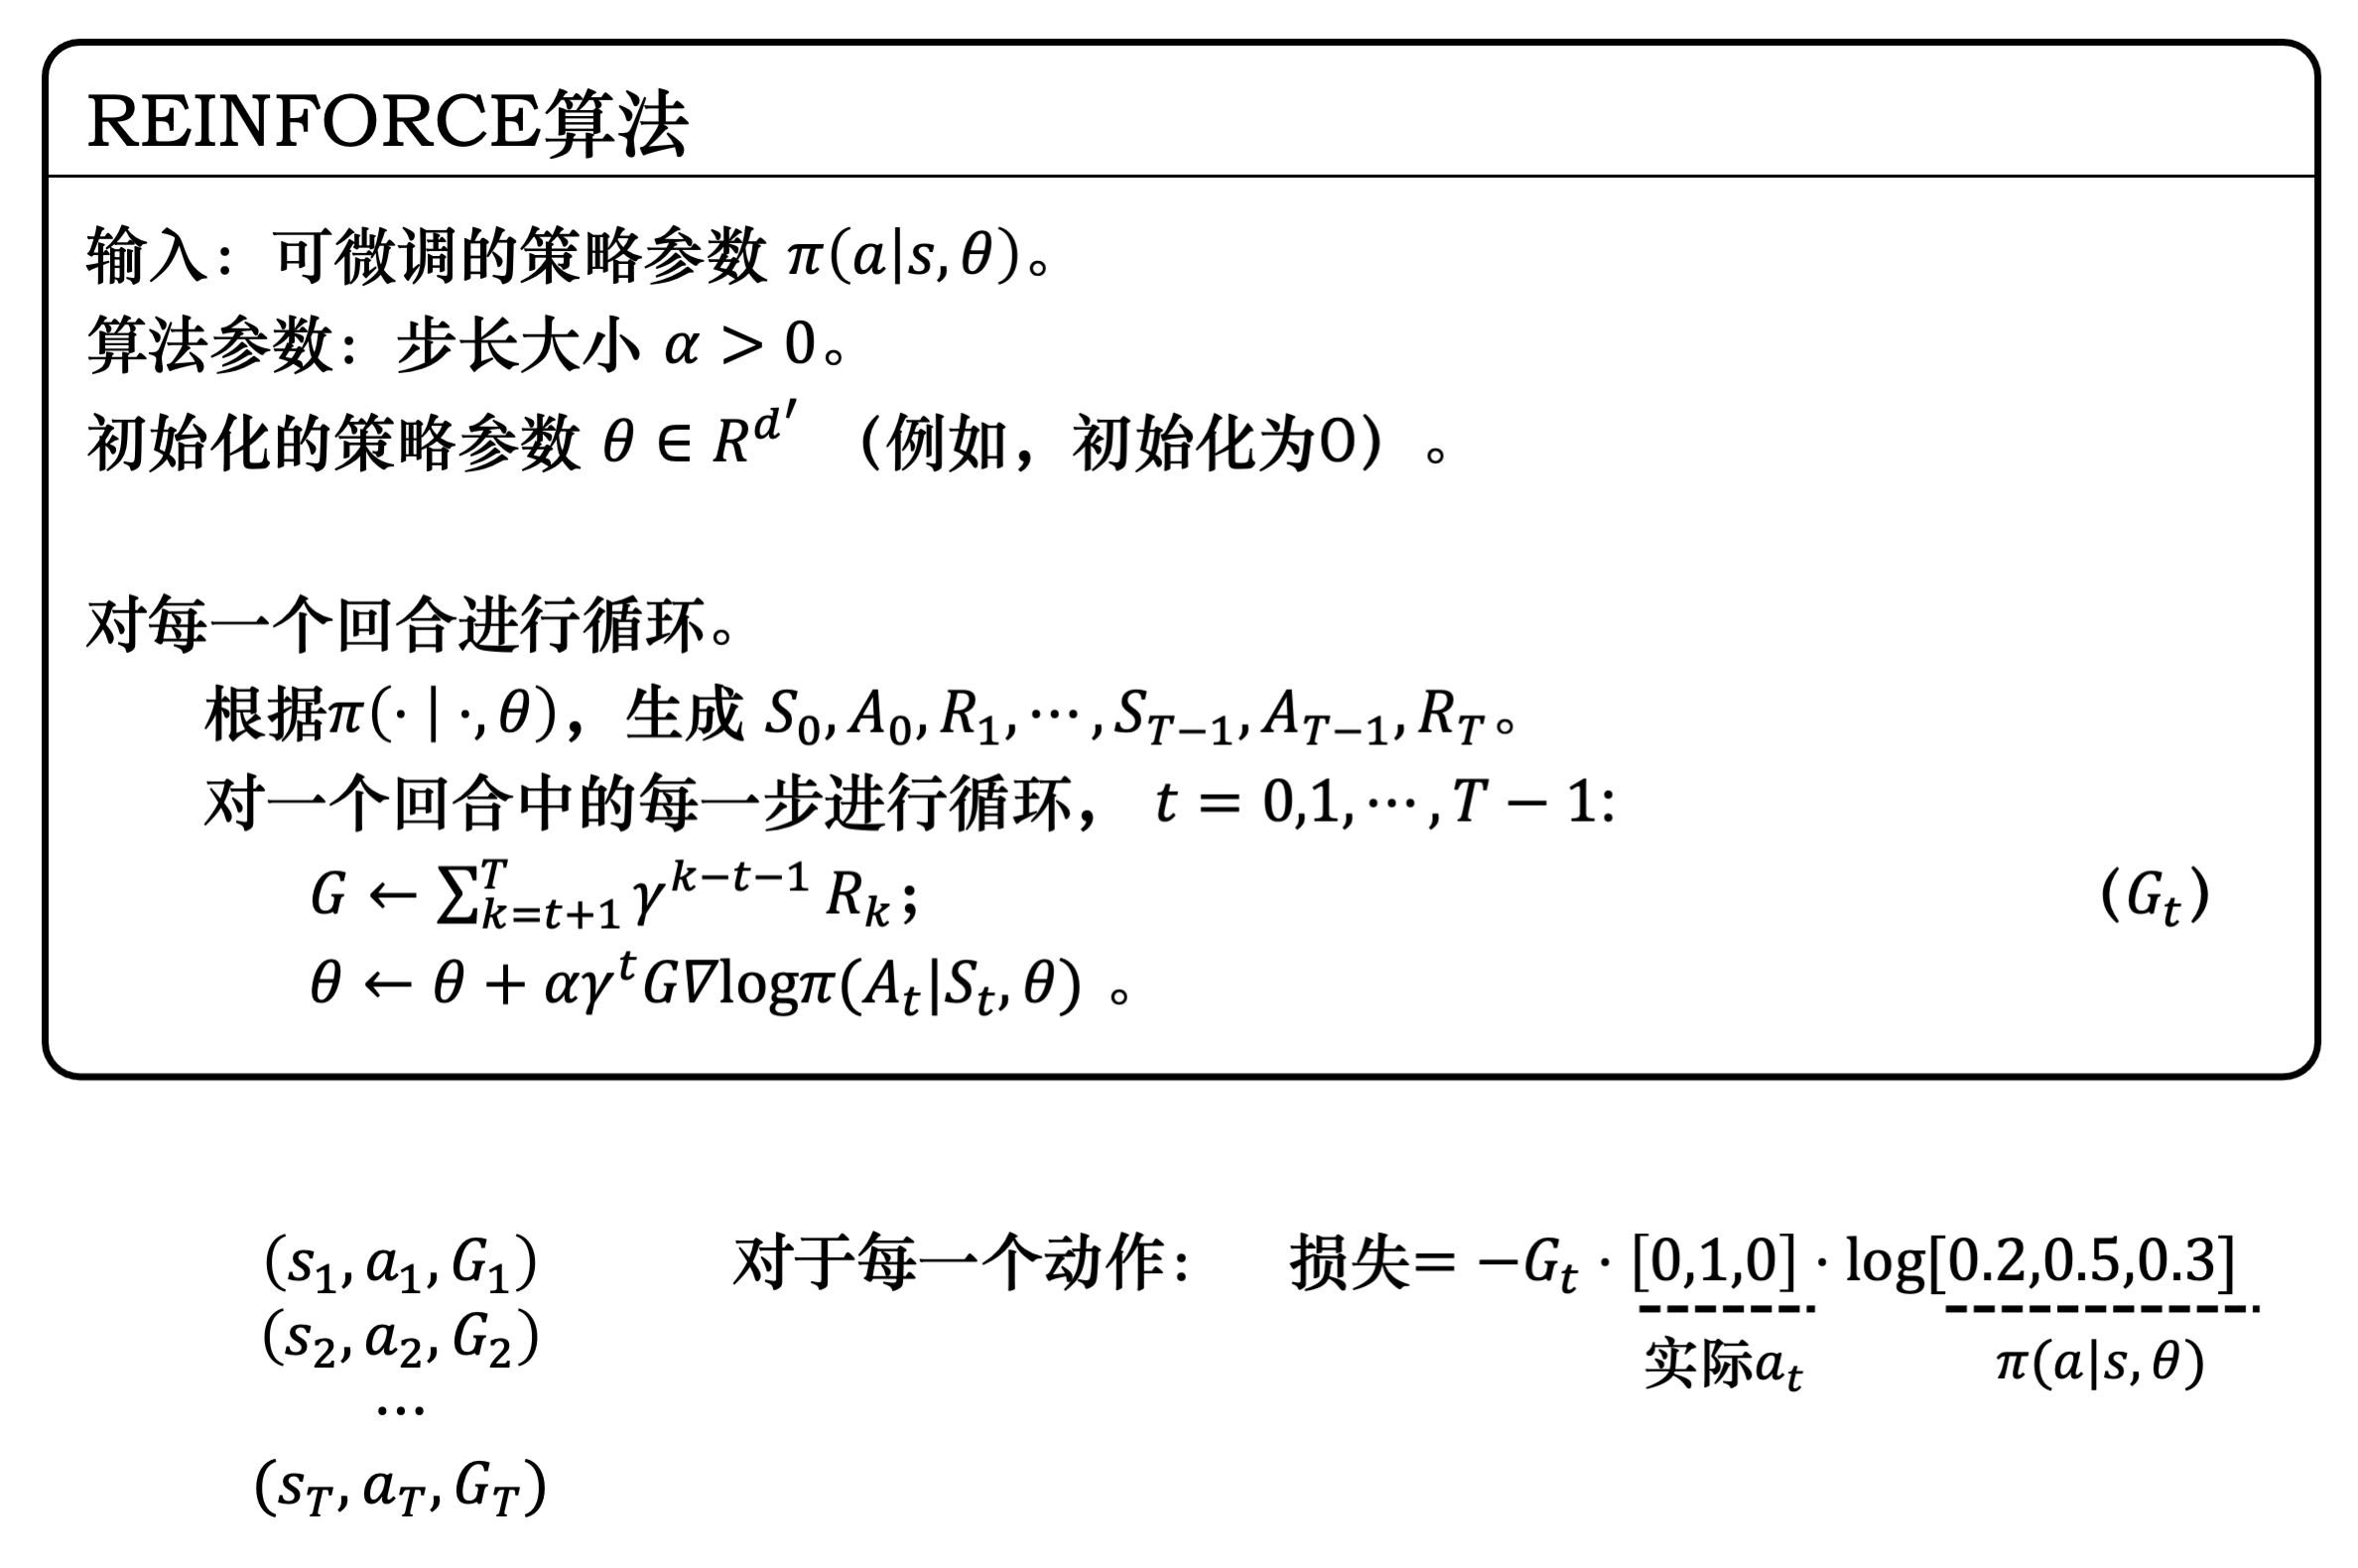
loss=−Gt⋅log⁡pθ(at∣st)

策略函数设计 ​

随机策略:输入状态s,输出对应动作概率分布

离散动作策略函数

Softmax计算概率

  • ϕ(s,a)是模型为动作输出分数,称为logits,可正可负。
  • 计算softmax得出概率称为probs,非负,加起来等于1。
  • 取对数后称为log_probs
πθ(a∣s)=pθ(a∣s)=eϕ(s,a)∑a′∈Aeϕ(s,a′)ϕθ(s,⋅)⏟logits:原始分数→Softmaxπθ(⋅∣s)⏟probs:概率→loglog⁡πθ(⋅∣s)⏟log_probs:对数概率

一般ϕ(s,a)和softmax合在一起

  • 给定状态s,选择动作a的对数概率,对参数θ求梯度,乘以该动作权重就是完整策略梯度。
∇θlog⁡πθ(a∣s)→Ψt⏟权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度
连续动作策略函数

策略动作从高斯分布得出

  • 在模型最后一层输出均值和方差两个值,来构建一个高斯分布,进行采样即可。
N(ϕ(s)θ,σ2)∇θlog⁡πθ(a∣s)=(a−ϕ(s)θ)⋅ϕ(s)σ2

策略梯度权重设计 ​

策略梯度权重多种形式 ​

策略梯度权重多种形式

策略梯度形式

∇J(θ)=1N∑n=1N∑t=0TnΨt⏟权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度

权重Ψt的7种表现形式

  • G(τ) 轨迹总奖励
R(τ)=G(τ)=r0+γr1+⋯γTrT=∑t=1Tγt−1rt
  • Gt 动作at的奖励
Gt=∑k=t+1Tγk−t−1⋅rk=rt+1+γ⋅Gt+1
  • Gt−b(st) 动作at奖励减去偏移量
Gt−b(st)
  • Qπ(st,at) 状态动作值函数
Qπ(st,at)Aπ(st,at)=Qπ(st,at)−Vπ(st)
  • TD误差
Aπ(st,at)=rt+1+γVπ(st+1)−Vπ(st)⏟TDError
  • GAE
AtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅δt+lAtGAE(γ,λ)(st,at)=∑l=0∞(γλ)l⋅(rt+l+γV(st+l+1)−V(st+l))

策略梯度信号选择问题 ​

AC 存在的问题

ActorCritic 存在的问题 (TRPO/PPO来解决)

  • 更新步长选择困难症
  • 每次梯度更新时,都对策略做采样。
    • 导致训练过程比较慢、采样随机性导致可能朝着错误方向更新。
  • TD Error 估计优势函数是有偏的
策略梯度信号选择-单步奖励+轨迹回报

1. 单步奖励rt

  • 缺点:太短视,没看长期回报。永远学不会先苦后甜的策略。

2. 完整轨迹回报G(τ)

∇J(θ)=1N∑n=1N∑t=0TnG(τn)⏟权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度
  • 高方差
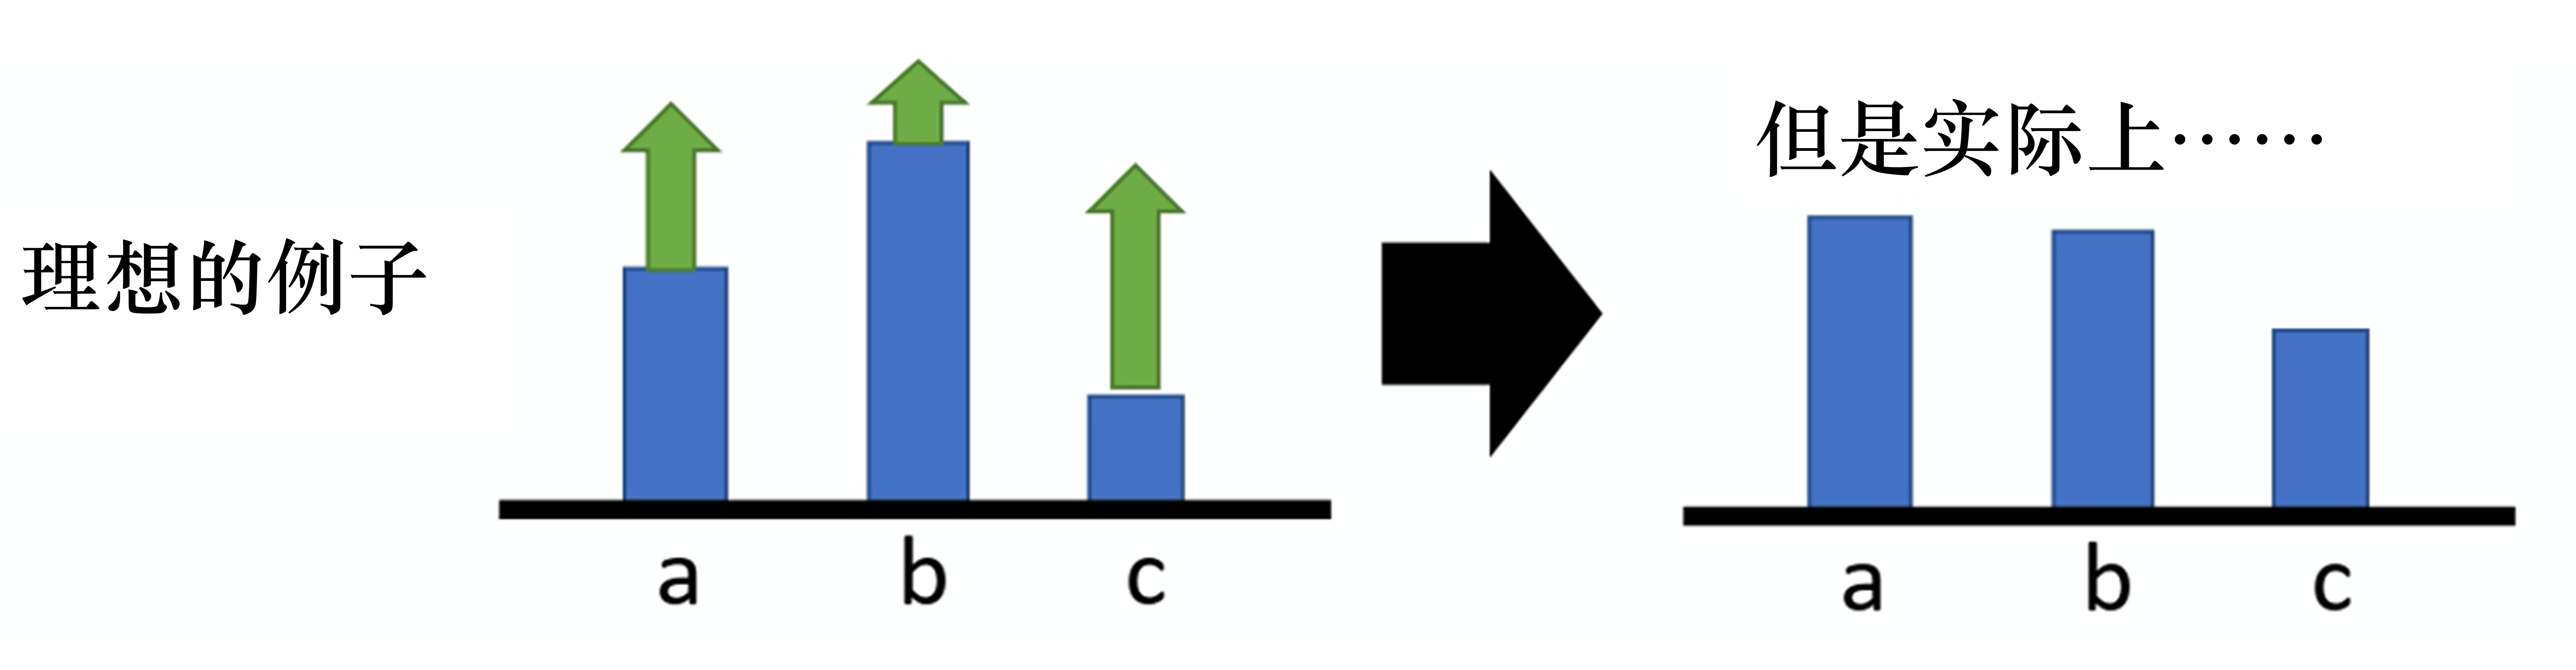
  • 权重很大大于0:
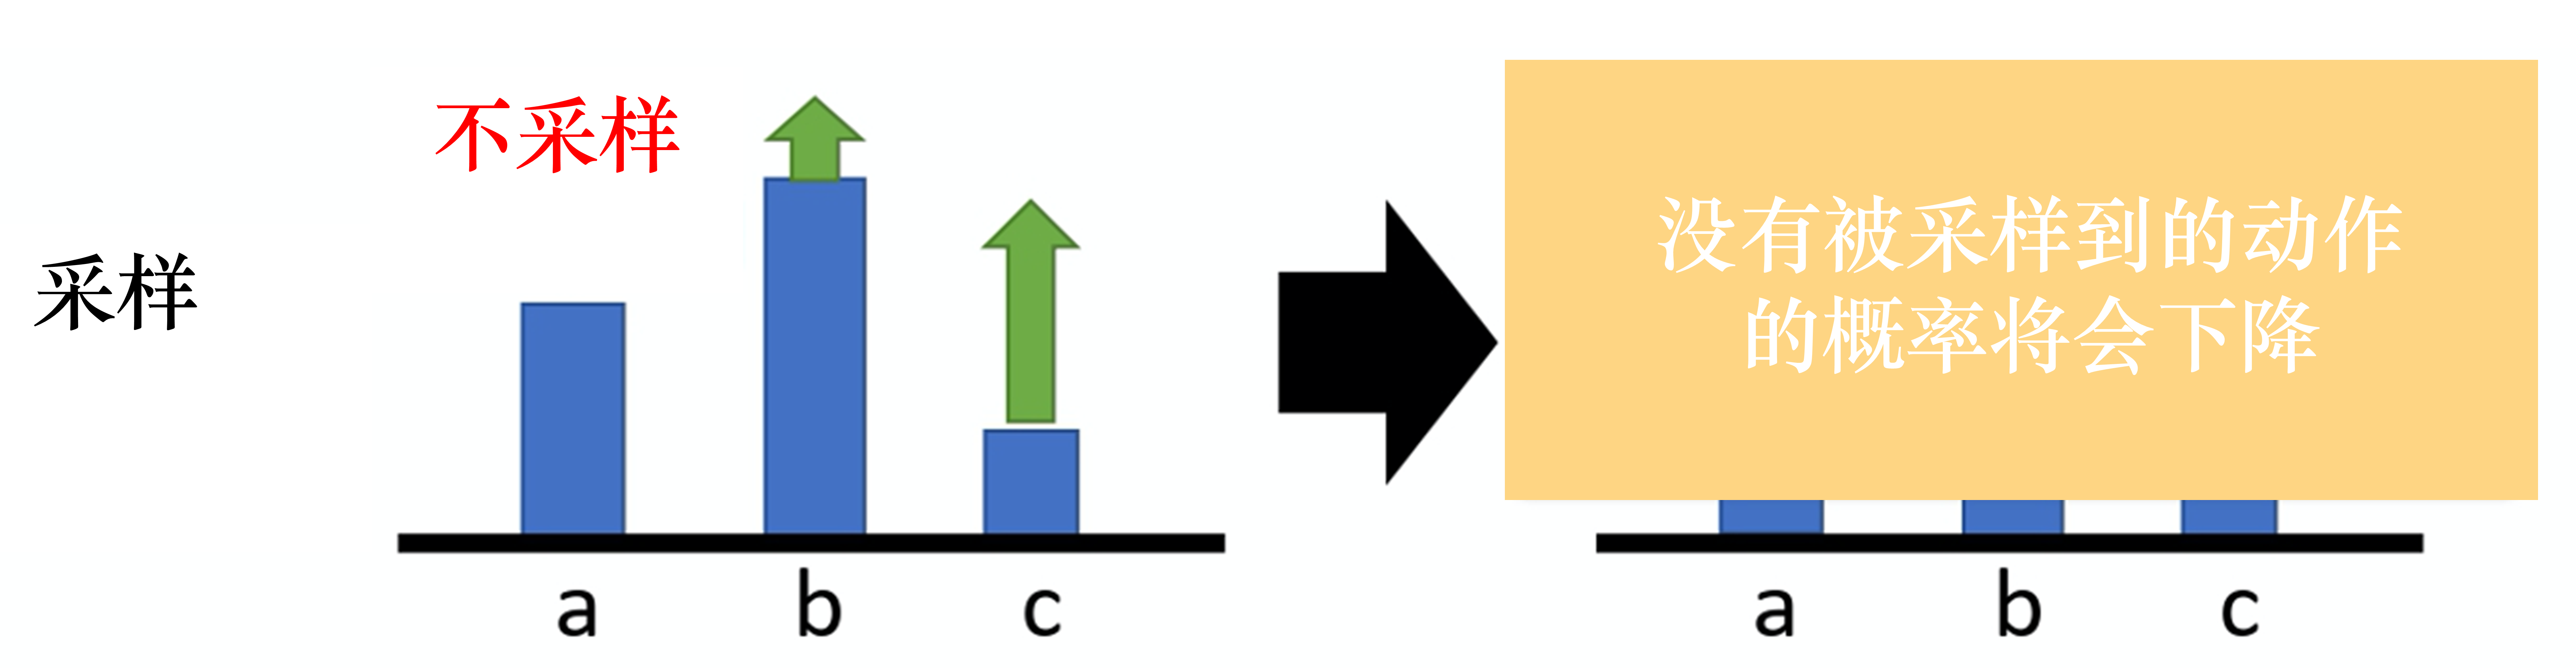
    • 所有采样到的动作概率都会提升且好坏区分度不明显
    • 没被采样到的动作,即使可能很好,概率也会下降
      • 因为提升了采样动作,未采样动作就会下降。
  • 所有动作a权重都一样:不公平
    • 有的动作好,贡献多,需提升概率;有的动作差,贡献少,需要降低概率。

3. 总回报Gt

  • 缺点:高方差、权重恒大于0
  • 举例
    • 某游戏每步奖励在[90,110]区间,任何轨迹的总回报Gt 都是非常大的正数。
    • 状态s下,有2个动作:好动作a1 、坏动作a2
    • 执行a1后:总回报 1010;更新a1时,+1010,非常强的正信号。
    • 执行a2后:总回报 1005;更新a2时,+1005,同样非常强的正信号。
  • 导致所有被采样的动作概率都会提升。
    • 会导致训练过程不稳定、 收敛很慢。
      • 奖励信号都很大,算法很难稳定分辨 出a1 比 a2 “好了一点点”。
      • 基础量是1000,这个5分的差异,在巨大的更新步长面前几乎可以忽略不计。
  • 导致未被采样动作的概率会下降。
    • 例如 a3是一个很好的动作,但由于没有被采样到
      • 提升了 采样到的a1,a2的概率,就自动降低了a3的概率。
策略梯度信号选择-优势函数

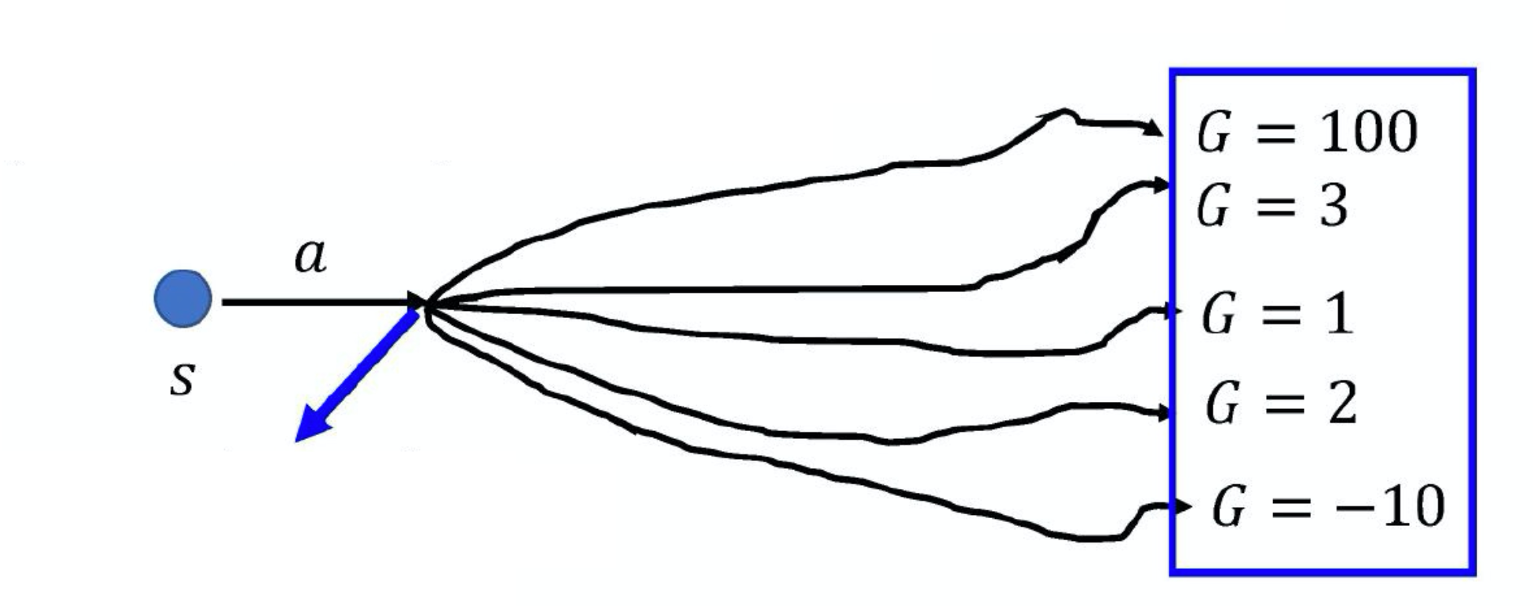
4. 基线/优势函数

  • 解决高方差问题:引入并减去基线/状态价值函数Vπ(st)
Aπ(st,at)=Qπ(st,at)−Vπ(st)Aπ(st,at)=rt+1+γVπ(st+1)−Vπ(st)⏟TDError
  • 例子

    • 游戏例子
    a1A(s,a1)=1010−1000=10清晰的正信号a2A(s,a2)=1005−1000=5较弱的正信号a4A(s,a4)=990−1000=−10清晰的负信号
    • 考试例子
      • 总回报Gt :你考了95分
      • 状态价值V(s)基线, 平均98分;
      • 你的优势A(sa):95-98=-3分,低于平均水平,学习动作a 需要调整。
  • 低方差、高偏差

5. GAE

  • 平衡方差和偏差

策略梯度重要技巧 ​

添加基线/优势函数 ​

添加基线/优势函数 ​

权重添加基线/优势函数

背景

  • 解决权重 R(τ)恒大于0带来的问题:未采样动作概率更新+方差大。
  • 加上基线,使其有正有负,降低方差。

核心思想

  • 添加基线函数b,使用新权重 R(τ)−b,有正有负
    • R(τ)−b>0:超过基线,让(s,a)概率上升
    • R(τ)−b<0:低于基线,让(s,a)概率下降
∇J(θ)=1N∑n=1N∑t=0Tn(R(τn)−b)⏟基线权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度
  • R−b:也称为优势函数

基线函数b的选择

  • 平均值 b=E[G(τ)],V(s):不断把G(τ)值记录下来,求平均即可
  • R和b相关性越高,方差越小,公式推导出来的。

降低方差方法的公式推导 ​

降低方差方法的公式推导

目的

  • 估计E[f],构造新估计量f^,使得
    • 无偏性:E[f]=E[f^],
    • 减小方差:Var(f^)<Var(f)

核心方法

  • 构建f^:引入一个与f相关的辅助函数g,E[g]已知。
f^=f−α(g−E[g])
  • 保证无偏性推导期望:推导可知E[f^]=E[f]
E[f^]=E[f]−α⋅E(g−E[g])=E[f]−α⋅(E[g]−E[g])=E[f]Var(f^)=Var(f−α(g−E[g]))=Var(f−α⋅g)=Var(f)+α2Var(g)−2α⋅Cov(f,g)
  • 最小方差求解:求解极值点 α取值
    • 方差恒为正,是常数;根据上式可知Var(f^)是关于α的凹函数,必然存在极小值
    • 求导数并使其为0,求解出最小值时的取值。
∂Var(f^)∂α=2αVar(g)−2Cov(f,g)令其=0,得:α=Cov(f,g)Var(g)
  • 最小方差求解:代回极值点,求解出最小值
Var(f^)=Var(f)+Cov2(f,g)Var(g)−2Cov2(f,g)Var(g)=Var(f)−Cov2(f,g)Var(g)=Var(f)(1−Cov2(f,g)Var(f)Var(g))=Var(f)⋅(1−ρ2(f,g))⏟相关系数)

结论

  • 方差极小值:f和g的相关性越高,Var(f^)越小

分配合适的分数 ​

分配合适的分数

背景

  • 解决同一轨迹内,所有动作权重都相同的问题
  • 使其有区分度,鼓励好的动作,抑制差的动作

方法1:使用动作时刻t后面的奖励

  • 动作(st,at)的权重:
    • 不用时刻0到结束的总奖励,而用动作时刻t开始到结束的总奖励
    • 即不用G(τ),改用Gt作为(st,at)的权重
∇J(θ)=1N∑n=1N∑t=0Tn(Gtn−b)⏟基线权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度Gtn=∑k=t+1Tnγk−t−1⋅rkn=rkn+γGt+1n

方法2:使用优势函数Aθ(st,at)

  • 优势函数Aθ(st,at):在状态s,采取动作a,相对于其他动作的优势
  • 优势函数Aθ(st,at):一般由网络估计出来,称为critic评论员
∇J(θ)=1N∑n=1N∑t=0TnAθ(stn,atn)⏟动作优势函数⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度

不同动作贡献不同,权重也应该不同:

策略梯度算法分类 ​

分类概览 ​

策略梯度分类概览

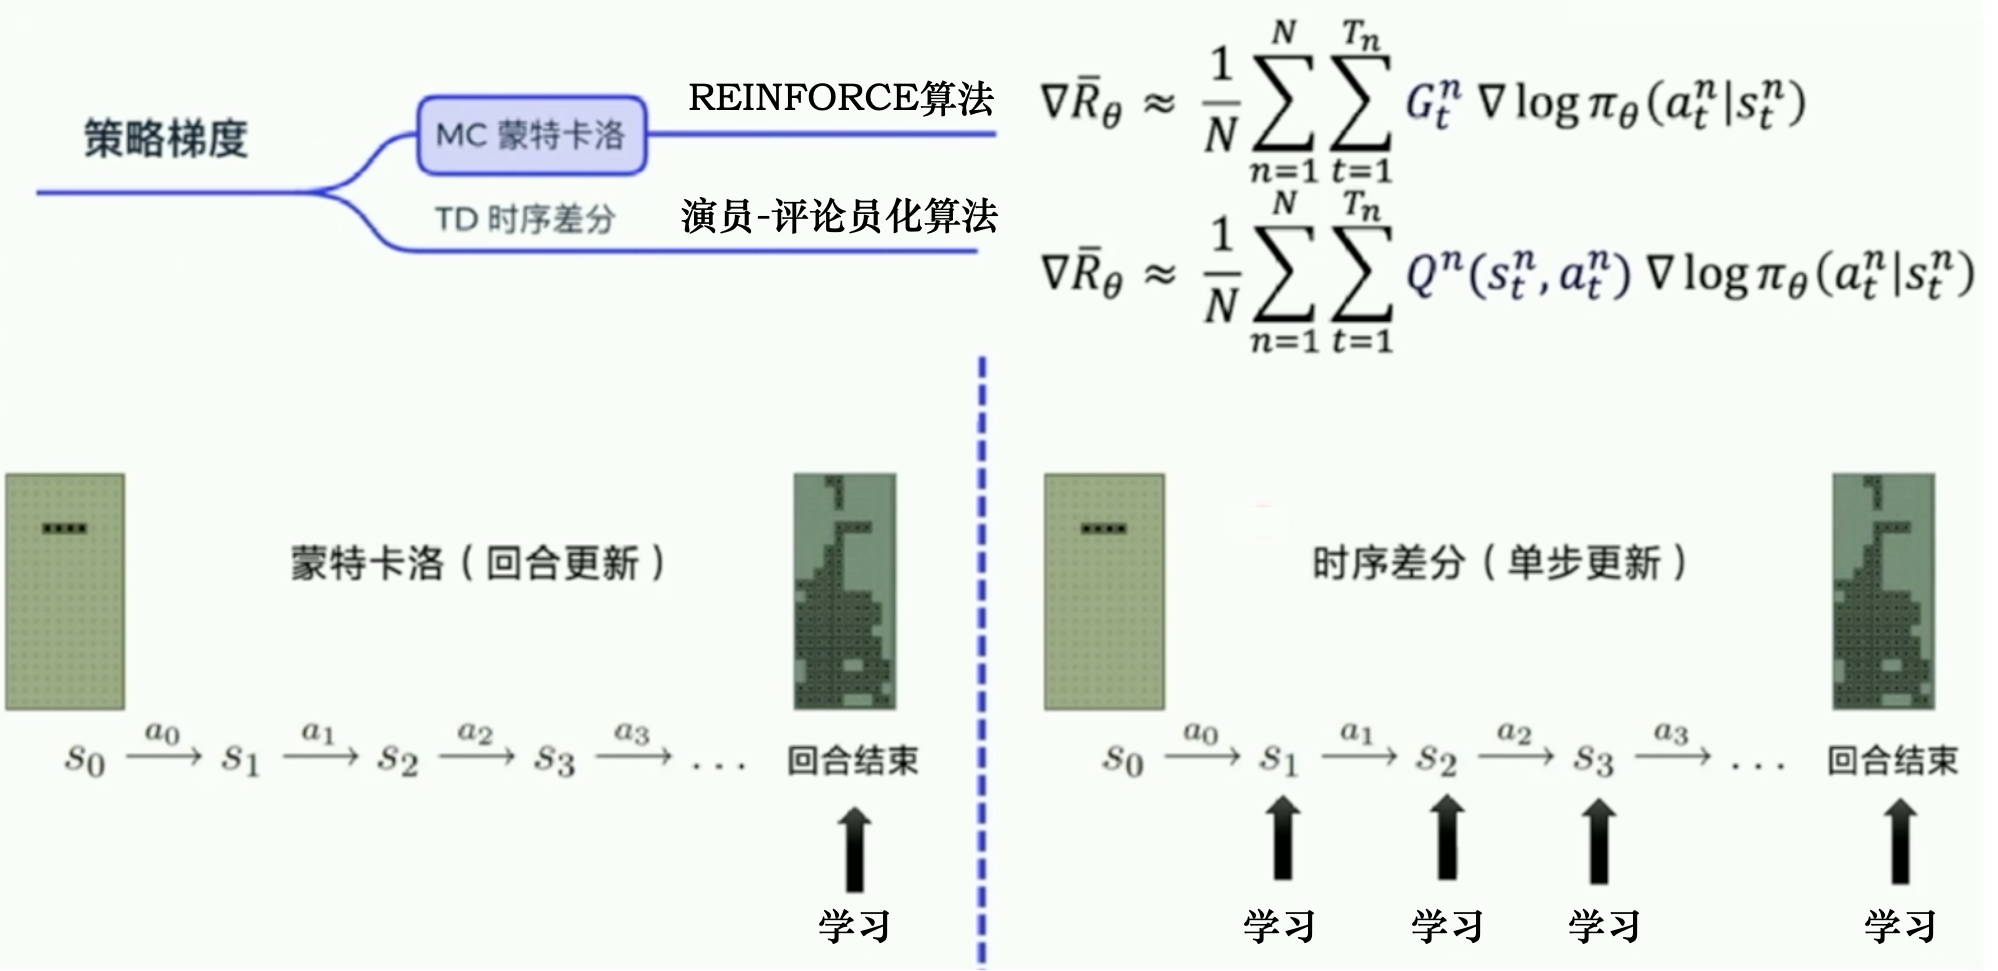
MC 蒙特卡洛方法

  • 回合更新;使用Gt作为权重。
  • REINFORCE算法
∇J(θ)=1N∑n=1N∑t=0TnGtn⏟权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度

TD 时序差分方法

  • 步骤更新;TD估计Q函数,作为权重。
  • Actor-Critic算法
∇J(θ)=1N∑n=1N∑t=0TnQn(stn,atn)⏟Q函数做权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度

蒙特卡洛策略梯度优缺点 ​

MC 策略梯度 优缺点

优点 (相比于基于价值的算法)

  • 适用于连续动作空间
  • 适用于随机性策略
  • 计算出的策略梯度是无偏的;基于价值的算法 则是有偏的。

缺点

  • 采样效率低:MC采样 不如 TD采样
  • 高方差:MC高方差,估计梯度时甚至比基于价值的算法方差还高;G很不稳定
  • 收敛性差:容易导致局部最优解
  • 难以处理高维离散动作空间

蒙特卡罗策略梯度 ​

REINFORCE 算法 ​

REINFORCE 核心思想

核心思想

  • 在策略梯度基础上,使用Gt作为动作权重,一个回合更新一次
∇J(θ)=1N∑n=1N∑t=0TnGtn⏟权重⋅∇log⁡pθ(atn∣stn)⏟动作a的梯度Gt=∑k=t+1Tγk−t−1⋅rk=rt+1+γ⋅Gt+1
  • 回合数据
  • 同策略算法

算法步骤

  • 根据策略采样一个回合数据;采样后,从0到T每时刻 根据(st,at,Gt)做参数更新
(s0,a0,r0),(s1,a1,r1),⋯,(sT,aT,rT)(s0,a0,G0),(s1,a1,G1),⋯,(sT,aT,GT)
  • 计算每时刻Gt权重
Gt=∑k=t+1Tγk−t−1⋅rk=rt+1+γ⋅Gt+1
  • 计算动作策略梯度:(st,at) 对数概率梯度
∇log⁡pθ(at∣st)
  • 每时刻更新参数
θ←θ+α⋅γtGt⋅∇log⁡pθ(at∣st)

算法流程

伪代码

REINFORCE++ 算法 ​

具体见笔记:REINFORCE++

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026