Skip to content

PPO 改进系列

📅 发表于 2025/09/22
🔄 更新于 2025/11/24
👁️ — 次访问
📝 6131 字
⏳ 20 分钟
ppo
#ppo
#vc-ppo
#vapo
#价值偏差
#长度不一
#奖励稀疏
#GAE奖励信号衰减
#价值预训练
#Decoupled-GAE
#长度自适应GAE
#Token-level Policy
#Clip-Higher
#正样本LM Loss
#分组采样
#RLOO
#REINFORCE++

(2504) VAPO (Seed) ​

VAPO 摘要

参考链接

问题背景

  • 非常solid的文章,对PPO的改进优化。
  • 针对价值偏差、长度不一、奖励稀疏3大问题

核心方法

  • 提出了价值预训练、解耦GAE、长度自适应GAE、token-level loss、CLip-Higher、正样本LMLoss、分组采样等7大核心方法。

关键结论

  • 价值模型相比无价值模型,能提高更细粒度的学习信号,性能更好、训练效率、稳定性更高。

问题背景 ​

价值偏差问题 ​

❓问题背景

LongCoT 推理任务 RL 在Value-based方法上,存在挑战。

价值模型偏差问题

1. 价值模型偏差

  • 偏差来自RM和Critic目标不一致,却用RM初始化Critic。
    • RM对完整句子打分,Critic预测中间状态的未来价值。
    • RM对不完整句子打低分、对长句打高分,导致一开始就有一个正向优势偏差。
    • 详见VC-PPO
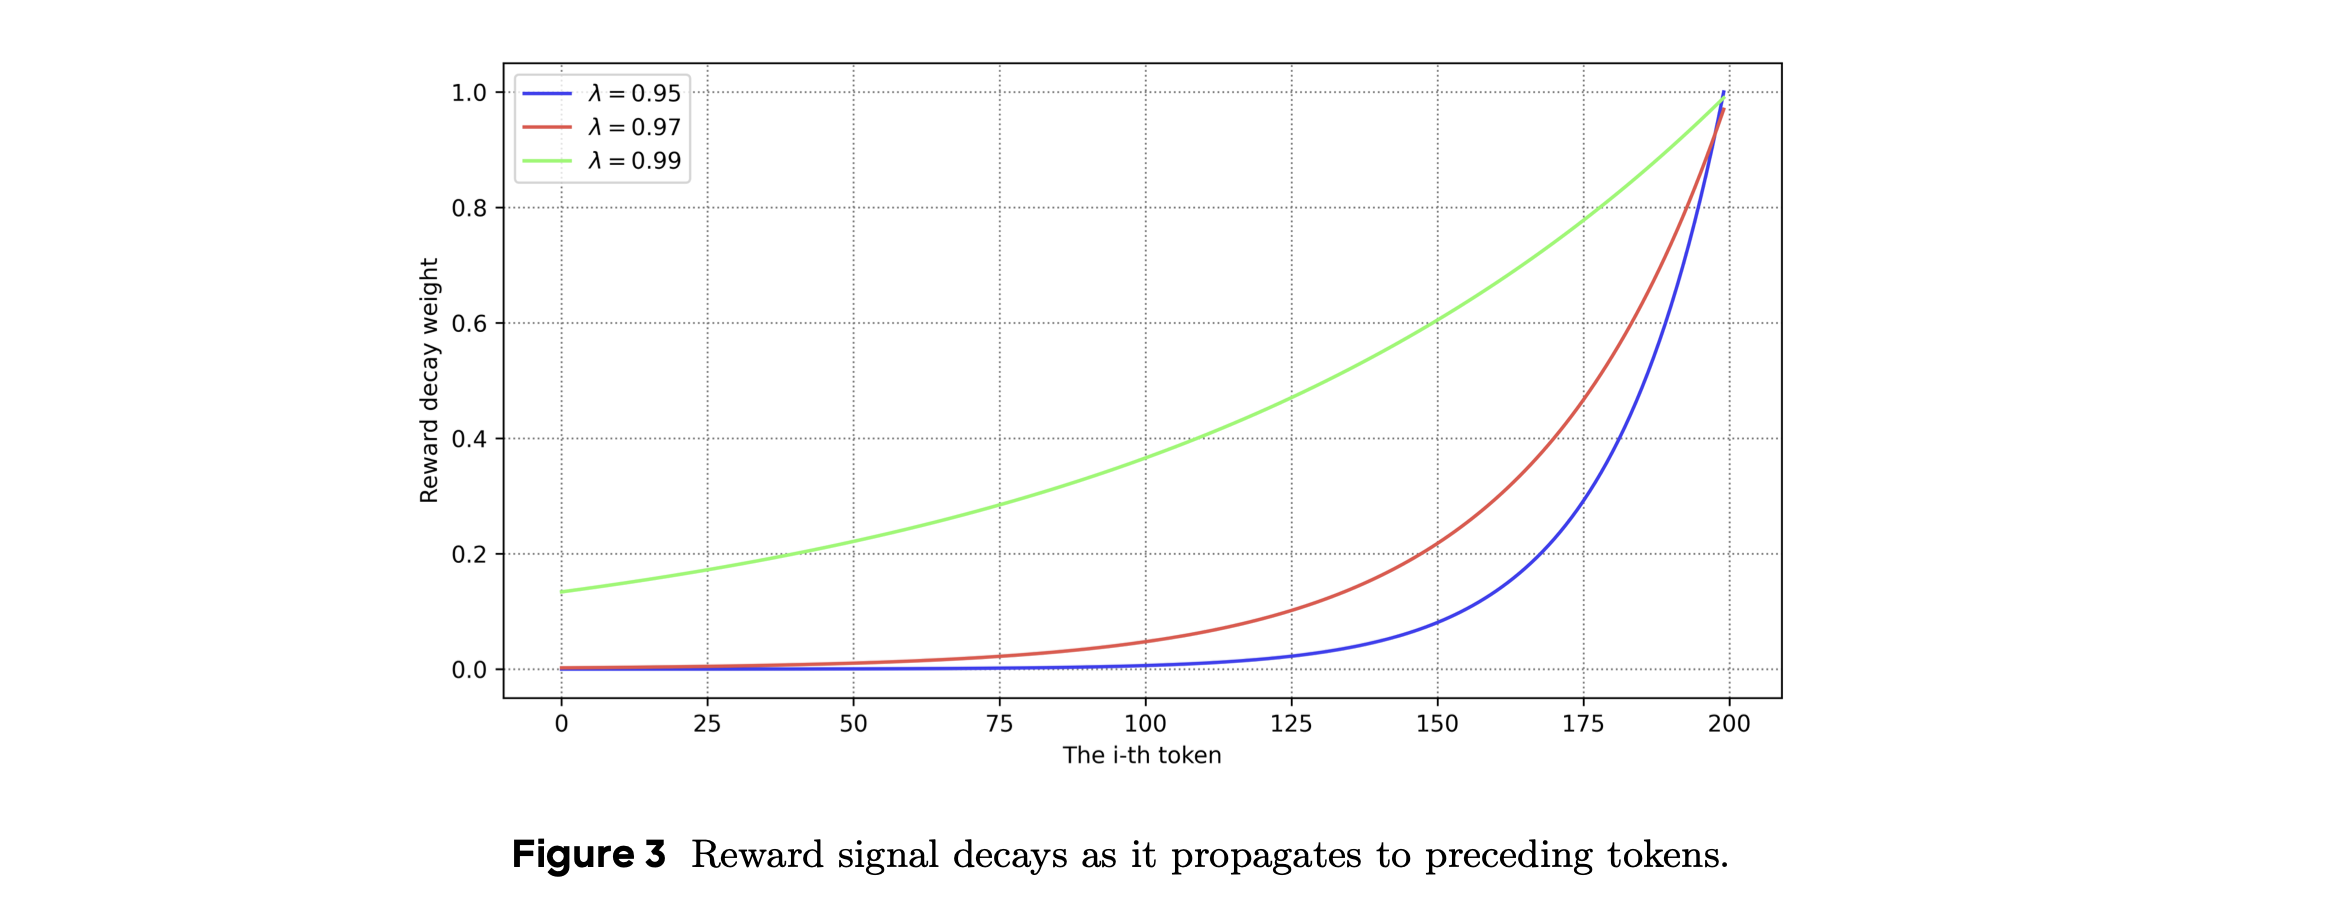
  • GAE λ<1时 奖励信号衰减,加剧价值学习难度
    • 最终环境奖励,传回到第t个token时,衰减因子为λT−t,
    • T-t很大时,衰减因子几乎为0,无奖励信号
    • 价值模型更新 完全依赖自举,难以作为基线,使得训练过程非常不稳定。

训练长度不一问题 ​

训练长度不一问题

2. 训练过程序列长度不一

  • 在推理任务中,模型生成答案长度差异巨大。普通GAE 固定λ 无法适应动态长度。
  • GAE优势估计
    • 对短序列:往往方差很高,导致训练不稳定
    • 对长序列:因为过多自举,引入高偏差。
    • GAE递归计算,把每一步的微小误差在长序列中不断累计放大,影响学习效果。
  • 根本原因:GAE指数衰减特性,天然不适合处理 长度变化范围极大的序列。
PPO Seq-Loss 缺点

标准Seq-Loss 缺点

  • 标准PPO是Sequence-Level Policy Loss,即2步平均。

    • 序列内平均(inner average):对一个序列的所有token求平均,作为序列loss
    • 样本间平均(outer average):对所有序列的loss求平均
  • 后果

    • 模型更关注学好短序列,忽略长序列中token的错误
    • 学不好处理长序列问题,因为长序列权重被稀释。

短序列/长序列token影响力不同

  • 由于序列是平均对待,因此短序列token影响力比长序列token影响力 更强。

    • 短序列A:10个token,每个token对ALoss的贡献是1/10。
    • 长序列B:1000个token,每个token对BLoss的贡献是1/1000。
    • 短序列A Token 犯错带来的惩罚影响力是长序列B Token影响力的100倍。

奖励被稀释

  • 1k 高质量回答:里面有100个token特别好,优势值很高
  • 但最终被其他900个普通token平均,导致最终总贡献和50个token普通回答差不多。

惩罚被稀释

  • 如1k 回答:前800好,后面200差,但差的被前面好的平均稀释了,得不到足够的惩罚。
  • 纵容了模型生成更长、质量更差的回答。

奖励稀疏问题 ​

奖励稀疏问题

3. 稀疏奖励信号

  • Rule-based 通常只有0和1 Sparse奖励信号,不是dense信号。
  • 长CoT会加剧稀疏性,采样到非0奖励的样本概率更低,大部分尝试都是错的。
  • 探索利用困境,需要保持平衡。
    • 需要探索:保持不确定性去探索不同推理路径,找到正确答案。
    • 需要利用:需要利用艰苦探索得到的正确样本,提升学习效率。
    • 如果不平衡,可能陷入局部最优解、大量无效探索。

📕核心方法

解决价值偏差问题(价值预训练+解耦GAE) ​

整体背景
  • 解决价值模型初始化不当 和奖励衰减带来的偏差问题。

价值预训练 ​

价值预训练

背景

  • 解决价值模型初始化偏差问题。

核心思想

  • 不使用RM初始化,而是在PPO之前,使用固定策略+MC采样回报,来预训练价值模型。
  • 价值模型在初期就能对累计奖励有一个更准确、偏差更低的估计。
  • 为RL学习提供一个高质量起点,避免训练初期崩溃。

价值预训练

  • 使用固定策略 πsft,生成大量数据;GAE使用λ=1变成无偏MC回报。
  • 使用生成数据+MC回报,来训练价值模型,直到收敛
    • 看Value Loss和Explained Variance。
  • 后续PPO使用Value预训练过的模型。
  • 具体见 VC-PPO 价值预训练

Decoupled-GAE ​

Decoupled-GAE

背景

  • 解决长序列中奖励衰减 导致价值更新不准确的问题。

核心思想

  • 对Policy和Critic的GAE计算解耦,使用不同的λ。
  • 对Critic
    • λ=1,使用无偏MC回报来训练网络,消除自举带来的偏差
    • 让模型能学到长序列末端的真实奖励信号。
  • 对Policy
    • λ<1(0.95),虽然引入一些偏差,但能有效降低方差。
    • 加速策略收敛和保持训练稳定。
  • 更多见 VC-PPO Decoupled-GAE

解决长度不一问题 (Length-Adaptive GAE + Token-Level Policy Loss) ​

Length-Adpative GAE 问题背景

问题

  • 解决固定GAE λ参数,无法适应长短不同序列的问题。

Length-Adpative GAE ​

Length-Adaptive GAE

目的

  • 动态调整GAE的λ参数,适应不同长度。
  • 如果λ=0.95固定,则存在奖励衰减问题。
    • 当步数很长l=100时,0.95100≈=0.006,奖励信号权重接近0。

核心思想

  • 动态调整λ,与序列长度l做适应

  • 序列很长时:λ变大, 接近1

    • 使最终奖励信号传播得更远,能看得越远,确保末端奖励信号不丢失,从而降低偏差。
  • 序列很短时:λ适当变小

    • 降低方差,使训练更稳定。
  • GAE 权重系数总和

    ∑t=0∞λpolicyt=1+λ+λ2+λ3+⋯=11−λpolicy

具体做法

  • 总影响力应该与序列长度l成正比

    ∑t=0∞λpolicyt=11−λpolicy=α⋅l
  • 长度自适应λ

    λpolicy=1−1α⋅l

Token-Level Policy Loss ​

Token-Level Policy Loss

PPO Seq-Loss 缺点

  • 标准PPO是Sequence-Level Policy Loss,即2步平均。

    • 序列内平均(inner average):对一个序列的所有token求平均,作为序列loss
    • 样本间平均(outer average):对所有序列的loss求平均
  • 例子见上文问题

  • 模型更关注学好短序列,忽略长序列中token的错误,学不好处理长序列问题,因为长序列权重被稀释。

Lppo(θ)=−1G∑i=1G⏟样本间平均1|oi|∑t=1|ot|⏟序列内平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)

VAPO Token-Level Loss

  • 不做序列内平均,直接对所有token做平均,每个token权重相同,不论它来自短序列或长序列。LVAPO(θ)=−1∑i=1G|oi|∑i=1G∑t=1|oi|⏟所有Token直接做平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)

解决奖励稀疏问题(Clip-Higher,正样本LM-Loss,分组采样) ​

Clip-Higher ​

Clip-Higher

标准PPO-Clip问题

  • 防止训练一步走太大而崩溃,把变化范围限制在[1−ϵ,1+ϵ]
  • 1+ϵ成为探索天花板,太低不利于探索
    • 当偶然探索到极好、但之前概率极低的策略时,很可能会被clip掉。
    • 天花板会限制奖励程度,使得策略更新过于保守,不利于大胆探索

Clip-Higher:奖要重奖、罚要慎罚

  • 把上下界解耦为非对称 [1−ϵlow,1+ϵhigh]

  • 提高上界ϵhigh=0.28:奖要重奖

    • 如0.2->0.28。为奖励信号打开更高天花板;当探索到好路径时,策略可以进行大幅度更新。
    • 为惊喜提供更大奖励空间。
  • 保持下界ϵlow=0.2不变或较小:罚要慎罚

    • 如果ϵlow太大,模型在惩罚错误路径时可能过于激进
    • 直接把概率压到0,这样会扼杀多样性,导致熵崩溃。
    LVAPO(θ)=−1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)

正样本LM Loss ​

正样本LM-Loss

目的

  • 最大化正样本生成概率

核心思想

  • 采样到正样本时,在强化学习策略更新基础上(正向奖励、PPO Loss、策略更新)。
  • 额外增加模仿学习,增加负对数似然,强迫模型去学习和复现整个正确推理过程。

NLL Loss

  • 最终策略loss:增加一项NLL Loss。
L(θ)=Lppo(θ)+μ⋅LNLL(θ)
  • NLL Loss:最大化正样本的生成概率。
  • 压榨正样本,不仅告知模型做对,且手把手教学如何做对的,记住这个过程。
LNLL(θ)=−1∑oi∈τpositive|oi|∑oi∈τ∑t=1|oi|log⁡πθ(at∣st)

分组采样 ​

分组采样 Group-Sampling

目的

  • 生成对比性数据来提升学习。
  • 同等资源情况下,两种策略
    • 广度优先:在一个batch中,使用多个prompt,每个prompt rollout 1次。
    • 深度优先:在一个batch中,使用较少的prompt,每个prompt rollout 多次。

VAPO 选择深度优先策略

  • 对同1个问题,多次采样。可能得到一个混合成功、失败、部分正确的样本集。
  • 为模型训练提供了丰富的对比信号,增强了学习效果。

实验结果 ​

实验配置 ​

✍️实验设置

实验配置

模型

  • Qwen-32B

数据

  • 训练:数学
  • 评测:AIME24

Baseline/基础算法

  • PPO、AdamW

Base PPO 参数设置

  • Policy 学习率1e-6,Critic 学习率 2e-6。
    • Critic 必须跟上 Actor的速率,才能提供准确的优势估计。
    • 如果更新太慢,提供的就是过时的估计。
  • Batch Size:8192个prompt,每个prompt采样1次
  • Mini-Batch Size:512
  • Critic Model:由RM初始化。
  • GAE:λ=0.95,γ=1
  • Clip:ϵ=0.2
  • 使用Sample-Loss

VAPO 设置

  • Critic:使用RM去做ValuePretrain,50个step。
  • Decoupled-GAE:
    • λcritic=1.0
    • λpolicy=1−1αl,α=0.5
  • Clip-Higher:ϵhigh=0.28,ϵlow=0.2
  • Token-Level Loss
  • 正样本 LM Loss
  • bs=512个prompt,rollout 16次,mini-bs=512

关键结果 ​

🍑关键结果

关键结果
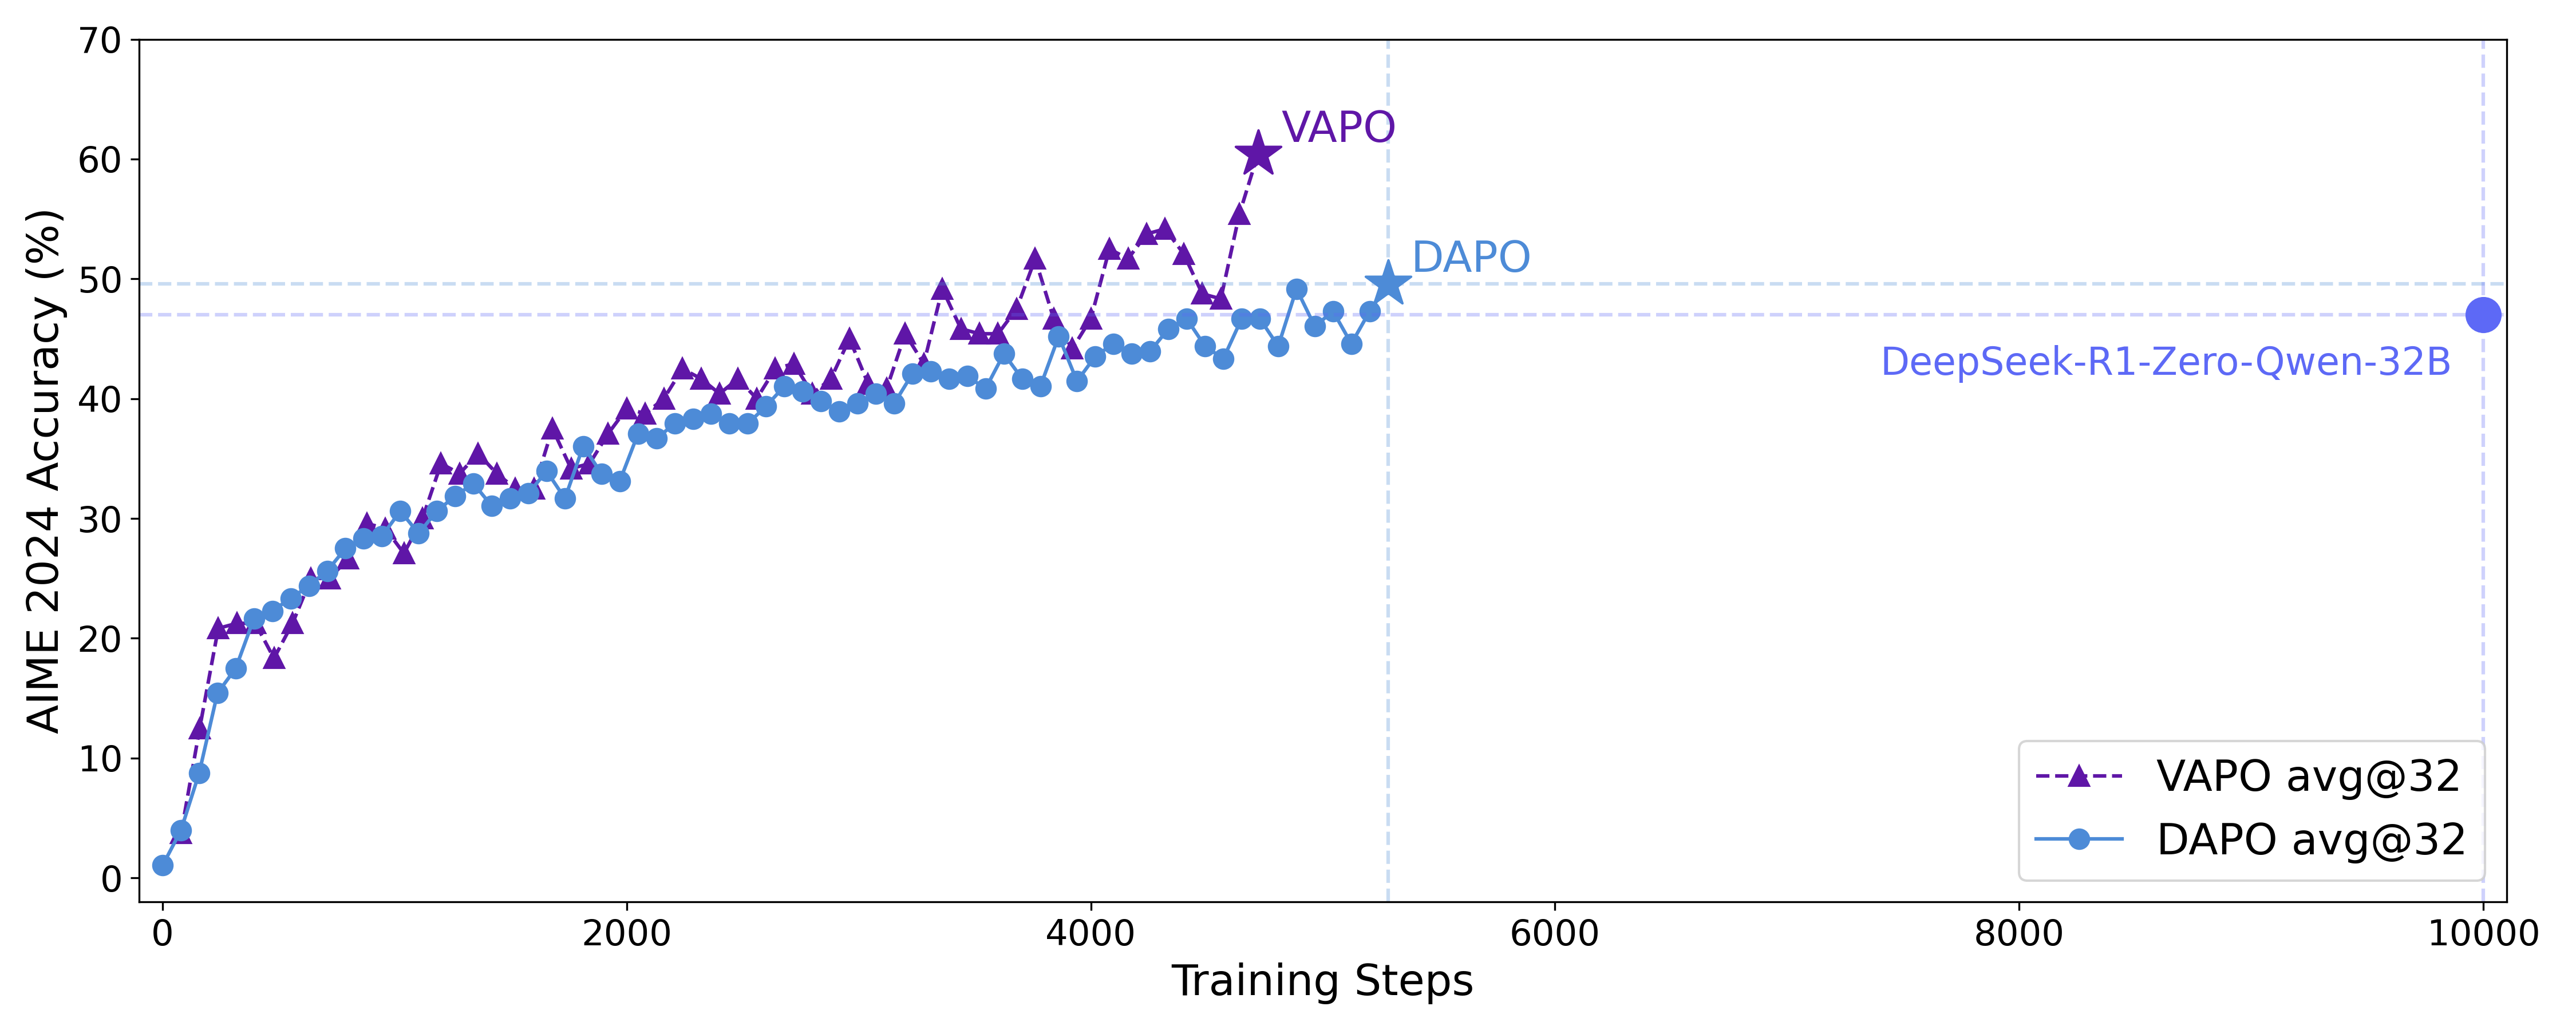
  • 性能好,AIME达60分。VAPO 超过 Critic-Free方法 GRPO(47)、DAPO(50),超过PPO(5)。
  • 训练效率和稳定性很高。
    • 训练效率高:仅用5000步达sota,60%步数达DAPO性能。
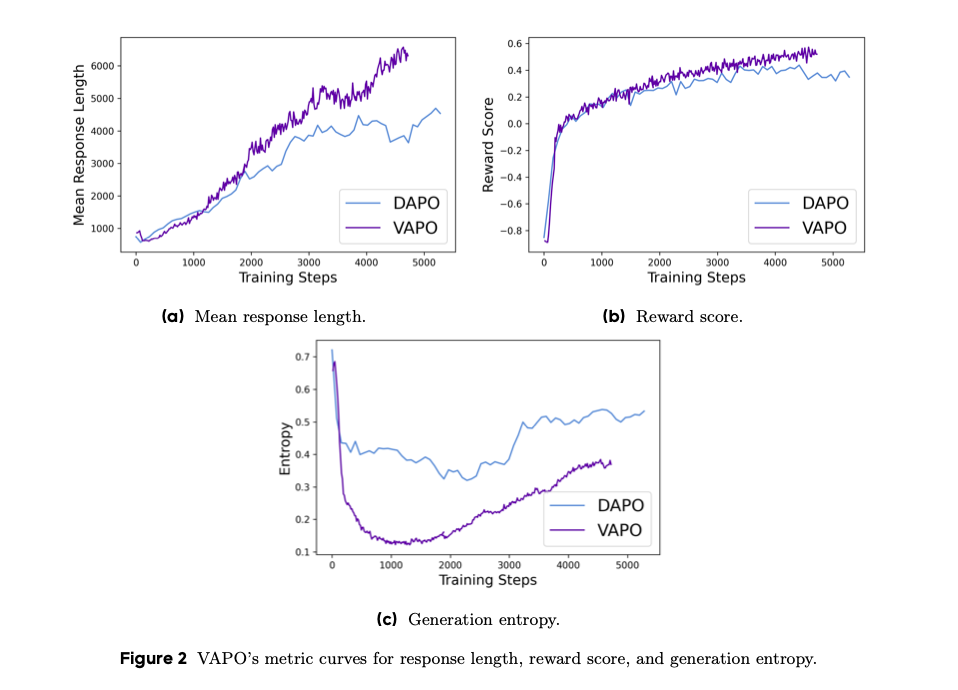
    • 稳定性高:训练曲线比DAPO更平滑,熵保持稳定。稳定复现60-61分成绩。
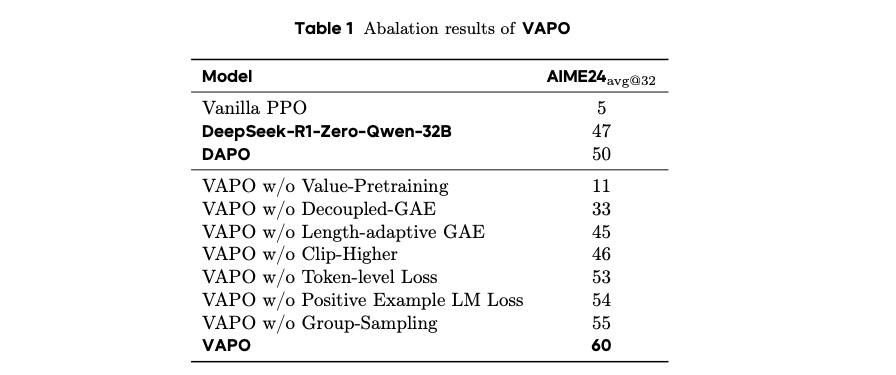
  • 系统验证了7大组件消融实验
    • 最重要:价值预训练、解耦GAE。去掉后,分别暴跌49分、暴跌27分。
    • 重要组件:长度自适应GAE(贡献15p)、Clip-Higher、Token-Level Loss(贡献7p)、正样本LM Loss(贡献6p)、分组采样(贡献5p)。
  • 价值模型具有优越性。
    • 相比Critic-Free(GRPO/DAPO)等,价值模型能提供更细粒度的学习信号,使得模型更好扩展推理长度,泛化更强。

VAPO 效果好

消融实验:

过程曲线

未来方向 ​

⛳未来方向

未来方向
  • VAPO 扩展至其他领域
  • 发展Value-Based RL。解决价值偏差、长序列等挑战,进一步优化价值模型的训练和使用。
  • 构建通用和更鲁棒智能体。探索更复杂、 推理更长的任务,构建通用可靠agent。

(2503) VC-PPO (Seed) ​

摘要

参考链接

核心方法

  • 首要提出价值预训练、Decoupled-GAE两大方法,解决价值偏差问题。

问题背景 ​

❓问题背景

问题背景

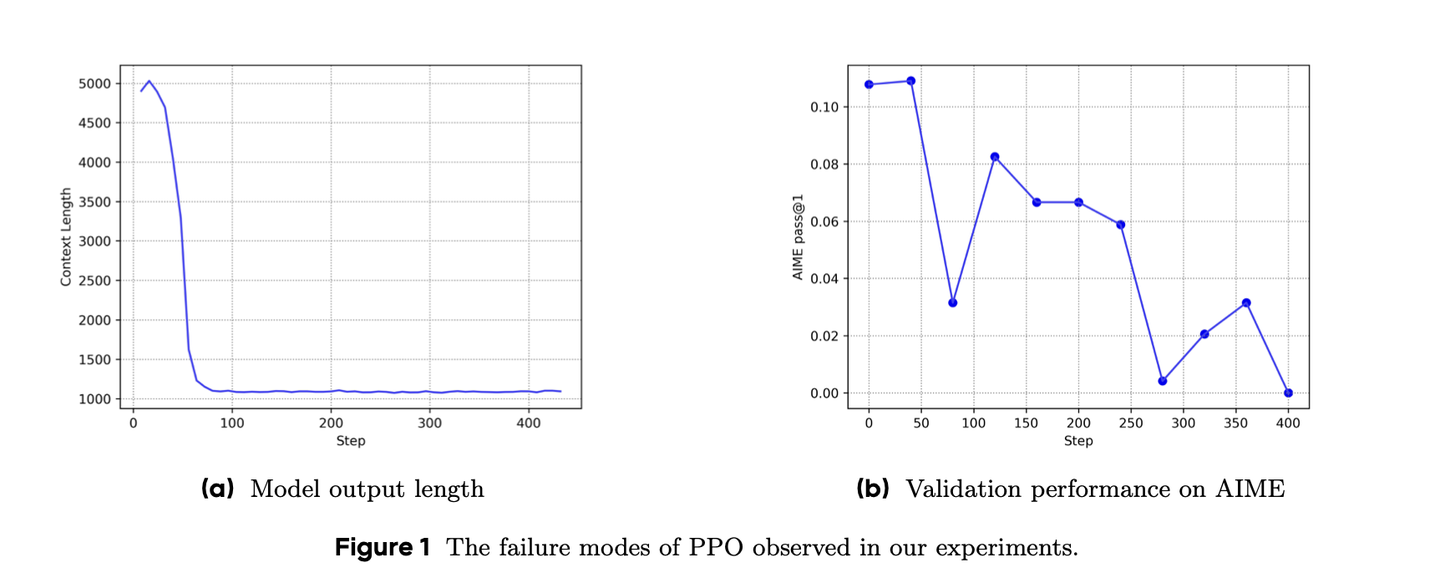
PPO 在Long CoT上会训练崩溃。

  • 表现:回复长度急剧缩短、性能下降。
  • 根本原因:Critic 初始化偏差、奖励信号衰减。

RM初始化Critic带来优势偏差 ​

RewardModel和Critic存在目标差异

标准PPO Critic 由 RM初始化

  • Critic 通过 RewardModel 初始化

RM和Critic 目标存在差异

  • RewardModel
    • 对完整序列打分:在<EOS>出现时做评估,<EOS>前面的token没被训过。
    • 不会对中间序列:不完整序列/写了一半的句子进行打分
  • Critic Model
    • 预测从当前位置(写了一半的句子)出发,未来能获得的总奖励期望是多少。
从Reward Model 初始化的Critic 存在打分和优势偏差

打分偏差

  • 对靠前的、不完整的句子状态,V(s) 打低分。
  • 随着句子变长、越来越完整,V(s) 逐渐打高分。
  • 对任意时刻t,都有V(s)<V(st+1)

优势偏差

  • 初期训练阶段 几乎没有KL惩罚,奖励为0,TD Error 恒大于0,导致优势恒大于0。
A^t≈∑l=0T−t−1λlδt+l=∑l=0T−t−1λl(rt+l⏟初期为0+V(st+l+1)−V(st+l)⏟初期>0)⇒A^t>0
  • At GAE优势是后面多个TD Error的加权求和

    • 由于TD Error恒大于0,Token越靠前 累加正项越多,最终优势值 A^t就越大。
    A^t=δt+λ⋅A^t+1
AtGAE(st,at)=δt+γλAt+1GAE(st+1,at+1)

若TD大于0,越靠前的token,优势值越大,证明过程

  • 优势值缓慢递减
δt>0⇒A^t>λ⋅A^t+1A^t>λA^t+1>λ2A^t+2>λ3A^t+3>⋯>λT−t−1A^T−1
  • 令δt≈c>0

    A^t=∑l=0T−t−1λlδt+l=∑l=0T−t−1λlc=c⋅1−λT−t1−λ
  • 从公式可以看出,t越靠前,优势值越大。

如下图所示,前面的token价值小、后面的token价值大,TDError>0,最终导致前面的token优势大,最后导致模型回复长度急剧缩短。
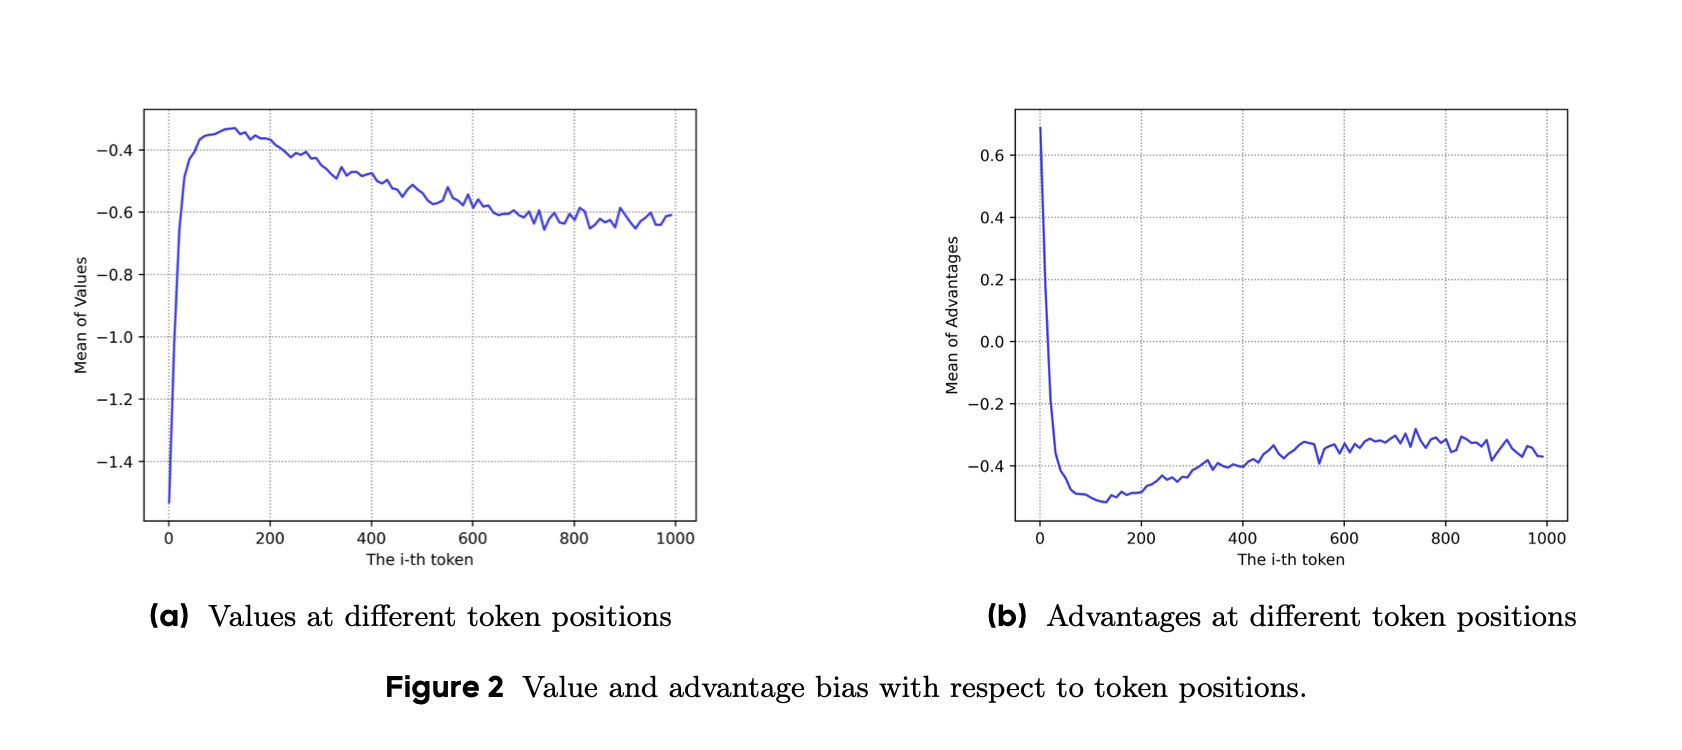
GAE 奖励信号衰减 ​

奖励信号衰减

更多详细推导见 GAE 奖励信号衰减

背景

  • 在LLM中,中间token奖励为0、仅最后1个token有环境奖励信号 rT。
  • 当真实外部信号rT 传递回第t个token时,会乘以权重(λγ)T−t,(λ)T−t ,权重容易变成0。
A^t=(λγ)T−trT⏟真实奖励信号+(一堆只包含V(s)的项)⏟来自价值函数估计的信号

奖励衰减缺陷 当λ<1 且 T-t 很大时

  • 前面token 收不到任何有效奖励信号,权重接近0了。
  • Critic模型 无法学习到他们的真正贡献。

当λ<1时,奖励信号衰减权重在后面的token衰减很快,接近1时衰减较慢。

LLM as Token-Level MDP过程 ​

马尔可夫决策过程 笔记

Token-Level MDP

符号定义

  • Prompt:x=(x0,⋯,xm)
  • Response:y=(y0,⋯,yT)
  • 词表:A

Token-Level MDP

  • 状态空间S:在时间步t,状态定义如下:

    st=(x0,⋯,xm,y0,⋯,yt)
  • 动作空间A:从词表A选择一个词token,比如选择动作a=yt+1

    yt+1=pθ(⋅∣st)=πθ(⋅∣st)
    • 论文里常用符号,q代表x,o代表y输出。也有用c代表当前状态
    πθ(ot∣q,o<t)
  • 状态转移矩阵P:状态转移概率为1

    • 给定st、执行动作a=yt+1,得到新状态st+1=(x0,⋯,xm,y0,⋯,yt,yt+1)。
    p(st+1∣st,a)=1
  • 终止条件:达到EOS或最大长度。

  • 奖励函数r(s,a):在状态s执行动作a的奖励。

    • 通常仅在序列结束后,环境才会给一个序列级信号。
    • GRPO和PPO有不同策略。
  • 初始状态分布d0:prompt x的概率分布,s0=(x0,⋯,xm)

  • 优化目标

    Lθ(c)=Ex∼pθ(⋅|c)[R(c,x)]

核心方法 ​

ValuePretrain/Critic 预训练 ​

📕核心方法

Value Pretrain 解决价值偏差

解决问题

  • RM初始化Critic带来的价值偏差问题、λ<1时带来的奖励信号衰减问题。

核心思想

  • 在正式PPO前 固定策略,使用 λ=1,对Critic做一次预训练。
  • 通过固定策略+MC回报,把价值模型的学习从不稳定的RL过程变成 稳定的监督学习过程。

具体做法

  • 固定策略模型(如πsft),使用GAE + λ=1退成MC采样,得到稳定梯度信号。

  • 正式PPO前 单独训练Critic模型,使其准确预测回报,直到收敛,看2个指标

    • Value Loss:预测价值和真实奖励 之间的差距

    • Explained Variance/解释方差:衡量预测趋势和真实趋势的匹配程度。

      • 预测误差的方差除以真实方差。预测误差的方差:还剩下多少无法解释的波动性。
      Explaned Variance=1−Var(Ygold−Ypred)Var(Ygold)∈(−∞,1]解释方差=1−无法解释方差占总方差的比例
      • 接近1:最好情况,模型几乎解释了所有的数据波动。
      • 接近0:模型和简单预测所有结果的平均值差不多。
      • 负数:模型还不如直接预测平均值,预测甚至是有害的,预测趋势是相反的。
  • 正式PPO时 使用预训练过的Critic模型,而不再使用RM做随机初始化。

价值预训练以后,advantage不再有偏差,模型输出长度也正常了。
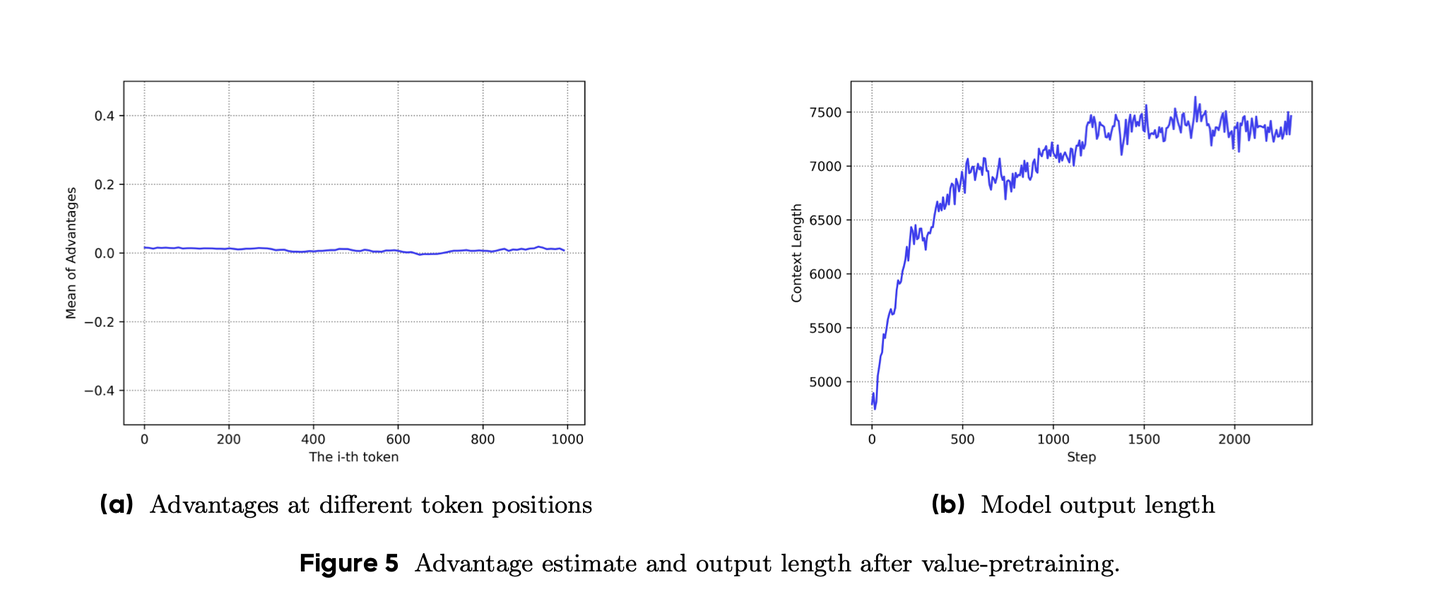
python
# 从SFT模型生成响应
responses = generate_responses(sft_model, prompts)

# 计算完整响应的奖励
rewards = reward_model(responses)

# 训练价值模型以预测每个token位置的奖励
for token_pos in range(len(response)):
    # 价值目标是序列的最终奖励
    value_target = rewards[response_idx]
    # 训练价值模型以预测每个位置的这个目标
    value_loss = (value_model(token_pos) - value_target)^2
    optimize(value_loss)

Decoupled-GAE/解耦GAE ​

Decoupled-GAE

解决问题

  • Critic偏好无偏估计,λ=1,追求准确性。
  • Actor偏好低方差, λ<1,需要平衡偏差和方差。如果方差太大,会导致训练不稳定`。
  • 训练RL的时候,成本很高,必须要降低方差、保证收敛。

核心思想

  • Critic和Actor使用不同的λ。
  • Critic:λ=1,确保奖励信号 在长序列中无衰减地传播,更好地学习价值模型。
  • Actor:λ<1(0.95),有效降低优势估计的方差,使策略更新过程更稳定、收敛更快。
python
# 解耦GAE
critic_lambda = 1.0  # 确保价值学习的强信号传播
actor_lambda = 0.95  # 控制策略更新中的方差

# 使用 critic_lambda 计算价值模型更新的优势
critic_advantages = calculate_gae(rewards, values, critic_lambda)  
value_loss = (values - (rewards + gamma * next_values))^2

# 使用 actor_lambda 计算策略模型更新的优势
actor_advantages = calculate_gae(rewards, values, actor_lambda) 
policy_loss = -log_probs * actor_advantages 

实验结果 ​

实验设置 ​

✍️实验设置

实验配置

实验数据

  • 数学数据
    • 训练:AIME(历史数据);评测:AIME(近2年)
  • 通用数据,验证泛化性,是否只在数学上生效
    • GPQA:问答
    • CodeForces:编程

模型

  • Qwen2.5-32B

训练策略/算法

  • 冷启动:使用一些推理数据 来冷启动训练模型,使得按 <think></think>格式输出
  • Value Pretraining:λ=1,Freeze Policy,其他参数同标准PPO。
  • Decoupled-GAE:λcritic=1, λactor=0.95。作者也研究了0.9-1.0参数。

Reward

  • Rule-Based:1 正确、-1错误

Baseline

  • 标准PPO
    • λ=0.95
    • 学习率 Policy 1e-6, Critic 2e-6,
    • KL惩罚系数 0:因为是rule-based reward,没有hacking
    • 上下文长度:8k、16k

关键结果 ​

🍑关键结果

关键结果
  • VC-PPO 有效果,解决了PPO 训练崩溃问题
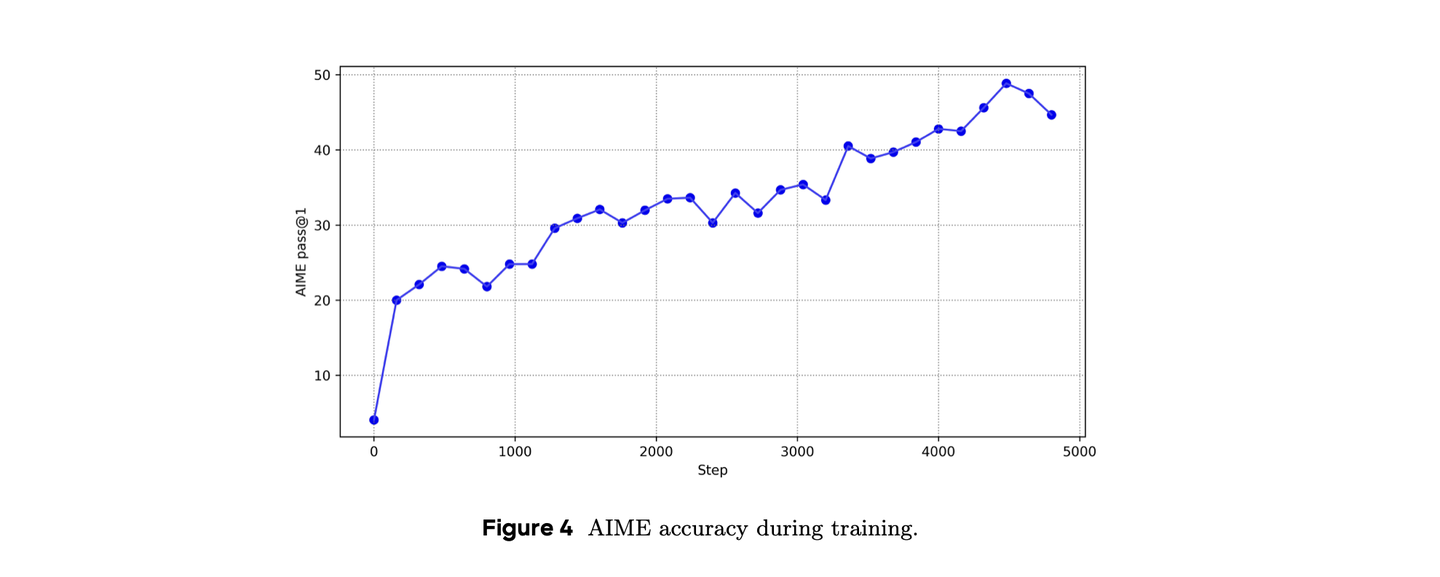
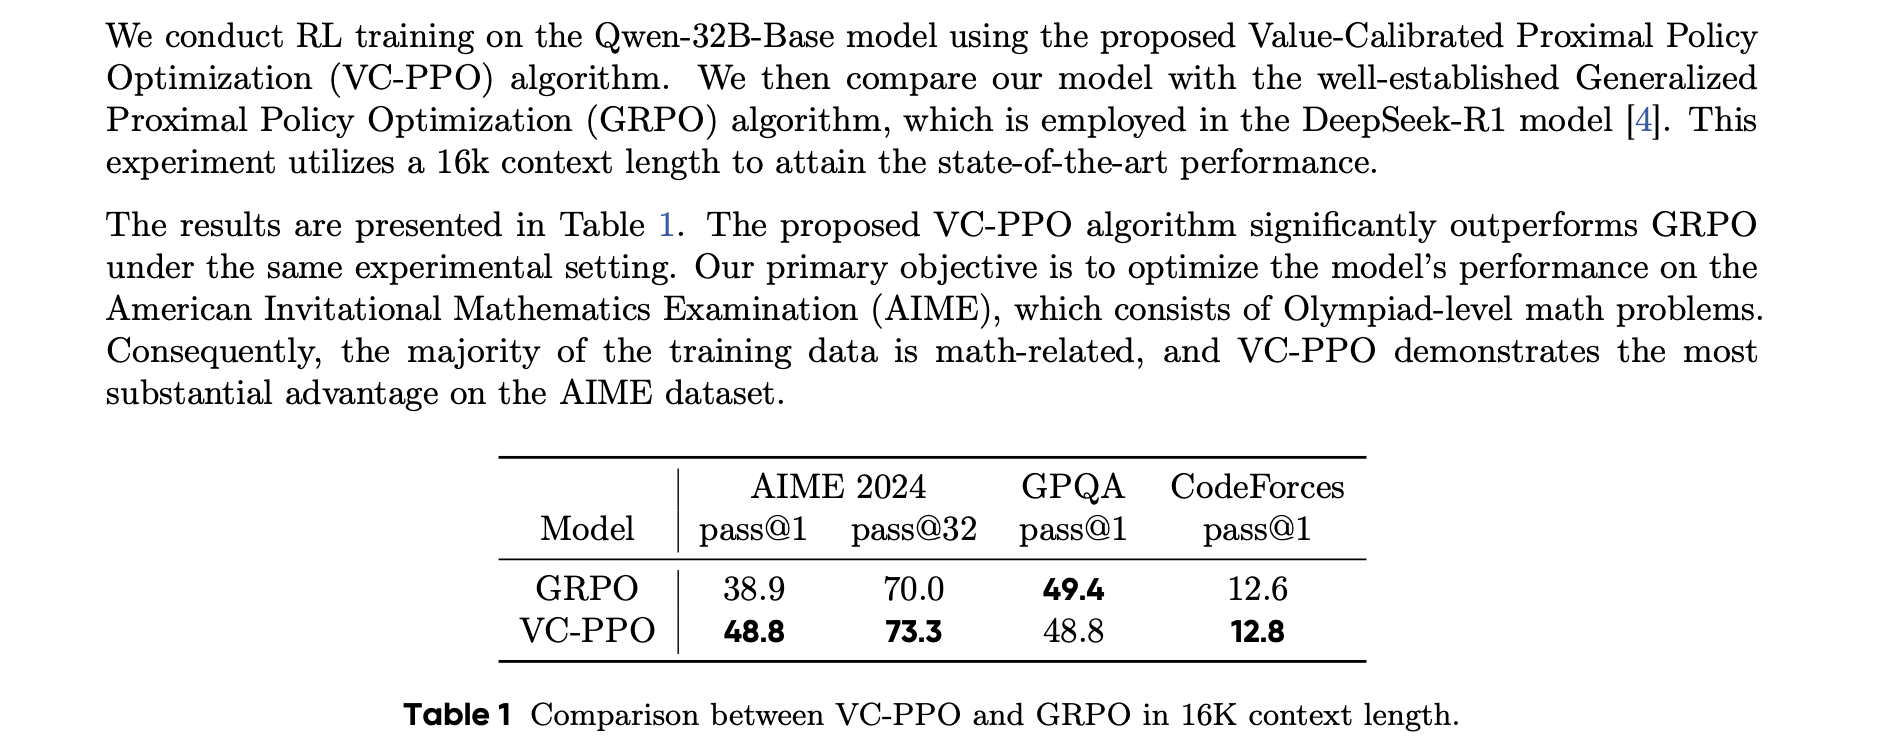
    • 标准PPO在AIME崩溃,VC-PPO pass@1 从5.6 -> 41.9(8k) -> 48.8(16k)
  • Value-Pretrain和Decoupled-GAE 两者都很重要。
    • 不解耦,性能会下降10个点(AIME)。
  • 价值预训练注入了知识,但并非训练的越久越好。50-100步有提升,但150步开始下降。
  • 价值和策略 在方差-偏差平衡上偏好不同。
    • Critic:偏好λ=1,低偏差、高方差
    • Actor:偏好λ<1,偏好低方差、哪怕有一些偏差。

AIME 有提升,非常优雅的提升曲线,并且超过GRPO。

价值预训练和Decoupled-GAE 都很有用。
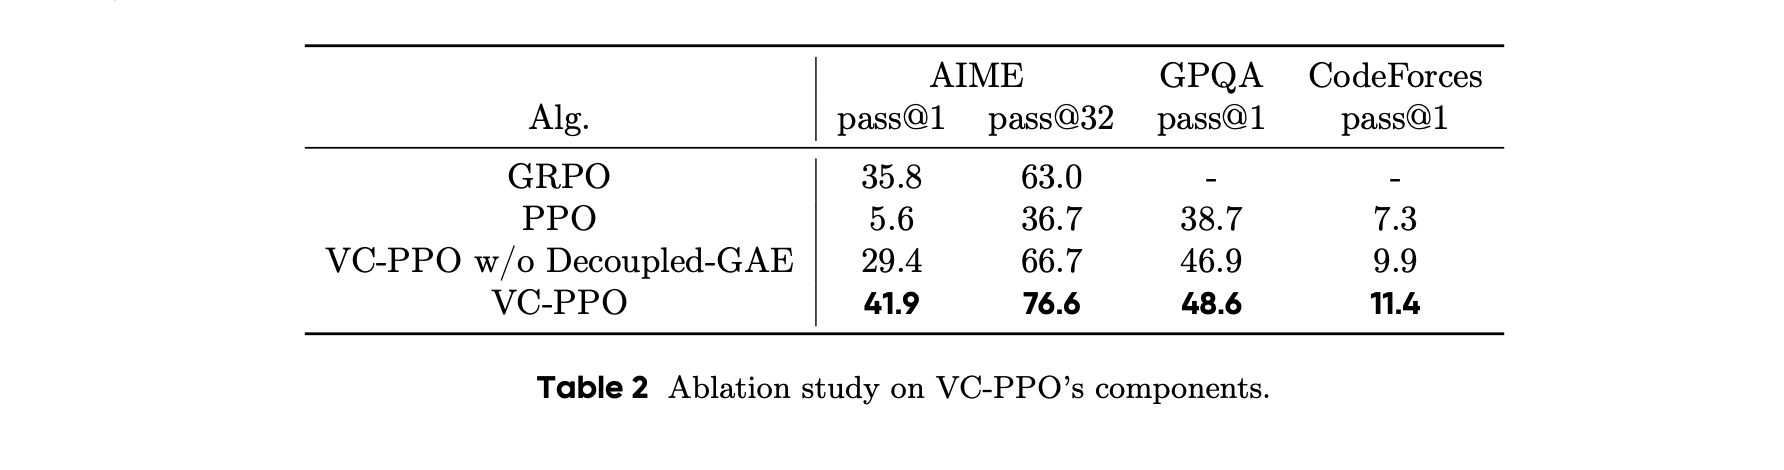
未来方向 ​

⛳未来方向

未来方向
  • Actor和Critic偏好不同,不应该视为一个整体进行优化,可以分开。
    • 根据回归loss和策略梯度两种不同的数学特性
    • 为Actor和Critic设置 更加差异化的优化策略,而不仅仅是调整λ。

(2501) REINFORCE++ ​

摘要
  • paper, paper

  • 很不错的工作,REINFORCE思想 + PPO技术,简单有效。

  • Reward加入Token-Level KL(K2) 惩罚、batch-level std 全局归一化、PPO-Clip Loss

  • 在通用RLHF、小规模数学、推理和Agent任务上做了验证,REINFORCE++ 优于GRPO。

问题背景 ​

❓问题背景

局部归一化存在问题 ​

问题背景

现有RLHF方法存在一些问题

  • PPO:由于Critic,导致开销大、不好训练
  • REINFORCE:简单 但方差大
  • GRPO:新的复杂性、不稳定性等。

GRPO/RLOO Prompt/Local-Level Normalization 存在问题

  • 存在理论偏差
    • 数学公式证明,分子(reward)和分母(local std)不是独立的,存在理论偏差。
  • 实际不稳定
  • 任务过拟合
    • 局部归一化:旨在激励模型战胜组内其他样本,而非追求全局最优奖励。
    • 在简单任务上过拟合,复杂任务上难以提升。
    • GRPO里的难度和长度偏差

核心方法 ​

📕核心方法

REINFORCE++ (k>=1) ​

核心方法

三个原则

  • 简单:基于REINFORCE开发优化
  • 训练稳定性:Reward 加入 Token-Level KL 惩罚,PPO-Clip Loss,归一化优势
  • 效率:critic-free,高效

整体目标

  • 和PPO一样,只是修改了优势估计
  • 每次采样1个回答,G=1
Lppo(θ)=−1G∑i=1G⏟样本间平均1|oi|∑t=1|ot|⏟序列内平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)

优势估计:Token-Level KL 惩罚直接加入Reward

  • 奖励=真实轨迹线奖励 - KL惩罚
  • KL惩罚:累加t时刻后每一个token的KL惩罚,因是对未来产生影响。
R(q,ot)=A^q,ot=r(o1:T,q)−β∑i=tTDKL(i)=rT−β∑i=tTlogπθold(ot|q,o<i)πθref(ot|q,o<i)

全局归一化

REINFORCE++ w/baseline (k>1) ​

REINFORCE++ w/baseline

背景

  • 多步RL场景

核心思想

  • 轨迹奖励 + Token-Level KL 惩罚

    R(q,ot)=r(o1:T,q)−β∑i=tTDKL(i)
  • 局部基线:Local/Group Baseline/Mean

    Aq,ot′=Rq,ot−meangroup(Rq,ot)
  • 全局归一化

    Aq,otnorm=Aq,ot′−meanbatch(Aq,ot′)stdbatch(Aq,ot′)+ϵ
  • Loss

    L=L(Anorm)−λ⋅JDLk2(θ)
  • KL散度使用K2: 低方差,更稳健

    k2=12(log⁡πθπref)2

算法实验 ​

实验配置 ​

✍️实验设置

实验配置

任务

  • 通用RLHF
    • 2w 多样化Prompt数据集
  • 推理任务
    • 小规模数学数据:30 AIME 训练集
    • 逻辑推理:Knights and Knaves
  • 多步RL:python解决数学问题

模型

  • LLaMA3-8B、Qwen2.5-7B

算法

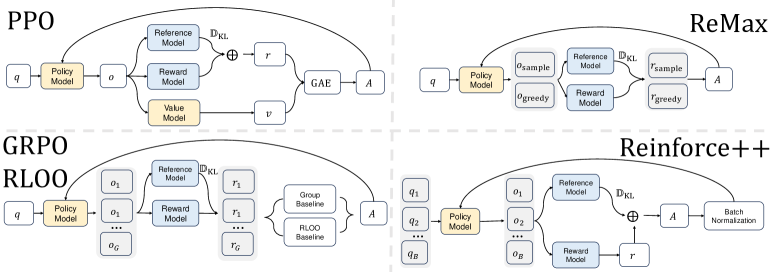
  • 核心:REINFORCE++、REINFORCE++ w/Baseline
  • 比较:GRPO、PPO、RLOO、ReMAX

关键结果 ​

🍑关键结果

关键结果
  • 引入PPO技巧的REINFORCE算法,大量实验表明REINFORCE++在人类对齐上有优势

  • 通用RLHF任务

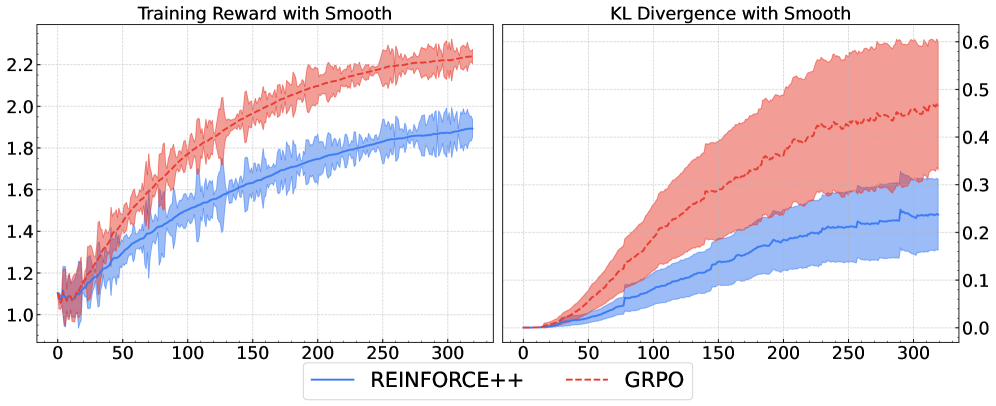
    • REINFORCE++ 单样本和GRPO 4样本 分数相当,回答更短token效率更高
    • KL散度更低、训练更稳定
  • 推理任务

    • 小规模数据集上REINFROCE++泛化性更好,GRPO则出现过拟合。
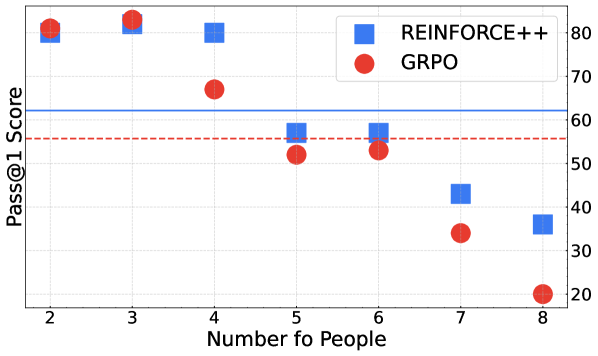
    • 逻辑推理任务上,随难度增加,GRPO性能急剧下降,REINFORCE++较为稳定
  • Agent 任务

    • 多步工具使用,REINFORCE++ w/Baseline 高于GRPO 高于PPO。24.1 > 22.58 > 21.85
  • 全局归一化:被LitePPO、ScaleRL、DLER等相继验证

通用RLHF
谜题数据
未来方向 ​

⛳未来方向

未来方向
  • 更高效的优势估计方法
  • 自适应归一化策略
  • 扩展到多模态模型
  • 理论分析

(2402) RLOO ​

RLOO 摘要
  • paper

  • RLOO

    • REINFORCE + 留一法计算优势,无需Critic和Ref模型。
    • Trajector-Level:在整个序列做建模,而非单个token作为一个动作。
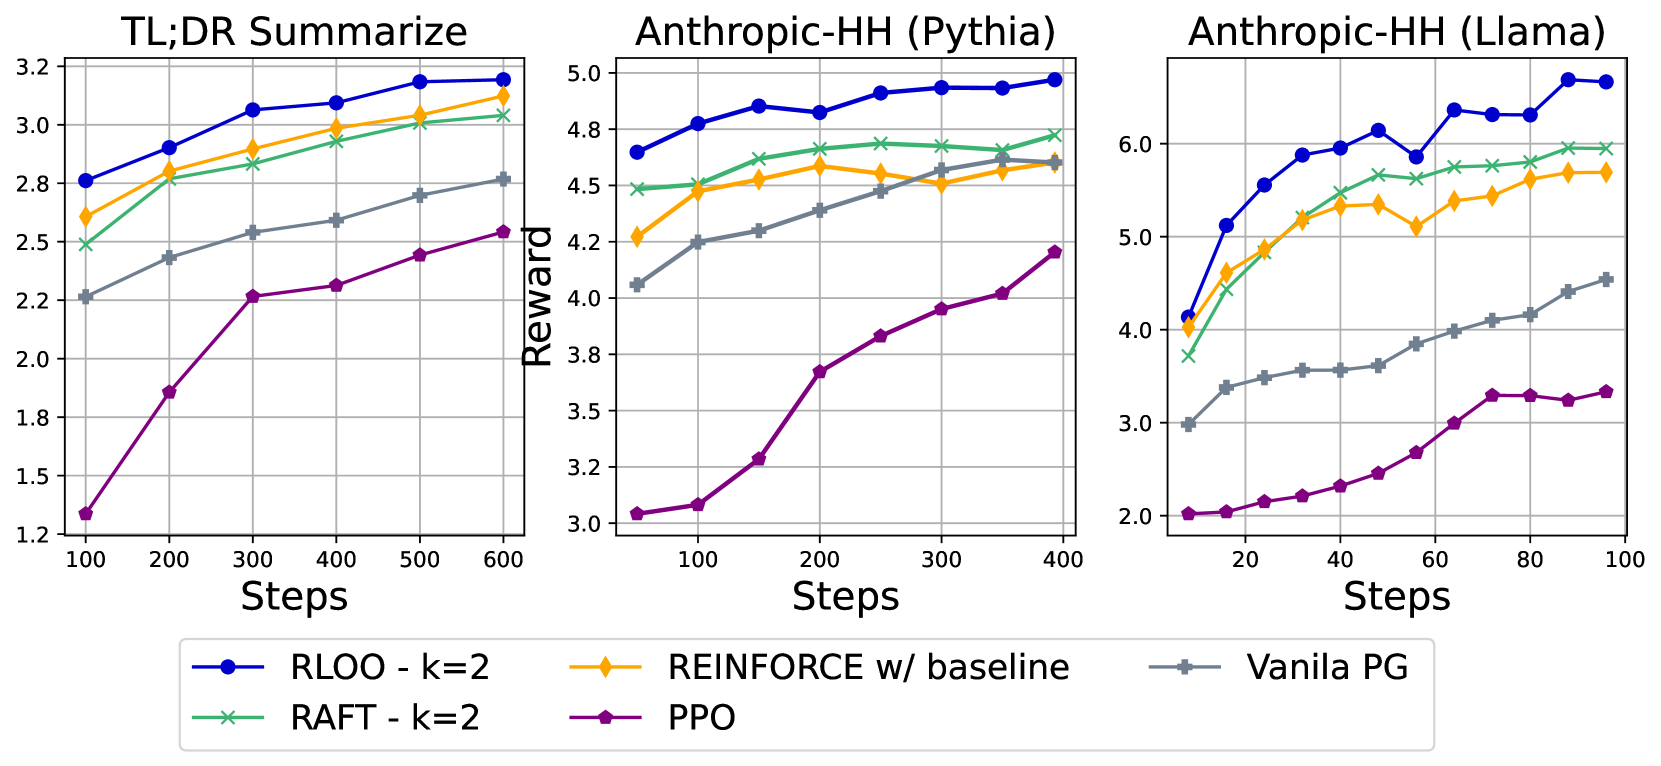
    • On-Policy 算法。
  • 在2个RLHF任务上,RLOO效果都优于PPO、Vanila PG、DAFT、DPO等。

问题背景 ​

PPO复杂可能不是最优选择 ​

❓问题背景

问题背景

人类对齐标准PPO阶段

  • SFT:高质量prompt-answer数据集微调
  • 训练RM:Pair、人类偏好
  • RL阶段:SFT作为初始策略,RM作为环境反馈信号。优化模型 使其获得更高奖励。

问题

  • PPO成本高、复杂。
  • RLHF场景下,是否真的需要PPO?

PPO 可能不是最优选择

  • 低方差环境但引入Critic可能带来偏差
    • 预训练+SFT后的模型 方差低。
    • 为降低方差,PPO引入Critic和优势估计,反而会带来偏差,得不偿失。
  • PPO-Clip 可能不必要
    • clip 防止策略更新步子太大导致崩溃。
    • 实际实验发现触发频率非常低,小于5%
  • 建模方式可能不恰当
    • PPO:每个词作为动作,前面的词作为状态
    • LLM:生成完整序列后才有奖励
    • 可以把生成整个序列看成一个单一动作,更自然和高效,可能更合适

核心方法 ​

REINFORCE + 留一法计算基线 ​

📕核心方法

REINFORCE Leave-One-Out

REINOFRCE

∇J(θ)=Ex∼D,y∼πθ(⋅|x)[(R(x,y)−b)⋅∇θlog⁡πθ(y|x)]∇JREINFORCE(θ)=1G∑i=1G∑t=1|oi|(R(x,y)−b)⋅∇θlog⁡πθ(y|x)

REINFORCE Leave-One-Out

  • 对一个Prompt,采样K/G次。计算优势时,基线使用其余k-1个的奖励平均值

    A(x,yi)=R(x,yi)−1K−1∑j=1,j≠iKR(x,yj)
  • 等同于减去平均回报基线

A(x,yi)=KK−1(R(x,yi)−1K∑j=1KR(x,yj))
  • 和GRPO很像,但是不除以标准差。

    A(x,yi)≈R(x,yi)−mean(R)
  • 同策略算法,无需重要性权重修正偏差。

整体优化目标

  • Trajectory-Level,而非Token-Level。
∇J(θ)=1K∑i=1K⏟轨迹级(R(x,yi)−1K−1∑j=1,j≠iKR(x,yj))⋅∇θlog⁡πθ(yi|x)

算法实验 ​

实验设置 ​

✍️实验设置

实验配置

任务

  • 训练数据:2个公开rlhf数据集
    • TL;DR Summarize(文本摘要)
    • Anthropic Helpful and Harmless Dialogue(HH,对话)。
  • 评测数据

模型

  • Pythia-6.9B和Llama-7B

算法

  • RLOO
  • 对比:
    • PPO、Vanilla PG(简化版本PPO,λ=1,仍在token层面建模)
    • DPO、RAFT(生成多个样本,选择得分最高的进行SFT)

评估指标

  • 奖励分数:测试集上RM的分数
  • 模拟胜率:GPT4作为裁判,生成答案和基线回答之间做比较
  • 对齐税:是否损害了模型其他能力。困惑度衡量流畅性,ngram衡量多样性。
  • 鲁棒性:测试算法对KL系数和奖励噪声的敏感度

关键结果 ​

🍑关键结果

关键结果

简单基础PG方法优于PPO

  • 在所有数据集和模型上,Vanilla PG和REINFORCE的性能优于PPO。
    • 在Llama+HH数据集上,PPO胜率32.0%,REINFORCE达55.3%。

RLOO性能最佳(奖励分数+GPT4胜率)

  • 4个样本,摘要数据集胜率(RLOO 77.9% > PPO 67.6% > RAFT 73.2% > DPO 66.6%)

RLOO样本效率更高

  • RLOO使用2个样本性能就能达到甚至超过RAFT使用4个样本水平。

建模完整序列是有效的

  • 在完整序列上操作的REINFORCE,性能与在token级别的Vanilla PG相当或更好
  • 同时实现更简单 计算开销更小。

RLOO鲁棒性更强

  • 更高KL惩罚或RM噪声时,RAFT下降明显,而RLOO则更稳健。
    • 梯度更新,RLOO考虑所有样本奖励。
    • RAFT仅依赖奖励最高样本,一旦排序错误,学习就受到严重影响。

⛳未来方向

未来方向
  • 未研究奖励模型过优化/Reward Hacking问题。

(2017) PPO ​

PPO 笔记

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026