Skip to content

免模型预测和控制

📅 发表于 2025/08/27
🔄 更新于 2025/10/23
👁️ — 次访问
📝 5693 字
⏳ 18 分钟
rl-theroy
#免模型
#免模型预测
#免模型控制
#蒙特卡洛
#时序差分
#λ-return算法
#狭义策略迭代
#广义策略迭代
#同策略
#异策略
#Sarsa
#Q学习
#经验平均回报
#增量均值
#蒙特卡洛误差
#动态规划
#自举
#采样
#强化
#单步时序差分
#n步时序差分,TD Error
#e贪心策略
#行为策略
#目标策略
#Q函数估计
免模型 ​

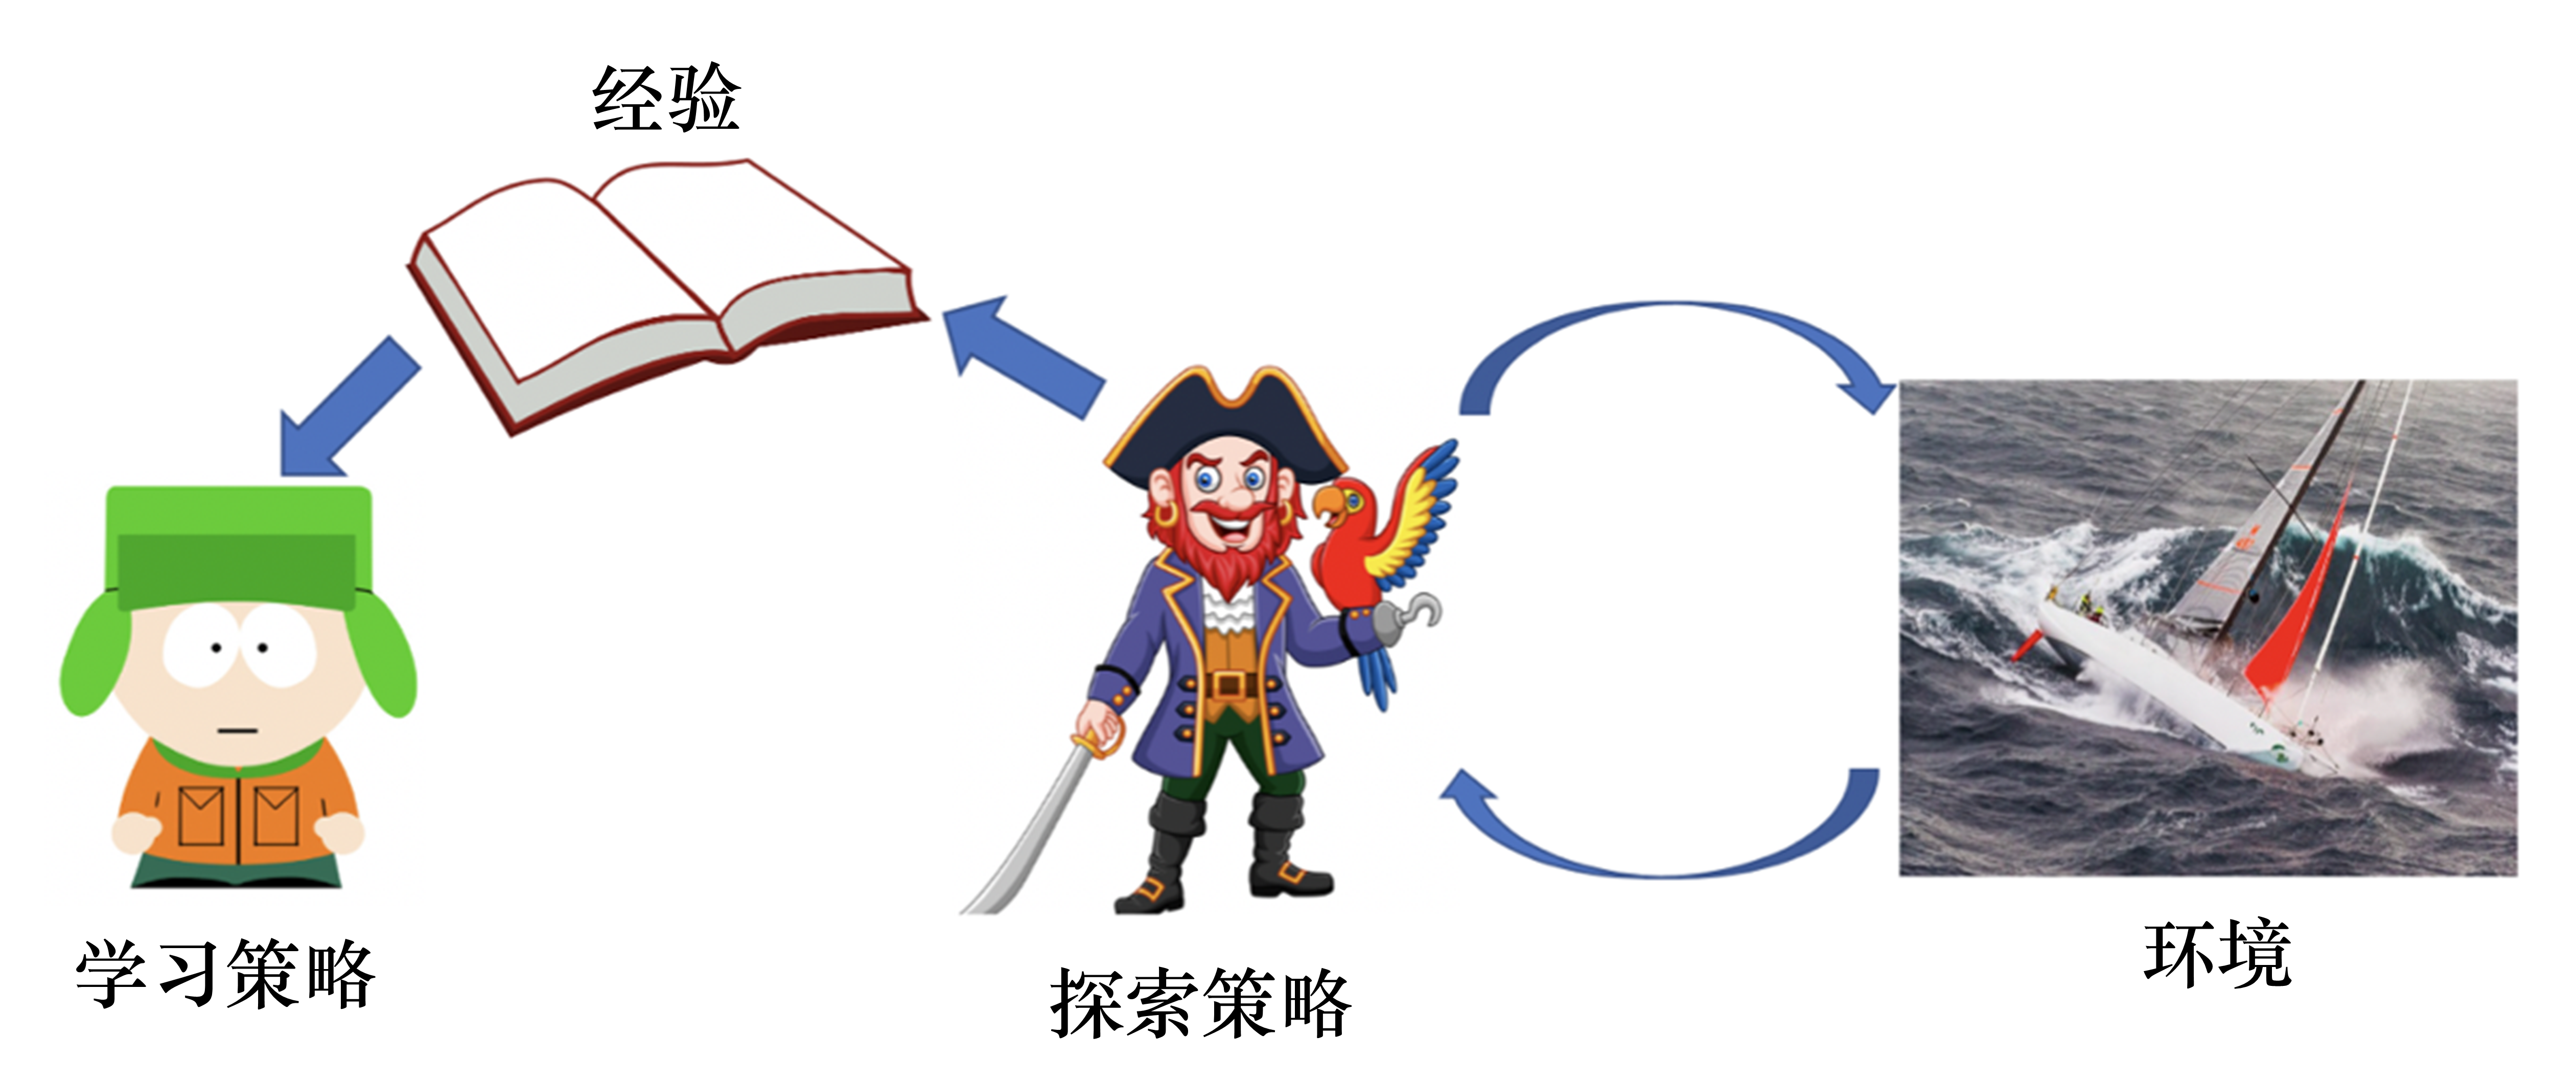
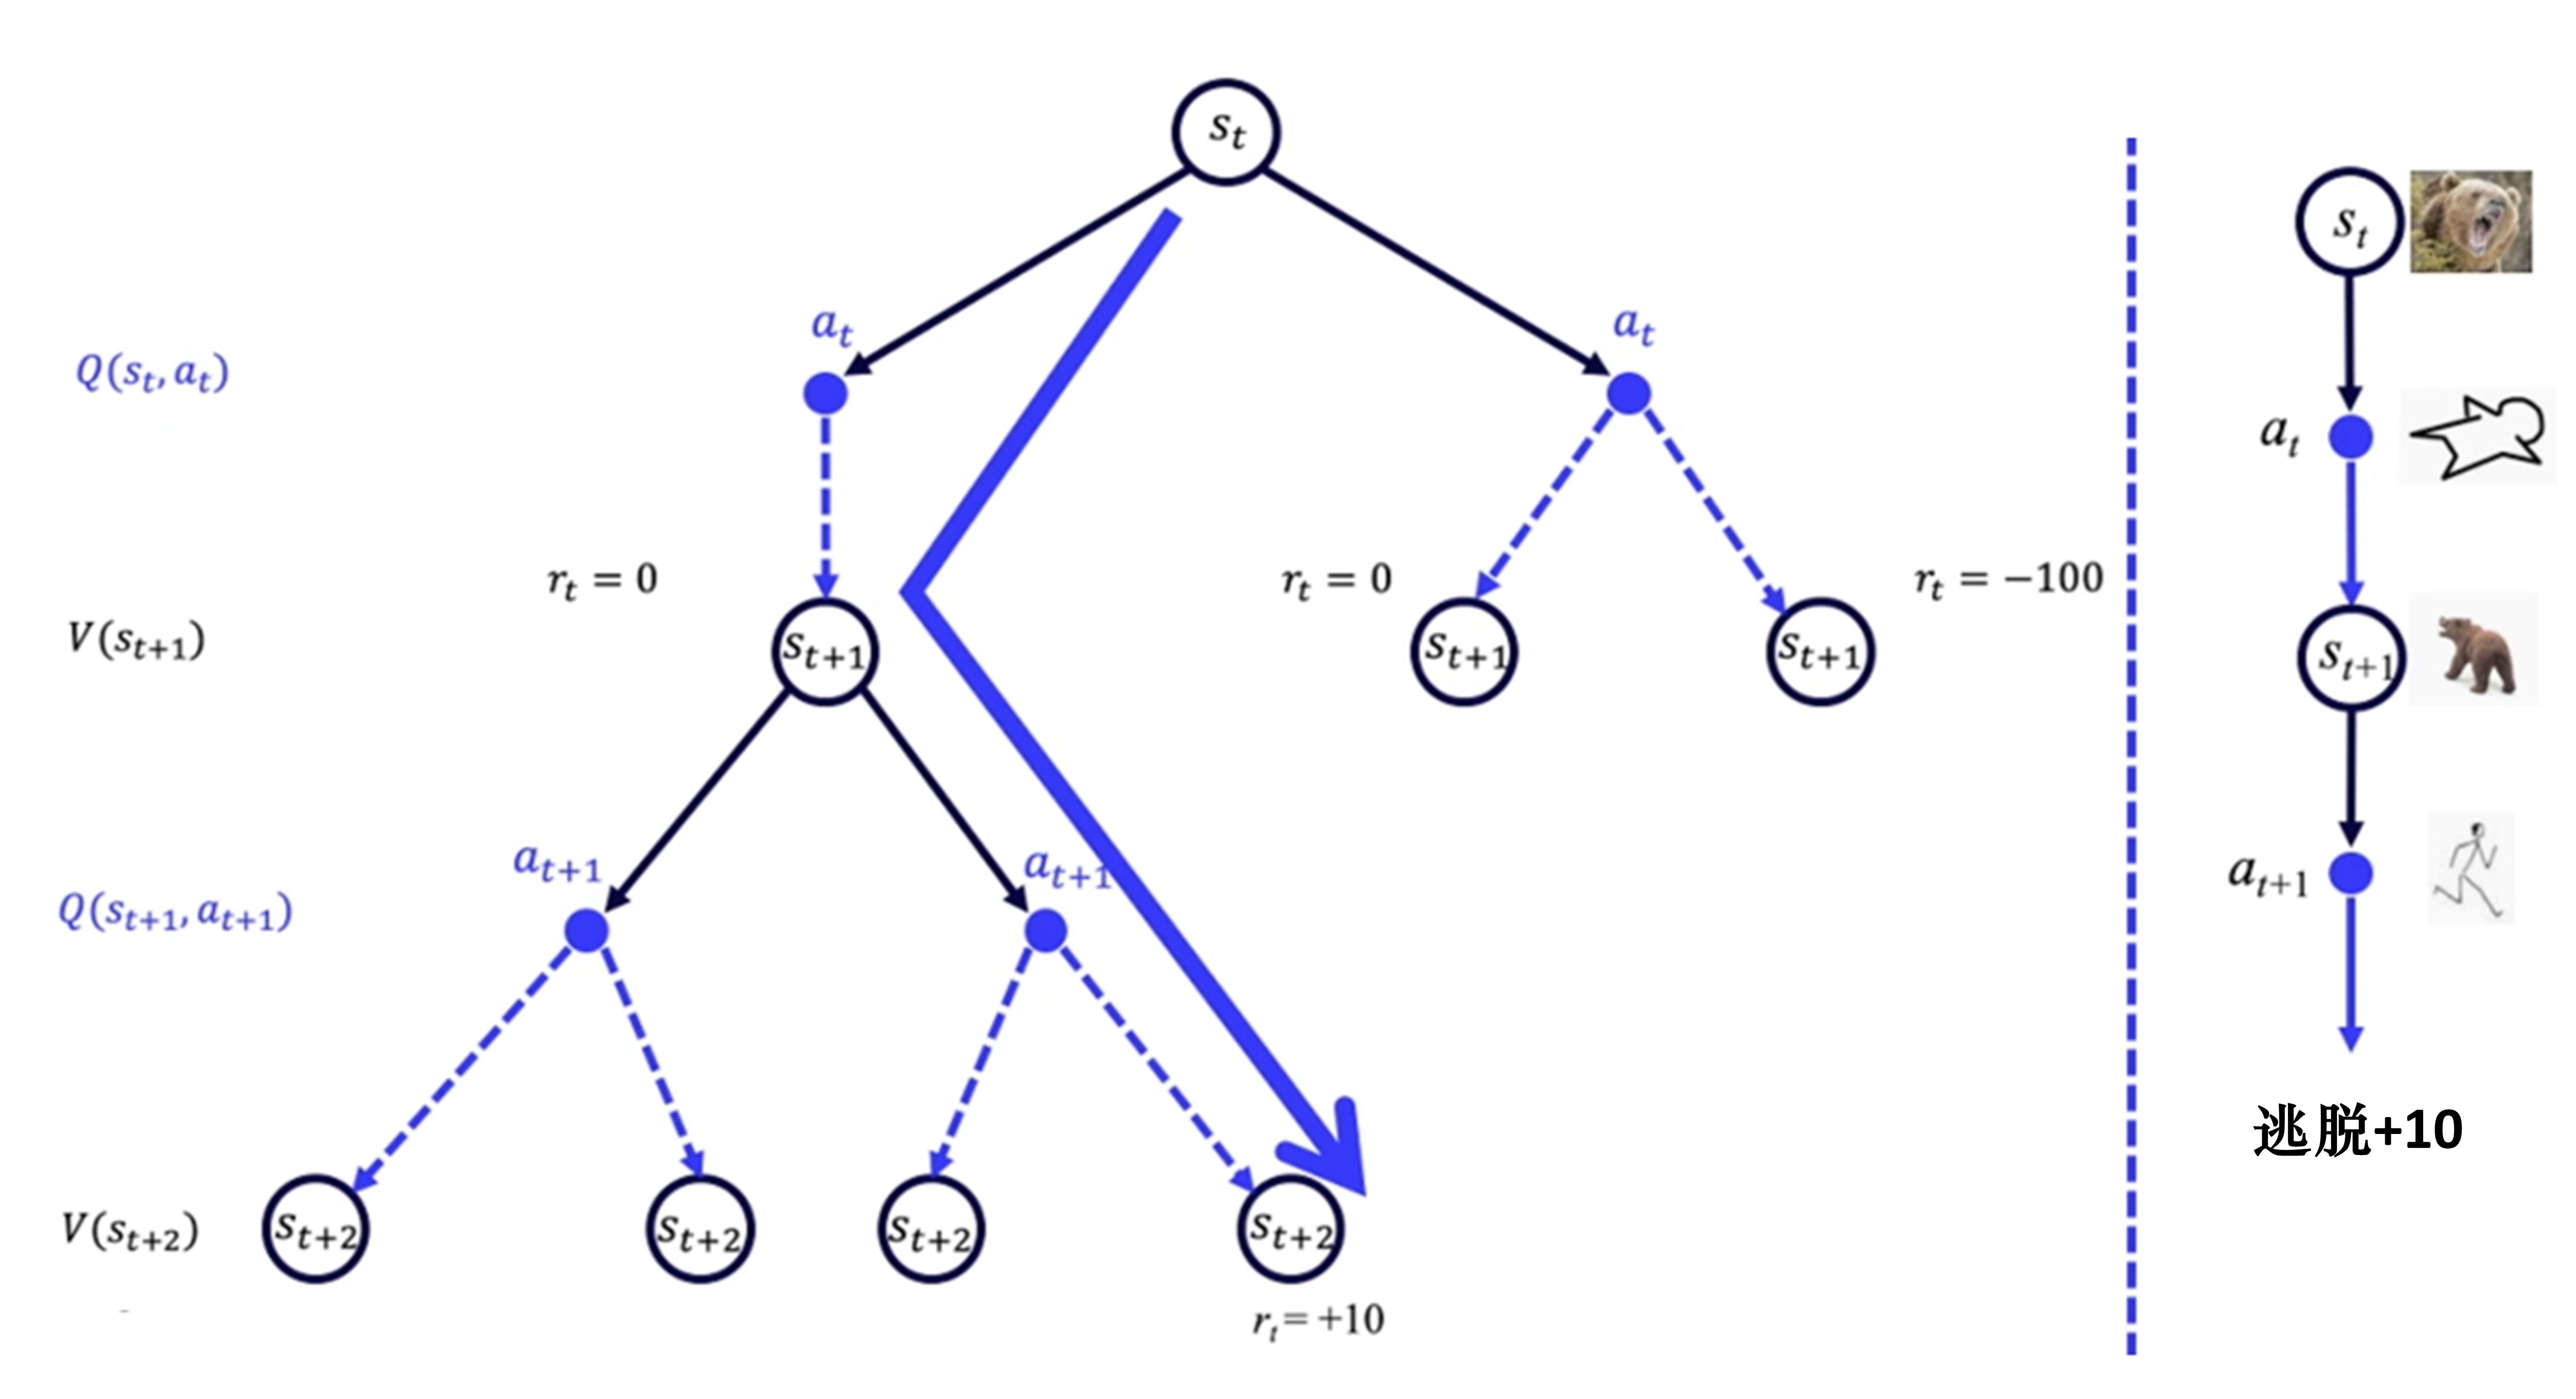
免模型试错探索,环境信息未知,没有概率可言,熊何时出现做什么,一切都未知。

RL可以应用在完全未知随机的环境,像人类一样,通过尝试不同的路来学习,慢慢了解哪个状态动作会更好。

免模型预测 ​

蒙特卡洛方法 ​

思想 ​

蒙特卡洛思想

核心思想

  • 通过多次采样来估计期望值的方法
  • 和环境实际交互获取经验(样本/轨迹),通过所有经验的平均回报来估计价值函数
  • 由于环境存在未知性,需要做探索-利用平衡,ϵ 贪婪策略做平衡。

特点

缺点

  • 只适用于有终止状态的马尔可夫决策过程 (MC方法通用问题)
  • 依赖每个轨迹的真实回报Gt

具体做法

  • 给定策略π,从状态s开始,智能体和环境交互,采样多条轨迹
  • 计算每条轨迹的真实回报Gt,用所有轨迹的平均回报来估计价值函数
Vπ(s)=Eτ∼π[rt+1+γrt+2+γ2rt+3+⋯∣st=s]=Eτ∼π[Gt∣st=s]≈1N∑i=1NGt(τi)
  • 如果估计Q函数,从状态s开始,强制执行动作a,再进行采样即可。
Qπ(s,a)≈Eτ∼p(τ)[G(τ)∣τs0=s,τa0=a]≈1N∑i=1NGt(τi)
  • 利用Q做贪婪策略,就能做策略改进了。
π′(s)=arg⁡maxaQπ(s,a)
经验均值估计价值函数

价值函数估计(经验均值)

  • 每回合,若在时间t状态s被访问,则更新总访问数和总回报
    • 总访问数: N(s)=N(s)+1
    • 总回报:S(s)=S(s)+Gt
  • 通过回报平均,来估计状态s的价值:V(s)=S(s)/N(s)

缺点

  • 需拿到所有的轨迹的回报后,才能求平均 更新价值函数

MC 增量更新 ​

MC 增量更新

做增量计算

  • 新估计值 = 旧估计值 + 学习率 * (目标值 - 旧估计值),
Vnew(st)=Vold(st)+α⋅(Gt−Vold(st)⏟目标值−估计值)V(st)←V(st)+α⋅(Gt−V(st)⏟MC误差)Q(st,at)←Q(st,at)+α⋅(Gt−Q(st,at))

蒙特卡洛误差

  • MC误差 = 轨迹真实回报 - 期望回报,希望估计回报 逼近真实回报
  • δ>0:说明估计值偏低;如果δ<0,说明估计值偏高,需要调整。
δ=Gt−V(st)

学习率α

  • 如果较大(接近1),更新比较激进,大幅朝着新回报值Gt靠拢

  • 如果较小,更新会比较保守。

优点

  • 不用保存所有样本数据,每采样一个新轨迹,就可以更新价值函数,做到回合级更新
  • 只更新轨迹上的所有状态,和轨迹无关的不用更新
  • 节省资源

缺点

  • 需等一个完整回合结束后,才能 算出每个状态的真实收益,利用收益去更新价值函数。
  • 不适用于持续性任务、步骤很长的回合制任务。

对比动态规划自举更新

Vk+1(s)=∑a∈Aπ(a∣s)(R(s,a)+γ⋅∑s′∈Sp(s′∣s,a)⋅Vk(s′))

MC vs DP ​

MC vs DP

环境模型

  • DP:需已知环境模型 (状态转移概率和奖励函数)
  • MC:无需完整环境模型,只需通过环境交互来收集经验即可
    • 只需拿到 实际发生的状态、动作和奖励
    • 不需事先知道 各种结果发生的概率,以及对应的奖励规律

策略更新

  • DP:使用自举,通过贝尔曼方程迭代更新。
    • 用价值函数估计值来更新价值函数,用策略评估值来更新策略。
  • MC:使用采样,通过轨迹回报来更新策略。

更新方式

  • DP:全局更新,需更新所有可能状态和动作。
  • MC:局部更新,只更新轨迹上的状态。通过一个经验的回报,就能做更新。

计算量

  • DP:计算量大。需计算所有可能的动作和状态,空间很大时,难以计算,非常慢。
  • MC:计算量小,只需更新轨迹上的状态动作即可。

适用场景

  • DP:状态空间小、模型已知
  • MC:状态空间大、模型未知

收敛性

  • DP:可收敛到最优解
  • MC:可能需要更多迭代次数才能收敛,受到样本随机性影响。

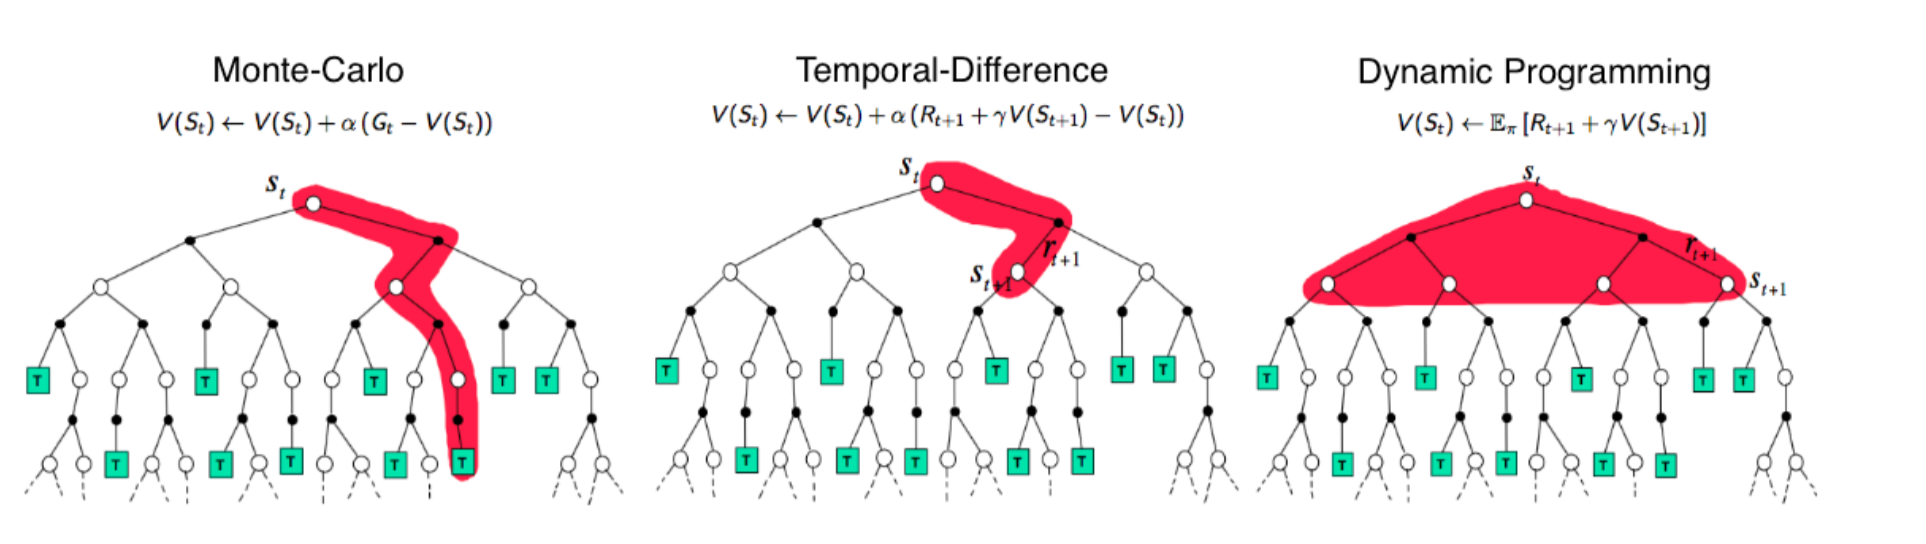
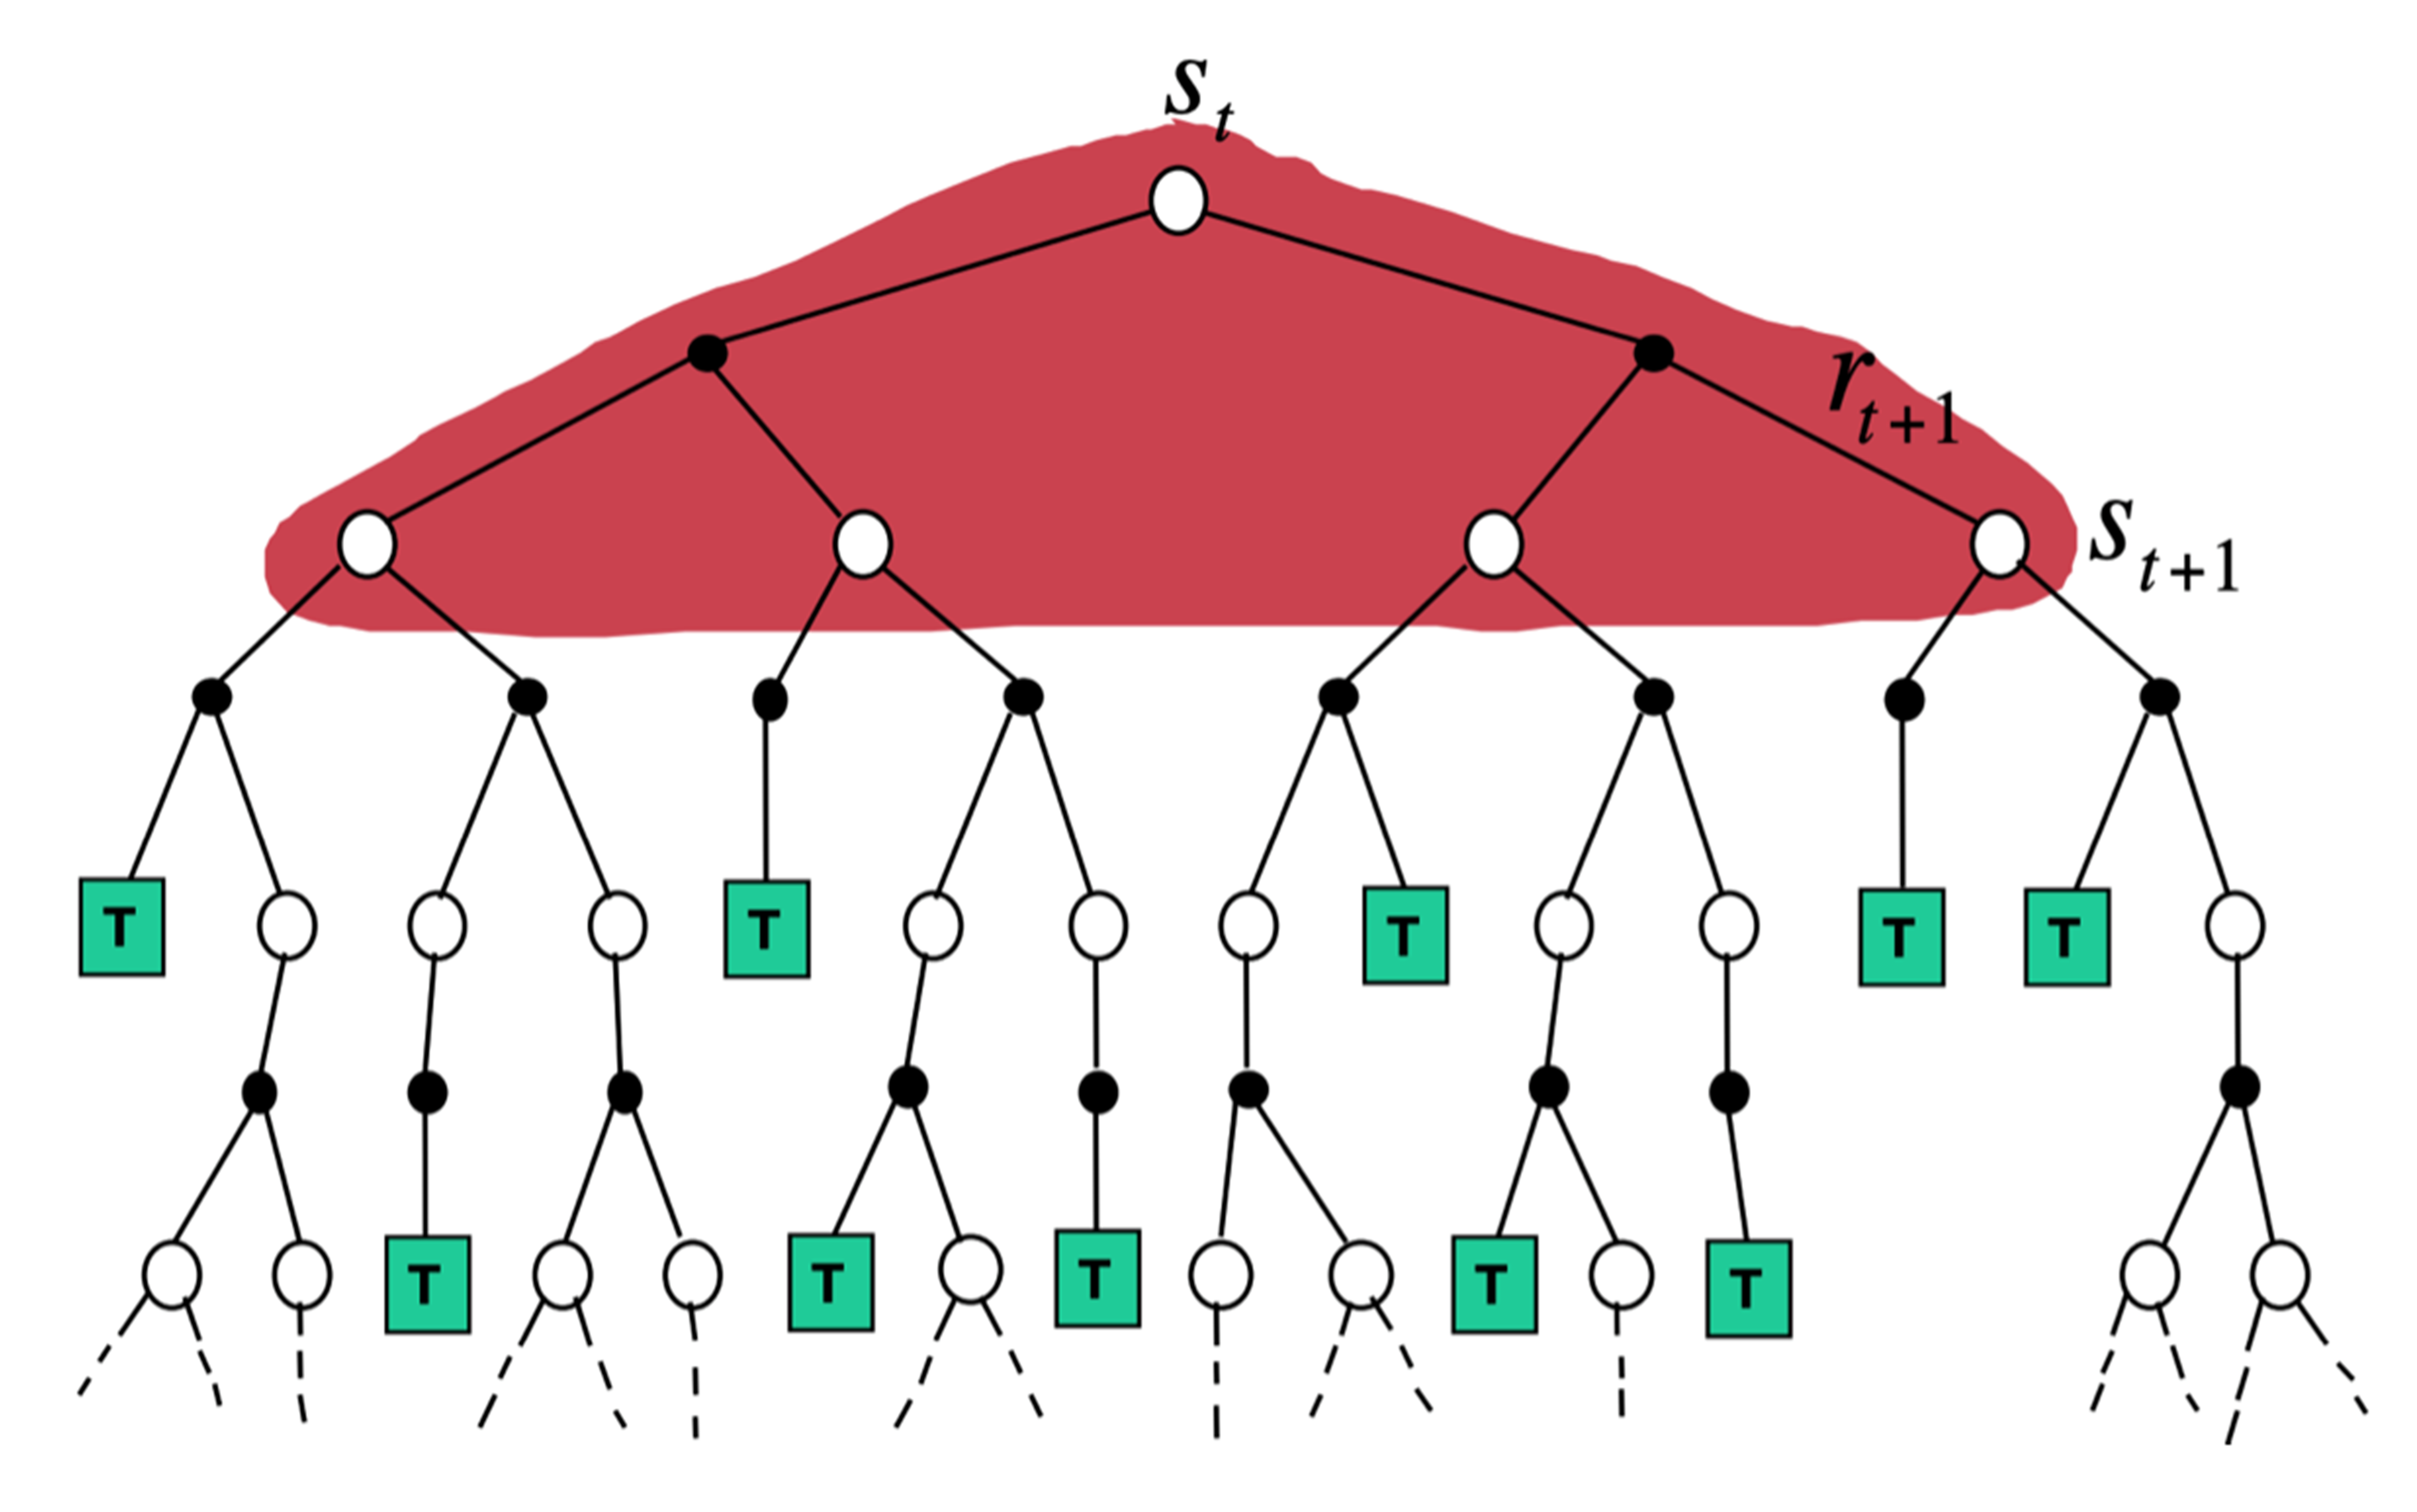
动态规划需更新所有状态来求期望:

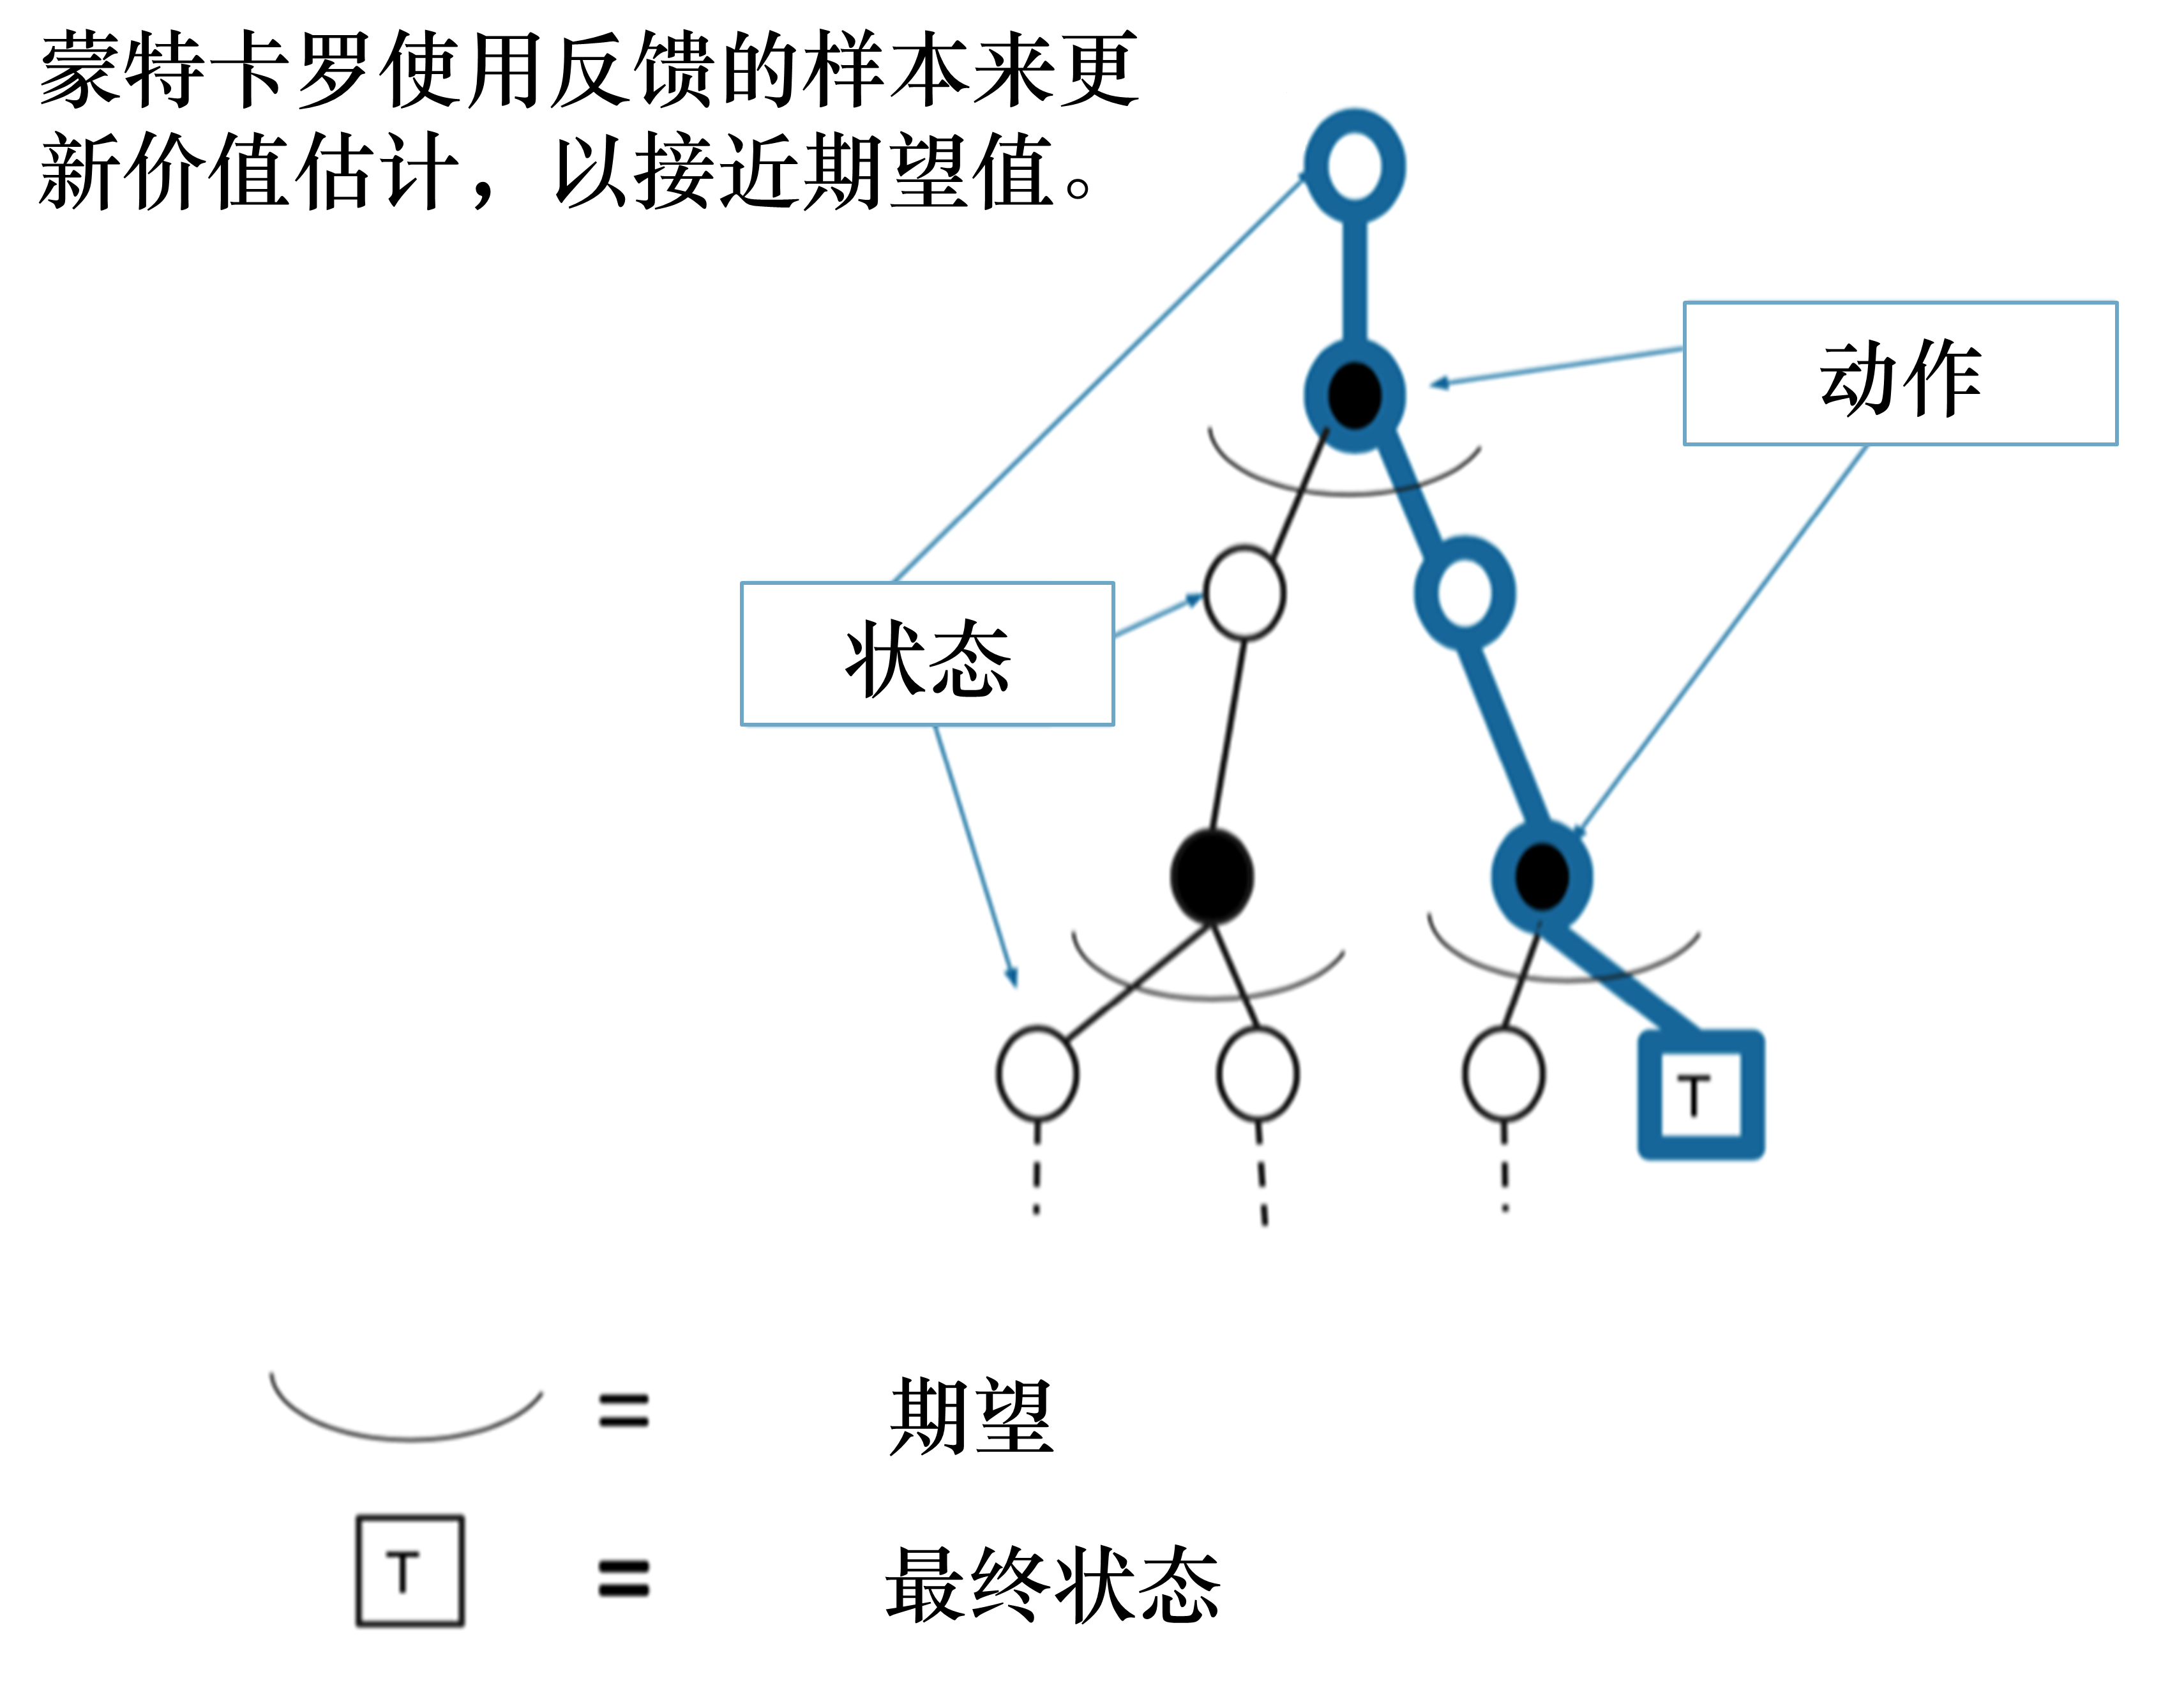
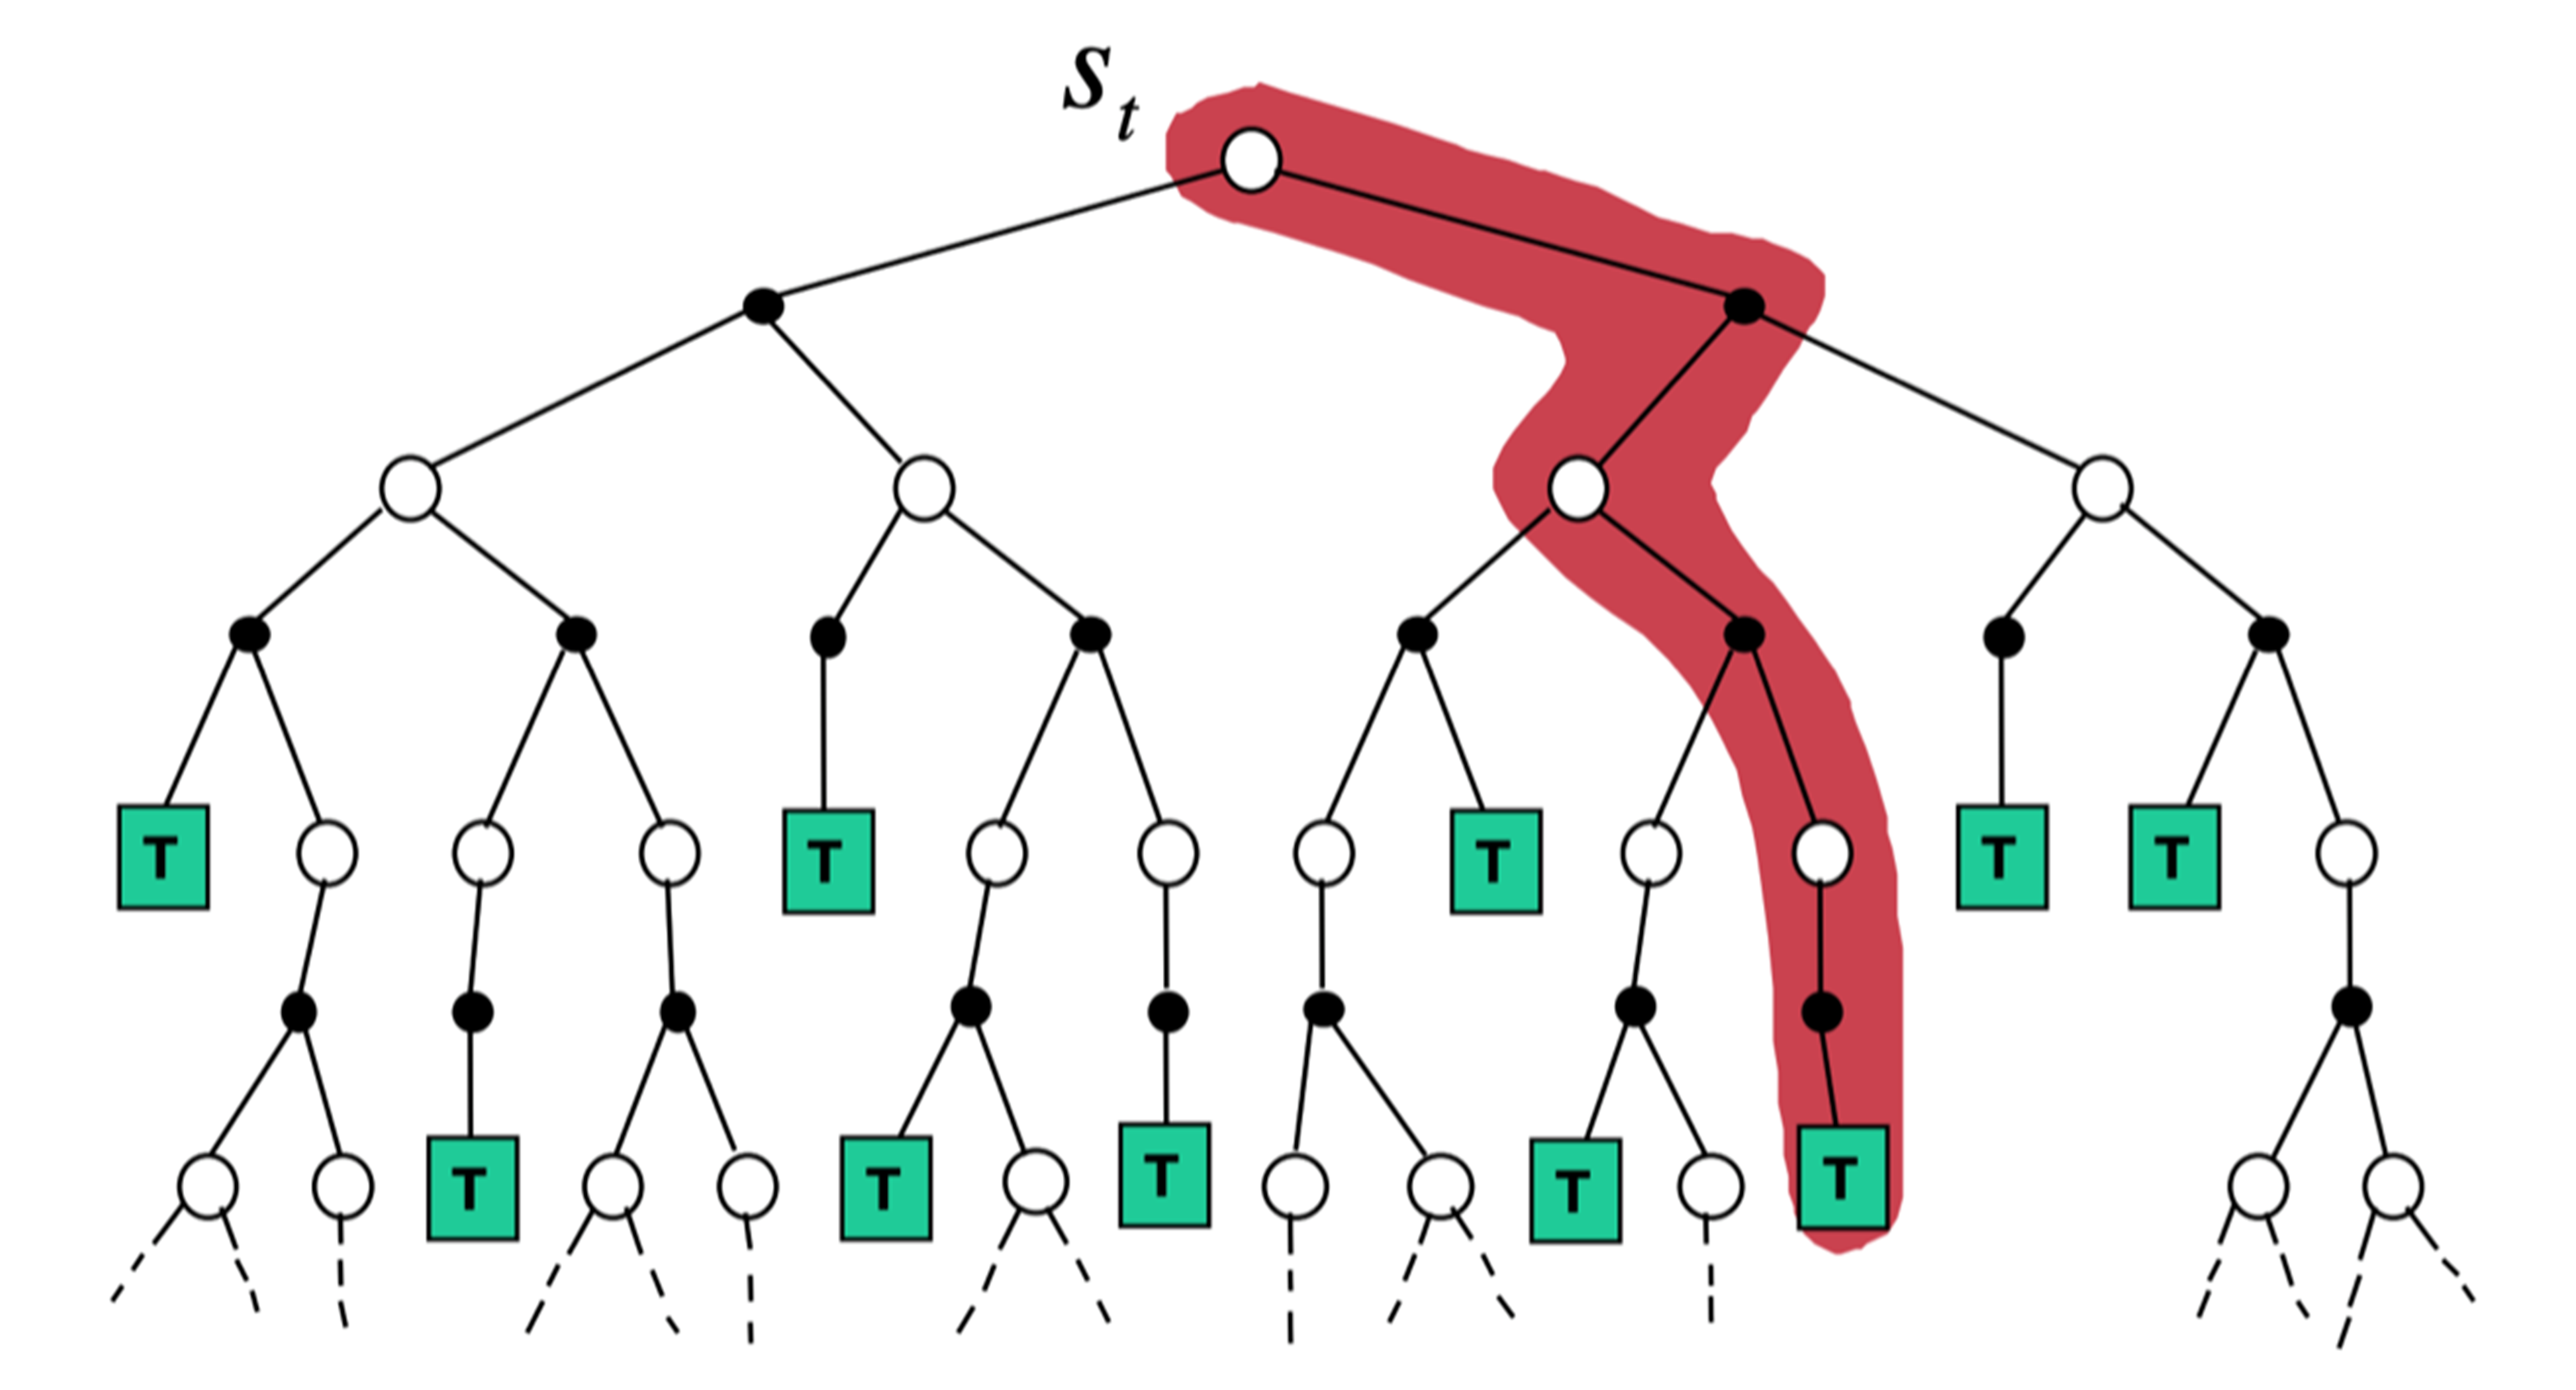
蒙特卡洛只更新轨迹线上的状态:

时序差分方法(自举估计轨迹回报) ​

一步时序差分 ​

时序差分方法

背景

  • MC需采样整个回合才能更新,TD只需采样1步就可以更新价值函数。
  • 单步采样
    • 可以快速适应环境变化。
    • 但只考虑一步的未来,导致自举方法是一种有偏估计。

核心思想

  • 使用MC采样 + DP自举 估计 轨迹回报。

  • 用V函数的自举估计值来代替MC中的真实轨迹回报 Gt

  • 无需等待轨迹结束,在每一步都可更新价值函数

一步时序差分TD(0)

  • 采样1步rt+1,自举估计出轨迹回报 作为目标值,来更新价值函数
    • 自举:用1个估计值,来更新另1个估计值
V(st)←V(st)+α⋅(rt+1+γV(st+1)⏟时序差分目标,采样1步−V(st)⏟估计值)V(st)←V(st)+α⋅(Gt⏟完全采样−V(st))

TD目标和TDError ​

TD目标和TDError

TD目标 (采样1步+自举估计回报)

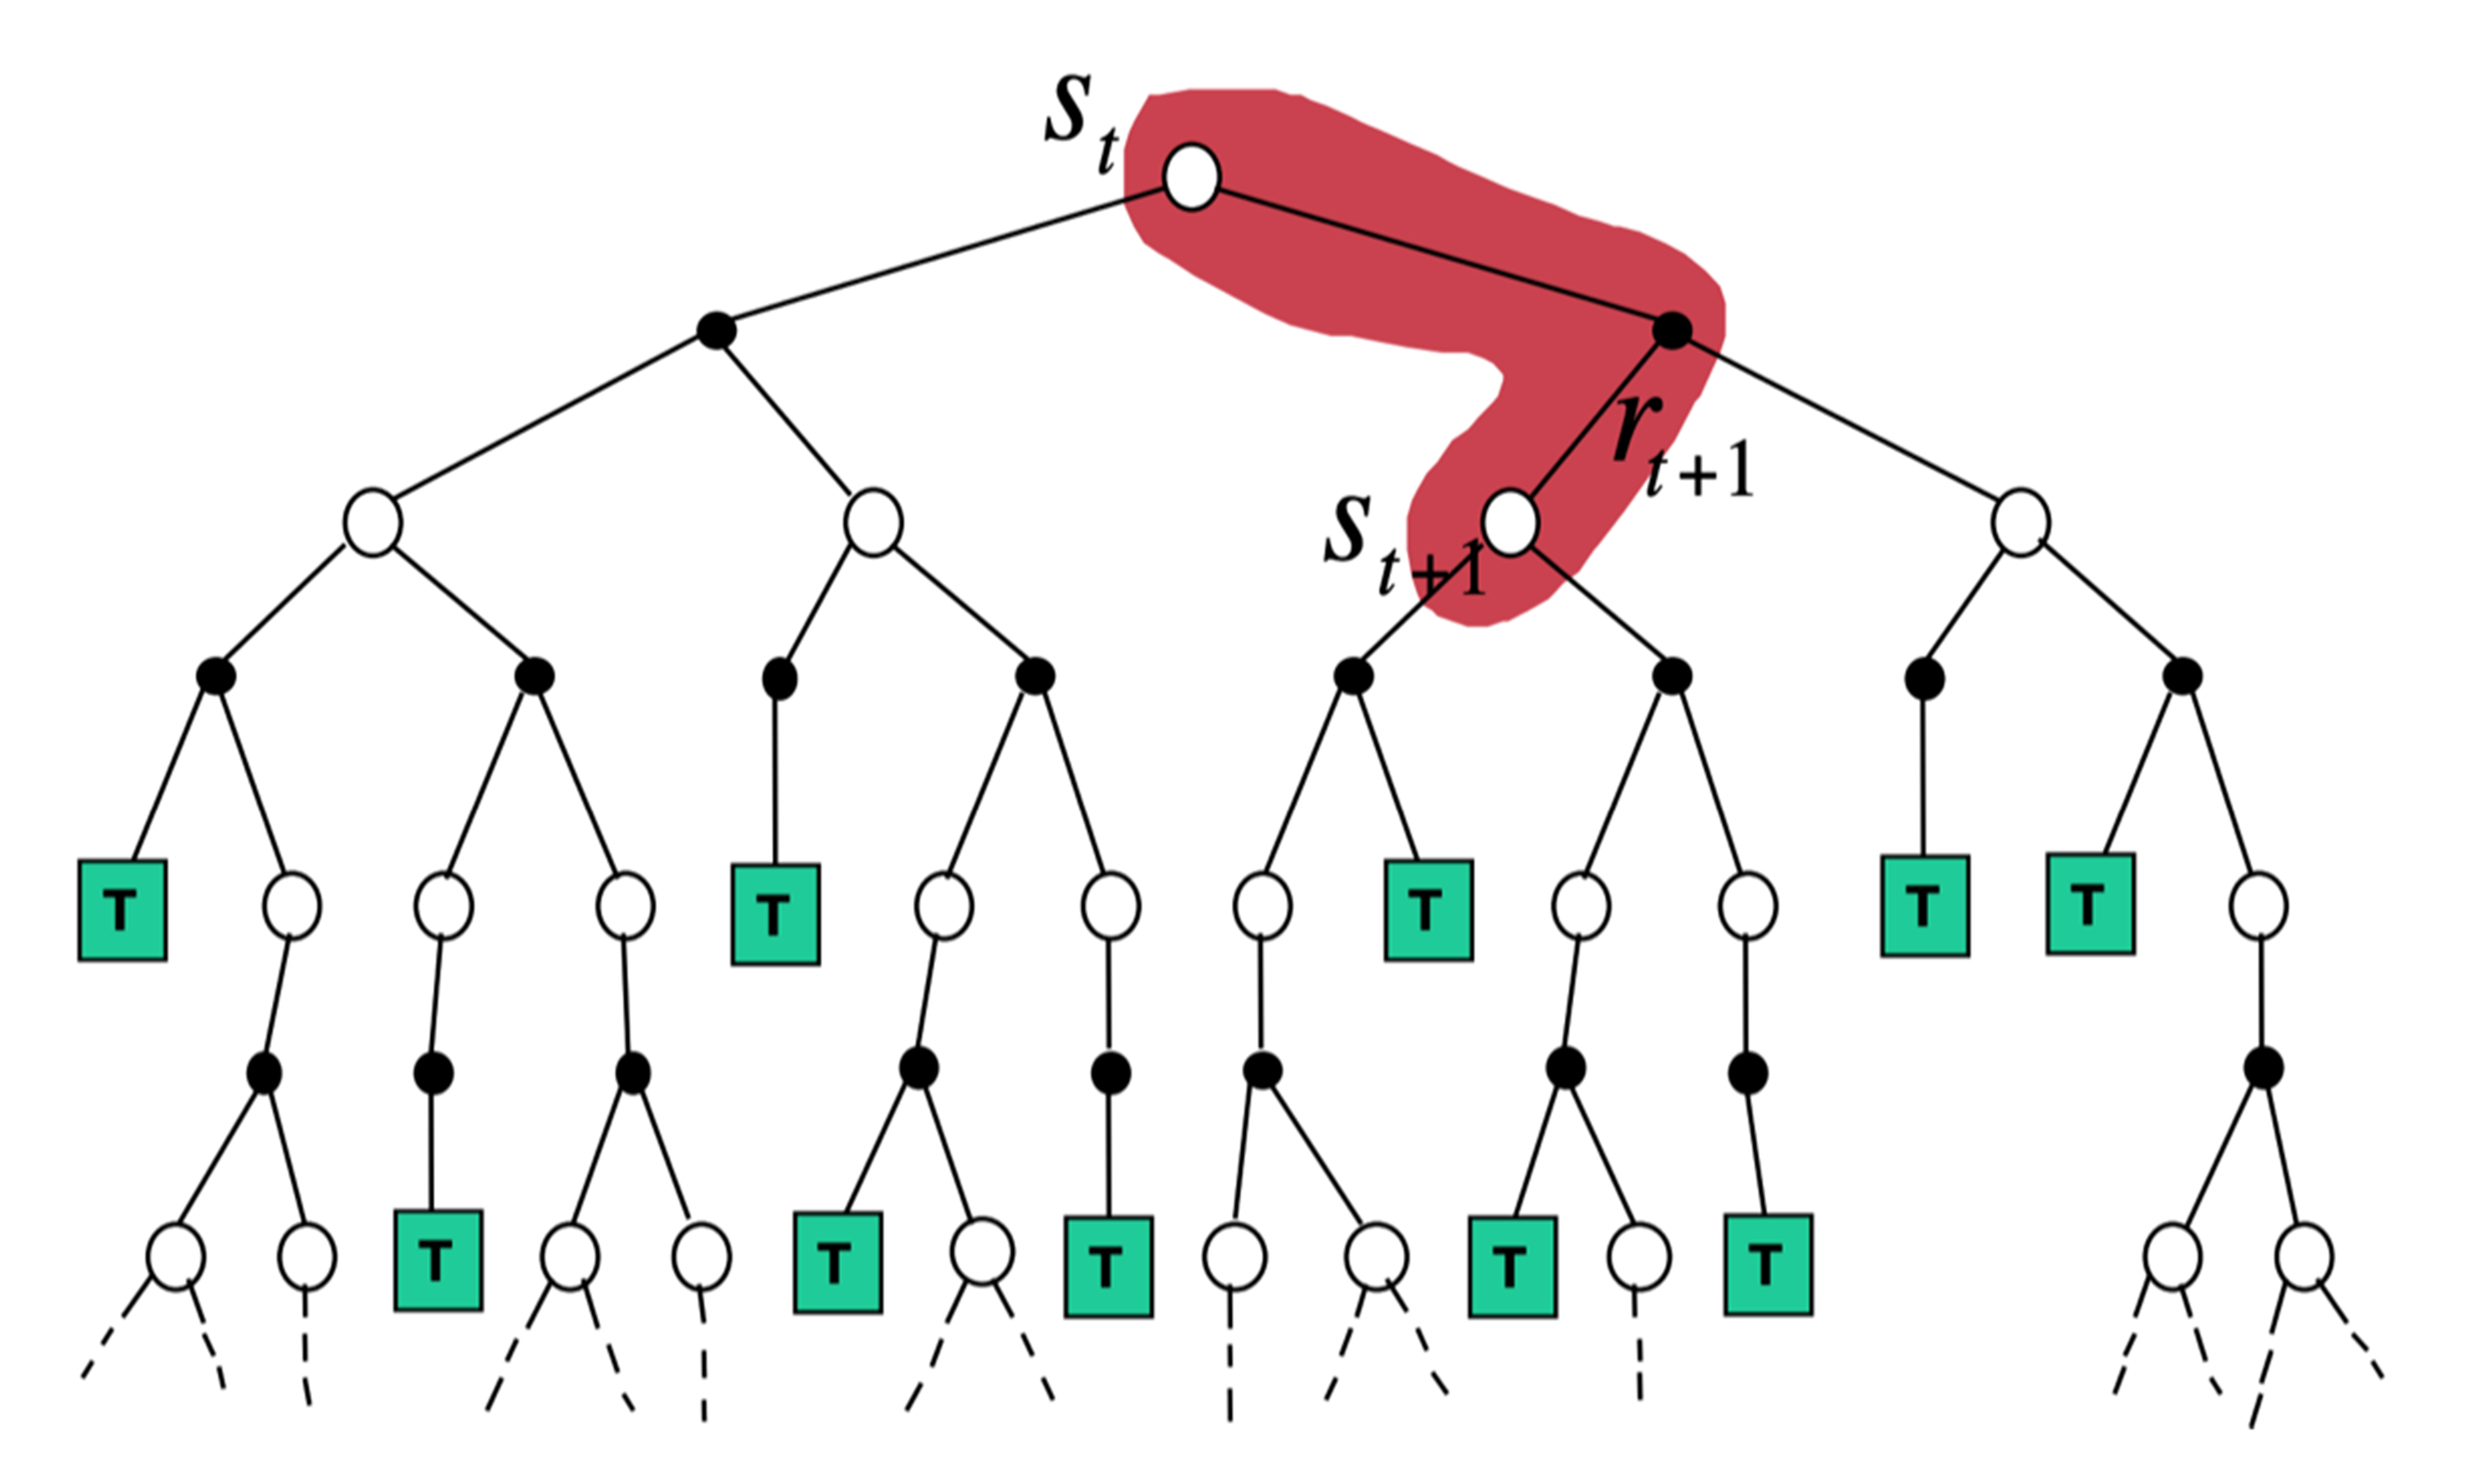
  • 采样1步:走1步得到的实际奖励rt+1
  • 自举估计:用上一轮的V(st+1)来估计当前轮的V(st),用之前的估计来估计V(st+1)
Gt≈V目标值(st)≈rt+1+γ⋅V(st+1)

TD error

  • 实际走一步看到的回报 rt+1+γ⋅V(st+1) 和 先前状态价值的预测 V(st)的之间的差距
  • 学习V(st)来逼近 时序差分目标/真实回报
δt=rt+1+γV(st+1)−V(st)
  • 类比MC Error
δt=Gt−V(st)

TD&MC 方差和偏差 ​

TD 的方差和偏差

TD (近视眼/有偏估计)

  • 自举1步,只能看到下1步。可能不准确(偏差大),但比较稳定(方差小)。
  • 用下一步状态估计值V(st+1) 来更新当前状态估计值V(st),
  • 偏差大:TD目标本身就是不准确的,这就导致了偏差
  • 方差小:但TD只依赖下一个状态,每次更新变动比较小

MC (远视眼/无偏估计)

  • 无偏估计:完全采样看整个回合,用实际真实回报,所以无偏。但常出现波动(方差大)。
  • 方差大:需等整个回合结束,回报是多个随机事件叠加结果,因此MC更新目标波动大、方差大

TDError 优势偏差方差问题 ​

为什么 TD Error 估计优势 是有偏的

0. 优势函数公式

Aπ(st,at)=δt=rt+1+γVπ(st+1)−Vπ(st)⏟TD误差

1. TD Error 有偏估计 问题分析

  • 如果Vπ(st)是无偏的,能准确估计出状态价值
    • 那么TD Error 也是无偏的,能准确估计出优势。
  • 但没有如果,现实 Vπ(st) 往往很难估计出状态价值
    • Vπ(s) 发生偏差时,无论采样多少次,都无法估算真正的优势函数
  • TDError 一定是有偏的,从而引发系统性偏差。

2. TD Error 高偏差 解决办法

  • Vπ(s) 价值函数估计不准,就少信赖它。
  • 采样多步回报,多信赖实际采样奖励 rt、rt+1、rt+2,⋯。

3. n步TD 高方差 问题分析

  • 由于随机策略及环境转移等内容,所以rt、rt+1、rt+2,⋯是 随机变量。
  • n步采样、相比之前单步采样,方差更大。
Var(rt+rt+1+rt+2+⋯)>Var(rt)

4. n步 TD 高方差 解决方法

  • 既不完全信任价值函数估计 Vπ,又不完全信任采样结果 rt、rt+1、rt+2,⋯。
  • 在单步TD 和 完全MC采样 之间做平衡。
  • GAE 算法、TD(λ) 算法

TD(λ) / λ-return算法 ​

指数移动加权平均 ​

指数移动加权平均
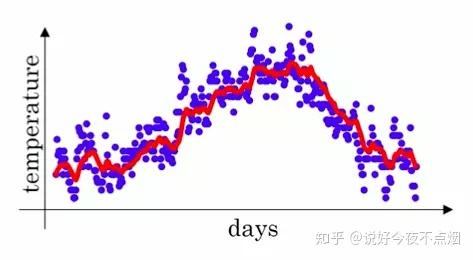
  • vt:到第t天的平均值,θt:第t天的温度值,β=0.9 是衰减系数
vt=β⋅vt−1+(1−β)⋅θtv0=0v1=βv0+(1−β)θ1v2=βv1+(1−β)θ2=β(βv0+(1−β)θ1)⏟v1+(1−β)θ2v3=βv2+(1−β)θ3=β(β(βv0+(1−β)θ1)+(1−β)θ2)⏟v2+(1−β)θ3
  • 指数加权平均:作为原数据的估计值,可以抚平短期波动,起到平滑作用
  • 离当前越近,权值越大;离当前越远,权值越小(指数递减),也有一定权值
v100=0.1(0.9)0⋅θ100+0.1(0.9)1⋅θ99+0.1(0.9)2⋅θ98+0.1(0.9)3⋅θ97+⋯vk=∑i=1k(1−β)⋅βk−i⋅θi=(1−β)∑i=1kβk−i⋅θi

红色的数据比蓝色的原数据更加平滑,少了很多噪音,并且刻画了原数据的趋势。

在梯度下降法中的应用
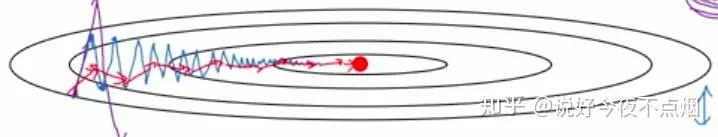
  • 纵轴方向,平均过程中正负摆动相互抵消,平均值接近于零,摆动变小,学习放慢。
  • 横轴方向,因为所有的微分都指向横轴方向,因此平均值仍然较大,向最小值运动更快了。
  • 在抵达最小值的路上减少了摆动,加快了训练速度。

n步回报(n步TD) ​

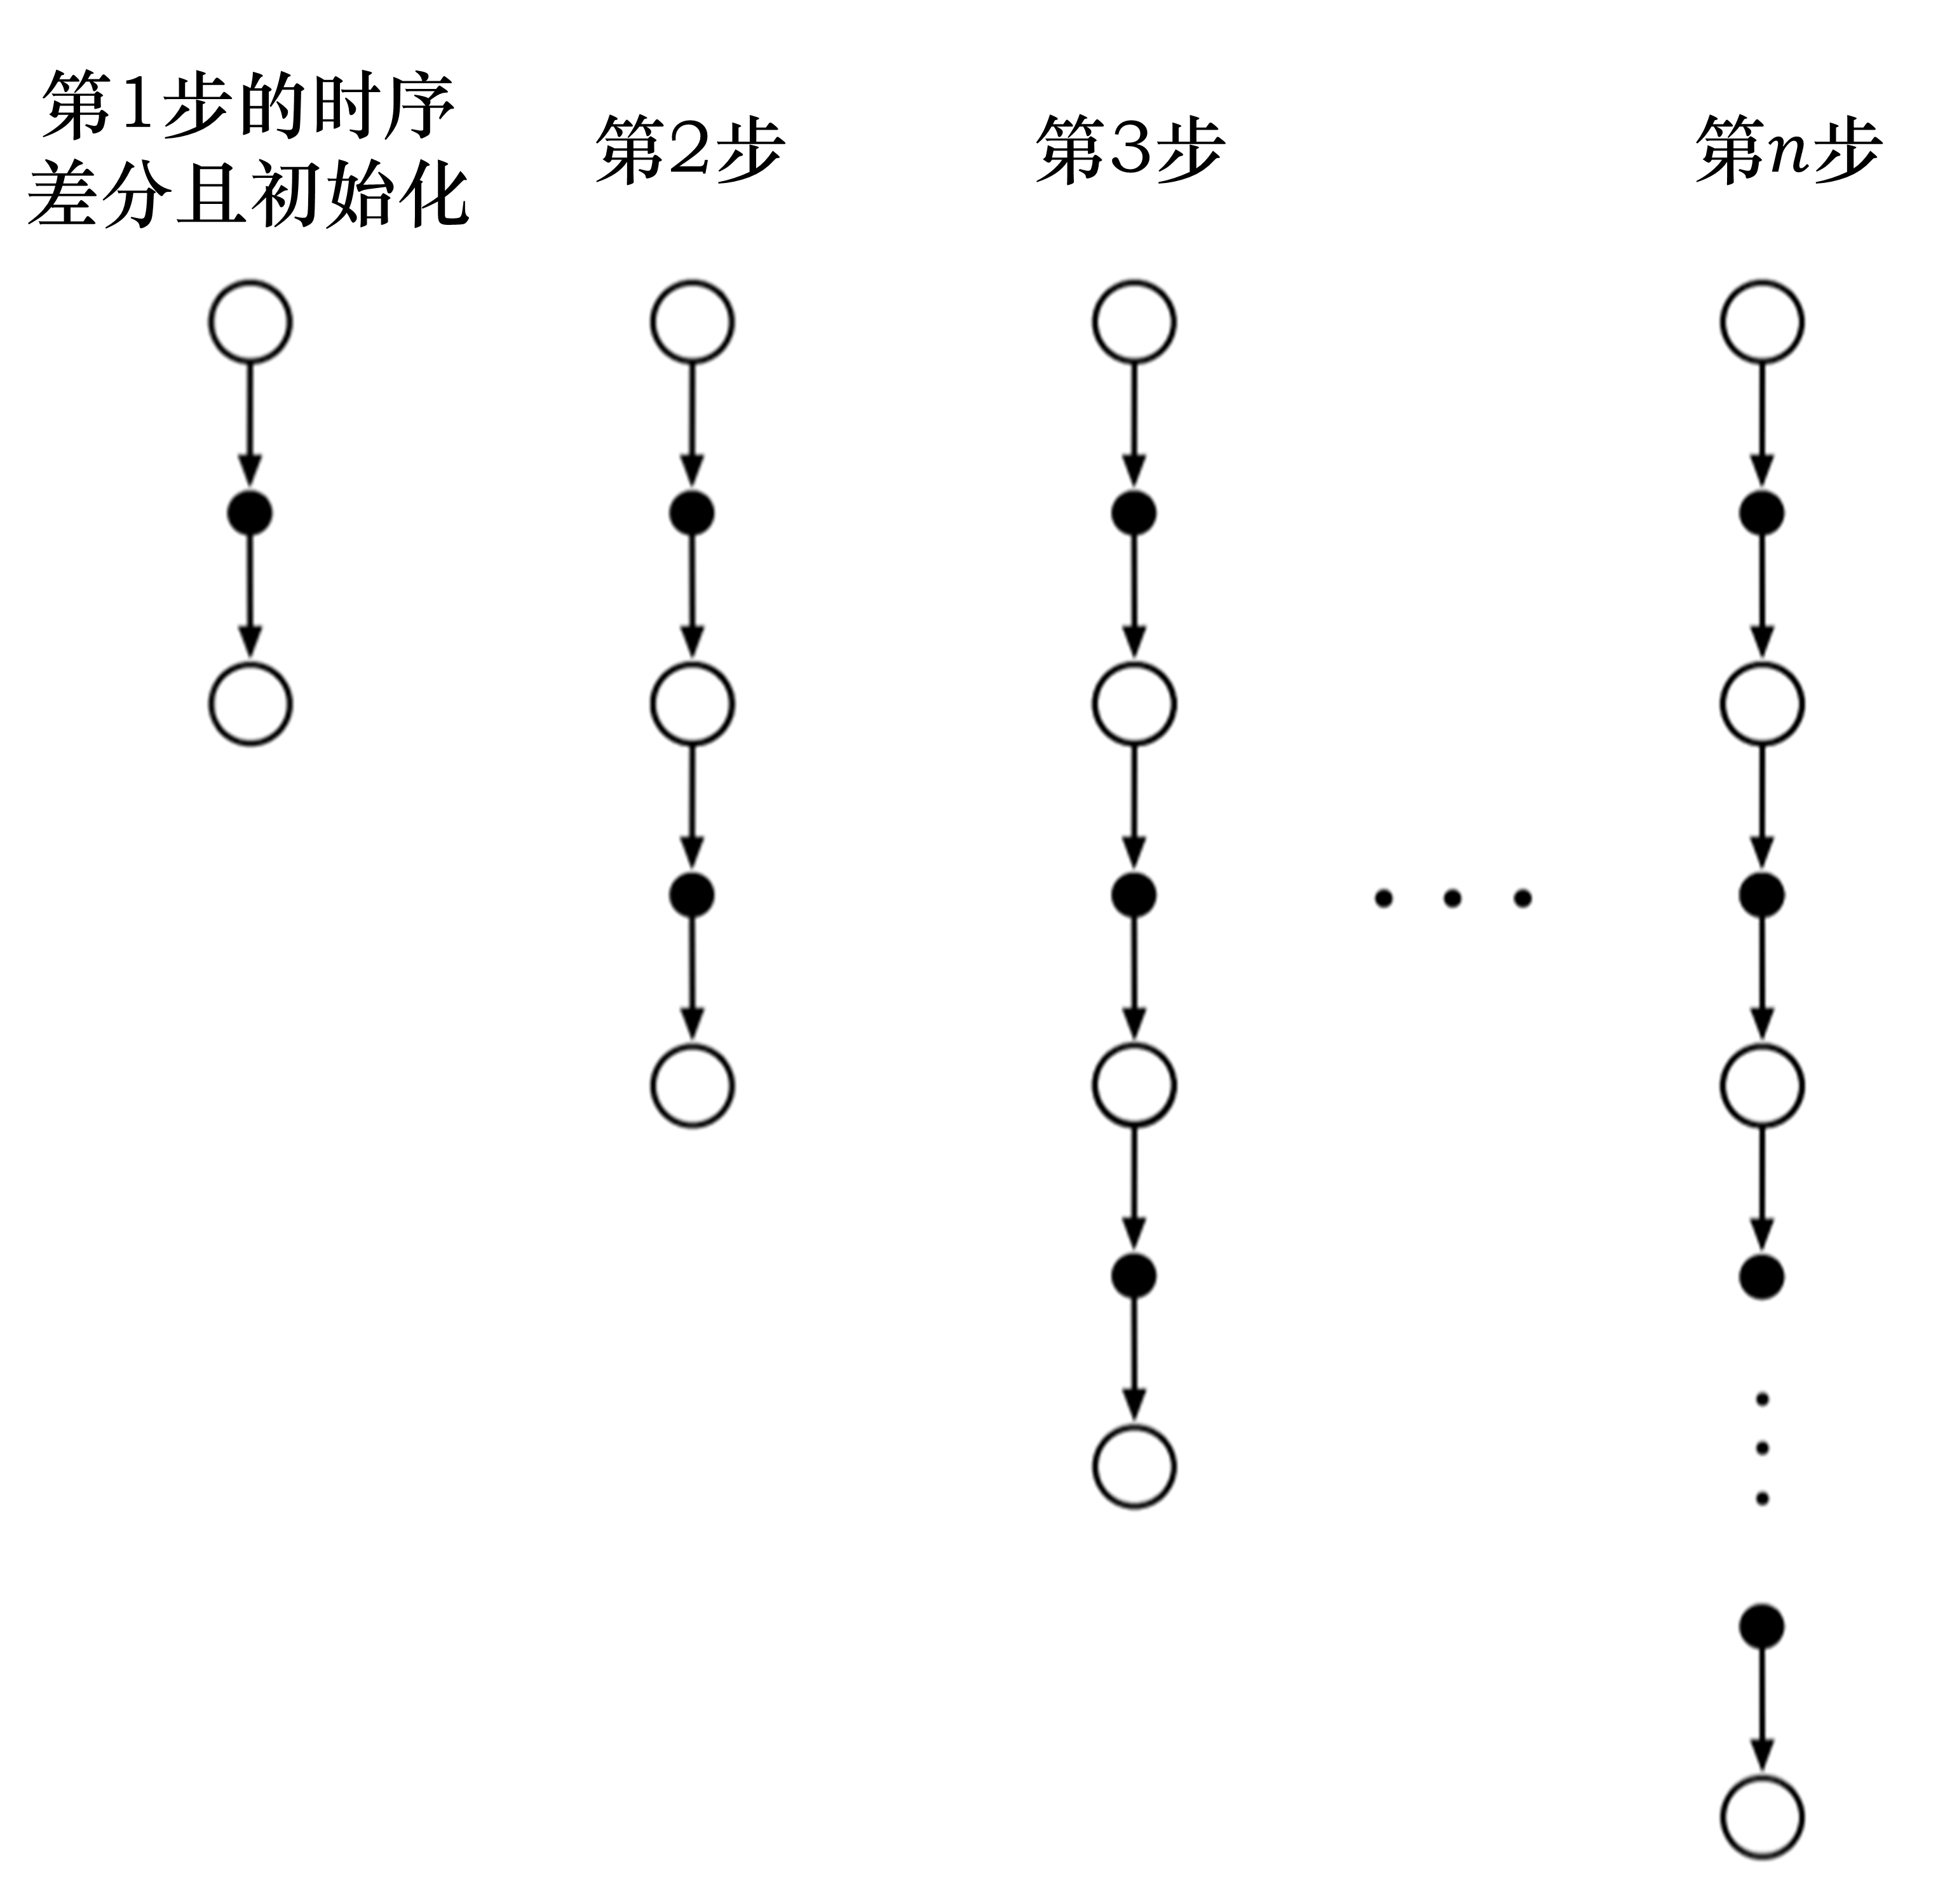
n步时序差分

背景

  • 1步TD:高偏差、低方差。MC:低偏差、高方差。
  • 在 单步采样 和 MC 回合采样之间,做折中。

核心思想

  • 往前采样n步,再更新,不局限于1步,不必等到回合结束👍
  • 比如往前走2步,得到2步的回报,再用自举来更新价值。
  • 考虑时刻t→t+n的回报。

时序差分目标

  • Gt:t+n:时刻t到t+n的n步回报。
  • V(st+n):在时刻t+n的价值估计。
n=1TD(0)Gt:t+1=rt+1+γ⋅V(st+1)n=2TD(1)Gt:t+2=rt+1+γ⋅rt+2+γ2⋅V(st+2)⋮n=nTD(n)Gt:t+n=rt+1+γrt+2+⋯+γn−1rt+n−1+γnV(st+n)⋮n=∞MCGt:t+∞=rt+1+γ⋅rt+2+γ2⋅rt+2+⋯+γT−t−1⋅rT
  • 增量式参数更新
V(st)←V(st)+α⋅(Gt:t+n−V(st))V(st)←V(st)+α⋅(rt+1+γ⋅rt+2+⋯+γn⋅V(st+n)⏟n步TD,采样n步,1个n步回报−V(st))

n的选择

  • 如果固定n
    • n较小,学习速度快,但可能不准确,但方差小
    • n较大,学习速度慢,但可能更准确,但方差大
  • 不同的任务可能需要不同的n值
    • 有些状态需要长远回报,有些状态需要较短回报

λ 回报算法 ​

λ 回报算法

问题背景

  • TD 高偏差、低方差;MC 高方差、低偏差。
  • n步回报,n难以确定;若固定n,所有状态都使用相同步长的回报,不够灵活。
Gt:t+n=rt+1+γrt+2+γ2rt+3+⋯+γn−1rt+n+γnV(st+n)

λ回报公式

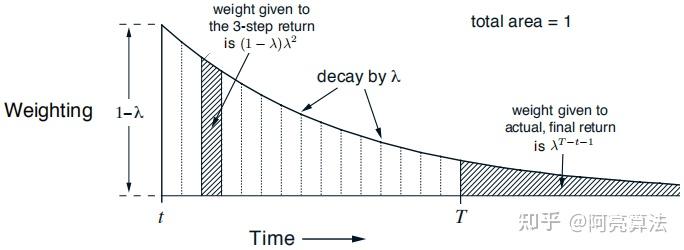
  • λ回报:对多个n步回报估计做λ权重加权平均,权重衰减,平衡方差和偏差
  • 共有多个n步估计量,步数n从1到∞
Gtλ=(1−λ)[λ0⋅Gt:t+1+λ1⋅Gt:t+2+λ2⋅Gt:t+3+λ3⋅Gt:t+4+⋯]
  • 推导过程 (分离终止项推导见下文)
Gtλ=(1−λ)[λ0⋅Gt:t+1+λ1⋅Gt:t+2+λ2⋅Gt:t+3+λ3⋅Gt:t+4+⋯]=(1−λ)∑n=1∞λn−1⋅Gt:t+n=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+λT−t−1⋅Gt⏟分离终止项
  • 推导结果
Gtλ=(1−λ)∑n=1∞λn−1⋅Gt:t+nGtλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+λT−t−1⋅GtGtλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n⏟回合内的n步回报加权平均+λT−t−1⋅Gt⏟n≥T−t后面的等效合并项

参数更新

V(st)←V(st)+α⋅(Gtλ−V(st))V(st)←V(st)+α⋅((1−λ)∑n=1∞λn−1⋅Gt:t+n⏟λ回报,多个n步回报,做平均−V(st))

λ 回报权重的理解 ​

权重的理解

权重 λn−1 和 系数1−λ

  • λn−1:估计量 Gt:t+n的加权/衰减权重,n越大,Gt:t+n衰减越高

为何需要乘以1−λ ?

  • 保证加权权重和为1:权重为等比数列 λ0+λ1+λ3+⋯λn+⋯

  • 权重求和

    ∑n=1∞λn−1=1−λn1−λ,|λ|<1时,⇒∑n=1∞λn−1=11−λ
    • 如果不乘1−λ:权重和为11−λ
    • 如果乘以1−λ,权重和为1

统一理解

  • (1−λ)⋅λn−1统称为权重、归一化权重,权重和为1。对所有n步回报加权平均。
(1−λ)⋅∑n=1∞λn−1=(1−λ)⋅11−λ=1

λ 回报分离终止项推导 ​

分离终止项的推导

背景

  • 无限求和公式 不适用于有限回合。

  • 回合在时间T结束 V(sT)=0,时间T以后不再有状态、没有回报。

  • 当t+n≥T,即n>T−t−1时,回合已经结束,无法通过无限公式计算Gt:t+n

    • 因为无法获取rT,rT+1,⋯, sT+1,sT+2,⋯, 无法计算V(st+n)
    • 但后面的所有即时奖励回报都为0。
    Gt:t+n=rt+1+γrt+2+γ2rt+3+⋯+γn−1rt+n+γnV(st+n)
  • 意味着,n≥T−t时,Gt:t+n 就等于完整的MC回报 Gt

Gt:t+n=rt+1+γrt+2+γ2rt+3+⋯+γT−t−1rT−1⏟Gt+γT−trT+⋯⏟没有奖励,全为0=GtGt:t+n=Gt,当n≥T−t时

分离终止项 λT−t−1⋅Gt

  • 作用:把无限求和公式 分成2部分
Gtλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+λT−t−1⋅Gt
  • 第1部分:从开始时间t到回合结束时间T之间的所有n步回报

    (1−λ)∑n=1T−t−1λn−1⋅Gt:t+n
  • 第2部分:n+t超出结束时间T 后的n步回报平均值,详见下文公式推导过程

    λT−t−1⋅Gt
    • λT−t−1:推导出来后面的权重
    • Gt:推导出来后面的回报求和内容

推导过程

  • 推导过程
Gtλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+(1−λ)∑n=T−t∞λn−1⋅Gt:t+n=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+(1−λ)∑n=T−t∞λn−1⋅Gt=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+(1−λ)Gt∑n=T−t∞λn−1⏟等比数列求和=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+(1−λ)Gt⋅λT−t−11−λ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+λT−t−1⋅Gt
  • 推导结果
Gtλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+λT−t−1⋅GtGtλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n⏟回合内的n步回报加权平均+λT−t−1⋅Gt⏟n≥T−t后面的等效合并项

TD(λ) 、TD(0)和TD(1) ​

TD(0)和TD(1)

TD(λ)

  • λ 越小:趋近于单步TD,偏差越大,方差越小
  • λ 越大:趋近于MC,偏差越小,方差越大
Gtλ=(1−λ)[λ0⋅Gt:t+1+λ1⋅Gt:t+2+λ2⋅Gt:t+3+λ3⋅Gt:t+2+⋯]Gtλ=(1−λ)∑n=1∞λn−1⋅Gt:t+nGtλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+λT−t−1⋅Gt

TD(0)

  • λ=0,完全衰减,退化为单步TD回报。
Gt0=(1−0)[1⋅Gt:t+1+0⋅Gt:t+2+0⋅Gt:t+3+⋯]=Gt:t+1

TD(1)

  • λ=1,完全不衰减, 退化为完整MC回报
  • λn−1=1会导致无穷级数发散,不能直接通过(1−λ)=0 去乘积计算
  • 需用分离终止项公式
Gt1=(1−1)∑n=1T−t−11n−1⋅Gt:t+n+1T−t−1⋅Gt=Gt

TD(λ) 价值函数更新 ​

TD(λ) 价值函数更新

直接使用λ回报替换TD目标来更新Q函数 (表格法)

Q(st,at)←Q(st,at)+α⋅(Gtλ−Q(st,at))

函数参数法

  • 用神经网络来近似价值函数,权重为w
w←w+α⋅(Gtλ−Qw(st,at))⋅∇wQw(st,at)
  • ∇wQw(st,at):价值函数对权重w的梯度。

资格迹 ​

资格迹

背景

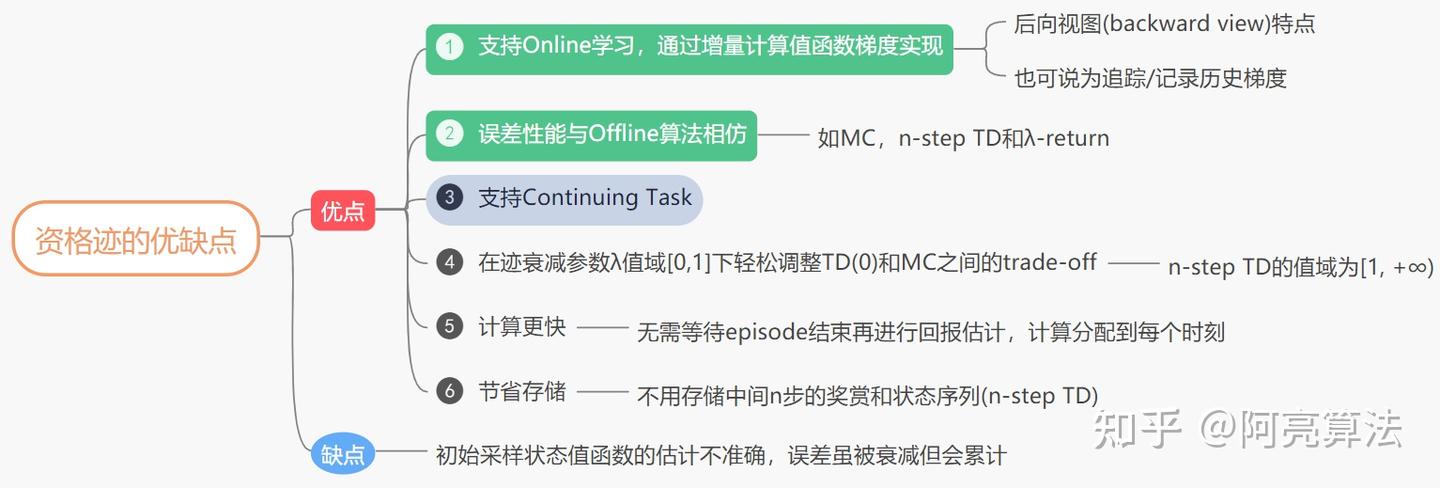
  • 在实际运算中,λ回报需存储所有历史信息。工程复杂、内存消耗高、不适合在线学习决策。
  • 引入资格迹(Eligibility Traces),高效计算λ回报的一种技巧。

资格迹

  • 资格迹作用
    • 记录了过去回合中哪些状态被访问过,以及对学习结果影响程度。
    • λ回报的复杂计算 变成 更简单增量式的更新方式,避免大量重复计算
  • zt:表示t时刻的资格迹,一个加权的价值函数梯度和。
  • γ是折扣因子,λ控制资格迹的衰减速度。
zt(s,a)={γλ⋅zt−1(s,a)+∇wQw(st,at)if(s,a)=(st,at)γλ⋅zt−1(s,a)otherwisezt=λγ⋅zt−1+∇wQw(st,at)
  • 当状态被访问时,资格迹会增加。早期访问过的状态,资格迹按γλ衰减。

使用资格迹

  • 按照如下公式更新价值函数。只需计算TD误差和资格迹,无需计算复杂的λ回报。
wt+1=wt+α⋅δt⋅zt
  • Sara(λ)
δt=rt+γ⋅Qw(st+1,at+1)−Qw(st,at)
  • Q-Learning(λ)
δt=rt+γ⋅maxaQw(st+1,at+1)−Qw(st,at)

MC vs TD vs n步TD vs TD(λ) ​

核心公式对比 ​

MC vs TD vs n步TD vs TD(λ)

MC 采样

  • V函数 更新
V(st)←V(st)+α⋅(Gt⏟完全采样−V(st))
  • MC Error
δ=Gt−V(st)

单步TD

  • V函数 更新
V(st)←V(st)+α⋅(rt+1+γV(st+1)⏟时序差分目标,采样1步−V(st)⏟估计值)
  • TD Error
δ=rt+1+γV(st+1)−V(st)

n步 TD

  • Gt:t+n 定义
Gt:t+n=rt+1+γrt+2+⋯+γn−1rt+n−1+γnV(st+n)
  • V函数 更新
V(st)←V(st)+α⋅(Gt:t+n−V(st))V(st)←V(st)+α⋅(rt+1+γ⋅rt+2+⋯+γn⋅V(st+n)⏟n步TD,采样n步,1个n步回报−V(st))
  • TD Errorδ=Gt:t+n−V(st)
δ=rt+1+γ⋅rt+2+⋯+γn⋅V(st+n)−V(st)

TD(λ)

  • Gtλ 定义
Gtλ=(1−λ)[λ0⋅Gt:t+1+λ1⋅Gt:t+2+λ2⋅Gt:t+3+λ3⋅Gt:t+2+⋯]Gtλ=(1−λ)∑n=1T−t−1λn−1⋅Gt:t+n+λT−t−1⋅Gt
  • V函数 更新
V(st)←V(st)+α⋅(Gtλ−V(st))V(st)←V(st)+α⋅((1−λ)∑n=1∞λn−1⋅Gt:t+n⏟λ回报,多个n步回报,做平均−V(st))
  • TD Error
δ=Gtλ−V(st)δ=(1−λ)∑n=1∞λn−1⋅Gt:t+n−V(st)

概念对比 ​

时序差分 vs 蒙特卡洛 vs 动态规划

时序差分

  • 可以在线学习,每走一步就能更新;在知道结果之前就能学习,快速灵活
  • 可以从不完整序列学习,可以在连续环境下进行学习
  • 利用了马尔科夫性质
  • 更新时使用了自举估计,一部分采样,一部分自举。
    • 以采样方式得到不完整序列,估计某状态后可能的奖励,不断采样持续更新价值
  • TD方法在每个时刻都可以更新价值函数,是一种高偏差、低方差的方法
  • TD 有偏估计,可能无法准确预测未来收益
  • 在延迟激励情况下,需很长时间才能把奖励传播到之前的状态,存在信用分配问题。

蒙特卡洛

  • 不能在线学习,必须游戏结束时才能更新
  • 只能从完整序列进行学习,只能在有终止的情况下进行学习
  • 没有假设环境具有马尔科夫性质
  • 没有使用自举
  • 高方差 多个r变量的累积求和,目标不稳定
  • 用整个序列的经验 去估计价值函数,低偏差、高方差方法。

动态规划

  • 有模型预测方法
  • 使用了自举

自举采样对比 ​

时序差分对比蒙特卡罗

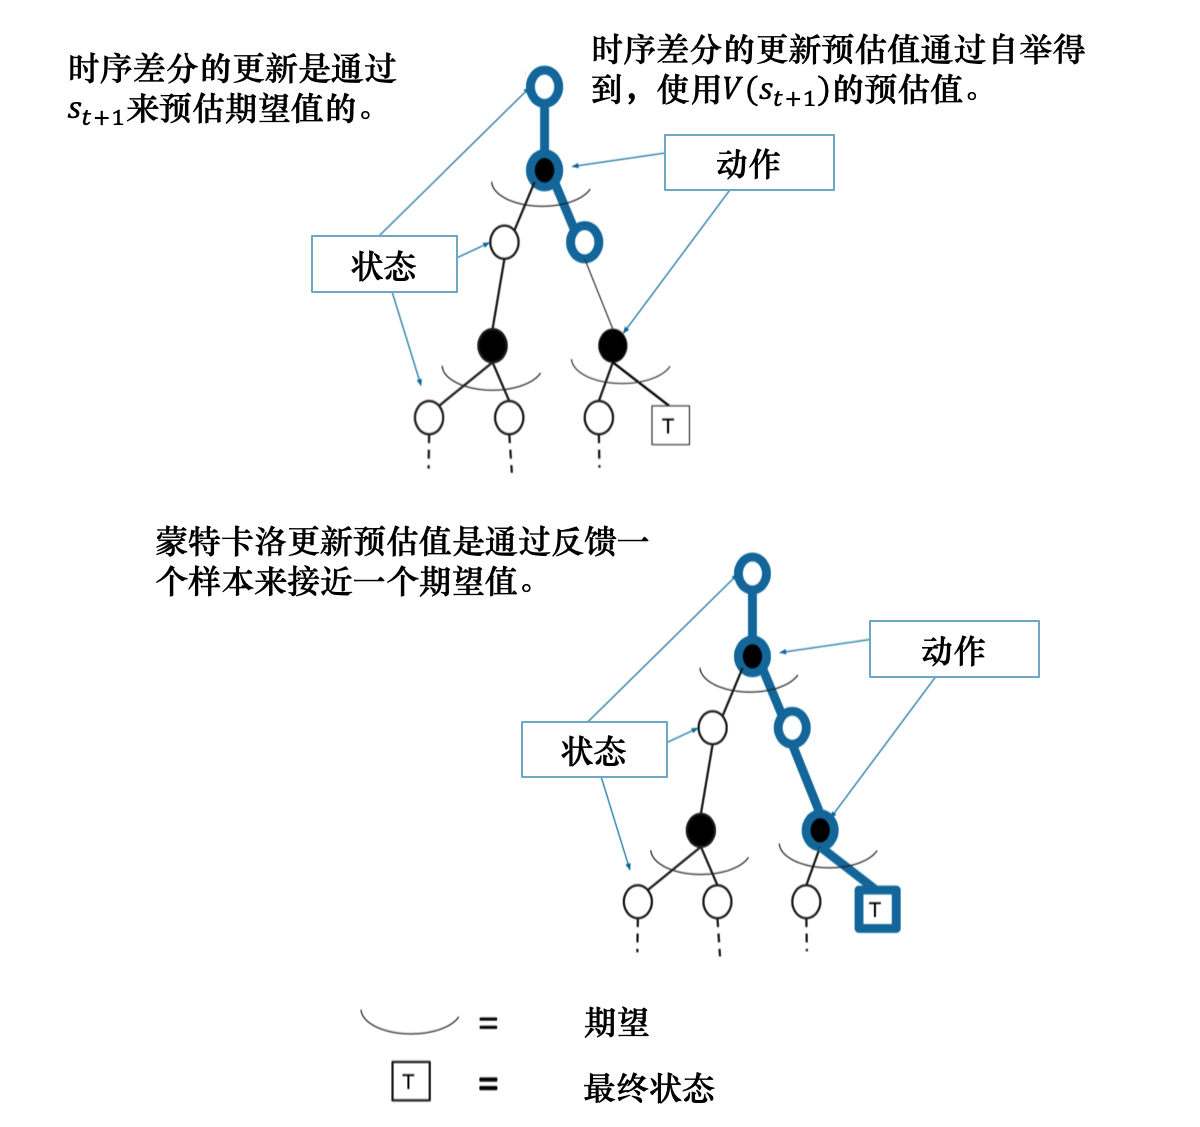
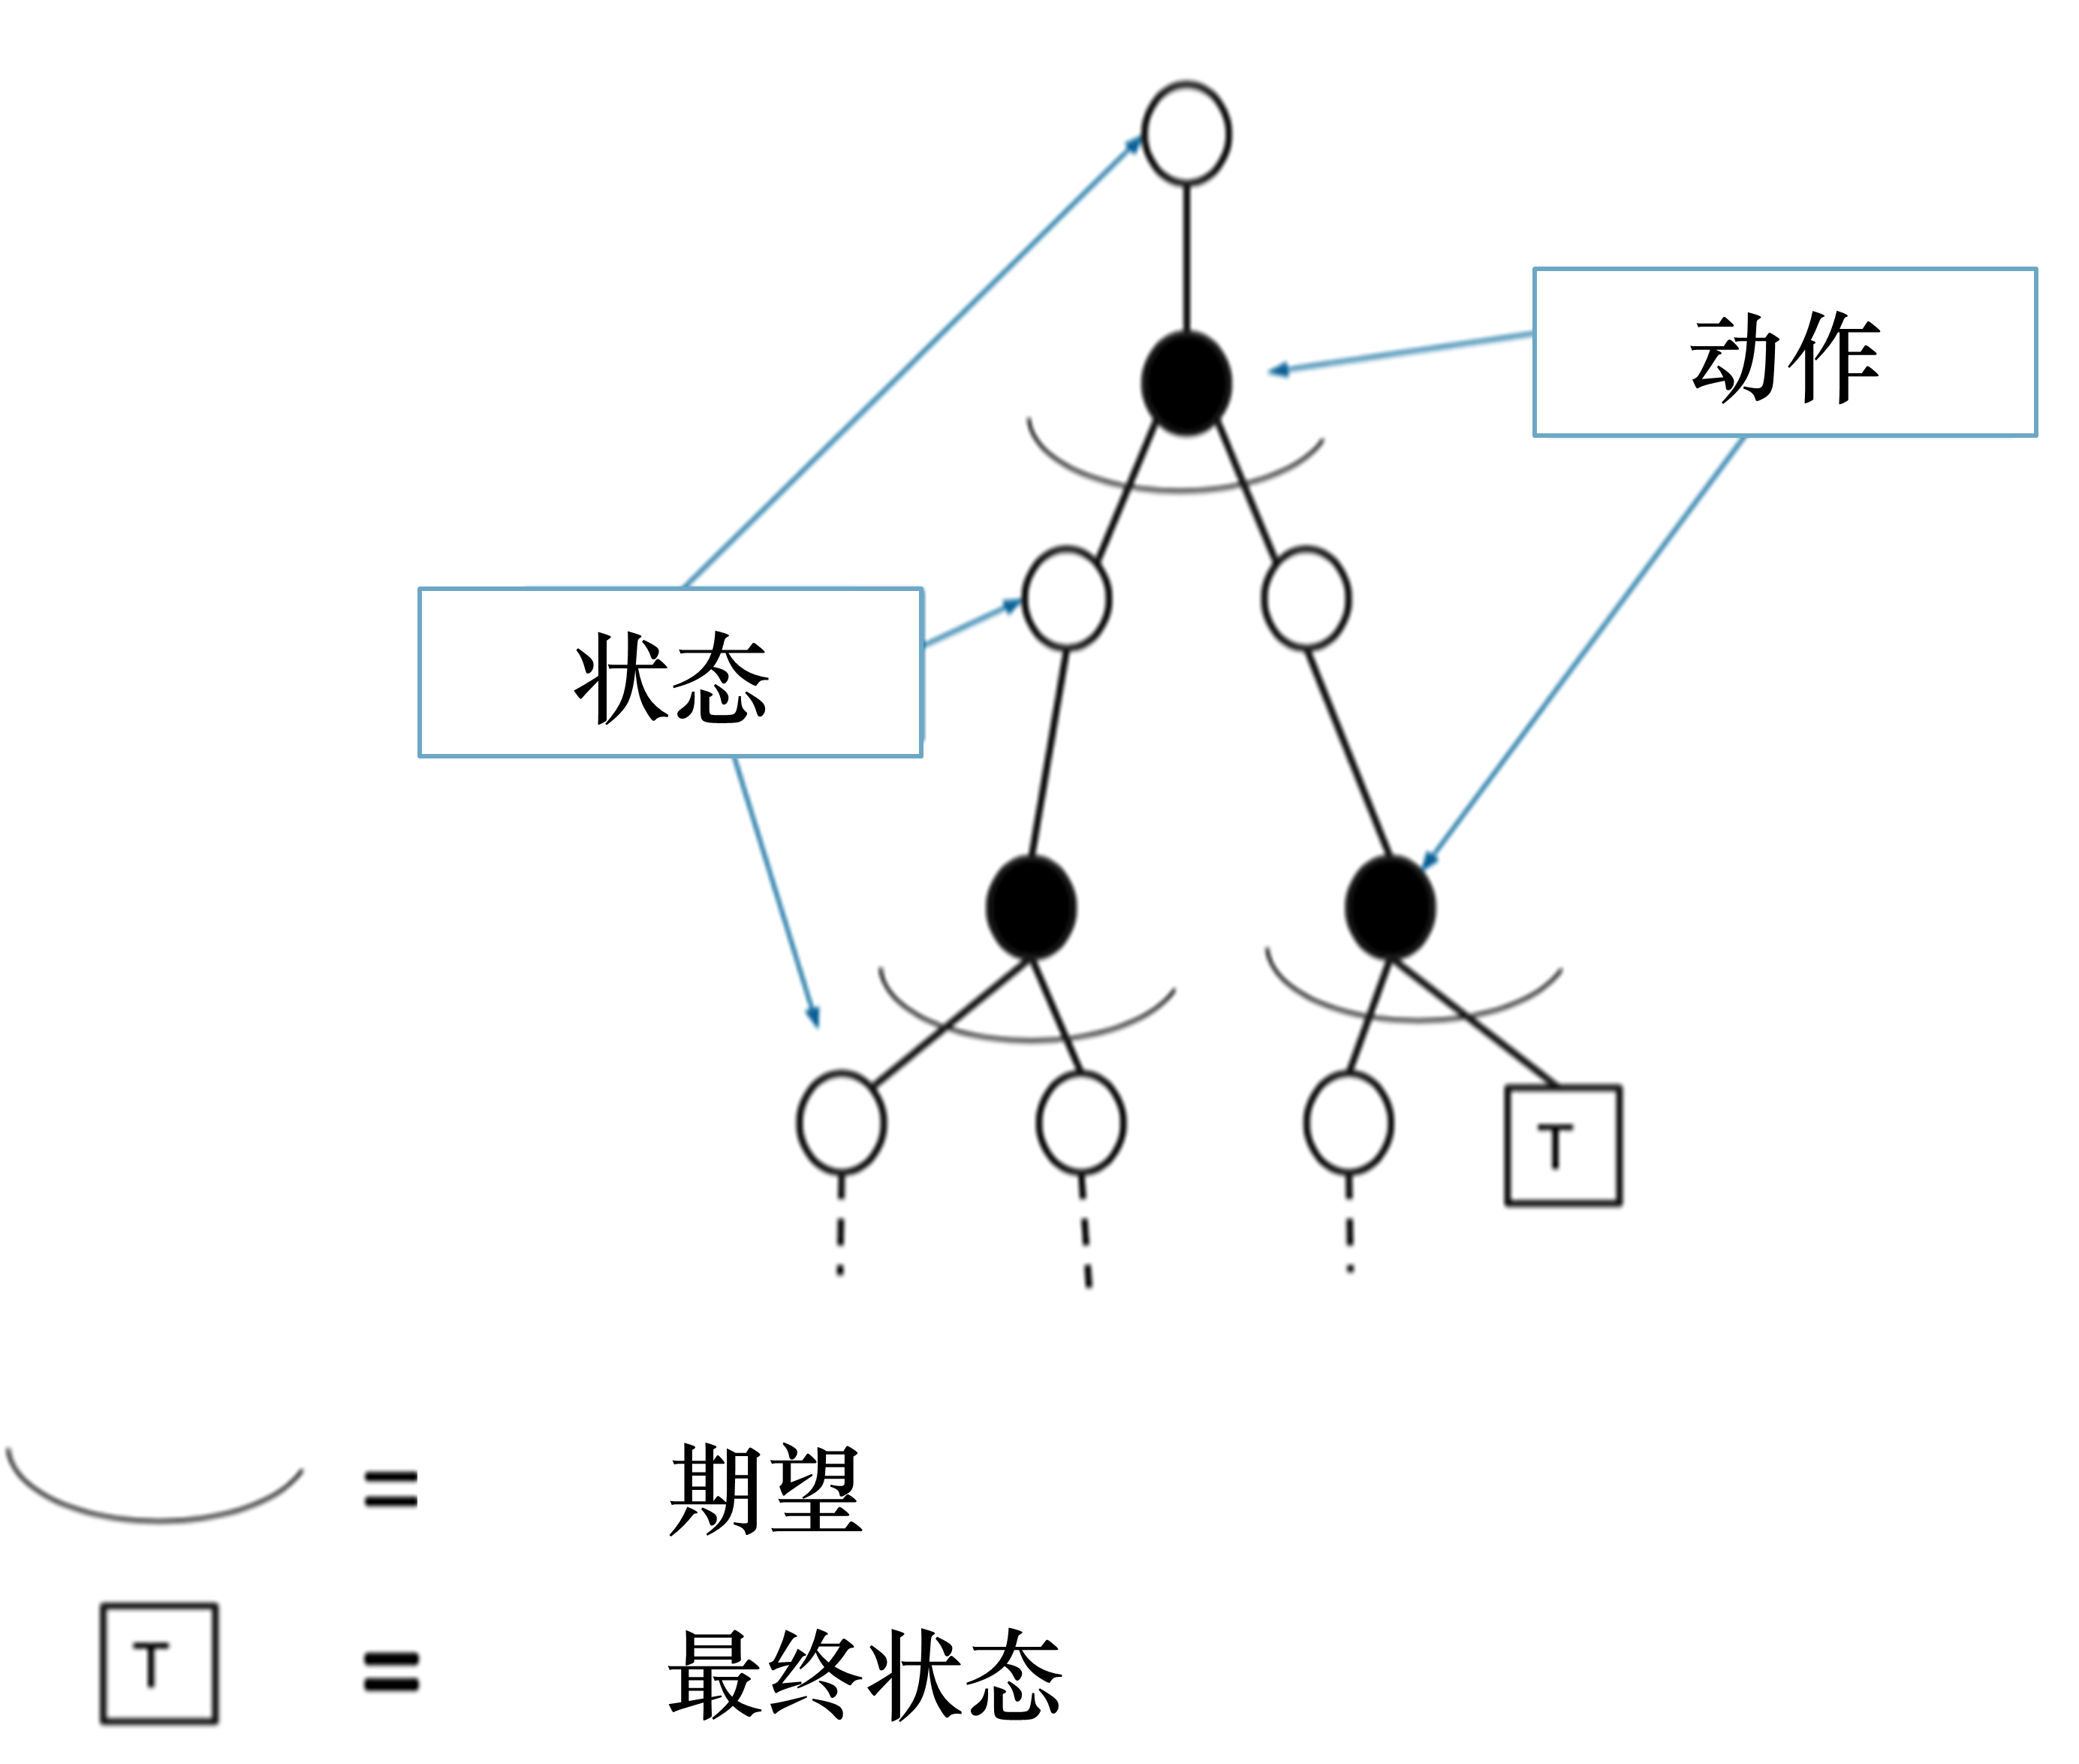
动态规划备份:直接计算期望

V(st)←Eπ[rt+1+γV(st+1)]

蒙特卡洛备份:采样一条支路计算,更新这条路径上的所有状态

V(st)←V(st)+α⋅(Gi,t−V(st))

时序差分备份:采样+自举,从当前状态开始走几步,关注局部步骤

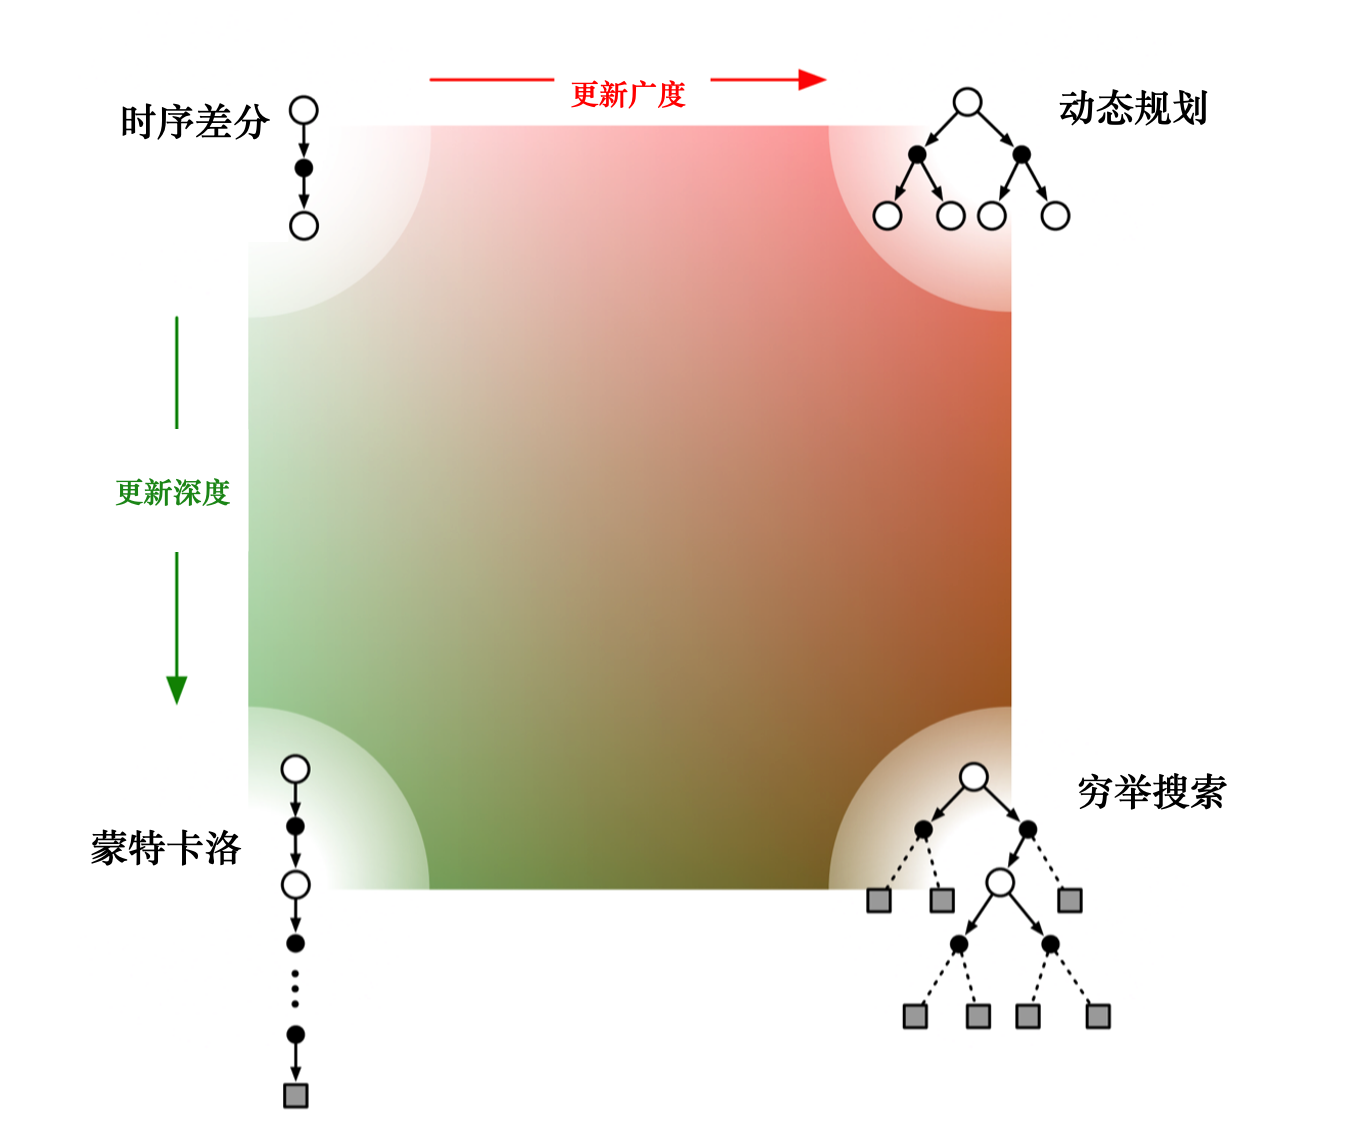
时序差分:需要广度,就变成动态规划;需要深度,就变成蒙特卡洛。

免模型控制 ​

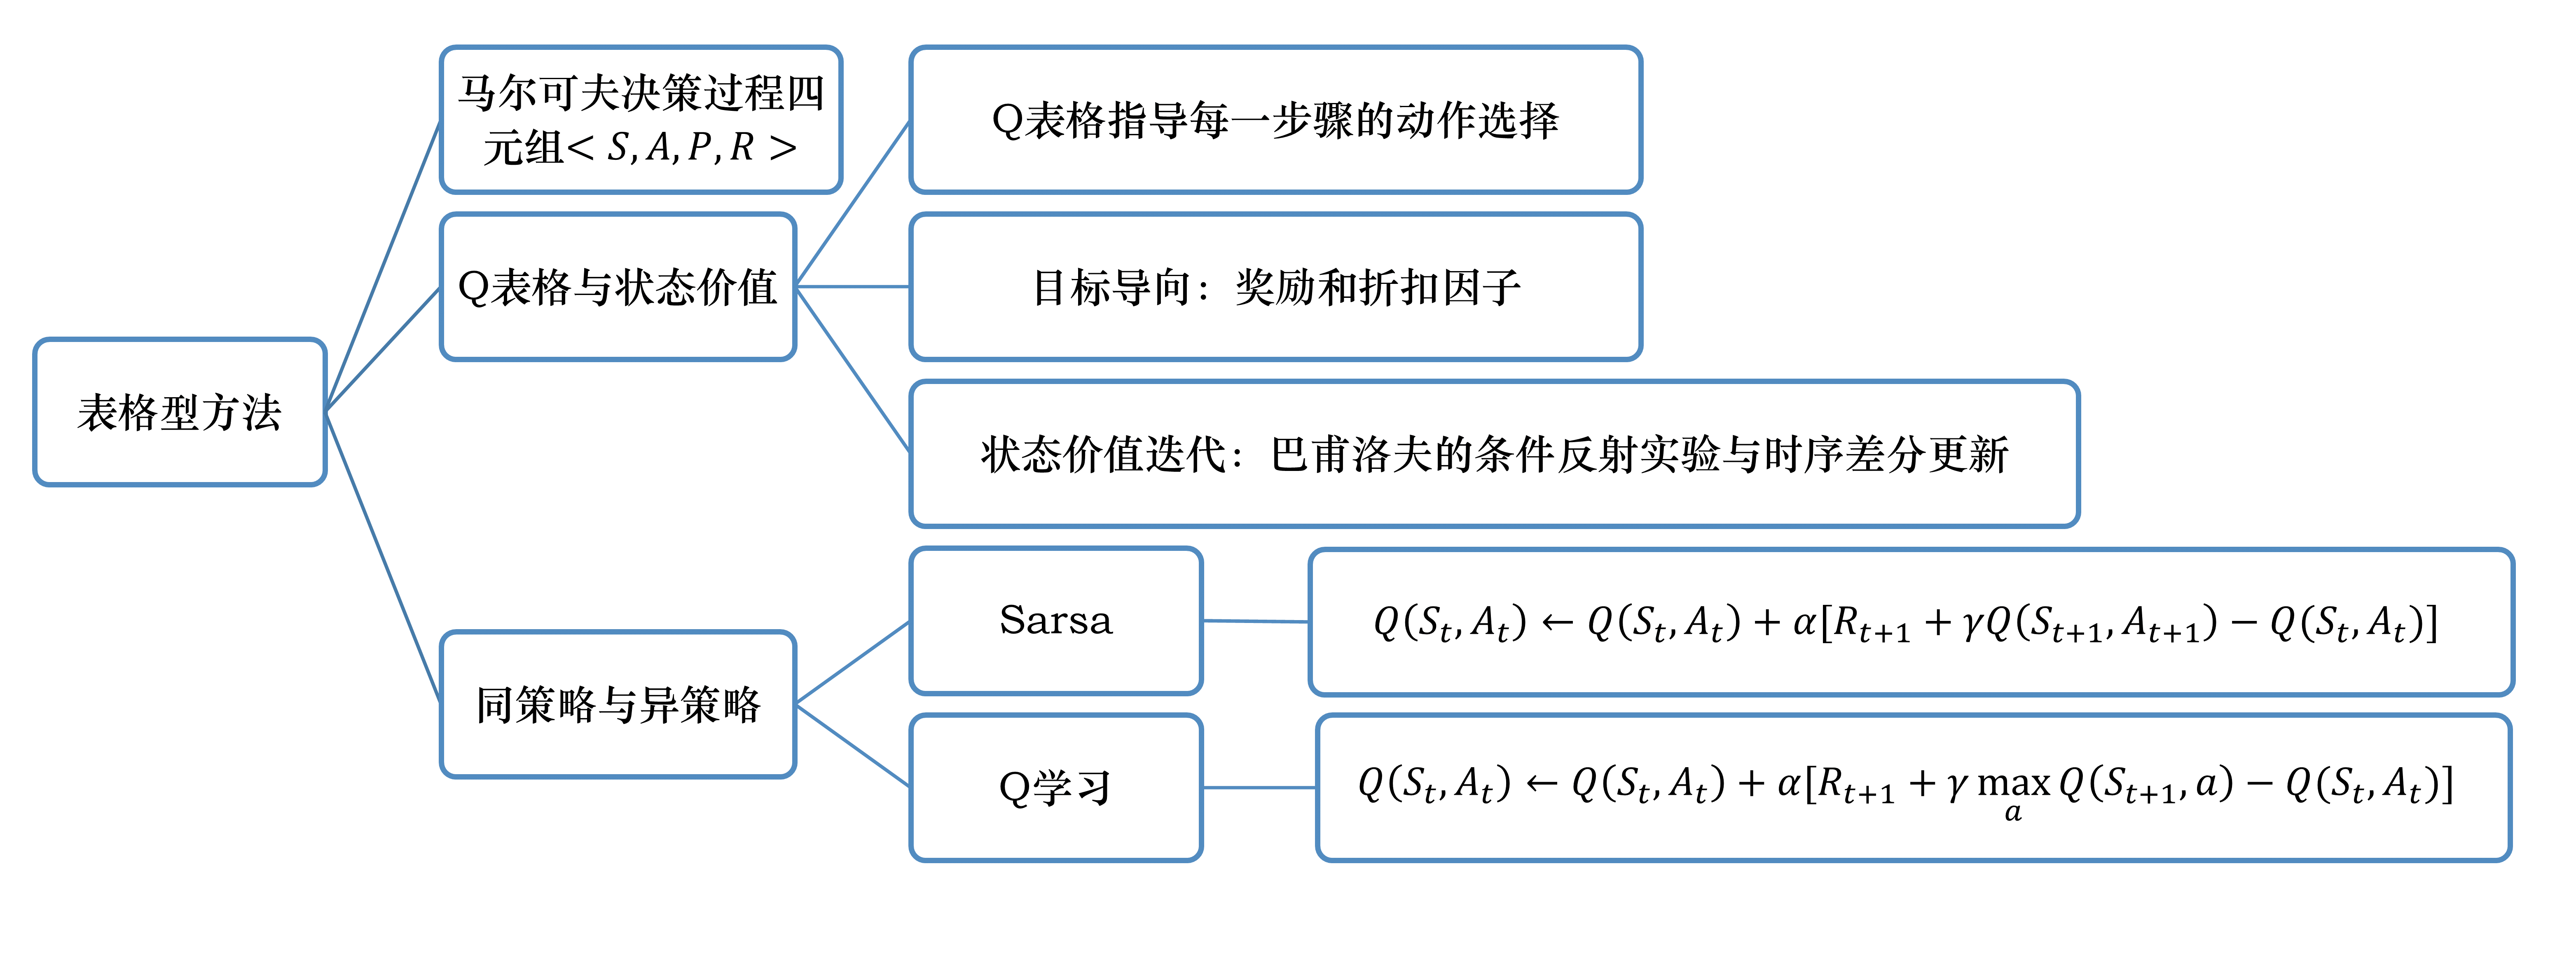
免模型控制是指不需要知道环境模型,进行寻找最优策略输出最有价值。Q-Learning和SARSA都是基于时序差分的算法。

策略迭代 ​

狭义策略迭代 ​

狭义策略迭代算法

定义

  • 有模型控制,通过策略评估和策略改进,不断迭代直到值函数收敛。

  • 通过环境信息(奖励函数、状态转移概率),来计算价值函数

Vπk+1(s)=∑a∈Aπ(a∣s)⋅(R(s,a)+γ⋅∑s′∈Sp(s′∣s,a)⋅Vπk(s′))Qπk+1(s,a)=R(s,a)+γ∑s′∈Sp(s′∣s,a)⋅Vπk(s′)

缺点

  • 依赖奖励函数和状态转移概率;免模型时无法估计

广义策略迭代 ​

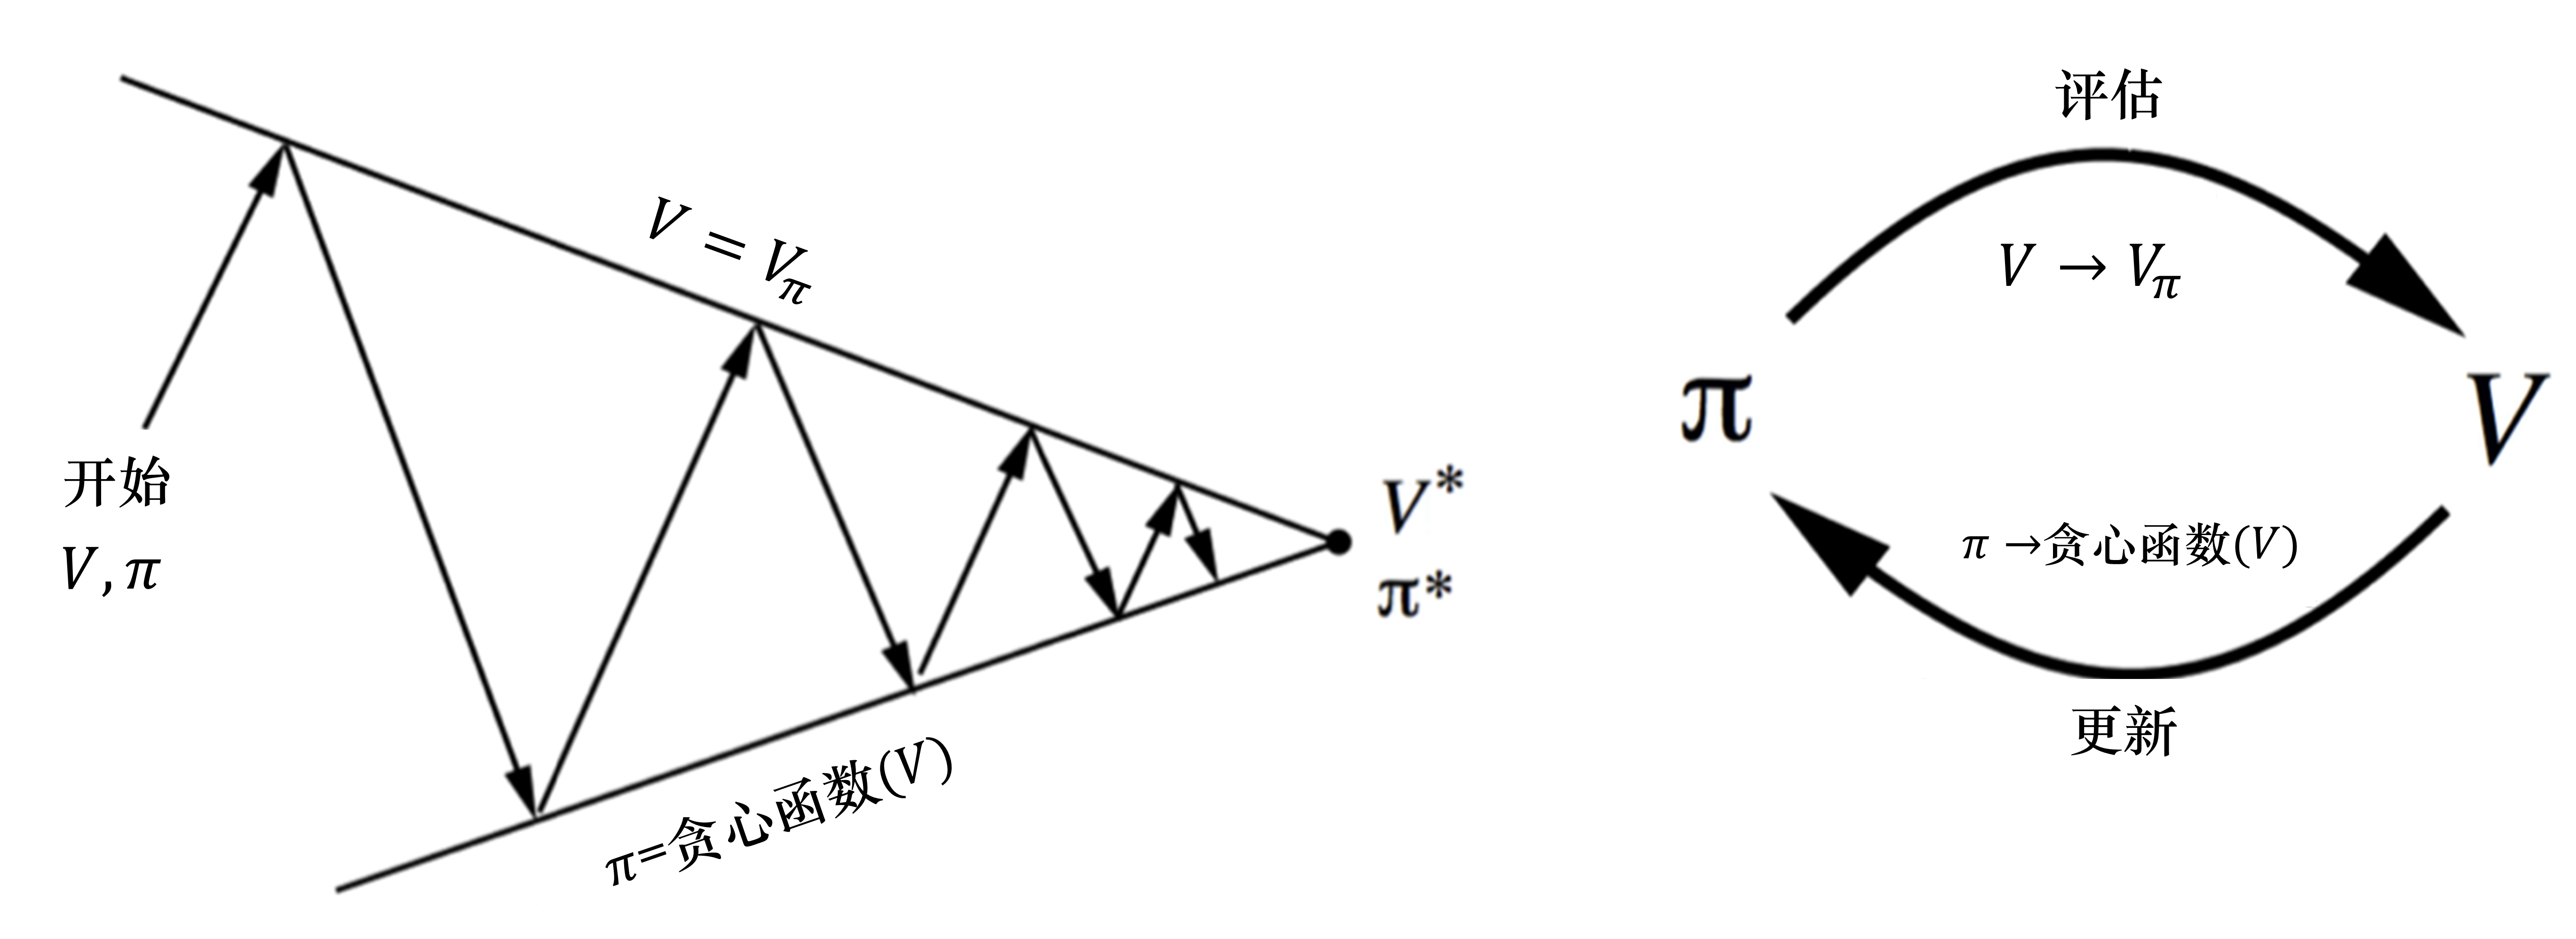
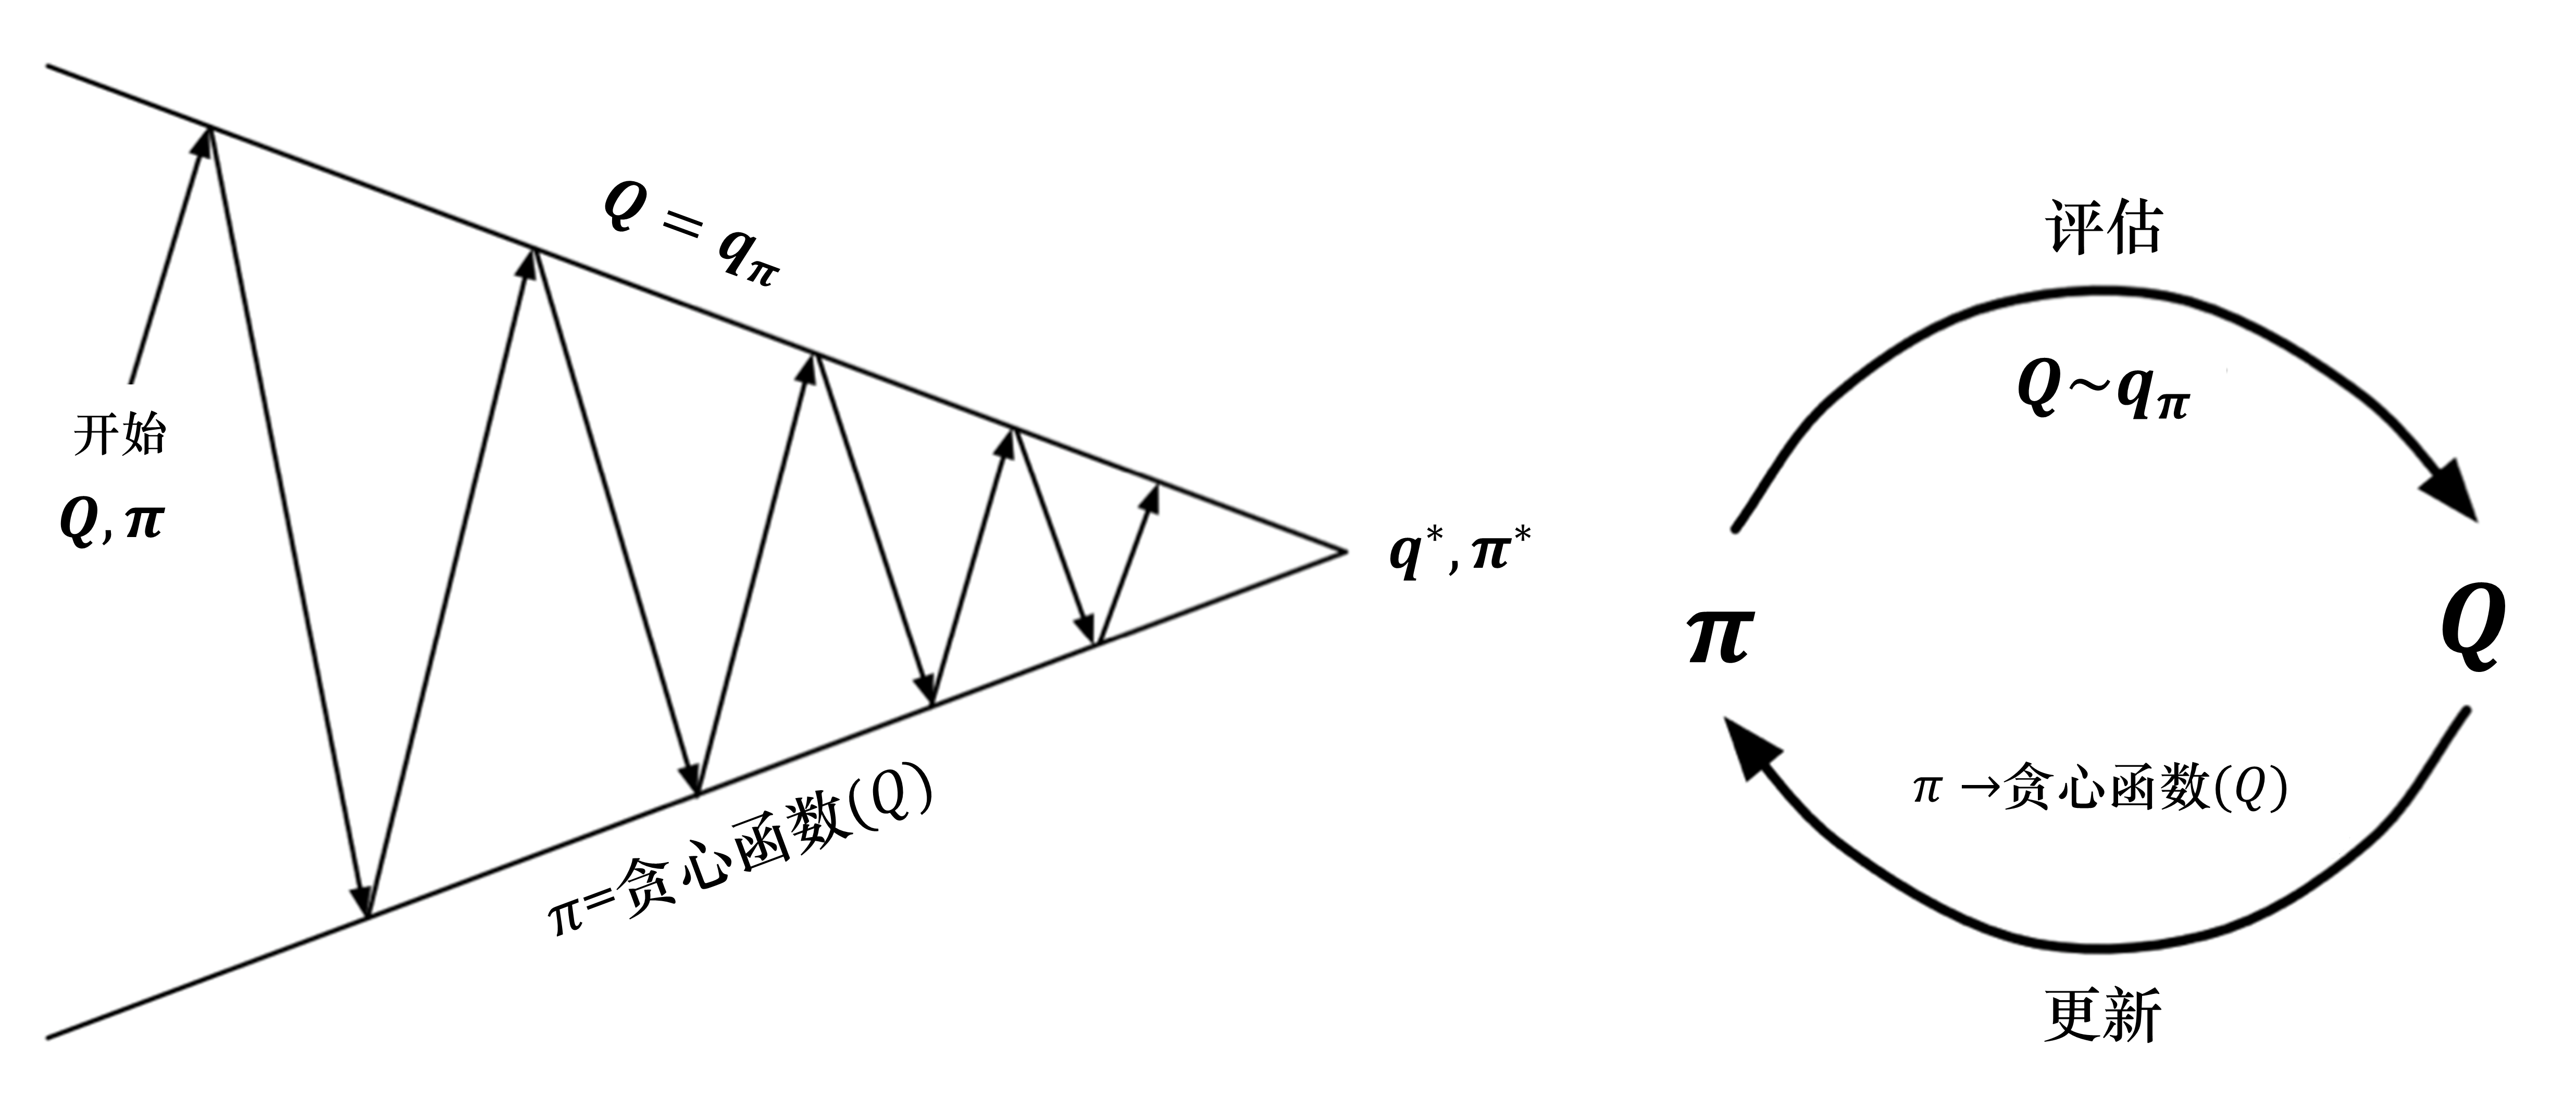
广义策略迭代算法

定义

  • 免模型控制:引入蒙特卡洛和时序差分,进行策略迭代
  • 策略评估:用蒙特卡洛探索采样多个轨迹,平均轨迹价值,来估计Q函数
Qπ(s,a)≈Eτ∼p(τ)[G(τ)∣τs0=s,τa0=a]≈1N∑i=1NG(τi)
  • 策略改进:直接选择最大的Q函数
π(s)=arg⁡maxaQ(s,a)

探索策略 ​

探索和利用

探索的意义
  • 一直基于某种思路工作,可能会比较好,但也可能会走偏
  • 换一种思路也许就会豁然开朗
  • 守旧不一定是坏事,不能过度好奇心
贪心策略

ϵ贪心策略

  • 为了保证足够的探索,以ϵ概率随机选择一个动作
  • ϵ按时间步递减,如0.1 -> 0.01
    • 开始时不确定哪个动作较好,花较多时间进行探索
    • 后期逐渐稳定,减少探索,降低ϵ
πϵ(s)={π(s)=arg⁡maxaQπ(s,a),依概率 1−ϵ(利用, 守旧派)随机选动作a′,依概率 ϵ(探索, 好奇心)
玻尔兹曼探索策略

定义

  • 对Q(s,a),a 被选中的概率和eQ(s,a)/T有关
  • T为温度系数
    • T很大,等概率选择;T很小,Q值更大的动作容易选中;T趋于0,只选择最优动作。
π(a∣s)=eQ(s,a)/T∑a′∈AeQ(s,a′)/T

同策略异策略 ​

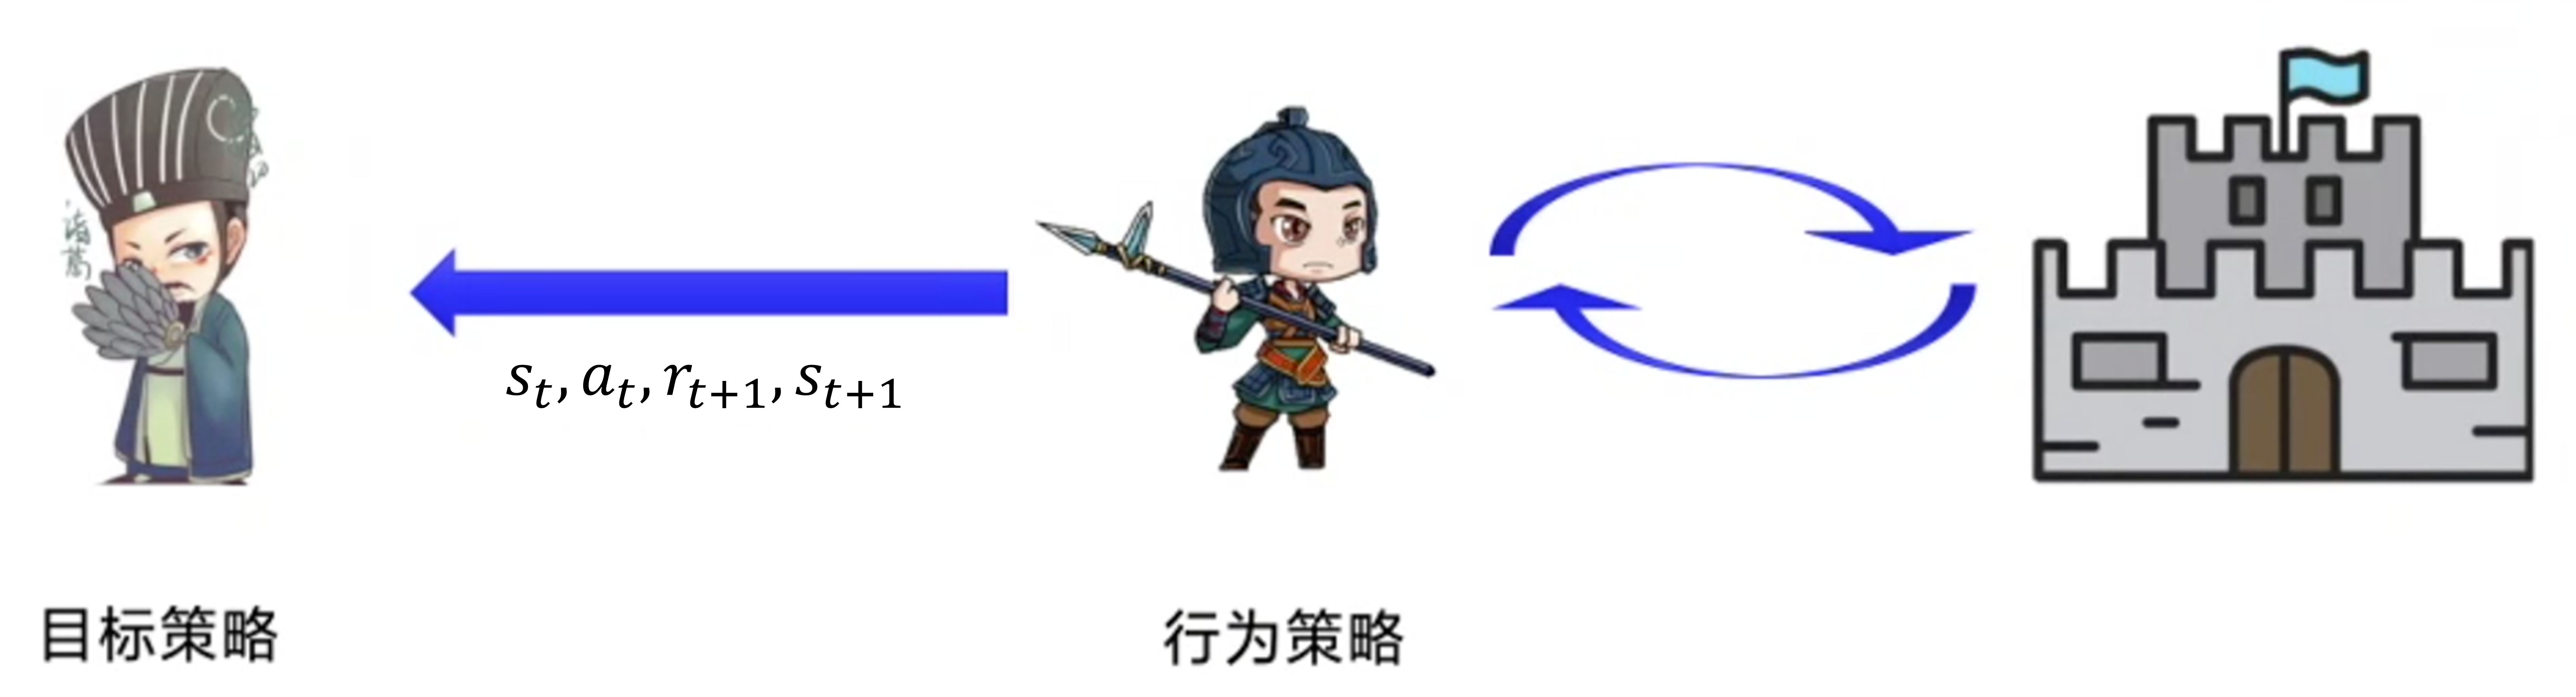
行为策略 vs 目标策略 ​

目标策略和行为策略

行为/探索/采样策略

  • 探索环境的策略,采集很多轨迹经验,给行为策略进行学习
  • 像前线的战士,希望充分探索环境,访问所有可能的状态和动作。
  • 如:策略评估,探索环境,采样估计Q函数

目标/学习/改进策略

  • 通过经验稿子进行学习的策略,不用和环境进行交互
  • 像后方的军师,尽可能利用已有的经验。
  • 如:策略改进,更新策略

同策略 vs 异策略 ​

同策略 vs 异策略

同策略/On-Policy

  • 定义
    • 行为/采样/探索策略 和 学习/改进/目标策略 相同。
    • 使用同一策略来搜集样本,通过样本学习并更新原策略。
  • 优点
    • 稳定,可以保证学习到的策略收敛到最优策略
    • 较好解决连续动作空间问题
  • 缺点
    • 样本利用效率低:仅能用来更新当前策略,不能更新其他策略

异策略/Off-Policy

  • 定义
    • 行为/采样/探索策略 μ 和 学习/改进/目标策略 π 不同。
    • 使用行为策略探索到的经验轨迹,`来优化目标策略**。
      • 如从经验回放或历史数据中学习。
    • μ可是随机策略,但采取 ϵ贪心 使其不至于完全随机,是基于Q表格逐渐改进的。
  • 优点
    • 学习效率高:旧策略的采样经验可多次利用,节省资源
    • 利用通过行为策略探索来学到最佳策略
      • 行为策略可采用 ϵ贪心算法,更加大胆,有可能探索到最佳策略
      • 目标策略仍使用普通贪心算法,根据行为策略经验来采用最佳策略
    • 可以学习其他智能体的动作
  • 缺点
    • 需分布比较接近,避免偏差和训练不稳定

SARSA:同策略TD ​

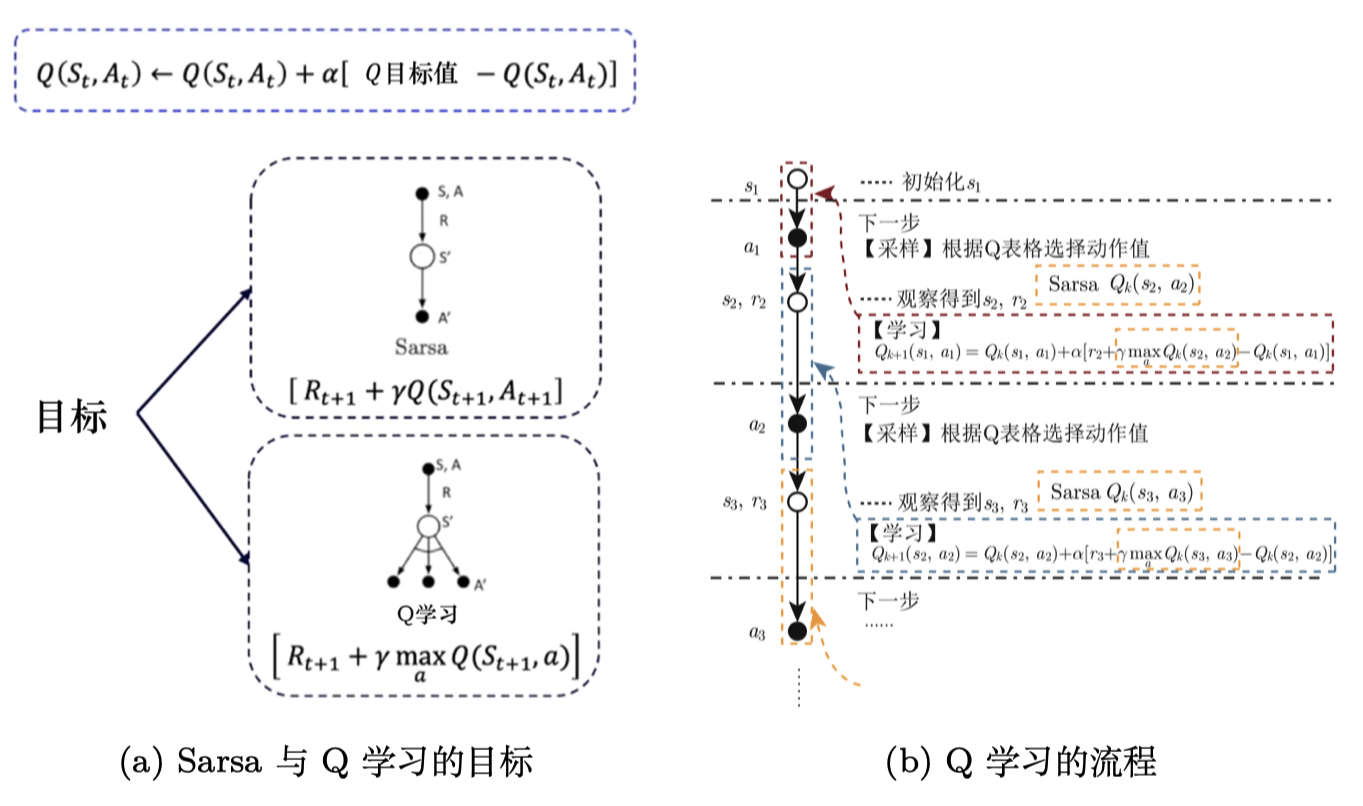
Sarsa 核心思想 ​

Sarsa 核心思想

核心思想

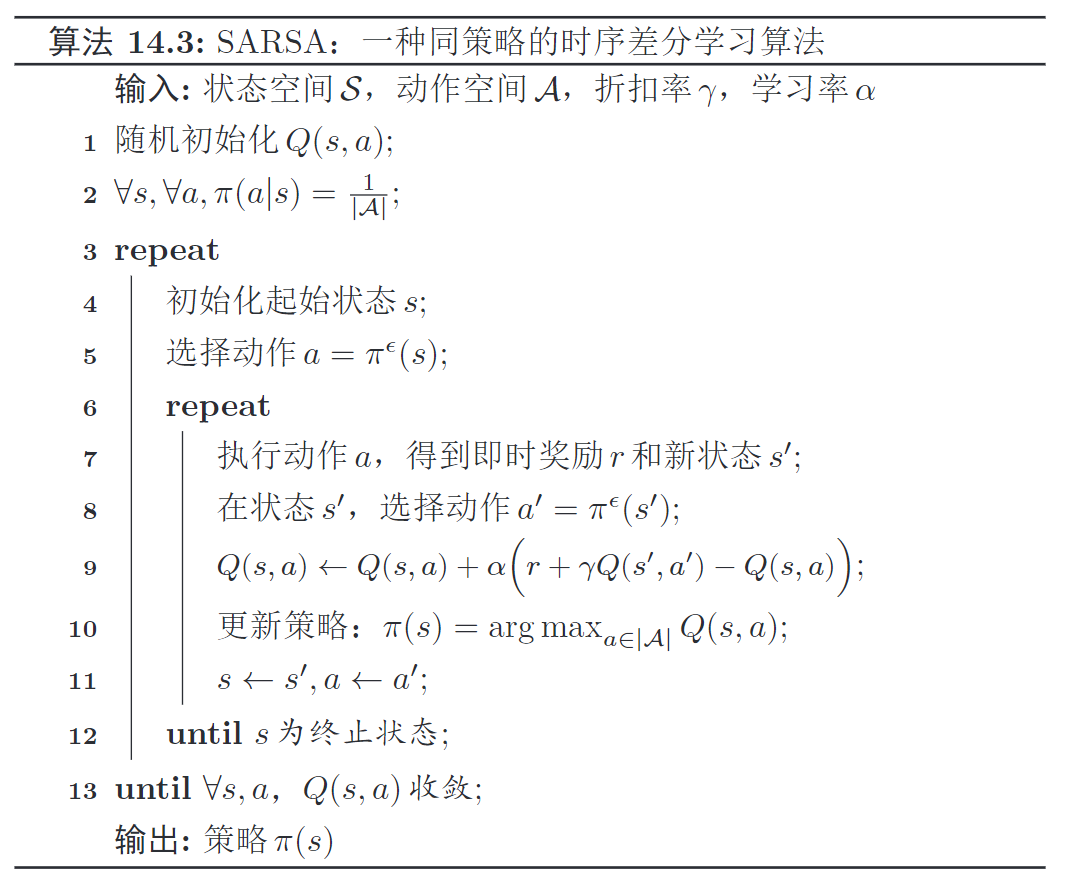
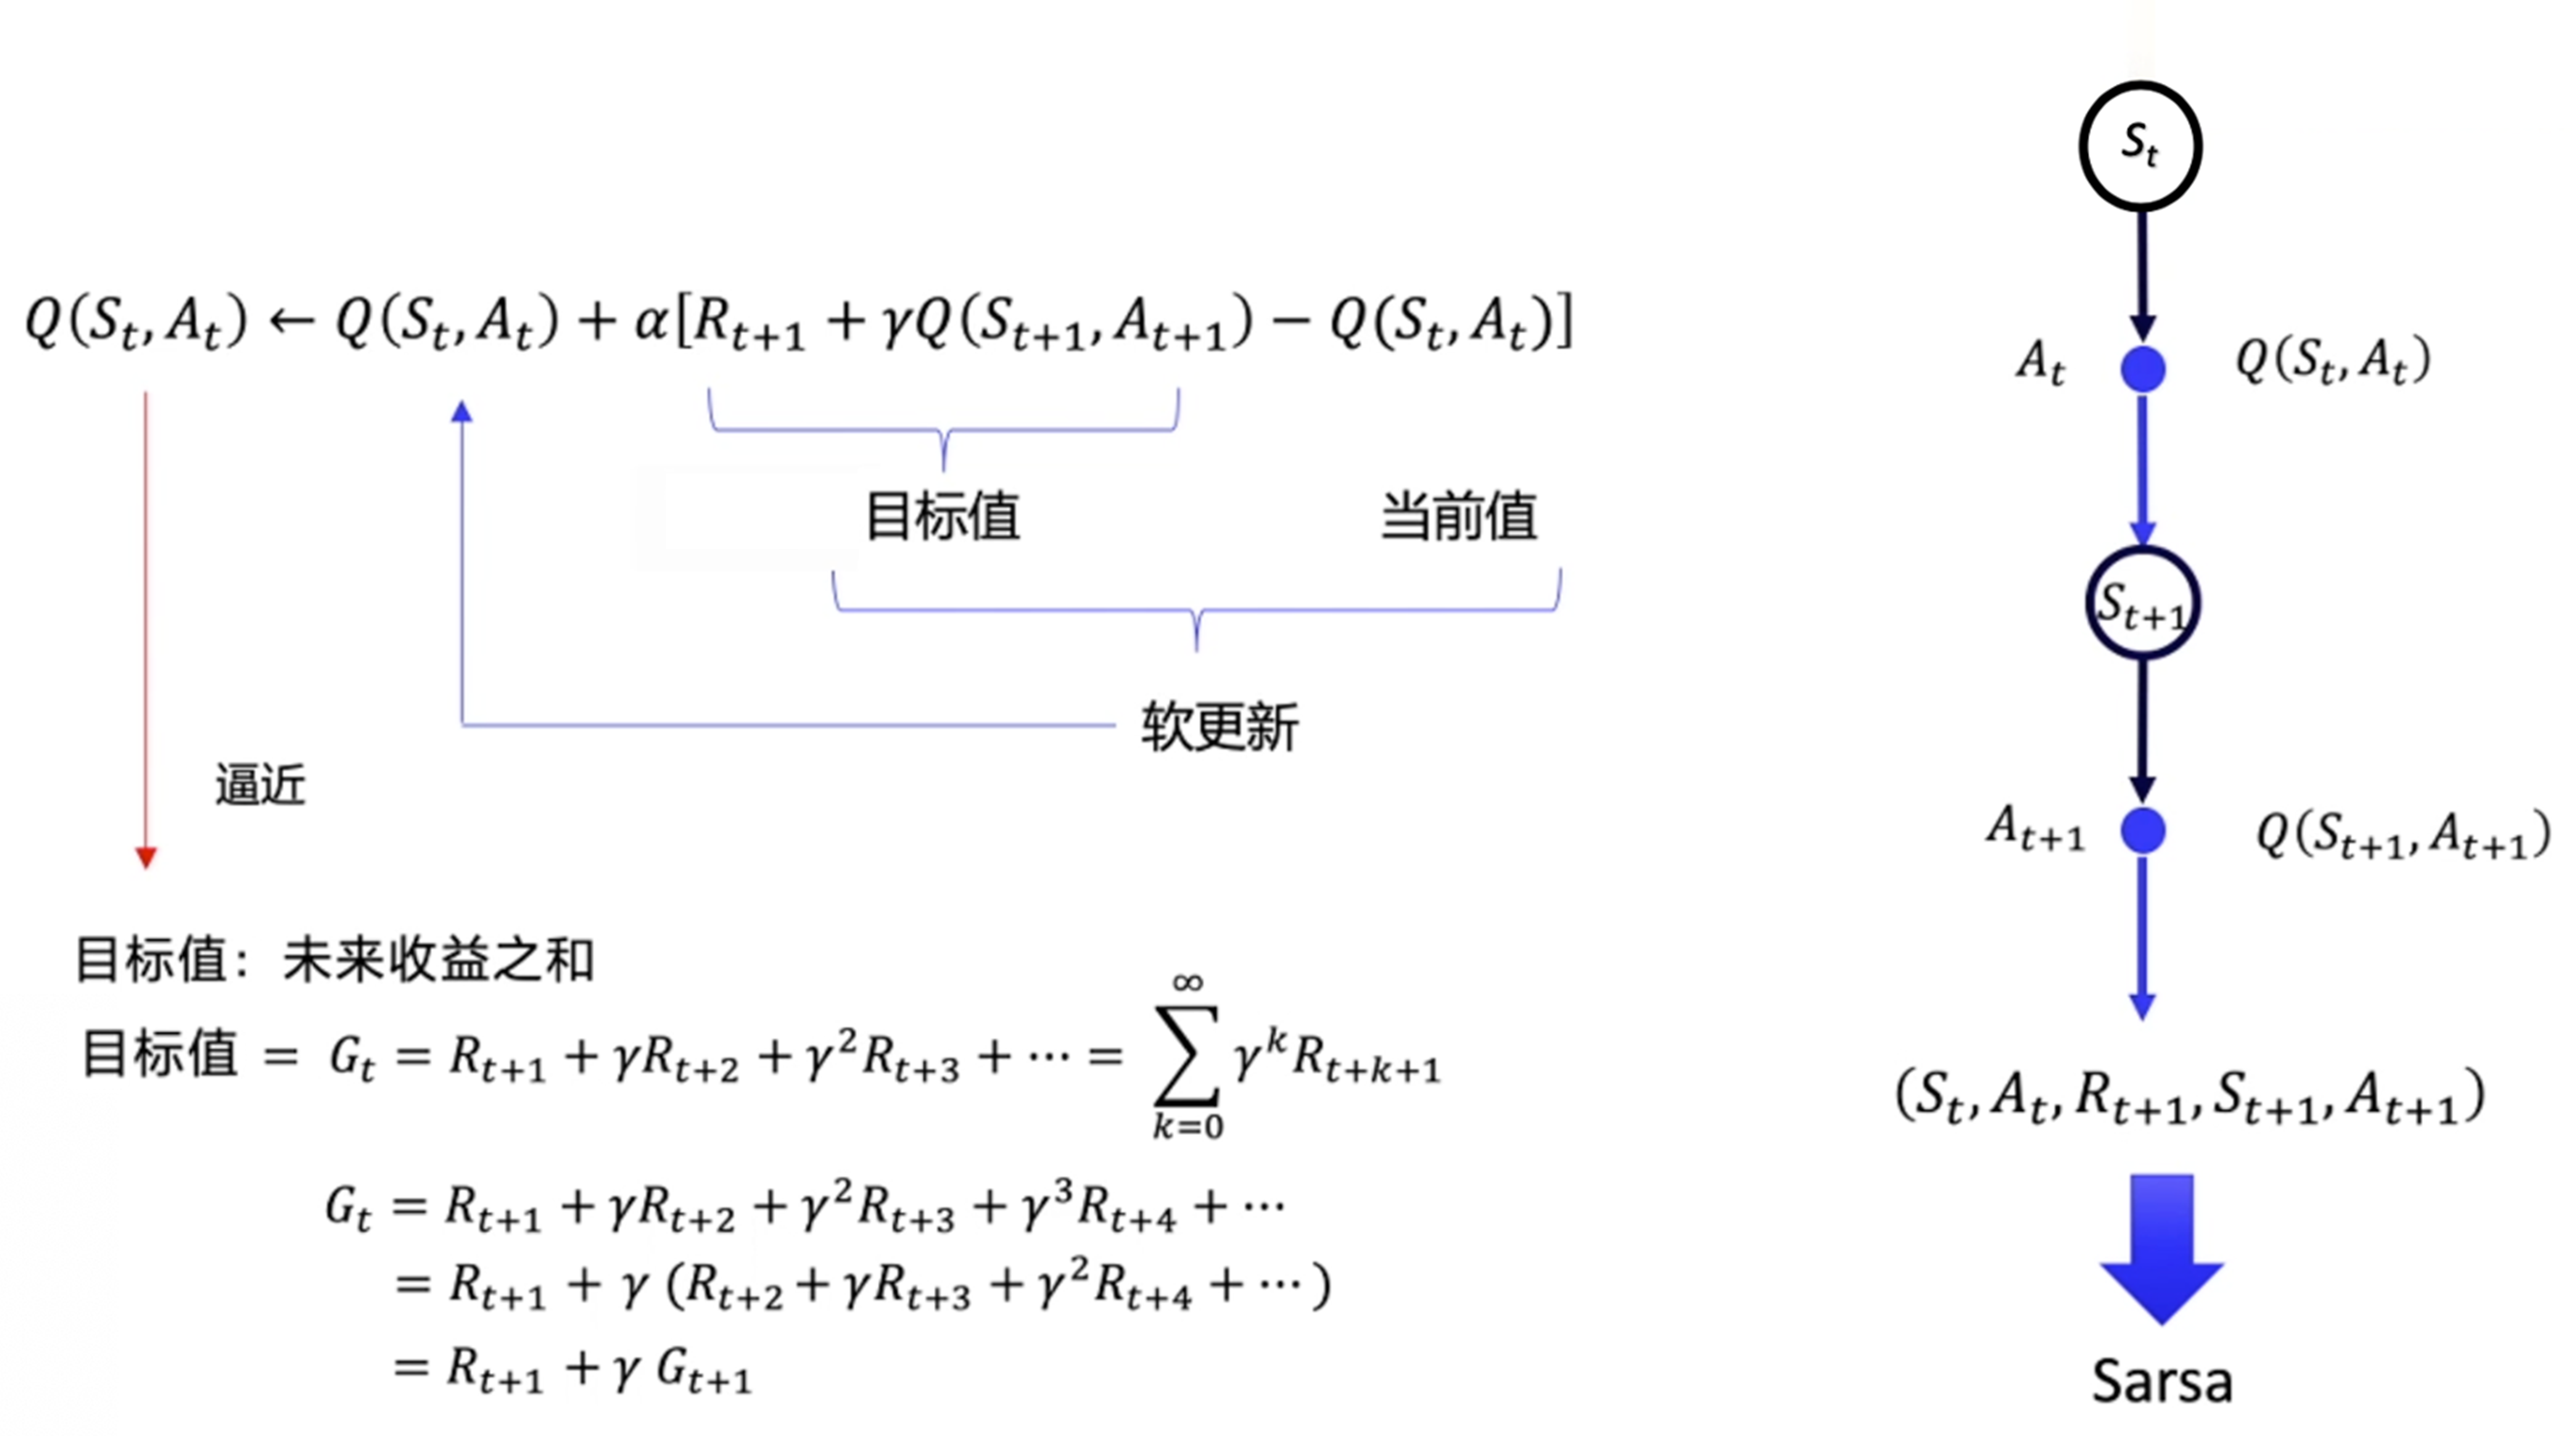
  • 用时序差分方法来估计Q函数,更新Q表格后就可更新策略
  • 用下一步Q(st+1,at+1)值,来更新当前步Q(st,at)值,不断强化每一个Q值
Qπ(st,at)←Qπ(st,at)+α⋅(rt+1+γ⋅Qπ(st+1,at+1)⏟TD目标值−Qπ(st,at)⏟当前值)Q(s,a)←Q(s,a)+α⋅(r+γ⋅Q(s′,a′)−Q(s,a))
Sarsa 算法流程

主要流程

  • 随机初始化π(s),不断迭代直到Q(s,a)收敛,进行以下迭代

  • 确定初始状态s,依策略选择动作a=πϵ(s),重复以下流程,直到s为终止态

    • 环境交互采样 s,a,r,s′,a′

      • 执行动作a,得奖励r、新状态s′
      • 在新状态s′,依策略选择动作a′=πϵ(s′)
    • 策略评估 / Q函数估计

      • Q(s,a)=Q(s,a)+α(r+γQ(s′,a′)−Q(s,a))
    • 策略改进更新 π

      • π(s)=arg⁡maxaQ(s,a)
    • 状态动作前进:s←s′,a←a′

n步Sarsa ​

n步时序差分

单步时序差分

  • 自举1步,用下一步Q(st+1,at+1)值,来更新当前步Q(st,at)值Q(st,at)←Q(st,at)+α⋅(rt+1+γ⋅Q(st+1,at+1)⏟TD目标值−Q(st,at)⏟当前值)

n步时序差分

  • 自举n步,一次性考虑n步回报
n=1Sarsa(0)Qt:t+1=rt+1+γ⋅Q(st+1,at+1)n=2Sarsa(1)Gt:t+2=rt+1+γ⋅rt+2+γ2⋅Q(st+2,at+2)⋮n=nSarsa(n)Qt:t+n=rt+1+γrt+2+⋯+γnQ(st+n,at+n)⋮n=∞MCQt:∞=rt+1+γ⋅rt+2+γ2⋅rt+2+⋯+γT−t−1⋅rT
  • n步回报Qtn
Qtn=rt+1+γ⋅rt+2+⋯+γn⋅Q(st+n,at+n)

Sarsa(λ) ​

Sarsa(λ)

核心思想

  • 模仿TD(λ)使用多个n步回报,引入资格衰减参数λ,对多个Qtn进行加权平均
Qtλ=(1−λ)∑n=1∞λn−1Qtn
  • Sarsa(λ)的更新策略
Q(s,a)←Q(st,at)+α⋅(Qtλ−Q(s,a))

Q学习:异策略TD ​

核心思想 ​

Q学习 核心思想

核心思想

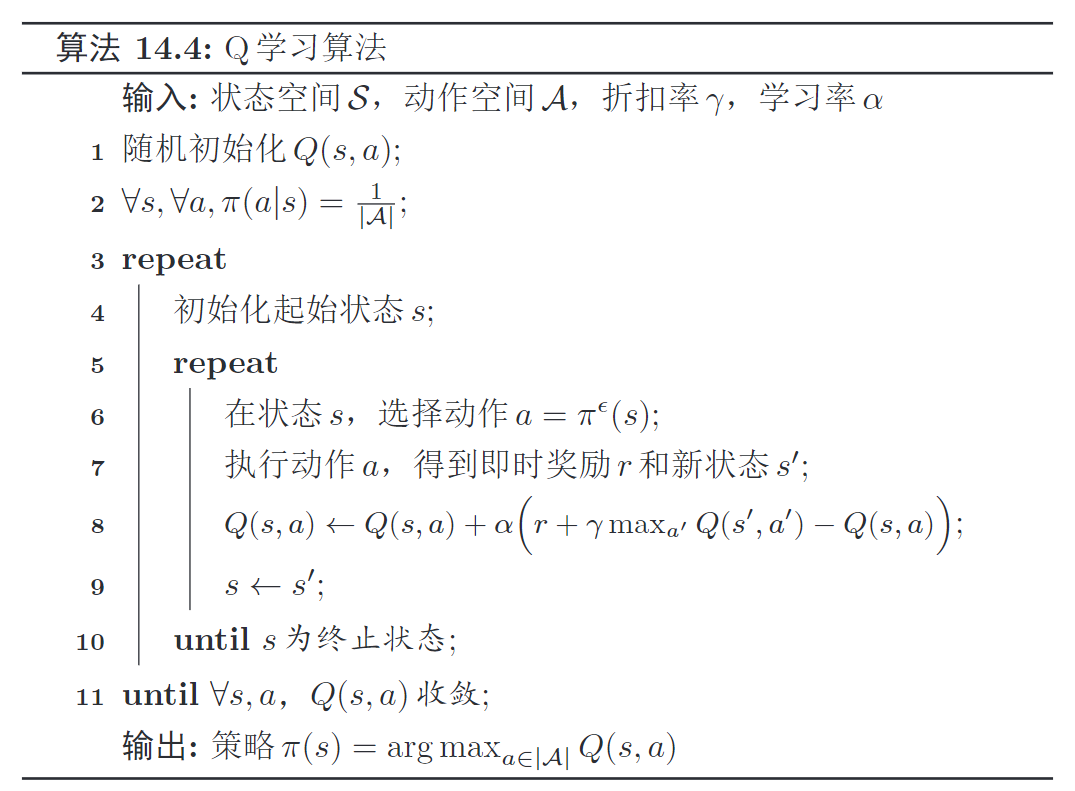
  • 同Sarsa一样,利用TD自举来估计Q函数,更新Q表格后可更新策略。

  • 但学习策略和行为策略不一样,是一种异策略算法

  • 学习策略

    • 估计Q函数时,采取下一时刻Q值最大的动作 a′=maxa′Q(st+1,a′)
    • a′≠at+1 ,a′ 不来自行为策略,并非下一步真正执行的动作at+1
    • 学习策略动作a′和行为策略动作at+1不一样
  • TD目标值:rt+1+γmaxa′Q(st+1,a′), 自举1步,更新Q函数

Q(st,at)=Q(st,at)+α(rt+1+γmaxa′Q(st+1,a′)⏟TD目标值−Q(st,at)⏟当前值)
  • 对比:Sarsa学习策略使用的动作at+1来自于行为策略采样的动作at+1,二者相同
Q(st,at)←Q(st,at)+α⋅(rt+1+γ⋅Q(st+1,at+1)⏟TD目标值−Q(st,at)⏟当前值)

算法流程 ​

Q学习 算法流程
  • 初始化策略π,执行以下迭代,直到所有Q(s,a)收敛

  • 初始化s,执行以下迭代,直到s为终止态

    • 环境交互采样/探索策略

      • 依策略选择动作 a=πϵ(s)
      • 执行动作a,得即时奖励r、新状态s′
    • Q函数估计/学习策略

      • 与sarsa不同,不使用探索策略 采样的下一步真正执行的 动作at+1

      • 而是直接选择最大Q值对应的动作 a′=maxa′Q(s′,a′) 用来估计Q。

        • a′≠at+1 ,a′ 不来自探索策略,并非下一步真正执行的动作
        Q(s,a)=Q(s,a)+α(r+γmaxa′Q(s′,a′)−Q(s,a))
    • 仅状态前进 s←s′

  • 策略更新,输出策略π

π(s)=arg⁡maxa∈AQ(s,a)

伪代码 ​

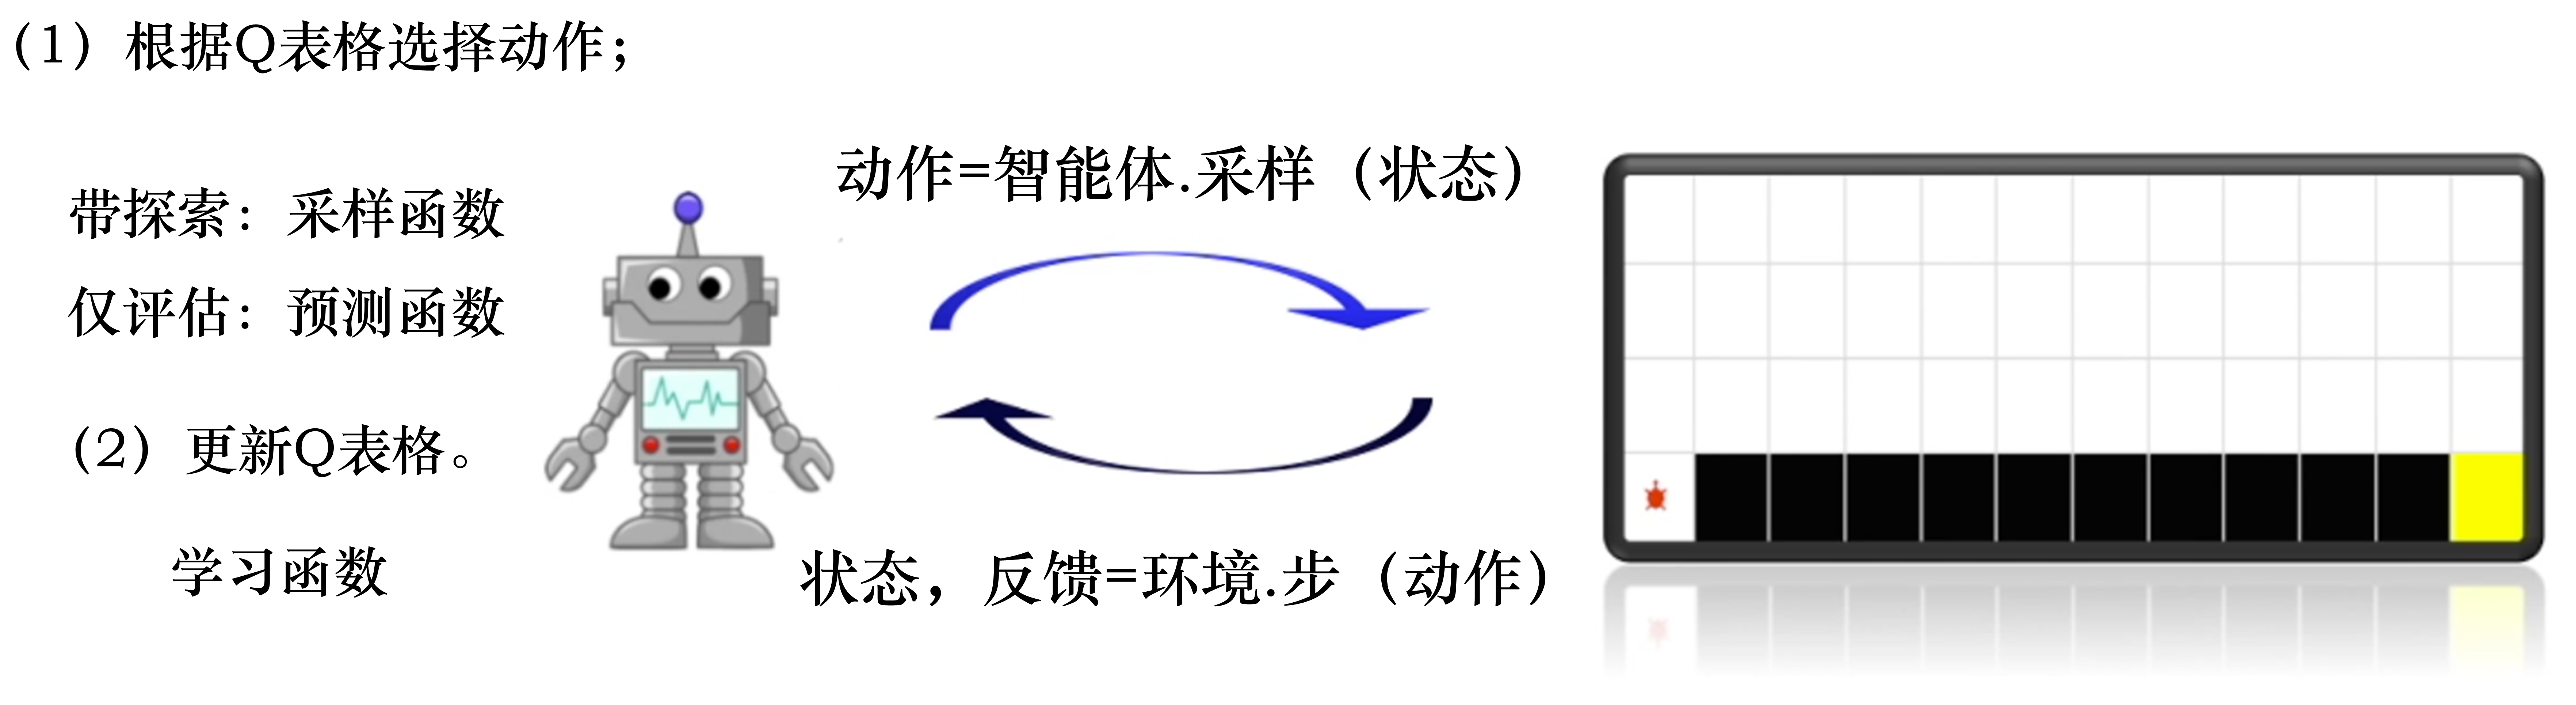
训练流程代码:多个回合

  • agent采样动作:agent.sample_action(state)
  • 环境交互:env.step(action)
  • 样本放入经验池:agent.meomory.push(xxx)
  • agent更新策略:agent.update(xxx)
python
for i_ep in range(train_eps): # 遍历每个回合
    # 重置环境,获取初始状态
    state = env.reset()  # 重置环境,即开始新的回合
    while True: # 对于比较复杂的游戏可以设置每回合最大的步长,例如while ep_step<100,即最大步长为100。
        # 智能体根据策略采样动作
        action = agent.sample_action(state)  # 根据算法采样一个动作
        # 与环境进行一次交互,得到下一个状态和奖励
        next_state, reward, terminated, _ = env.step(action)  # 智能体将样本记录到经验池中
        agent.memory.push(state, action, reward, next_state, terminated) 
        # 智能体更新策略
        agent.update(state, action, reward, next_state, terminated)  
        # 更新状态
        state = next_state  
        # 如果终止则本回合结束
        if terminated:
            break

Agent类:

  • 采样动作:ϵ贪心法,指数衰减
  • 预测动作:直接根据Q_table选择最大值即可
  • 策略更新:更新Q_table,
python
class Agent:
    def __init__():
    		self.Q_table  = defaultdict(lambda: np.zeros(n_actions))

    def sample_action(self, state):
        ''' 采样动作,训练时用
        '''
        self.sample_count += 1
        # epsilon是会递减的,这里选择指数递减
        self.epsilon = self.epsilon_end + (self.epsilon_start - self.epsilon_end) * math.exp(- self.sample_count / self.epsilon_decay) 
        # e-greedy 策略
        if np.random.uniform(0, 1) > self.epsilon:
            action = np.argmax(self.Q_table[str(state)]) # 选择Q(s,a)最大对应的动作
        else:
            action = np.random.choice(self.n_actions) # 随机选择动作
        return action
    
    def predict_action(self,state):
        ''' 预测或选择动作,测试时用
        '''
        action = np.argmax(self.Q_table[str(state)])
        return action
    
    def update(self, state, action, reward, next_state, terminated):
      	''' 更新Q_table即可
      	'''
        Q_predict = self.Q_table[str(state)][action] 
        if terminated: # 终止状态
            Q_target = reward  
        else:
            # TD目标计算,reward + 直接Q max值,而非给定下一时刻真正执行的动作的Q值
            Q_target = reward + self.gamma * np.max(self.Q_table[str(next_state)]) 
        self.Q_table[str(state)][action] += self.lr * (Q_target - Q_predict)
        return

Sarsa vs Q-Learning ​

Sarsa vs Q-Learning

Sarsa

  • 同策略算法
  • 自己的策略采样轨迹,并用Qπ(st+1,at+1)来更新Qπ(st,at)

Q-Learning

  • 异策略算法
  • 不需要知道下一步实际执行哪个动作,更新Q时 默认选择Q值最大的动作
  • 不用知道下一步实际at+1,就能更新Q(st,at)
  • Q学习不担心受探索的影响,比Sarsa更大胆
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026