Skip to content

熵和RL相关文章

📅 发表于 2025/11/03
🔄 更新于 2025/11/11
👁️ — 次访问
📝 3107 字
⏳ 10 分钟
rl
#entropy

(2505) Clip-Cov/KL-Cov ​

摘要
  • paper: entropy mechanism of rl

  • 非常有深度的一篇文章。

  • 围绕熵坍塌进行了深入研究

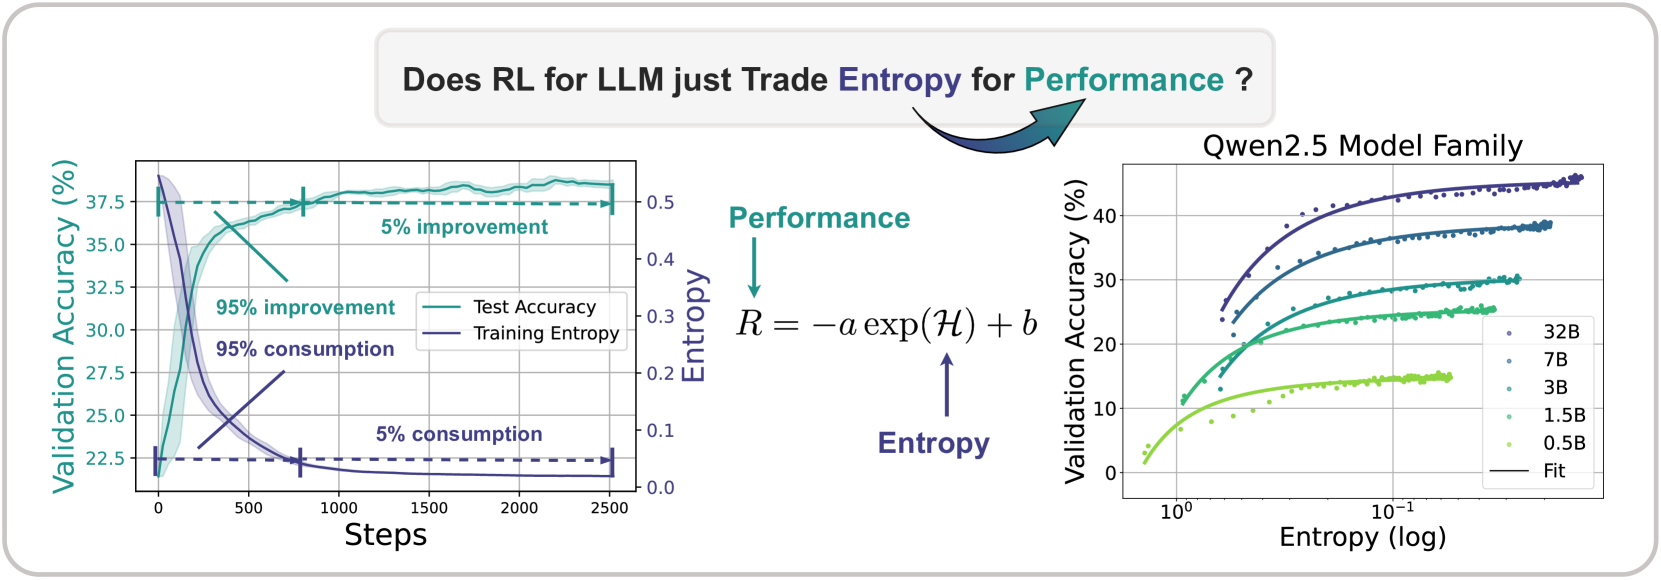
    • 模型性能和熵存在预测关系,熵限制,性能有上限。
    • 熵和协方差有关系。协方差2个变量:对数概率和logit变化程度。
    • 高优势高概率token,协方差大,使得熵坍塌
  • 提出Clip-Cov和KL-Cov的方法,精准控制少部分高协方差token。

    • 效果很好。7B提升2pt,32B提升6.4pt。

问题背景 ​

熵坍塌 ​

❓问题背景

策略熵坍塌

RL 核心挑战

策略熵的含义

  • 探索潜力的一个量化指标,代表动作探索空间的不确定性。

熵坍塌的表现

  • 训练开始一些step后,策略熵就急剧下降甚至趋于0。策略变得极其确定。

熵坍塌的危害

  • 探索停止,无法探索新路径
  • 熵耗尽,性能达瓶颈,再继续训练也是徒劳的。

普通正则熵无效

  • 简单应用熵正则是无效的。

需要打破熵瓶颈

  • 可扩展RL,需要打破熵瓶颈。

熵正则及其问题(无效方法) ​

熵正则及其问题

Entropy Loss:在loss上减去熵

  • 熵越大, loss会小一点。激励模型去寻找熵更高的策略。
    • α:entropy_coef
Lentropy=L−α⋅H(πθ)
  • 缺点:参数非常敏感,非常脆弱
    • entropy_coef 太小:[0.0001, 0.001],对熵几乎没有作用,熵依然崩溃
    • entropy_coef 太大:0.01,熵直接爆炸了,胡言乱语,输出随机token

KL Loss:在loss上增加KL惩罚

  • 偏离参考模型较远时,loss会大一点。
    • 不希望偏离参考模型太远。通常πref具有较高的熵。确实能起到拉住熵的作用。
    • β:kl_coef
LKL=L+β⋅DKL(πθ||πref)
  • 优点:
    • 只要β>0,确实能稳住熵。β越大,熵稳定的水平就越高。
  • 缺点
    • 扼杀了模型的学习能力。kl_coef>0 模型性能低于kl_coef=0

RL 范式 ​

RL 范式

RL 优化目标

  • 优化策略,最大化累计奖励maxθJ(θ)=Ex∼D,y∼πθ(x)[r(y)]

通过策略梯度来优化

∇θJ(θ)=Ex∼D,y∼πθ(x)[∑t=0TAt⋅∇θlog⁡πθ(yt∣y<t)]

PPO 近端策略优化

  • PPO 算法:off-policy提高训练、限制策略更新幅度
JPPOCLIP(πθ)=Eq,o∼πθold1|o|∑t=1|o|min(πθ(ot∣q,o<t)πθold(ot∣q,o<t)⋅At,clip(πθ(ot∣q,o<t)πθold(ot∣q,o<t),1−ϵ,1+ϵ)⋅At)

GRPO 组内优势减小方差

  • GRPO 算法:使用组内优势,减小方差A^i,t=A^i=r^i=ri−mean(r)std(r)

策略熵 ​

策略熵定义

策略熵

  • 含义:量化不确定性,策略在选择动作时的可预测性、随机性。

  • 计算:给定策略和数据,平均token-level的熵,作为策略熵。

    H(πθ,D)=−ED,πθ[log⁡πθ(yt∣y<t)]=−1|D|∑x∈D1|y|∑i=1|y|Eyt∼πθ[log⁡πθ(yt∣y<t,x)]
H(πθ,D)=−1|D|∑x∈D1|y|∑i=1|y|Eyt∼πθ[log⁡πθ(yt∣y<t,x)]

策略熵公式理解

  • πθ(yt∣y<t,x)

    • 给定输入x和已有y,生成下一词yt的概率,[0, 1]之间,模型自信程度。
    • 值越大,概率越大, 越自信,不确定性越低。
  • log⁡πθ(yt∣y<t,x)

    • 取对数,(−∞,0] 之间,值越大,概率越大,越自信,不确定性越低。
  • 1|y|∑i=1|y|

    • 序列内部所有token求平均,平均token熵
  • 1|D|∑x∈D

    • 序列间 所有序列求平均,作为策略熵。概率越大,不确定性越低。
  • −1|D|∑x∈D

    • 增加负号,把值转换成正数。
    • 值越小,熵越小,概率越高,不确定性越低;值越大,熵越高,概率越低,不确定性越高。
    H(πθ,D)=−1|D|∑x∈D⏟序列间求平均1|y|∑i=1|y|⏟内部求平均Eyt∼πθ[log⁡πθ(yt∣y<t,x)⏟log probs]

模型性能和熵 ​

性能和熵关系公式 ​

模型性能和熵存在预测关系

性能和熵直接挂钩

  • 在没有熵loss或KL正则的情况下

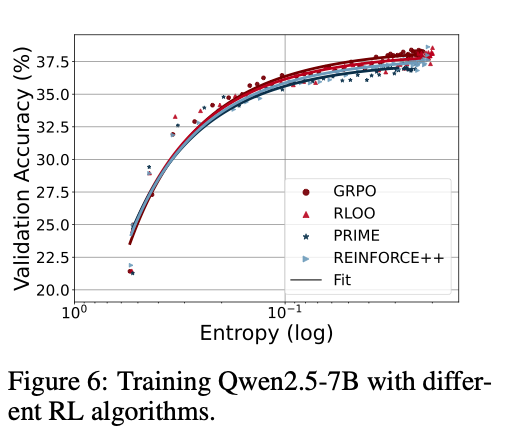
  • 模型性能R 和 策略熵H 之间,存在一个可预测的指数关系

    R=−aexp⁡H+b
    • 系数a、b:反应了策略和数据的内在特征
  • 性能提升,熵必然减小。牺牲熵、来提升模型性能。

  • 性能和熵挂钩,而不是和计算资源挂钩,且和算法无关,后期实验有验证。

性能存在上限

  • 上限:H=0→eH=1,后续投入再多计算资源也无用
Rmax=−a+b

验证实验配置 ​

✍️实验设置

验证实验配置

模型

  • Qwen 系列:Qwen2.5 0.5-32B
  • Mistral 系列:7B、24B
  • LLaMA 系列:LLaMA3.2 3B、LLaMA3.1 8B
  • DeepSeek系列:DeepSeek-Math-7B-Base

任务/数据

  • 数学
    • 训练:
    • 评测:MATH500, AIME24, AMC, OlympiadBench, OMINI-MATH
  • 代码
    • 训练:
    • 评测:Eurus-2-RL-Code, KodCode

算法

  • GRPO、REINFORCE++、PRIME

超参

  • Lr:5e-7;1e-6 PRM
  • bs=256, micro_bs=128
  • KL系数:0
  • ϵ=0.2
  • 策略:过滤掉全对或全错的prompt, DAPO 动态采样

验证实验结果 ​

🍑关键结果

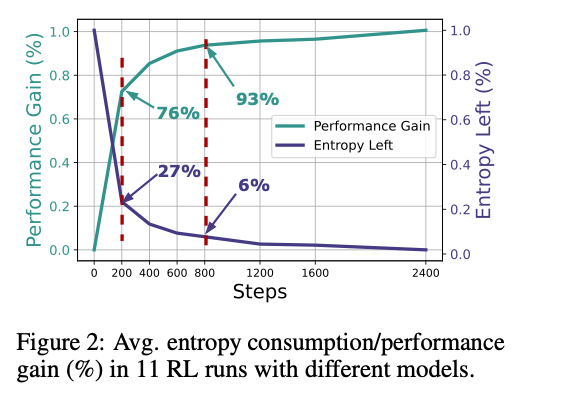
11个RL训练实验

早期消耗熵活动性能

  • 前200step(1/12训练):熵下降73%,性能增益76%。
  • 前800step (1/3训练):熵损失94%,性能增益93%。
  • 超过2/3的训练,仅产生很小的回报。

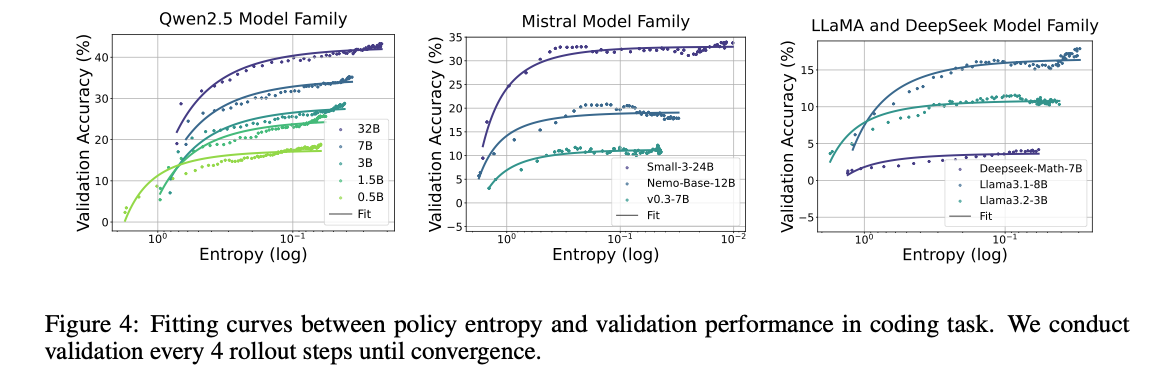
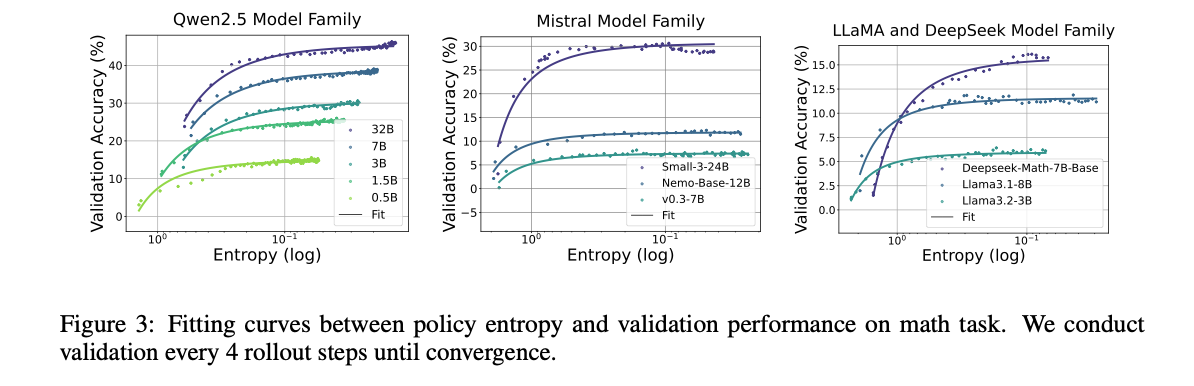
多组实验完美拟合熵和性能的曲线

  • GRPO 实验。
  • 曲线和算法无关,RLOO、PRIME、REINFORCE++都差不多。

ab 系数理解

  • a:转化效率。

    • a越大,越擅长把探索潜力转换成性能,越高效,a越大。
    dRdH=−aexp⁡H
  • b、-a+b:性能潜力

    • 模型越强,−a+b 越大。

早期消耗熵、增加性能。

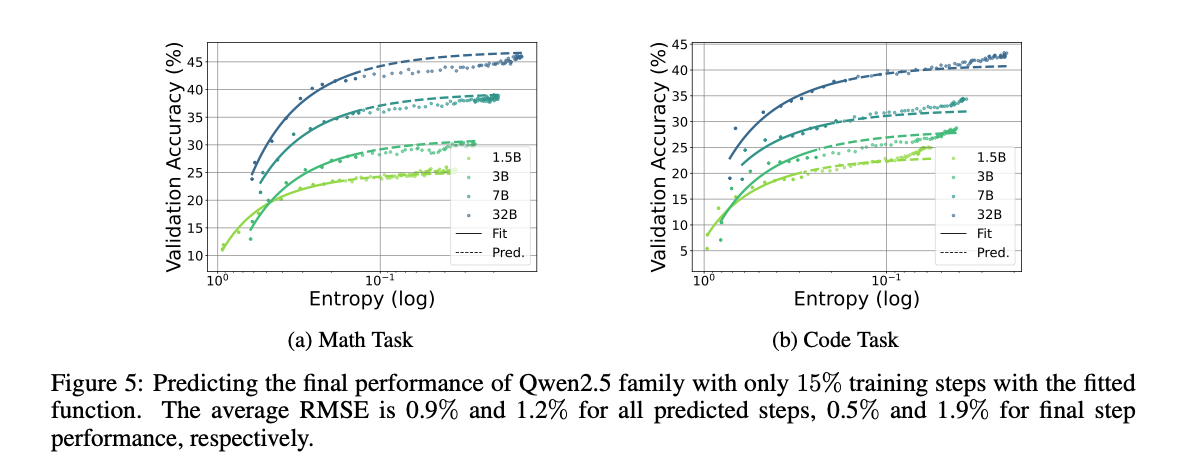
完美拟合曲线:实线是公式计算的,散点是实际测量的(熵, 性能)数据对。
在训练早期,可以通过公式来预测后期性能,性能上限是注定的。
熵性能曲线和RL算法无关,不同算法结果类似。
熵和协方差 ​

熵和协方差的关系 ​

熵和协方差有关系

熵变化和协方差有关系

  • LLM Softmax这种策略,在两个连续步骤之间
  • 熵变化与协方差 有关系。

协方差理解

  • 协方差变量:动作的对数概率和对应的logit变化
    • 对数概率/自信程度:生成某个词的概率,值越大,模型越确定
    • logit变化/信念增强程度:模型得到奖励BP后,对这个动作的增强程度。
      • 变化越大:模型认为这个动作越值得被强化
  • 当自信程度和信念增强程度同时很高时,协方差为正、很大。
    • 模型继续强化这个动作,排除掉其他可能性,导致熵急剧下降。

高协方差有害

  • 高协方差 导致了熵急剧下降,对ScaleRL非常有害。

熵的Token变化关系

  • 高优势高概率 Token:协方差大,降低熵

  • 高优势低概率 Token:协方差低,增加熵

熵和协方差公式分析及结论 ​

熵和协方差关系 公式推导

Softmax 动作a概率

  • zs,a:给定状态s,选择动作a的logit
πθ(a∣s)=exp⁡(zs,a)∑a′∈Aexp⁡(zs,a′)

熵变化

  • 熵变化≈对数概率和logits变化之间的负协方差。
ΔH=H(πθk+1)−H(πθk)≈Es∼dπθ[−Cova∼πθk(⋅∣s)(log⁡πθk(a∣s)⏟初始信心,zs,ak+1−zs,ak⏟变化量)]H(πθk+1)=H(πθk)+ΔH
  • log⁡πθk(a∣s)
    • 在更新前对动作a的初始信息
    • 负对数概率,范围[0, 1],概率越大,确定性越大,随机性越小。
  • zs,ak+1−zs,ak
    • 动作a的logit在更新后的变化量,对a信息的增强或减弱。
  • −Cova∼πθk(⋅∣s)(log⁡πθk(a∣s),zs,ak+1−zs,ak)​
    • 增加负号
      • 协方差若为正,ΔH<0,熵减小,不确定性变小
      • 协方差若为负,ΔH>0,熵变大, 不确定性变大
协方差结论

结论

  • 高概率、高优势 token,导致高协方差,会降低熵。
  • 协方差越高、熵下降越快。
  • 动作概率和动作优势呈强烈正相关,是导致策略熵下降的根本原因。

实验结论

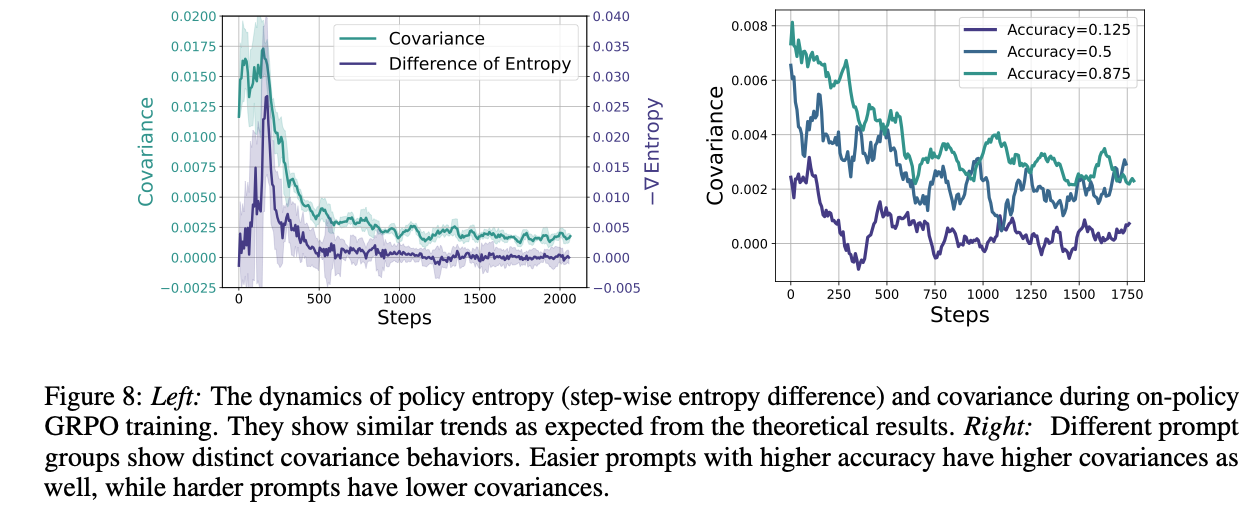
  • 协方差和−ΔH熵变化趋势一致,协方差越高、熵下降越快。
  • 难度大的样本,协方差更低,有助于熵;难度低的样本,协方差高。
  • 下图左侧:协方差和−ΔH 负熵变化趋势一致
  • 下图右侧:难样本,协方差低,有助于熵

两种策略梯度的熵变化公式 ​

两种策略梯度熵变化公式

普通策略梯度

  • logit会被当前动作的概率 缩放
θk+1=θk+η∇θJ(θk)zs,ak+1−zs,ak=η⋅πθ(a∣s)⋅A(s,a)
  • 熵变化
H(πθk+1)−H(πθk)≈−η⋅Cova∼πθk(⋅∣s)(log⁡πθk(a∣s),πθ(a∣s)⋅A(s,a))

自然策略梯度

  • 利用fisher信息矩阵的逆矩阵F−1对梯度做了预处理。
    • 费雪信息矩阵:衡量参数变化时,策略分布会变化多少。乘以逆矩阵,矫正了参数空间的扭曲。
  • NPG
    • 直接把logit的变化和优势联系起来,导致缩放项消失了。
    • 不管动作初始概率是多少,更公平地对待所有动作的优势。
θk+1=θk+ηF−1∇θJ(θk)zs,ak+1−zs,ak=η⋅A(s,a)H(πθk+1)−H(πθk)≈−η⋅Cova∼πθk(⋅∣s)(log⁡πθk(a∣s),A(s,a))

普通策略梯度vs自然策略梯度 ​

特征普通策略梯度 (VPG)自然策略梯度 (NPG)
优化空间参数空间 (θ)策略空间 (动作的概率分布)
步长含义在参数最陡峭的方向上迈出固定的一步。在最优方向上产生一个固定大小的策略变化(KL散度)。
Logit 变化Δz∝πθ(a,s)⋅A(s,a)Δz∝A(s,a)
熵变化项Cov(log⁡π,π⋅A)Cov(log⁡π,A)
优点实现简单。更稳定,对参数化不敏感,能避免策略过早崩溃。
缺点对参数化敏感,可能迈出毁灭性的大步。计算昂贵(需要计算并求逆费雪矩阵)。

核心方法:抑制高协方差token ​

背景

问题

  • 熵坍塌,熵和协方差相关,熵正则无效。
  • 仅少量token 协方差特别大,导致熵崩溃。
    • 仅0.02%的高协方差tokens的平均协方差值是整体平均值的1800倍以上

核心思想

  • 精准打击协方差特别大的token即可。

协方差计算公式

  • token-level 协方差,输出token yi的协方差
  • 注意协方差2个变量是:yi的对数概率/初始信念和logit变化/动作优势/信念变化。
Cov(yi)=(log⁡πθ(yi)−1N∑j=1Nlog⁡πθ(yj)⏟对数概率均值)⋅(A(yi)−1N∑j=1NA(yj)⏟logit变化均值)

Clip-Cov/高协方差裁剪 ​

Clip-Cov

背景

  • 忽略限制高协方差token。

核心思想

  • 随机选择一小部分高协方差token,在梯度更新中,分离并忽略掉他们的梯度 detach()
  • 冷却机制,忽略掉最强正反馈信号token,防止他们完全主导学习过程,保留其他可能性。

筛选过程

  • 计算每个token的协方差

  • 设置协方差筛选范围上下限 [wlow,whigh],一般可设为平均协方差的500倍。

  • 筛选高协方差token:设置筛选比例r=0.02,从中筛选r∗N个token,记录index,用于clip掉。

    Iclip=I∼Uniform({i∣Cov(yi)∈[wlow,whigh]},⌊r∗N⌋)
  • 对高协方差token:一律detach 梯度,不做更新

    LClip-Cov(θ)={Et[πθ(yt∣y<t)πθold(yt∣y<t)⋅At]t∉Iclip0t∈Iclip

KL-Cov/高协方差限制 ​

KL-Cov

背景

  • 限制高协方差token的更新幅度。

核心思想

  • 不完全忽略高协方差token,对高协方差token施加KL惩罚,限制更新幅度不能太大。

具体方法

  • 计算所有token的协方差。
  • 筛选高协方差token:所有token按协方差从高到低排序,选择top-k比例的token
IKL={i∣RankCov(yi)≤k∗N}
  • 对高协方差token:增加KL惩罚,限制更新幅度LKL-Cov(θ)={Et[πθ(yt∣y<t)πθold(yt∣y<t)⋅At]t∉IKLEt[πθ(yt∣y<t)πθold(yt∣y<t)⋅At−β⋅DKL(πθold(yt|y<t),πθ(yt|y<t))]t∈Iclip

Clip-Cov+KL-Cov vs Clip-Higher ​

和Clip-Higher 对比

Clip-Higher

  • 放宽限制,允许更多低概率且高优势的token参与梯度计算,这些token恰好是负协方差的、增加熵。
  • 间接、无意中,做了正确的事情。

Clip-Cov, KL-Cov

  • 不通过概率筛选,直接使用协方差这个根本指标作为阈值。
  • 对熵的控制更精准、直接。

算法实验 ​

实验设置 ​

Clip-Cov & KL-Cov 实验配置

模型

  • Qwen2.5-7B, Qwen2.5-32B

Baseline

  • GRPO, GRPO+Clip-Higher(0.28)

任务

  • 训练数据:DAPO-MATH-17K

  • 评测数据:MATH500, AIME24, AIME25, AMC, Omini-Math, Olympiad-Bench, Minierva

超参

  • 训练Rollout

    • bs=256, rollout.n=8, temperature=1
  • 评估

    • AIME+AMC:temperature=0.6
    • 其他测试集:贪婪解码
  • Clip-Cov

    • 比例r:r=2⋅10−4, CLIP上下限 [wlow=1,whigh=5]
  • KL-Cov

    • top-k比例

      k={2⋅10−3Qwen2.5-7B2⋅10−4Qwen2.5-32B
    • β=1

  • max_generation_length = 8192

关键结果 ​

关键结果
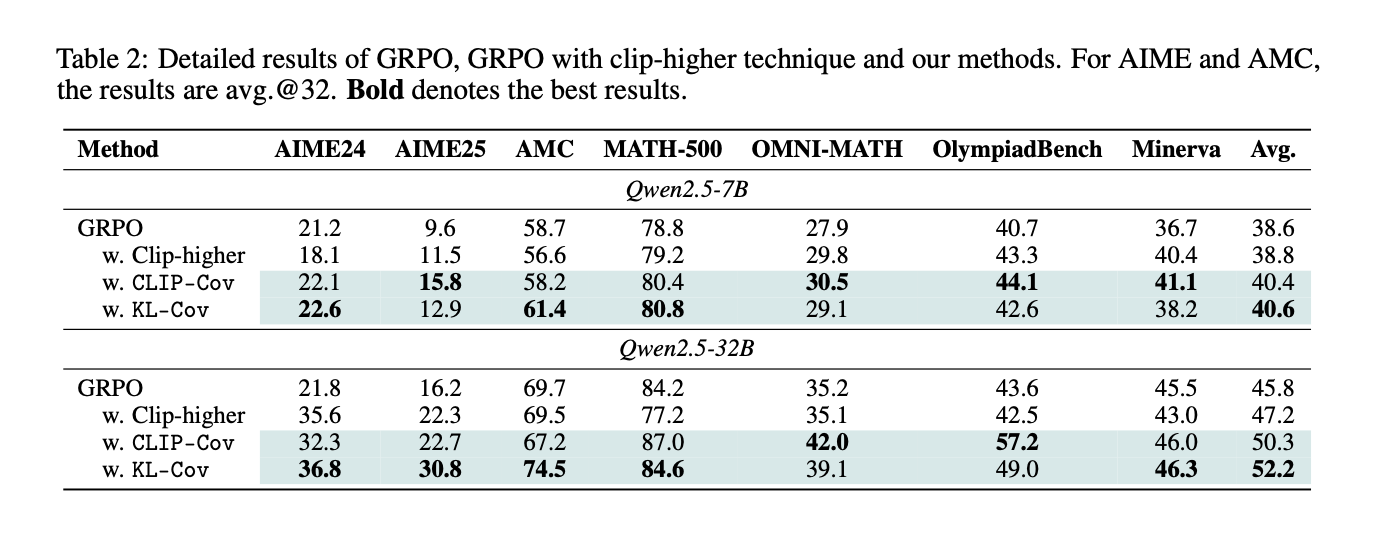
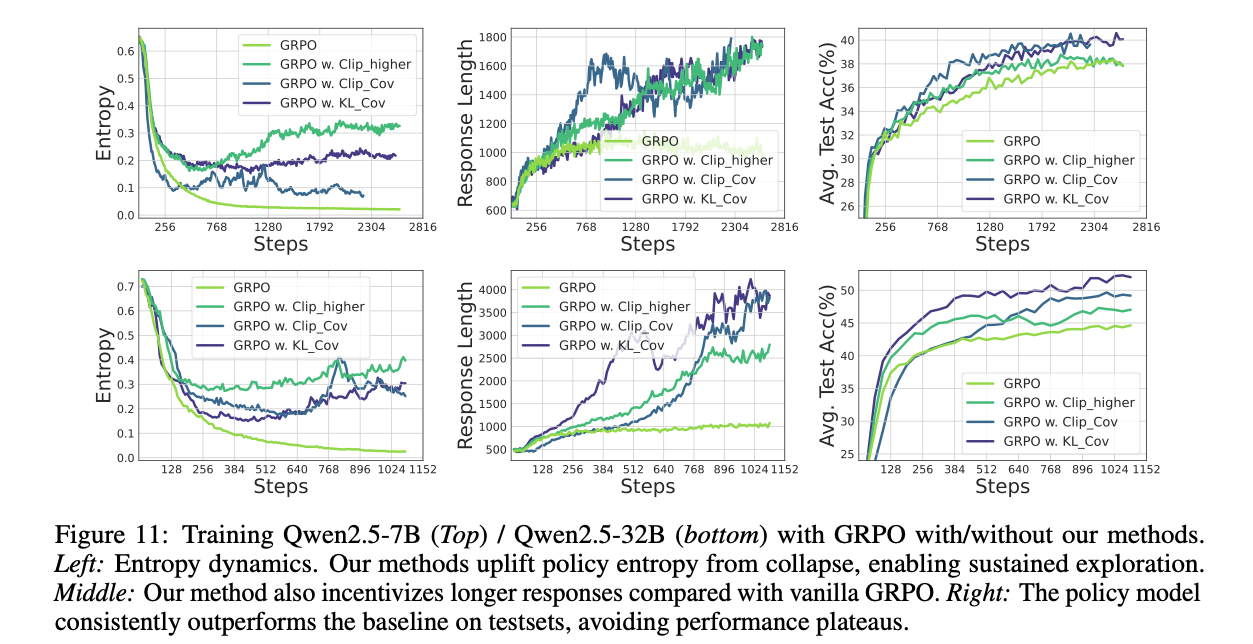
  • Clip-Cov和KL-Cov 效果好。7B平均提升2.0pt,32B提升6.4pt。
  • 新方法维持了高策略熵,实现了持续探索和学习。
    • 基线方法熵耗尽时,KL-Cov仍能把熵维持在10倍以上水平。
    • 激励更长回答。
    • 避免性能饱和,持续稳定提升。
  • Cov方法在大模型上效果更好,展现出良好的Scaling。
    • 解除了探索限制,能更好释放大模型潜能。
  • 干预可控且高效。
    • 可干预:Clip-Cov 裁剪比例、上下限;KL-Cov top-k比例、系数等。
    • 干预高效:干预少量token即可改变训练过程的熵动态
  • 熵控制的哲学
    • 熵崩溃是由少部分高优势高概率token引起的,是由少数点坍塌引发的连锁反应。
      • 精准扶住关键点,就能稳住整个系统。
    • 熵和性能并非直接关系。
      • 并非 维持的熵越高、性能就越好。不同的熵水平,可能达到相似性能。
      • 什么样的熵才是最优的呢?

性能好

维持了高策略的熵,实现持续探索和学习。

未来方向 ​

⛳未来方向

未来方向
  • 寻找最优熵值
    • 是否存在?动态控制熵策略,前期探索,后期收敛。需要根据任务难度自动调整参数。
  • 深入分析关键token
    • 有什么特征?
  • 泛化到其他领域和算法
  • 利用可预测性提升RL效率

相关文章 ​

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026