有模型预测和控制
📅 发表于 2025/08/27
🔄 更新于 2025/10/23
👁️ — 次访问
📝 1154 字
⏳ 4 分钟
rl theory
#有模型
#动态规划算法
#价值迭代
#策略迭代
#贝尔曼最优方程
#最优性原理
#价值函数
#最佳价值函数
#最佳策略函数
已知环境信息,状态转移概率和奖励函数,就变成一个状态转移序列决策问题。
但现实情况很难知道环境信息,压根不知道熊到底会做什么,一切都未知,需要免模型算法。
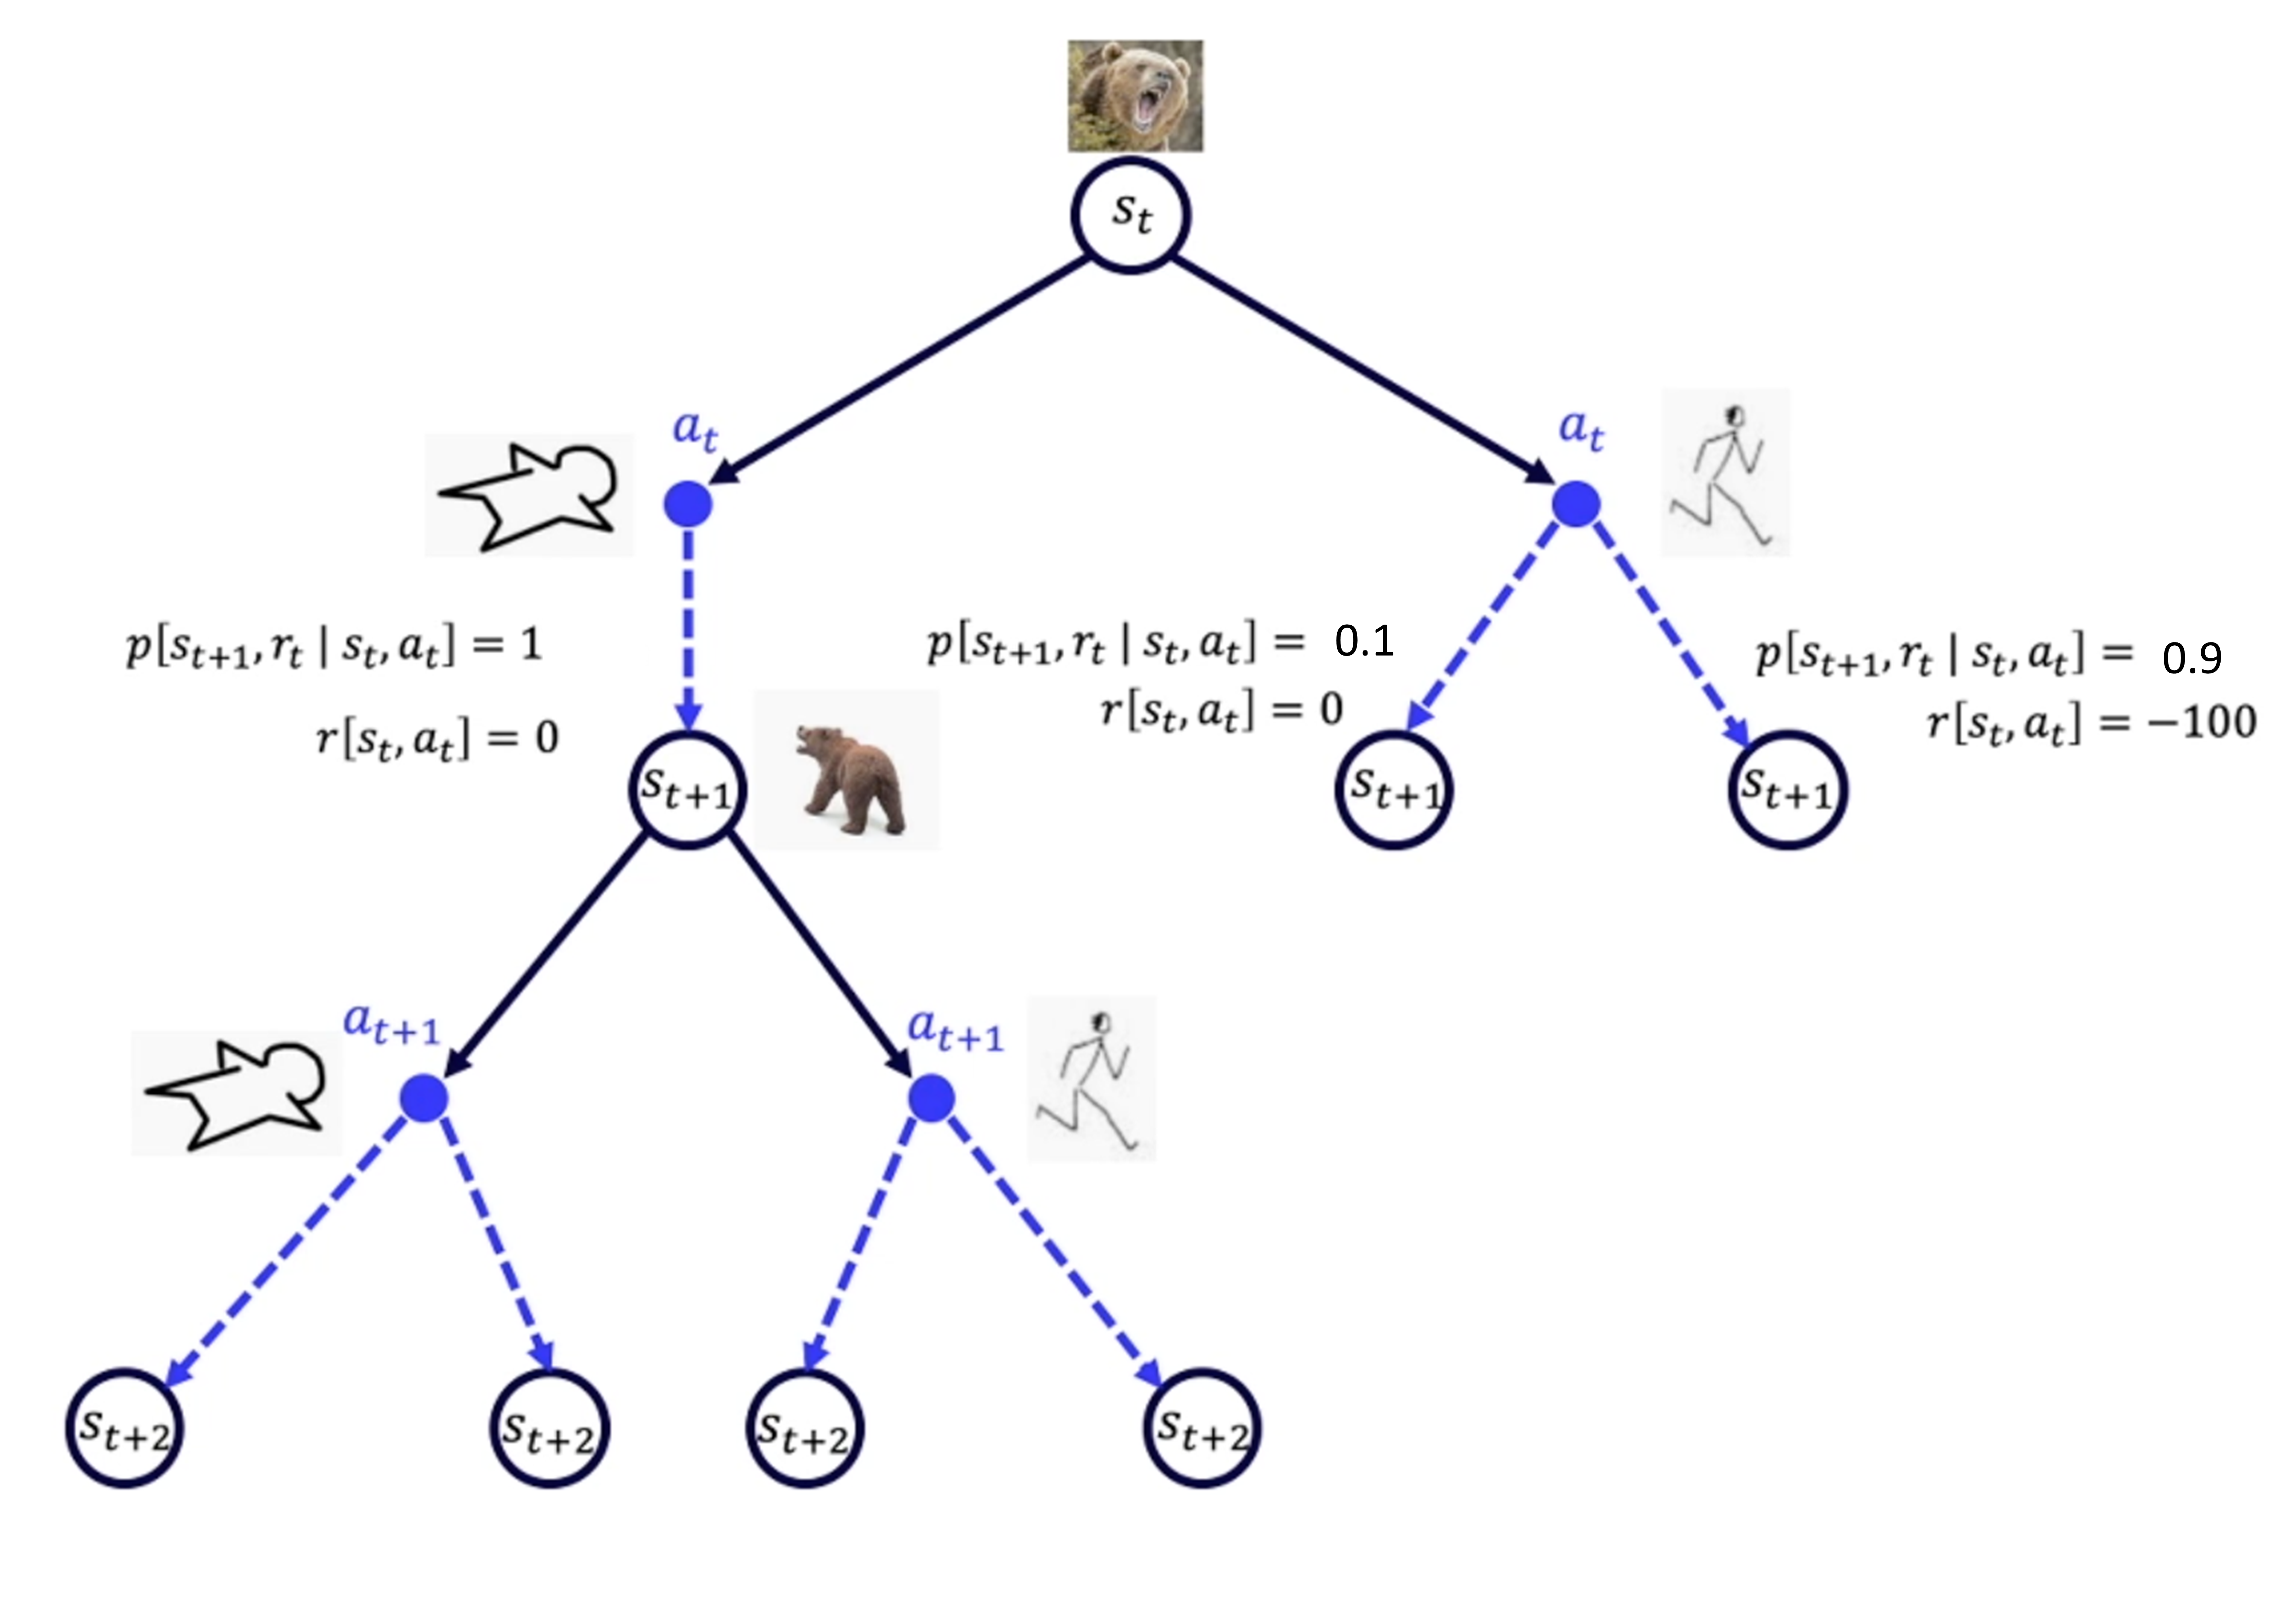
最优子结构/满足最优化原理
问题可拆分为多个子问题,问题最优解 包含的子问题的解也是最优的。第一步执行最优动作,后续每一步都按最优策略去做,最终结果也是最优。当前状态 与未来状态 有迭代关系。重叠子问题
子问题多次出现,其结果能被重复使用,可保存首次计算结果供后续使用存储状态价值 无有效性
不受后面决策的影响,只与 前状态有关,即马尔科夫性质。适用RL场景
核心思想
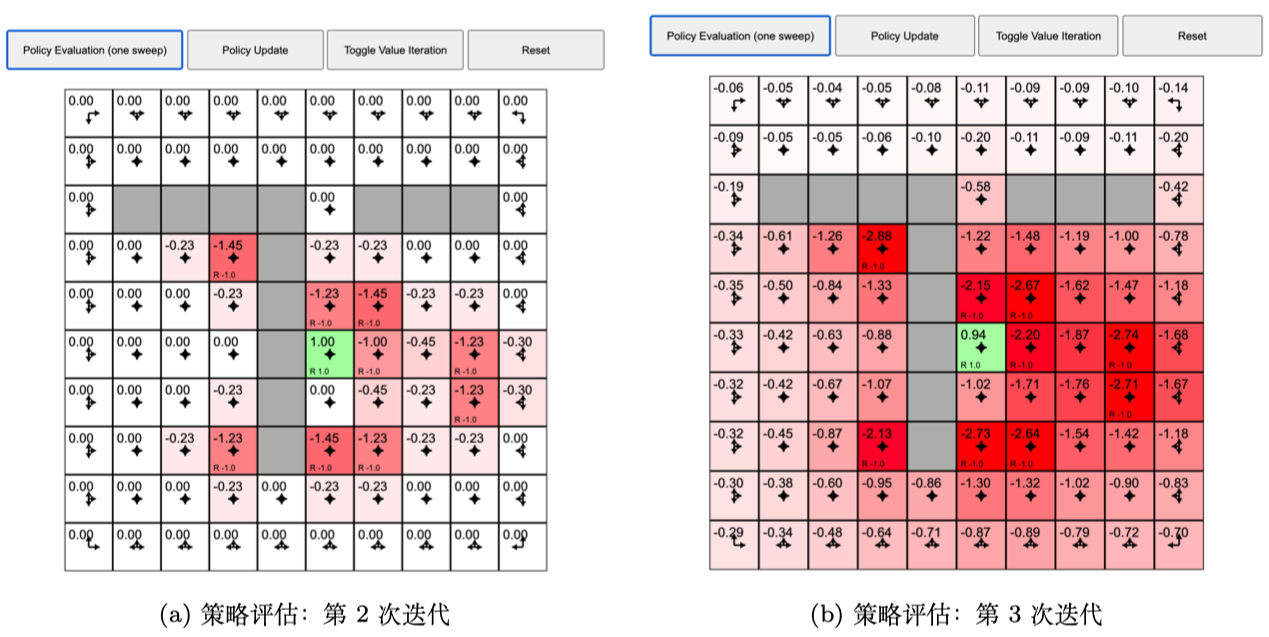
多次迭代 逐渐收敛价值函数通过求解贝尔曼方程,来找到最优策略。迭代过程
求解出每个 当前状态最优价值依赖下一状态最优价值。自举:用一个估计值去更新另一个估计值。即时奖励+下一个状态最优价值,保证当前最优决策建立在后续最优决策基础上。给定策略后,可以把其简化为马尔可夫奖励过程,去掉a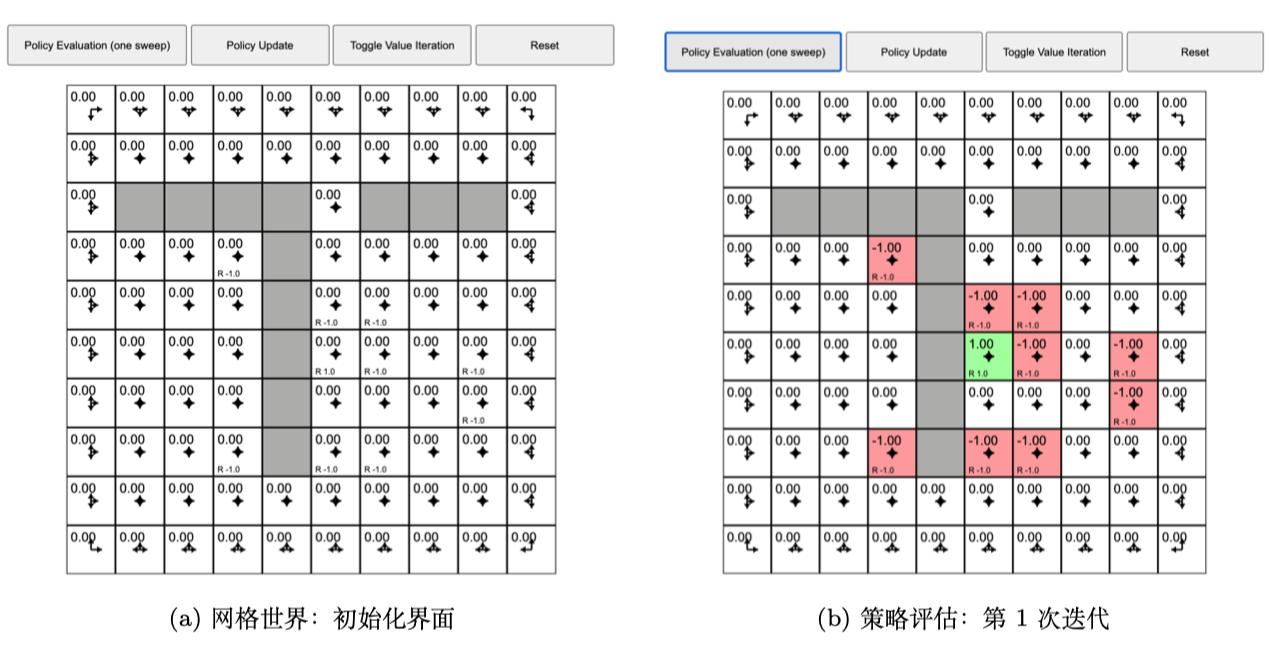
最佳价值函数和最佳策略
搜索一种策略,让每个状态的价值函数 都取得最大值通过最佳价值函数来获取最佳策略
不一定是唯一的,可能多种动作取得相同价值主要方法
核心思想
推算出Q函数对Q函数做贪心搜索,来改进策略评估策略 <--> 改进策略,一直迭代,直到收敛策略评估
策略改进
根据Q函数 贪心改进策略,会变得更好或不变,但不会变差取让Q函数取得最大值的动作,Q函数就变成V函数了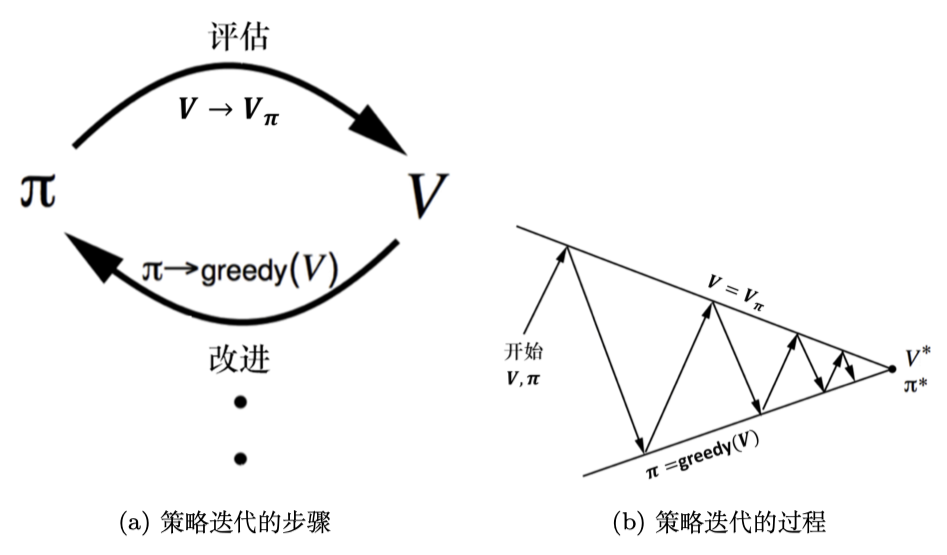
策略改进结束后
最佳策略下的状态价值 必须等于 采取最佳动作 回报的期望。满足贝尔曼最优方程时,整个状态 已收敛达最佳状态Q函数贝尔曼最优方程
V函数贝尔曼最优方程
由动态规划策略评估可知
当前动作最优,未来每一步动作都是最优,那么最终结果就是最优的。最优性原理
达最优价值,意味从都达最优价值核心思想
贝尔曼最优方程来迭代计算当所有子问题达最优时,达到最优直接迭代贝尔曼最优方程,价值函数就能趋向于最佳价值函数,最后取其策略即可关键流程
所有状态初始化:
从k=1迭代到H次,每次迭代如下:
迭代完成后,提取最优策略