Skip to content

(18年笔记)基于策略函数的学习方法

📅 发表于 2018/04/22
🔄 更新于 2025/08/04
👁️ — 次访问
📝 1625 字
⏳ 5 分钟
强化学习
#策略函数
#策略梯度
#REINFORCE
#基准函数
#Actot-Critic
#强化学习算法总结

基于策略函数的学习方法 ​

背景 ​

强化学习目标

基于策略函数的学习方法
  • 无需值函数直接优化策略,参数化的策略处理可以处理连续状态和动作
  • 基于梯度的学习、无梯度的学习

策略梯度 ​

策略梯度概览

1. 核心思想

  • 假设策略πθ(a∣s)是一个关于θ的连续可微函数 (策略连续可微假设)
  • 用梯度上升的方法优化参数θ使目标函数J(θ)最大。 策略梯度是一种基于梯度的RL方法。
J(θ)=∫pθ(τ)⋅G(τ)dτ

2. 总结核心3个推导步骤

  • 代入J(θ)目标函数,算导数
∂J(θ)∂θ≜Eτ∼pθ(τ)[∂∂θlog⁡pθ(τ)⋅G(τ)]
  • 代入策略π和状态转移概率p(st+1|st,aa),细分偏导数
∂∂θlog⁡pθ(τ)=∑t=0T−1∂∂θlog⁡πθ(at∣st)
  • 代入轨迹回报G(τ)做分解,算出策略梯度 ⭐
∂J(θ)∂θ=Eτ∼pθ(τ)[∑t=0T−1(∂∂θlog⁡πθ(at∣st)⋅γtG(τt:T))]
策略梯度详细推导过程

策略梯度推导 (目标函数J(θ)关于策略参数θ的导数推导)

  • 代入J(θ),求导数转换成期望形式
    • 参数θ的优化方向:使总回报越大的轨迹τ概率也越大, G(τ)↑⇒pθ(τ)↑
∂J(θ)∂θ=∂∂θ∫pθ(τ)G(τ)dτ=∫(∂∂θpθ(τ))⋅G(τ)dτ=∫pθ(τ)⋅(1pθ(τ)⋅∂pθ(τ)∂θ)⋅G(τ)dτ⏟梯度写成期望形式,便于蒙特卡罗估计=∫pθ(τ)⋅(∂∂θlog⁡pθ(τ))⏟对数恒等式⋅G(τ)dτ=Eτ∼pθ(τ)[∂∂θlog⁡pθ(τ)⋅G(τ)]导数:f(x)=log⁡(x),f′(x)=1x对数恒等式:∂∂θlog⁡f(θ)=1f(θ)⋅∂f(θ)∂θ
  • 代入策略π和环境状态转移概率p(st+1∣st,at),进一步细分偏导数,梯度只和策略相关

    ∂∂θlog⁡pθ(τ)=∂∂θlog⁡(p(s0)⏟初始状态⋅∏t=0T−1πθ(at∣st)⏟执行动作⋅p(st+1∣st,at)⏟状态改变)=∂∂θ(log⁡p(s0)⏟θ求导为0+∑t=0T−1log⁡πθ(at∣st)+∑t=0T−1log⁡p(st+1∣st,at)⏟θ求导为0)=∑t=0T−1∂∂θlog⁡πθ(at∣st)
  • 代入G(τ)分解回报,算出策略梯度

∂J(θ)∂θ=Eτ∼pθ(τ)[∂∂θlog⁡pθ(τ)⋅G(τ)]=Eτ∼pθ(τ)[∑t=0T−1∂∂θlog⁡πθ(at∣st)⋅G(τ)]=Eτ∼pθ(τ)[∑t=0T−1∂∂θlog⁡πθ(at∣st)⋅(G(τ0:t)⏟r0∼rt−1+γt⋅G(τt:T)⏟rt∼rT)]=Eτ∼pθ(τ)[∑t=0T−1∂∂θlog⁡πθ(at∣st)⋅G(τ0:t)⏟为0,at只影响后面,不贡献梯度+∑t=0T−1∂∂θlog⁡πθ(at∣st)⋅G(τt:T)⏟不为0]=Eτ∼pθ(τ)[∑t=0T−1∂∂θlog⁡πθ(at∣st)⋅γt⋅G(τt:T)]
  • 其中 G(τ)分解为2部分 :0-t的累计回报 和 t到T的累计回报,
    • 注意:时刻t的动作at 只能影响t时刻之后的奖励,不能影响t时刻之前的奖励。
G(τ)=∑t=0T−1γt⋅rt+1=G(τ0:t)+γt⋅G(τt:T)
  • G(τt:T):时刻t作为起始时刻到时刻T,收到的总回报
G(τt:T)=∑k=tT−1γk−t⋅rk+1

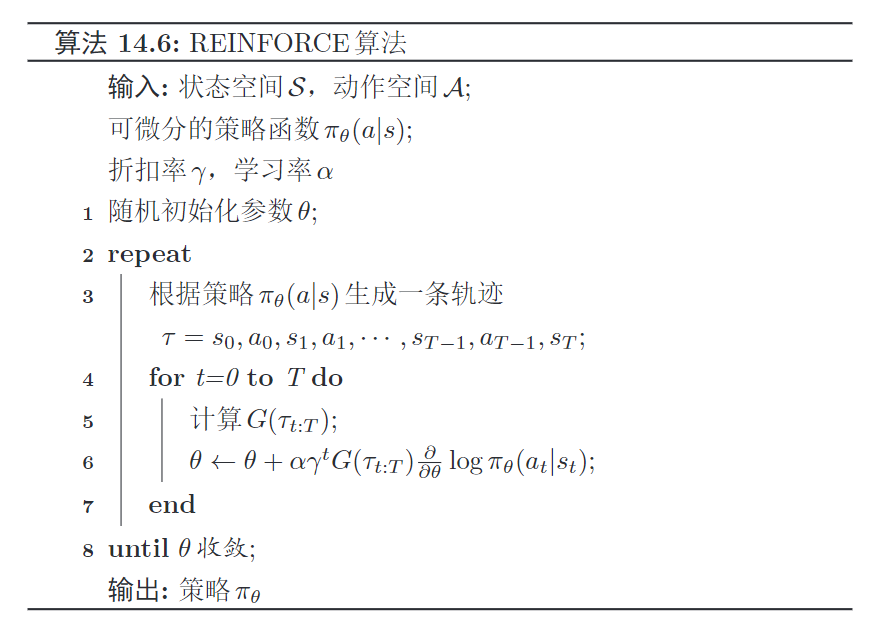
REINFORCE算法 ​

REINFORCE

核心思想

  • 策略梯度中,通过当前策略πθ随机采样N条轨迹来近似期望。τ(1),⋯,τ(N)
∂J(θ)∂θ≈1N∑n=1N(∑t=0T−1∂∂θlog⁡πθ(at(n)|st(n))⋅γtG(τt:T(n))⏟每个时刻的策略梯度)
  • 结合随机梯度上升算法,每次采样1条轨迹,并计算每个时刻的梯度,来更新参数

算法步骤

  • 输入:状态空间S,动作空间A,可微分策略函数πθ(a∣s),折扣率γ,学习率α

  • 初始化:随机初始化参数θ,训练直到收敛

  • 根据πθ(a∣s)采样一条轨迹

τ=s0,a0,s1,a1,⋯,sT−1,aT−1,sT
  • 在每个时刻计算回报G(τt:T)、策略梯度,并更新策略函数参数 (0~T)
θ←θ+α⋅∂∂θlog⁡πθ(at|st)⋅γTG(τt:T)⏟每个时刻的策略梯度

缺点

  • 不同路径的方差很大,导致训练不稳定;
  • 需要根据一个策略采集一条完整的轨迹。

带基准线的REINFORCE算法 ​

带基准线的REINFORCE 算法思想

背景

  • REINFORCE缺点:不同轨迹样本G(τ)方差很大,导致训练不稳定

核心思想

  • 使用基准函数b(st)去减小策略梯度的方差,基准函数和at无关

    • 准确是减少G(τ)带来的方差。
  • 每个时刻的策略梯度:引入基准函数之前

∂Jt(θ)∂θ=Est,at[∂∂θlog⁡π(at∣st)⋅γtG(τt:T)]=Est,at[∇θlog⁡π(at∣st)⋅γtG(τt:T)]
  • 每个时刻的策略梯度:引入基准函数之后
∂J^t(θ)∂θ=Est,at[∂∂θlog⁡π(at∣st)⋅γt(G(τt:T)−b(st))⏟基准函数,减小G方差]
  • 由于 b(st)和at无关 ,通过推导可知新旧策略梯度一致,保证了无偏性
∂J^(θ)∂θ=∂J(θ)∂θ
  • 由下文降低方差的方法推导可知:b(st)和G(τt:T) 越相关,方差越小,就越好

基准函数的选择

  • 很自然可以选择值函数作为基准函数 :b(st)=Vπθ(st)。

  • 但由于值函数未知,可用学习参数Vϕ(st)来近似值函数

  • 用参数估计,目标函数如下,和Q网络参数逼近很像。

    L(ϕ∣st,πθ)=(Vπθ(st)−Vϕ(st))2
  • 用蒙特卡罗来估计Vπθ(st)

  • 最终策略函数参数θ的梯度如下

∂J^t(θ)∂θ=Est,at[∂∂θlog⁡π(at∣st)⋅γt(G(τt:T)−Vϕ(st))⏟基准函数,减小G方差]
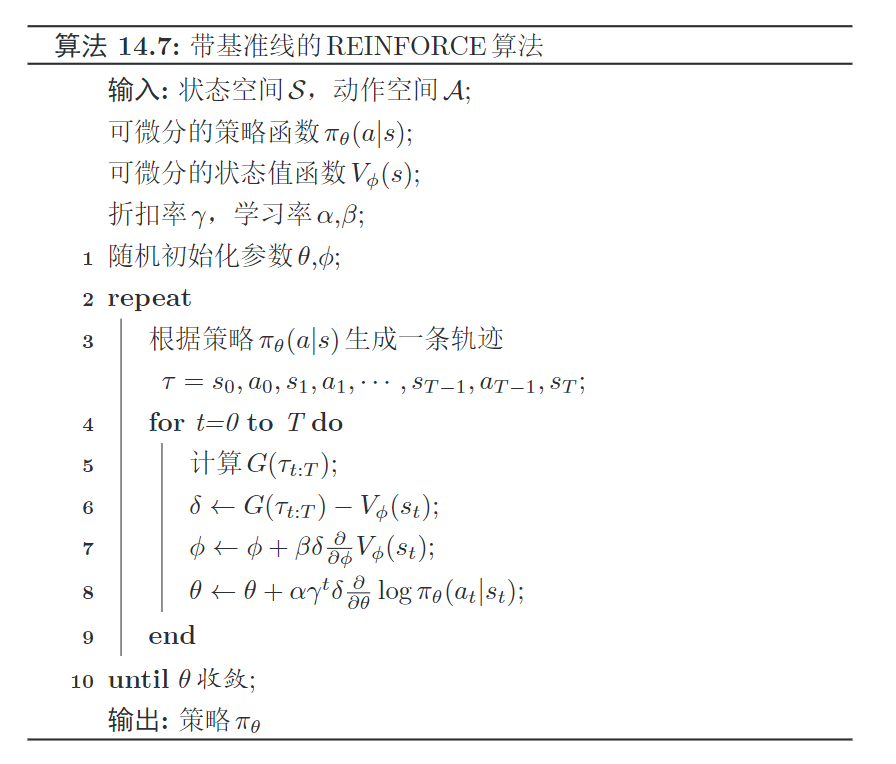
带基准线REINFORCE算法步骤

算法步骤

  • 输入:状态空间S,动作空间A,可微分策略函数πθ(a∣s),可微分状态值函数Vϕ(s),折扣率γ,学习率α
  • 初始化:随机初始化参数θ、ϕ,训练直到策略收敛,输出πθ
  • 根据策略πθ(a|s)生成1条轨迹,
τ=s0,a0,s1,a1,⋯,sT−1,aT−1,sT
  • 每个时刻循环计算,先计算G(τt:T),再依次更新值函数和策略函数参数
δ←G(τt:T)−Vϕ(st)ϕ←ϕ+β⋅δ⋅∂∂ϕVϕ(st)θ←θ+α⋅γtδ⋅∂∂θlog⁡π(at|st)
降低方差方法的公式推导

目的

  • 估计E[f],构造新估计量f^,使得
    • 无偏性:E[f]=E[f^],
    • 减小方差:Var(f^)<Var(f)

核心方法

  • 构建f^:引入一个与f相关的辅助函数g,E[g]已知。
f^=f−α(g−E[g])
  • 保证无偏性推导期望:推导可知E[f^]=E[f]
E[f^]=E[f]−α⋅E(g−E[g])=E[f]−α⋅(E[g]−E[g])=E[f]Var(f^)=Var(f−α(g−E[g]))=Var(f−α⋅g)=Var(f)+α2Var(g)−2α⋅Cov(f,g)
  • 最小方差求解:求解极值点 α取值
    • 方差恒为正,是常数;根据上式可知Var(f^)是关于α的凹函数,必然存在极小值
    • 求导数并使其为0,求解出最小值时的取值。
∂Var(f^)∂α=2αVar(g)−2Cov(f,g)令其=0,得:α=Cov(f,g)Var(g)
  • 最小方差求解:代回极值点,求解出最小值
Var(f^)=Var(f)+Cov2(f,g)Var(g)−2Cov2(f,g)Var(g)=Var(f)−Cov2(f,g)Var(g)=Var(f)(1−Cov2(f,g)Var(f)Var(g))=Var(f)⋅(1−ρ2(f,g))⏟相关系数)
  • 极小值:f和g的相关性越高,Var(f^)越小

Actor-Critic算法 ​

Actor-Critic 算法

背景

  • REINFORCE算法 方差大、学习效率较低,G(τt:T) 计算慢
    • 每次根据一个策略采样一条完整轨迹,并计算这条轨迹上的回报
  • 借TD动态规划思想,提高采样效率,状态s的总回报由即时奖励和下个状态的值函数来估计。

核心思想

  • 迭代计算t作为初始时刻的轨迹总回报 G(τt:T)
G^(τt:T)=rt+1+γVϕ(st+1)
  • 初始,演员随机表演、评论员随机打分;通过每步各自不断学习更新,评分越来越准、表演越来越好。
    • 演员,策略函数πθ(s,a):学习策略获得高回报
    • 评论员,值函数Vϕ(s),评估当前策略好坏
  • Vϕ(s)值函数目标函数,调整打分标准
L(ϕ)=minϕ(G^(τt:T)−Vϕ(s))2=minϕ(rt+1+γVϕ(st+1)⏟动态规划,实际值−Vϕ(st)⏟预测值)2
  • πθ(s,a)策略函数策略梯度, 调整策略;值函数作为基线函数,降低方差,
∂J^t(θ)∂θ=Est,at[∂∂θlog⁡π(at∣st)⋅γt(G^(τt:T)−Vϕ(st))⏟基准函数,减小G方差]
  • 值函数3个功能
    • 估计轨迹真实回报(打分)
    • 更新值函数参数ϕ (调整打分标准)
    • 作为基函数来减少策略梯度的方差(调整策略)

优点

  • 可以单步更新参数,不需要等到回合结束才进行更新
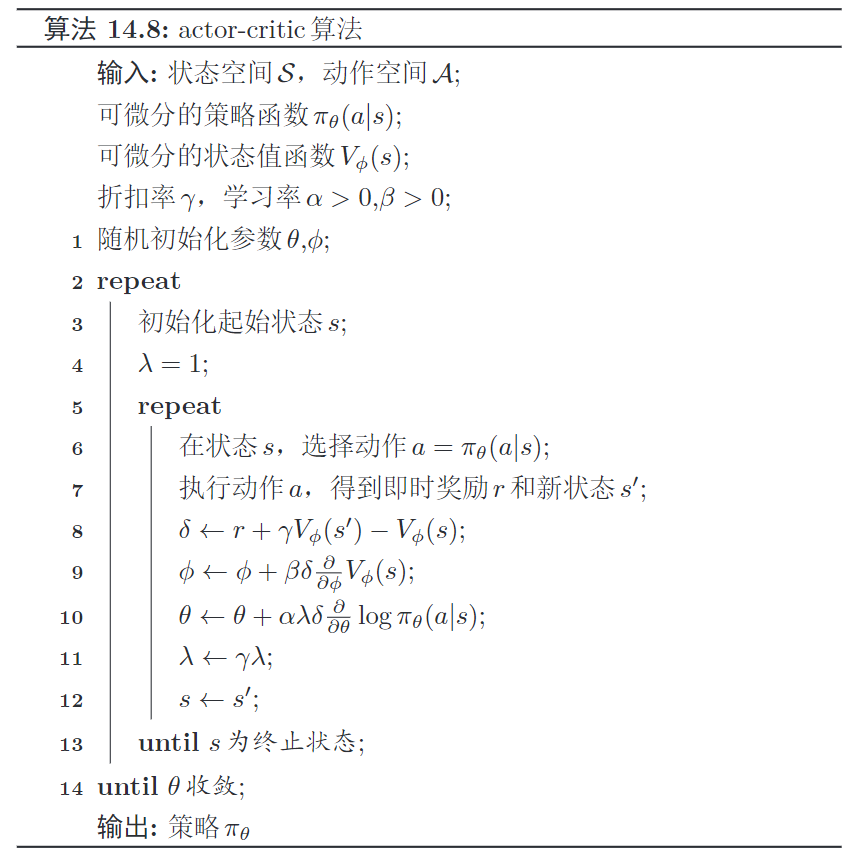
Actor-Critic 算法步骤

算法步骤

  • 输入:状态空间S,动作空间A,可微分策略函数πθ(a∣s),可微分状态值函数Vϕ(s),折扣率γ,学习率α、β
  • 初始化:随机初始化参数θ、ϕ,训练直到策略收敛,输出πθ
  • 初始化起始状态s,每个步骤做采样更新,直到s为终止态
  • 执行动作 a=πθ(a|s),获得奖励 r(s,a,s′)和新状态s′
  • 动态规划估计轨迹回报,计算基准差值 δ,更新值函数参数、更新策略函数参数
预估轨迹回报G(τt:T)←r+γVϕ(s′)基准函数差值δ←G(τt:T)−Vϕ(s)=r+γVϕ(s′)−Vϕ(s)值函数参数ϕ←ϕ+β⋅δ⋅∂∂ϕVϕ(st)策略函数参数θ←θ+α⋅γtδ⋅∂∂θlog⁡π(at|st)

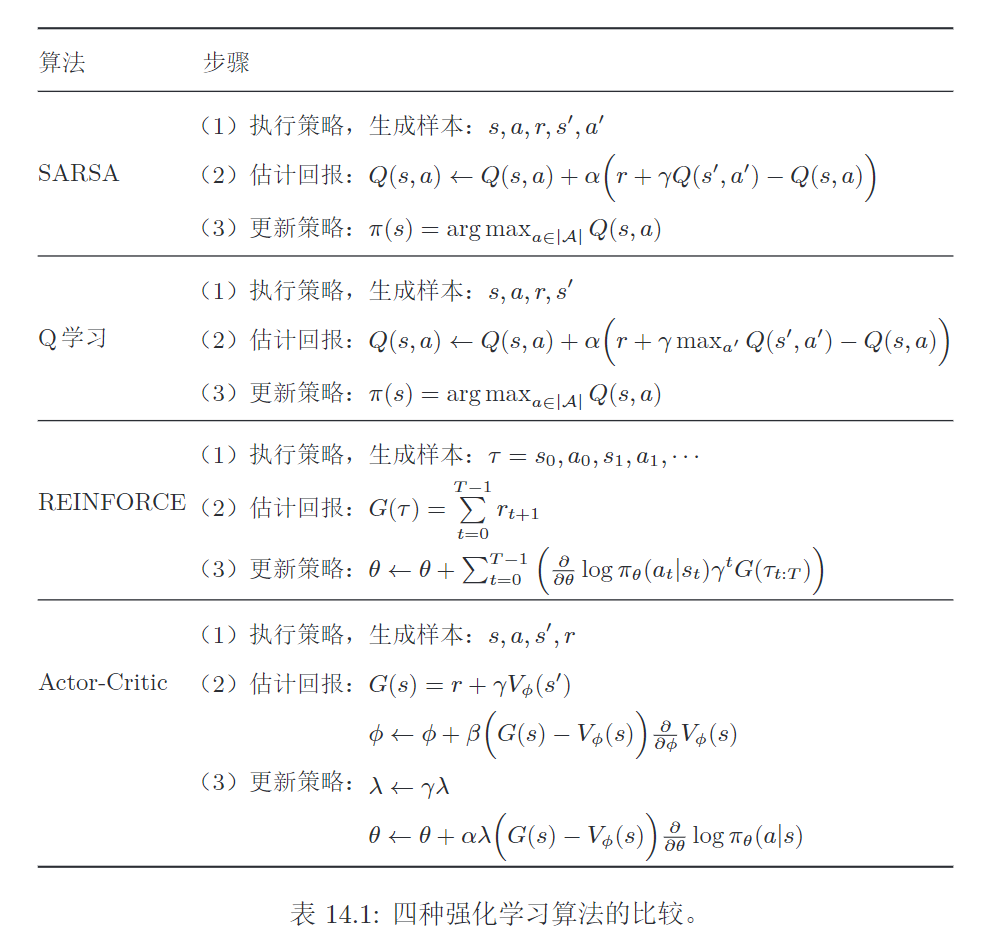
强化学习算法总结 ​

方法总览 ​

1. 通用步骤

  1. 执行策略,生成样本
  2. 估计回报
  3. 更新策略

2. 值函数与策略函数的比较

值函数的方法

策略更新,导致值函数的改变比较大,对收敛性有一定的影响

策略函数的方法

策略更新,更加平稳。

缺点:策略函数的解空间很大,难以进行充分采样,导致方差较大,容易陷入局部最优解。
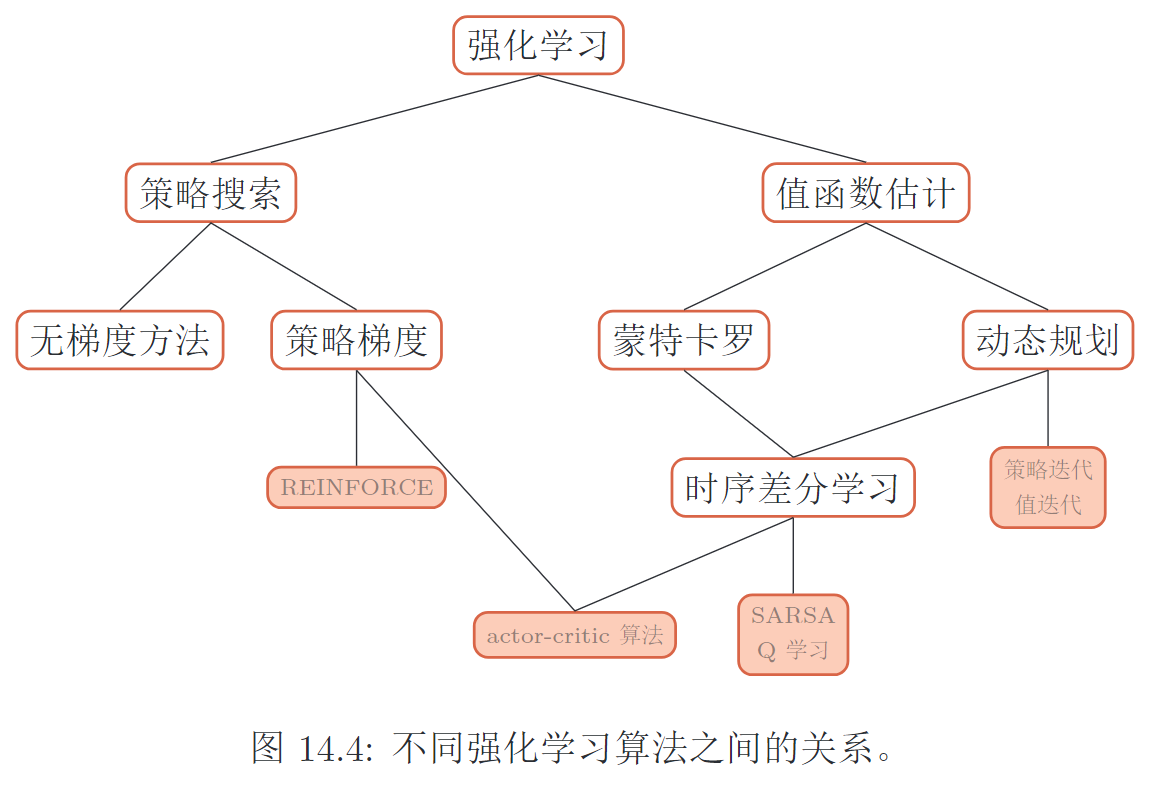
四个典型方法 ​

与监督学习的区别 ​

强化学习监督学习
样本与环境进行交互产生样本,进行试错学习人工收集并标注
反馈只有奖励,并且是延迟的需要明确的指导信息(每个状态对应一个动作)
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026