Skip to content

GRPO 改进系列

📅 发表于 2025/11/03
🔄 更新于 2026/08/05
👁️ — 次访问
📝 8580 字
⏳ 28 分钟
grpo
#GPPO
#悲观更新
#GRPO
#DAPO
#熵坍塌
#Clip机制不公平
#探索
#奖励噪声
#训练不稳定
#Clip-Higher
#动态采样
#Token-Level Loss
#Overlong 奖励设计
#GSPO
#Token-Level 重要性权重
#Seq-Level 重要性权重
#MoE Routing RePlay
#CISPO
#重要性权重 Clip
#Dr.GRPO
(2601) GDPO(Nvidia) ​

🌺 论文摘要

论文摘要

参考链接

核心方法

模型效果

重要结论

关键贡献

(2512) Scaling GRPO (DeepSeek-V3.2) ​

重要

参考链接

Scaling GRPO 算法 ​

IS权重优化KL3估计 ​

用IS权重优化KL3估计

问题:当πθ≪πref时

  • 当前策略概率低,但参考策略概率高,认为生成了不该生成的内容。
  • K3估计器的梯度,会给这些token 分配极大无边界的权重
  • 导致梯度瞬间爆炸,引入噪声训练不稳定

无偏KL估计

  • 核心:重要性采样比例 * 原始K3估计。

  • 乘以 rt(θ),无论采样如何,梯度期望值都是准确的,消除了系统误差,梯度变无偏估计。

DKLt(πθ,πθref)=πθ(oi,t∣q,oi,<t)πold(oi,t∣q,oi,<t)⋅(πref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−logπref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−1)

KL 实践参数设定

  • 不同领域任务,所需的KL不一样。

    • 通用对话/文案任务:需较强KL,保持语言流畅风格一致性。

    • 数学/逻辑推理:就几乎无需KL。

Mask 异策略负样本 ​

Off-Policy Sequence Mask

异策略负样本可能有害

  • 直观上,模型从自己的错误中学习是有效果的,但高度异策略的负样本,很可能是有害的。
  • 训推不一致:推理框架高度优化,和训练框架可能不一致,加剧了异策略程度。
    • Off-Policy:把1次rollout样本分多个mini-batches,做多次梯度更新
    • 更新第2次以后:采样策略和更新策略 不一致。
  • KL散度和IS权重的区别

Mask 异策略负样本

  • Mask不好的序列,不学它,差序列定义如下:

    • 结果不好:A^i,t<0,优势为负
    • 偏差大:DKL(πold∣∣πθ)>δ,KL差异大,rollout模型和当前模型 差异大
  • 系数计算公式

    • 序列级KL散度:序列内所有token的KL值做平均,作为序列级KL散度,设定最大阈值δ
    • Token级系数 Mi,t,优势为负且KL差异较大时,设为0
    Mi,t={0,A^i,t<0,1|oi|∑t=1|oi|logπold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)>δ1,otherwise
  • 目标

    JGRPO(θ)=Eq,{oi}i=1G∼πold1G∑i=1G1|oi|∑t=1|oi|[min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵ,1+ϵ)⋅A^i,t)⋅Mi,t−βDKL(πθ(oi,t)∣∣πref(oi,t))]

保留Routing和采样Mask 消除训推不一致 ​

保持MoE Routing 和 Sampling Mask

核心:消除训练和推理时的不一致

  • Keep Routing:消除模型结构动态性带来的不一致。
  • Keep Sampling Mask:消除概率空间截断带来的不一致。

保持MoE路由

  • 问题:
    • 采样时:Router选择专家A和B;训练时:Router却选择专家B和C。
    • 专家A做贡献没被更新,专家C没做事情却被更新,导致参数更新方向很随机,导致训练崩溃
  • 方法:Routing Replay。
    • 推理时,记录每个token选择的专家;训练时不计算路由,强制使用推理时的专家。
    • GSPO 序列级IS权重:无token级IS,评估整个句子,无需Routing Replay,对底层专家不敏感,

保持采样Mask

  • 问题:
    • 推理时,通常使用top-p, top-k来提高回复质量,低概率token概率为0,相当于词表截断。
    • 训练时,计算IS权重,则πθ和πold动作空间/定义域 不一样,导致计算失效。
  • 方法
    • 保留采样Mask,在训练时应用到πθ,该部分概率为0。保证πθ和πold词表一致。

(2508) GPPO (快手) ​

GPPO 算法 ​

Gradient-Preserving Clipping Policy Optimization

GPPO

背景

一句话总结

  • 在CISPO基础上,把原4个clip情况 变成2个,其余都正常更新,不做clip,减少clip。

悲观更新

  • 我设定一个条件,当我觉得安全时,才让你正常全额更新。
  • 只要你太激进(过度乐观、过度悲观),我就把你限制住。

核心思想

  • 当IS比例 δ=rt(θ)超出截断范围,不切断梯度,而是利用 δsg(δ) 温和地回传梯度。
    • 前向时,分子分母相同 值为1;

    • 反向时,分母为常数,分子为变量,梯度可以正常回传。

    • sg(δ):停止梯度,计算数值时,该值等于输入值。

单token loss,设置三种条件

  • 过度悲观:优势为负且比率过低,A^(j)<0 且 δ<1−ϵl

    lt(j)=β1⋅1−ϵlsg(δ)⋅δ⋅A^(j)
  • 过度乐观:优势为正且比率过高,A^(j)>0 且 δ>1+ϵh

    lt(j)=β2⋅1+ϵhsg(δ)⋅δ⋅A^(j)
  • 信任区域内:正常更新

    lt(j)=δ⋅A^(j)

核心公式

  • 目标函数如下,其中δ=rtj(θ),是IS权重比例。

    LGPPO(θ)=Ex∼D[1∑j=1MTj∑j=1M∑t=1Tjmin(rt(j)A^(j),clip(rt(j),1−ϵlsg(δ)δ,1+ϵhsg(δ)δ)⋅A^(j))]
  • 梯度

    ∇θLGPPO(θ)=Ex∼D[1∑j=1MTj∑j=1M∑t=1TjFj,t(θ)⋅ϕθ(aj,t,sj,t)⋅A^(j)]Fj,t(θ)={1−ϵl,δ<1−ϵlandA^(j)<01+ϵh,δ>1+ϵhandA^(j)>0δ,其他情况, 如: δA^(j)≤clip(δ,1−ϵl,1+ϵh)⋅A^(j)

Reward 设置

  • 数学:1、-1,无思考的话,也要进行惩罚。
  • 代码:soft reward,按测试用例比例计算得分。

GPPO vs CISPO ​

GPPO vs CISPO

核心区别在clip条件上

  • GPPO:有条件的clip,2种条件、1个正常更新,原4个clip情况 变2个情况,其余正常更新。
  • CISPO:完全clip、外乘logprob 保留token梯度。

三种场景核心差别

  • 坏动作、概率变高,A<0,rt(θ)>1
    • GPPO:无限制,使用δ强力惩罚
    • CISPO:仅clip到 1+ϵh
  • 好动作、概率变高,A>0,rt(θ)>1
    • GPPO:条件clip到1+ϵh
    • CISPO:clip到1+ϵh
  • 好动作、概率变低,A>0,rt(θ)<1
    • GPPO:无限制,使用δ恢复
    • CISPO:clip到 1−ϵl

Case

  • 模型犯错了,优势为负(A=-10),IS比例却很大(r=100)
  • CISPO:
    • r=clip(δ,1−ϵl,1+ϵh)=clip(100,0.9,1.1)=1.1
    • 梯度1.1 * (-10)=-11
  • GPPO
    • 不符合条件1和2,符合条件3
    • 正常更新,梯度 100*(-10)=-1000

​

(2508) LitePPO (淘天) ​

摘要

参考链接

核心内容

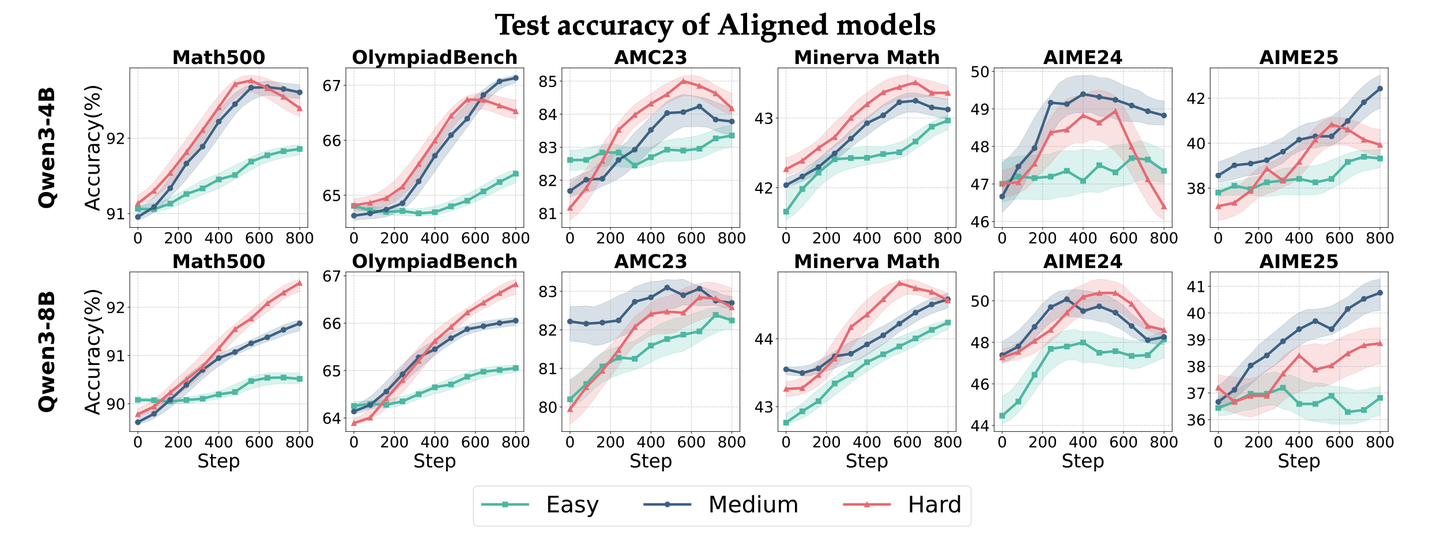
  • 最核心:针对常见RL技巧做总结,并对比实验验证真实有效和适用性。
    • 任务分难度、模型分Base和Instruct等。
    • 验证了 Clip-Higher、优势归一化、Loss聚合策略、超长过滤。
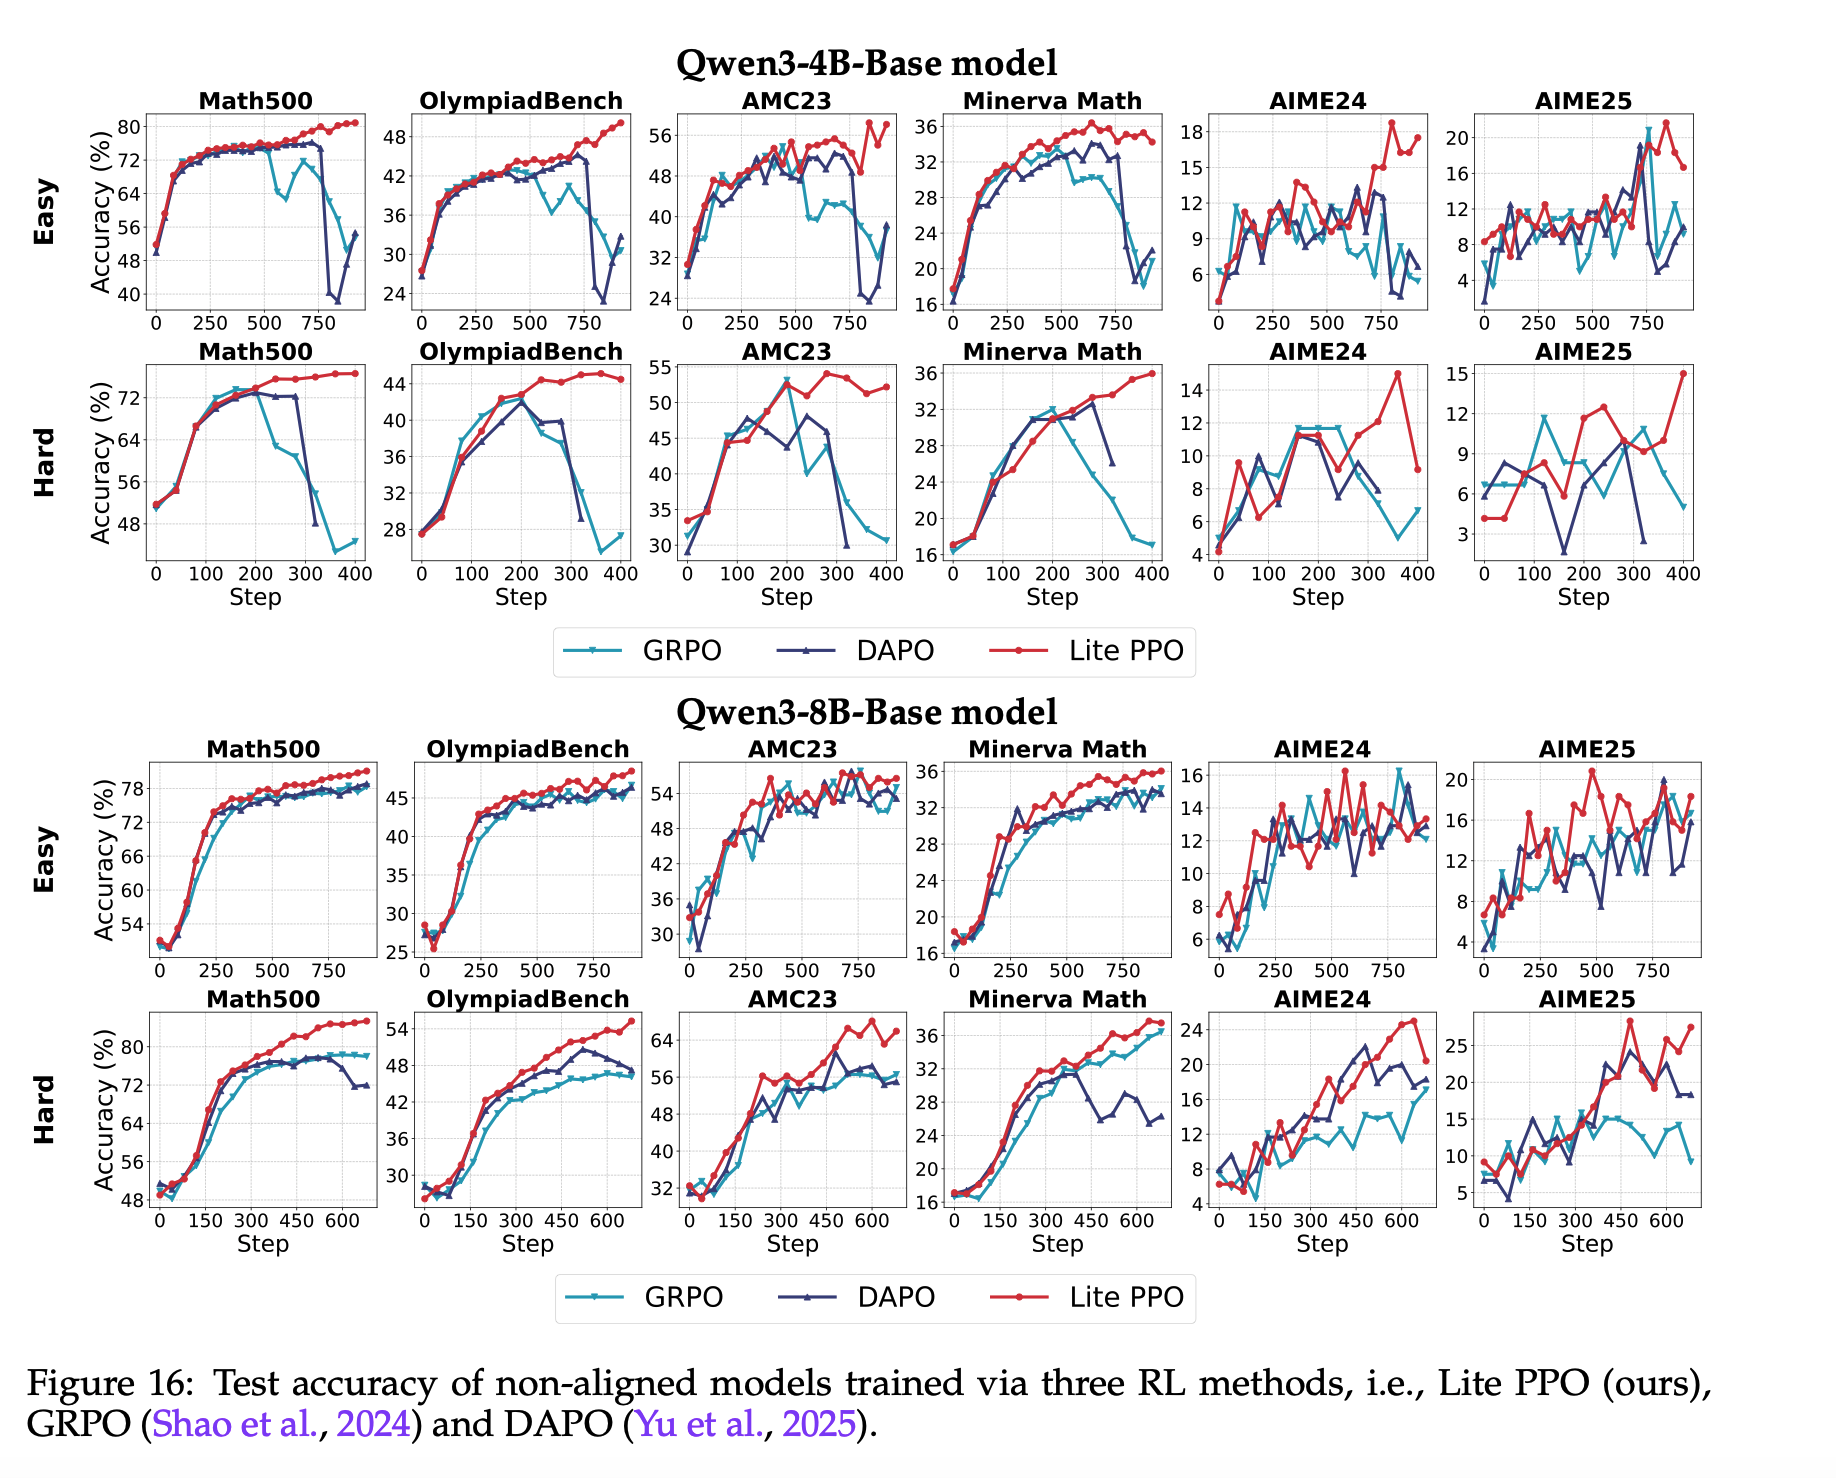
  • 最后提出LitePPO:
    • LitePPO:Group Mean + Batch Std + TokenLevelLoss,加PPO Loss。
    • 在Base小模型上,超过GRPO、DAPO。

问题背景: RL技巧各执一词有矛盾 ​

❓问题背景

RL技巧各执一词充满矛盾

目前RL技巧太多,各说各的好,缺乏统一应用指南和深入研究

  • 关于归一化

  • 关于组优势时除以标准差

    • GRPO:要除以标准差

      A^i,t=A^i=ri−mean(r)std(r)
    • Dr.GRPO:不除以标准差

      A^i,t=A^i=ri−mean(r)
  • 关于Loss聚合

    • DAPO:Token-Level Loss

      LDAPO(θ)=−1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)
    • GSPO:Response-Level Loss

      JGSPO(θ)=Ex∈D,{yi}i=1G∼πθold[1G∑i=1Gmin(si(θ)⋅A^i,clip(si(θ),1−ϵ,1+ϵ)⋅A^i)]

可能的原因

  • 实验环境、训练数据、初始模型、评测准则等等都不一样。

RL 技巧及研究实验 ​

0. 实验设置和实验总结 ​

实验配置

模型

  • Qwen3-4B Qwen3-8B 对齐及Base版本 Qwen3-4B-Base, Qwen3-8B-Base

任务

  • 训练数据:SimpleRL-Zoo-Data, DeepMath
    • 移除了答案仅为“是/否”的样本,避免噪声
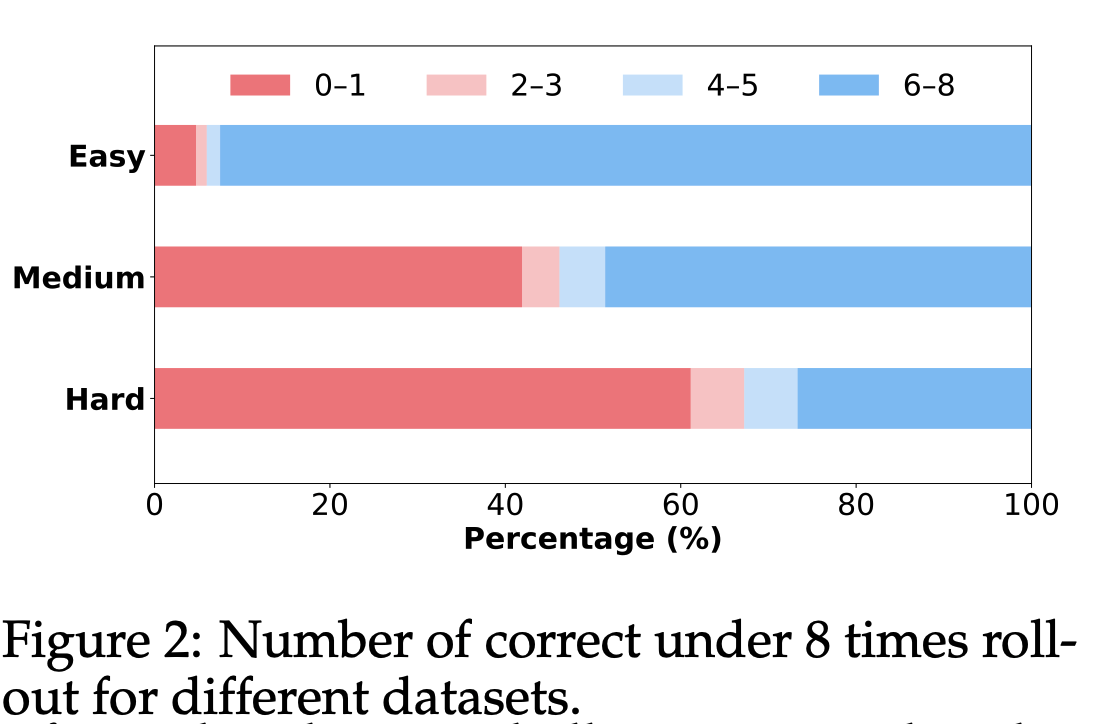
    • 难度分级:
      • 简单:5k,从SimpleRL-Zoo-Data-Easy随机筛选。
      • 中等:5k,从DeepMath-103k选择最简单的。
      • 困难:5k,从DeepMath-103k按难度抽样。
    • 按照不同难度的训练数据去进行实验
  • 评测数据
    • Math500, OlympiadBench, MinervaMath, 部分 AIME24, AIME25, AMC

算法

  • loss:PPO loss
  • 优势:REINFORCE?

框架

  • ROLL,而非Verl

超参

  • 全局:bs=1024,
  • Rollout:bs=128, rollout.n=8
  • 回复长度:8k
  • lr: 1e-6
  • temperature: 0.99, top_p=0.99, top_k=100

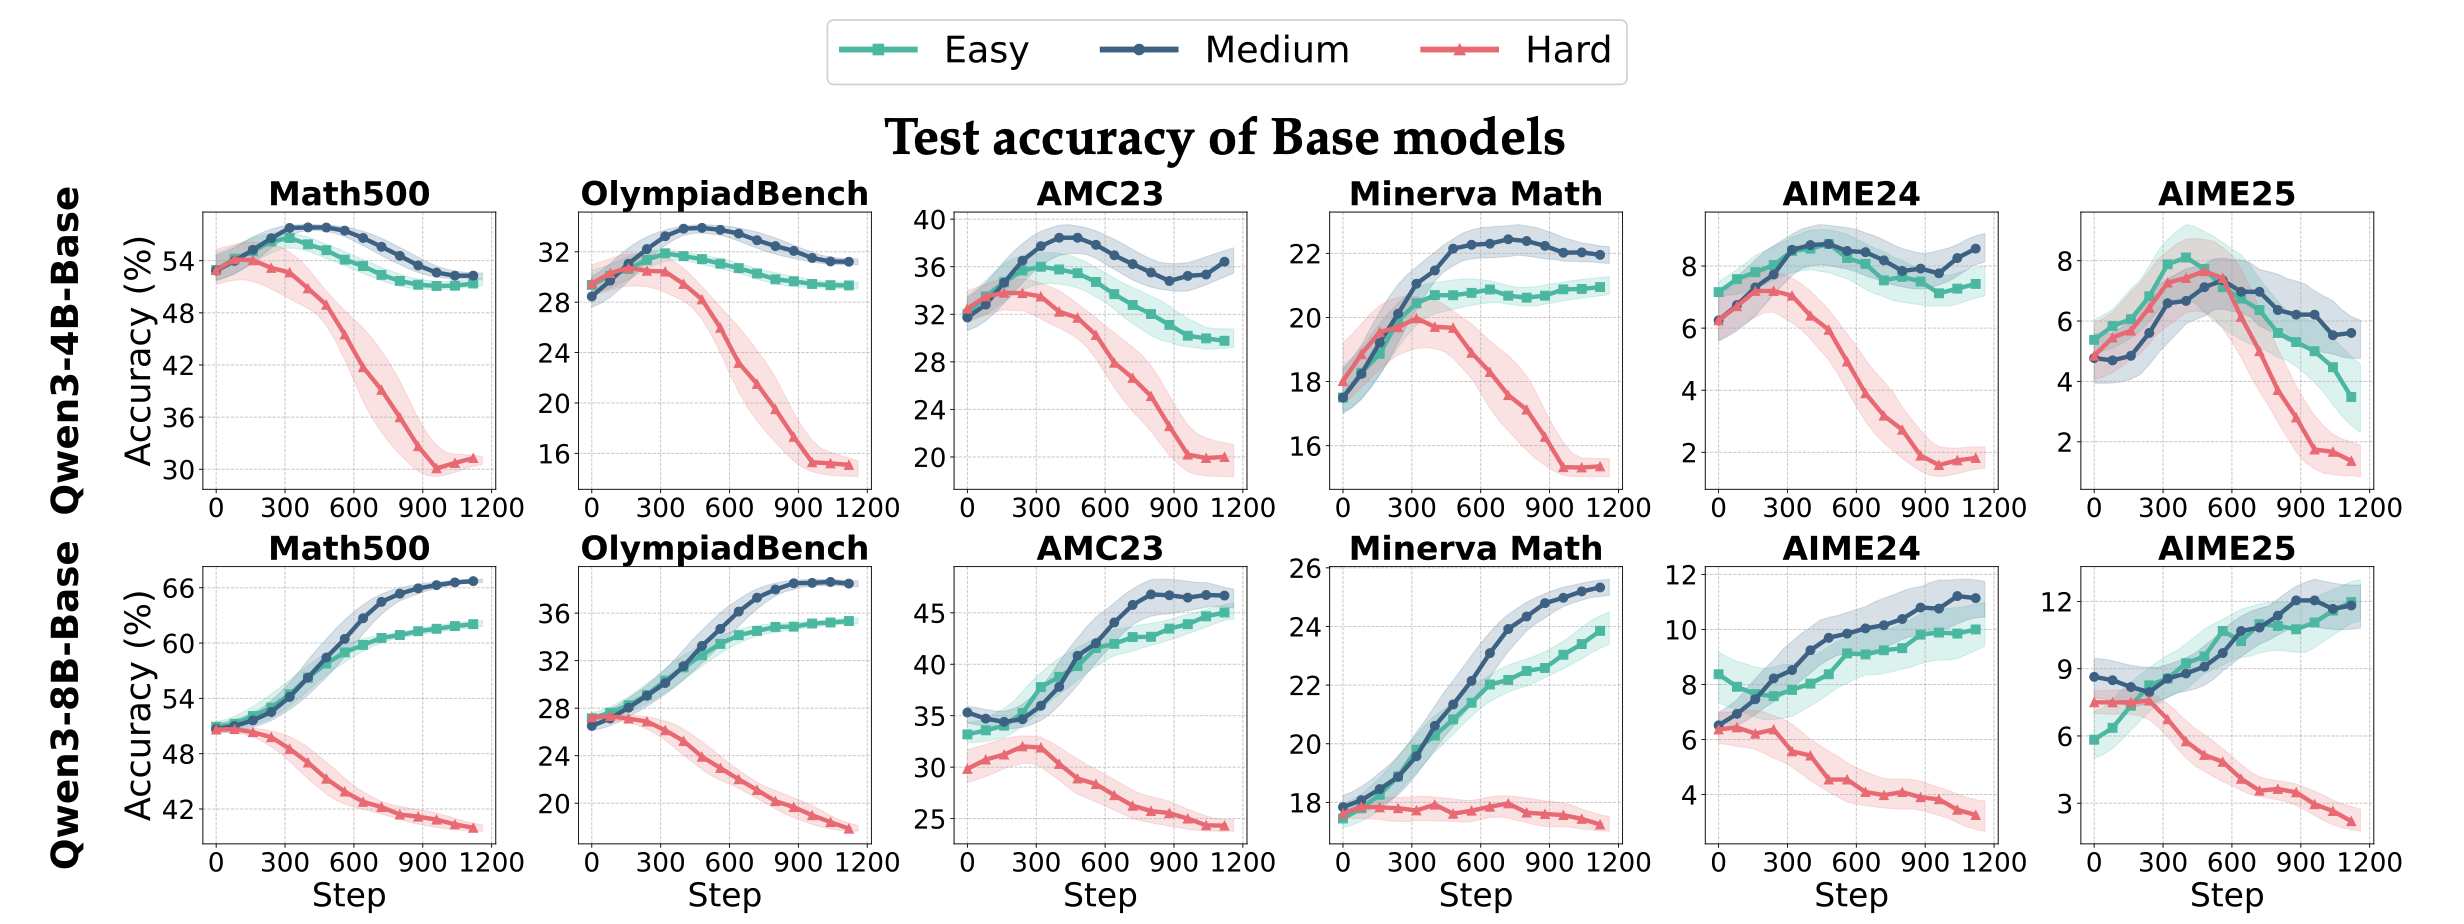
不同难度数据

实验总结

任务难度

  • 任务难度影响
    • 随着epoch增加,准确率曲线也不同
  • 基础模型影响
    • RL对Base模型提升较大;但对已经高度优化过的模型,提升小一些,仅2%。

RL 技巧

  • Group归一化 适应各种奖励,Batch归一化在奖励范围较大时,有点作用。
  • Group Mean + Batch Std 效果稳健。
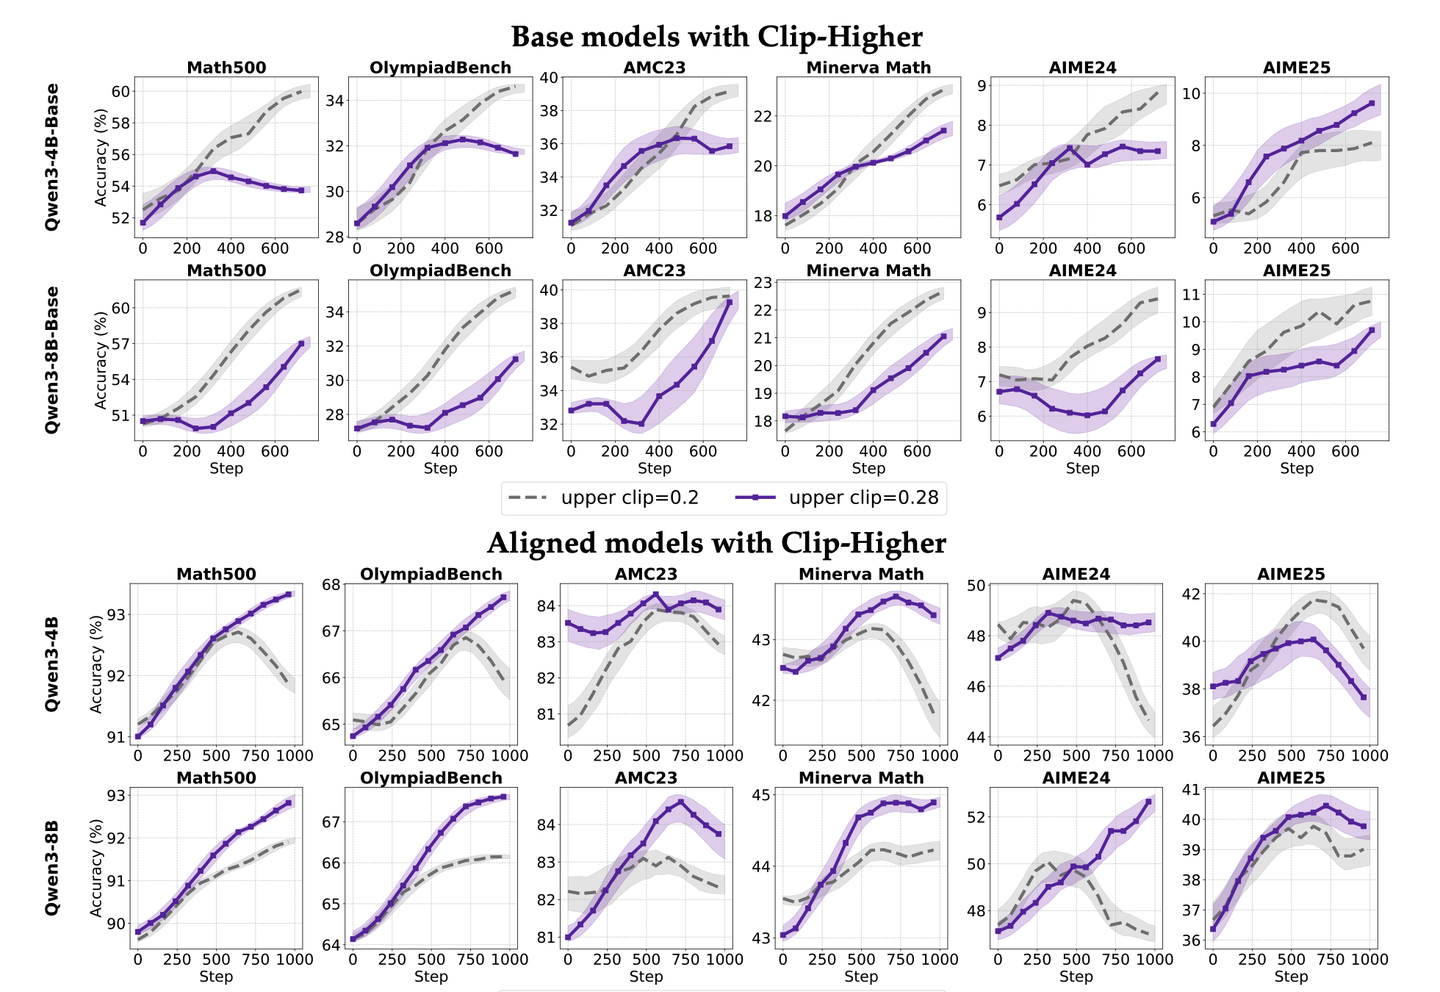
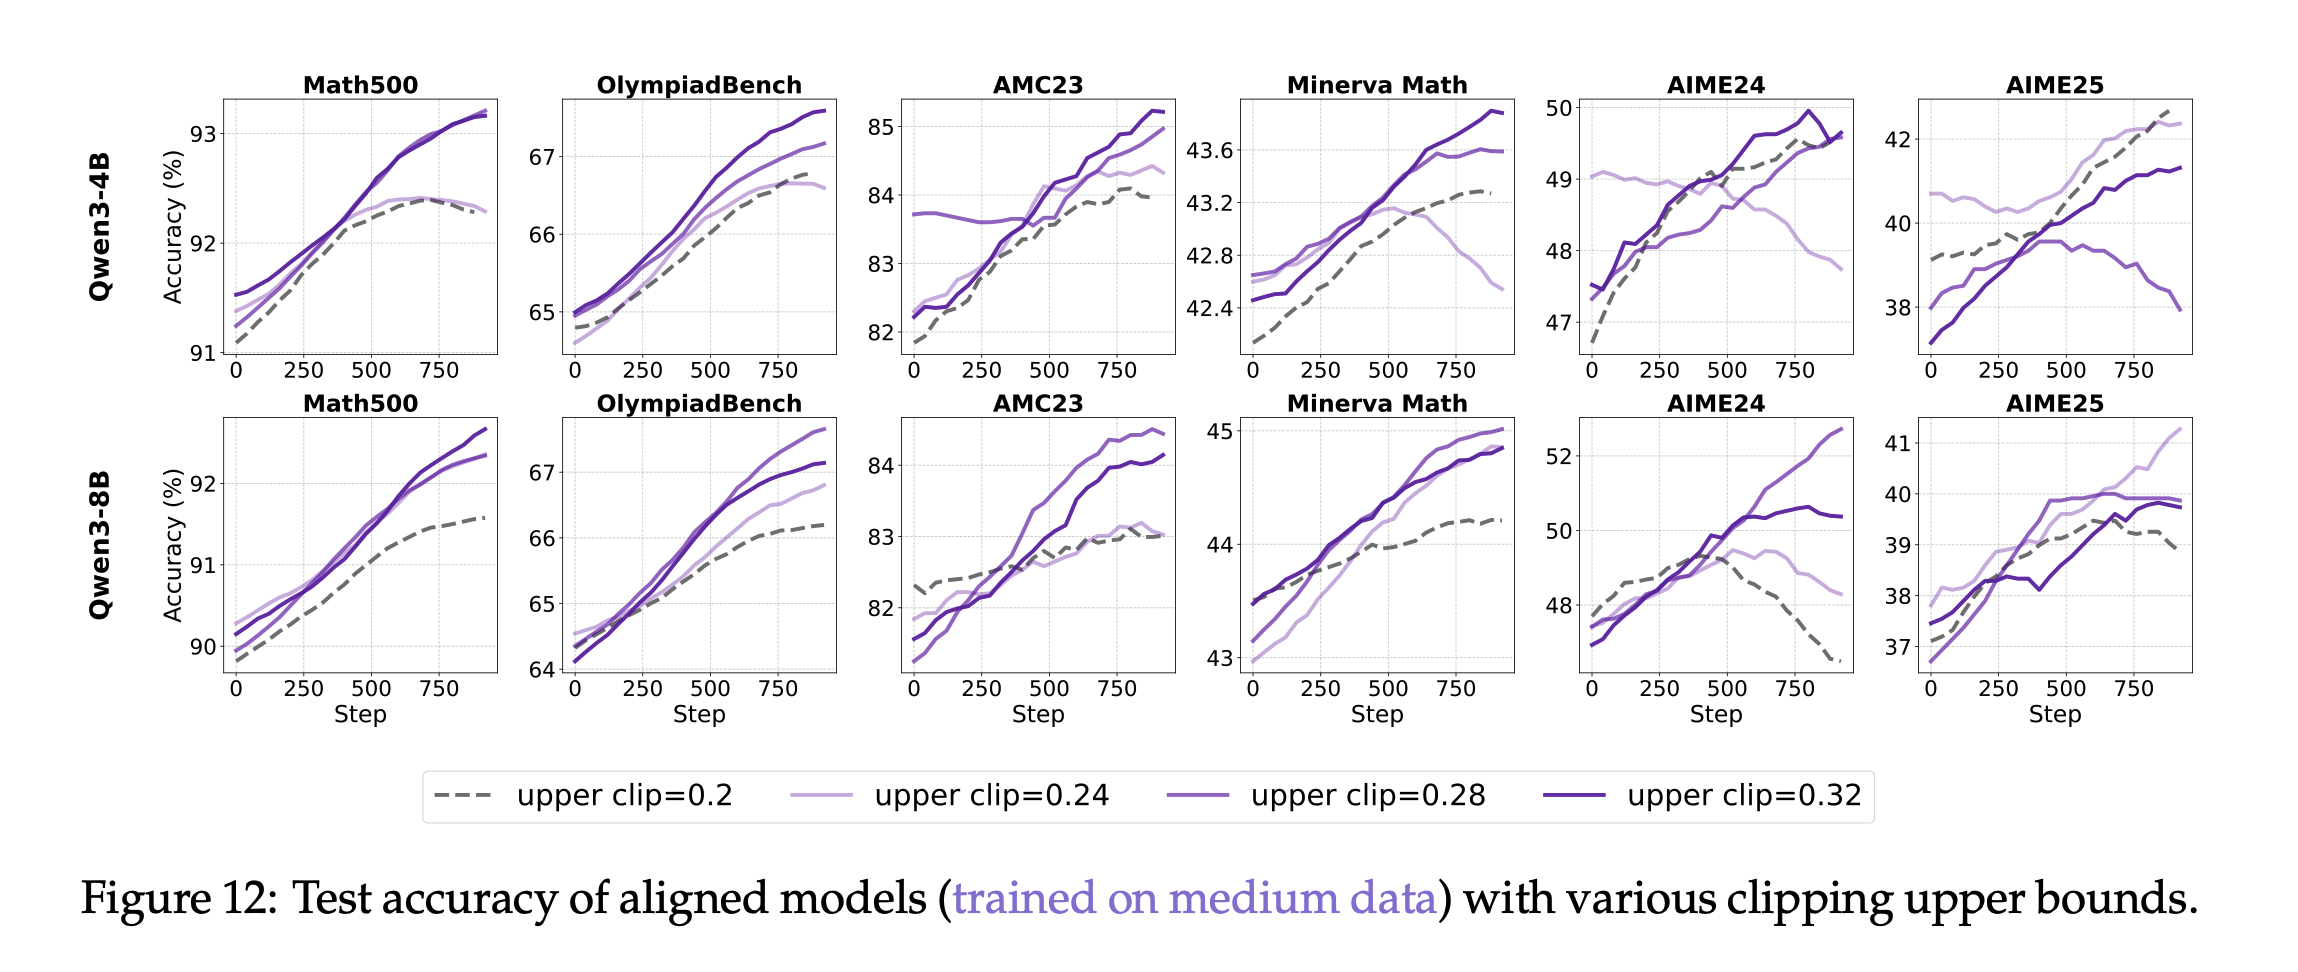
  • Clip-Higher的最佳上限和具体模型有关,对对齐模型有作用,4B-0.32, 8B-0.28最佳。
  • Token Loss 对Base模型更友好,Seq Loss 对对齐模型效果更好。
  • 超长过滤在短回复任务中有效(8k),但在长回复任务中(20k) 似乎没啥效果。

1. 基线设计 ​

RL 技巧

1. 基线设计

2. 裁剪策略 ​

2. 裁剪策略

目的

  • 裁剪,限制单次更新幅度,防止策略过度更新。

方法

  • 可以裁剪重要性权重、奖励、优势等。

  • PPO-Clip:裁剪IS权重,[1−ϵ,1+ϵ]

    • 缺点:抑制了低概率token,高概率token进一步强化,导致策略确定,熵坍塌
  • DAPO-Clip-Higher:裁剪IS权重,调高上限,保持探索性,[1−ϵlow,1+ϵhigh]

  • CISPO:只裁剪IS权重的数值、SG+外乘logprob 保留token梯度。

  • Value-Clip:裁剪价值网络,防止更新过快。

实验结果

Clip-Higher

  • ϵhigh=0.28,可以减轻熵坍塌
  • 提高裁剪上限,和基础模型也有关。
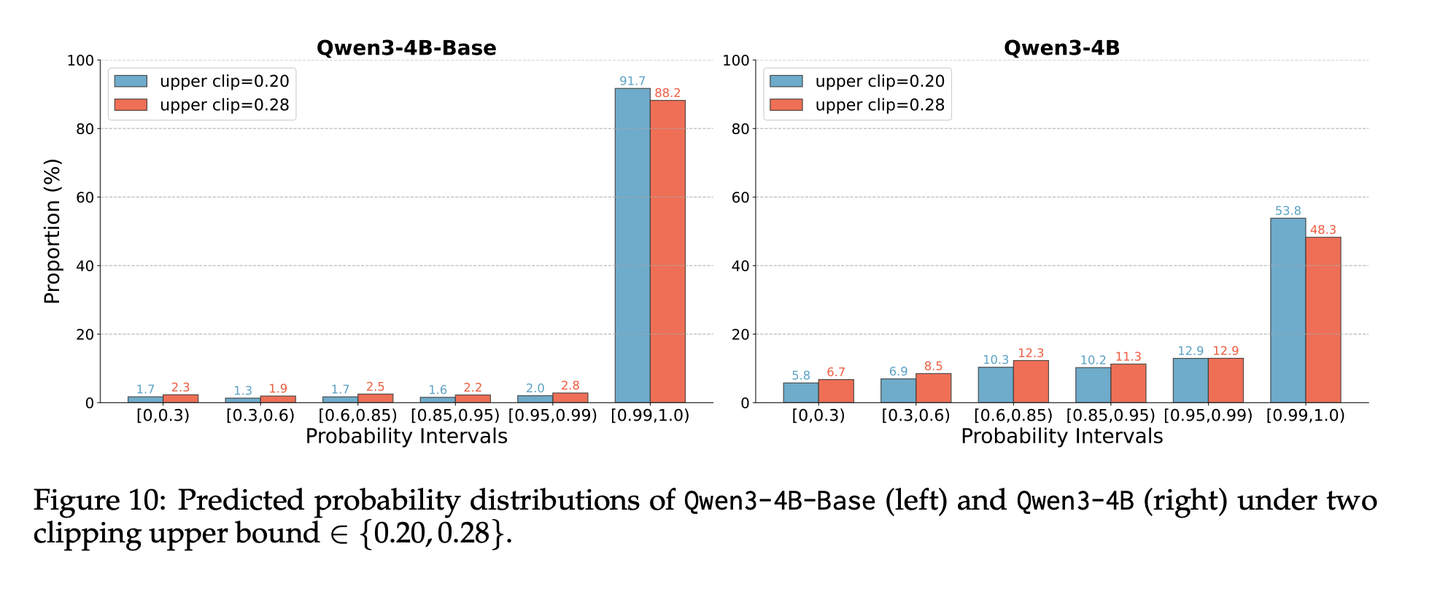
    • 针对base模型:对熵影响不大。
      • 裁剪率很低,连续策略之间差别不大,限制了探索能力。
      • base模型性能较差,可能不知如何探索,限制了探索能力。
      • Base预测最常见的下一词,概率分布尖锐。
    • 针对instruct模型:能明显缓解熵崩溃,提升一些性能。
      • 与base模型比,在初始阶段,高概率词汇更少。
        • 提高裁剪上界,可以有效减少token之间的概率差距,缓解熵崩溃。
        • 有一定经验,可能性多,概率更均匀地分布在多个有效开局上
      • 有一定经验,给予探索空间,能突破瓶颈,达到更高效果。
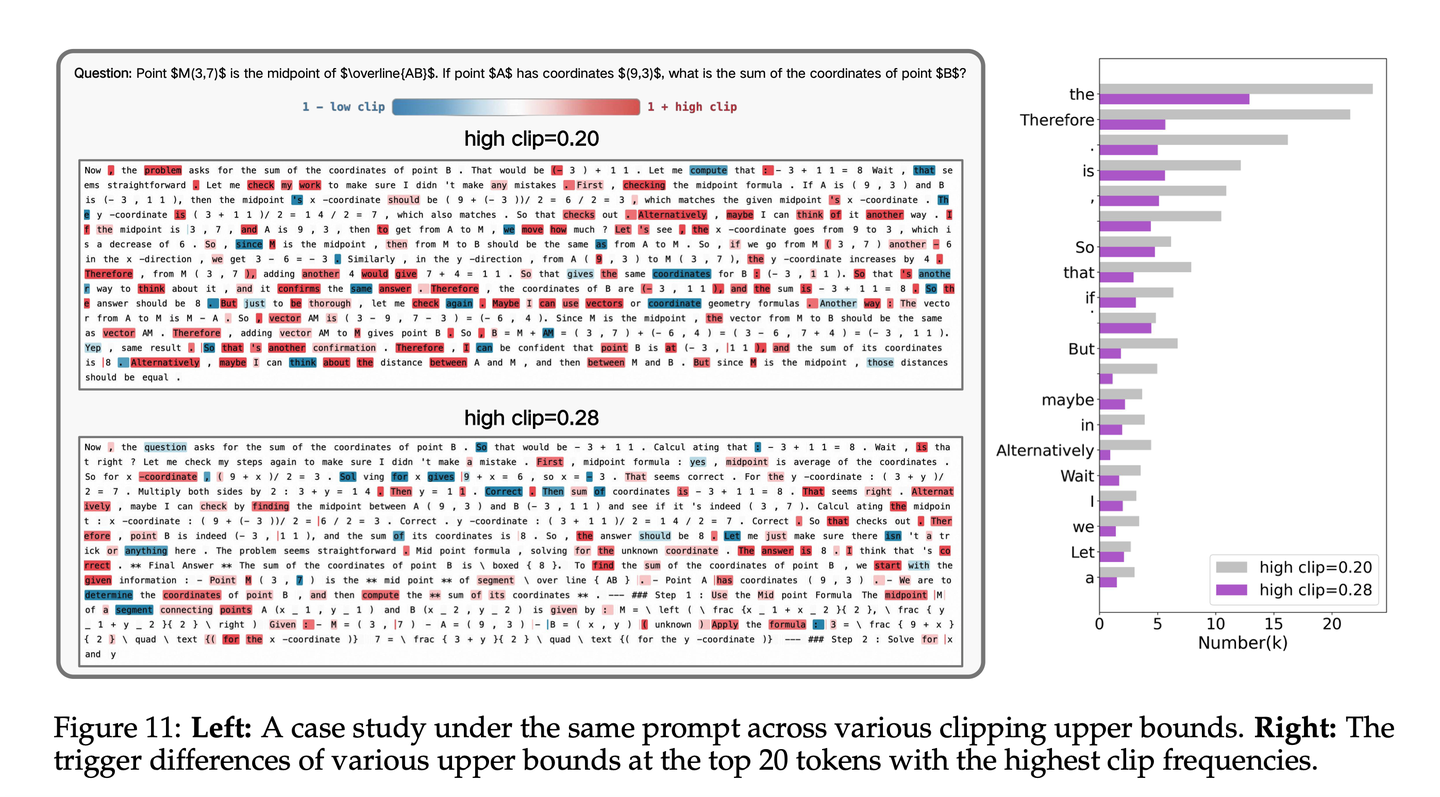
  • 表示转折的token容易被clip掉,影响模型探索,增大clip允许模型探索更广。
    • clip调高后,这些转折token就容易被优化到,促进多种探索。
  • clip最佳上限值和具体模型有关,需要调优。
    • 4B模型:clip 从0.2 ->0.32,效果一直增长。
    • 8B模型,clip 从0.2->0.32,最优效果是0.28。需要调优。

Clip-Higher 在Base模型上效果一般,在对齐后的模型上有效果。

Base模型高概率token多。

转折词汇经常被clip,提高上限后,转折词就能被优化,促进多种探索。

3. 归一化策略 ​

归一化策略

3. 归一化策略

  • 含义:归一化奖励、优势。

  • 目的:稳定梯度大小,拉到同一水平线进行比较,让不同任务可比较。

  • 方法:

    • GRPO/RLOO:组归一化

      A^i,t=A^i=ri−mean({rj}j=1K)std({rj}j=1K)
    • REINFORCE++:Batch归一化 ,使用全局批次的平均奖励作为基线

      A^i,t=A^i=ri−mean({rj}j=1bs⋅K)std({rj}j=1bs⋅K)
    • Dr.GRPO:不除以标准差,避免难度偏差。 A^i,t=A^i=ri−mean(r)

      • 论文没研究此方法,只研究了不归一化。
实验结论

关于归一化方法

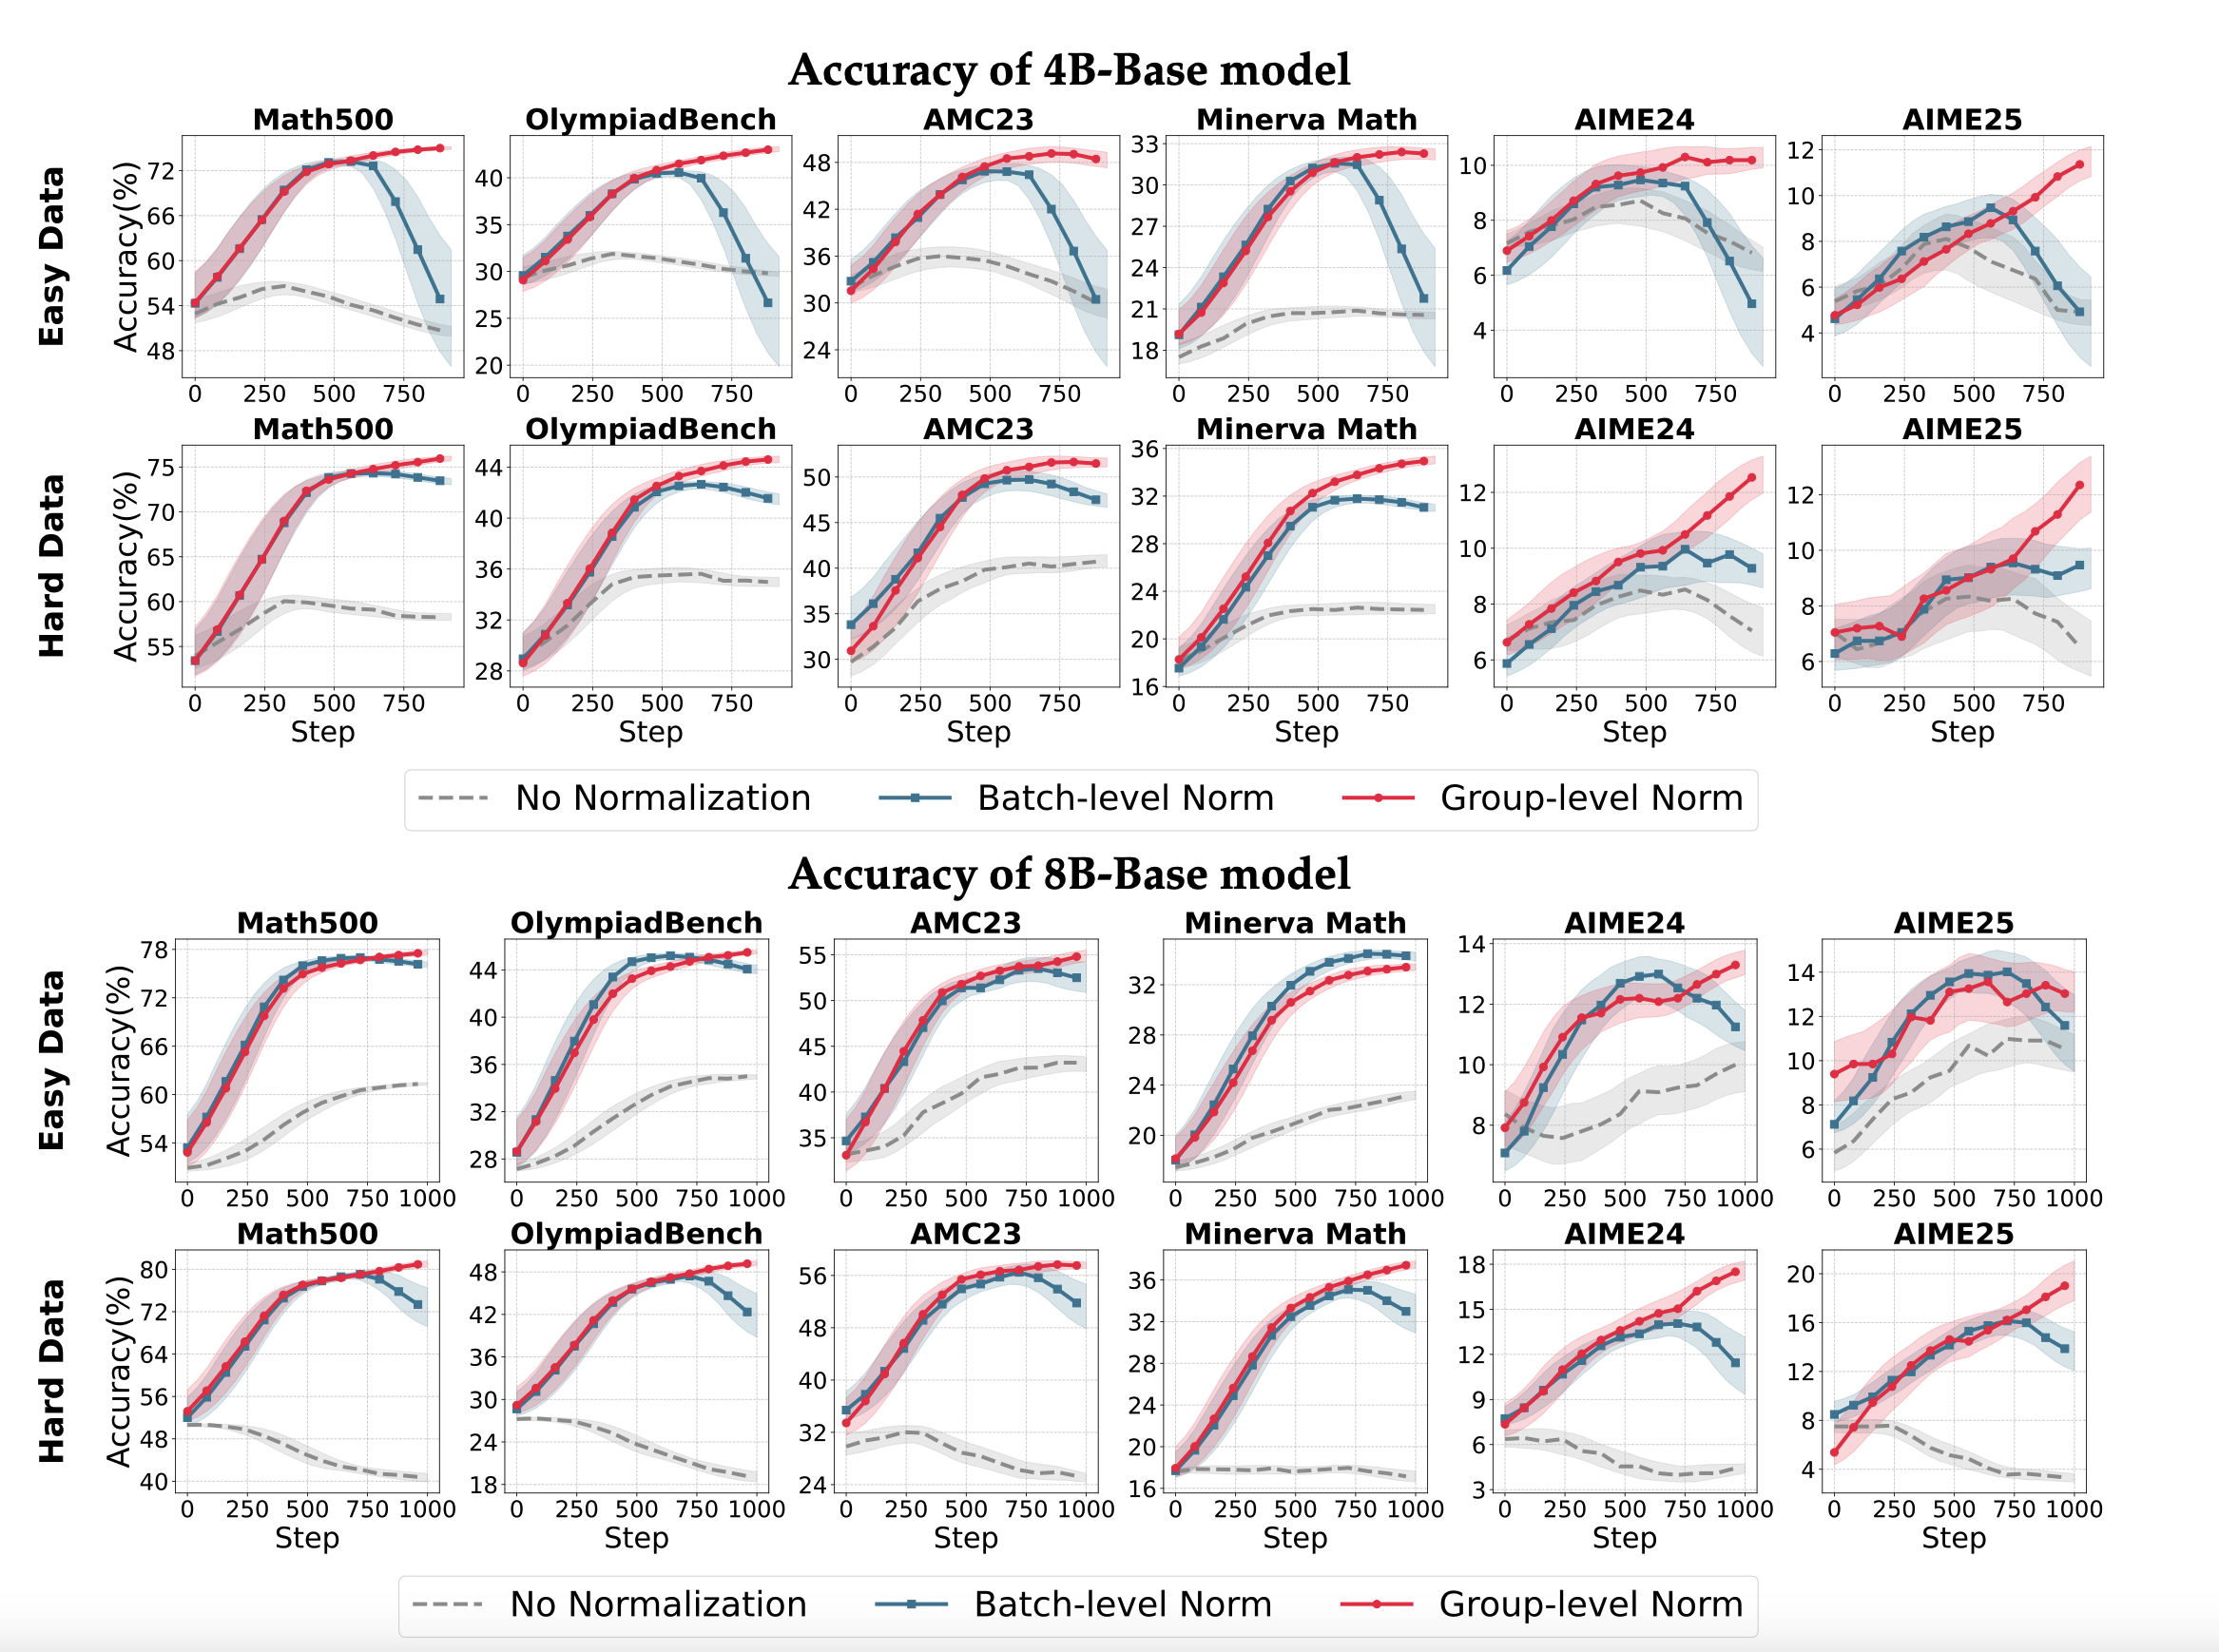
  • 归一化肯定比不归一化好。
  • 组归一化整体都比较好
    • 在{0,1}稀疏奖励下,比批归一化稳定性好、效果好。
    • 适用于不同reward设置。
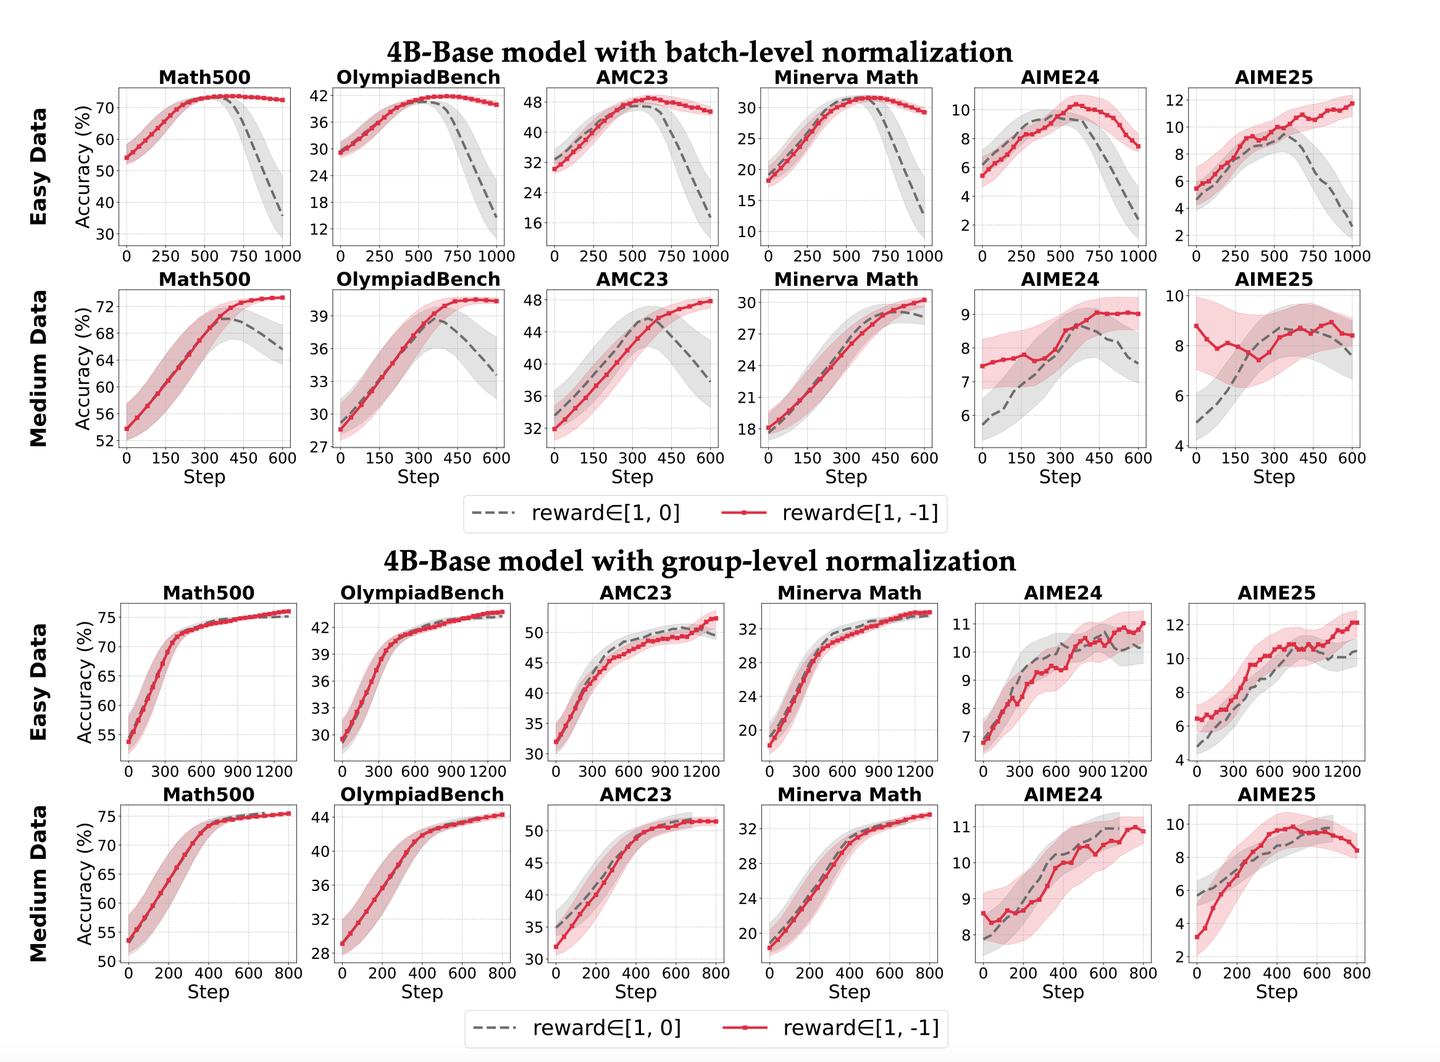
  • Batch归一化在{-1,1}大范围奖励下,批归一化有优势,个人感觉也不是很明显。

标准差

  • 不稳定的任务 标准差大,
  • 除以大标准差,会削弱或抑制那些偶然成功的高奖励学习信号。

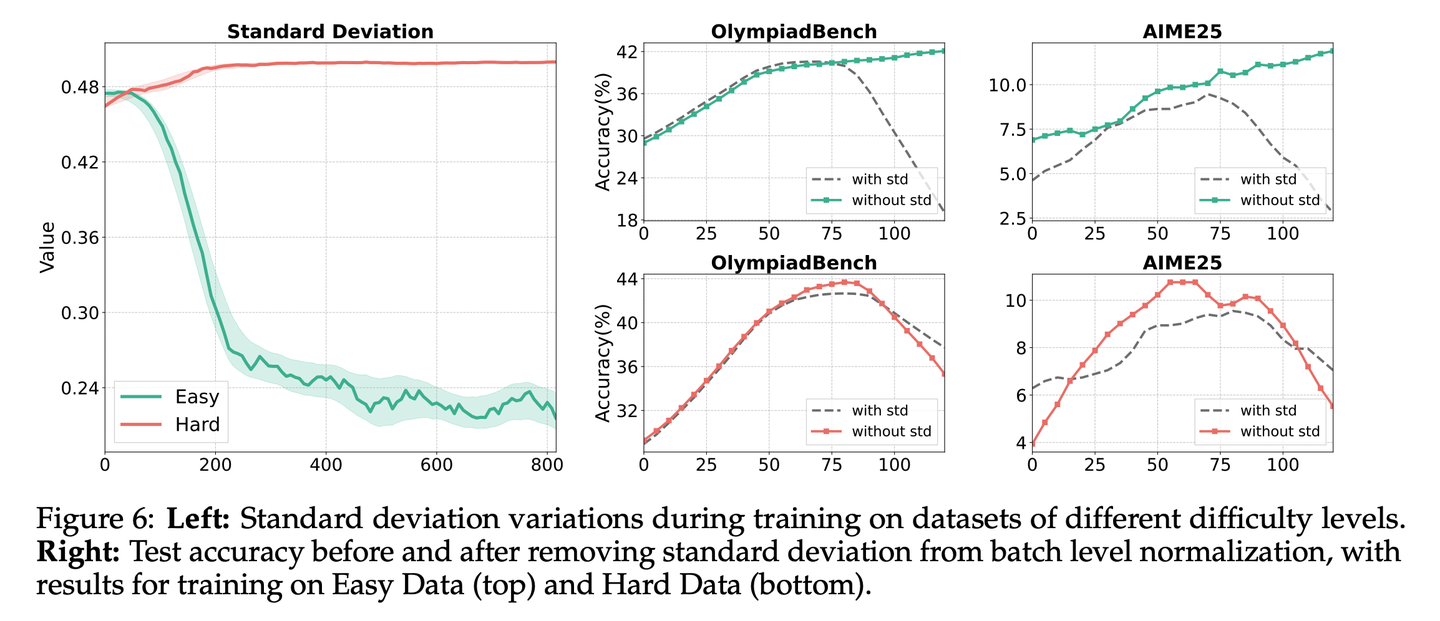
关于去掉标准差

  • 简单任务下,标准差有害,不用标准差更好。
    • 奖励几乎相同,标准差很小接近0,会导致梯度爆炸、训练崩溃。
  • 复杂任务下,标准差无害,可以用标准差。
    • 奖励比较多样化,标准差比较稳定,但用和不用标准差,训练都比较稳定。

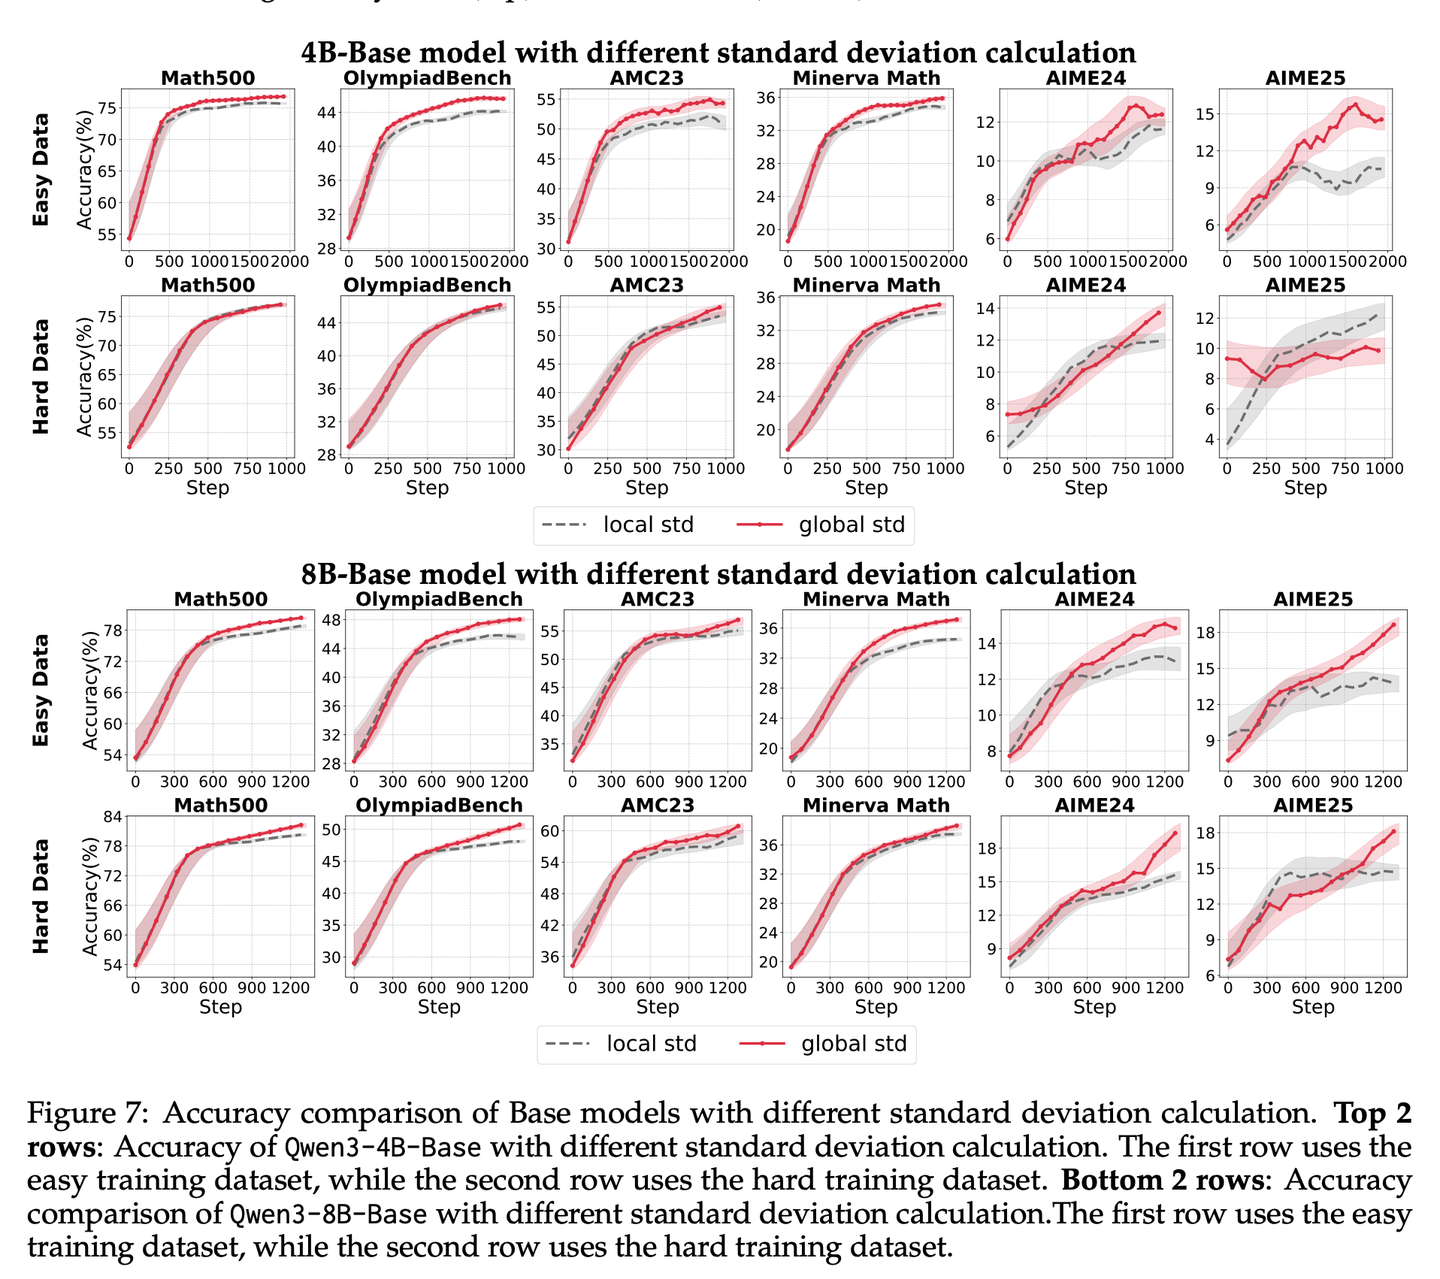
关于鲁棒归一化

  • group mean + batch std 更鲁棒。
    • global std(batch) 比 local std(group) 要好一点。
    • batch std 提供了强大平滑全局的缩放,控制整体更新幅度。

0-1 reward下,组归一化,效果稳定。

-1-1 reward下(reward scale 较大时),作者说批归一化要好点,但我没看出来,明显Group的结果要比Batch要好一些。

  • 简单任务,std比较小,没有std会好一些。
  • 复杂任务,std比较大,有无std差不多。

batch的global std、比group的local std 看起来要好一点?

4. 过滤策略 ​

过滤策略

4. 过滤策略

  • 含义:

    • 在梯度计算前,筛选出有价值的样本,过滤掉无信息、不理想的样本。
    • 但:若对推理正确仅超长样本直接给-1,则会带来奖励噪声。
  • 方法:

    • DAPO:超长回复过滤/奖励设计
    • 过滤错误特别多、过于简单的样本、过滤难度之外的样本。
    • DAPO:过滤掉全对或全错的batch
过滤实验

超长过滤

  • 超长过滤能降低 重复但无法终止的样本。
  • 效果有效性
    • 在截断长度较短时(8k):使用超长过滤会有效果。
    • 在长度较长时(20k):使用超长过滤,效果就不大了。

5. Loss 聚合策略 ​

Loss 聚合策略

5. Loss 聚合粒度

  • 含义:决定了每个token对总目标的贡献权重。

  • 方法

    • GRPO:Sequence-Level Loss:序列内平均、再序列间平均。

      Lseq-level(θ)=−1G∑i=1G⏟序列间平均1|oi|∑t=1|ot|⏟序列内平均min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)
    • DAPO:Token-Level Loss,减少长度偏差,所有token贡献相同,Verl默认就是这个。

      Ltolen-level(θ)=−1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)
    • GSPO:序列级重要性权重、序列级clip 更新。

      JGSPO(θ)=Ex∈D,{yi}i=1G∼πθold[1G∑i=1G⏟序列间平均min(si(θ)⋅A^i,clip(si(θ),1−ϵ,1+ϵ)⋅A^i)]
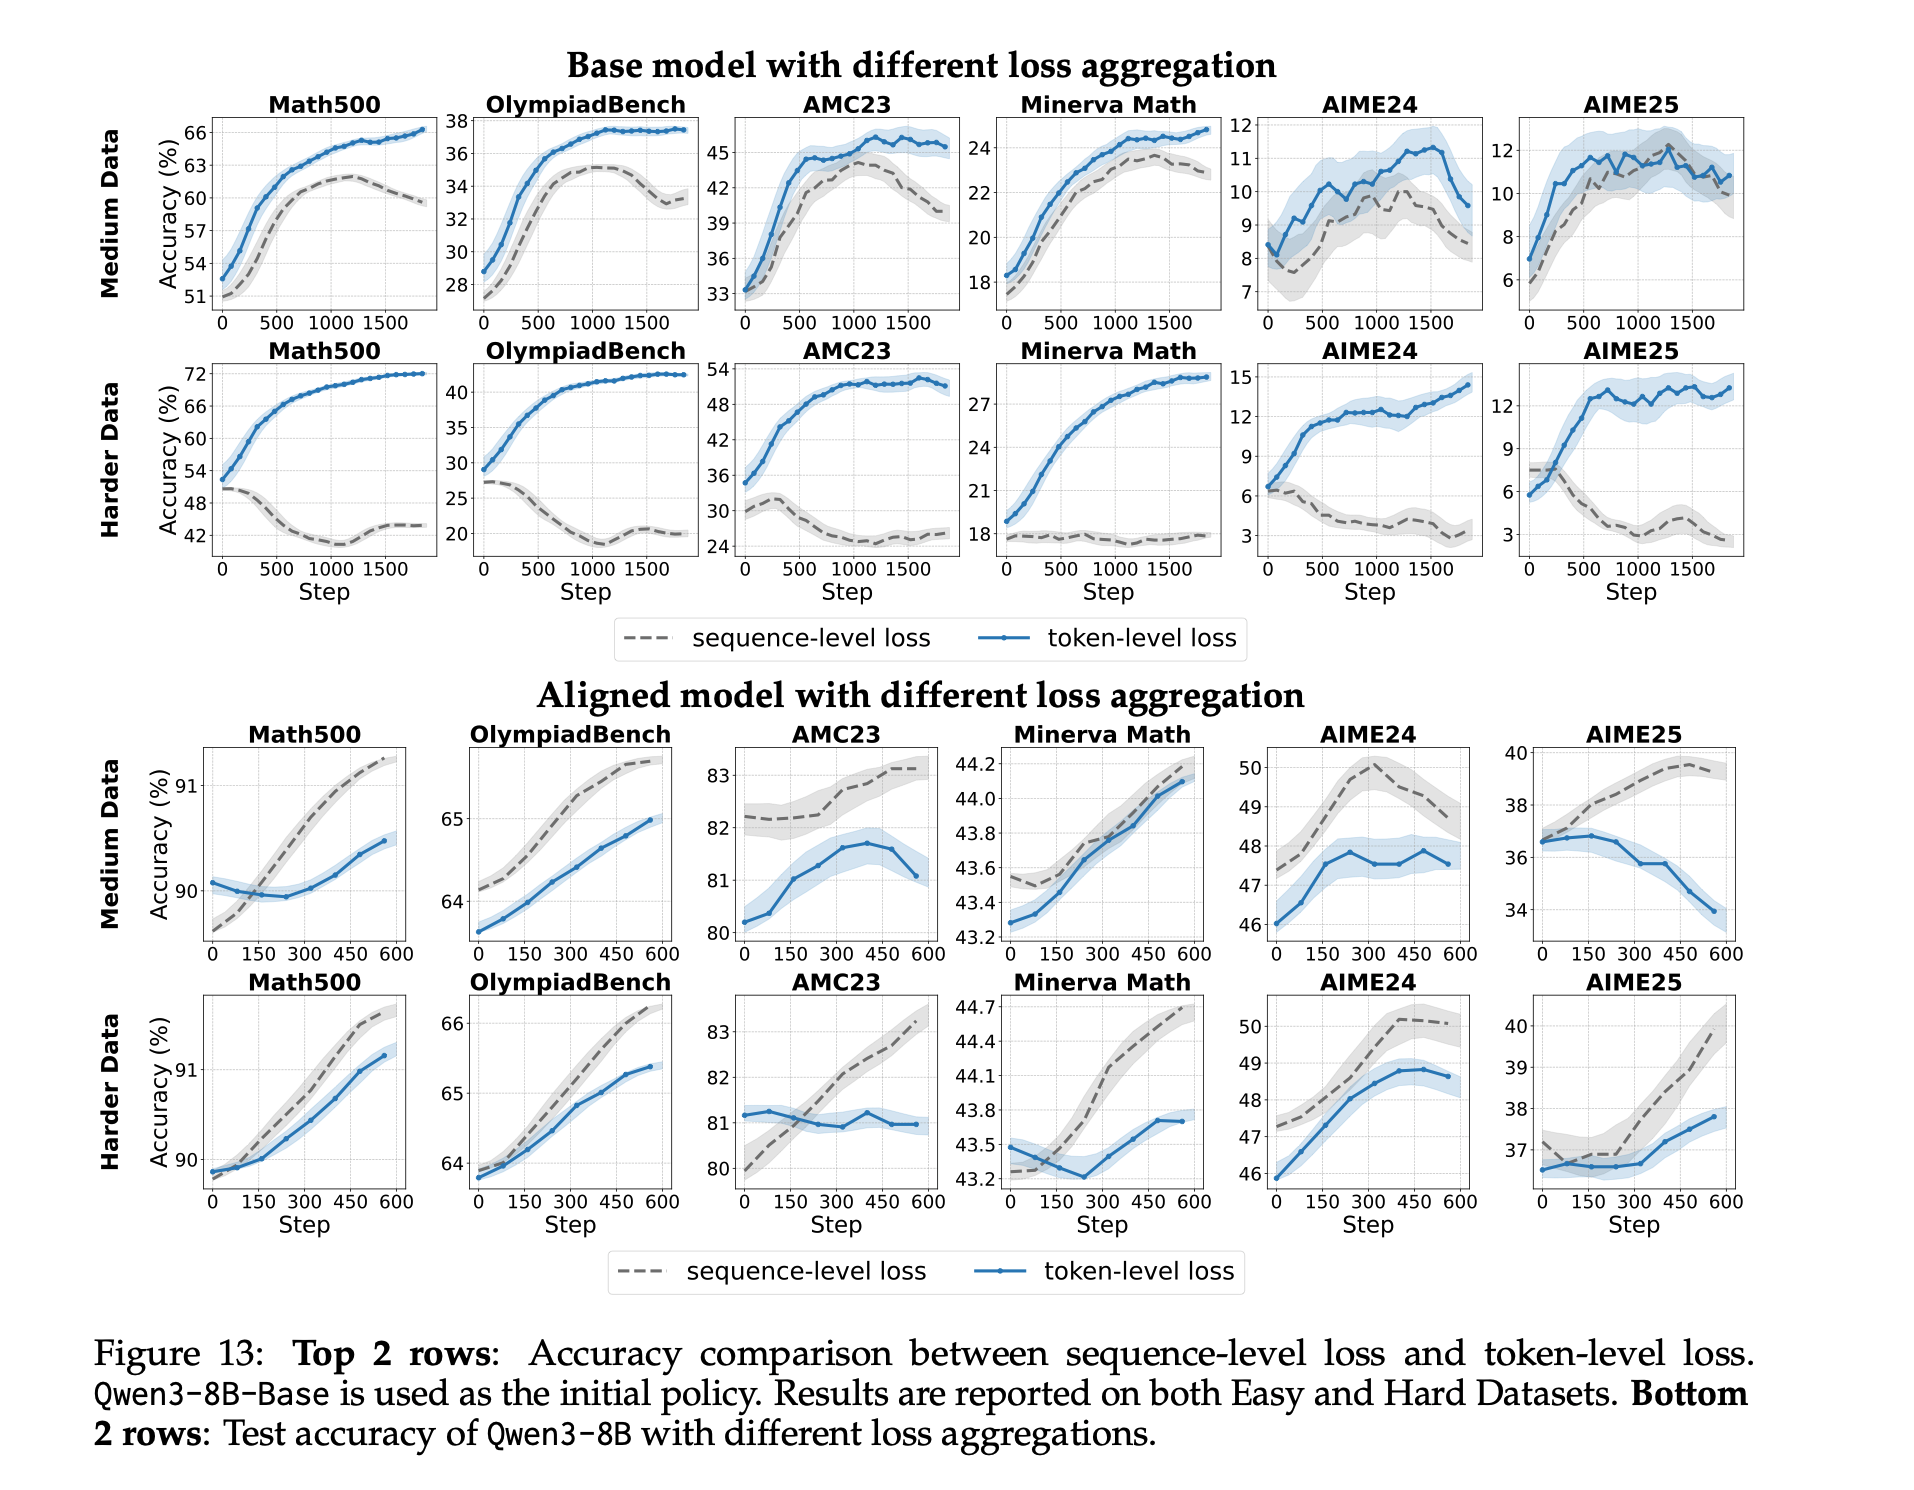
Loss聚合策略 实验结果

关于聚合粒度

  • 对Base模型(Qwen3-8B),token-level-loss 效果更好。
  • 对对齐模型(Qwen3-8B),seq-level-loss 效果更好。收敛速度和准确率都高于token-level loss。

对Qwen3-8B-Base,Token-Level Loss 效果更好。

对Qwen3-8B,Seqence-Level Loss 效果更好。

6. 附加loss策略 ​

附加loss

6. 附加loss函数

  • 目标:补充主目标对训练进行正则化
  • 方法
    • KL Loss:约束和参考模型差异。
    • SFT Loss:保持对齐

7. 奖励函数设计 ​

奖励函数设计

7. 奖励函数设计

  • 长度惩罚、格式化奖励、长度相关的准确度奖励等。

核心方法:LitePPO ​

📕核心方法

核心方法

LitePPO

  • 2项技术 (针对Base小模型有效果)
    • Group Mean + Batch Std
    • Token-Level-Loss
  • 使用 vanilla PPO Loss

算法实验 ​

✍️实验设置

LitePPO。

🍑关键结果

关键结果
  • 对于非对齐小模型(4B-Base和8B-Base)
    • group mean + batch std 归一化,效果好。
    • Token-Level-Loss 效果好。
  • Lite PPO+Base模型,在相关Bench上,比GRPO和DAPO效果好。

⛳未来方向

未来方向

(2507) GSPO (Qwen) ​

摘要

参考链接

问题背景

  • 认为Token级重要性权重,每个token IS权重不同,导致方差噪声大。
    • 并不能实现预期的序列分布修正作用。
    • 并被序列累积+Clip放大了,导致训练崩溃。

核心方法

  • 提出序列级重要性权重,每个Token IS权重相同
  • 增加了稳定性和公平,序列奖励+序列更新。

关键结论

  • GSPO 优点比GRPO训练更稳定、效率更高。
  • 对MoE RL训练也增加稳定性,无需Routing Replay。

其他

  • 似乎没有什么具体指标、也没有讲训练数据。干货比较少。
  • 没有对比DAPO、CISPO。

问题背景 ​

❓问题背景

Token级重要性权重噪声大容易训崩 ​

GRPO Token-Level 重要性采样 训练崩溃

GRPO 存在训练稳定性问题

  • Scale RL训练 需要稳定性。
  • GRPO训大模型不稳定:经常出现严重不可逆转的训练崩溃。

Token-Level IS 和 序列级别奖励信号不匹配

  • GRPO在每个token上计算重要性权重

    • 但LLM是序列逐字比较不合理,单个token概率变化,并不能反映 整个序列的概率变化。

    • 使得重要性权重 并不能真正修正分布差异。

      rt(θ)=πθ(at∣st)πθold(at∣st)=πθ(yt∣x,y<t)πθold(yt∣x,y<t)
    ri,t(θ)=πθ(yi,t∣x,yi,<t)πθold(yi,t∣x,yi,<t)
  • 奖励信号是序列级别,但重要性权重优化却是token级别,不匹配。

Token-Level IS 产生训练崩溃的原因

  • 单token重要性权重 方差大、噪声大,不稳定,时好时坏,
  • 噪声随序列变长 逐渐累积,滚雪球。
  • 维稳的Clip机制,反而放大了噪声:
    • 充满噪声的权重,被频繁裁剪,会扭曲整个学习信号。
    • 嘈杂的信号 变成 持续的、错误的信号,反而加速模型崩溃。

MoE专家激活不稳定容易训崩 ​

MoE + GRPO 训练不稳定

MoE 专家激活不稳定 影响收敛

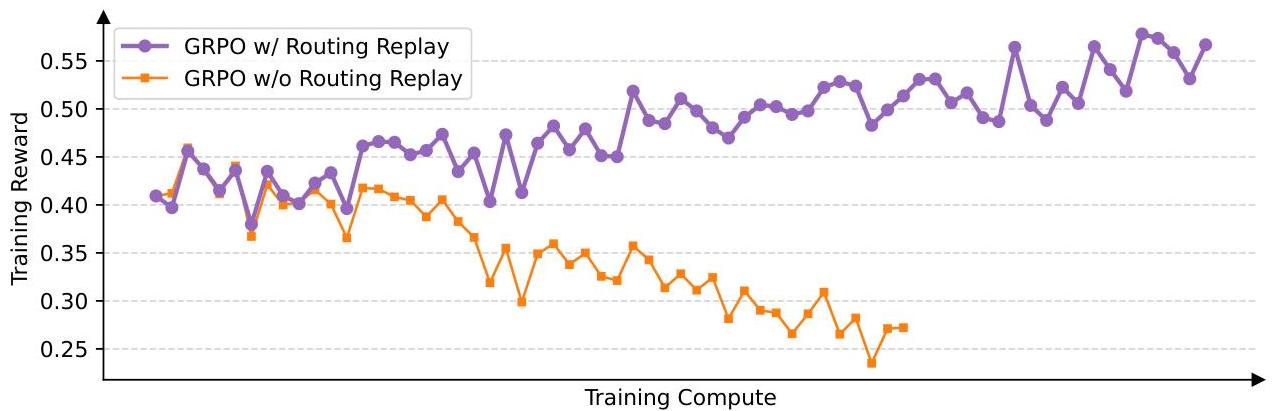
  • 对于同一个输入,新旧策略 激活的专家 大约有10%不一样。
  • 这种不稳定性,导致GRPO Token级重要性权重,发生剧烈波动,阻碍收敛。

解决方法1:Routing Replay

  • 计算重要性权重时,缓存旧策略πθold激活的专家。
  • 计算新策略πθ时,强制重复 旧策略激活的专家。
  • 确保新旧策略 在每个token 使用相同的专家,恢复IS稳定性。
  • 不使用Routing Replay 很快就会崩溃。

解决方法2:GSPO

  • 从算法上去掉token级重要性权重,采用序列级重要性权重。
  • 评价整个句子好不好,评价尺度更宏观,对底层专家模型不敏感。
  • 无需Routing Replay。

有Routing Replay 训练没有崩。

核心方法 ​

📕核心方法

GSPO-序列级IS权重/优势/梯度 ​

序列级Token权重

Token级重要性权重

ri,t(θ)=πθ(yi,t∣x,yi,<t)πθold(yi,t∣x,yi,<t)

序列级重要性权重

  • 对序列做重要性权重:更好地衡量整句话的概率变化。
si(θ)=πθ(yi∣x)πθold(yi∣x)
  • 长度归一化:降低方差,避免太长导致连乘概率太小,

    si(θ)=(πθ(yi∣x)πθold(yi∣x))1|yi|=exp(1|yi|∑t=1|yi|log⁡πθ(yt∣x,yi,<t)πθold(yt∣x,yi,<t))

GSPO 训练目标

  • 序列级奖励、序列级优化,相一致。
  • clip整个序列。
JGSPO(θ)=Ex∈D,{yi}i=1G∼πθold[1G∑i=1Gmin(si(θ)⋅A^i,clip(si(θ),1−ϵ,1+ϵ)⋅A^i)]

GSPO 梯度

  • 每个token使用相同的Seq-IS权重。
∇θJGSPO(θ)=∇θEx∈D,{yi}i=1G∼πθold(⋅|x)[1G∑i=1Gsi(θ)⋅A^i]=Ex∈D,{yi}i=1G∼πθold(⋅|x)[1G∑i=1Gsi(θ)⋅A^i⋅∇θlog⁡si(θ)]=Ex∈D,{yi}i=1G∼πθold(⋅|x)[1G∑i=1G(πθ(yi|x)πθold(yi|x))1|yi|⏟序列重要性权重⋅A^i⏟序列优势⋅1|yi|∑t=1|yi|∇θlog⁡πθ(yi,t|x,yi,<t)⏟序列梯度]∇θJGSPO(θ)=Ex∈D,{yi}i=1G∼πθold(⋅|x)[1G∑i=1G(πθ(yi|x)πθold(yi|x))1|yi|⋅A^i⋅1|yi|∑t=1|yi|∇θlog⁡πθ(yi,t|x,yi,<t)]

对比GRPO梯度

  • 其中:A^i,t=A^i
∇θJGRPO(θ)=Ex∈D,{yi}i=1G∼πθold(⋅|x)[1G∑i=1G1|yi|∑t=1|yi|⏟序列内平均πθ(yi,t|x,yi,<t)πθold(yi,t|x,yi,<t)⏟token重要性权重⋅A^i,t⏟token优势⋅∇θlog⁡πθ(yi,t|x,yi,<t)⏟token梯度]

GSPO vs GRPO

  • GRPO:每个token有自己的重要性权重。
    • 各token IS权重不同,累积起来,波动性很大,带来很大噪声。
  • GSPO:每个token都用相同的序列级重要性权重。
    • 各token IS权重相同,增加了稳定性和公平。
    • 前向时 各Token用相同序列权重,反向时 各token保留自己梯度通路
    • log_prob - log_prob.detach():数值等于0,但梯度不等于0。detach 保留数值,切断梯度

GSPO 代码 ​

py
@register_policy_loss("gspo")
def compute_policy_loss_gspo(
    old_log_prob: torch.Tensor,
    log_prob: torch.Tensor,
    advantages: torch.Tensor,
    response_mask: torch.Tensor,
    loss_agg_mode: str = "seq-mean-token-mean",
    config: Optional[DictConfig | ActorConfig] = None,
    rollout_is_weights: torch.Tensor | None = None,
) -> tuple[torch.Tensor, torch.Tensor, torch.Tensor, torch.Tensor]:
    """
    Compute the clipped policy objective and related metrics for GSPO.

    See https://arxiv.org/pdf/2507.18071 for more details.

    Args:
        old_log_prob (torch.Tensor):
            Log-probabilities of actions under the old policy, shape (batch_size, response_length).
        log_prob (torch.Tensor):
            Log-probabilities of actions under the current policy, shape (batch_size, response_length).
        advantages (torch.Tensor):
            Advantage estimates for each action, shape (batch_size, response_length).
        response_mask (torch.Tensor):
            Mask indicating which tokens to include in the loss, shape (batch_size, response_length).
        loss_agg_mode (str, optional):
            Aggregation mode for `agg_loss`. For GSPO, it is recommended to use "seq-mean-token-mean".
    """

    assert config is not None
    assert isinstance(config, ActorConfig)
    clip_ratio_low = config.clip_ratio_low if config.clip_ratio_low is not None else config.clip_ratio
    clip_ratio_high = config.clip_ratio_high if config.clip_ratio_high is not None else config.clip_ratio

    negative_approx_kl = log_prob - old_log_prob

    # compute sequence-level importance ratio:
    # si(θ) = (π_θ(yi|x)/π_θold(yi|x))^(1/|yi|) =
    # exp [(1/|y_i|) * Σ_t log(π_θ(y_i,t|x,y_i,<t)/π_θold(y_i,t|x,y_i,<t))]
    seq_lengths = torch.sum(response_mask, dim=-1).clamp(min=1)  
    negative_approx_kl_seq = torch.sum(negative_approx_kl * response_mask, dim=-1) / seq_lengths  

    # Combined ratio at token level:
    # s_i,t(θ) = sg[s_i(θ)] · π_θ(y_i,t|x, y_i,<t) / sg[π_θ(y_i,t|x, y_i,<t)]
    # In log space: log(s_i,t(θ)) = sg[log(s_i(θ))] + log_prob - sg[log_prob]
    # 数值等于0,但梯度不等于0
    log_seq_importance_ratio = log_prob - log_prob.detach() + negative_approx_kl_seq.detach().unsqueeze(-1) 
    log_seq_importance_ratio = torch.clamp(log_seq_importance_ratio, max=10.0) # clamp for numerical stability

    # finaly exp() to remove log
    seq_importance_ratio = torch.exp(log_seq_importance_ratio)  

    pg_losses1 = -advantages * seq_importance_ratio
    pg_losses2 = -advantages * torch.clamp(seq_importance_ratio, 1 - clip_ratio_low, 1 + clip_ratio_high)
    pg_losses = torch.maximum(pg_losses1, pg_losses2)

    # Apply rollout importance sampling weights if provided
    if rollout_is_weights is not None:
        pg_losses = pg_losses * rollout_is_weights

    # for GSPO, we need to aggregate the loss at the sequence level (seq-mean-token-mean)
    pg_loss = agg_loss(loss_mat=pg_losses, loss_mask=response_mask, loss_agg_mode="seq-mean-token-mean") 

    # For compatibility, return zero for pg_clipfrac_lower (not used in standard GSPO)
    pg_clipfrac = verl_F.masked_mean(torch.gt(pg_losses2, pg_losses1).float(), response_mask)
    pg_clipfrac_lower = torch.tensor(0.0, device=pg_loss.device)

    ppo_kl = verl_F.masked_mean(-negative_approx_kl, response_mask)

    return pg_loss, pg_clipfrac, ppo_kl, pg_clipfrac_lower
python
def agg_loss(loss_mat: torch.Tensor, loss_mask: torch.Tensor, loss_agg_mode: str):
    """
    Aggregate the loss matrix into a scalar.

    Args:
        loss_mat: `(torch.Tensor)`:
            shape: (bs, response_length)
        loss_mask: `(torch.Tensor)`:
            shape: (bs, response_length)
        loss_agg_mode: (str) choices:
            method to aggregate the loss matrix into a scalar.
    Returns:
        loss: `a scalar torch.Tensor`
            aggregated loss
    """
    if loss_agg_mode == "token-mean":
        loss = verl_F.masked_mean(loss_mat, loss_mask)
    elif loss_agg_mode == "seq-mean-token-sum":
        seq_losses = torch.sum(loss_mat * loss_mask, dim=-1)  # token-sum
        loss = torch.mean(seq_losses)  # seq-mean
    elif loss_agg_mode == "seq-mean-token-mean":
        seq_losses = torch.sum(loss_mat * loss_mask, dim=-1) / torch.sum(loss_mask, dim=-1)  # token-mean
        loss = torch.mean(seq_losses)  # seq-mean
    elif loss_agg_mode == "seq-mean-token-sum-norm":
        seq_losses = torch.sum(loss_mat * loss_mask, dim=-1)
        loss = torch.sum(seq_losses) / loss_mask.shape[-1]  # The divisor
        # (loss_mask.shape[-1]) should ideally be constant
        # throughout training to well-replicate the DrGRPO paper.
        # TODO: Perhaps add user-defined normalizer argument to
        # agg_loss to ensure divisor stays constant throughout.
    else:
        raise ValueError(f"Invalid loss_agg_mode: {loss_agg_mode}")

    return loss

GSPO 总结对比 ​

GSPO / GSPO-token:共享序列权重,仍有裁剪归零

标准GSPO

  • 序列级平均:红色si(θ)用于整条回答的裁剪判断。
JGSPO(θ)=Ex∼D, {yi}i=1G∼πθold(⋅∣x)[1G∑i=1Gmin(si(θ)⋅A^i,clip(si(θ),1−ϵlow,1+ϵhigh)⋅A^i)]
  • 序列级 IS权重
si(θ)=exp⁡[1|yi|∑t=1|yi|log⁡πθ(yi,t∣x,yi,<t)πθold(yi,t∣x,yi,<t)]
  • 未clip时:所有token 共享1个序列级IS权重,但各自Logprob梯度不必相同
∇θ[si(θ)A^i]=si(θ)A^i1|yi|∑t=1|yi|∇θlog⁡πθ(yi,t∣x,yi,<t)
  • clip时:见下部分

GSPO-token

  • 序列内Token平均 → 序列平均;si,t(θ)==si(θ),仅前向数值相同
JGSPO-token(θ)=Ex∼D, {yi}i=1G∼πθold(⋅∣x)[1G∑i=1G1|yi|∑t=1|yi|min(si,t(θ)⋅A^i,t,clip(si,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)]
  • 序列级IS权重:前向右侧值为1
si,t(θ)=sg[si(θ)]⋅πθ(yi,t∣x,yi,<t)sg[πθ(yi,t∣x,yi,<t)]
  • 分子传递梯度信号,前向保留序列数值,反向只通过第一个log_prob
    • log_prob - log_prob.detach() + log_seq_ratio.detach()
∇θ[si,t(θ)A^i,t]=sg[si(θ)]A^i,t∇θlog⁡πθ(yi,t∣x,yi,<t)
GSPO vs GRPO vs CISPO
  • GSPO后续有clip,仍可能丢弃token梯度。

  • 和GRPO有区别:clip时参照序列级权重,而GRPO参照Token权重。

  • 和CISPO有区别:CISPO保留token梯度 仅clip IS权重数值,外乘Logprob仍可传梯度。

    • CISPO 不因ratio越界而切断外层Logprob的梯度通路。

算法实验 ​

实验设置 ​

✍️实验设置

实验配置

模型

  • Qwen3-30B-A3B-Base

算法

  • GSPO vs GRPO

任务

  • 训练数据:
  • 评测数据:AIME24(avg Pass@1, 32次采样)、LiveCodeBench (avg Pass@1, 8次采样)、CodeForces

超参

  • mini-bs=4,
  • Clip比例:
    • GSPO:[1−3⋅10−4,1+4⋅10−4]
    • GRPO:[1−0.2,1+0.27]

关键结果 ​

🍑关键结果

关键结果
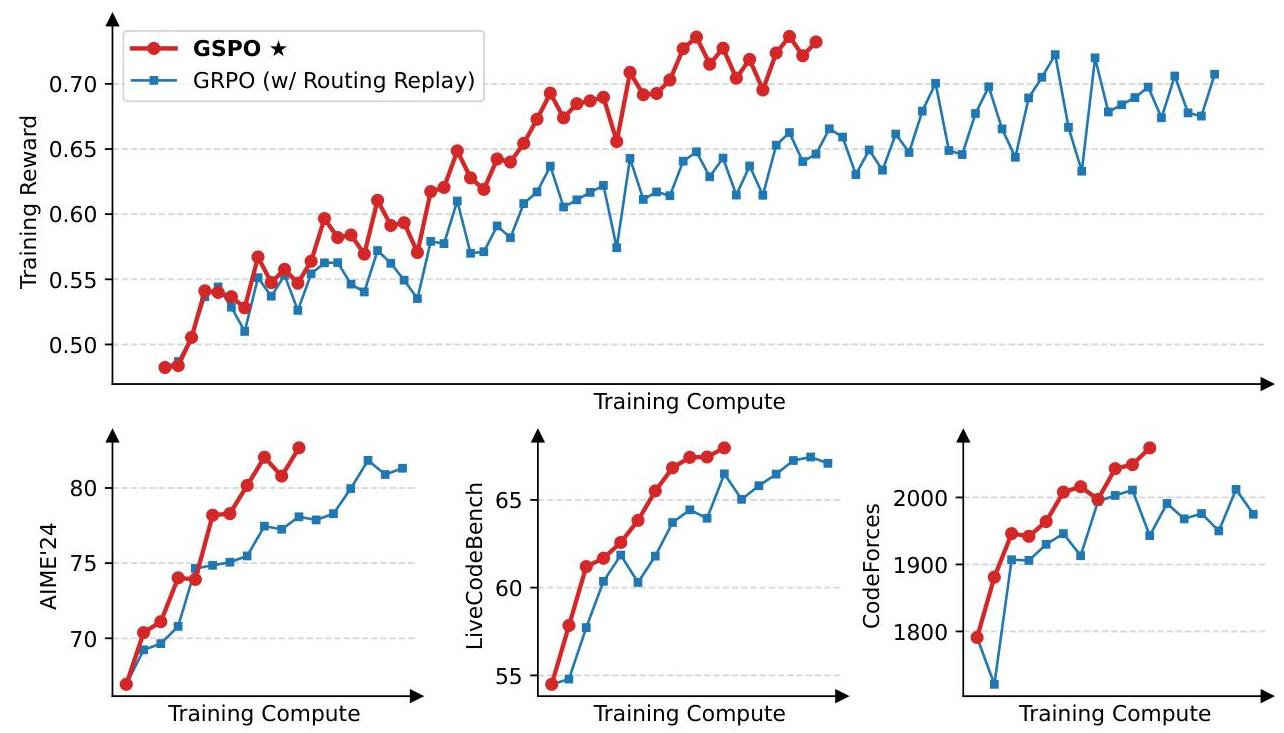
  • GSPO 训练过程很稳定。
  • GRPO 训练效率高于GRPO。
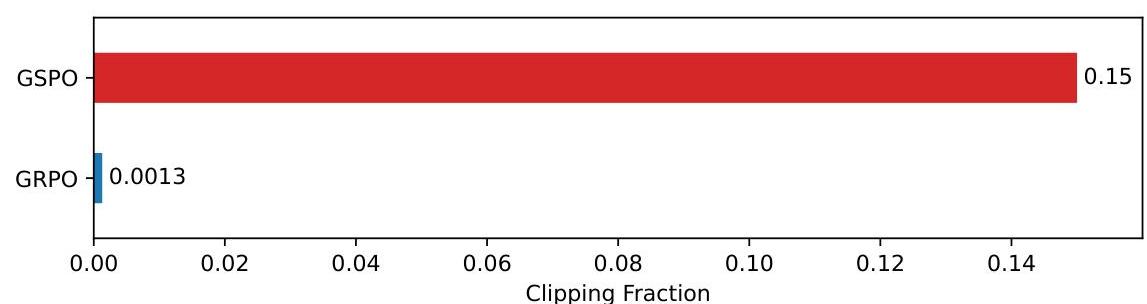
  • GSPO Clip的token比GRPO多2个数量级(15% vs 0.13%),却更稳定效果好,说明很多token嘈杂低效。
  • GSPO 对MoE RL训练有好处,新旧策略重要性权重能保持稳定,不用Routing Replay。

比较稳定,减少训练资源

GSPO Clip的token比GRPO多2个数量级,15% vs 0.13%,

未来方向 ​

⛳未来方向

未来方向

(2506) CISPO (MiniMax) ​

摘要

参考链接

问题背景

  • Clip 抑制了稀有关键Token

核心方法

  • DAPO改进,仅Clip IS权重数值+保留Token梯度

问题背景 ​

❓问题背景

Clip 抑制了稀有关键token ​

GRPO Clip抑制了关键token

GRPO-Clip 抑制了关键token

  • 稀有关键token:低概率、但高优势,在基座模型中很少出现。
  • 策略更新时:IS权重很大,被CLIP掉了,导致无法影响梯度更新。
  • 过滤了关键token,导致模型无法学会复杂推理能力

DAPO Clip-Higher

  • 设置ϵhigh,但效果不好。

核心方法 ​

📕核心方法

Stop Gradient ​

切断梯度

f(x)

  • 一个因子不求导,另一个因子仍可求导
f(x)=sg(x)⋅x∂f∂x=0⋅x⏟第一条路径被切断+sg(x)⋅1⏟第二条路径仍然存在=sg(x)

前后向不同

  • f(x),x=2时:前向f=2*2=4,反向梯度=2

    表达式(x=2) 时的数值自动微分得到的梯度
    x⋅x44
    sg(x)⋅x42
    sg(x⋅x)40

CISPO 算法 (仅Clip IS数值+保留Token梯度) ​

CISPO 算法

背景

CISPO 核心思想

  • 只clip重要性权重的值,但仍保留相关token的梯度

  • 核心做法:StopGradient IS权重,外乘Logprob使可传梯度

    • 不因ratio越界而切断外层Logprob的梯度通路
  • 采用GRPO组内相对优势

  • 采用Token-Level Loss

公式

JCISPO(θ)=Eq∼D,{oi}i=1G∼πθold[1∑iG|oi|∑i=1G∑t=1|oi|⏟token级平均sg(r^i,t(θ))⋅A^i,t⋅log⁡πθ(oi,t∣q,oi,<t)]r^i,t(θ)=clip(ri,t(θ),1−ϵlowIS,1+ϵhighIS)

GRPO/CISPO/GSPO 梯度保留裁剪对比 ​

SG 只切断所在路径
  • SG:保留数值、停止梯度求导;clip:区间内导数为1,区间外为0(不讨论边界点)。
ri,t(θ)=πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),∇θri,t(θ)=ri,t(θ)∇θlog⁡πθ(oi,t∣q,oi,<t)
GRPO / PPO-Clip:clip 将梯度归零

目标函数(Token-Level)

JGRPO(θ)=Eq∼D, {oi}i=1G∼πθold(⋅∣q)[1∑i=1G|oi|∑i=1G∑t=1|oi|min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)]

单Token梯度

  • 目标项:log⁡πθ通过概率比 → clip 传梯度,目标外没有额外乘log⁡πθ。
JGRPO,i,t(θ)=min(ri,t(θ)A^i,t, clip(ri,t(θ),1−ϵlow,1+ϵhigh)A^i,t)
  • 归零条件:正优势超过上界或负优势低于下界,min才选中常数clip分支。
∇θJGRPO,i,t(θ)={0,A^i,t>0, ri,t(θ)>1+ϵhigh,0,A^i,t<0, ri,t(θ)<1−ϵlow,ri,t(θ)A^i,t∇θlog⁡πθ(oi,t∣q,oi,<t),其他情况.
  • 链式法则:clip分支梯度包含∂clip/∂r=0;后面∇θlog⁡πθ即使非零,也会乘上这个0。
CISPO:裁剪权重,保留外面的 Logprob 梯度

完整目标函数

  • Token级平均,红色SG权重停止求导,蓝色Logprob保留梯度
JCISPO(θ)=Eq∼D, {oi}i=1G∼πθold(⋅∣q)[1∑i=1G|oi|∑i=1G∑t=1|oi|sg(r^i,t(θ))⋅A^i,t⋅log⁡πθ(oi,t∣q,oi,<t)]

单Token梯度

  • 目标项:权重先clip + SG,外面额外乘上 log⁡πθ;SG只切断权重路径
r^i,t(θ)=clip(ri,t(θ),1−ϵlowIS,1+ϵhighIS)JCISPO,i,t(θ)=sg[r^i,t(θ)]A^i,tlog⁡πθ(oi,t∣q,oi,<t)∇θJCISPO,i,t(θ)=sg[r^i,t(θ)]A^i,t∇θlog⁡πθ(oi,t∣q,oi,<t)
  • 越过上界:权重变为1+ϵhighIS,仍乘在Logprob梯度前;不会仅因越界 丢弃该项梯度。
  • 同值对照:优势为2、ratio为1.5、上界为1.2时
    • GRPO目标为2.4(常数)
    • CISPO目标为2.4log⁡πθ(oi,t∣q,oi,<t)。
GSPO / GSPO-token:共享序列权重,仍有裁剪归零

标准GSPO

  • 序列级平均:红色si(θ)用于整条回答的裁剪判断。
JGSPO(θ)=Ex∼D, {yi}i=1G∼πθold(⋅∣x)[1G∑i=1Gmin(si(θ)⋅A^i,clip(si(θ),1−ϵlow,1+ϵhigh)⋅A^i)]
  • 序列级 IS权重
si(θ)=exp⁡[1|yi|∑t=1|yi|log⁡πθ(yi,t∣x,yi,<t)πθold(yi,t∣x,yi,<t)]
  • 未clip时:所有token 共享1个序列级IS权重,但各自Logprob梯度不必相同
∇θ[si(θ)A^i]=si(θ)A^i1|yi|∑t=1|yi|∇θlog⁡πθ(yi,t∣x,yi,<t)
  • clip时:见下部分

GSPO-token

  • 序列内Token平均 → 序列平均;si,t(θ)==si(θ),仅前向数值相同
JGSPO-token(θ)=Ex∼D, {yi}i=1G∼πθold(⋅∣x)[1G∑i=1G1|yi|∑t=1|yi|min(si,t(θ)⋅A^i,t,clip(si,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)]
  • 序列级IS权重:前向右侧值为1
si,t(θ)=sg[si(θ)]⋅πθ(yi,t∣x,yi,<t)sg[πθ(yi,t∣x,yi,<t)]
  • 分子传递梯度信号,前向保留序列数值,反向只通过第一个log_prob
    • log_prob - log_prob.detach() + log_seq_ratio.detach()
∇θ[si,t(θ)A^i,t]=sg[si(θ)]A^i,t∇θlog⁡πθ(yi,t∣x,yi,<t)
GSPO vs GRPO vs CISPO
  • GSPO后续有clip,仍可能丢弃token梯度。

  • 和GRPO有区别:clip时参照序列级权重,而GRPO参照Token权重。

  • 和CISPO有区别:CISPO保留token梯度 仅clip IS权重数值,外乘Logprob仍可传梯度。

    • CISPO 不因ratio越界而切断外层Logprob的梯度通路。

算法实验 ​

✍️实验设置

实验配置

模型

  • Qwen2.5-32B

算法

  • CISPO vs GRPO vs DAPO

任务

  • zero-RL 设置
  • 训练数据:DAPO-MATH-17K 数据
  • 评测数据:AIME24

🍑关键结果

关键结果
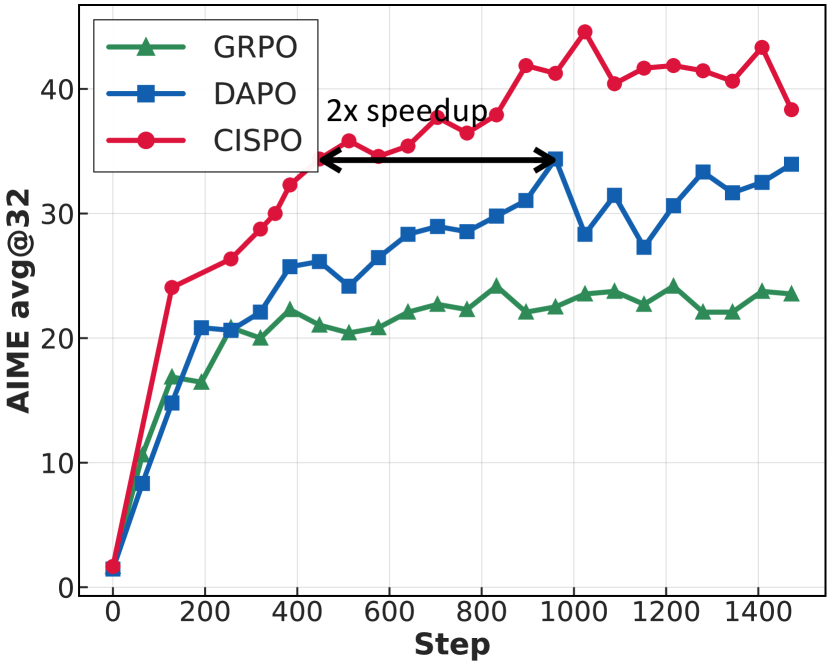
  • CISPO 效果好,AIME24 超过 DAPO 和 GRPO。
  • CISPO 效率高,仅需DAPO 50% step 达 DAPO效果。

⛳未来方向

未来方向

(2504) DAPO (Seed) ​

DAPO 摘要

参考链接

问题背景

  • 围绕GRPO 熵坍塌、奖励噪声、训练不稳定等问题展开。

核心方法

  • 提出了Clip-Higher、动态采样、Token-Level Loss、Overlong 奖励设计、数据转换等4大核心方法。

关键结论

  • DAPO 效果和效率都很好,20pt提升,做了丰富的组件消融实验,都很有用。

问题背景 ​

❓问题背景

熵坍塌 ​

参考文章

PPO/GRPO 熵坍塌

熵坍塌表现

  • 模型熵迅速下降
  • 失去新意,停止探索,过早进入利用阶段,需要探索利用平衡。

普通Clip机制不公平

  • 普通CLIP把策略更新幅度 限制在对称区间 [1−ϵ,1+ϵ]、[1−0.2,1+0.2]
  • 对不同概率的token来说,不公平。压制了低概率、但具有探索性的好步骤。
  • 假设2个以下token都是好词,A^>0。
    • 利用token:已知可靠路径,旧策略概率0.9,概率提升上限 0.9*1.2=1.08
    • 探索token:探索的更优解,旧策略概率0.01,概率提升上限 0.01*1.2=0.012
    • 探索的token,只能从1%提升到1.2%,几乎没有变化,对其太严格了。

熵坍塌本质:Clip上界压制了探索性

  • 上界压制了低概率、具有探索性的好步骤;
  • 放任已知高概率安全步骤变得更加绝对、概率更高;
  • 久而久之,探索性路径被堵死,模型只会走老路,导致熵坍塌。

奖励噪声 ​

奖励噪声

来源1:超长回答的粗暴惩罚

  • 超长了要惩罚、但生成内容又是对的,这就带来奖励困扰。直接给-1惩罚,有问题。

来源2:对复杂答案的解析识别错误

  • 模型可能给出逻辑相同的答案,但仅仅因为无法解析,导致错误。
  • DAPO:对数据做转换,所有答案都变成数字

训练不稳定 ​

问题背景

训练不稳定

核心方法 ​

📕核心方法

Clip-Higher ​

Clip-Higher

问题

  • 解决熵坍塌问题。

Clip-Higher:奖励时要重奖励、惩罚时要谨慎惩罚

  • 上下界由[1−ϵ,1+ϵ] 变成 [1−ϵlow,1+ϵhigh]
  • 保持下界ϵlow=0.2不变
    • 如果太大,模型惩罚错误时,会过于激进,抑制了探索。
  • 提高上界ϵhigh=0.28
    • 设置更高探索天花板,当探索到好路径时,策略可以大幅度更新。
  • Loss
LDAPO(θ)=−1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)
  • 目标函数
JDAPO(θ)=E(q,a)∼D,{oi}i=1G∼πθold(⋅∣q)[1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵlow,1+ϵhigh)⋅A^i,t)]

熵坍塌问题里的例子

  • 原始:0.01 * 1.2 = 0.012,概率从1% -> 1.2%,最多增长0.2
  • 现在:0.01 * 1.28 = 0.0128,概率1% -> 1.28%,最多增长0.28,比之前扩大了40%增幅

动态采样 ​

动态采样

GRPO 组采样问题

  • 如果采样到1组的Reward全为1或全为0,会导致优势全为0,导致梯度为0,训练无效。

动态采样

  • 采样:对每个问题,生成G个回答,
  • 评估:评估每个回答准确率
  • 过滤:过滤掉准确率为0或100%的问题及其答案
  • 重复1-3步

Token-Level Loss ​

Token-Level Loss

PPO/GRPO 标准Seq-Loss 缺点

  • 两层平均,对长度不敏感

    • 长序列token权重被稀释
    • 训练贡献度:长序列token << 短序列token
  • 长度不敏感后果

    • 导致模型更关注短序列优化
    • 忽略长序列token里的错误,导致难以学会处理长序列问题。
Lppo(θ)=−1G∑i=1G⏟样本间平均1|oi|∑t=1|ot|⏟序列内平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)

DAPO Token-Level Loss

  • 直接对所有Token做平均,每个token权重相同,不论来自长或短序列。
LDAPO(θ)=−1∑i=1G|oi|∑i=1G∑t=1|ot|⏟所有Token直接做平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)
python
def agg_loss(loss_mat: torch.Tensor, loss_mask: torch.Tensor, loss_agg_mode: str):
    """
    Aggregate the loss matrix into a scalar.

    Args:
        loss_mat: `(torch.Tensor)`:
            shape: (bs, response_length)
        loss_mask: `(torch.Tensor)`:
            shape: (bs, response_length)
        loss_agg_mode: (str) choices:
            method to aggregate the loss matrix into a scalar.
    Returns:
        loss: `a scalar torch.Tensor`
            aggregated loss
    """
    if loss_agg_mode == "token-mean":
        loss = verl_F.masked_mean(loss_mat, loss_mask)
    elif loss_agg_mode == "seq-mean-token-sum":
        seq_losses = torch.sum(loss_mat * loss_mask, dim=-1)  # token-sum
        loss = torch.mean(seq_losses)  # seq-mean
    elif loss_agg_mode == "seq-mean-token-mean":
        seq_losses = torch.sum(loss_mat * loss_mask, dim=-1) / torch.sum(loss_mask, dim=-1)  # token-mean
        loss = torch.mean(seq_losses)  # seq-mean
    elif loss_agg_mode == "seq-mean-token-sum-norm":
        seq_losses = torch.sum(loss_mat * loss_mask, dim=-1)
        loss = torch.sum(seq_losses) / loss_mask.shape[-1]  # The divisor
        # (loss_mask.shape[-1]) should ideally be constant
        # throughout training to well-replicate the DrGRPO paper.
        # TODO: Perhaps add user-defined normalizer argument to
        # agg_loss to ensure divisor stays constant throughout.
    else:
        raise ValueError(f"Invalid loss_agg_mode: {loss_agg_mode}")

    return loss

Overlong 奖励设计 ​

超长奖励设计

问题背景

  • 对超长回答,通常直接给-1惩罚

  • 若该回答很好,仅仅是超长。直接给-1,会有矛盾混淆,奖励噪声,干扰训练过程

    • 答案正确性奖励:分值高,你做的好
    • 长度惩罚:分值低,你做的差

Soft 超长惩罚

  • 设置cache长度Lcache和硬顶线Lmax,安全线等于Lsafe=Lmax−Lcache
    • 低于安全线,不惩罚;
    • 超过硬顶线,直接给-1.
    • 介于安全线和硬顶线之间,根据超出长度来计算惩罚,线性下降。
Rlength(y)={0|y|≤Lmax−LcacheLmax−Lcache−|y|LcacheLmax−Lcache<|y|≤Lmax−1|y|≥Lmax

数据转换 ​

数据转换
  • 收集数据并做格式转换,为了方便reward,把所有答案都转换成数字,最终17k数据集。
  • 格式转换
    • 转换前:输出复杂, 不好计算reward,如a+bc
    • 转换后:输出简单,方便计算reward,如a+b+c,如llm输出11+2+6=19即可。
    • 让llm去改写question

算法实验 ​

实验设置 ​

✍️实验设置

实验配置

任务

  • 数学

数据

  • 训练数据:DAPO-MATH-17K
  • 评测数据:AIME24,avg@32,temp=1.0, topp=0.7

算法

  • GRPO

模型

  • Qwen2.5-32B

超参设计

  • 1e-6,学习率;最初20 steps 线性warm up
  • Rollout 阶段:bs=512个prompt,rollout 16
  • Training 阶段:mini_bs=512,共16次梯度更新
  • 长度16k,cache 4k;硬顶线为20k
  • Clip-Higher:[1-0.2, 1+0.28]

关键结果 ​

🍑关键结果

关键结果
  • DAPO 效果和效率都很好。
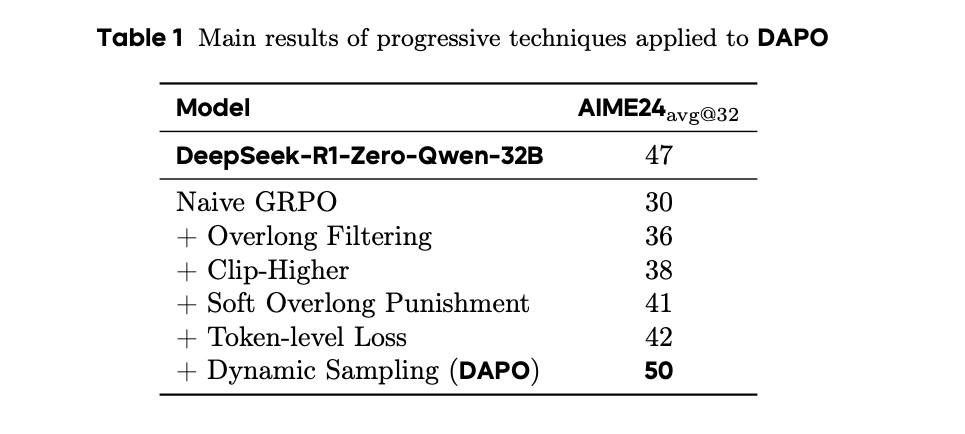
    • 基础GRPO算法仅30%准确率,DAPO 达50%,超过DeepSeek-R1-Distill-32B (47%)。
      • AIME24,Qwen2.5-32B 从0% -> 50%,。
    • 且仅需DS-R1 一半的训练步数。
  • 各重要组件的消融实验
    • 超长过滤、CLIP-Higher、Soft 超长惩罚都能带来6-11pt的提升。
    • DAPO 带来20pt提升。
  • RL 不仅仅是强化已知正确路径,更多是创造、涌现、新的推理模式。
    • 即探索的力量。

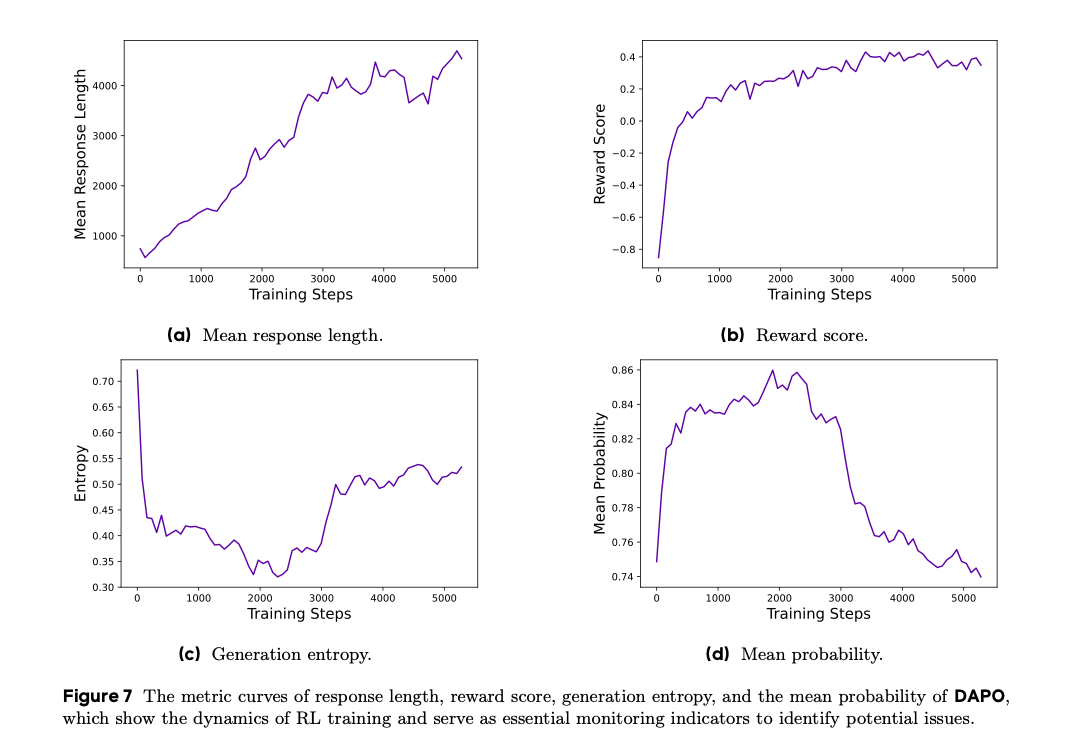
消融实验:

RL 训练观测三大指标 ​

RL 训练观测三大指标

回复长度

  • 和稳定性、性能相关;
  • 更长度代表更大探索空间:回复越长,越有机会探索复杂的推理链。
  • 健康趋势:缓慢、稳定增长。
  • 长度停止或下降:结合验证集准确率来看,可能训崩了。

Reward

  • 代表对任务的拟合程度。
  • 健康趋势:稳定增长。
  • 小心:过拟合。

熵

  • 和模型探索能力相关,代表创造力、不确定性,需要维持在一个合理范围。
  • 熵过低/熵坍塌:概率分布过于尖锐、导致探索能力下降。
  • 熵过高:过度探索、回答过于随机、胡言乱语。
  • DAPO:通过Clip-Higher,解决了熵坍塌问题;维持熵缓慢增长,有助于性能提升。
  • 健康趋势:缓慢、稳定增长。

未来方向 ​

⛳未来方向

未来方向
  • 涌现的机制是什么?
  • 如何更好地引导涌现?
  • 涌现是通用的吗?
  • 可解释性

(2503) Dr.GRPO ​

摘要

参考链接

问题背景

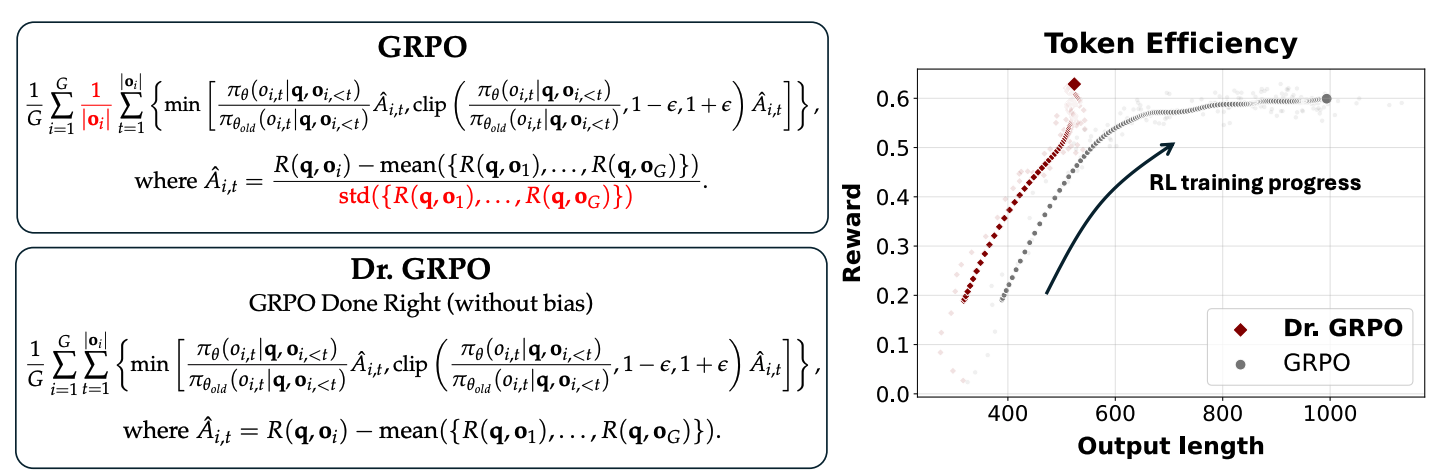
  • 针对回复变长但效果降低、性能提升不稳定的问题
  • 认为是GRPO里的长度偏置和优势除以标准差带来的问题难度偏置造成的。

核心方法

  • 提出Dr.GRPO,去掉序列内平均、优势不除以标准差,提升了Token效率,回复长度变短。

问题背景 ​

❓问题背景

R1-Zero背后的问题 ​

R1-Zero 背后的问题

类R1-Zero训练中的不稳定现象

  • 回复长度增加,但性能提升不稳定
  • 有时产生更长、更啰嗦的错误答案

R1-Zero存在问题需要探究

  • 性能提升来源是什么?
    • 激发潜在推理能力、还是预训练知识被激活
  • 回答变长一定是好事吗?
  • 基础模型扮演何种角色,不同基座对最终RL训练效果差别大吗?

GRPO里的偏差 ​

GRPO里的偏差 计算优势时引入Bias

回复长度Bias

LGRPO(θ)=1G∑i=1G⏟样本间平均1|oi|∑t=1|ot|⏟序列内平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)

问题难度Bias

  • 计算优势时 除以标准差。
    • 简单问题:方差小,标准差小,优势大,权重大。
    • 困难问题:方差大,标准差大,优势小,权重小。
  • 导致对于真正需要学习的困难问题,学习不足。
A^i,t=A^i=r^i=ri−mean(r)std(r)

核心方法 ​

去掉2个偏差:序列内平均偏差和优势标准差 ​

📕核心方法

Dr.GRPO

背景

  • 解决GRPO里的长度偏差和问题难度优势偏差问题。

核心思想

  • 去掉2个偏差项:去掉序列内平均、计算优势时不除以标准差。

公式

  • 去掉序列内平均,消除长度偏差
LDr.GRPO(θ)=1G∑i=1G∑t=1|ot|⏟仅样本间平均min(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t)⋅A^i,t,clip(πθ(oi,t∣q,oi,<t)πθold(oi,t∣q,oi,<t),1−ϵ,1+ϵ)⋅A^i,t)
  • 计算优势时,去掉除以标准差,消除问题难度偏差。困难问题一样有高优势权重,可以更新。A^i,t=A^i=ri−mean(r)

算法实验 ​

✍️实验设置

实验配置

模型

  • Qwen2.5-1.5B-Base, Qwen2.5-Base

任务

  • 训练数据:MATH Dataset
  • 评测数据:AIME24、AMC、MATH500、Minerva Math、OlympiadBench

算法

  • Dr.GRPO vs GRPO

🍑关键结果

关键结果
  • Dr.GRPO 修复了GRPO里的2个偏差,提升了token效率,输出回复更短,能有效抑制错误答案增长?
    • 回答变长是GRPO里优化算法的偏见,而非长思考?
  • 模板和基础模型不匹配,效果也不会好。
    • Qwen2.5-MATH-1.5B数学能力已经较好,强行套用R1模板,会损害性能。
  • 基座模型能力较弱时,先进行预训练,再进行RL,才能提升效果。

Token效率更高

⛳未来方向

未来方向

(2402) GRPO (DeepSeek Math) ​

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026