Skip to content

DeepSeek 系列

📅 发表于 2025/07/16
🔄 更新于 2026/08/05
👁️ — 次访问
📝 18930 字
⏳ 57 分钟
deepseek
#DeepSeek R1
#R1-Zero
#Native Sparse Attention

变化点 ​

2026

2026.09 · DeepSeek-V4.1-Flash

  • CED、CSA2 与低精度 KV Cache 降低长任务的 prefill 和缓存成本。
  • 扩展多模态预训练、自动任务构建、effort 条件 RL 与多教师 OPD。

2026.06 · DeepSeek-V4

  • CSA / HCA 压缩历史 KV,结合 mHC 与 Muon,扩展至 1M 上下文。
  • 领域 SFT/GRPO 后,以全词表多教师 OPD 整合能力;配套 FP4 QAT 与可恢复 rollout。
2025

2025.12 · DeepSeek-V3.2

  • 引入 DSA + Lightning Indexer,通过两阶段 CPT 学习稀疏注意力。
  • Scaling GRPO 稳定 RL;结合专家蒸馏与工具交互训练。

2025.10 · DeepSeek-OCR(视觉压缩分支)

  • 将文档编码为视觉 token,探索以图像压缩文本上下文。(model)

2025.08 · DeepSeek-V3.1

  • 统一 Thinking / Non-Thinking,长上下文继续训练扩展至 128K。
  • 强化工具与 Agent,调整多轮推理和工具调用格式。
2025(续)

2025.05 · DeepSeek-R1-0528

  • 扩大后训练计算并优化算法,提高复杂任务的推理深度。
  • 同时改进 Function Calling 与幻觉控制。(model)

2025.02 · Native Sparse Attention(架构研究)

  • 联合 压缩注意力 + 选择注意力 + 局部注意力,从训练阶段使用稀疏计算。
  • 按硬件访存特点设计选择与计算,减少长上下文开销。

2025.01 · DeepSeek-R1 / R1-Zero

  • R1-Zero 验证直接 RL 的推理能力;R1 加入冷启动与多阶段后训练。
  • 结合推理 RL、拒绝采样 SFT 和通用 RL,再蒸馏到小模型。
2024 及以前

2024.12 · DeepSeek-V3

  • 在 MLA、MoE 基础上引入 无辅助损失负载均衡,减少均衡目标对学习的干扰。
  • 结合 FP8 训练与 MTP,提高训练和生成效率。

2024.06 · DeepSeek-Coder-V2

  • 基于 DeepSeek-V2 做 6T tokens 代码 CPT,强化代码与数学能力。
  • 结合 FIM、代码 SFT 与 GRPO,扩展编程任务覆盖。

2024.05 · DeepSeek-V2

  • 以 MLA 压缩 KV Cache,DeepSeekMoE 用细粒度专家提高参数效率。
  • 形成低激活开销的 MoE 基座,后续代码与推理模型在此演进。

(2609) DeepSeek-V4.1-Flash (CED、CSA2、长任务 RL) ​

🌺 论文摘要

DeepSeek-V4.1-Flash 论文摘要

参考链接

  • paper、model。
  • DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression。

问题背景

  • 长任务输入远多于输出,重复 prefill、KV 存储和缓存恢复限制部署效率。
  • Agent RL 需要持续产生有难度、可验证的任务,并控制长轨迹的训练成本。

核心方法

  • 高效架构:CED 减少 prefill,CSA2 复用 KV/索引,FP4 与 SWA 回放压缩缓存。
  • 多模态预训练:视觉 encoder 两阶段训练,图文去重混合,45T tokens 联合预训练。
  • 任务与环境:训练任务构建模型,以真实失败、仓库任务驱动生成、试解、审查与修复。
  • 后训练:SFT → RL → 40+ 教师 OPD;effort 控制长度代价,多 Harness 异步 RL 扩大训练。

模型效果(DeepSeek-V4.1-Flash + SFT/RL/OPD,max)

  • 相对 V4-Flash,DeepSWE v1.1 54.4 → 74.2,Terminal-Bench 2.1 82.7 → 90.6。

重要结论

  • effort 在中等档位已获得大部分收益;继续增大预算,轨迹明显变长,提升逐渐减小。
  • 单一与多 Harness 的 RL 均随训练扩大持续提升,模型合并可整合不同训练路径。

核心贡献

  • 以低缓存成本支撑长任务,将自动任务生产、可恢复 rollout 和多教师训练整合到基模路线。

未来方向

  • 改进长上下文稀疏检索与缓存恢复的稳健性,继续扩大数据、模型和 RL。

问题背景 ​

长任务的计算成本与训练数据瓶颈

历史输入不断增长

  • Agent 每轮加入代码、工具结果与旧对话;缓存未命中时,需要重新处理大量历史。
  • 减少激活参数还不够:全局 KV、局部 SWA 与索引计算也要分别优化。

任务可运行,不代表奖励可靠

  • 任务描述、环境和测试不一致,会把环境错误或测试漏洞当成模型能力。
  • 长轨迹耗时不齐,同步等待拖慢训练;无限延长推理又会增加部署与 rollout 成本。

核心方法 ​

长上下文架构与缓存优化 ​

CED 与 CSA2:减少重复编码和历史访问

CED 分离编码与生成

  • 模型:552B Backbone + 196B Engram,20 层 encoder + 20 层 decoder。
  • decoder 的全局 KV 由 encoder 最后一层表示投影得到,长输入无需完整经过 decoder。
  • decoder 仍维护逐层局部 SWA;prefill 只补算输入末尾短窗口的局部状态。
  • 生成新 token 时运行两部分:prefill 激活 8B,decode 激活 16B。

CSA2 复用缓存与索引

  • Full:生成全局 KV 与索引,选择当前 query 要读取的历史位置。
  • Reindex:复用已有 KV,重新选择历史位置;Reuse:连已选位置也一起复用。
  • 各层仍计算自己的 query 和 SWA,复用全局历史不等于跳过本层注意力。
  • decoder 首个 Full 层扫描历史,选出最多 16384 个候选位置;后续层只在其中取 Top-512。
  • 分层索引在后训练中加入,训练与推理采用相同候选限制,减少长上下文的重复扫描。
CSA2 的 Full、Reindex、Reuse 三种模式。重点看 KV 与 Top-K 索引在哪些层重新计算、在哪些层复用。
原文图 4:CSA2 的 Full、Reindex、Reuse 三种模式。重点看 KV 与 Top-K 索引在哪些层重新计算、在哪些层复用。 来源
FP4 KV 与 SWA Bounded Replay

全局 KV 长期保存

  • CSA2 跨层共享 KV,再通过后训练 FP4 QAT 适应低精度缓存。
  • 在 RoPE 后量化全局 KV;局部 SWA 对精度更敏感,保留 FP8。
  • 全局 KV 放入持久缓存;活跃会话的 SWA 放入短 TTL 的内存池,及时回收。

局部状态按需重建

  • SWA 跨层依赖累积,精确恢复需要回放 层数 × 窗口长度 的历史。
  • Bounded Replay:只回放末尾 128 tokens,以近似局部状态换取较低恢复成本。
  • encoder 恢复时复用已有全局 KV,只重建局部 SWA;新输入再正常生成两类 KV。
  • decoder 的短窗口回放同样避免重新处理整个长输入。
条件记忆与计算融合

Engram 条件记忆

  • 使用 2/3/4-gram 多头哈希查表,经上下文门控融合,分离记忆存储与主干计算。
  • 推理地址由输入 token 决定,可提前从主机预取;RL rollout 中表驻留 GPU。
  • 相对原 Engram 去掉短因果卷积,以减少收益较小的推理复杂度。

Single-Pass mHC

  • 当前 block 使用上一 block 预测的输入混合系数,解除“先预测系数、再重读输入”的依赖。
  • Mega-mHC 合并残差更新、输入混合与下一组系数预测,减少激活读写。
DSpark:自适应投机解码

草稿生成与验证

  • 3 个轻量 block 一次生成 5 个位置的草稿分布,Markov head 补充草稿间依赖。
  • confidence head 预测逐位置接受概率,估计连续草稿能够保留多长。
  • 调度器结合当前负载与引擎吞吐,选择验证长度,避免一律验证同样多的草稿。

训练衔接

  • 主干预训练结束后,冻结主干,单独训练 DSpark。
  • 后训练继续更新 DSpark,使其跟上策略变化;DSpark loss 不反传主干。
  • 同一模块同时加速线上生成与 RL/OPD 的 rollout。

多模态数据与预训练 ​

语料清洗与图文混合

文本数据的有效信息量

  • 用模型规模与数据规模的对照实验调整语料配比,结合领域专家细化质量维度。
  • 清除弱模型生成内容、低质量机器翻译等“改写式重复”,避免大量 token 只重复旧信息。
  • 更新代码仓库、commit、依赖库与框架数据,覆盖更接近真实开发的新知识。

多模态数据分级处理

  • 图文对:网页图片 + alt text,经相关性过滤、图像语义去重。
  • 交错图文:先筛选网页/PDF,再下载图片、重组图文、再次去重,最后用 SmolVLM 评分。
  • 将部分淘汰文档重新筛选组合成图文对,减少可用内容浪费。
  • 补充 OCR、grounding、长尾知识、图像—代码配对与 Computer-Use 轨迹。
  • 合并文本与多模态语料;重叠样本优先保留图文版本,最终 token 配比约 7:1。
视觉 encoder 的两阶段训练

低分辨率对比学习

  • 从头训练 DeepSeek-ViT,采用 2D-RoPE、线性 patch projection、RMSNorm 与 SwiGLU。
  • 用约 47B 图文对做 SigLIP 对比训练,分辨率上限 224×224。
  • 这一阶段先扩大视觉知识覆盖;高分辨率带来的早期收益,对最终模型帮助有限。

高分辨率自回归学习

  • 接入临时 4B MoE,用 236B tokens 的描述、图表、OCR 等材料预测文本。
  • 分辨率提高到 544~1344,学习细粒度视觉特征;完成后丢弃临时 LLM,保留 ViT。
  • 通过 3×3 pixel-unshuffle 将视觉 token 减至 1/9,再投影到正式 Backbone。
原生多模态预训练与参数更新

联合训练与长上下文

  • 正式语言模型从开始就混合图像与文本,共训练 45T tokens。
  • 初期冻结 ViT,仅训练其末层归一化与 projector;学习率衰减阶段解冻 ViT,小学习率联合更新。
  • 从 64K 长度的稀疏注意力训练起步,在 34T tokens 时扩展到 1M。
  • 超长文档预切分、统一分配预训练与扩展样本,再进行 packing,减少重复与 padding。

不同参数采用不同更新方式

  • 线性矩阵用 Muon;Q/K 按 head 分别更新,适应不同注意力头的梯度差异。
  • Engram/embedding/输出头用动量 + Sinkhorn 行列归一化,减少 Adam 的状态显存。
  • Norm 等非矩阵参数保留 AdamW;图像和文本分别调整 MoE 路由偏置,避免总负载掩盖单模态失衡。

Agent 任务与环境构建 ​

任务构建模型与质量闭环

任务定义与生成奖励

  • 一个任务由 问题 + 环境 + 验证系统 组成,同时生成参考解和奖励信号。
  • 难度:任务需有挑战;正确性:三部分无关键错误,任务要求与验收一致。
  • 用难度和正确性作为奖励,迭代训练任务构建模型,提高自动出题与质量检查能力。

任务持续复审

  • 合成后进行过滤、去重和难度校准,保持任务多样性与课程平衡。
  • 每轮 RL 的新轨迹再次用于审查旧任务,发现新的环境错误或可利用漏洞。
  • 作者将本轮后训练的主要收益归于任务规模、多样性与可验证性,而非新优化算法。
General Agent:真实工作流与失败重放

还原工具接口

  • 收集员工与外部合作方自愿反馈的实际工作交互,覆盖 SaaS、企业应用和业务后端。
  • 从交互中还原输入格式、输出结构、API schema 与行为约束,构建可控的 mock 工具。

针对失败补任务

  • 汇总负面反馈与失败案例,重建当时的工具上下文、用户交互方式和触发条件。
  • 生成单轮或多轮训练环境,重复检验同类失败,并对已暴露的能力弱项开展 RL。
Coding Agent:仓库任务生产流程

任务来源与环境搭建

  • 来源:真实 coding session 中的复杂/低表现任务,以及达到 star 门槛的 GitHub 仓库。
  • 筛选:真实 session 按轨迹去重;先确认仓库能在容器中构建、运行、自动验证。
  • 任务设计 Agent:选定起始 turn/commit,设计实现目标与 fail-to-pass / pass-to-pass 检查点。
  • 环境搭建 Agent:安装依赖、准备初始目录/测试/描述,自测后删除答案痕迹,打包镜像层。

多 Agent 试解与独立审查

  • 多个 Agent 分别尝试解题,暴露描述歧义、环境问题及真实难度。
  • 独立质检 Agent:结合环境与试解轨迹,检查事实错误、任务—测试不匹配和 reward hacking。
  • 修复 Agent:修正缺陷,调整过易/过难的检查点,再重新验证。
  • 验证通过的任务进入 RL;后续训练轨迹继续为任务复审提供证据。

可控推理 RL 与多教师蒸馏 ​

SFT 初始化与多 Harness RL

后训练分工

  • SFT:监督初始化;随后在合成任务与环境中做 RL,最后以 OPD 汇总各领域能力。
  • RL 扩展:增加训练计算量,同时训练同一 Harness 的多个版本及不同 Harness。
  • 模型合并:合并不同 Harness/配置得到的 checkpoint,重新初始化下一轮 RL,整合并行训练所得。

跨 Harness 统一采样

  • Agent sandbox 运行原生 Harness 和工具;worker 控制 rollout,将交互整理成统一轨迹。
  • 两者放在 DSec,脱离可抢占的 GPU 训练池;Trainer 更新参数不要求重启整个任务环境。
  • 因而可以扩大工具、交互协议与上下文管理方式的覆盖,减少只适应单一 Harness 的问题。
Effort-conditioned RL:学习质量与长度的取舍

同一模型接受不同推理档位

  • 目标:输出长度影响部署与 rollout 成本,让同一模型学习不同的质量—成本取舍。
  • system prompt 加入 Reasoning Effort: b,b∈[1,100];数值越高,允许更充分的推理。
  • 对同一题目 x,在若干 effort 档位分别采样多条回答;单轮推理与多轮 Agent 都采用这一机制。
  • 保留原任务奖励,再加入长度惩罚;改变的是训练时的计算代价,不是到指定 token 数就强制截断。

长度奖励

rb,jlen=−min{Cmax,k(b)ℓb,jLnorm},k(b)=k0exp⁡(−b−bminτ)
  • ℓ 是推理 token 数,L_norm 为参考长度,C_max 限制一条轨迹的最大扣分。
  • 蓝色 k(b) 决定单位长度的代价:低 effort 扣得重,高 effort 扣得轻。
  • k₀ 控制整体精简压力;τ=λ·平均档位间隔,τ 越小,档位间的惩罚差异越大。
  • 正确性等任务奖励仍保留,模型需权衡额外推理带来的收益与代价。
同题同档比较:优势的参照条件一致

组内优势

  • 只有相同 (题目 x, effort b) 的样本属于一组,组内奖励减均值后得到相对优势。
  • 将原任务奖励记为 r_task,总奖励为 r=r_task+r_len,中心化形式为:
Ab,j=rb,j−1Mb∑j′=1Mbrb,j′(固定同一题目与 b)
  • 跨档位的长度代价不同,直接混组会把奖励尺度差异带入优势;同档比较才是在相同代价下选策略。
  • 高 effort 也不会无条件奖励长回答,只有额外质量收益足以抵消长度代价,才值得多推理。

示例:仅演示奖励含义

  • 两个候选:短回答 1K tokens / 任务分0.85,长回答 3K tokens / 任务分1.0。
  • 设 L_norm=1K 且未触及惩罚上限;低档 k=0.2,总奖励为 0.65 / 0.40,偏好短回答。
  • 高档 k=0.05,总奖励变为 0.80 / 0.85,额外正确性收益足以支持长回答。
  • 两个档位分别做组内比较,学习到各自的质量—成本取舍。
指数惩罚与部署控制

指数形式的动机

  • 附录假设额外推理的边际收益逐渐下降;合理长度位于“边际解题收益 ≈ 单位 token 代价”处。
  • 若边际收益近似指数下降,让 k(b) 也指数下降,可使偏好的推理长度随 effort 近似平滑增长。
  • 这解释了惩罚曲线的设计;实际轨迹仍由题目难度、工具交互与推理策略共同决定。

同一 checkpoint 的档位选择

  • 训练只使用有限档位,部署可以输入中间值;API 的 low / high / max 对应 50 / 75 / 100。
  • 无需切换模型权重,便可调整探索、验证与推理开销。
异步 rollout:控制长尾、长度偏置与旧策略数据

按完成样本补充并发

  • rollout 与训练共用 GPU、分时执行;完成样本数达到下一题所需组大小,就派发下一题。
  • 不必等某个最慢题组结束;调度时统计不同组的完成数,不改变优势计算时的题组归属。
  • 数据足够即抢占 rollout;保存 token 级 KV、路由和执行状态,切换 checkpoint 后继续。

异步带来的两类偏差

  • 短样本先完成:按数据集限制并发,必要时丢弃启动阶段过早返回的短样本,避免初期只学短回答。
  • 样本来自旧策略:通过派发/等待条件约束策略滞后,mask 过旧 token 的训练 loss。
  • 跨 checkpoint 的 MoE 路由:拼接各采样片段实际使用的路由,Trainer replay 不重新改路由。
全词表 OPD:汇总 40+ 领域教师

教师选择与监督方式

  • 单个 RL run 未必同时得到各领域最优能力;最终 OPD 汇集所有领域数据与 40+ 教师。
  • 每个领域的最佳教师可来自不同训练阶段,教师间及师生间允许采用不同架构。
  • On-policy:学生生成自己的前缀,教师在这些前缀上提供下一 token 分布监督。
  • 全词表监督:利用教师对所有 token 的相对偏好,而非仅模仿一份固定最终答案。

异步训练中的动态调整

  • 持续追踪学生能力,调整数据配比、各数据集并发与教师选择。
  • 教师高效切换;新旧配置的样本可同时在途,系统保证配置过渡一致,不中断训练。
DSec 沙箱与 Agent Team 训练

可恢复、可隔离的环境执行

  • DSec 按机器分片;调度器近似估计资源,节点做最终准入,避免集中协调成为瓶颈。
  • VM 绑定 NUMA 域,限制容器资源影响范围;敏感延迟任务与后台任务隔离调度。
  • 按沙箱限制文件权限与网络,防止取答案、修改系统等 reward hacking;破坏环境记失败轨迹。
  • 任务被抢占时保留完整环境与执行状态,释放计算资源后仍能恢复。

Agent Team 的协作奖励

  • 主 Agent 分派任务,持久化子 Agent 共享仓库,通过 mailbox 交换进度与结果。
  • RL 同时考虑任务效果、委派/通信奖励与延迟惩罚,学习有用的并行协作。
  • 延迟按执行依赖 DAG 的关键路径计算,节点成本来自固定速率 token 开销与实测工具耗时。
  • 避免把服务排队、批处理波动全算成模型责任,同时惩罚无效串行与同步等待。

实验设置(多模态预训练 + SFT/RL/OPD) ​

模型训练配置

预训练

  • 总量 45T tokens,batch=100.6M tokens;序列长度 64K → 1M。
  • warmup=2000 steps;lr=2.6e-4 保持到 28T,余弦衰减至 40T,再以 2.6e-5 训至 45T。
  • 每层 1 个共享专家 + 384 个路由专家,每 token 激活 6 个路由专家。
  • Muon momentum=0.95, wd=0.1;Engram 学习率按主干的 5× 缩放。

后训练

  • SFT → 合成任务 RL → 全词表 OPD,最后阶段汇集 40+ 教师与各领域数据。
  • RL 比较单一 Harness、多版本及多类 Harness,并通过 checkpoint 合并开启后续训练。
  • SFT 的样本量与超参未公开。
基模、Agent 与多 Agent 评测

评测对象与采样

  • Base:比较 V4-Flash-Base、V4-Pro-Base 与 V4.1-Flash-Base,使用相同内部评测框架。
  • 推理任务:GPQA、HLE、Codeforces、MathArena,temperature=1, top_p=1。
  • Coding Agent:通常用 DSH Minimal,context=1M, temperature=1, top_p=0.95。
  • DeepSWE 使用 mini-SWE;跨 Harness 对照保持 checkpoint、解码配置、任务集不变。
  • DeepSWE 每题 8 次采样,Terminal-Bench 2.1 每题 3 次,最多 500 轮生成。

环境与多 Agent 对照

  • Coding 评测限制网络、移除 Git 历史与临时构建缓存,减少外部答案与验证漏洞干扰。
  • ProgramBench 保留参考解通过率至少 95% 的 172 题,按固定时间截止比较单/多 Agent。
  • ProgramBench 以单次 rollout 得分至少 0.95 计入 Almost@1;FrontierSWE v2 使用无 GPU 子集。

关键结果(DeepSeek-V4.1-Flash,Base 与 SFT/RL/OPD) ​

基模能力与缓存成本

Base 能力并非只靠后训练获得

  • 相对 V4-Flash-Base,MMLU-Pro 68.3 → 74.1,HumanEval 69.5 → 79.4。
  • 对比更大的 V4-Pro-Base,HumanEval 76.8 → 79.4,但 LongBench-V2 仍为 51.5 → 45.2。
  • 说明较低激活量下多项能力已接近大模型;长文本困难题仍有明显改进空间。

缓存压缩的来源

  • 全局 KV 约 890 bytes/token,为 V4-Flash 的约 1/4,来自跨层共享与 FP4 压缩。
  • 持久 KV 再移除 SWA 常驻,降至约 1/8;这是存储节省,不能直接当作端到端速度倍率。
Agent 能力与训练扩大

最终模型(max)

  • DeepSWE v1.1 54.4 → 74.2,Terminal-Bench 2.1 82.7 → 90.6,相对 V4-Flash 改善仓库与终端任务。
  • AutomationBench 37.7 → 54.8,Agents’ Last Exam 25.2 → 31.8,收益也覆盖通用工具任务。
  • 较难的 Terminal-Bench 4.0 得分 31.2,仍低于 Opus-5 的 51.8。

训练计算与 Harness 都有影响

  • Fig.7/8 中,增加 RL 步数持续改善单一、多版本及多类 Harness 表现。
  • 上下文扩展到 1M 后,极长任务继续获益;合并不同训练路径的 checkpoint 后还能继续提升。
  • 同一最终模型在 DeepSWE 上,mini-SWE 74.2、Claude Code 69.8、Codex 65.6。
  • 跨 Harness 可迁移,但效果仍取决于交互协议与上下文管理,模型和 Harness 需要联合优化。
Effort 与并行协作的收益

推理预算有边际递减

  • effort 25 → 100,DeepSWE 66.0 → 74.2,Terminal-Bench 2.1 82.4 → 90.6,输出约增加 2.5×。
  • 中间档位已获得大部分精度收益;最高档更适合困难任务,不宜将更长轨迹直接理解为更高效率。

多 Agent 在相同截止时间下提高完成质量

  • ProgramBench 8小时:单 Agent Almost@1 20.39%,多 Agent 30.04%。
  • FrontierSWE v2 20小时:单 Agent Mean@5 28.20%,多 Agent 32.90%。
  • 结果说明协作能在固定时间内完成更多有效工作;此处约束时间,没有对齐两者总 token 消耗。
Effort 同时改变任务正确率和输出长度。实线看 Pass@1、虚线看 token 用量,比较不同任务的精度收益与计算增长。
原文图 9:Effort 同时改变任务正确率和输出长度。实线看 Pass@1、虚线看 token 用量,比较不同任务的精度收益与计算增长。 来源

未来方向 ​

未来方向
  • 稀疏检索:扩大极长上下文压力测试,识别 CSA2 候选遗漏导致的能力下降。
  • 缓存恢复:检验 SWA 近似回放在不同缓存命中位置、会话边界与真实负载下的稳健性。
  • 困难任务:改进已趋饱和的评测,继续研究大规模任务合成、数据/模型/RL 协同扩展。
  • 模型与 Harness:联合优化交互协议、工具和训练环境,提高复杂任务能力与部署效率。

(2606) DeepSeek-V4 (CSA/HCA、百万上下文、全词表 OPD) ​

🌺 论文摘要

DeepSeek-V4 论文摘要

参考链接

问题背景

  • 长推理、跨文档分析与 Agent 交互不断增加上下文,Attention 计算和 KV Cache 限制扩展。
  • 多领域 RL 专家各有所长,需要把知识、推理、代码和 Agent 能力整合到同一个模型。

核心方法

  • 架构优化:CSA 压缩后稀疏选择 + HCA 高压缩全量注意力,配合 mHC 与 Muon。
  • 预训练:Flash 32T、Pro 33T;增强长文档与多语言数据,MidTrain 加入 Agent 数据,扩至 1M。
  • 领域后训练:专家分别 SFT → GRPO,最终用 十余教师全词表 OPD 整合能力,替代混合 RL。
  • 长轨迹系统:FP4 QAT、可恢复 rollout、DSec 沙箱,支持百万上下文 RL 与 OPD。

模型效果(DeepSeek-V4-Pro-Max,SFT + GRPO + OPD)

  • 代码与 Agent:LiveCodeBench v6 93.5,SWE-bench Verified 80.6,Terminal-Bench 2.0 67.9。
  • 长上下文效率:1M 时单 token FLOPs 为 V3.2 的 27%,KV Cache 为 10%。

重要结论

  • Flash 增加思考预算后,数学推理可接近 Pro;知识与复杂 Agent 任务仍存在明显差距。
  • 更长思考对高难推理更有效;部分 Agent 指标从 High 到 Max 的收益较小。

核心贡献

  • 给出百万上下文基模的完整训练与部署方案,公开 Pro、Flash 权重及推理实现。

未来方向

  • 简化混合架构、研究 MoE 训练稳定性,继续改进长程 Agent、多模态和数据构建。

问题背景 ​

长上下文的计算与训练成本
  • Attention 成本持续增长:长 CoT 与 Agent 历史增加计算、缓存和重复 prefill 开销。
  • 稀疏选择仍保存大量历史:V3.2 的 DSA 减少读取位置,V4 进一步沿序列维压缩 KV。
  • 多领域训练相互影响:分别训练专家,再把专家能力蒸馏进统一模型。
  • 长轨迹容易中断:抢占与故障会打断采样,从头重采还会偏向更容易完成的短回答。

核心方法 ​

长上下文架构与缓存优化 ​

CSA 与 HCA 混合注意力

CSA:压缩后选择相关历史

  • 将 KV 序列压至 1/4,用可学习权重聚合相邻、重叠窗口,保留跨块信息。
  • Lightning Indexer 对压缩条目打分;Flash 取 Top-512,Pro 取 Top-1024。
  • 主 Attention 只读取选中的压缩 KV;所有 Query Head 共享这组 Key/Value。

HCA:高压缩保留全局信息

  • 每 128 tokens 压成一个 KV 条目,对全部压缩条目计算 Attention。
  • CSA、HCA 交替使用;均补充 128-token SWA,保留最近 token 的细粒度信息。
  • 压缩分支只访问此前完成的块,SWA 补足当前块信息,保持因果约束。
  • Attention Sink 允许某个 Head 降低总注意力权重,避免强行从历史中提取无关信息。
mHC 与 MoE

mHC:扩展残差流并约束数值增长

  • 将残差流扩成 4 路,分别学习层输入混合、残差传递与层输出分配。
  • 用 Sinkhorn-Knopp 将残差映射约束为双随机矩阵,行、列权重和均为 1。
  • 约束让跨层传递不持续放大信号;主体 Attention、FFN 的隐藏维度保持不变。

DeepSeekMoE 与 MTP

  • 每层含共享专家与路由专家;每个 token 激活 6 个路由专家,前 3 层采用 Token-ID Hash Routing。
  • 延续无辅助损失负载均衡,另加小权重的序列内均衡项,避免单条序列极端偏载。
  • 保留 V3 的 MTP 训练目标;Query、KV 的 RMSNorm 抑制 Attention Logits 爆炸。
异构 KV Cache 与前缀复用

压缩缓存与局部状态分开管理

  • CSA/HCA:保存随序列增长的压缩 KV;RoPE 维用 BF16,其余维用 FP8。
  • State Cache:每个请求保留固定大小的 SWA KV,以及尚不足一个压缩块的尾部状态。
  • 压缩 KV 落盘后可复用相同前缀,只重算末尾尚未完成压缩的 token。

SWA 缓存的空间与重算取舍

  • 完整保存:读出命中位置的最近窗口,重算最少,但磁盘写入量大。
  • 周期快照:每隔一段序列保存窗口状态,从最近快照继续计算。
  • 不保存 SWA:复用压缩 KV,重算末尾 窗口长度 × 层数 范围以恢复状态。

预训练数据与稳定训练 ​

数据构建与上下文扩展

高质量语料

  • 网页过滤:移除批量自动生成、模板化内容,降低重复低质内容引起的模型退化。
  • 数学与代码:作为核心训练语料,在 MidTrain 引入 Agent 数据,增强代码交互能力。
  • 多语言与长文档:扩大跨文化长尾知识,优先纳入论文、技术报告等有独特信息的长文本。

预处理与训练阶段

  • 沿用 V3 的 token-splitting、FIM,加入上下文构建特殊 token,词表保持 128K。
  • 按合适长度打包不同来源文档,减少截断;用 sample-level attention mask 隔离不同样本。
  • 长度按 4K → 16K → 64K → 1M 扩展,Flash 最初 1T tokens 使用 Dense Attention。
  • 在 64K 阶段引入稀疏注意力:先短暂预热 Indexer,再联合训练稀疏模型。
Muon 与 MoE 稳定性

Muon 优化器

  • 大部分矩阵参数采用 Muon;Embedding、预测头、RMSNorm 等保留 AdamW。
  • 对动量更新做正交化:前 8 次 Newton-Schulz 快速收敛,后 2 次将奇异值稳定到 1。
  • 按更新矩阵 RMS 缩放,复用原有学习率配置;分配 ZeRO 参数时保持矩阵完整。

异常路由与激活抑制

  • Anticipatory Routing:提前用旧参数算好未来 Batch 的路由,当前主干更新复用这些 Expert Index。
  • 将路由与主干的同步变化分开,缓解路由与 MoE 异常值相互放大的循环。
  • 检测到 Loss Spike 后短暂回退并启用该策略,稳定后恢复普通训练。
  • SwiGLU Clamping:线性分支限制在 [-10, 10],Gate 上界设为 10,抑制激活离群值。

领域 RL 与多教师 OPD ​

领域专家与分档推理

SFT → GRPO

  • 数学、代码、Agent、指令遵循等领域分别训练专家,先用高质量领域数据 SFT。
  • 再用领域 Prompt、奖励与 GRPO 强化对应能力。
  • 可验证任务:测试用例或规则 Verifier 评分;难以验证的任务使用 rubric 引导的生成式奖励。

推理预算与 Generative Reward Model

  • 按不同长度惩罚与上下文窗口训练专家,形成 Non-think、Think High、Think Max 三档。
  • Max 使用更弱长度惩罚和更长上下文,训练模型投入更多推理计算。
  • GRM:Actor 同时承担生成和判断角色,按 rubric 推理评分,并通过 RL 提升判断能力。
  • 用少量、多样的人类标注监督评分能力,将模型自身推理用于开放任务评估。
Agent 交互与思考保留

Interleaved Thinking

  • 工具场景:保留全部历史 thinking,跨工具返回、跨新用户消息连续累积任务状态。
  • 相比 V3.2,避免新用户消息清空推理后,模型重新构造已有计划与判断。
  • 普通对话:新用户消息到来后仍移除旧 thinking,保持上下文简洁。

工具接口与辅助任务

  • 使用 DSML + XML 表达工具名和参数,减少转义失败和格式错误。
  • Quick Instruction:专用 token 触发搜索判断、Query 生成等辅助任务,复用已算 KV。
  • Query、来源权威性、领域识别等可并行执行,减少额外小模型的重复 prefill。
全词表 On-Policy Distillation

十余教师整合为一个学生

  • 按数学、代码等任务选择对应专家,由学生生成轨迹,教师在学生实际前缀上提供分布。
  • 优化学生到教师的 Reverse KL,将不同领域、不同推理预算的能力整合到统一参数。
  • V4 用这一阶段替代 V3.2 的最终混合 RL。

完整分布监督

  • 单个采样 token 的 KL 估计方差较大;V4 对全词表 logits 计算 KL,稳定蒸馏梯度。
  • 教师权重按需加载,只缓存最后一层 Hidden State;训练时用对应预测头重建 logits。
  • Batch 按教师编号整理,GPU 同时只驻留一个教师预测头,避免保存所有教师的完整词表分布。
LOPD(θ)=∑iwiDKL(πθ∥πEi),y∼πθ.
  • 红色 KL 对齐学生与领域教师,w_i 为领域教师权重;蓝色学生分布提供轨迹。
  • 教师监督学生实际会访问的生成前缀,将各领域能力整合到同一学生。

百万上下文 RL 与执行系统 ​

低精度训练与采样一致性

FP4 QAT

  • 后训练阶段量化 MoE Expert 权重 与 CSA Indexer QK,教师和 Reference 也适配量化。
  • Trainer 将 FP32 主权重量化到 FP4,再转为 FP8 计算;通过 STE 将梯度传回主权重。
  • Rollout、部署直接运行原生 FP4 权重,使采样行为与线上推理保持一致。

Batch Invariance 与长序列训练

  • 固定 Attention、GEMM 的累加顺序,减少 Batch 划分改变带来的逐位输出差异。
  • Rollout 数据拆成轻量元数据与逐 token 数据;先全局 Shuffle/Packing,再按 Mini-Batch 加载重数据。
  • MegaMoE 将专家拆成小批次流水执行,重叠 Dispatch、计算与 Combine,缓解长尾小 Batch 开销。
可恢复 Rollout 与 DSec 沙箱

中断后继续原轨迹

  • 每生成一个 token 就写入 WAL;被抢占时保存未完成请求的 KV Cache。
  • 恢复时继续解码;硬件故障丢失 KV 时,从 WAL 中的已有 token 重建缓存。
  • 保留原前缀,避免把未完成长回答全部重采而引入短序列偏差。

环境执行与状态恢复

  • DSec 统一 Function Call、Container、microVM、fullVM,覆盖函数调用到完整代码仓库执行。
  • 镜像分层存储、按需加载,降低大量不同环境的启动与存储成本。
  • 按顺序记录命令和结果,恢复时回放已完成结果,避免重复执行产生副作用。
  • 沙箱状态与 rollout 恢复配合,支持长时间、多轮工具交互。

实验设置(32T/33T Pretrain + SFT/GRPO/OPD) ​

模型与训练配置

基础模型与预训练

  • Flash:284B-A13B,43 层;32T tokens,峰值 lr=2.7e-4,最大 bs=75.5M tokens。
  • Pro:1.6T-A49B,61 层;33T tokens,峰值 lr=2e-4,最大 bs=94.4M tokens。
  • Flash 前 2000 步预热;学习率大部分时间保持恒定,末期余弦衰减至峰值的 1/10。
  • 两者训练长度均扩至 1M;领域专家 SFT + GRPO 后,用十余教师 OPD 整合。

Base 评测

  • 对比 V3.2-Base、V4-Flash-Base、V4-Pro-Base,统一内部评测框架与各任务条件。
  • 覆盖知识、数学/代码、语言理解与 LongBench-V2。
后训练模型评测

推理、代码与长上下文

  • 推理 temperature=1;Non-think、High、Max 的上下文上限分别为 8K、128K、384K。
  • 代码使用 LiveCodeBench v6;Codeforces 收集 14 场比赛、114 道题,按多次提交协议计算 Rating。
  • 1M 上下文使用 MRCR、CorpusQA,并重新评测 Opus 4.6 与 Gemini 3.1 Pro。

Agent 与真实研发任务

  • SWE-bench Verified、SWE-Pro、SWE Multilingual、Terminal-Bench 2.0 使用内部 bash + file-edit Harness。
  • Code Agent:max_steps=500,max_context=512K。
  • 搜索使用 websearch + Python,相同交互与上下文上限;BrowseComp 使用 discard-all 上下文管理。
  • 内部研发从 50+ 工程师收集约 200 题,筛选 30 题,保留仓库、运行环境与人工 rubric。

关键结果(DeepSeek-V4 Flash / Pro,Base 与 SFT/GRPO/OPD) ​

基模质量与长上下文效率

更小 Flash 仍提升多项基础能力

  • 相比 V3.2-Base,Flash 激活参数从 37B 降至 13B。
  • HumanEval 62.8 → 69.5,LongBench-V2 40.2 → 44.7;但 BigCodeBench 63.9 → 56.8。
  • Pro 进一步提升知识与长上下文:SimpleQA-Verified 55.2、LongBench-V2 51.5。

1M 上下文的成本与效果

  • 相比 V3.2,Pro 单 token FLOPs 降至 27%、KV Cache 降至 10%;Flash 分别为 10%、7%。
  • MRCR 长度增加到 128K 之后性能开始下降,支持 1M 窗口仍需关注有效检索能力。
  • 上下文上限 1M 的基准中,Pro-Max 的 MRCR、CorpusQA 分别为 83.5、62.0,高于 Gemini 3.1 Pro。
推理预算与 Agent 能力

Think High → Think Max

  • Pro:LiveCodeBench 89.8 → 93.5,HLE 34.5 → 37.7,复杂推理继续受益。
  • Flash:HMMT 91.9 → 94.8,接近 Pro-Max 的 95.2;SimpleQA 仍为 34.1,低于 Pro-Max 57.9。
  • Flash Agent:SWE-bench Verified 78.6 → 79.0,Terminal-Bench 56.6 → 56.9,增加思考收益有限。

复杂代码任务仍依赖模型能力

  • Pro-Max 的 SWE-bench Verified 80.6,接近 Opus 4.6 Max 的 80.8。
  • Terminal-Bench 2.0:Flash-Max 56.9、Pro-Max 67.9;Pro 的复杂执行能力更强。
  • Pro-Max 的 SWE-Pro 55.4、Toolathlon 51.8,仍低于 GPT-5.4 xHigh 的 57.7、54.6。
  • 内部研发 30 题中,Pro-Max 通过率 67%,Sonnet 4.5 为 47%,Opus 4.5 Thinking 为 73%。
搜索与中文实际任务

迭代搜索优于一次检索

  • 同模型内部 869 题比较中,Agentic Search 胜率 61.7%,RAG 胜率 18.3%。
  • 平均 prefill 从 10453 增至 13649 tokens;多次搜索、读取与综合提高复杂问答质量。

写作能力与复杂约束

  • 中文实用写作对 Gemini 3.1 Pro,Pro 胜率 62.7%,对方为 34.1%。
  • 复杂指令、多轮写作对 Opus 4.5,Pro 胜率 45.9%,对方为 52.0%,约束遵循仍有差距。

未来方向 ​

架构、稳定性与 Agent
  • 简化架构:系统研究各组件的必要性,保留关键设计,减少混合结构复杂度。
  • 训练稳定性:解释 Anticipatory Routing、SwiGLU Clamping 的作用机制,增强异常监控与预测。
  • 稀疏与低延迟:探索更稀疏 Embedding、低延迟架构与系统,改进长上下文交互效率。
  • 能力扩展:继续长程多轮 Agent、多模态,以及更好的数据筛选和合成。

(2512) DeepSeek-V3.2 ​

🌺 论文摘要

DeepSeek-V3.2 摘要

参考链接

问题背景

  • 开源和闭源差距越来越大,闭源模型性能提升很快 复杂任务能力很强。
  • 主要问题:架构长文本太贵太慢、后训练资源投入不足、Agent效果不足

核心方法

  • DeepSeekSparse Atteention:Ligntning Indexer 细粒度Token Topk选择器

  • DSA 2阶段预训练:2.1B Dense预热 + 943B Sparse预训练。

  • Scaling GRPO 算法

    • IS权重优化KL3估计、Mask异策略负样本、保持路由和采样Mask 消除训推不一致。
  • 后训练:专家蒸馏 + 混合RL训练。

    • 设计工具调用+推理思考的上下文管理
    • 设计Search+Code+数学逻辑+代码工具+General四大Agentic任务构建过程

模型效果

  • DeepSeek-V3.2 在推理任务上的性能与 GPT-5-high 相近,略低于 Gemini3-Pro。
  • SWE-V、SWE-Verified和Terminal2.0:超过开源模型。

关键结论

核心贡献

  • 稀疏注意力架构

未来方向

  • 世界知识落后闭源模型:扩大预训练,弥补差距。
  • 复杂任务仍落后前沿模型:进一步完成基模和后训练流程。
  • Token效率提升:需更长上下文才达Gemini3-Pro效果。

问题背景 ​

❓问题背景

问题背景

开源和闭源差距越来越大

  • 闭源模型性能提升很快,处理复杂任务能力很强。

  • 开源:MiniMax, Kimi, Qwen, GLM

  • 闭源:Claude 4.5, Gemini3 Pro, GPT-5

三个原因

  • 架构缺陷:Softmax注意力 平方复杂度,长文本太贵太慢。
  • 后训练资源投入不足:限制高难任务,大部分都在预训练上,后训练做的少。
  • Agent效果不足:泛化指令和指令遵循效果不好。

模型架构 ​

提示
  • 整体同DeepSeek-V3.2-Exp一致,通过DeepSeek-V3.1-Terminus 继续训练
  • 区别仅是通过CPT来引入DSA。

DeepSeek Sparse Attention 架构 ​

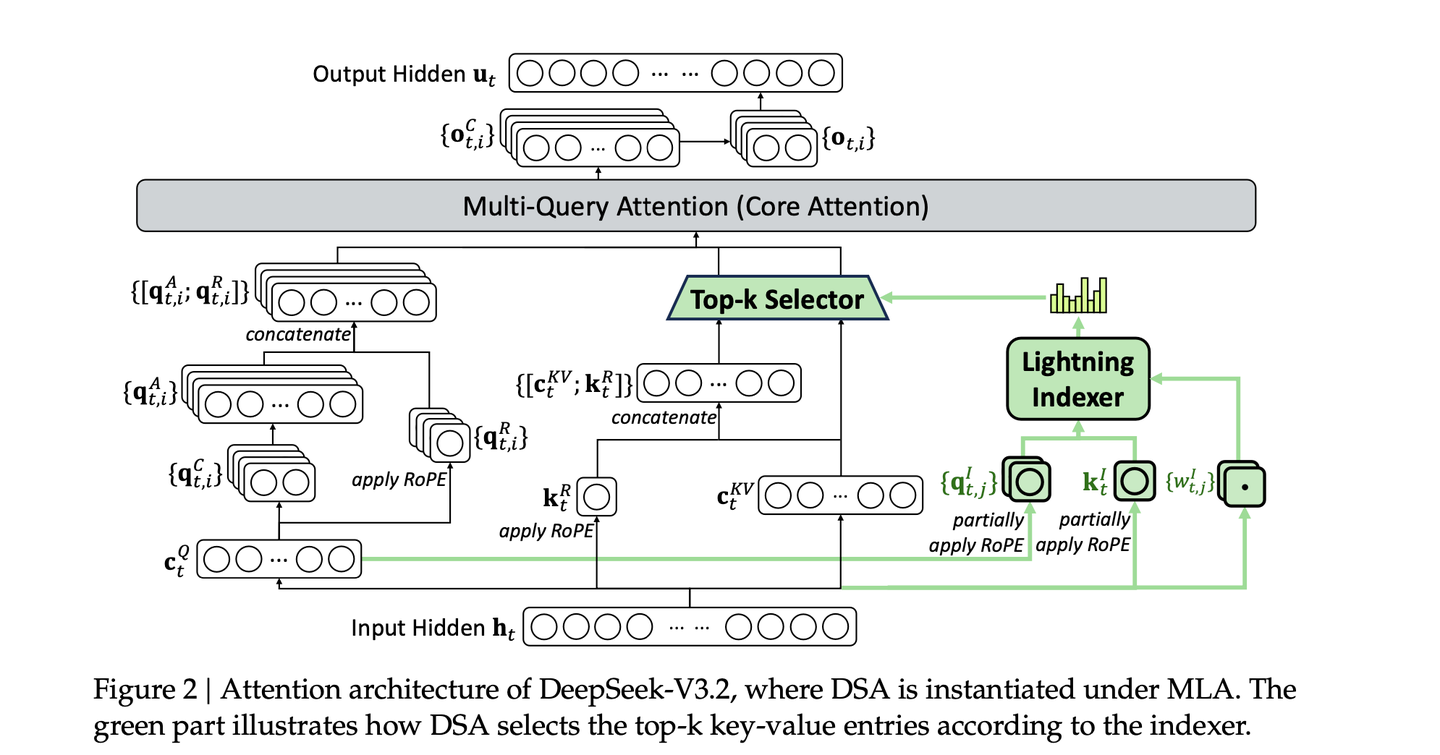
DeepSeek Sparse Attention

Lightning Indexer

  • 符号定义

    • ht∈Rd:query token;hs∈Rd:前面的某token;
    • It,s:二者的索引分数,HI:索引头数量
    • qt,jI∈RdI:来自query-token ht;ksI:来自前面-token hs,wt,jI∈R
  • 使用超轻向量 (qI,kI,wI) 计算索引分值 It,s,决定哪些token被选中。

  • 使用FP8(吞吐量高) + ReLU(比softmax快)

    It,s=∑j=1HIwt,jI⋅ReLU(qt,jI⋅ksI)

细粒度Token Topk选择器

  • 对query token ht, 仅稀疏选择top-k的token cs (Key-Value对),去计算注意力。ut=Attn(ht,{cs∣It,s∈Top-k(It,:)})

DSA 和 MLA 结合

  • 问题:如果每个query 都选择不同top-k,那么显存难以加速,都在寻找数据。
  • 背景:MLA:压缩KV矩阵;MQA:所有query共享1套KV。
  • 采用MLA的MQA模式
    • 每个latent vector 会被该query token的所有query head 共享。
    • 所有query 共享1套被选中的token。

稀疏注意力2阶段CPT(Dense预热+Sparse训练) ​

2阶段预训练

整体

  • Checkpoint: Base-DeepSeek-V3.1-Terminus;数据:上下文长度128k。
  • 分为Dense预热和Sparse训练 2阶段。

Dense 预热阶段

  • 目标:初始化Lighting Indexer,学会预测哪些token是重要的。

  • 方法:冻结主模型参数,仅训练Indexer参数。

  • 训练目标:

    • KL Loss作为训练目标,让indexer预测分布 接近DenseAttention分布。
    • Teacher:DenseAttention, 目标分布,pt;Student:SparseAttention
    LI=∑tDKL(pt,:||Softmax(It,:))
  • 共训2.1B tokens。lr=1e-3,1000步,每步16个序列,每序列128k token,

Sparse 训练阶段

  • 正式训练稀疏注意力,同时训练主模型和indexer,

  • 每个query token,不看所有128k token,而是仅看2048个token,执行Top-k选择。

    St={s|It,s∈Top-k(It,:)}LI=∑tDKL(pt,:||Softmax(It,St))
  • 共训 943B tokens。lr=7.3e-6,训练1.5w步,每步480序列,每序列128k。

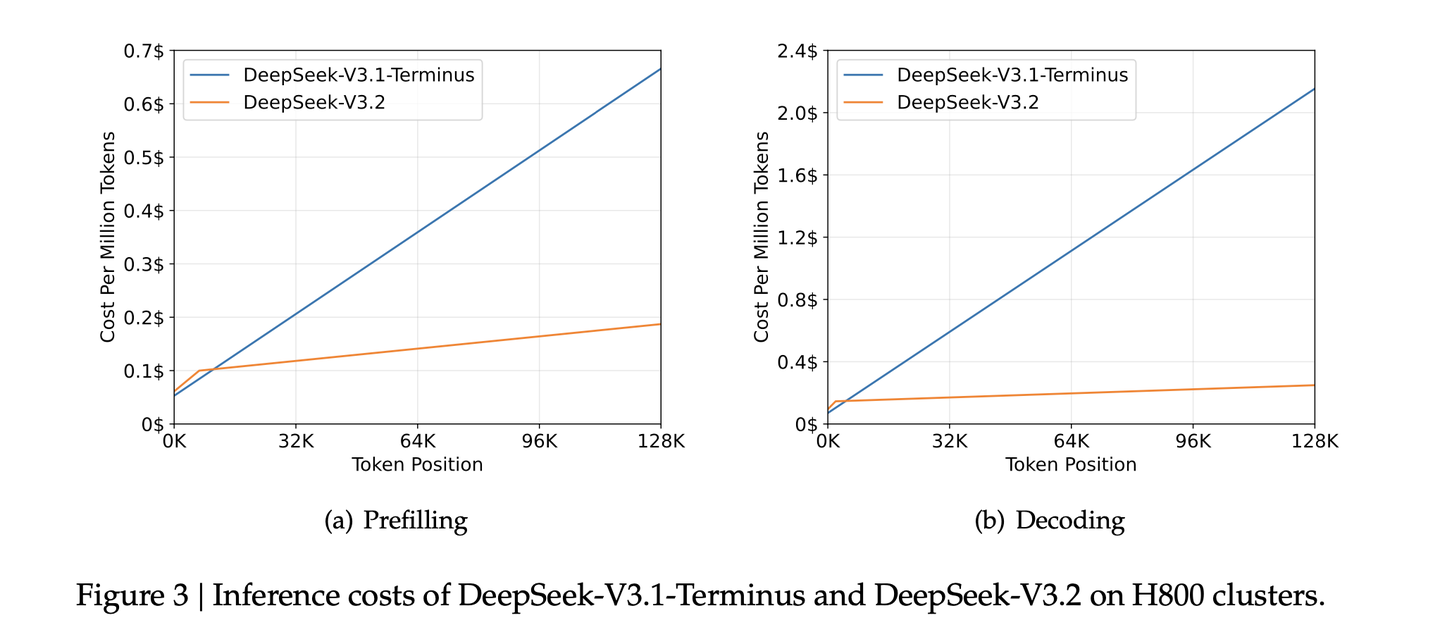
整体效果,在标准Benchmark、人工偏好、长上下文上,DSA和之前模型,效果一致,并未出现明显下降,但推理成本得到极大下降。
Post-Train (专家蒸馏+MixedRL) ​

后训练概览

专家蒸馏训练

  • 单独训练8个领域专家模型 (从 DeepSeek-V3.2-Base 开始)
    • 写作、问答、数学、编程、逻辑推理、通用agentic任务、agentic编程、agentic搜索
    • 专家训练:都经过单独RL训练,各专家支持思考和非思考模式。
    • 但具体细节,似乎没见过。
  • 领域专家蒸馏
    • 用专家生成 长推理和直接回复数据,再用蒸馏数据 去训练Base模型
    • 后续再接下文的Mixed RL训练,通才单模型仅比多专才效果低一点点。

Mixed-RL训练

  • 混合训练:推理+agent+人类对齐。GRPO算法。
    • 推理+Agent:Rule-Based奖励 + 长度惩罚 + 语言一致性奖励。
    • 其他通用任务:GenRM,每个任务有一个rubrics
  • 优点:平衡 不同领域性能,解决灾难性遗忘问题。

Scaling GRPO ​

📕核心方法

IS权重优化KL3估计 ​

用IS权重优化KL-3估计

问题:当πθ≪πref时

  • 参考策略概率高,但当前策略概率低,认为生成了不该生成的内容。

  • K3估计器的梯度,会给这些token 分配极大、无边界的权重

    • 会导致梯度瞬间爆炸,引入噪声,训练不稳定

K3 无偏估计优化

  • 核心:重要性采样比例 * 原始K3估计。

  • 乘以 rt(θ),无论采样如何,梯度期望值都是准确的,消除了系统误差,梯度变无偏估计。

DKLt(πθ,πθref)=πθ(oi,t∣q,oi,<t)πold(oi,t∣q,oi,<t)⋅(πref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−logπref(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)−1)

KL 实践参数设定

  • 不同领域任务,所需KL不一样。

    • 通用对话/文案任务:需较强KL,保持语言流畅风格一致性。

    • 数学/逻辑推理:就几乎无需KL。

Mask 异策略负样本 ​

Off-Policy Sequence Mask

异策略负样本可能有害

  • 高度异策略负样本,很可能是有害的。尽管直观上模型从自己错误中学习是有效的
  • 训推不一致:推理框架和训练框架不一致,加剧了异策略程度,推理框架高度优化。
    • Off-Policy:把1次rollout样本分多个mini-batches,做多次梯度更新
    • 更新第2次以后:采样策略和更新策略 不一致。
  • KL散度和IS权重的区别

Mask 异策略负样本

  • Mask不好的序列,不学它,差序列定义如下:

    • 结果不好:A^i,t<0,优势为负
    • 偏差大:DKL(πold∣∣πθ)>δ,KL差异大,rollout模型和当前模型 差异大
  • 系数计算公式

    • 序列级KL散度:序列内所有token的KL值做平均,作为序列级KL散度,设定最大阈值δ
    • Token级系数 Mi,t,优势为负且KL差异较大时,设为0
    Mi,t={0,A^i,t<0,1|oi|∑t=1|oi|logπold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)>δ1,otherwise
  • 目标

    JGRPO(θ)=Eq,{oi}i=1G∼πold1G∑i=1G1|oi|∑t=1|oi|[min(ri,t(θ)⋅A^i,t,clip(ri,t(θ),1−ϵ,1+ϵ)⋅A^i,t)⋅Mi,t−βDKL(πθ(oi,t)∣∣πref(oi,t))]

保持路由和采样Mask 消除训推不一致 ​

保持MoE Routing 和 Sampling Mask

核心:消除训练和推理时的不一致

  • Keep Routing:消除模型结构动态性带来的不一致。
  • Keep Sampling Mask:消除概率空间截断带来的不一致。

MoE 训练崩溃问题

  • 采样时:Router选择专家A和B;训练时:Router却选择专家B和C。
  • 专家A做贡献没被更新,专家C没做事却被更新,导致参数更新方向很随机,导致训练崩溃

Routing Replay 方法

  • 推理时,记录每个token选择的专家;训练时,不计算路由,强制使用推理时的专家。
  • GSPO 序列级IS权重: 序列级别,无token级IS,对底层专家不敏感,无需路由回放。

Sample Mask 低概率导致词表截断问题

  • 推理时,通常使用top-p, top-k来提高回复质量,低概率token概率为0,相当于词表截断。
  • 训练时,计算IS权重,则πθ和πold动作空间/定义域 不一样,导致计算失效。

保持采样Mask 方法

  • 保留采样Mask,在训练时应用到πθ,该部分概率为0。保证πθ和πold词表一致。

Thinking in Tool-Use ​

工具调用思考-上下文管理 ​

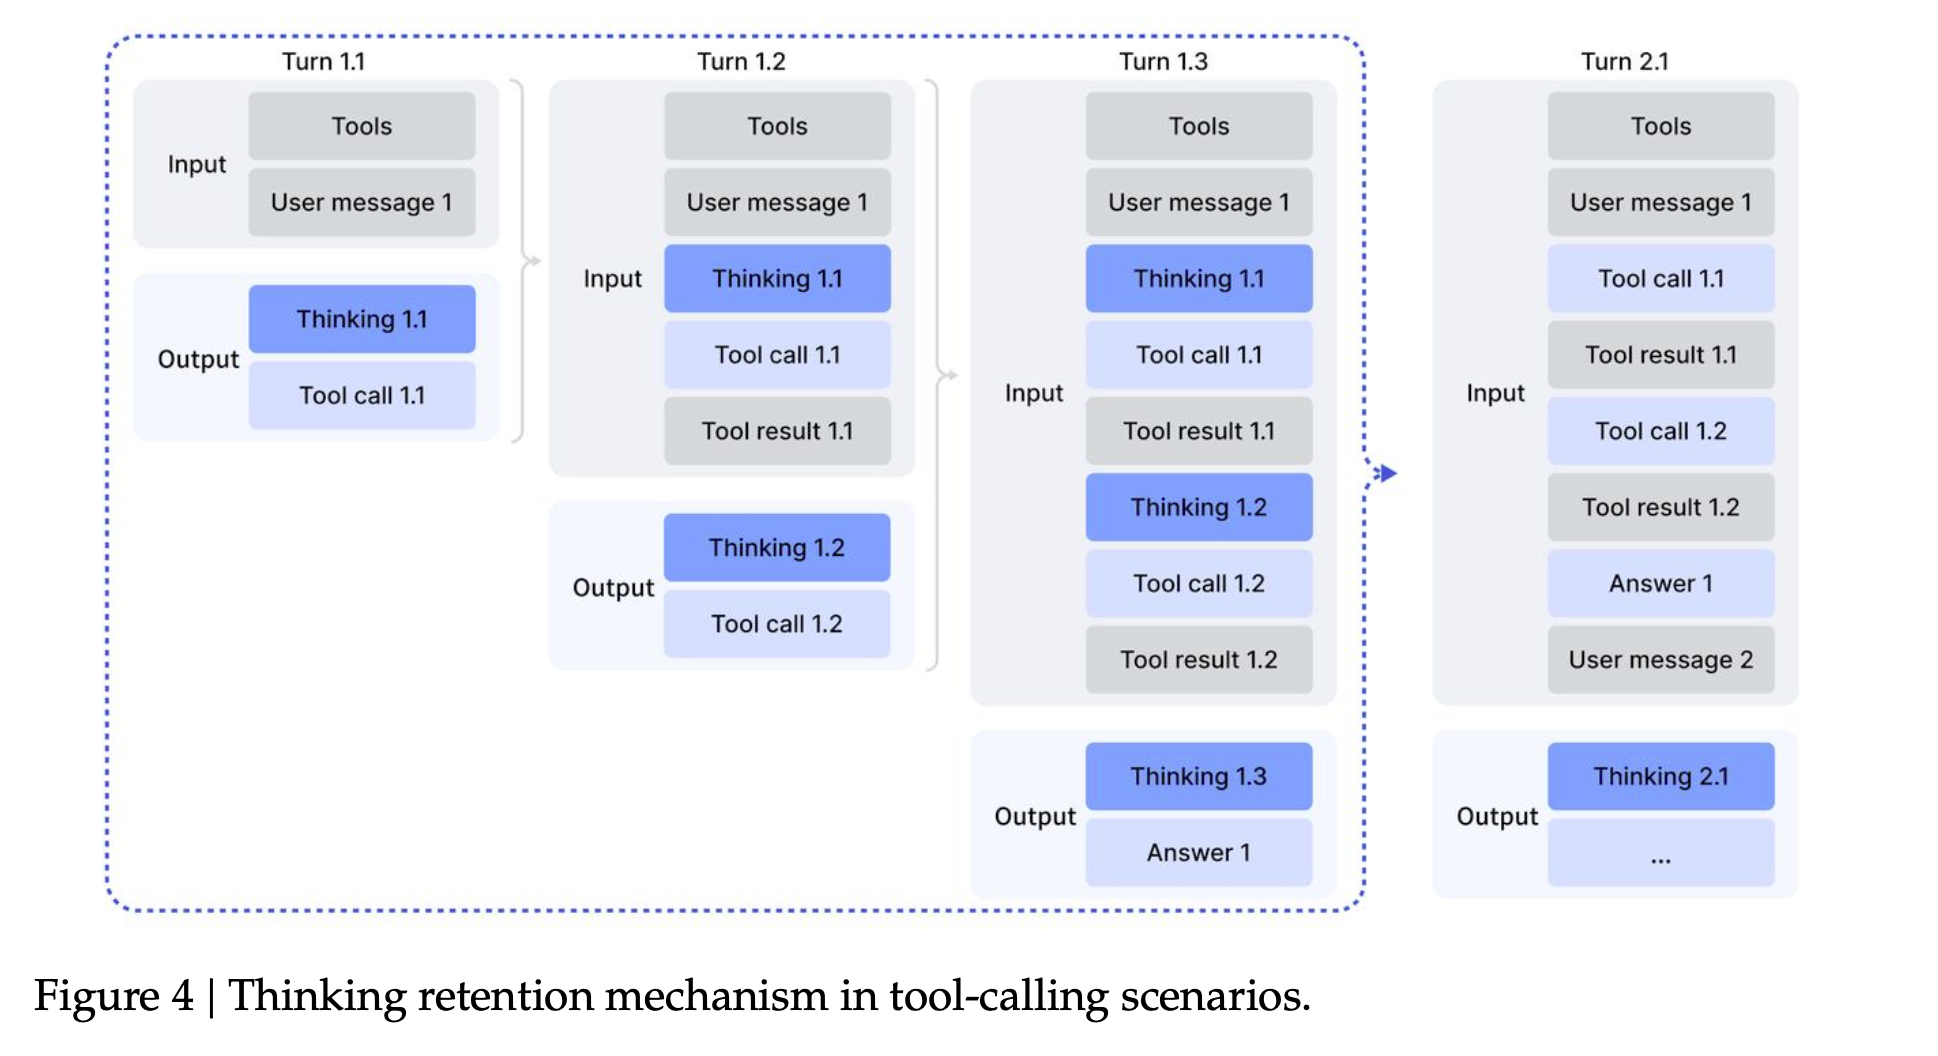
保留工具调用思考过程
  • 新User消息到达,丢弃之前的思考内容,仅保留Tool Call和Answer。
  • 若无新User,则在每一步的工具调用中,保留思考过程
    • R1:每一步都丢弃和重新思考。
  • 具体如下图所示:Thinking - Tool Call - Thinking - Tool Call
超长上下文管理

问题

  • 测试时,某些场景128k 仍然不够

方法

  • 测试时,引入上下文管理,token超过80%时:

    • Summary:总结轨迹并重新启动Rollout过程

    • Discard-75%:丢弃前75%的工具调用历史来腾出空间

    • Discard-all:丢弃所有的工具调用历史来重置上下文

自蒸馏冷启动 ​

自蒸馏冷启动

背景

  • 目标:想要一个既能深度思考(R1-Style)、又能熟练使用工具(Agentic Style)的模型。
  • 但现有数据:推理数据-非Agent,Agent数据-无推理。

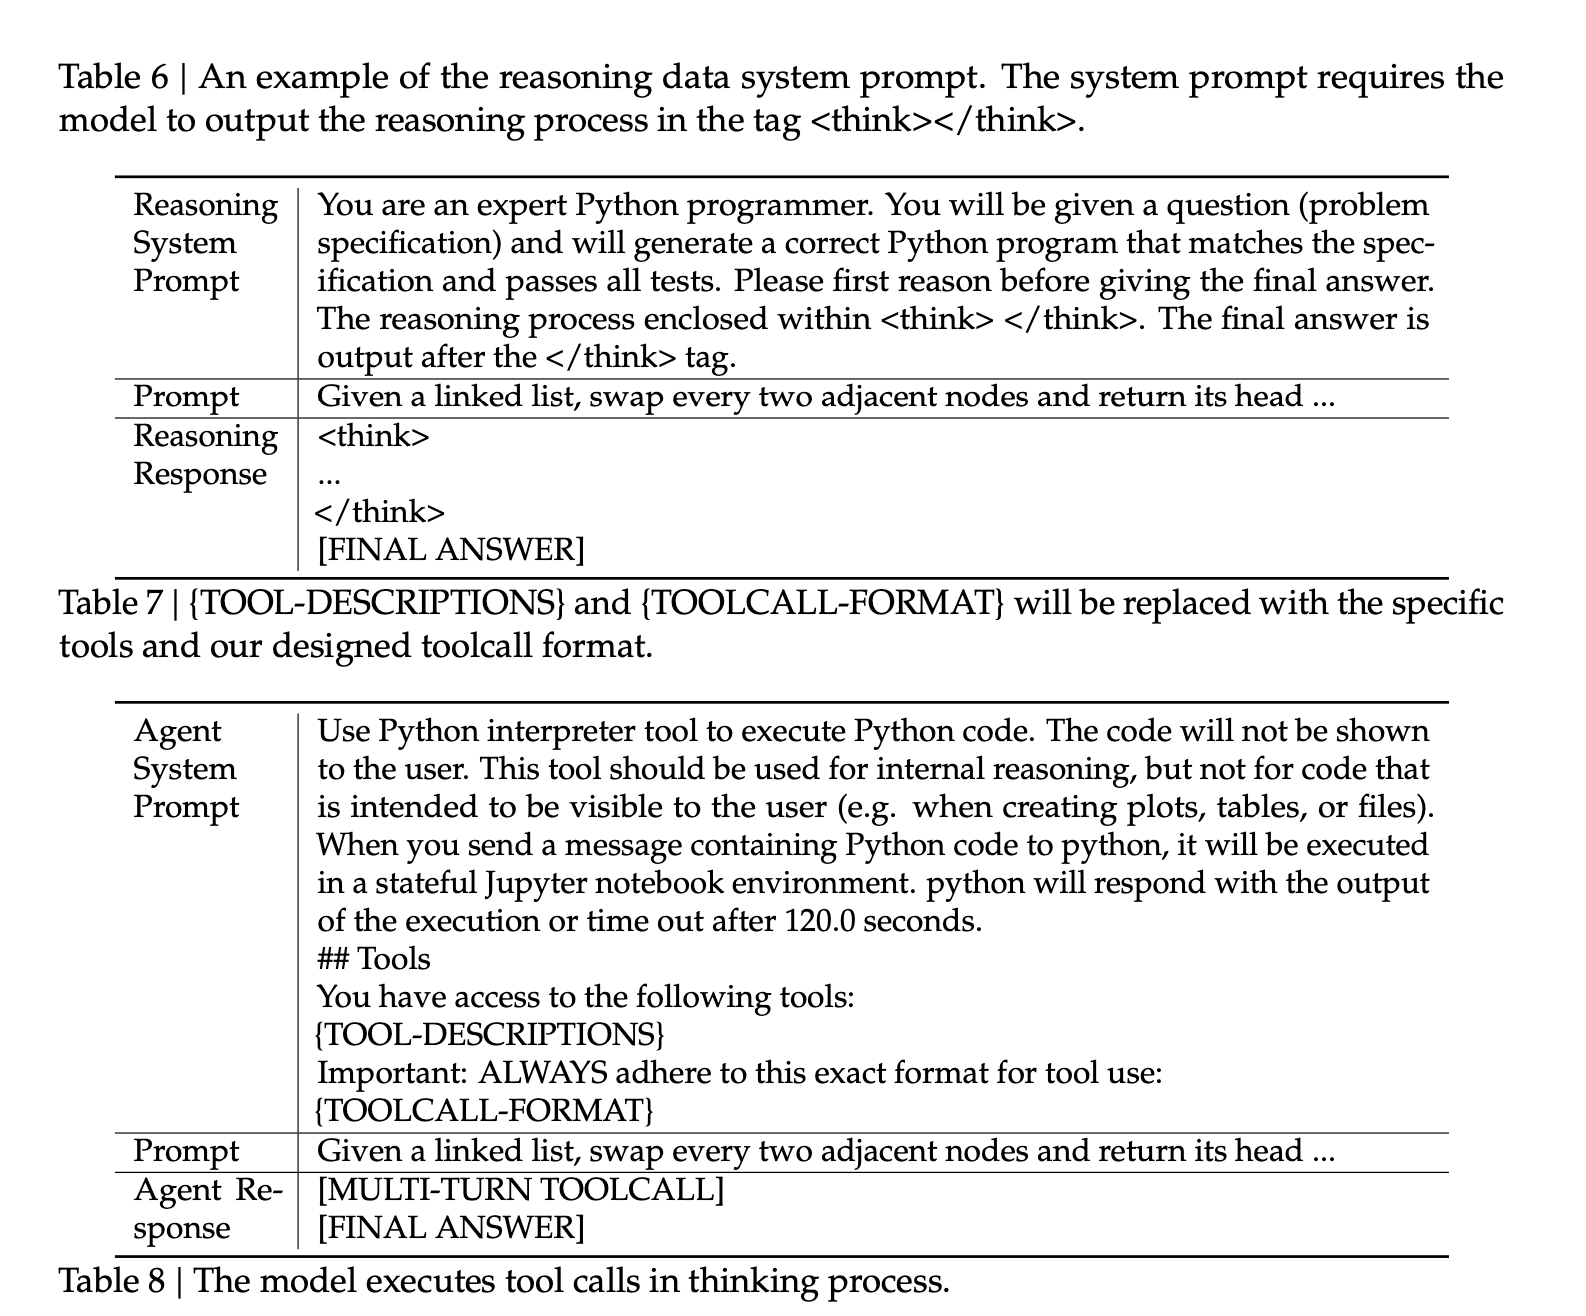
推理思考的Agent 数据构建方法

  • 设计Prompt,把推理思考和工具使用 合在一起。
  • 效果
    • 成功率低:但也可取出成功轨迹作为正样本。
    • 依赖指令跟随能力:不同任务需不同 system prompt。

滚雪球冷启动

  • SFT 微调 -> 收集正样本 -> SFT 微调....,
  • 逐渐提高成功率,后续可做大规模RL

四大Agent任务构建(Search&Code&推理&General) ​

📕核心方法

Search Agentic 任务构建

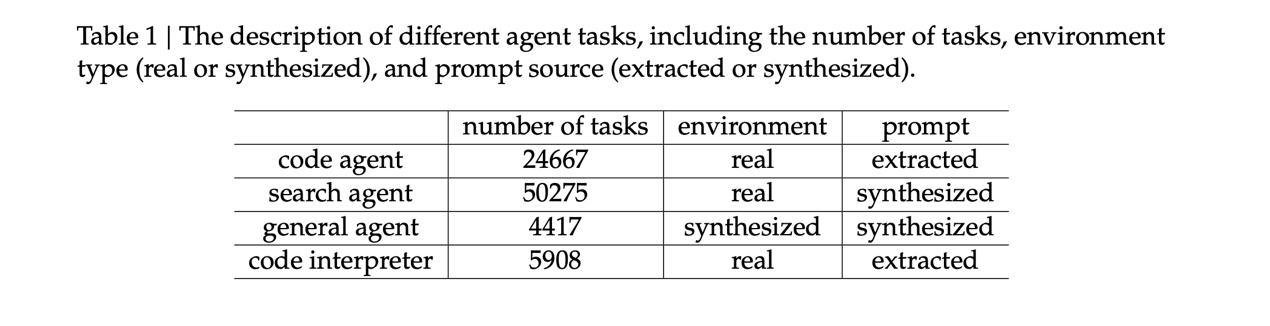
数据量

  • 50k任务,真实环境,合成任务。

MulitAgent Pipeline 合成高质量多样数据

  • 从web数据中挖掘出长尾实体
  • 问题构建Agent:使用搜索工具探索实体,把信息整合成QA对。
  • 多个答案生成Agent:配置不同,为QA对生成候选答案。
  • 验证Agent:具有搜索能力+多轮验证,仅保留GT正确且所有候选答案错误的难样本。

GenRM 多维质量评估

  • 设计覆盖多个质量维度的rubrics,来打分。
Code Agent 任务构建

数据量

  • 24k任务,真实环境,提取Prompt。
  • 最终构建:数万个 高质量 多语言 Issue解决 RL交互环境.

Github Issue PR 任务构建

  • 从数百万Github Issue-PR中,构建大规模软件Issue解决的可执行环境。
  • 数据过滤:启发式规则+LLM,确保每条包括:
    • 合理的Issue描述、Gold Patch、Test Patch。
  • 环境构建Agent(DeepSeek-V3.2):负责包安装、依赖解析和测试执行。
    • 测试输出:标准JUnit格式
    • 环境构建成功标准:Gold Patch应用后,Fail-to-Pass和Pass-to-Fail都为0
数学逻辑任务构建+代码解释器

数据量

  • 5.9k任务,真实环境,提取Prompt。

Code Interpreter Agent (推理任务+代码工具)

  • 复杂推理任务:数学+逻辑+数据科学,每个问题 需用代码来解决。
  • 环境:Jupter Notebook作为代码解释器。
通用Agent 任务构建

数据量

  • 4.4k任务,1.8k合成环境,合成prompt。

  • 期望困难+好验证的任务:合成了1827个任务环境。

  • 最终得到几千条数据:环境+工具集合+任务+验证器

环境构建Agent

  • 数据准备:给定任务类别+Sandbox(bash+搜索),Agent搜索数据并存入数据库。
  • 工具合成:Agent为任务合成工具,工具即函数。
  • 任务合成
    • 基于数据库合成简单任务+Solution+Verification,python实现。
    • 限制:Solution只能调用工具,不能调用其他函数或直接访问数据库
    • 一致性检查:Solution结果必须通过验证函数校验,不断修改,直到通过为止。
  • 难度升级:迭代增加任务难度,更新解决方案、验证函数、扩充工具集。

数据筛选

  • 筛选出有难度可执行的优质任务,而非直接使用所有数据。

  • 使用DeepSeek-V3.2 解决100次,留下pass@100 > 0的任务。

实验设置(CPT+蒸馏+AgentRL, DeepSeekV3.2Base) ​

✍️实验设置

实验设置

基础模型

  • DeepSeek-V3.2 Base

训练任务/数据

  • 稀疏架构CPT:Dense预热2.1B,Sparse训练 943B,数据长度128k。
  • 专家蒸馏:8大领域,各训一个专家模型。
  • Mixed-RL 训练:也没写。
  • Agentic 任务:4大类,8.5w。

评测任务/数据

  • 通用:MMLU-Pro, GPQA Diamond.
  • 数学:AIME 2025, HMMT 2025, IMO 2025.
  • 代码:Codeforces, LiveCodeBench, SWE-bench Verified.
  • Agent:BrowseComp, τ2-Bench, Terminal Bench 2.0.

算法/策略

  • Scaling GRPO

超参

  • 长度:128k
  • RL训练:混合思考和直出2种模式

关键结果(DeepSeek-V3.2, 推理/代码等任务) ​

🍑关键结果

关键结果

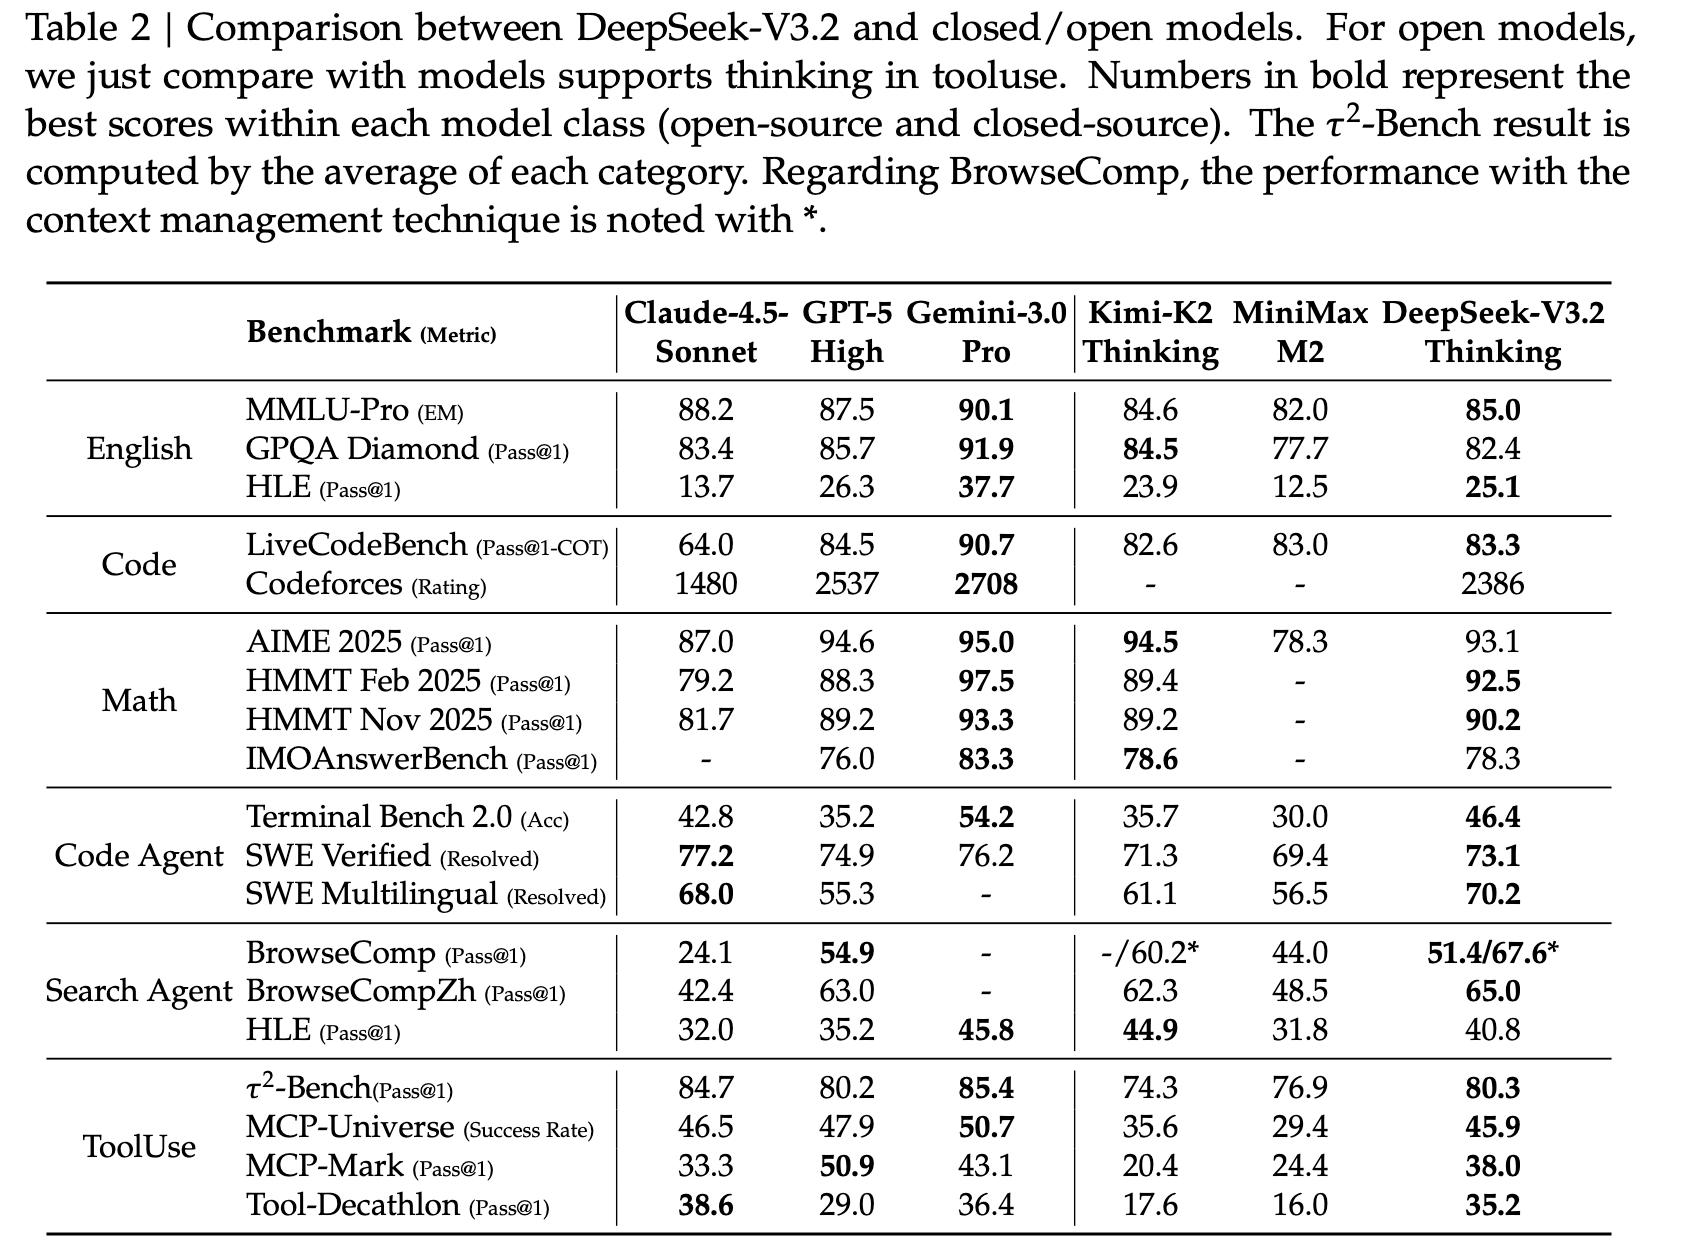
Post-Training 评估

  • 推理任务
    • DeepSeek-V3.2 在推理任务上的性能与 GPT-5-high 相近,略低于 Gemini3-Pro。
    • 与K2-Thinking相比,DeepSeek-V3.2得分相当,但输出token数量少得多。
    • 原因:RL预算增加,已达预训练的10%;性能受长度约束RM限制,去掉后还能提升。
  • 代码任务:
    • SWE-Bench-Verified, Mulitlingual, Terminal2.0:超过开源模型,后者基于ClaudeCode框架实现。
  • 搜索任务
    • 支持128k上下文,约20%测试用例超出限制。不使用上下文管理仅51.4分。
  • 工具使用
    • 缩小闭源模型差距。通过上下文管理可进一步提升性能。

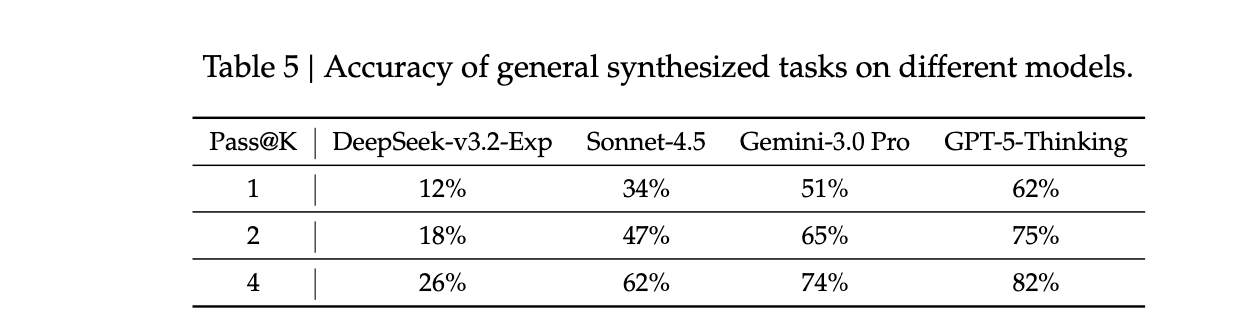
合成任务评估

  • 合成任务对RL是否有挑战?
    • 有挑战。DeepSeek-v3.2-Exp效果差,远低于GPT-5-Thinking最好。
  • 合成任务泛化性如何,能否泛化到真实任务?
    • 在DeepSeek-V3.2-SFT 做RL,在Tau2Bench/MCP-Mark/MCP-Universe都有提升。
    • 对比实验:RL限制在纯Code和搜索场景,并不能提升这些Bench效果。

合成任务还是有难度:

未来方向 ​

⛳ 未来方向

未来方向
  • 世界知识落后闭源模型:扩大预训练,弥补差距。
  • Token效率提升:DeepSeekV3.2 需生成更长轨迹才能匹配Gemini3-pro效果。
    • 探索更高效的测试时计算扩展策略(如并行搜索与串行思考的最佳组合)。
  • 复杂任务仍落后前沿模型:进一步完成基模和后训练流程。

(2510) DeepSeek-OCR ​

(2508) DeepSeek-V3.1 (混合推理、长上下文 CPT) ​

DeepSeek-V3.1

参考链接

核心变化

  • 在 V3 基座上继续训练,保留 671B 总参数 / 37B 激活,上下文 128K。
  • 一个模型支持 Thinking / Non-Thinking,由 Chat Template 选择模式。
  • 后训练强化工具使用与 Agent,Thinking 以更短响应时间接近 R1-0528 的回答质量。
长上下文继续训练

训练数据与长度

  • 增加长文档,延长两个上下文扩展阶段。
  • 32K 阶段训练 630B tokens,128K 阶段训练 209B tokens。

低精度训练

  • 权重和激活采用 UE8M0 FP8 scale,适配 microscaling 数据格式。
混合推理与工具交互

模式与上下文

  • Thinking 生成思考后回答;Non-Thinking 直接回答,二者共享模型参数。
  • 多轮请求保留历史回答,去掉上一轮思考正文。
  • 普通 ToolCall 使用 Non-Thinking;Thinking 搜索使用单独的 Search Agent 格式。

公开结果

  • LiveCodeBench(2408–2505)pass@1:Non-Thinking 56.4,Thinking 74.8。
  • 内部 Code Agent 的 SWE-bench Verified 为 66.0,体现仓库修复能力。

(2505) DeepSeek-R1-0528 ​

后训练与推理深度

相对 R1 的变化

  • 增加后训练计算并优化算法,提高数学、编程与逻辑推理能力。
  • AIME 测试中,平均推理长度由约 12K → 23K tokens,支持更深入的分析。
  • 改进 Function Calling,降低幻觉,并提升交互式编程体验。
R1-0528 结果与小模型蒸馏

推理与代码

  • AIME 2025 70.0 → 87.5,更深推理带来明显收益。
  • LiveCodeBench 63.5 → 73.3;SWE-bench Verified(Agentless)49.2 → 57.6。

蒸馏

  • 使用 R1-0528 的 CoT 训练 Qwen3-8B-Base,得到 R1-0528-Qwen3-8B。
  • 小模型在 AIME 2024 超过 Qwen3-8B,并接近 Qwen3-235B-Thinking。
  • 来源:model。

(2502) Native Sparse Attention ​

DeepSeek Native Sparse Attention

参考链接

问题背景

  • llm长度很重要,full注意力 随n平方增长,稀疏注意力 选择与Q少量相关Token来计算。
  • 但Sparse实际效果不好:内存访问不连续 只在特定阶段加速 训练full预测Sparse不匹配。

核心方法

  • Native 稀疏注意力:动态计算更紧凑的KV 保证稀疏性。
  • 压缩块级粗粒度、选择保留细粒度、局部滑动注意力,3种注意力加权求和。
  • 基于NSA架构做预训练:27B 模型+260B tokens.

模型效果

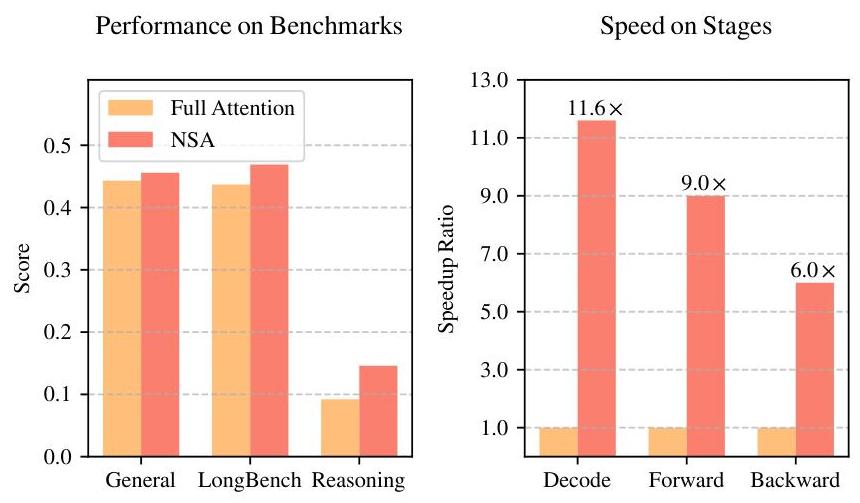
  • 在通用、长上下文、CoT上,NSA和Full 效果差不多,但提速达6-11倍

重要结论

关键贡献

问题背景:长度扩展依赖稀疏注意力 ​

❓问题背景

稀疏注意力对长度扩展有用

llm长度很重要

  • 长度很重要,但传统softmax注意力,时间复杂度随文本长度二次方增长,太高了不ok。
    • 如:解码64k长度,softmax注意力 占据70-80%时间

稀疏注意力可解

  • 稀疏注意力:只选择与Q相关的少量Token,来计算Query-Key注意力。
  • 稀疏注意力笔记

稀疏注意力实际效果并不好 ​

稀疏注意力存在问题

实际加速效果不好

  • 不符合硬件计算逻辑, 内存访问不连续

    • Sparse Attention 逻辑:减少FLOPS运算,随机、不规则访问内存。

    • GPU 逻辑:并行计算。

    • 不匹配:导致GPU大量在等待数据、找数据,而非计算,实际加速并不高。

  • 只在推理特定阶段做加速

缺乏预训练/训推不一致

  • 架构偏差/不一致:预训练采用full、后训练/inference采用sparse

    • 模型未充分学到Sparse,无法充分发挥sparse的潜力和优势
  • 使用稀疏注意力,需解决:硬件对齐问题、训练感知问题。

稀疏注意力实际不高效的原因 ​

当前稀疏注意力实际不高效的原因

只在推理某个特定阶段做加速

  • H2O(2023):仅在decoding使用Sparse Attention
    • 在prefilling需要计算复杂的预处理,如注意力map/索引构建等操作。
  • MInference(2024):仅在prefilling使用Sparse Attention

与主流解码架构MQA/GQA不兼容

  • MQA,GQA :多个Q头 共享 1组 K-V头

    • 解码时非常高效,GPU只需从内存加载一小部分K和V。
  • 如Quest(2024)/Sparse:每个Q头 独立选择 KV-Cache

    • 在MHA下是稀疏的,但在GQA 实际效果不理想
      • 需把Group内所有Q头独立选的KV-Cache,都找出来做并集,作为GQA的KV

      • 虽然Sparse减少计算操作,但需要的KV-Cache却仍然高。

      • 在解码阶段,内存访问非常高,内存是瓶颈,最终导致实际加速效果不理想。

稀疏注意力训练存在挑战 ​

稀疏注意力训练困难

若不训练稀疏注意力,直接用效果不好

  • 在预训练好的 Full Attention模型,直接应用稀疏注意力,会损害模型性能。

若训练稀疏注意力,则存在挑战

  • 某些稀疏操作不可微分,导致模型无法学习
    • 训练依赖梯度,某些操作是离散的(A或B,无中间状态),导致梯度无法通过操作回传
  • 某些操作尽管理论上可训练,但其内存访问模式非常不规则,导致在GPU上训练效率很低
    • FlashAttention利用SRAM 把连续内存块加载进来进行计算。
    • 但某些Sparse是Token粒度的,可能会选择5、28、106这些不连续的token
      • GPU需要从内存的各零散位置去读数据
      • 大部分时间都在找数据、而非算数据,导致训练速度极慢。

Native Sparse Attention ​

核心思想 ​

📕核心方法

核心方法

核心思想

  • 对每个qt,不用原始完整的KV,用通过q和上下文kv 动态计算出来的 更紧凑的KV
  • 重新映射的KV总数 远小于原始总数,维持高稀疏性。Nt≪t
K~t=fK(qt,k:t,v:t),V~t=fV(qt,k:t,v:t)ot∗=Attn(qt,K~t,V~t)
  • 同时有压缩、选择、滑动3种策略进行加权,权重由门控网络计算出来。ot∗=∑c∈Cgtc⋅Attn(qt,K~t,V~t)

压缩+选择+滑动 注意力 ​

压缩粗粒度注意力

压缩思想

  • 通过将连续的KV块聚合成块级表示,来捕获整个块的信息。
  • 创建了更紧凑信息更密集的KV对
  • 把多个token进行压缩聚合

具体做法

  • 将K序列分成长度为l的块,每块之间有长度为d的滑动步长。
  • 可学习的MLP与块内位置编码一起,将每个块中的Key映射到一个压缩Key。

优点

  • 捕获更粗粒度的高级语义信息,从而减少注意力机制的计算负担

缺点

  • 可能丢失细粒度信息
选择性保留注意力

选择思想

  • 选择性保留细粒度token

  • 从历史信息中,挑选最重要的几个信息快,来参与计算

具体做法

  • 重要性分数
    • NSA利用压缩token的注意力计算产生的中间注意力分数来推导选择块的重要性分数。
  • Top-n 选择
    • 按重要性分数排名,保留top-n块中的token

优点

  • 在降低计算复杂度的同时,保留重要的细粒度信息,避免因过度压缩而损失关键细节。
滑动局部注意力

目的

  • 为了防止 局部模式过快适应并主导学习过程,从而阻碍模型从压缩和选择token中有效学习
  • NSA引入了一个专门的滑动窗口分支来显式处理局部上下文。

核心思想

  • 处理局部信息的滑动窗口,只关注最近一小段的历史信息

核心创新 ​

NSA和硬件对齐 ​

Hardware-aligned System

背景

  • 稀疏注意力的硬件不对齐问题,计算逻辑不同,导致实际加速和理论不匹配。

核心思想

  • NSA 所有操作都是基于block,使得内存访问变得很规整、连续,方便GPU。

端到端NSA训练 ​

训练感知

背景

  • Sparse缺乏预训练问题、训推不一致问题。

核心思想

  • 端到端训练,模型从预训练开始,就学会如何高效做信息压缩和筛选。
  • 使得稀疏模式和模型本身就很匹配。

算法实验 ​

✍️实验设置

实验配置

模型

  • 27B

预训练数据

  • 260B tokens

架构

  • Native Sparse Attention

评估Bench

  • 通用评估
  • 长上下文评估
  • CoT 推理评估

🍑关键结果

关键结果
  • 在通用、长上下文、CoT上,NSA和Full 效果差不多,但提速达6-11倍。

计算效率

⛳未来方向

未来方向

(2501) DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning ​

摘要

参考链接

核心方法

  • 纯rule-based强化学习 DeepSeek-R1-Zero
  • 四阶段训练的 DeepSeek-R1
    • CoT冷启动 + 推理任务强化学习 + RFT提升通用任务能力 + 全场景RL保证安全无害
  • 80w SFT蒸馏数据 微调小模型 效果很好

重要结论

关键贡献

  • 开创性作品,截止2507已达16w的论文引用😨。

问题背景 ​

❓问题背景

问题背景

缺乏开源o1方法

  • LLM在推理方向有进展,但在复杂数学和科学上仍是重大挑战,开源界缺乏复制o1的明确路径

之前推理相关方法存在问题

  • SFT方法:高质量SFT推理数据 成本高难以获取。
  • RL方法:通常和SFT数据结合,难以探索纯RL潜力。
  • Test-Time Scaling:通过长度提升能力,但如何有效扩展,仍然是挑战。
  • PRM:实际场景难以应用存在局限性
  • MCTS搜索:效果有限。

核心方法 ​

📕核心方法

整体训练流程 ​

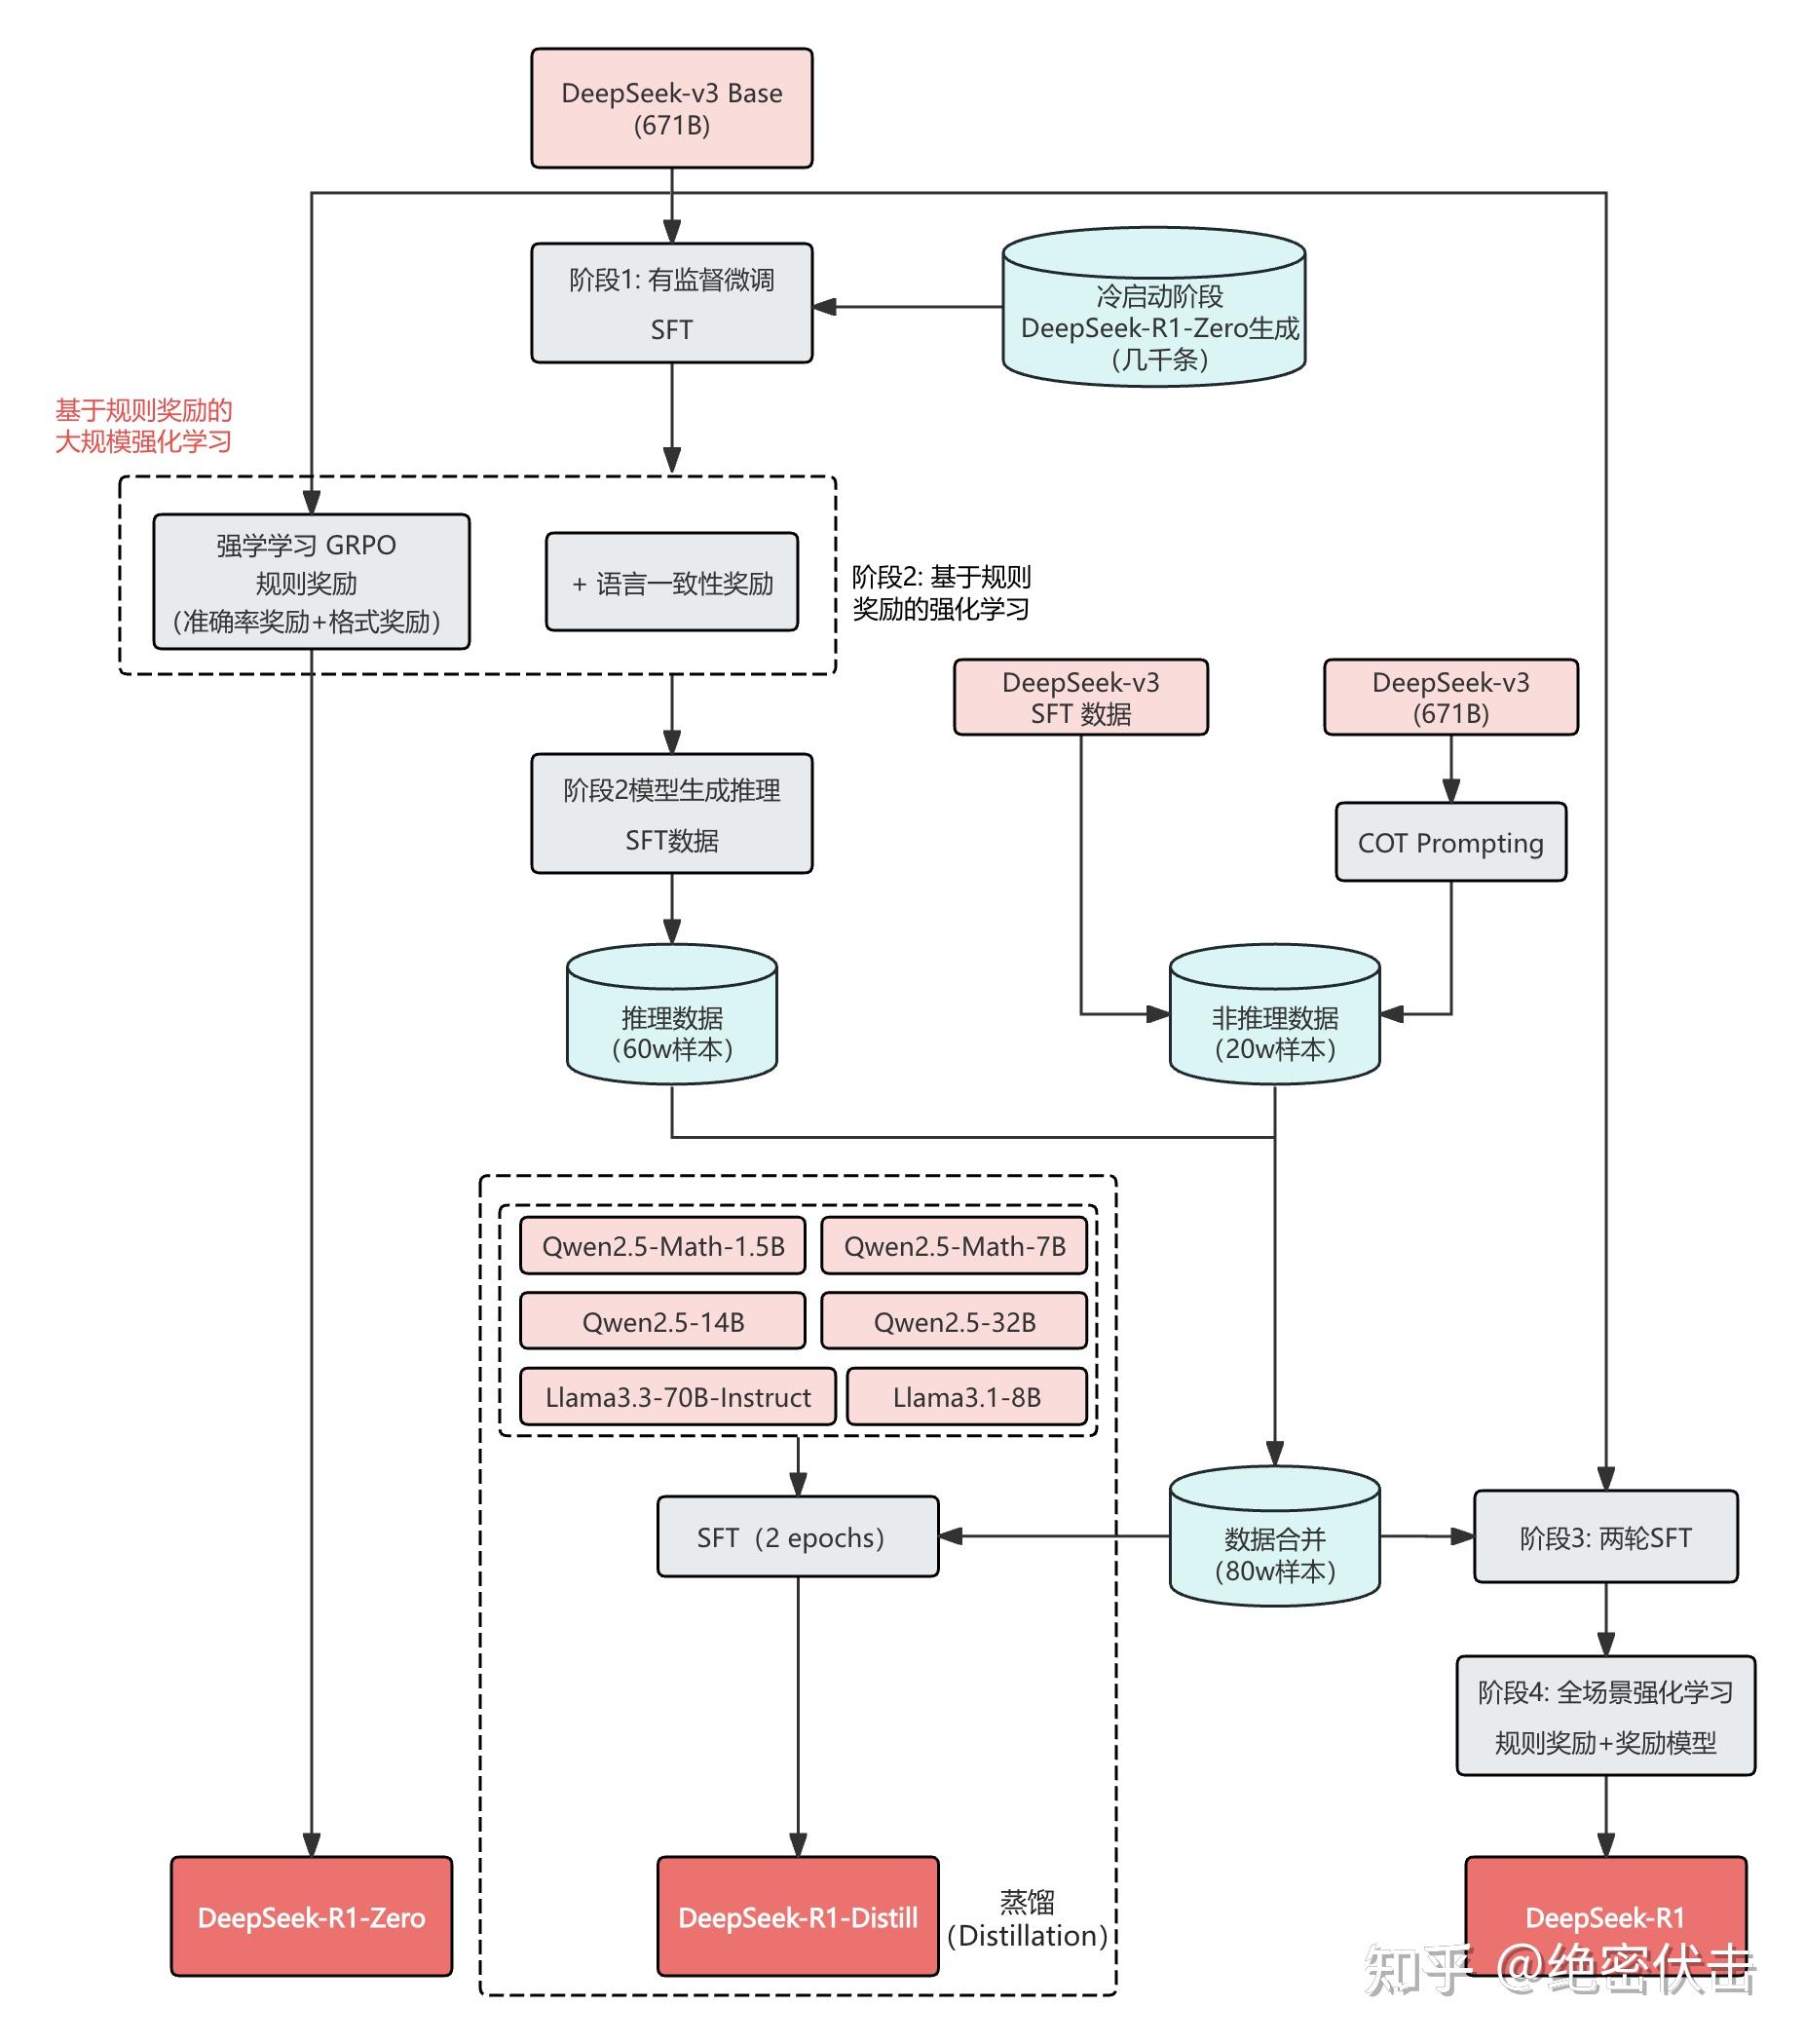
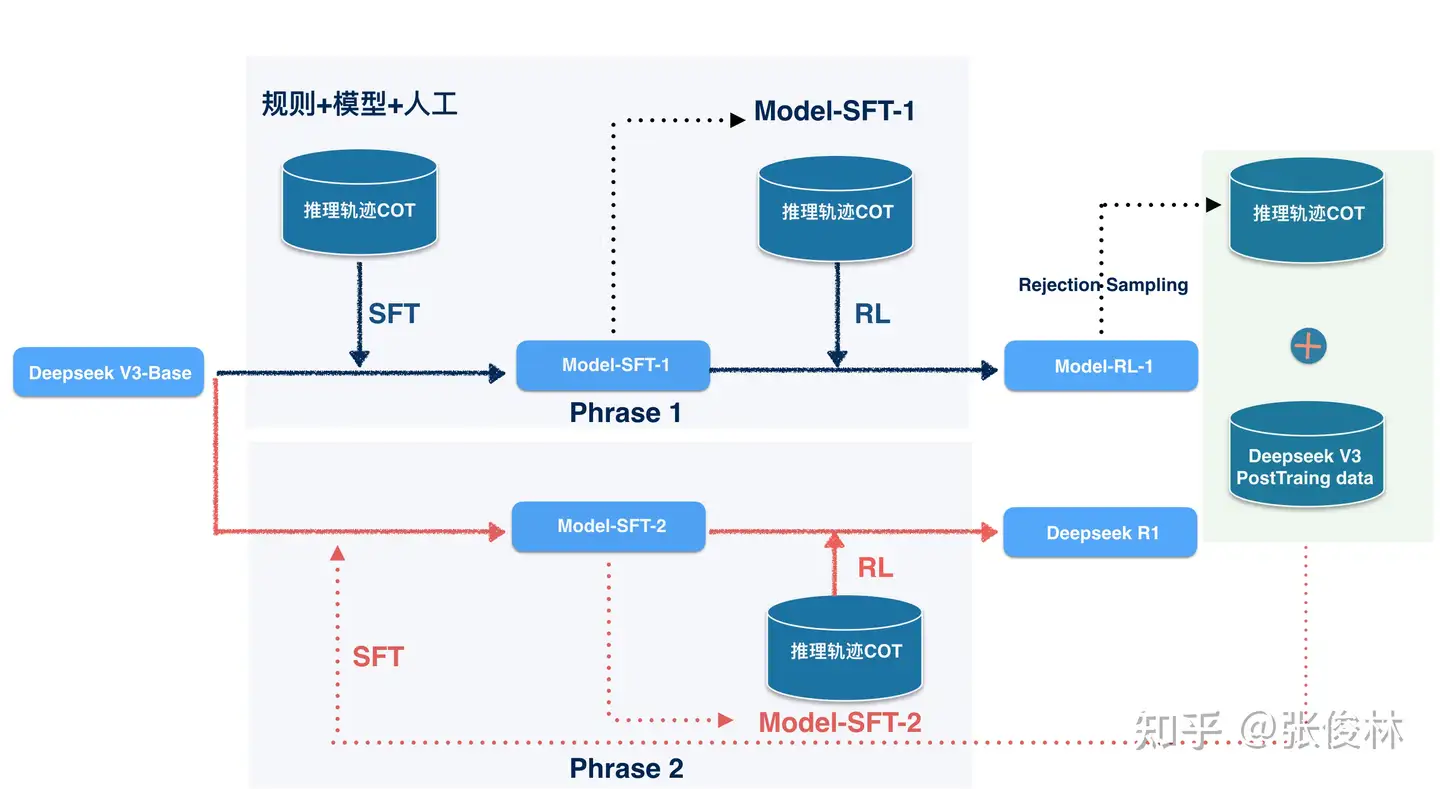
训练流程
  • DeepSeek-R1-Zero:纯强化学习
  • DeepSeek-R1:冷启动SFT -> 推理任务RL -> Cot+通用数据SFT(80w) -> 全场景RL
  • 蒸馏小模型:直接用80w数据做SFT

R1-Zero ​

DeepSeek R1-Zero 纯强化学习

核心思想

  • 核心方法:直接基模+Rule-based RL,不使用SFT
  • Reward
    • 准确率奖励:评估答案正确性,答案输出在box中,数学/Code任务。
    • 格式奖励:输出遵循格式 <think>
  • 🔥GRPO算法
    • 通过组内奖励来优化模型,无需critic model
    • 采样一组输出 并计算组内奖励均值和标准差 来估计优势函数,来优化模型
  • 训练模板
    • 特定prompt,要求模型先生成推理过程,再输出最终答案,保证可解释性。

💥取得效果

  • 数学评估:随RL推进,AIME24任务由15.6% -> 71%,媲美o1-0912
  • 自我演化过程
    • 输出长度不断增加,从几百到几千token,
    • 模型自然获得解决复杂任务的能力,更深入探索和优化思维过程
  • 顿悟时刻(AhaMoment)🤔
    • 主动回溯、推翻先前想法并重新推理的行为。类似于人类恍然大悟。

💔缺点不足

  • 可读性差**、**语言混合。

R1-多阶段训练方式 ​

DeepSeekR1目标

目标

  • 解决R1-Zero中存在的语言混合/可读性差等问题。
  • 训练一个人类友好、通用性强的模型。
阶段1:CoT微调 冷启动

🐱阶段1:冷启动

  • 目的:为了避免RL不稳定,让模型掌握基本CoT能力,更具输出可读性。
  • 思想:RL之前用小部分高质量CoT数据微调模型 作为最初RL Actor,DeepSeek-V3-base。
  • 收集几千条数据
    • Few-Shot Long Cot方法:让模型输出带反思和验证的答案
    • 收集R1-Zero结果:进行人工修正优化
阶段2:强化学习提升推理任务能力

🐸阶段2:推理强化学习

  • 目的:专注于推理任务 做大规模强化学习 解决语言一致性问题
  • 方法:在冷启动模型上,使用代码/数学/科学/逻辑推理等数据(具有明确答案)做RL
  • 奖励函数
    • 语言一致性:计算目标语言在CoT中的比例。reward=CoT中目标语言的Token数CoT总Token数
    • 答案正确性:正确答案。
阶段3:拒绝采样SFT提升通用任务能力

🐬阶段3:拒绝采样和SFT

  • 目的:提升模型在写作/问答/RolePlay等通用任务上的能力
  • 方法:构建推理和非推理SFT数据,基于V3-Base做SFT。
  • 推理数据构建(60w):
    • 用上阶段RL模型做拒绝采样:每个推理样本生成多个轨迹 仅留正确选项 构建高质量样本。
    • 数据评估筛选标准
      • 规则判断:对于数学等容易判断的,使用rule进行判断。
      • 模型判断:用DeepSeekV3,同时输入标准和模型答案,来判断是否正确。
      • 可读性过滤:过滤难以阅读的样本,比如语言混合、过长段落、过长代码片段等。
  • 非推理数据构建(20w):
    • 核心:使用Deepseek-v3的pipeline和部分v3的SFT数据。
    • 方法:让v3在回答任务之前,先生成一些Cot;对于简单任务(如hello),则不需要Cot
  • 训练:80wSFT数据 +V3-Base + 2轮SFT训练
阶段4:全场景强化学习 保证安全和无害

🐶阶段4:全场景下的强化学习

  • 目的:使模型在推理和非推理所有任务上表现良好,保证安全性和无害性
  • 方法:在上阶段的SFT模型上进行RL训练。

小模型蒸馏 ​

蒸馏小模型

核心

  • 使用80wSFT数据,直接对Qwen/LLaMA等小模型做SFT微调。

效果

  • 显著提高小模型性能,在较小训练开销下 取得远胜于自身RL学习的效果
  • 展现出蒸馏技术的有效性

算法实验 ​

✍️实验设置

实验配置

模型评测

  • 基模评测:

    • 多种数学推理(AIME24/Math500),代码题(LiveCodeBench/Codeforces)
    • 知识问答(MMLU/GPQA/SimpleQA),开放式场景(AlpacaEval2.0/ArenaHard)
  • 蒸馏模型评测:AIME24/Math500/GPQA/Codeforces/LiveCodeBench。

关键参数

  • 最大生成长度32k,temperature=0.6, top-p=0.95
  • 每次生成64个回答以估计pass@1,mean@64了。

🍑关键结果

关键结果

DeepSeekR1 效果好

  • 教育知识Bench效果好相比V3提升显著(MMLU-Pro/GPQA等)
  • 指令遵循能力强(IF-Eval),摘要简洁长度偏差小
  • 数学推理能力和o1持平,远超其他模型

蒸馏模型效果好

  • R1-Qwen-7B所有方法超过GPT4o-0523,R1-14B全面超越QwQ-32B-Preview,R1-32B和R1-70B大多数都优于o1-mini

未来方向 ​

⛳未来方向

未来方向

(2412) DeepSeek-V3 (MLA、无辅助损失均衡、FP8) ​

🌺 论文摘要

DeepSeek-V3 论文摘要

参考链接

问题背景

  • 大规模 MoE 需要同时控制专家负载、跨机通信和训练精度带来的成本。

核心方法

  • 模型架构:MLA 压缩 KV;DeepSeekMoE 用路由 bias 均衡专家;MTP 增加预测信号并支持投机解码。
  • 低精度训练:FP8 与 DualPipe,减少精度/通信开销并重叠通信与计算。
  • 推理蒸馏与 RL:SFT 吸收 R1 专家的反思、验证模式,再以 GRPO 强化推理与通用能力。

模型效果(DeepSeek-V3 Chat)

  • MATH-500 90.2,SWE-bench Verified + Agentless 42.0。

重要结论

  • 架构与系统联合优化,在增强能力的同时降低大规模 MoE 的训练成本。

核心贡献

  • 提供 671B-A37B 开放模型,以及路由均衡、MTP、FP8 的可复用设计。

未来方向

  • 降低部署门槛,改进长上下文效率、推理深度和多维评测。

问题背景 ​

问题背景
  • 更大 MoE 需要同时控制训练成本、专家负载和跨卡通信;后训练还要强化数学与代码推理。

核心方法 ​

模型架构 ​

KV 压缩与 MoE 路由

MLA

  • 将多头 KV 压缩为低维表示,减少解码时需要保存和读取的缓存。

无辅助损失均衡

  • 路由时给专家分数加 bias:过载专家降低 bias,欠载专家提高 bias。
  • bias 只影响选谁;最终输出仍使用原始 affinity 加权。
  • 保留较小的序列级均衡约束,防止单个序列出现极端负载。
连续预测未来 token
  • 将当前隐状态与后续 token embedding 结合,交给额外 Transformer 模块。
  • 多个预测深度顺序连接,保留完整因果关系,增加每个位置的监督信号。
  • MTP 与主模型共享 embedding 和输出头;推理时可用于生成候选再由主模型验证。
MTP 按预测深度顺序连接模块,并共享 embedding 与输出头;每层融合后续 token 信息,保留完整因果链。
原文图 3:MTP 按预测深度顺序连接模块,并共享 embedding 与输出头;每层融合后续 token 信息,保留完整因果链。 来源

低精度训练系统 ​

精度控制与通信重叠

FP8

  • 激活按 1×128 tile、权重按 128×128 block 计算 scale,限制 outlier 对其他数值的影响。
  • 定期将矩阵乘法中间结果转入 FP32 寄存器累加,减少长维度求和误差。
  • 减少显存和计算开销,同时控制数值误差。

DualPipe

  • 将前向、反向拆为 Attention、dispatch、MLP、combine 等阶段,安排计算与通信重叠。
  • 从流水线两端发送 microbatch,双向调度降低设备空闲与流水线气泡。
  • MoE 跨节点通信与专家计算共同调度,降低稀疏模型的通信瓶颈。
FP8 的细粒度量化与高精度累加。左侧看 tile/block 如何隔离异常值,右侧看周期性高精度累加如何控制误差。
原文图 7:FP8 的细粒度量化与高精度累加。左侧看 tile/block 如何隔离异常值,右侧看周期性高精度累加如何控制误差。 来源

推理蒸馏与 RL ​

领域专家生成推理数据

推理任务

  • 用内部 R1 生成高质量推理,但原始答案存在过长、格式不佳等问题。
  • 每个领域训练专家模型:学习普通回答与带反思、验证的 R1 回答。
  • 专家经 RL 融合两类模式,再做拒绝采样,生成准确且较简洁的 SFT 数据。

通用任务

  • 写作、角色扮演和普通问答由 V2.5 生成,结合人工检查。
不同任务的反馈
  • 数学答案、代码测试等可验证任务使用规则反馈。
  • 自由形式回答使用 RM;偏好数据同时包含评分与推理依据。
  • GRPO 用同题回答的组内分数估计 baseline,省去同规模 Critic。

实验设置(14.8T Pretrain + SFT/GRPO) ​

实验设置

基础模型与数据

  • DeepSeek-V3:671B 总参数,37B 激活;预训练 14.8T tokens。
  • SFT:1.5M 样本,2 epochs;包含推理与通用任务。

训练设置

  • 预训练 4K,之后扩展到 32K → 128K。
  • SFT:学习率 5e-6 → 1e-6,sample masking 隔离同序列中的不同样本。
  • 正式训练约 2.788M H800 GPU hours。

评测任务

  • 通用知识、数学、代码、指令遵循;SWE-bench Verified 使用 Agentless。

关键结果(DeepSeek-V3 Chat,SFT + GRPO) ​

模型效果与消融

数学与代码

  • MATH-500 达 90.2,推理蒸馏与后训练带来较强数学能力。
  • SWE-bench Verified 达 42.0,同表 Claude 3.5 Sonnet 为 50.8;仓库任务仍有差距。

架构与训练

  • MTP 消融显示额外预测目标有助于模型能力,也能用于推理加速。
  • 无辅助损失均衡在对照中取得更好的效果,专家呈现更明显的领域专门化。
  • 低精度计算、通信调度和稀疏架构共同支持了较低训练成本。

未来方向 ​

原文提出的方向
  • 部署效率:减小高效部署所需规模,继续提高生成速度。
  • 架构与上下文:提高训练/推理效率,探索更长上下文与 Transformer 之外的结构。
  • 数据与推理:扩展高质量数据和训练信号,提高思考长度与深度。
  • 多维评测:减少只优化固定 benchmark 带来的能力误判。

(2406) DeepSeek-Coder-V2 (6T Code CPT、SFT、GRPO) ​

🌺 论文摘要

DeepSeek-Coder-V2 论文摘要

参考链接

问题背景

  • Code 模型需要加强代码与数学,同时保留通用语言能力和长上下文能力。

核心方法

  • 从 V2 中间 checkpoint 出发,用 6T tokens 做继续预训练。
  • 数据混合:60% Code + 10% Math + 30% General。
  • SFT + GRPO:代码测试构建偏好数据,再训练 RM 提供 RL 信号。
  • Lite 版本加入 FIM,支持代码补全。

模型效果(236B Instruct)

  • HumanEval 90.2、MATH 75.7、Aider 73.7、SWE-bench 12.7。

重要结论

  • 标准代码题表现较强,复杂开发任务仍受指令遵循能力限制。

核心贡献

  • 提供通用基座经过大规模 Code CPT 和后训练的完整路线。

未来方向

  • 增强指令遵循与真实开发场景能力。

问题背景 ​

问题背景
  • 通用基模的代码能力受语种、仓库上下文和复杂推理限制,需要扩大 Code 数据覆盖并加入执行反馈。

核心方法 ​

代码数据与继续预训练 ​

多来源语料

GitHub

  • 按行长度、字母比例与文件类型过滤低质量内容,再做近似去重。
  • 代码覆盖扩展到 338 种语言,并保留 markdown、Issue 等相关文本。

Web 迭代召回

  • 以 StackOverflow、技术文档和数学网站为种子,训练 fastText 召回相关网页。
  • 按域统计命中率,标注相关 URL,将尚未召回的高质网页补入种子。
  • 迭代训练分类器与召回,扩大代码、数学覆盖;使用 V2 BPE 处理多语言分词。
数据与模型

语料构建

  • 使用多来源代码、数学和通用文本,代码比例提高到 60%。
  • 保留 30% 通用语料,避免专门训练后丢失语言能力。

模型分支

  • 236B-A21B 延续 V2 MoE;16B-A2.4B Lite 提供较小部署版本。
  • Lite 采用 PSM 顺序的 FIM,比例约 50%;236B 版本采用 next-token prediction。
  • 上采样长文档,使用 YaRN 扩展到 128K。

指令与执行反馈训练 ​

SFT 数据混合
  • 收集约 20K 代码指令、30K 数学指令,并混入 V2 通用指令数据。
  • 得到约 300M tokens 数据,累计训练 1B tokens。
从测试反馈训练 RM

反馈问题

  • 单个题目的测试可能覆盖不足,直接使用是否全过的 01 反馈存在噪声。

训练过程

  • 采样代码并运行测试,以测试反馈构建偏好数据。
  • 训练 RM 学习更有泛化性的评分,再以 RM 信号进行 GRPO。
  • 数学偏好使用真实答案构建,RL prompts 总计约 40K。

实验设置(DeepSeek-V2 中间模型 + 6T CPT) ​

实验设置

基础模型与训练数据

  • 从已训练约 4.2T tokens 的 V2 中间 checkpoint 出发。
  • 继续预训练 6T tokens,包含 Code、Math、General。

后训练超参

  • SFT:lr=5e-6, warmup=100, batch=1M tokens,总计 1B tokens。
  • RL:约 40K 数学与代码 prompts,GRPO + RM。

评测任务

  • HumanEval、数学、代码补全、长上下文与代码修复。
  • 修复评测包含 Defects4J、SWE-bench、Aider;RM 与直接测试奖励作对照。

关键结果(DeepSeek-Coder-V2-236B Instruct) ​

代码能力与实际开发

语料消融(1B 模型)

  • 同为 1T tokens,新语料使 HumanEval 30.5 → 36.0、MBPP 44.6 → 49.0。
  • 固定模型与训练量的对照支持语料质量提升,而不只是规模扩大。

标准题与代码编辑

  • HumanEval 90.2、MATH 75.7;Aider 73.7。
  • 大规模继续预训练同时增强代码和数学,通用语言能力保持接近 V2。

复杂仓库任务

  • SWE-bench 仅 12.7;单题代码能力尚未转化为稳定的复杂开发能力。
  • 作者认为指令遵循仍是关键短板,需要与代码能力一起优化。

奖励设计

  • 内部 LeetCode 对照中,RM 信号优于直接 Compiler 01 反馈。
  • 当测试覆盖不足时,学习型奖励可补充直接执行反馈。
内部 LeetCode 对照:用执行反馈训练 RM,再以 RM 指导 RL,优于直接使用 Compiler 的 0/1 信号。
原文图 3:内部 LeetCode 对照:用执行反馈训练 RM,再以 RM 指导 RL,优于直接使用 Compiler 的 0/1 信号。 来源

未来方向 ​

指令遵循与真实开发
  • 提高复杂需求下的指令遵循、代码修改和多步骤任务能力。
  • 将标准代码题进步进一步转化为真实开发场景的生产效率。

(2405) DeepSeek-V2 (MLA、DeepSeekMoE、两阶段 GRPO) ​

🌺 论文摘要

DeepSeek-V2 论文摘要

参考链接

问题背景

  • 长上下文 KV 存储和大规模模型计算成本限制了训练与服务效率。

核心方法

  • MLA:压缩 KV,位置相关部分单独保存。
  • DeepSeekMoE:共享专家处理共性,细粒度路由专家组合处理不同输入。
  • 设备受限路由:限制每个 token 跨越的设备,控制通信开销。
  • 8.1T Pretrain → 128K 扩展 → SFT → 两阶段 GRPO。

模型效果(DeepSeek-V2)

  • Base:MMLU 78.5、MATH 43.6;SFT → RL 后 HumanEval 76.8 → 81.1。

重要结论

  • 21B 激活参数配合 KV 压缩,可同时提高能力并降低训练与推理成本。

核心贡献

  • 建立 MLA + DeepSeekMoE 的架构路线,成为后续系列的重要基础。

未来方向

  • 继续扩展 MoE,改善多语言、对齐与多模态能力。

问题背景 ​

问题背景
  • 扩大参数规模会增加训练计算、KV Cache 和部署成本,需要同时优化 Attention 与专家计算。

核心方法 ​

模型架构 ​

KV 低秩压缩
  • 将多个头的 key/value 压缩到共同的低维 latent,推理时主要缓存该表示。
  • 将 KV 升维矩阵吸收到 query 和输出投影中,解码时直接与 latent 计算,不必展开全部 KV。
  • RoPE 依赖位置,会阻碍上述矩阵吸收;因此单独保留位置相关 key,与压缩内容分开处理。
  • 缓存减少后,可以支持更多并发请求与更长输入。
MHA、GQA、MQA 与 MLA 的缓存方式对照。MLA 将多头 K/V 压缩为共同 latent,降低生成时的 KV 存储需求。
原文图 3:MHA、GQA、MQA 与 MLA 的缓存方式对照。MLA 将多头 K/V 压缩为共同 latent,降低生成时的 KV 存储需求。 来源
专家分工与通信

专家结构

  • 2 个共享专家处理通用知识;160 个路由专家中选 Top-6。
  • 细粒度专家增加组合方式,共享专家减少不同专家重复学习。

负载与通信

  • 每个 token 限制访问的设备数量,减少跨设备传输。
  • 同时平衡专家、设备和通信负载,避免少数设备成为瓶颈。

SFT 与两阶段 RL ​

对齐训练

SFT

  • 1.5M 指令样本,包括 1.2M helpfulness 与 0.3M safety。
  • 改进数据质量,减少幻觉并增强写作能力。

两阶段 RL

  • 第一阶段用推理 RM 优化代码与数学;第二阶段混合 helpfulness、safety 和规则奖励。
  • GRPO 使用同题候选的组内分数作 baseline,减少 Critic 模型成本。

实验设置(DeepSeek-V2,Pretrain + SFT/GRPO) ​

实验设置

基础模型与数据

  • 236B 总参数,21B 激活;预训练 8.1T tokens。
  • 长上下文扩展至 128K;SFT 1.5M 样本、2 epochs。

训练超参

  • 预训练峰值 lr=2.4e-4, warmup=2000, weight_decay=0.1。
  • SFT:lr=5e-6。

评测任务

  • Base:MMLU、MATH、代码等;Chat:HumanEval、LiveCodeBench、IFEval、开放式对话。
  • 另评估每 token 训练成本、KV 占用和最大生成吞吐。

关键结果(DeepSeek-V2 Base / Chat) ​

能力与成本

模型能力

  • Base 的 MMLU 78.5、MATH 43.6,体现稀疏模型的基础能力。
  • SFT → RL 后 HumanEval 76.8 → 81.1,后训练进一步改善代码生成。

训练与推理效率

  • 相对 DeepSeek 67B,训练成本减少约 42.5%,KV Cache 减少约 93.3%。
  • 最大生成吞吐提高至约 5.76 倍;较小 KV 也允许更高并发。
对齐训练结论
  • 通用偏好对齐存在 alignment tax:偏好得分提高时,部分推理能力可能回退。
  • 论文实验中 online RL 优于所比较的 offline 对齐;持续采样能更新训练反馈。

未来方向 ​

原文提出的方向
  • 模型扩展:继续扩大 MoE,同时保持训练与推理经济性。
  • 对齐与知识:减少幻觉,提高帮助性、安全性与知识更新能力。
  • 语言与模态:补强中英文之外的语言,向多模态扩展。
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026