Skip to content

MiniMax 系列

📅 发表于 2025/11/07
🔄 更新于 2026/08/05
👁️ — 次访问
📝 12644 字
⏳ 38 分钟
mainllm
#MiniMax-Text-01
#MiniMax-VL-01
#MiniMax-M1
#Linear attention
#Lightning Attention
#Hybrid Attention
#预训练数据
#数据有效性实验
#多阶段训练策略
#Reward Model
#GenRM
#Offline-DPO
#Online-GRPO
#安全对齐
#长上下文
#VL模型
#CiSPO算法
#可验证数据
#不可验证数据
#SynLogic合成数据
#GenRM长度偏差问题
#长思考Scaling

变化点 ​

2026

2026.05 报告 · MiniMax-M2 系列 / M2.7

  • CISPO 与 Forge 支撑多任务、长轨迹 RL,覆盖 Coding、Agent 和办公任务。
  • M2.7 进一步参与模型研发与 Harness 迭代,扩展模型辅助研发。
2025

2025.12 · MiniMax-M2.1

  • 强化多语言编程、Web/App 开发与复合指令约束。
  • 缩短冗余思考与回答,改善跨 Agent 框架使用体验。(blog)

2025.10 · MiniMax-M2

  • 由 Lightning 混合注意力转回 Full Attention,面向复杂多步任务。
  • 采用交错思考,并用指令、环境和工具反馈扰动提高 Agent 泛化。

2025.06 · MiniMax-M1

  • 在 MiniMax-Text-01 上扩展长推理训练,结合可验证与开放任务。
  • 使用 CISPO 稳定 RL,降低长轨迹训练开销。

2025.01 · MiniMax-01

  • 结合 Lightning Attention 与 Softmax Attention,支持百万级上下文。
  • 从 Text-01 扩展至 VL-01,形成文本与视觉模型分支。

(2605) MiniMax-M2 系列 (CISPO、Forge、M2.7) ​

🌺 论文摘要

MiniMax-M2 系列论文摘要

参考链接

问题背景

  • 长程 Agent 需要跨轮保留推理、操作真实环境;只有问答数据和最终答案奖励,难以覆盖完整工作流程。
  • 低激活参数模型需要兼顾任务能力与成本;长轨迹又带来采样等待、重复计算和训练状态错位。

核心方法

  • 架构与基础训练:229.9B-A9.8B MoE,Full Attention + MTP;29.2T tokens 预训练后学习交错思考。
  • 任务与环境:SWE、AppDev、Terminal、搜索与办公任务,配套可执行环境和产物验证器。
  • 多领域 RL:CISPO 裁剪重要性权重;任务、过程和完成时间奖励共同指导多轮交互。
  • 系统与迭代:Forge 以真实 completion 组织异步训练;M2.7 参与诊断、实验和 Harness 修改。

模型效果(M2.5 → M2.7,SFT+CISPO)

  • SWE-bench Pro:55.4 → 56.2;Terminal-Bench 2.0:51.7 → 57.0。
  • GDPval-AA:35.0 → 50.0;MLE Bench Lite 奖牌率:51.5% → 66.6%。

重要结论

  • 长上下文影响架构选择:SWA 在短任务上接近 Full Attention,但长检索与长程 Agent 效果下降。
  • 能力提升并不均匀:办公、ML 实验增益较大,MMLU-Pro 从 85.2 降至 81.8。

核心贡献

  • 给出围绕真实工作产物组织数据、奖励和 RL 系统的完整 Agent 训练路线。
  • Forge 将不同 Harness 的真实请求接入同一训练系统,支持复杂上下文管理与多 Agent 工作流。

未来方向

  • 持续扩展任务数据、RL 系统与自进化能力;补强高效注意力的长上下文数据、评测和基础设施。

问题背景 ​

长程 Agent 的能力与训练成本

最终答案难以覆盖实际工作质量

  • 代码可以生成,应用未必能运行;文件可以打开,表格公式、页面交互仍可能错误。
  • 验证对象需要从回答文本扩展到实际产物:测试、运行状态、单元格值、渲染结果。

长轨迹放大训练开销

  • 不同任务耗时从秒到小时;同步等待慢任务会浪费资源,优先消费快任务又会偏向简单样本。
  • Harness 可以压缩历史、调用子 Agent;训练必须保存模型当时看到的上下文,不能仅拼接完整日志。
  • 多次 completion 大量共享历史;独立计算每条样本,会重复处理相同长前缀。

核心方法 ​

模型架构与基础训练 ​

细粒度 MoE 与路由

模型配置

  • MiniMax-M2:62层,229.9B 总参数,单 token 激活 9.8B。
  • 隐藏维度 3072;每层 256个专家,每个 token 选择 Top-8。

路由策略

  • 细粒度专家:增加专家数量、缩小单专家 FFN,扩大相同激活预算下的专家组合空间。
  • Sigmoid Gating:独立计算各专家分数,多个专家可以同时获得高分。
  • Expert Bias:为专家路由分数增加可学习偏置,调节负载,减少对辅助均衡 Loss 的依赖。
Full Attention 与长上下文

结构选择

  • 全层使用 Full Attention,48个 Query Head、8个 KV Head,采用 RoPE。
  • GQA 通过共享 KV Head 降低缓存开销;每个 Query 仍可访问完整历史。

选择依据

  • 团队尝试混合 SWA:调整窗口与全局层比例、RoPE、层内混合方式和 Sink Token。
  • 主要风险集中在长检索、多跳推理和长程 Agent;因此 M2 保留 Full Attention。
  • 高效注意力还需要配套低精度状态、Prefix Cache 与投机解码实现,不能只比较理论复杂度。
MTP 训练与投机解码

训练流程

  • 预训练先加入 1个 MTP Module,提供下一位置的辅助预测监督。
  • 衰减阶段扩展至 3个 MTP Module,从主模型复制权重初始化。
  • 先冻结主模型、单独训练新增模块,Loss 稳定后再联合训练。

推理过程

  • MTP 模块先生成多个 Draft Token,主模型一次前向验证这些候选。
  • 被接受的候选直接使用;验证流程保持原模型的采样分布。
  • RL 阶段继续训练 MTP,避免主策略更新后 Draft 分布落后。
预训练与交错思考 SFT

数据构成

  • 网页、论文、书籍、代码和结构化问答;模型评分与分类器共同筛选质量。
  • 上采样代码、数学、STEM,同时保留通用知识与语言覆盖。

训练阶段

  • 恒定学习率阶段:19.9T tokens;衰减阶段:9.3T tokens。
  • 上下文按 8K → 32K → 192K 扩展,衰减阶段混合短文本与长文本。
  • 长文本来自代码拼接、长 PDF、主题相关文档打包;扩长度时继续补充高质量数据。
Interleaved Thinking SFT

轨迹形式

  • 思考 → 工具调用 → 工具反馈 → 新一轮思考,每轮都能根据新证据修改计划。
  • 保留前轮 thinking,使已排除的假设、任务约束和中间结论继续参与下一轮决策。

数据筛选

  • 覆盖 Chat、Reasoning、Code、Cowork,同时包含单轮推理和多轮交互。
  • 按领域奖励进行大规模 Rejection Sampling,再清洗推理、动作和反馈,保留高质量完整轨迹。

任务与环境构建 ​

SWE-Scaling(真实 PR、可执行环境、任务扩展)

PR 与环境

  • 收集宽松许可仓库中的已合并 PR、关联 Issue、Code Diff 与测试,过滤缺少有效测试的样本。
  • 环境 Agent 编写 Docker 构建脚本,依据执行错误修复依赖、编译器和测试命令。
  • 按 PR 类型分流:Bug Fix、Feature、性能优化、重构、测试,覆盖 10余种语言。

任务验证

  • Bug Fix:提取 F2P 和 P2P 测试,既检查原 Bug 修好,也检查原有功能未被破坏。
  • Feature:提取新增功能测试点;测试依赖新接口时,不强行套用 Bug 修复的 F2P 规则。
  • 性能优化:保留功能测试,并确认前后性能差异稳定、可测。
  • 用 Golden Patch 验证任务有效性,再检查题意与测试是否一致,补全缺失条件。
PR 任务扩展

难度与任务类型

  • Bug Injection:向已有代码注入错误,扩展修复场景。
  • Commit Merging:合并相邻提交,构造需要多步修改的任务。
  • SWE-Test:从修复任务反向构造写测试任务,要求测试在修复前失败、修复后通过。
  • Code Review:检查变更并识别缺陷,由另一模型复核,补充无法直接执行验证的任务。
AppDev(专家任务合成、Prompt Distillation、AaaV)

专家指导合成

  • 专家设计 Meta Query,明确技术栈、架构约束、应用场景和功能要求。
  • 从组件库、框架、UI 风格等种子池采样,生成不同开发需求,再做 MinHash 去重。
  • 按技术栈合理性、功能可实现性、需求清晰度过滤任务。

Prompt Distillation

  • 采样时给完整专家提示:先写规格、维护 TODO、执行测试,并遵循设计规范。
  • 训练时去掉部分提示,让模型将这些做法学成默认行为,减少推理时的提示依赖。
Agent-as-a-Verifier

三级验证

  • 执行层:检查文件、语法、依赖安装、构建和 HTTP 状态;运行失败直接拒绝。
  • 交互层:用 Playwright 点击按钮、填写表单,检查核心流程是否真正完成。
  • 视觉层:渲染应用,检查布局、视觉层次和设计质量。

奖励与筛选

  • 每个 Rubric 需要通过/失败判断及对应证据,以各项通过情况筛选轨迹。
  • 执行层是硬门槛:视觉评分高不能抵消应用无法运行。
SWE 与 AppDev 的数据流程:前者从真实仓库变更构造可执行任务,后者从开发需求生成应用,并以分层检查验证产物。
原文图 3:SWE 与 AppDev 的数据流程:前者从真实仓库变更构造可执行任务,后者从开发需求生成应用,并以分层检查验证产物。 来源
Terminal-Gym(环境合成、任务演化、难度校准)

任务与环境

  • 从 Stack Overflow 筛选可脚本化、可测试的 Linux/Docker 问答,保留高质量已接受答案。
  • 将问答改写成任务规格:环境、工具、输入输出、成功条件和必要文件。
  • Agent 生成 Dockerfile 与测试脚本,执行后依据错误反馈迭代修复。

难度演化

  • 逐步减少路径、命令和预期输出等提示,但保持任务目标不变。
  • 同一任务的不同表述共用测试,避免验证器只适配某种题面。
  • 根据参考模型通过率和环境修复次数筛选任务,增加较难且可执行的样本。
Cowork(搜索、办公、表格、Slides)

Deep Search

  • 从种子问题出发,逐轮改写题目、隐藏实体线索,增加跨来源搜索与推理难度。
  • 为问题配套证据要求;接受轨迹时,检查答案是否由实际检索内容支持。
  • 开放式研究报告用 Rubric 评估事实、透明度、不确定性与风险说明。

办公任务

  • 以适配 Harness 的 GDPval 任务为种子,按职业、地区和工作场景扩展任务。
  • 同时生成工作目录、支持文档、不同详细程度的需求,以及预期产物规格。
  • 从多个教师与不同 Harness 设置采样,过滤编造数据、引用或实体的轨迹。
表格与 Slides 验证

金融与表格

  • Evidence-Driven:先调用真实金融工具获得执行记录,再从记录反推可回答的问题。
  • Workbook Walk:对种子表格执行原子操作,将中间表格作为新种子,再从操作轨迹反推问题。
  • 用外部引擎重算输出表格,比较单元格结果;开放式建模再辅以 Rubric 或 Agent 评审。

Slides

  • 分别合成从文档生成整套 Slides、对已有页面局部编辑的任务。
  • 验证执行成功、功能要求、布局规则,再把文件渲染为图片检查视觉质量。
  • 混合不同生成工具库的轨迹,避免能力绑定单一工具接口。
推理与通用数据扩展

推理数据 Scaling

  • Query 扩展:补充新问题和薄弱难度区间,提高任务覆盖。
  • Response 扩展:同题采样多条正确解法,提高推理策略多样性。
  • 按训练阶段调整两类数据的预算,结合题目清洗、Verifier 边界检查和解答评分控制质量。

通用能力保留

  • 混合写作、问答和多轮对话;同时保留用工具与不使用工具的样本。
  • Role-Play:专家模型 Self-Play 合成对话,按角色、逻辑和风格一致性筛选。
  • 使用去偏后的产品反馈训练 Role-Play,并监测熵与 Reward Hacking。

多领域 RL 与信用分配 ​

Completion-MDP 与训练状态

角色划分

  • Policy:给定本轮上下文,生成一次 completion;可以包含思考、工具调用或子 Agent 请求。
  • Harness:执行工具,管理记忆、上下文压缩和分支,构造下一轮输入。
  • Verifier:检查任务产物和过程,提供奖励;Trainer 消费请求、响应与奖励更新模型。

训练单元

  • 每个训练样本是实际请求的 (state, completion);整条任务轨迹用于奖励传播和优势估计。
  • 例如 Harness 已将 100K 历史压缩成 20K:训练该动作时也使用实际的 20K 输入。
  • 历史可以被改写,训练不要求它始终是前一轮内容的简单追加。
复合奖励与 Reward-to-Go

三个组成部分

  • 任务奖励:测试通过、目标产物质量等主要任务信号。
  • 过程奖励:约束语言混杂、错误工具格式,鼓励结构清晰的中间推理。
  • 时间奖励:按实际完成时间与参考时间的比值评分,时间越短,奖励越高。
rt=rtperf+αrtprocess+βrtspeed
  • 蓝色项针对实际耗时;并行工具调用和减少无效子 Agent 开销,都可能改善这一项。

优势估计

  • 从当前动作向后累计奖励,再减去 trajectory baseline,降低长轨迹梯度方差。
  • 报告的基础式采用后续奖励求和,并进一步给出带折扣的 Reward-to-Go。
Gt=∑p=tTγp−trp,A^i,t=Gi,t−Bi
  • G 表示后续回报,B 为轨迹基线;已经发生且不受当前动作影响的奖励不再重复计入。
CISPO 重要性权重裁剪

更新规则

  • 在相同上下文、相同生成 token 上,计算当前策略概率 / 采样策略概率。
  • 将比例裁剪到 [0, 1+ε],停止对比例求导;再用它乘优势和当前 token 的 log-prob。
  • 对有效响应 token 求和,按总 token 数归一;以下为单 token 的最大化目标。
ρ^=clip(πθπold,0,1+ϵ),Jt=sg(ρ^)A^tlog⁡πθ
  • 蓝色权重控制更新幅度;红色优势决定提高还是降低该 token 的概率。
  • Loss 实现取 -J;反向传播经过 log π,不经过裁剪后的权重。

与 PPO 的差别

  • 正优势 token 的概率比超过上限时,PPO 的 clipped 分支可能不再提供梯度。
  • CISPO 保留该 token,只限制梯度权重,减少高重要性权重造成的更新不稳定。
  • 例:比例 3、上限 2、优势 1,该项仍保留 2 × ∇log π 的更新。
多领域 RL 课程

同阶段混合

  • 每阶段同时采样 Reasoning、Coding、Agent、General,减少单领域优化造成的遗忘。
  • 早期侧重推理与通用能力,后期提高 Agent 与代码任务占比。

跨阶段调整

  • 逐领域增加允许的上下文长度,从较短交互扩展到长程任务。
  • 随模型能力提高增加难题比例;领域比例、长度和难度共同调整。

训练系统与模型迭代 ​

Gateway 与白盒/黑盒 Harness

数据流

  • Agent/Harness → Gateway → Rollout Engine:请求模型生成,返回 completion。
  • 请求、响应、奖励 → Data Pool → Train Engine:构造训练样本,计算 CISPO,再同步新权重。

Harness 接入

  • 白盒:训练框架知道上下文管理规则,可重建截断或摘要后的训练状态。
  • 黑盒:只要求 completion 请求经过 Gateway,记录真实输入,不必改写内部 Agent Loop。
  • 两者共用训练接口,支持复杂记忆、动态历史改写和多 Agent 协作。
Forge 把 Agent、训练/推理和中间接口分离。沿 Gateway 与 Data Pool 观察请求、轨迹和训练数据如何流动。
原文图 4:Forge 把 Agent、训练/推理和中间接口分离。沿 Gateway 与 Data Pool 观察请求、轨迹和训练数据如何流动。 来源
Windowed FIFO 调度

窗口规则

  • 以最早未消费的任务为队首,只允许窗口内已完成的任务进入训练。
  • 窗口内可以乱序消费;窗口外即使更早完成,也需要等待窗口前移。
  • 窗口大小控制吞吐与样本分布之间的取舍,避免训练持续被短任务占据。

示例

  • 窗口包含任务 1~4:任务 2、3 完成后可以先训练,不必等待任务 1。
  • 任务 10 即使完成,也不能越过当前窗口;因此乱序幅度受到限制。
Prefix Tree 与 Rollout 加速

Prefix Tree Merging

  • 将共享上下文的多个 completion 合并成树,共同前缀只计算一次,再分别计算各个分支。
  • 前向后按元数据恢复独立样本 Loss,保留各样本的注意力关系与损失权重。
  • 适合长前缀、多轮请求;前缀重合越多,可节省的重复计算越多。

推理侧优化

  • MTP 联合训练:用 Top-K KL Loss 让 Draft 跟随 RL Policy,维持接受率。
  • Prefill/Decode 分离:分别调度长输入处理和逐 token 生成,减少互相阻塞。
  • 全局 KV Cache:跨实例共享前缀缓存,路由同时考虑排队时间与缓存迁移成本。
M2.7 自进化(Model Iteration System)

实验执行循环

  • 人类制定实验目标;M2.7 运行实验、读取日志、诊断异常、修改代码和配置。
  • 每轮写报告与记忆,基于前次失败继续分析;重大方向调整由人类审查触发。

Harness 改进

  • 模型执行失败分析 → 修改 Harness → 评测,积累循环检测等机制与更合适的配置。
  • MLE 任务中,模型每轮保存记忆文件和自我批评,再据此改进下轮实验。
  • 这里的自进化包含研发流程与 Harness 改进,模型参数更新仍由训练系统执行。

实验设置(预训练、SFT、CISPO) ​

✍️ 实验设置

训练配置

基础模型

  • MiniMax-M2:229.9B-A9.8B,62层,256 Experts / Top-8,Full Attention + GQA。

训练任务/数据

  • 预训练:29.2T tokens;19.9T 恒定学习率阶段 + 9.3T 衰减阶段。
  • SFT:Chat、Reasoning、Code、Cowork 的筛选轨迹;RL 混合推理、代码、Agent 与通用任务。
  • Agent 任务使用前述 PR、AppDev、Terminal、搜索和办公数据 Pipeline。

算法与超参

  • 长度课程:8K → 32K → 192K;MTP Loss Weight:0.3 → 0.1。
  • RL:CISPO + 复合奖励 + Reward-to-Go;Windowed FIFO 实践窗口 W=0.3N。
  • 报告未给出完整 SFT/RL 样本量、学习率、Batch Size、训练步数与奖励系数。

架构消融

  • MoE/MTP 对照:17.8B-A2B,统一训练 500B tokens。
  • 细粒度 MoE:32 Experts / Top-2 对比 128 Experts / Top-8,保持总参数与激活参数一致。
  • Attention 对照:在 M2 架构规模比较 Full Attention 与混合 SWA,分别评估预训练与 SFT 模型。
评测任务与协议

模型与采样

  • M2.5、M2.7:开启 Thinking 与 Interleaved Thinking;默认 temperature=1, top_p=0.95。
  • 对照:Opus 4.6、Sonnet 4.6、GPT-5.4、Gemini 3.1 Pro,使用对应高推理配置。

Coding / MLE

  • SWE-bench Pro、Multilingual、Multi-SWE、NL2Repo:M2 使用 Claude Code,平均 4次。
  • Terminal-Bench 2.0:Terminus-2 XML,8 vCPU / 16GB,2h 限制,平均 4次。
  • MLE Bench Lite:22个竞赛,单任务 1张 A30 / 24h,Bash + WebSearch,独立重复 3次。

搜索、办公与推理

  • BrowseComp 等搜索任务使用 WebExplorer;历史达到窗口 30% 后清理 Assistant 与 Tool 消息。
  • GDPval-AA 使用 Artificial Analysis 评测;内部办公任务通过专家 Rubric 验收。
  • AIME 2026、GPQA、MMLU-Pro 等遵循 AA Index v4.0,无工具、pass@1。

关键结果(MiniMax-M2.7 + SFT/CISPO) ​

🍑 关键结果

Coding、办公与推理效果

Coding 与 ML 实验(M2.5 → M2.7)

  • SWE-bench Pro:55.4 → 56.2;Multilingual:74.1 → 76.5,仓库修复继续改善。
  • Terminal-Bench 2.0:51.7 → 57.0;NL2Repo:26.6 → 39.8,复杂终端和项目构建增益更大。
  • MLE Bench Lite 奖牌率:51.5% → 66.6%;24 小时内反复诊断、修改实验能持续积累收益。

办公与搜索(M2.5 → M2.7)

  • GDPval-AA:35.0 → 50.0;Toolathlon:38.3 → 46.3,跨工具和工作产物任务明显改善。
  • 金融建模内部评测:33.8 → 57.0;表格竞赛 MEWC v2:49.8 → 63.3。
  • BrowseComp:76.3 → 77.8;复杂浏览内部集 RISE:50.2 → 64.3。

推理与通用知识

  • AIME 2026:87.2 → 94.2;GPQA:85.2 → 89.8,推理能力随版本提升。
  • MMLU-Pro:85.2 → 81.8;因此需要同时监控通用能力,不能只按 Agent 分数选择训练配比。
  • 主要增益集中在新增任务与验证 Pipeline 对应的领域,体现真实任务数据的价值。
架构消融结论

细粒度 MoE(17.8B-A2B,500B tokens)

  • 32 Experts / Top-2 → 128 Experts / Top-8:MATH 19.6 → 24.1,HumanEval 29.7 → 32.5。
  • 相同参数与激活预算下,专家划分更细可改善组合能力;这是独立的小规模结构实验。
  • 加 MTP:MATH 19.6 → 21.3,HumanEval 29.7 → 30.1,辅助预测为推理和代码提供额外收益。

Full Attention 与 SWA

  • 预训练 RULER 128K CWE:Full 90.0、SWA 72.0;32K 时二者均为 99.0。
  • SFT 后 SWE-verified:Full 54.7、SWA 50.2;Terminal:26.7、23.8。
  • 短任务分数接近仍可能掩盖长任务缺陷;架构评测需要覆盖最终部署的上下文长度和交互方式。
训练系统与自进化结论

长轨迹训练

  • Prefix Tree 在高前缀重合负载下,报告最高 40倍 训练加速;收益来自避免重复计算历史。
  • 去掉前轮 Thinking 的消融会降低长程 Agent 表现,说明中间假设与推理状态值得跨轮保留。

研发闭环

  • 内部 Harness 优化连续执行 100轮 修改与评测,发现循环检测等策略,内部评测改善约 30%。
  • 模型已能承担部分实验执行与失败诊断;稳定积累收益仍依赖可运行评测、持久记忆和人类审查。

未来方向 ​

⛳ 未来方向

报告提出的后续路线

高效架构与长上下文

  • 完善长上下文数据、评测和推理基础设施,再推进次二次复杂度注意力。
  • 重点补齐复杂多跳任务评测、低精度状态存储、Prefix Cache 与投机解码的兼容性。

Agent 数据与训练闭环

  • 将 Terminal-Gym 扩展为自动构建环境的 Anything2Docker,并扩展 CVE-Factory 的安全任务。
  • 继续协同扩展高质量任务、Forge RL 系统和模型辅助研发,使后续版本获得持续增益。

(2512) MiniMax-M2.1 ​

(2510) MiniMax-M2 ​

问题背景 ​

❓问题背景

放弃稀疏注意力的原因 ​

问题背景

高效(稀疏/线性)注意力目标是节省资源

  • 节省计算资源,同等算力下获得更好性能;而不是在无限算力下超越Full注意力的绝对效果。

现有Bench不全面/评测局限性/观测局限性

  • 旧Bench+小模型上,稀疏能打Full注意力。
  • 但随着模型Scale,在复杂/多步推理任务上,稀疏注意力显示出明显缺陷,
    • 初期没有问题,随着模型训练,在后期才慢慢出现,非常昂贵的教训

相比Full,稀疏注意力基建不成熟

  • 训练:瓶颈在于内存访问,需要极致的IO优化。DeepSeek NSA 笔记
  • 推理:要实现理论上的速度,需要解决一些工程问题:States的低精度存储、高效Prefix Cache、优化投机解码等。

滑动窗口失败实验

  • 改成滑动窗口注意力:发现上下文越长性能下降越明显,因为预训练是Full,
    • 按照DeepSeek NativeSA的说法,需要预训练就是Sparse才行,否则存在预训练微调/训推不一致的问题。

Agent后训练对齐目标难确定 ​

后训练对齐目标

问题

  • 模型在不同框架里实际效果差异很大。
    • 如ClaudeCode里ok,在Roo Code却不ok
    • 在ToolUse等Benchmark里ok,实际场景又不ok。

目标1:开源Benchmark

  • 衡量纯粹能力:如BrowseComp。

目标2:适配不同工具

  • 模型在不同CodeIDE/Cli、Agent框架等工具里,都能表现稳定。

Agent 泛化的失败经验 ​

警告

初期Scale想法及问题

  • 从最小工具集出发(python+搜索+browse网页浏览),Scale上百种工具。
    • 仅仅Scale Tool_Info
  • 问题
    • 模型换个框架(系统指令)、换个环境等,性能就会大幅下降。
  • 真正的泛化,应该是全链路的泛化,适应各种扰动信息。

核心方法 ​

📕核心方法

由Linear变回Full Attention ​

核心方法

背景

  • 当模型Scale以后,在复杂多步推理任务上,Linear注意力效果不行、低于Full注意力。

核心方法

Interleaved Thinking ​

M2交错思考模式

核心思想

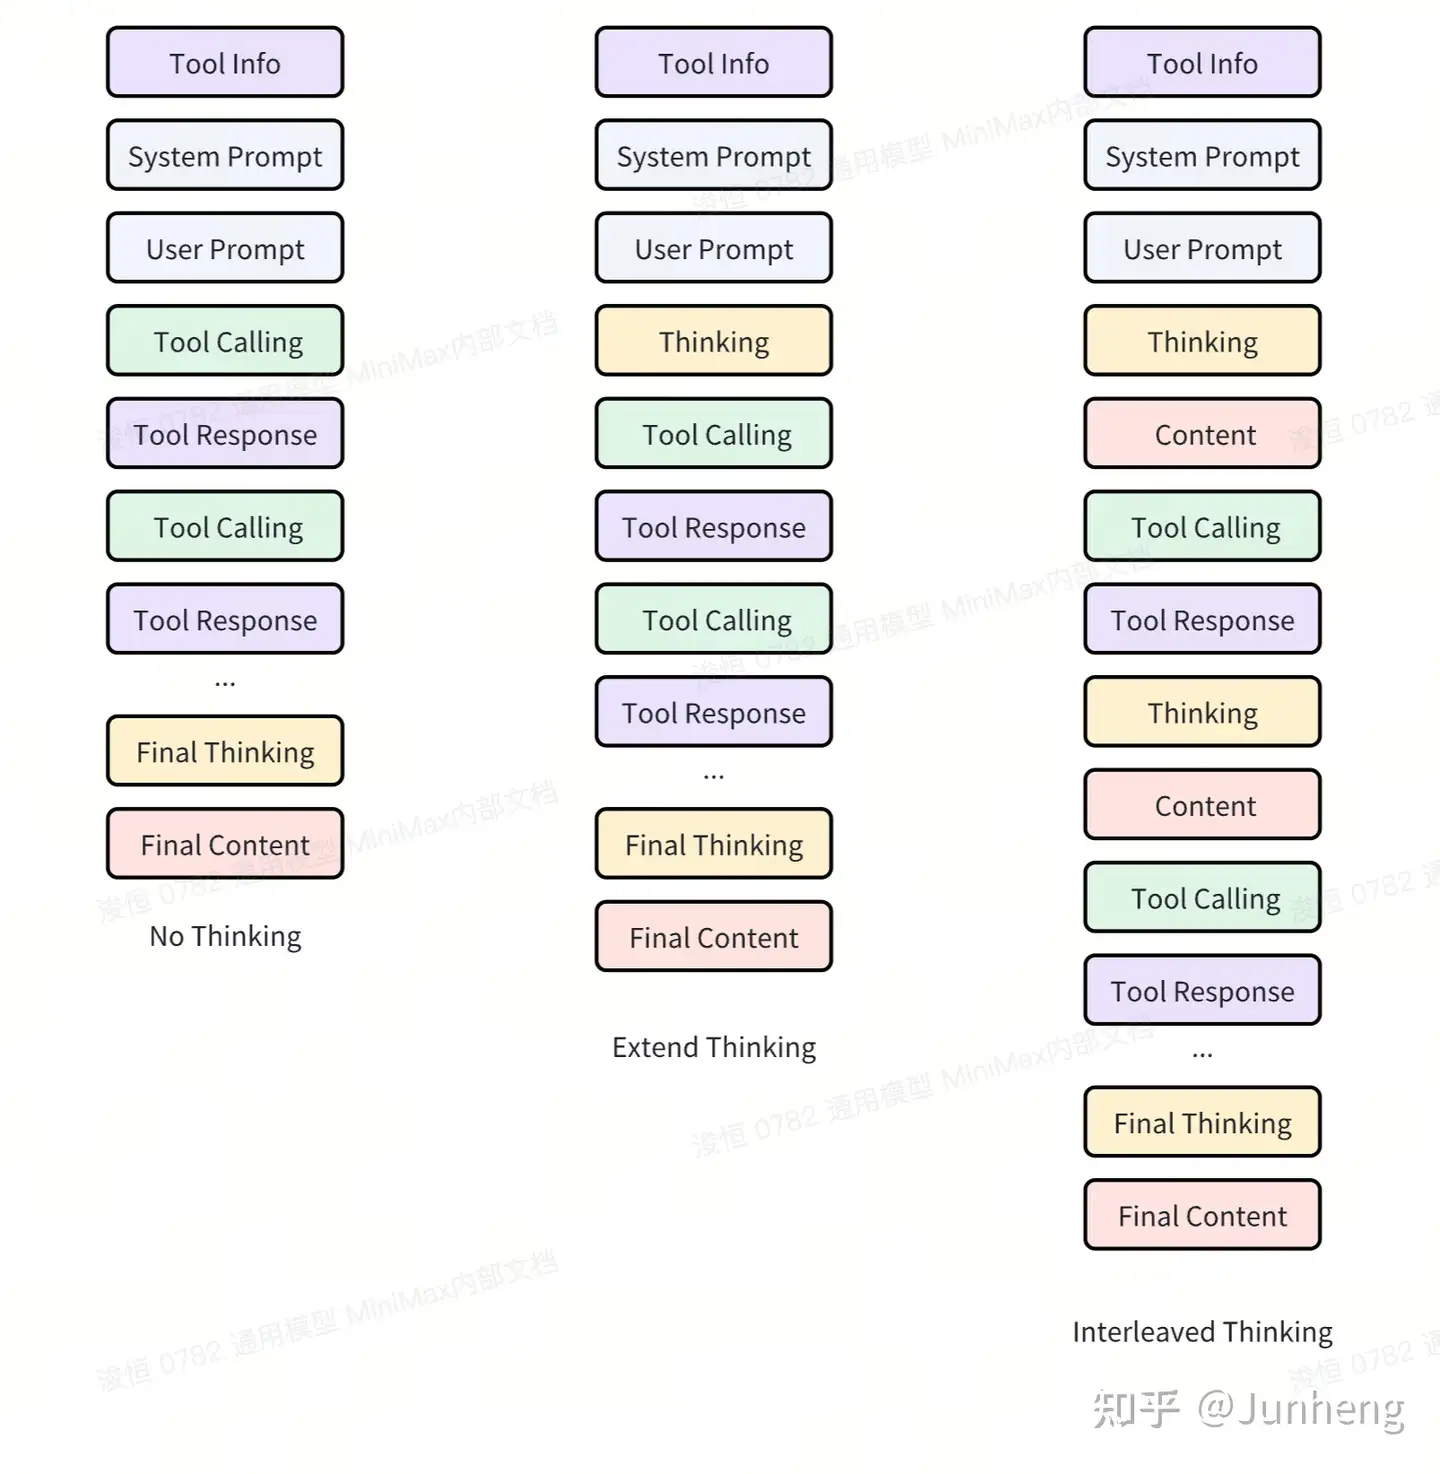
  • thinking 可以出现在任意位置,而不是推理模型那样只在开头。

  • 原因

    • 若只在开头思考,很难保证长任务的指令遵循

    • Agent加入了模型外的扰动(工具返回内容),要求LLM能稳定从这些信息中探索到有用的内容。

Interleaved Thinking

  • 见下图最右侧。
  • 先进行一小步思考,决定调用工具;调用工具,得到结果;再次进行思考。
  • 思考 -> 行动 -> 思考 -> 行动,直到任务完成。

特点

  • 需保留完整上下文,包括中间所有的thinking内容。

Agent 全链路泛化 ​

全链路泛化-数据方法

背景

  • 泛化不仅仅对Tool_Info做Scaling,而需要对全链路做泛化,应对所有环节变化。

全链路泛化

  • 系统指令扰动:System Prompt,不同框架可能不同,
  • 用户指令扰动:User Prompt,用户提问可能模糊、不完整。
  • 环境扰动:Env,代码仓库文件结构可能是混乱的。
  • 工具返回扰动:Tool Response,同一个错误,不同工具返回可能不一样。

核心方法

  • 覆盖全轨迹泛化的数据链路,人工制造出各种环境的扰动数据,来训练模型。

优点

  • 提高模型抗扰动能力,保证在绝大扰动情况下,都能稳定的完成任务。
  • 结果超出预期。

Good Reasoning 数据 ​

好的推理数据3个标准

质量必须高

  • CoT:逻辑完整、无冗余。
    • 比如:过于简单的CoT会让模型不思考或过于自信。
  • Response:多样性要好、不同格式,
    • 不过拟合在一个固定bench格式上
  • 数据必须干净:过滤幻觉、逻辑错误、指令不跟随等数据
    • 清洗方法:Rule + LLM-as-a-judge方法,。

数据多样性和难度

  • math和code是推理能力的基础:能给其他任务带来收益。
  • 需要足够多样的领域数据:逻辑推理、科学知识、指令跟随、开放创意等。
  • 数据要有难度:更难的、更复杂的query,对模型训练更有效。
  • 需调整数据分布:
    • 根据passrate(可验证数据)、复杂度评分(不可验证)来做调整。

数据Scaling

  • 当数据质量和多样性都过关时,就进入大力出奇迹阶段,提升数据规模,带来效果增益。
  • 常见手段
    • 增加query数量,1Q多A,多epoch训练,混合不同方向的数据,带来更多的训练步数
  • 工业数据Scale Pipeline
    • 高效生产海量、高质量、多样化的数据。
    • 把数据分为2类,建立2条pipeline,自动化数据合成和处理。
      • 可验证:数学/code
      • 不可验证:开放性的,无唯一答案的。
未来方向

复合能力

  • 如 知识+Reasoning,Agent工具对Reasoning任务的增益。

融合可验证和不可验证2类任务

  • 不同doman CoT融合、训练方式统一等。

✍️实验设置

实验配置

🍑关键结果

关键结果

⛳未来方向

未来方向

(2506) MiniMax-M1: Scaling Test-Time Compute Efficiently with Lightning Attention ​

摘要
  • paper, 2025 LLM 技术报告(8):MiniMax-M1
  • 在MiniMax-Text-01上,扩展RL训练(CPT/SFT/RL),提出了CiSPO算法。
  • 核心:RL训练中,可验证任务和不可验证任务的数据构建及训练策略,以及长度Scaling。

问题背景 ​

❓问题背景

问题背景

MiniMax-Text-01

  • Hybrid Lightning Attention + MoE

LRM

  • LRM很好,但扩充长度受限于softmax o(n2)限制。
  • 有些解决方法,但都没在LRM上大规模应用。

冷启动训练 ​

继续预训练 ​

继续预训练

背景

  • 提升基座模型推理和长上下文能力,推理相关数据预训练,保持多样性。

训练数据

  • 7.5T tokens:精心挑选的推理相关语料。
  • 用真实自然的Web和PDF数据,不用人工合成数据。
  • 提高数学、代码数据召回率,整体达70%比例。包括STEM、Code、Book、推理数据等。

训练策略

  • 降低MoE辅助loss系数、调整并行策略支持更大的micro_batch_size。
  • 学习率
    • 2.5T tokens:8e-5
    • 5T tokens:衰减至8e-6

上下文扩展

  • 背景:Hybrid注意力,激进扩展上下文,容易出现梯度爆炸。
  • 原因:早期层优化跟不上后期层的变化。
  • 方法:
    • Earlier Layers和Later Layers有不同的衰减率。
    • 四阶段训练方法:从32k开始,逐步扩展至1M token。

SFT ​

SFT

背景

  • 通过高质量示例,向模型慢慢注入类似于反思、CoT之类的预期行为。
  • RL 冷启动。

训练数据

  • 领域:数学、代码、STEM、写作、QA、多轮对话。
    • 数学、代码占比60%

RL 训练 ​

📕核心方法

CISPO算法 ​

CiSPO
  • CISPO 算法:放弃信任域、只裁剪IS权重数值,使用Token-Level-Loss

可验证数据 ​

可验证数据

1. 数学推理

  • 数据源:公开、数学竞赛等,数十万高质量,覆盖多种难度,每个都有参考答案。
  • 清洗流程
    • 过滤
      • 不完整的、格式错误、排版错误
      • 多个子问题的、证明题的、二元选择题(避免蒙)
      • 不能从参考答案中提取出最终答案的
      • 使用强推理模型做预测,计算pass@10,过滤得分超过0.9的样本
    • 去重
      • SFT去重:基于embedding的方法
      • Benchmark去重:基于embedding+ngram的方法
    • 重写
      • 多选改写为开放式问题
    • 答案提取:利用模型从参考答案中提取出最终答案
  • 结果:50k高质量数学数据

2. 逻辑推理

  • 数据源:挑选41个logic推理任务(密码破译、数独等)
  • SynLogic:合成了53k逻辑推理数据。
    • 2大核心:Task-specific generator + rule-based task-specific verifiers。
    • 配置难度系数
      • 避免过难数据:要求pass@10 > 0
      • 难度下限:MiniMax-Text-01:通过率在0-0.5之间。
    • 在训练后期,逐步增加难度。

3. 竞赛编程

  • 数据源:公开竞赛平台、网站。
  • 对于无测试用例的:
    • 使用MiniMax-Text-01生成测试用例
    • 和推理一致,根据质量和难度筛选问题,仅保留中等和较难问题。
  • 最终:3w 竞赛编程数据。

4. 软件工程

  • 基于github的真实数据,筛选了几k。
    • 包括PR + Issue。(bug定位、代码修复等)
    • 有预定义的测试用例,也可以生成测试用例。
    • 每条数据:问题描述、初始错误代码、一组测试用例。
  • 类似SWE-Bench,构建可验证的RL环境,沙盒环境
    • 代码可执行
    • 正反馈:编译成功、测试用例通过
    • 负反馈:编译失败、测试用例不通过等等

不可验证数据 ​

不可验证数据

总计

  • 25k 复杂样本

有GT 任务

  • STEM及其他事实性问题,有客观gt 但表达多样,不好通过rule验证
  • Generative Reward Model,5分制,评估2部分
    • RM Benchmark(人工标注的):(模型回复,gt)
    • Best-of-N和Pass@N的差距
    • 逐步调优GenRM的prompt。

无GT 任务

  • 从内部标签系统抽样的数据,包括指令跟随、创意写作等。
    • 确保多样性,覆盖多个领域。
  • 参考答案生成:使用内部/外部模型,生成参考答案。
  • 奖励信号:模型回复和参考答案做比较。
    • -1:更差,0:差不多;1:更好

训练策略 ​

GenRM 长度偏差解决办法

LongCoT GenRM 长度偏差 / Reward Hacking

  • 偏爱冗长回复,且无实质内容,
  • 不爱更精简的、更好的回复。

方法1:离线策略(无效果)

  • 丰富训练数据多样性:不同响应长度、来源、质量等
  • 使用对抗样本暴露弱点
  • 改进模型架构。
  • 无效果:无法避免真实动态RL训练里的长度偏见。

方法2:在线监控&重新校准(有效)

  • 训练过程中,实时监控长度偏见。
    • 长度增加、GenRM得分增加,但指标下降。
  • 如果发现,则停止训练,重新校准GenRM以后再训练。

方法3:补充算法手段

  • Reward修正、价值裁剪、归一化
    • 钝化奖励信号,降低长度bias带来的训练影响。
课程设计

背景

  • 单一策略同时学习推理、通用任务,有挑战。

方法

  • 课程设计:从rule任务开始,逐步混入通用任务。
    • 先学明确对错的、再学灵活通用的。
  • 优点:防止灾难性遗忘,

长思考RL Scaling ​

RL Scaling to Longer Thinking

背景

  • 第一步训练:40k输出长度,MiniMax-M1-40k
  • Scaling:80k,目标训练MiniMax-M1-80k

数据

  • 过滤:使用M1-40k 过滤易回答样本,保留困难样本。
  • 降采样合成推理数据,因为其会破坏长上下文的RL训练稳定性。

长度扩展策略

  • 逐步扩展长度:40k -> 48k -> 56k -> 64k -> 72k -> 80k。
  • 优点:保证训练稳定
  • 判断依据:困惑度是否收敛、99%输出长度是否接近上下文窗口限制等

解决训练不稳定问题

  • 问题:在每个长度窗口的训练后期,容易崩溃现象。
  • 表现:生成序列的后半部分,变成 语无伦次或乱码文本,通常伴随困惑度增加。
  • 根本原因
    • 负样本长度增长速度远高于正样本,大量超长负样本占据主导
    • 巨大负梯度累积在序列后半部分。
  • 解决方法
    • 熔断机制:检测到重复生成无意义内容,提前终止生成
    • 平衡计分:采用seq-loss和token-loss的归一化组合,避免超多负样本token影响
    • 控制更新幅度:降低梯度裁剪阈值和ϵhigh

算法实验 ​

实验配置 ​

✍️实验设置

实验配置

Core Benchmark

  • 数学
    • Math500、AIME24/AIME25(采样32次,算平均)
  • 代码
    • LiveCodeBench、FullStackBench
    • 指标:16次采样
  • 推理知识
    • GPQA-Diamond(32次采样)、MMLU-Pro、HLE Bench(没使用外部工具)、ZebraLogic
  • 软件工程
    • SWE-bench Verified
  • 长上下文
    • OpenAI-MRCR、LongBench-v2
  • Agentic Tool Use
    • TAU-Bench (最多40步,GPT4.1作为user model)
  • 事实性
    • SimpleQA
  • 通用助手
    • MultiChallenge(多轮对话,GPT-4o 打分)

关键结果 ​

🍑关键结果

关键结果

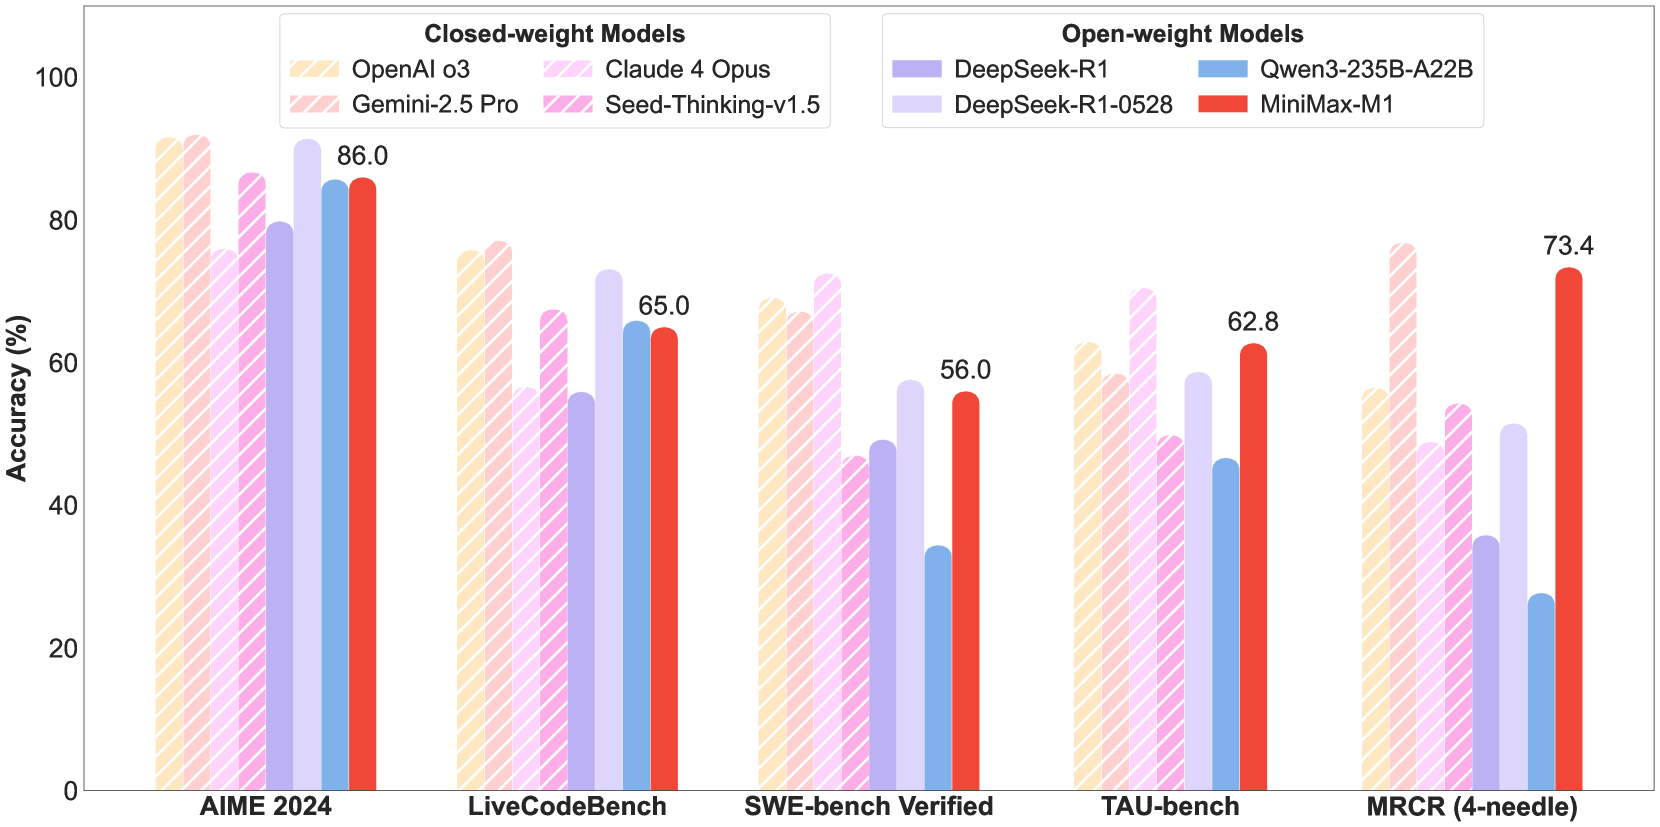
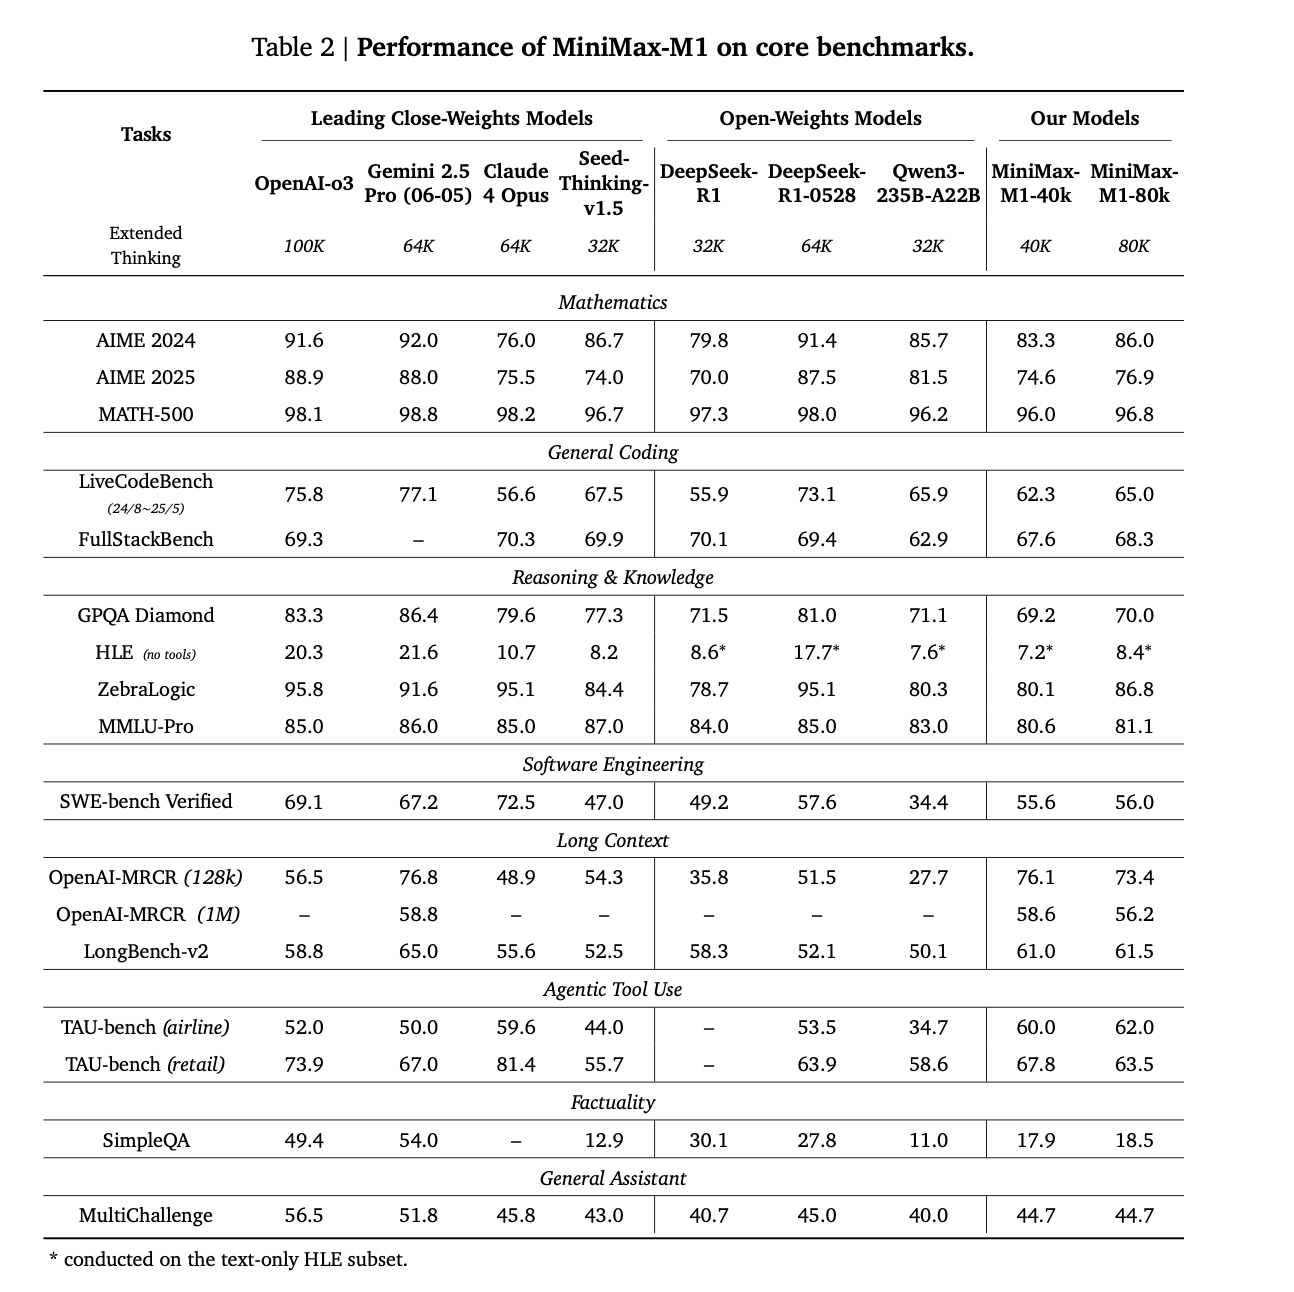
结果

  • 基于MiniMax-Text-01进行RL训练,得到MiniMax-M1
    • MiniMax-M1-40k 和 MiniMax-M1-80k,80k生成长度优于40k。
    • 在SE/ToolUse/长上下文:超过DeepSeek-R1和Qwen3-235B
  • 效率高(线性注意力):更方便大规模RL训练
    • Inference:和DeepSeek-R1相比,生成64k 节省50% FLOPS,生成100k 节省只需25% FLOPS。
  • 1M超长上下文:有能力处理复杂真实问题。

指标

  • 通用任务:稳居第一梯队
    • 数学&编程
    • 知识&对话
  • 王牌领域:三大榜单统治力效果
    • SWE-Bench
    • 长上下文:
    • 工具使用:TAU-Bench

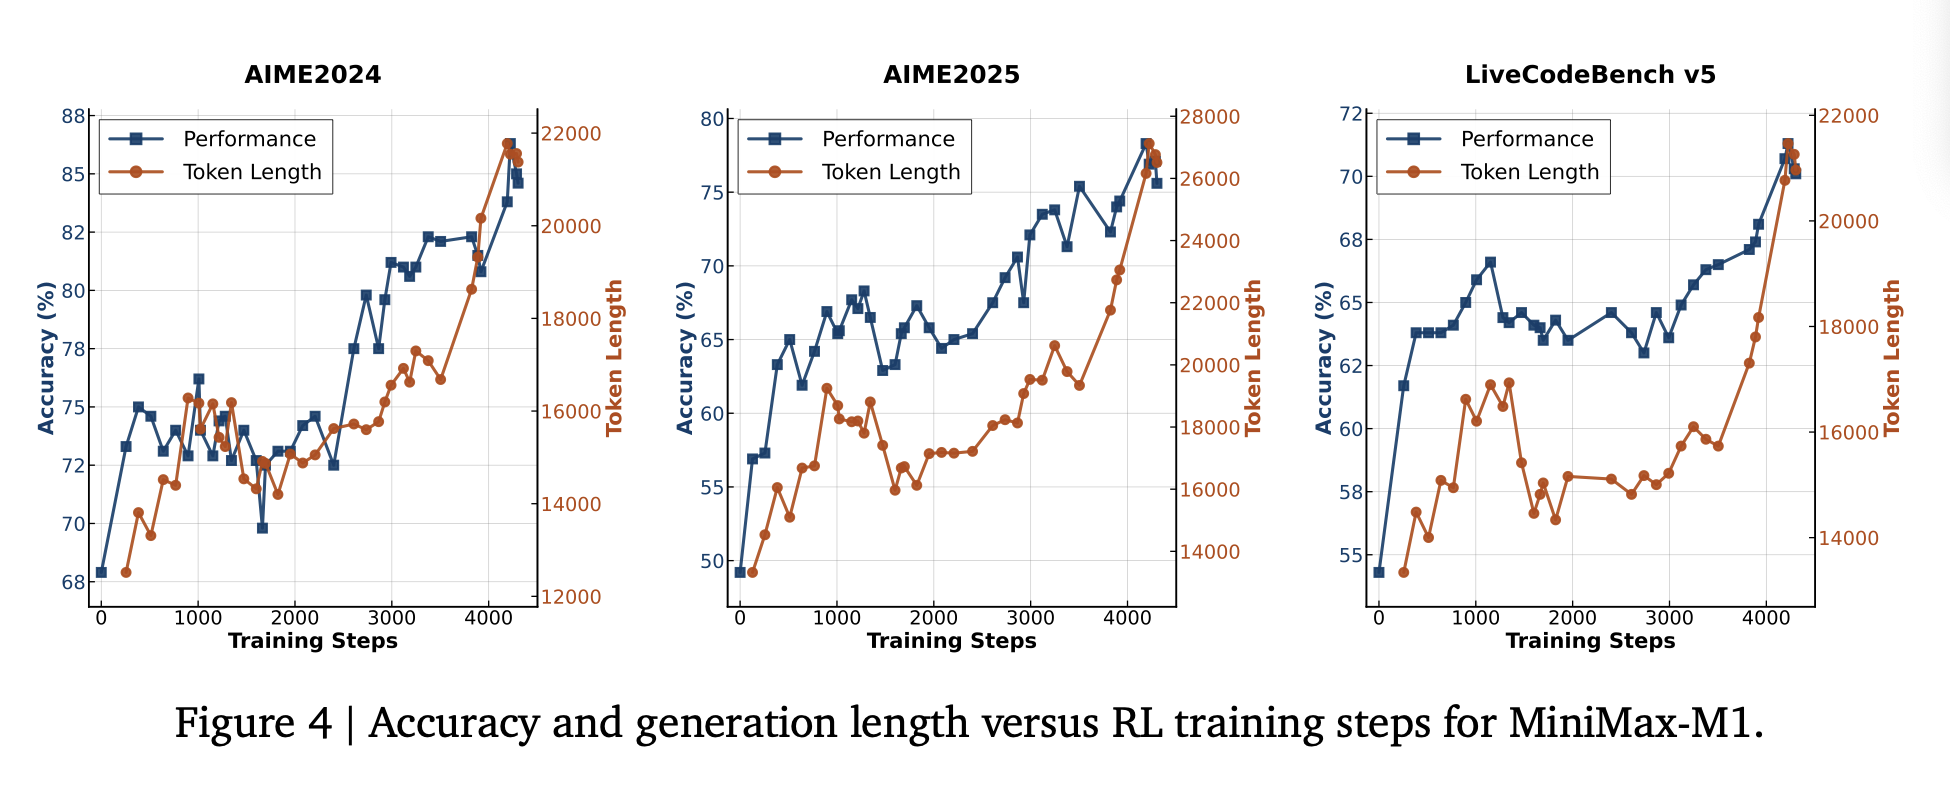
模型性能和回复长度呈正相关

未来方向 ​

⛳未来方向

未来方向
  • Agent:主导和世界交互、执行复杂任务
  • Agent核心要求:长记忆海量信息处理能力、深度推理能力

(2501) MiniMax-01: Scaling Foundation Models with Lightning Attention ​

摘要
  • paper, 如何评价2025年1月15日发布的 MiniMax-01模型,论文翻译MiniMax-01

  • 解决长度限制问题,预训练,大规模Scale应用线性注意力,实现超长上下文 1M Tokens。

    • Hybrid Lightning Attention,MoE 模型,激活46B,总456B
    • 同时扩展至多模态,构建MiniMax-Vl-01。
  • 比较详尽的一篇预训练文章

    • 网络架构:架构设计、Lightning Attention、尺寸确定
    • 预训练:预训练数据构建、数据有效性实验、预训练策略。
    • PostTrain:Prompt构建、RewardModel、SFT、DPO、GRPO、安全对齐、长上下文等。

问题背景 ​

❓问题背景

问题背景
  • 当前模型大都在32k-256k,但对专业书籍、代码项目等真实场景还远远不够。
  • 长度扩展受限于Transformer O(n2) 计算复杂度。学术界处理方法:
    • Sparse Attention, Linear Attention, 长卷积, State Space模型(Mamba系列)、linear RNN等。
    • Linear Attention 没有在工业界真正大规模scale过。
  • MiniMax-01目标:效果好 + 超长上下文。

网络架构 ​

整体参数 ​

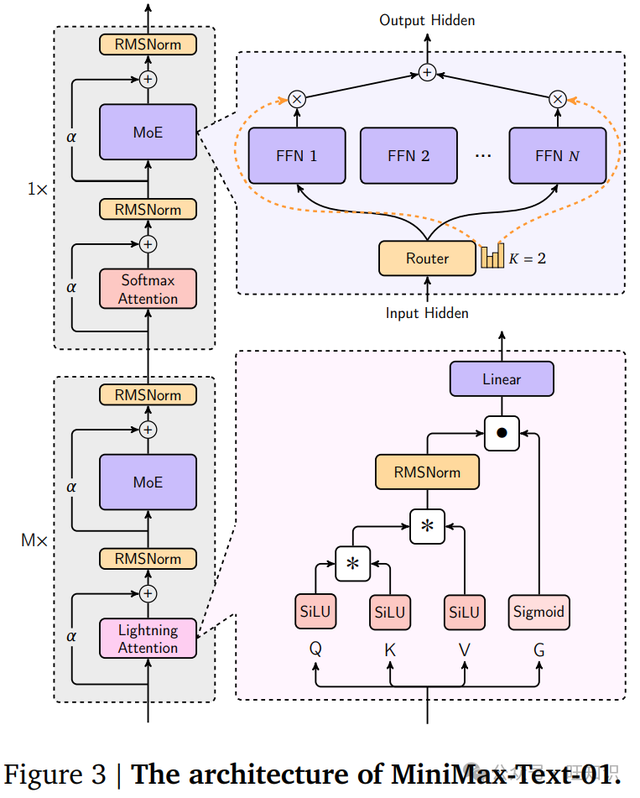
MiniMax-01 整体架构

整体架构

  • Moe 架构:456B参数、激活45B、32个专家。

基本单元

  • 通道混合器(Channel Mixer, 注意力)
    • 不同token之间混合信息。
    • Hybrid Lightning Attention,共2种类型attenion:
      • lightning 注意力 :长文本、高效。
      • softmax 注意力:性能强、计算慢。GQA
    • 7:1模式:每个7个线性注意力层,就插入1个softmax注意力层。
      • 折中方案:保留长序列效率和softmax模型关键性能
  • 特征混合器(Feature Mixer, MLP)
    • MoE,每个token独立计算。

整体参数

  • 确定参数原则:在8-bit下, 8*80GB 能处理,100w token。
  • 深且宽:num_hidden_layers=80层、hidden_size=6144
  • 注意力
    • num_attention_heads=64,head_dim=128
    • 7个线性注意力 + 1个softmax注意力(GQA, GroupSize=8)
      • 7:1比例,不断堆叠,直到80层,间下图
  • MoE
    • 32个专家,top-2路由。挑选2个专家进行加权
  • 位置编码
    • RoPE, base_frequency=10000
  • 总参数:456B,激活约46B。
    • 46B计算成本,实现接近456B模型的知识容量。

配置参数:MiniMax-Text-01

json
{
  "architectures": [
    "MiniMaxText01ForCausalLM"
  ],
  "attention_dropout": 0.0,
  "attn_type_list": [
    0,...,1, ..., 0 ....
  ],
  "auto_map": {
    "AutoConfig": "configuration_minimax_text_01.MiniMaxText01Config",
    "AutoModelForCausalLM": "modeling_minimax_text_01.MiniMaxText01ForCausalLM"
  },
  "bos_token_id": null,
  "eos_token_id": null,
  "head_dim": 128,
  "hidden_act": "silu",
  "hidden_size": 6144,
  "initializer_range": 0.02,
  "intermediate_size": 9216,
  "layernorm_full_attention_alpha": 3.5565588200778455,
  "layernorm_full_attention_beta": 1.0,
  "layernorm_linear_attention_alpha": 3.5565588200778455,
  "layernorm_linear_attention_beta": 1.0,
  "layernorm_mlp_alpha": 3.5565588200778455,
  "layernorm_mlp_beta": 1.0,
  "max_position_embeddings": 10240000,
  "model_type": "minimax_text_01",
  "num_attention_heads": 64,
  "num_experts_per_tok": 2,
  "num_hidden_layers": 80,
  "num_key_value_heads": 8,
  "num_local_experts": 32,
  "output_router_logits": false,
  "postnorm": true,
  "rms_norm_eps": 1e-05,
  "rope_theta": 10000000,
  "rotary_dim": 64,
  "router_aux_loss_coef": 0.001,
  "router_jitter_noise": 0.0,
  "shared_intermediate_size": 0,
  "shared_moe_mode": "sigmoid",
  "sliding_window": null,
  "tie_word_embeddings": false,
  "transformers_version": "4.45.2",
  "use_cache": true,
  "vocab_size": 200064
}

MoE ​

MiniMax-01 MoE

MoE

  • 输入token:xt,输出隐向量: ht

  • Gate网络权重:Wg,专家:FFNi

  • 对前k个专家的输出进行加权求和

    ht=∑i=1|E|Softmaxi(TopK(xt⋅Wg))⋅FFNi(xt)

解决路由坍塌/专家平衡问题:辅助loss

  • 问题:大部分token都发送给少数机构专家,出现赢者通吃现象

  • 方法:辅助loss

    • fi:专家i的实际负载,分配的token数量占总token数量的比例
    • mi:专家i的平均路由得分。
    • 负载和得分的乘积 加权求平均,该值越小,说明越均衡。比如
      • 极度不均衡(负载比例1和0,路由概率0.99和0.01),loss=0.495
      • 非常均衡(负载比例0.5和0.5,路由概率0.5和0.5),loss=0.25
    Laux=αaux⋅1E∑i=1Efi⋅mi

解决负载不均衡问题:Global Router

  • 分布式,数据在不同GPU组是随机的,导致某些组的某些专家恰好收到远超其容量的token。
  • 使用全局路由器,在把token发给够足专家之前,所有GPU组先通过allgather,全局路由掌握全局信息后,进行调度,避免有些组累死、闲死的情况。

Lightning Attention ​

Lighting Attention 问题背景

问题背景

  • 传统SoftmaxAttention 时间复杂度为O(dn2),太慢

    O=[(QK⊤)⊙M]V
  • Linear Attention 时间复杂度为O(nd2),线性依赖于n

    • 但cusum操作严格顺序执行太慢,无法真正并行计算,阻碍GPU大规模并行计算。
    O=Norm(Q(K⊤V))ot=Stqt,St=St−1+vtkt⊤St=∑j=1tvjkj⊤∈Rd×d
    • Minimax-01 递归写法kv0=0,kvt=kvt−1+ktvt⊤,ot⊤=qt⊤kvt
Lightning Attention 核心思想

Lightning Attention 核心思想

  • 利用分块技术来计算注意力,

    • 把无法并行的大问题,分解成大量可并行的小问题 + 少量不可并行的衔接。
  • 把序列分成2块

    • 第一块包含m个token Q1,K1,V1,第二块包含剩下的token Q2,K2,V2
    X=[X1X2],X1∈Rm×d,X2∈R(n−m)×d,
  • 每块分为

    • 块内计算(传统softmax 并行计算)、块间计算(线性注意力高效计算)。
    • 大部分并行、小部分串行。

第一块计算

  • 分解成2部分,块内计算 + 块间计算

    O1=Q1KV0⏟块间+[(Q1K1⊤)⊙M]V1⏟块内
  • 块内部分

    • 块内部的自我注意力。
    • 采用softmax注意力、左乘形式,因为m比较小。完全并行计算。
  • 块间部分

    • 代表了第一块中每个token对它之前所有历史信息的注意力
    • KV0:从第0个块传递来的状态矩阵
    • 采用线性注意力、右乘形式,非常高效。

状态更新

  • 第一块计算完成后,更新状态。把第一块的信息累计到状态矩阵中。KV1=KV0+K1⊤V1

第二块更新

  • 分解成2部分,块间计算 + 块内计算

    O2=Q2KV1⏟块间+[(Q2K2⊤)⊙M]V2⏟块内
  • 计算同第一块。

Hybrid Lighting Attention ​

Hybrid Lighting Attention

Hybrid Lighting Attention

  • 结合lightning和softmax attention
  • 7:1模式,每7个lighting就插入1个softmax

Softmax vs 线性注意力

  • Softmax 注意力
    • 通读书籍,处理第t个词时,会把之前的所有词都过一遍。
    • 优点:记忆力好,检索能力强;缺点:计算量大。
    • 容量:草稿纸大小 o(d),128。
  • 线性注意力
    • 直觉上:无法有效检索。
    • 但通过容量来记录压缩历史信息:循环更新的状态矩阵大小,St∈Rd×d,
    • 容量:草稿纸大小 o(d2/h),128*128/64=256
  • 但在容量上,线性注意力更大
Hyrbid Lighting Attention 优点
  • 提升了效率、支持更长上下文。
  • 在模型效果上也带来提升。
    • 在信息检索、外推任务上,混合模型反而还超过了纯softmax模型。
  • 能充分发挥Post-Layer Norm的优点
    • 使用Hybrid后,实验Post-LN比Pre-LN 效果更好,从43.9 -> 50.2。
    • 性能大于风险。

模型尺寸形状确定过程 ​

模型尺寸形状确定过程

第一步:小模型做实验确定关键参数配比

  • 使用大量小实验,来寻找最佳实践。
    • 混合比例:线性和softmax 注意力配比
    • 深宽比:瘦高个(层数多、每层窄) 还是 矮胖子 (层数少、每层宽)?
    • 内部配置:线性注意力的记忆该设多大?RoPE用在多少维度上?
  • 结论:对混合架构来说,模型深度更好。

第二步:用定制化的scaling law 预测规模

  • 像Chinchilla这样著名的scaling law不适用当前架构,需定制化scaling law

  • 模型规格

    minPall,PactL(Pall,Pact,T)subject toCcompute(Pall,Pact,T)<CandPall<500B
  • Loss

    • 给定激活参数、Token数量、专家数量E条件下

    • 由激活参数数量和训练token数T决定,其余是需拟合的参数

    L(Pact,T∣E)=d+αPactα+bTβ+c(PactT)γ
  • 最终确定:456B总参数、46B激活参数

预训练 ​

预训练数据 ​

预训练数据

数据来源

  • 整体来自于学术文献、书籍、互联网、编程代码等。

数据质量增强

  • 基于规则清洗+去重
  • 基于上一代MoE模型作为Reward模型,在多个维度上进行打分
    • 连贯性、简洁性、教育价值、有用性、知识丰富度、类别相关性等。
    • 最终确定:知识深度、实用性、类别分布作为主要指标。
    • 类别分布(新闻小说代码等):确保每种类型数据都有,避免模型偏科。

数据格式优化

  • 网站和数据数据:提取后就作为高质量数据,无需格式化。
  • 对话和问答数据:
    • 过度格式化 会降低数据多样性和质量。
    • 设计了一套嵌套问答格式,平衡了自然理解和结构一致性。

数据混合

  • 利用3个质量指标,开发了复杂方法,来调整数据分布。
  • 完全删掉低分内容,会影响下游任务性能。
    • 尽管使用知识深度、有用性更高的数据,在指标评估上会更好。
  • 平衡采样策略
    • 从基础语料库均匀分布开始,逐步调整采样权重,慢慢偏向高质量内容
    • 同时保持不同类别

数据有效性实验 ​

数据有效性实验

实验目的

  • 使用特征不同但数量大小相同的数据,训多个小MoE模型,来评估单个数据的影响。
  • 不是靠人盲猜哪些数据有用。

衡量指标

  • 多选Benchmark,但去掉选项索引,评估模型生成正确答案的对数归一化准确率

    log⁡accnorm2(x)=log⁡softmaxp′(c∈Cx){(p′(c∗))}
  • pi′(c):样本i、选项c的字节归一化概率

    pi′(c)=pi(c)/bytes(c)

实验设置

  • 40B token数据,训练激活1B、总参数8B的模型。
  • 混合数据:20B web文档数据 + 20B 假设数据。

重复数据的影响

  • 低质量数据:训练2轮以后,性能开始下降。
  • 高质量数据:最多训练4轮。

训练策略 ​

训练策略

参数

  • Xavier 均匀分布初始化策略
  • Adam 优化器,β1=0.9,β2=0.95,weight decay=0.1
  • 动态逐步调大batch size
    • 初始16M-> 32M(69B) -> 64M (790B) -> 120M(4.7T tokens)
    • 根据数学方程,预测当前模型loss,来计算batch size。
    • 前期:模型不稳定,使用小batch size 更容易收敛。
    • 后期:模型稳定, 使用大batch size来加速训练。
  • 学习率
    • warm up:500次迭代,达峰值 2×10⁻⁴,保持稳定直到7.2T tokens。
      • 发现gradient norm过高异常,可能是学习率过大。
    • 剩余3.2T tokens:学习率调整为 1.3×10⁻⁴
    • 快速衰减阶段 1T Tokens:学习率指数及衰减至 3×10⁻⁵
  • MoE 辅助loss系数:0.01

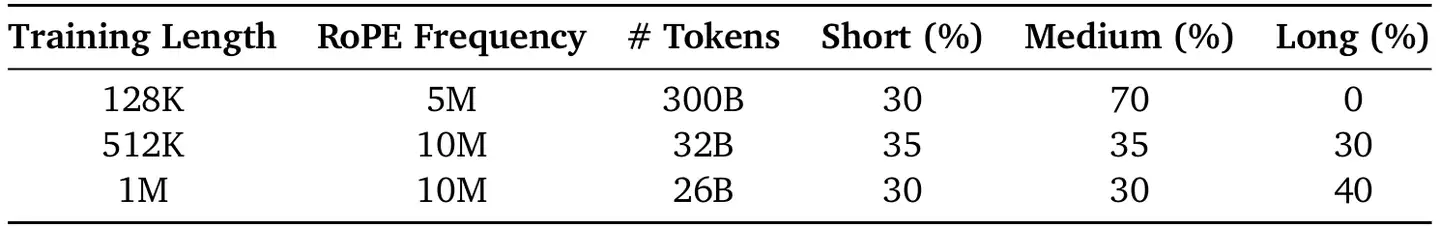
上下文扩展:3阶段训练策略

  • 阶段1:128k,RoPEFreq 5M, 300B token
  • 阶段2:512k,RoPEFreq 10M,32B token
  • 阶段3:1M,RoPEFreq 10M,26B token
  • Trick
    • 每个阶段的后20%周期里,混入10%的高质量长上下文问答数据,长度分布和预训练相似。
    • 减轻分布变化导致的不稳定性:过渡阶段使用源特定权重的线性插值。

VL 模型

  • 集成ViT,训练MiniMax-VL-01:在5120亿视觉token上进行训练,使用4阶段训练过程。

Post Train ​

Prompt 构建 ​

Prompt 构建
  • 从多个源,收集了数百万、多样化、高质量的prompt。
    • 领域:长上下文、编程、数学、逻辑推理、创意写作、函数调用、通用知识和安全等。
  • 打标系统:按任务类型、知识领域、任务难度做分类。
  • 重复过滤:消除重复prmpt,保持最佳难度分布

Reward Model ​

Reward Model

核心思想

  • 从4个维度,来评估回复。

正确性/Correctness

  • 针对可被验证的任务
    • 数学推理:使用早期MiniMax-Text-01,基于答案一致性,生成2元奖励。
      • 一致、不一致。
    • 代码编程:沙盒环境,测试用例的成功率。

真实性/Truthfulness

  • 评估事实准确性,一个pipeline
    • 系统抽样,人工众包验证、先进大模型验证

有用性/Helpfulness

  • 评估是否对用户有帮助,比如遵循理解指令。
    • 自动化规则检查、人工主观评估

无害性/Harmlessness

  • 评估是否安全、合乎道德和法律。
    • 早期MiniMax-Text-01 做安全性检查。

SFT ​

SFT

数据构建

  • 多阶段过程,利用了通过迭代 SFT+RL循环训出的领域特定专家模型。
  • 使用专家+拒绝采样,生成高质量回复。
    • 每个prompt,在不同温度下,生成多个回答
    • 基于奖励系统,选出最优的回答。
  • 整合n-gram相似度+语义相似度过滤器,确保训练数据多样性和高质量。

RL-offline(DPO) ​

Offline-RL-DPO
  • 使用 DPO,因为简单、在长上下文下好构造数据。
  • 数据构造
    • Prompt:使用SFT-Trained-Prompt。SFT-Untrained-Prompt 性能差异不大。
    • Responses:不同温度下的回复
    • 基于奖励系统,选出最佳、最差回复,构建出偏好对。

RL-online(GRPO) ​

Online-RL-GRPO

背景

  • 在线RL比离线RL好:样本效率高、领域泛化性好。

数据集

  • SFT-Untrained-Prompt
    • 如果使用SFT-Trained-Prompt,会导致模型饱和,表现为困惑度降低。
  • 数学推理任务,使用中等难度的题

GRPO变体

  • IS权重 CLIP 优化

    • 传统GRPO问题:在IS大+负优势值时,容易导致梯度不稳定。
    • 改进:额外clip,直接丢弃这种case,减轻了噪声传播
  • KL 散度优化:

    • 进一步稳定梯度,重新构建KL项DKL(θ)=Et[SG(πθ(at|st)−πθold(at|st))⋅log⁡πθ(at∣st)]
  • 平衡优势估计

    • 确保正负样本的奖励贡献 是公平的,保证训练稳定。
    • 在分布不平衡时,特别有效。

安全对齐 ​

安全对齐

数据构建

  • 保证多样性、准确性。
  • 特定安全类别Prompt
    • 利用已有安全分类标准,为每个类别定制prompt
  • 真实场景用户数据
    • 收集
  • Prompt 扩充
    • 基于早期MiniMax-Text-01,基于red team attack prompt,扩充prompt。
    • 增强鲁棒性

Hamless Reward Model 的回复

  • 基于安全规则,开发了一个无害的Reward Model。
  • 防止过度拒绝:把Helpfulness加入安全规则中。

长上下文训练 ​

长上下文训练

核心思想

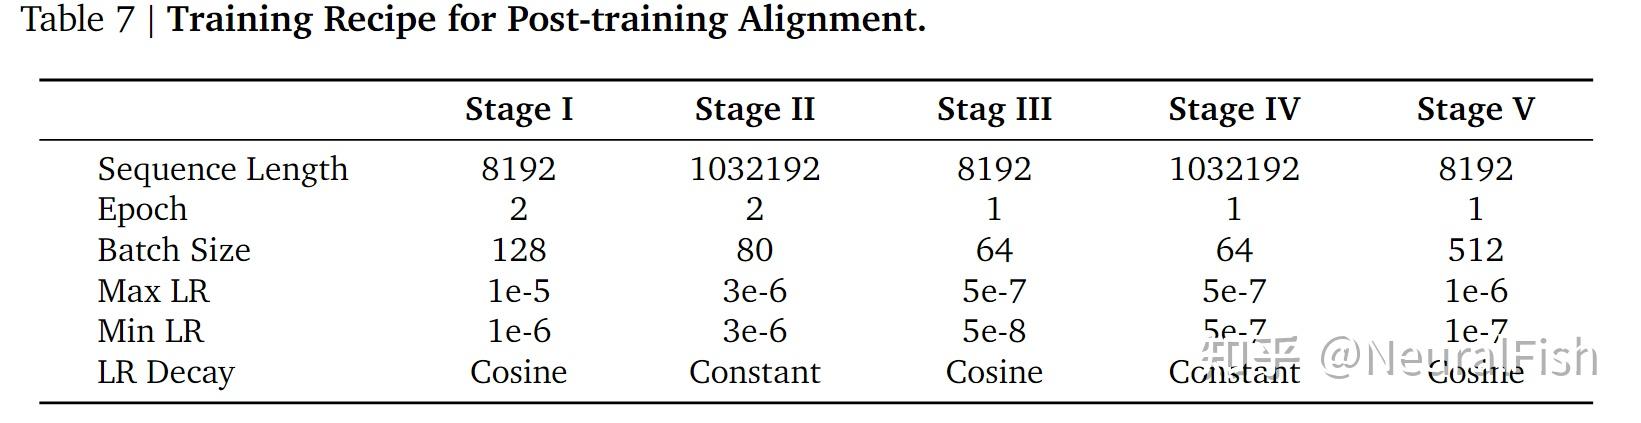
  • 五阶段训练方法,长短交替,SFT + DPO + GRPO。
  • 增强长序列能力、保持短序列效果。

多阶段训练方法

  • Stage1 (SFT, 8k) 短上下文训练
    • 8k,过滤超过8k的数据
  • State2 (SFT, 1M) 长上下文训练
    • 1M,50%都是长Prompt,适应长上下文
  • State3 (DPO, 8k)
    • 8k,校准,保证短序列效果、保证长序列效果。
  • State4 (DPO, 1M)
    • 1M,精通长文本
  • Stage5(GRPO, 8k)
    • 8k,提升数学推理等能力。

多模态模型 ​

核心思想

核心思想

  • 把Image Encoder + Image Adapter 适配到MiniMax-Text-01,开发出MiniMax-VL-01。

数据集 ​

多模态数据

图文标题数据

  • 互联网收集过滤,庞大的图文标题数据。
  • ViT 在 6.94亿 图文对上进行训练,为其中的1.8亿构建精选标题,

图像描述数据

  • 1亿,来自Common Crawl等。
  • 每张图有细粒度描述,模型生成+人工精炼,描述大概300token。

指令数据

  • 合成大量涉及视觉的QA数据,构建了全面多样化的指令数据集。
    • 领域:OCR、物体定位、几何问题等等。

整体架构 ​

架构

整体架构

  • 视觉编码:3B 的 ViT-L/14
    • 动态分辨率,336*336 -> 2016*2016
    • 直接利用原始特征,从头开始训练
  • 图形适配器:随机初始化的双层MLP
  • LLM:MiniMax-Text-01

训练策略 ​

四阶段训练策略

阶段1:模态对齐

  • 目标:给定图像,生成标题,实现视觉和文本token对齐。
  • 训练:ViT + Adapter的权重。
  • 分辨率:336×336

阶段2:增强视觉理解

  • 目标:模型输出 和人类指令对齐
  • 训练:所有模型参数。
  • 数据:从指令数据采样4200亿多模态token,配比MiniMax-Text-01后训练数据(20:1)

阶段3:增强用户体验

  • 目标:真实场景效果
  • 数据:日常图片数据、模拟真实用户输入、精心标注。

阶段4:增强偏好

  • 目标:DPO
  • 数据:4万个图文对数据
    • Prompt:从指令和真实用户数据中精心筛选prompt
    • Response:多种策略(温度/图形弱化/引入幻觉等)生成Responses
    • 奖励:MiniMax-Text-01 作为评估器,多维度评估
    • 偏好对:选择得分最高和最低的作为正负样本。

框架优化 ​

框架

计算

  • 现有框架对softmax attention进行优化,但MiniMax-01是 lightning + softmax+ moe 架构。
  • 框架优化
    • 减少跨GPU开销:Expert 并行 + Expert Tensor 并行,来实现MoE中的all-to-all通信。
    • 上下文:使用变长环形注意力减少冗余计算,实现Linear Attention 序列并行(LASP)
    • 量身定制的CUDA核心,H20上超过75%的浮点运算利用率。

关键结果 ​

🍑关键结果

关键结果
  • 打破常规:效果好而且不依赖传统softmax注意力,大规模应用线性注意力。
  • 极致的上下文能力:400万token,效果匹配顶尖闭源模型
  • 一套探索各种模型、数据集、评估和算法的适用方法论。

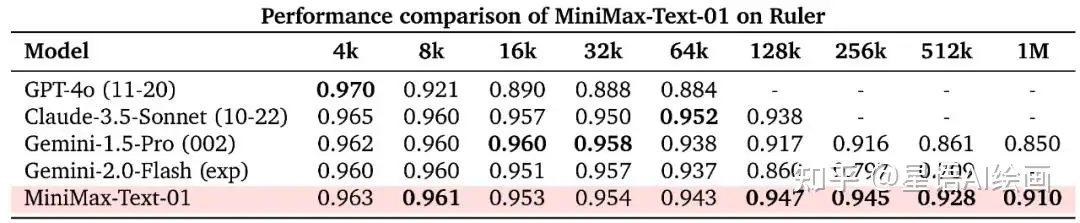
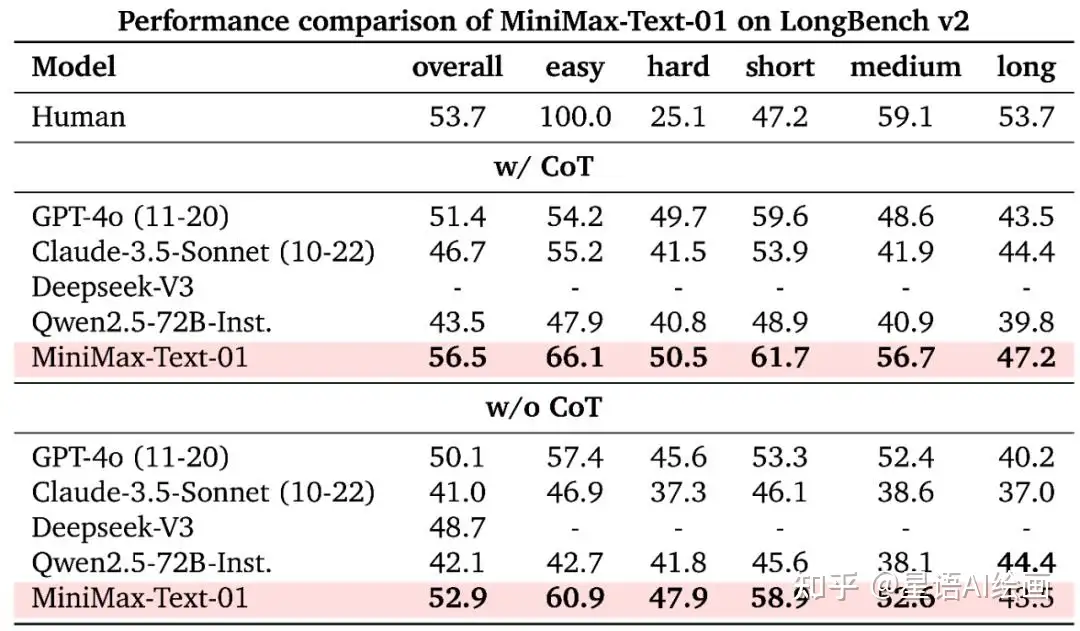
能高效处理1M-4M tokens,超长上下文,效果优于Gemini1.5-Pro。

大海捞针,检索任务,效果也很好:

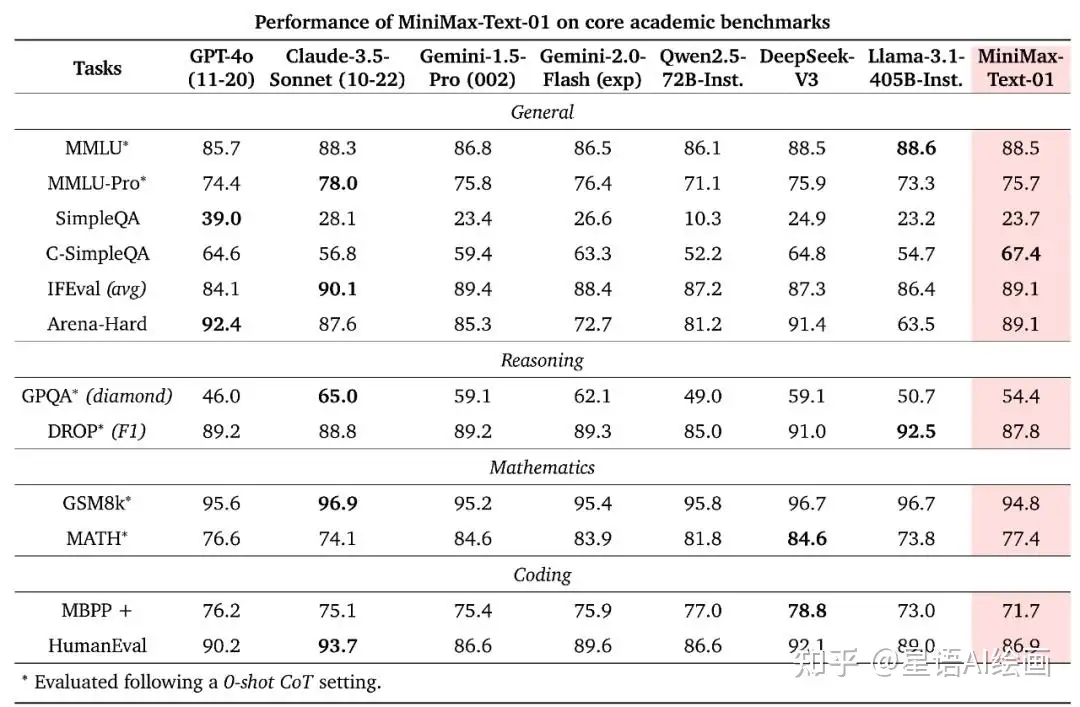
学术任务上,也很出色。

长上下文学习能力,也很好。

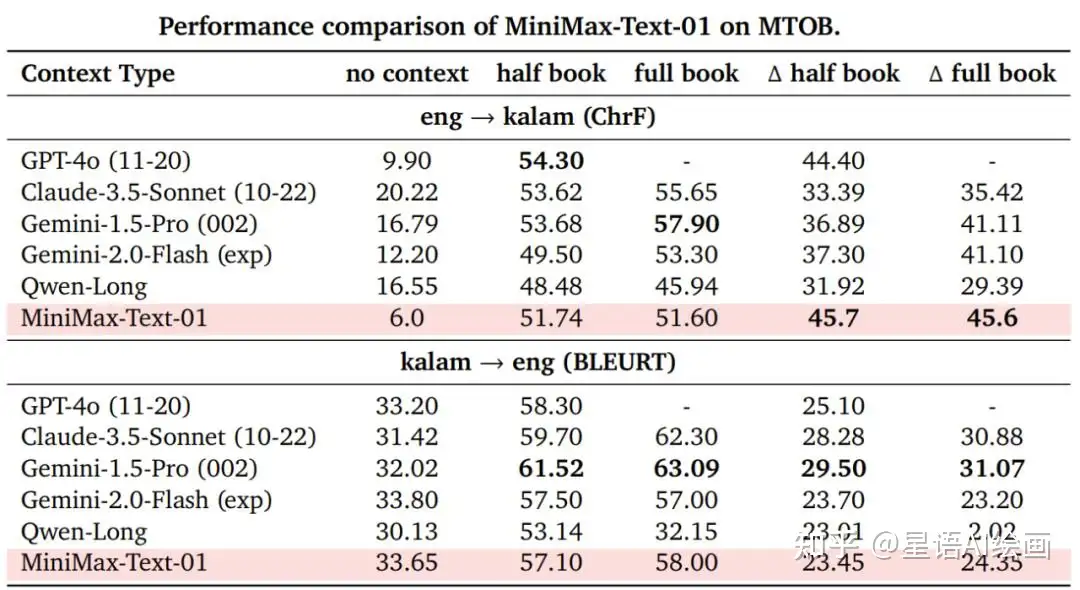
未来方向 ​

⛳未来方向

未来方向
  • 长上下文评估体系:贴近现实真实场景、难度更高的长上下文评测
  • 极致的架构:目前是线性和softmax 7:1,期望终极目标是100%高效上下文,无限长上下文
  • 补齐代码能力:预训练数据中代码比例和质量有限,

:::``

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026