Skip to content

LLM Attention 系列

📅 发表于 2025/11/14
🔄 更新于 2025/11/24
👁️ — 次访问
📝 3345 字
⏳ 11 分钟
llm-attention
#softmax attention

概览 ​

分类方法核心思想主要解决的问题
基础Traditional Softmax Attention计算完整的 N x N 注意力矩阵建立序列依赖关系
算法优化Linear Attention利用矩阵乘法结合律,近似计算O(N²) 复杂度
Sparse Attention只计算部分重要的注意力权重O(N²) 复杂度
架构创新Multi-Head Attention并行计算多个子空间的注意力提升模型表达能力
Multi-Query / Group-Query Attention多组/所有头 共享K和VMHA的KVCache显存瓶颈
Multi-Head Latent Attention引入信息瓶颈(潜向量)处理超长序列的 O(N²) 复杂度
实现优化Flash Attention分块计算,避免读写巨大中间矩阵内存带宽瓶颈,硬件利用率低

标准Softmax Attention/Full Attention ​

标准Softmax注意力公式 ​

标准 Softmax Attention

符号定义

qi,ki,vi,oi∈Rd×1Q=[q1,q2,⋯,qn]⊤∈Rn×dK=[k1,k2,⋯,kn]⊤∈Rn×dV=[v1,v2,⋯,vn]⊤∈Rn×dO=[o1,o2,⋯,on]⊤∈Rn×d
  • Q、K的维度和V、O的维度可以不相同,参考MLA。

核心思想

  • 注意力本质:Q,K,V→O 映射。

  • Causal场景:ot 至多和 Q[:t],K[:t],V[:t] 有关。

    O=softmax(QK⊤+logM)⋅V
  • M∈Rn×n:掩码矩阵,下三角矩阵

    Mi,j={1,i≥j0,i<j
    • logM,对M的分量逐一取log,log0=−∞

Softmax Attention 分量形式

  • 分母:权重和,分子每项的权重*值,再求和。除以分母:保持数值稳定性
ot=∑j=1texp⁡(qt⊤kj)vj∑j=1texp⁡(qt⊤kj)
  • 简单示例,多项V加权求和
o5=q5k1sum⋅v1+q5k2sum⋅v2+q5k3sum⋅v3+q5k4sum⋅v4+q5k5sum⋅v5

Softmax Attention 精简

  • 最核心为分子,需把 n×n的矩阵exp(QK⊤)算出来,空间和时间复杂度,都正比于n2

    O=exp(QK⊤+logM)⋅V=(exp(QK⊤)⊙M)V
  • 精简:去掉softmax

    O=(QK⊤⊙M)V
  • 精简:去掉掩码,非causal

    O=(QK⊤)V=Q(K⊤V)
  • 增加归一化

    O=RMSNorm((QK⊤⊙M)V)

注意力精简公式 ​

注意力精简公式

Attention 精简公式

ot=Attn(qt,k:t,v:t)ot=Attn(qt,k:t,v:t)=∑i=1tαt,i⋅vi∑j=1tαt,jαt,i=eqt⊤kidk=eqt⊤ki−edk

矩阵带掩码 公式

O=softmax(QK⊤+logM)⋅VO=exp(QK⊤+logM)⋅V=(exp(QK⊤)⊙M)V

矩阵精简公式

O=(QK⊤⊙M)VO=(QK⊤)V=Q(K⊤V)O=RMSNorm((QK⊤⊙M)V)

Softmax和Linear时间复杂度 ​

Softmax和线性注意力时间复杂度

Softmax和线性注意力

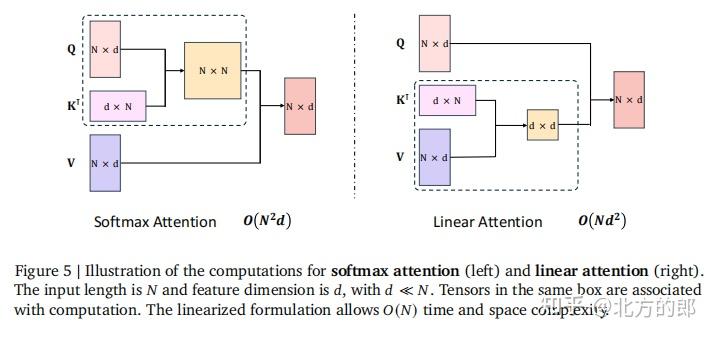
O=(QK⊤)⏟Rn×nV⏟Rn×d⟺Q⏟Rn×d(K⊤V)⏟Rd×d
  • 左侧:传统softmax注意力
    • 时间复杂度:O(n×n×d)=O(dn2)
      • 第一步:O(n×d×n);第二步:O(n×n×d)
      • 综合两步:O(dn2)+O(dn2)=O(dn2)
    • 当n很大时:由于 n2,计算成本非常高
    • Flash Attention降低了空间需求,但平方时间复杂度依然无法避免。
  • 右侧:线性注意力。
    • 时间复杂度:O(d×n×d)=O(nd2)
      • 第一步:O(d×n×d);第二步:O(d×n×d)
      • 综合两步:O(nd2)+O(nd2)=O(nd2)
    • 当n很大时,d2为常数,复杂度随n线性递增,计算成本低
  • 区别
    • 计算上:仅仅是交换了计算顺序

Softmax 时间复杂度例子

  • QK⊤矩阵乘法 (传统softmax注意力)

    Q⏟Rn×d×K⊤⏟Rd×n=W∈Rn×n
    • 结果矩阵W共 n×n个元素,第i行j列元素Wi,j计算过程

      • Qi:第i列,d个元素的行向量,维度为 1×d
      • Kj⊤:第j行,d个元素的列向量,维度为 d×1
      Wi,j=Qi⋅Kj⊤=∑l=1dQi,l⋅Kl,j⊤
    • 单个元素计算复杂度:o(d),d次乘法、d−1次加法

    • 整体复杂度:有n2个元素,共o(dn2)

线性注意力时间复杂度例子

  • K⊤V矩阵乘法 (线性注意力)

    K⊤⏟Rd×n×V⏟Rn×d=W∈Rd×d
    • 结果矩阵W共 d×d个元素,第i行j列元素Wi,j计算过程

      • Ki⊤:第i行,n个元素的行向量,维度为 1×n
      • Vj:第j列,n个元素的列向量,维度为 n×1
      Wi,j=Ki⊤⋅Vj=∑l=1nKi,l⊤⋅Vl,i
    • 单个元素计算复杂度:o(n),n次乘法、n−1次加法

    • 整体复杂度:有d2个元素,共o(nd2),复杂度线性依赖于n

Attention 概念 ​

Attention 概念
  • Input:一般是一个句子;乘以矩阵得Q/K/V 3个向量

  • QKV向量

    • Query:表示当前查询query
    • Key: Key是各个位置的键,
    • Value:Value各个位置的信息
  • 注意力权重

    • softmax(Q∗K): 即当前query对各个位置的注意力权重α1,⋯,αl。
    • 早期QK有 dot/concat/w 这3种score计算的3种方式
  • 加权求和

    • 利用注意力权重对各位置Value加权求和,就得到输出
Attention(Q,K,V)=softmax(QK⊤dk)⋅V
  • 除以dk进行缩放,防止梯度爆炸,
Self-Attention vs 其他Attention

Self-Attention

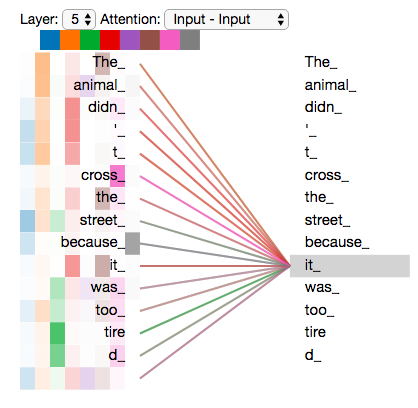
  • Self-attention:self顾名思义,计算自身序列中各位置与其他各位置的注意力,V来自自身。
  • Target-Attention:计算自己和其他内容的注意力,V来自其他内容。
  • Self-Attention 可以通过两个位置一步attention计算,远距离学习知识依赖和语序结构。
  • RNN/LSTM:距离越远,信息损耗越大,有效提取捕获远可能性越小。
Attention vs 全连接
  • 👁️Attention:有锚点👍
    • 有Query和Key,有Value。Query作为一个锚点计算attention score后做加权。
    • 比喻:左手拿白色小球,右手从袋子抓球,抓出来和左手做对比
  • 全连接层:🈚️锚点
    • 无Query和Key,只有一个Value。最后给每个v一个权重做加权。
    • 比喻:在袋子里凭记忆和感觉随便抓一个球出来。

Attention 变体

  • 最早期的Attention、Hard Attention等。
  • Muliti-Head Attention:使用多组QKV生成多个Z,拼接乘大矩阵,得融合Z,再给FFN。
    • 学习不同表征,识别不一样的模式,增强模型表达能力
  • Relative Position Encoding:使用相对位置编码引入位置信息

Attention 解码详细推导 ​

Attention 推导

符号定义

  • 假设dim=dk,部分公式省略缩放、softmax、向量转置等。
  • Attnstepi(Q,K,V):第i步的完整Attention矩阵
  • Attni(Q,K,V):attention矩阵的第i行

Step=1,共1行

  • 第1行:Attn1(Q,K,V)=softmaxted(Q1K1T)V→1=(Q1K1T)V→1
Attnstep1(Q,K,V)=softmax(Q1K1Tdk)×V1=[Q1]⋅[K1⊤]⋅[V1]=[softmax(Q1K1T)×V1→]=[Attn1(Q,K,V)]

Step=2,共2行

  • 第1行:Attn1(Q,K,V)=(Q1K1T)V→1,step1已算过
  • 第2行:Attn2(Q,K,V)=(Q2K1T)V→1+(Q2K2T)V→2
Attnstep2(Q,K,V)=[Q1Q2]⋅[K1K2]⋅[V1V2]=[Q1K1TQ1K2T⏟Q1不能看见K2Q2K1TQ2K2T]⋅[V1V2]=[Q1K1T−∞Q2K1TQ2K2T]⏟被mask掉,softmax为负无穷⋅[V1V2]=[Q1K10Q2K1Q2K2]⏟过了softmax和缩放,简写⋅[V1V2]=[Q1K1TV1Q2K1V1+Q2K2V2]=[Attn1(Q,K,V)Q2K1⊤V1+Q2K2⊤V2]

Step=3, 共3行

  • 第1行:Attn1(Q,K,V)=(Q1K1T)V1,第1步已算过
  • 第2行:Attn2(Q,K,V)=(Q2K1T)V1+(Q2K2T)V2,第2步已算过
  • 第3行:Attn3(Q,K,V)=(Q3K1T)V1+(Q3K2T)V2+(Q3K3T)V3,第3步算第3行

结论

  • 每一步都存在大量冗余,第i步,只需要计算第i行即可,前i-1行都已经计算过

  • 矩阵中,第k行只和Qk相关,和其余位置的Q无关。

    • Qk会和前面的每一对Ki,Vi做attention计算,来计算当前行。
  • 解码xk,只需输入字符xk−1即可。

几个重点思考(降维/dk等) ​

重要思考

1、Self-Attention Padding 做 Mask

  • Q⋅K ,需要对padding部分置为−∞负无穷,再过Softmax才会为0。

2、Transformer Multi-Head Attention 要对head 进行降维

  • 输入向量维度为d,需要降维到 d′(远小于d),主要是为了降低计算复杂度
  • 时间复杂度:o(d2)、o(hd2)→o(d′2)、o(hd′2)

3、维度和点击的关系

  • q,k向量 维度d越大,点积值q⋅k越大,点积属于均值0、方差d的正态分布。

    E(q⋅k)=0,D(q⋅k)=d
  • 方差的性质

    D(cx)=c2D(x),D(c+x)=D(x)。c为常数

3、深入理解dk缓解梯度爆炸问题

  • Attention计算过程:内积QK后 -> softmax。softmax主要入参是eqk。

  • 如果不进行缩放:

    • softmax入参在[e−3d,e3d]之间,会很大或很小
      • 导致注意力权重 接近one-hot分布
      • 饱和区梯度消失:x值继续变大,y几乎不变
  • 因此:QK后才除以dk

    • 使得softmax入参在[e−3,e3]之间,不大也不小
  • 数学思路

    • q⋅k 除以d,抵消掉,由0-d正态分布,又回到0-1正态分布。
    E(q⋅k)=0,D(q⋅k)=d⇒D(q⋅kd)=q⋅k(d)2=1
    • 方差为1,有效控制点积结果发散,应对了梯度消失问题。

注意力算法优化(降低时间复杂度) ​

线性注意力 ​

核心思想 ​

线性注意力核心思想

背景

  • 把FullAttention 复杂度O(dn2)变为O(nd2),O(n2) 变成 O(n),即平方复杂度变成线性复杂度。

核心思想

  • 矩阵交换律,右乘,中间状态矩阵迭代计算,具体公式见下文。

优点

  • 速度极快、内存占用小

缺点

  • 性能效果损失,最新MiniMax-M2 已经由 Lighting Attention 切换回 FullAttention了。

线性注意力基本公式 ​

线性注意力

线性注意力基本公式

O=(QK⊤)⏟Rn×nV⏟Rn×d⟹Q⏟Rn×d(K⊤V)⏟Rd×d
  • 分量形式

    ot=∑j=1tvj⏟向量(kj⊤qt)⏟标量=∑j=1t(vjkj⊤)qt=(∑j=1tvjkj⊤)qt=Stqt
    • 各元素维度vj∈Rd×1,kj⊤∈R1×d,qt∈Rd×1→kj⊤qt∈R1×1,St=vjkj⊤∈Rd×d

状态公式

  • 记括号部分为St,Casual形式的Attention可写成以St为状态的线性RNNot=Stqt,St=St−1+vtkt⊤
St=∑j=1tvjkj⊤
  • 线性Attention:本质是一个cumsum,将所有历史信息 等权地叠加。

记忆遗忘及解决方法(RetNet/Minimax-01) ​

提示

现行Attention 记忆遗忘缺点

  • 本质是cumsum,各历史信息同等权重叠加。
  • 当叠加token足够多时,每个token的信息占比会变得很小。
  • 仅靠固定大小矩阵 St∈Rd×d难以准确重建任意token,每个token的记忆会变得模糊不清。

RetNet/MiniMax-01:增加衰减因子

  • 衰减因子γ:模型倾向于遗忘早期信息,就近原则
ot=Stqt,St=γ⋅St−1+vtkt⊤

DFW/Mamba/Mamba2

  • 把衰减因子γ推广为位置t的函数γ(t)ot=Stqt,St=γ(t)⋅St−1+vtkt⊤

TestTimeTraining ​

Test Time Training

TTT 思想

  • 把 K,V视作语料对,根据语料训练模型,St为模型参数

    (k1,v1),(k2,v2),⋯,(kt,vt)
  • 最后输出

    ot=f(St,qt)

TTT 实现的RNN

  • 当前模型参数为St−1,优化器接收到新数据(kt,vt),更新模型参数为St

    ot=f(St,qt),St=St−1−ηt∇St−1L(f(St,qt),vt)
  • RNN:把历史数据有效压缩到一个固定大小的State中,而模型参数正好是固定大小的。

  • 类比

    • 压缩任务:RNN;解压器:模型f;压缩包:权重;压缩算法:SGD;压缩率:损失L

线性注意力主要工作 ​

线性注意力主要工作

Sparse Attention ​

核心思想 ​

核心思想

背景

  • 传统Softmax Attention,时间复杂度随长度二次方增加 o(dn2),不利于长度扩展。

稀疏注意力核心思想

  • 假设
    • 一个token只需关注序列中少数几个关键位置,无需关注所有位置。
  • 具体做法
    • 不计算完整 N×N的注意力矩阵,只计算一小部分稀疏位置的。
    • 只选择与Q相关的少量Token,来计算Query-Key注意力。

优点

  • 在性能和效率之间取得平衡,复杂度可降低到o(nlog⁡n)

传统稀疏注意力的缺点

常见稀疏模式 ​

常见稀疏模式

局部注意力 / Sliding Window

  • 只关注邻近的几个词。

全局注意力 / Global Attention

  • 预设一些全局节点,让所有词都与它们进行计算。

组合模式

稀疏注意力主要工作 ​

稀疏注意力主要工作

注意力结构优化(提升推理效率) ​

一图概览MHA+MQA+GQA+MLA ​

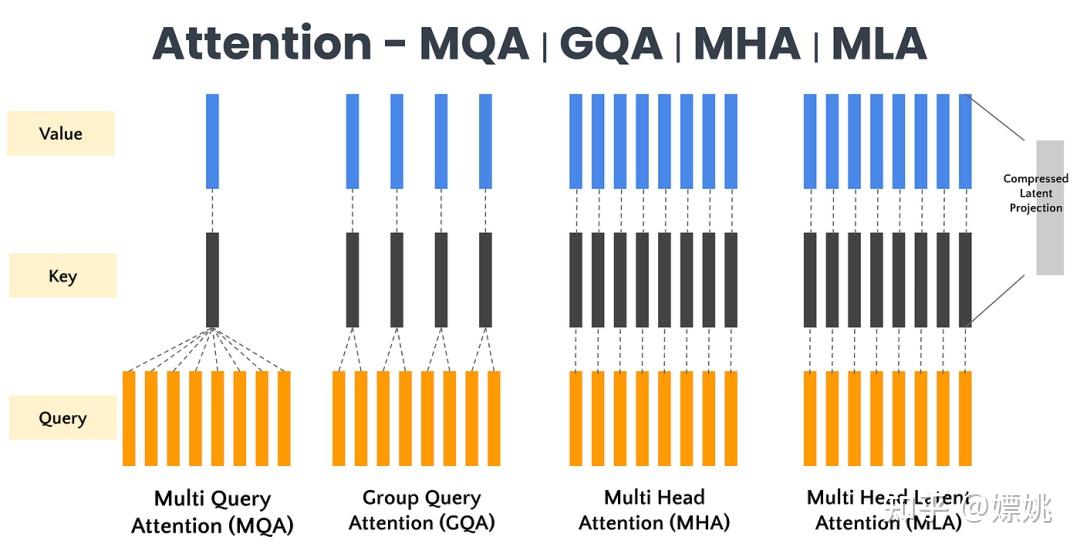
MHA + MQA + GQA + MLA

Multi-Head Attention

  • 并行计算多个子空间QKV的注意力,提升模型表达能力。

Multi-Query Attention

  • 所有Query共享一对K和V,减少KV参数,提升推理速度,优化o(dn2)问题。

Group-Query Attention

  • 在MHA和MQA中做折中,把Query分组,每组共享一对K和V,效果比MQA好、速度比MHA快。

Multi-Head Latent Attention

  • 把KV联合压缩成一个 小的潜在向量,来解决KV缓存高的问题。压缩、缓存、重建三步。
Mulit-Head Attention(2017) ​

多头注意力

Multi-Head Attention

核心思想

  • MHA,多组QKV,学习不同表征模式,增强模型能力,类似CNN多个卷积核

优点

  • 多头关注不同部分,最终再融合 起来得更好效果。

  • 如:对词向量维度512进行8头切割,每头输入维度为64,最后采用concat进行融合。

缺点

  • 计算成本高

Multi-Query Attention(2019) ​

Multi-Query-Attention

核心思想

  • 所有query共享同一个Key和Value 矩阵,每头仅保留Query参数,

优点

  • 大大减少KeyValue参数,提升推理速度

缺点

  • 但带来 精度损失。

Group-Query Attention(2023) ​

Grouped-Query Attention

核心思想

  • query分为n组,每组共享Key和Value矩阵。
  • 其实在MHA和MQA之间做折中。

优点

  • 精度比MQA好,速度比MHA快。

Multi-Head Latent Attention(2024) ​

Multi-Head Latent Attention

问题

  • MHA计算复杂度高 O(dn2),
  • MHA推理长序列时,KV缓存高、显存压力大。

核心思想: 低秩KeyValue联合压缩

  • 压缩
    • 不直接计算存储完整的K和V,而是压缩成一个维度很小的latent vector
  • 缓存
    • 推理时,缓存非常小的潜在向量,而非原始KV
  • 重建
    • 在计算注意力时,从缓存的latent vector中,重建出原始的Key和Value。

优点

  • 大幅减少KV缓存:与DeepSeek 67B比,KV缓存减少93.3%
  • 推理性能提升:最大生成吞吐量提升5.76倍
  • 相比MQA/GQA,性能还有提升

实现优化(解决硬件效率问题) ​

Flash Attention ​

Flash Attention
  • 目前最高效的注意力实现
  • 核心思想:利用GPU的SRAM,将连续的内存块,加载进来进行计算,最大化硬件利用率。

GPU 硬件限制 ​

GPU 硬件限制
  • GPU - SRAM:很小很快,20MB、19TB/s (吞吐量)
  • GPU - HBM:GPU显存大小,大但慢,80GB、1.5TB/s
  • CPU - DRAM:CPU内存,很大但很慢, 1TB、12GB/s

Softmax Tiling ​

参考文章:FlashAttention中的softmax快分块计算详解

Softmax Tiling
  • 数值稳定

    • 背景:避免数值exi 过大溢出,
    • 方法:每个元素都减去最大值得exi−max(x)
    • 效果:exi−max(x) 在[0,1]区间。softmax结果和原softmax一致
  • 分块计算softmax:

    • 把X分为多个块,各块单独计算最大值、softmax分子、softmax分母
    • 根据各块信息,计算全局分母;再更新各自分子,得全局分子。

Flash Attention 算法 ​

Flash Attention 算法
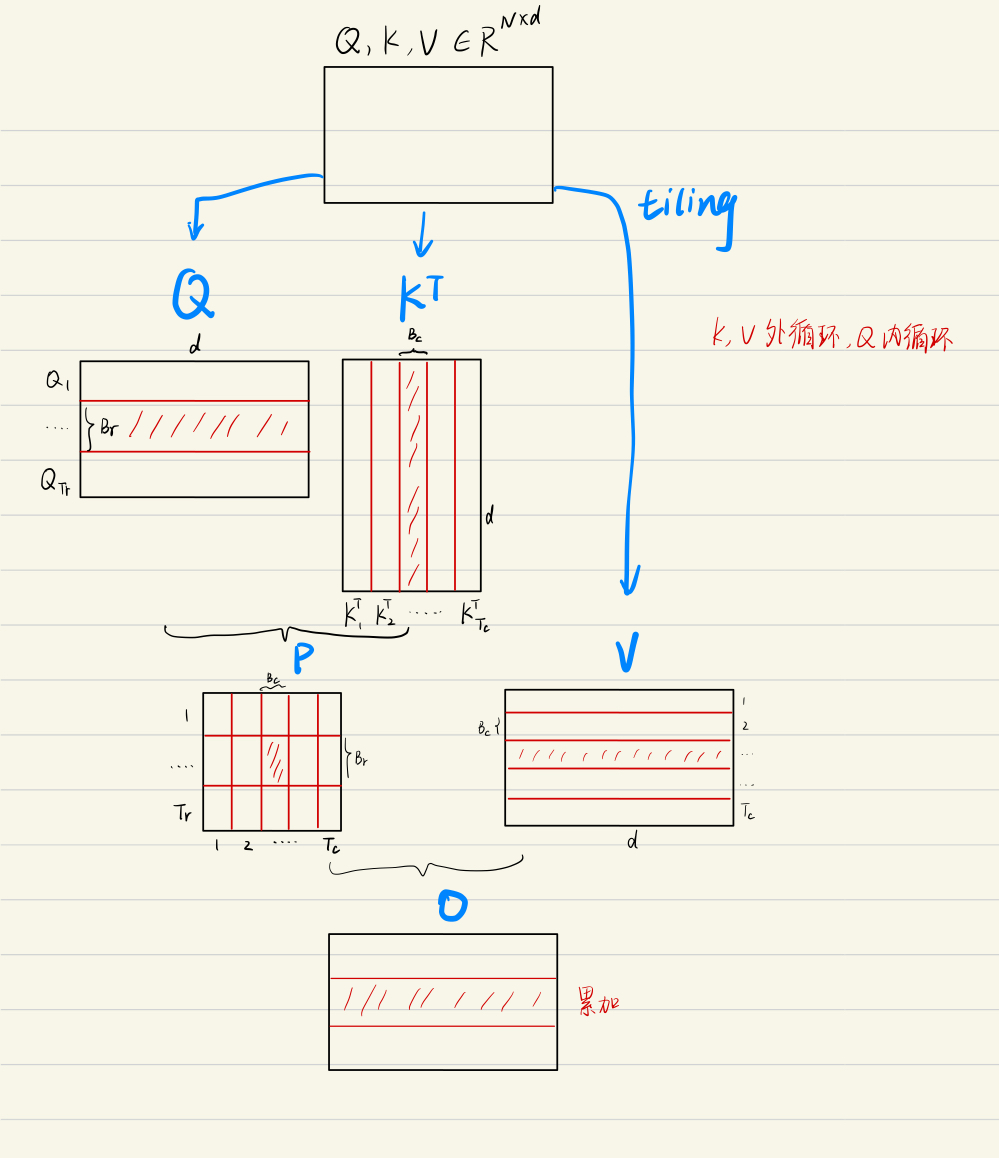
  • 主要目标:避免从GPU-HBM中读取和写入注意力矩阵。
  • 计算softmax不需要全局信息
    • 把输入分块,以分块增量方式计算softmax,即 softmax tiling算法。
  • 反向传播不存储中间attention矩阵(N2),只存储softmax归一化系数。
    • 标准Attention:需要把过程中的S、P写入HBM中,矩阵大小和输入序列长度有关,非常大
    • FlashAttention:不使用中间注意力矩阵,通过存储归一化因子来减少HBM内存的消耗。
  • 算法流程,具体见论文。
    • 简单讲:每次只计算一个block的只,通过多轮双for循环完成注意力计算。
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026