Skip to content

GLM 系列

📅 发表于 2025/09/24
🔄 更新于 2026/08/05
👁️ — 次访问
📝 6013 字
⏳ 19 分钟
mainllm
#glm4.5
#moe
#pretrain
#midtrain
#posttrain
#agentic sft
#reasoning rl
#Agentic RL
#WebSearcj
#SWE RL
#GeneralRL
#HolisticRL
#InstructionFollowing RL
#FunctionCall RL
#Pathology RL
变化点 ​

2026

2026.08 · GLM-5.3-Flash

  • 使用线性与稀疏混合注意力,降低长序列计算成本。
  • 以 30T 多模态 tokens 训练新基座,结合 mHC 稳定深层网络。

2026.02–08 · GLM-5 → 5.3

  • 增加 Repo MidTrain 与 Agentic RL,强化仓库级代码任务。
  • 结合稀疏注意力、分阶段 RL 与蒸馏,持续扩展长程 Agent 能力。
2025

2025.12 · GLM-4.7

  • 将交错推理、历史思考保留与逐轮 thinking 控制结合。
  • 减少多轮任务中的重复推理,延续已确认的约束与计划。

2025.12 · GLM-4.6V(视觉分支)

  • 将图像理解接入原生 Function Calling。
  • 工具结果与视觉反馈进入后续推理,支持视觉任务的连续交互。

2025.09 · GLM-4.6

  • 上下文由 128K 扩展至 200K,推理支持搜索和工具参与。
  • 加强真实编程任务、复杂指令遵循和长程 Agent 执行。

2025.08 · GLM-4.5

  • 以深窄 MoE 配合预训练、MidTrain,统一推理、代码与 Agent 能力。
  • 分别训练推理、Agent 和通用 RL,再整合能力。
2024 及以前

2024.06 · ChatGLM / GLM-4

  • 10T tokens 中英与多语言预训练,结合 SFT、RLHF 和分阶段长上下文扩展。
  • All Tools 统一搜索、Python、绘图与函数调用,形成工具增强对话模型。

(2608) GLM-5.3-Flash (混合注意力、30T 多模态预训练) ​

GLM-5.3-Flash:结构与训练

来源与定位

  • 模型卡、技术博客。
  • 面向长上下文 Agent,同时控制推理成本并保持历史信息检索能力。

混合注意力与 MoE

  • Linear Attention 把历史压入状态,Sparse Attention 保留选中历史位置的直接访问。
  • 320B-A18B MoE 控制每 token 计算;mHC 约束跨层连接的混合,改善扩展效率。

原生多模态预训练

  • 从新基座训练,使用约 30T tokens 多模态语料,联合学习文本、视觉与 Agent 能力。
公开表现与评测设置

仓库修复

  • DeepSWE v1.1 63.4;mini-SWE-agent,context=400K, timeout=6h。
  • 采样为 max effort, temperature=0.95, top_p=1,评估修改代码并完成验证的能力。

终端执行

  • Terminal-Bench 2.1 84.3;Claude Code 2.1.207,timeout=6h。
  • 使用 max effort, temperature=1, top_p=1, max_new_tokens=65536。
  • 两项结果分别覆盖仓库修复与终端操作,运行框架和预算也属于实际效果的一部分。

(2602–2608) GLM-5 → 5.3 (Repo MidTrain、Agentic RL) ​

已有详细笔记

(2512) GLM-4.7 (交错推理、思考保留) ​

GLM-4.7:多轮 Thinking

来源与问题

  • 模型卡、技术博客。
  • 多轮工具交互丢失前轮推理,会造成重复分析和计划不一致。

三种推理策略

  • Interleaved Thinking:行动前分析,收到工具结果后继续推理,再决定下一步。
  • Preserved Thinking:跨轮保留 thinking;Harness 按原顺序回传 reasoning_content,延续约束与计划。
  • Turn-level Thinking:按当前步骤开关推理,复杂定位开启,简单确认可关闭。
  • 三者分别处理推理与行动交替、历史保留和当前轮开销,组合用于持续代码任务。
公开表现(GLM-4.6 → 4.7)

代码与终端

  • SWE-bench Verified 68.0 → 73.8,Multilingual 53.8 → 66.7,覆盖不同语言仓库。
  • Terminal-Bench 2.0 24.5 → 41.0,终端多步执行收益更突出。
  • SWE/Terminal:temperature=0.7, top_p=1, max_new_tokens=16384,开启 Preserved Thinking。

搜索与历史管理

  • BrowseComp 45.1 → 52.0;4.7 加入上下文管理后达 67.5。
  • 模型升级和运行时历史管理均影响搜索效果,不能只比较模型名称。

(2512) GLM-4.6V (原生多模态 Function Calling) ​

GLM-4.6V:原生多模态工具调用

来源与配置

视觉交互链路

  • 图像、截图和文档页直接参与工具调用,避免先转成纯文本而丢失布局与细节。
  • 工具返回图表、检索图片或渲染页面,模型读取视觉反馈,再决定后续动作。
  • 例如检查页面截图、修改布局、重新渲染验证,形成连续视觉操作。
公开表现与不足

相对 GLM-4.5V

  • MMLongBench-Doc 44.7 → 54.9,Design2Code 82.2 → 88.6:跨页理解与截图转代码改善。
  • OSWorld 35.8 → 37.2,WebVoyager 84.4 → 81.0:视觉理解提升尚未全面转化为操作收益。
  • 评测使用 temperature=0.8, top_p=0.6, top_k=2, repetition_penalty=1.1, max_new_tokens=16K。

原文改进方向

  • 加强纯文本推理和指令执行,减少 overthinking、重复内容,改善计数和人物识别。

(2509) GLM-4.6 (200K、工具增强推理) ​

GLM-4.6

参考链接

相对 GLM-4.5 的变化

  • 上下文由 128K → 200K,容纳更长的代码、网页证据与工具历史。
  • 推理过程支持工具参与,强化代码修改、搜索与连续 Agent 任务。
  • 重点提升真实编程体验、复杂指令遵循和输出质量。
工具推理与公开表现

交互方式

  • 根据问题选择搜索或执行工具,读取返回结果,再继续推理和行动。
  • 工具增强推理与搜索各自提供评测模板。

结果

  • GLM-4.7 官方比较表中,GLM-4.6 的 SWE-bench Verified 为 68.0。
  • BrowseComp 为 45.1,加入 Context Management 后为 57.5。
  • 长任务结果受上下文管理影响,需要同时考虑模型与交互策略。
  • 来源:GLM-4.7 model。

(2508) GLM-4.5 ​

🌺 论文摘要

论文摘要
  • paper, 技术报告
  • MoE架构,深而窄。2阶段预训练+Mid-Training。
  • PostTraining
    • SFT:2阶段SFT,自动AgenticSFT数据构造。
    • Reasoning RL (数学+代码+科学):2阶段难度课程学习,动态采样温度等。
    • Agentic RL (WebSearch + SWE RL):数据收集,自蒸馏迭代优化。
    • General RL (综合+指令跟随+函数调用+问题RL):Rule+RLHF+RLAIF 3种反馈信号。

问题背景 ​

❓问题背景

问题背景
  • LLM变化:通用问答 -> 问题解决者
  • 闭源模型在数学和代码修复领域有效果,开源模型有差距,难以解决复杂真实问题。
  • 缺乏在Agentic(使用外部工具和世界交互), Reasoning(多步推理), Coding(真实软件工程) 同时优秀的开源模型。

模型架构 ​

模型架构
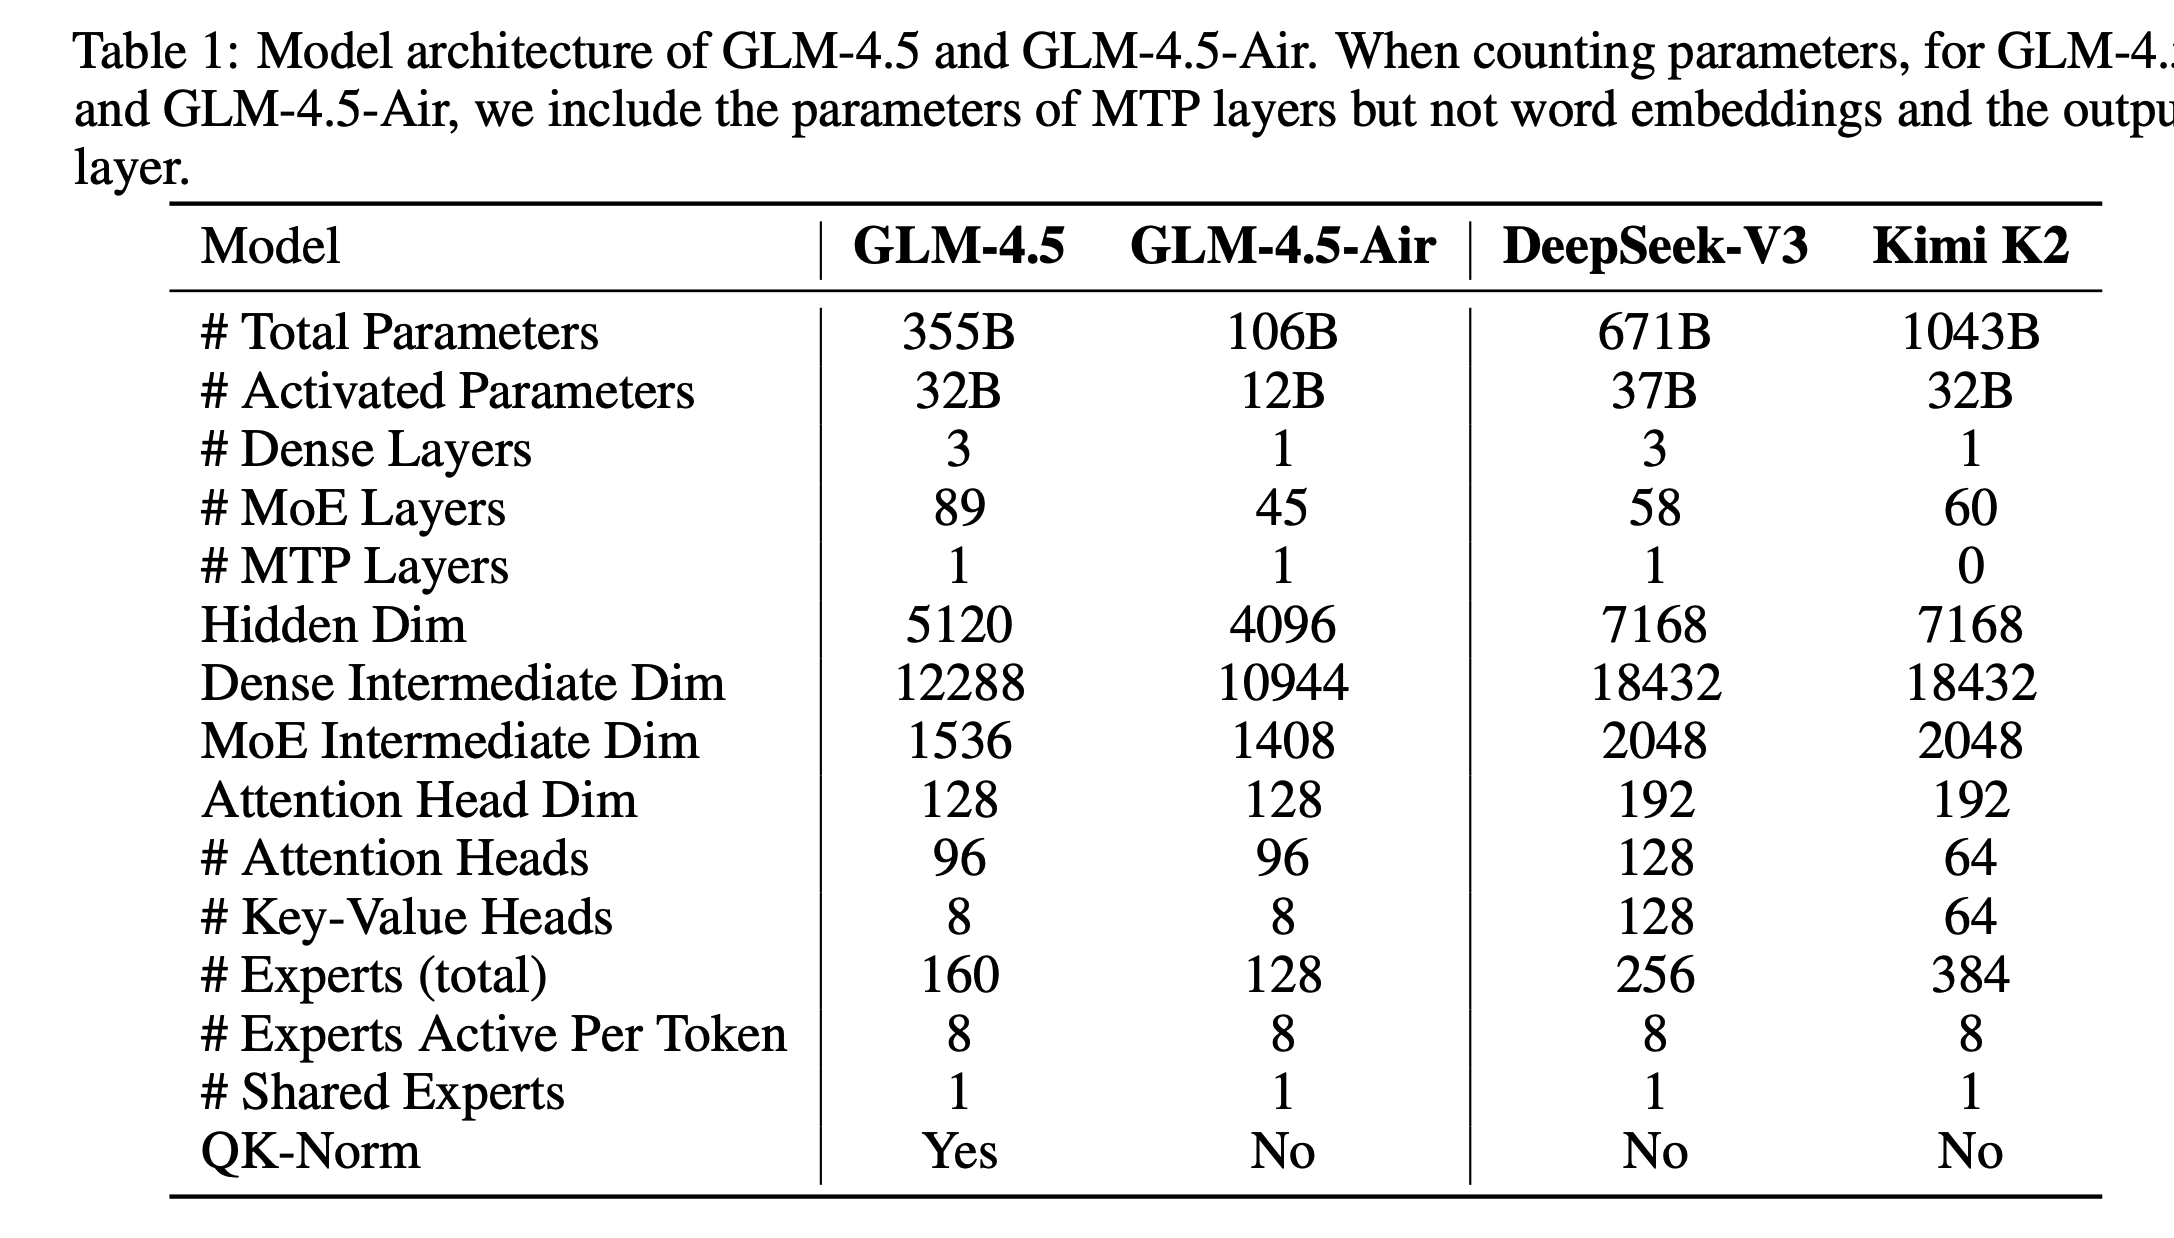
  • MoE 架构
    • loss-free balance routing:无需辅助loss,来平衡路由。
    • sigmoid gates:sigmoid决定token给哪些专家,传统是Softmax Topk
  • 更深而窄:层数变多、hidden_dim变小。
    • 实验发现:深度对推理能力很重要。
    • 对比DeepSeek-V3, Kimi-K2:由宽变窄、由浅变深
  • GQA + partial RoPE.
  • 注意力头更多: 5120隐藏层维度 + 96个head,一般是64个
    • 没降低训练loss,但提升了MMLU和BBH的分数
  • 稳定性:采用QK-Norm来稳定attention logits的数值范围,防止训练不稳定。
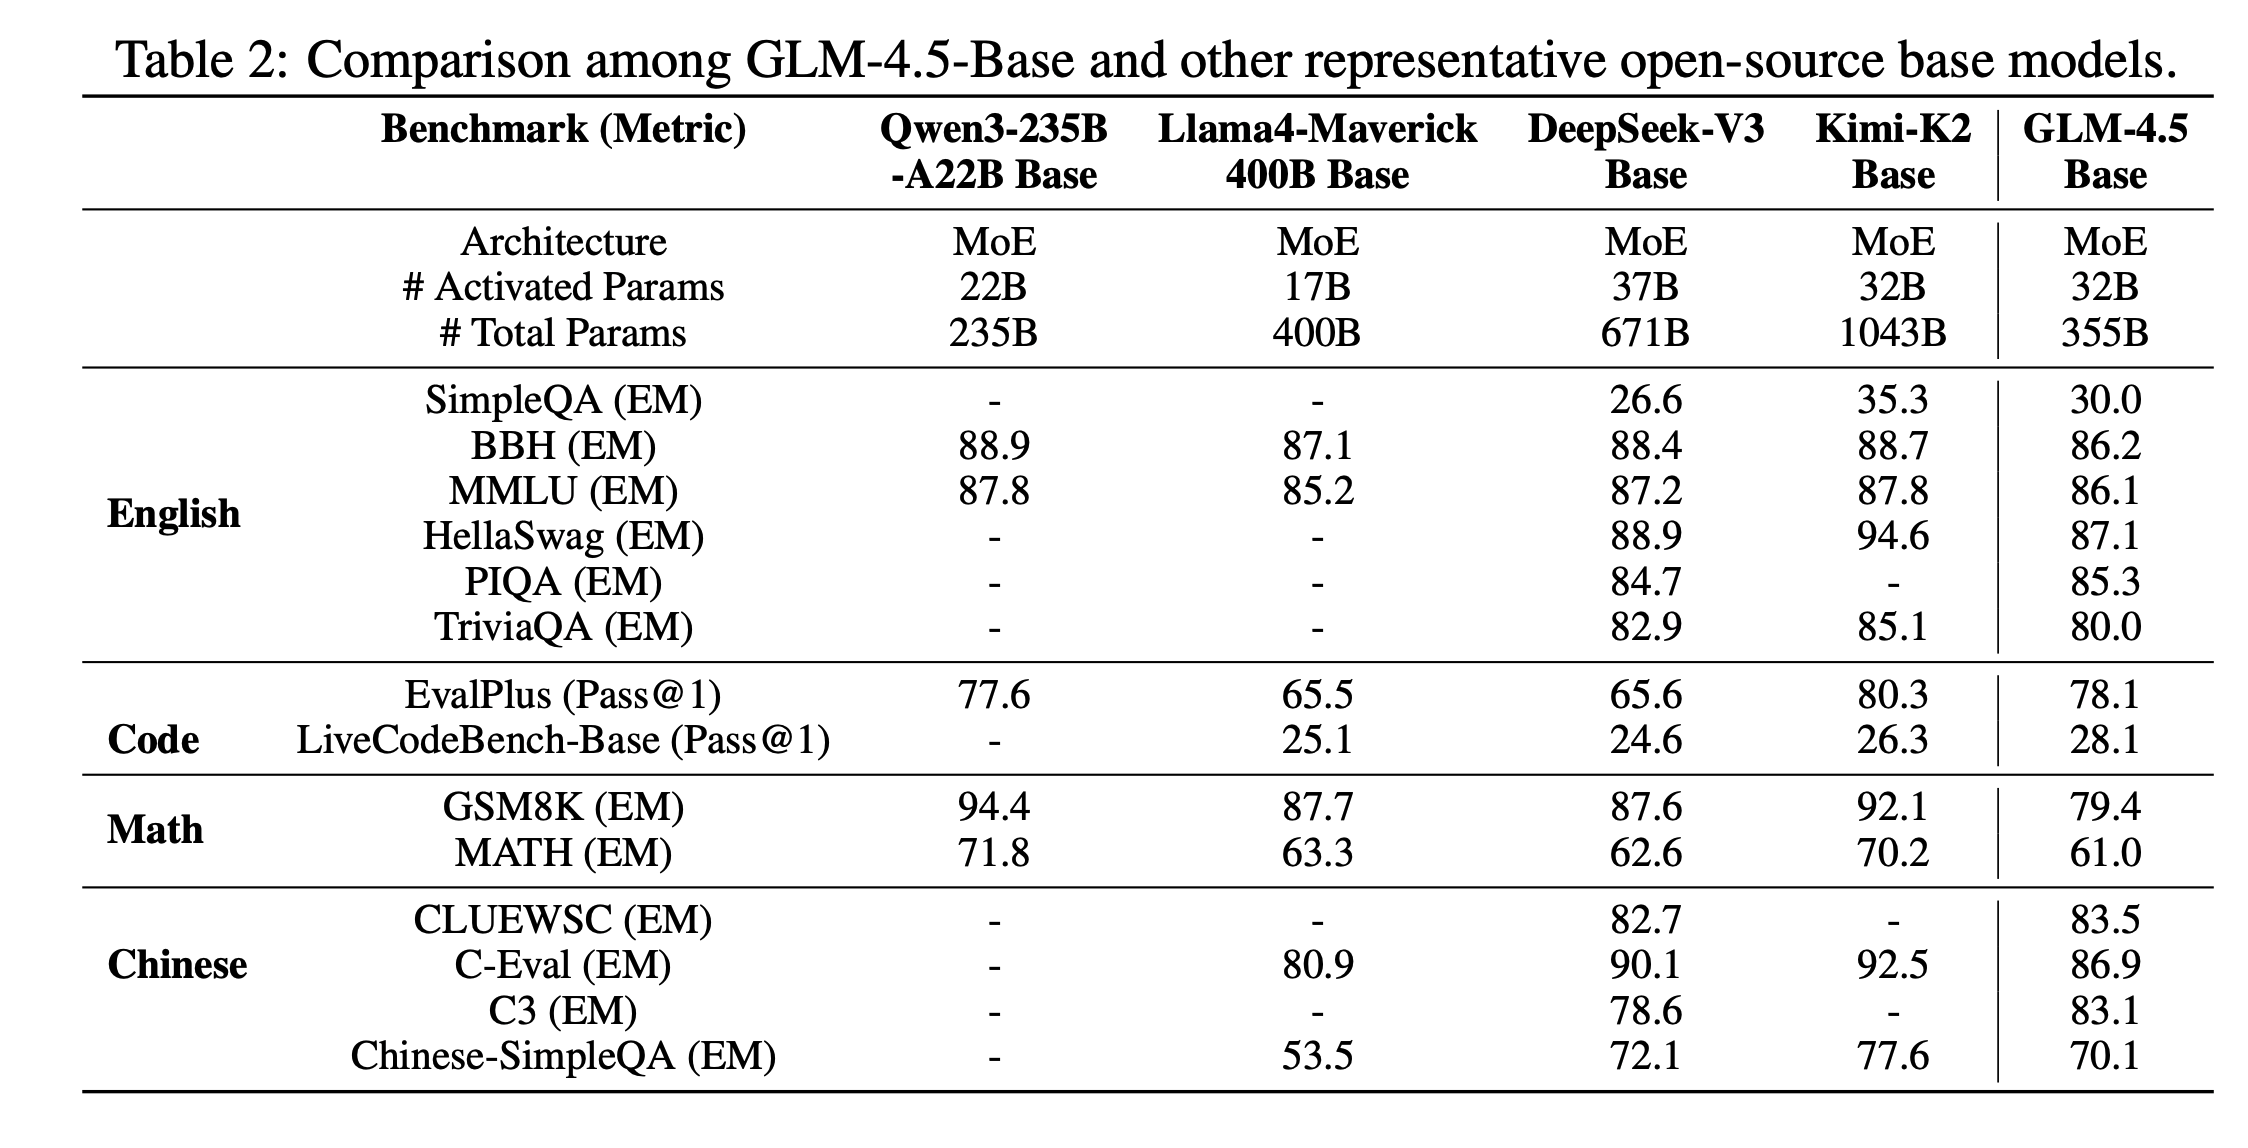
  • 参数:355B-A32B, 106B-A12B

预训练 ​

📕核心方法

预训练数据 ​

预训练数据
  • Web数据:中英文web网页(爬取的)。
    • 同Nemotron-CC,对网页按质量打分,分桶。
    • 丢弃低质量。上采样高质量buckets,贡献3.2个epoch训练,覆盖推理高频知识。
    • 使用SemDedup去掉自动模板生成的网页。
  • 多语言:爬取网页、Fineweb-2。做质量分类,对高质量进行上采样。
  • 代码:
    • Github+各种代码平台数据。
      • 初步规则过滤,按语言做质量分类:高质、中等、低质量。
      • 上采样高质量、去掉低质量代码。所有源码数据应用FIM任务。
    • Code相关 Web数据
      • stage1:HTML Code标签,FastText检索代码内容
      • stage2:做质量评估(高、中、低),同源代码一样采样过滤。
      • stage3:使用细粒度解析器,重新解析选择的网页,更好保留代码格式内容。
  • 数学和科学
    • 来源:web、书籍、论文等。
    • 使用LLM,根据数学和科学内容比例,对文档进行评分,并训练小分类器来预测分数。
    • 上采样高分数据
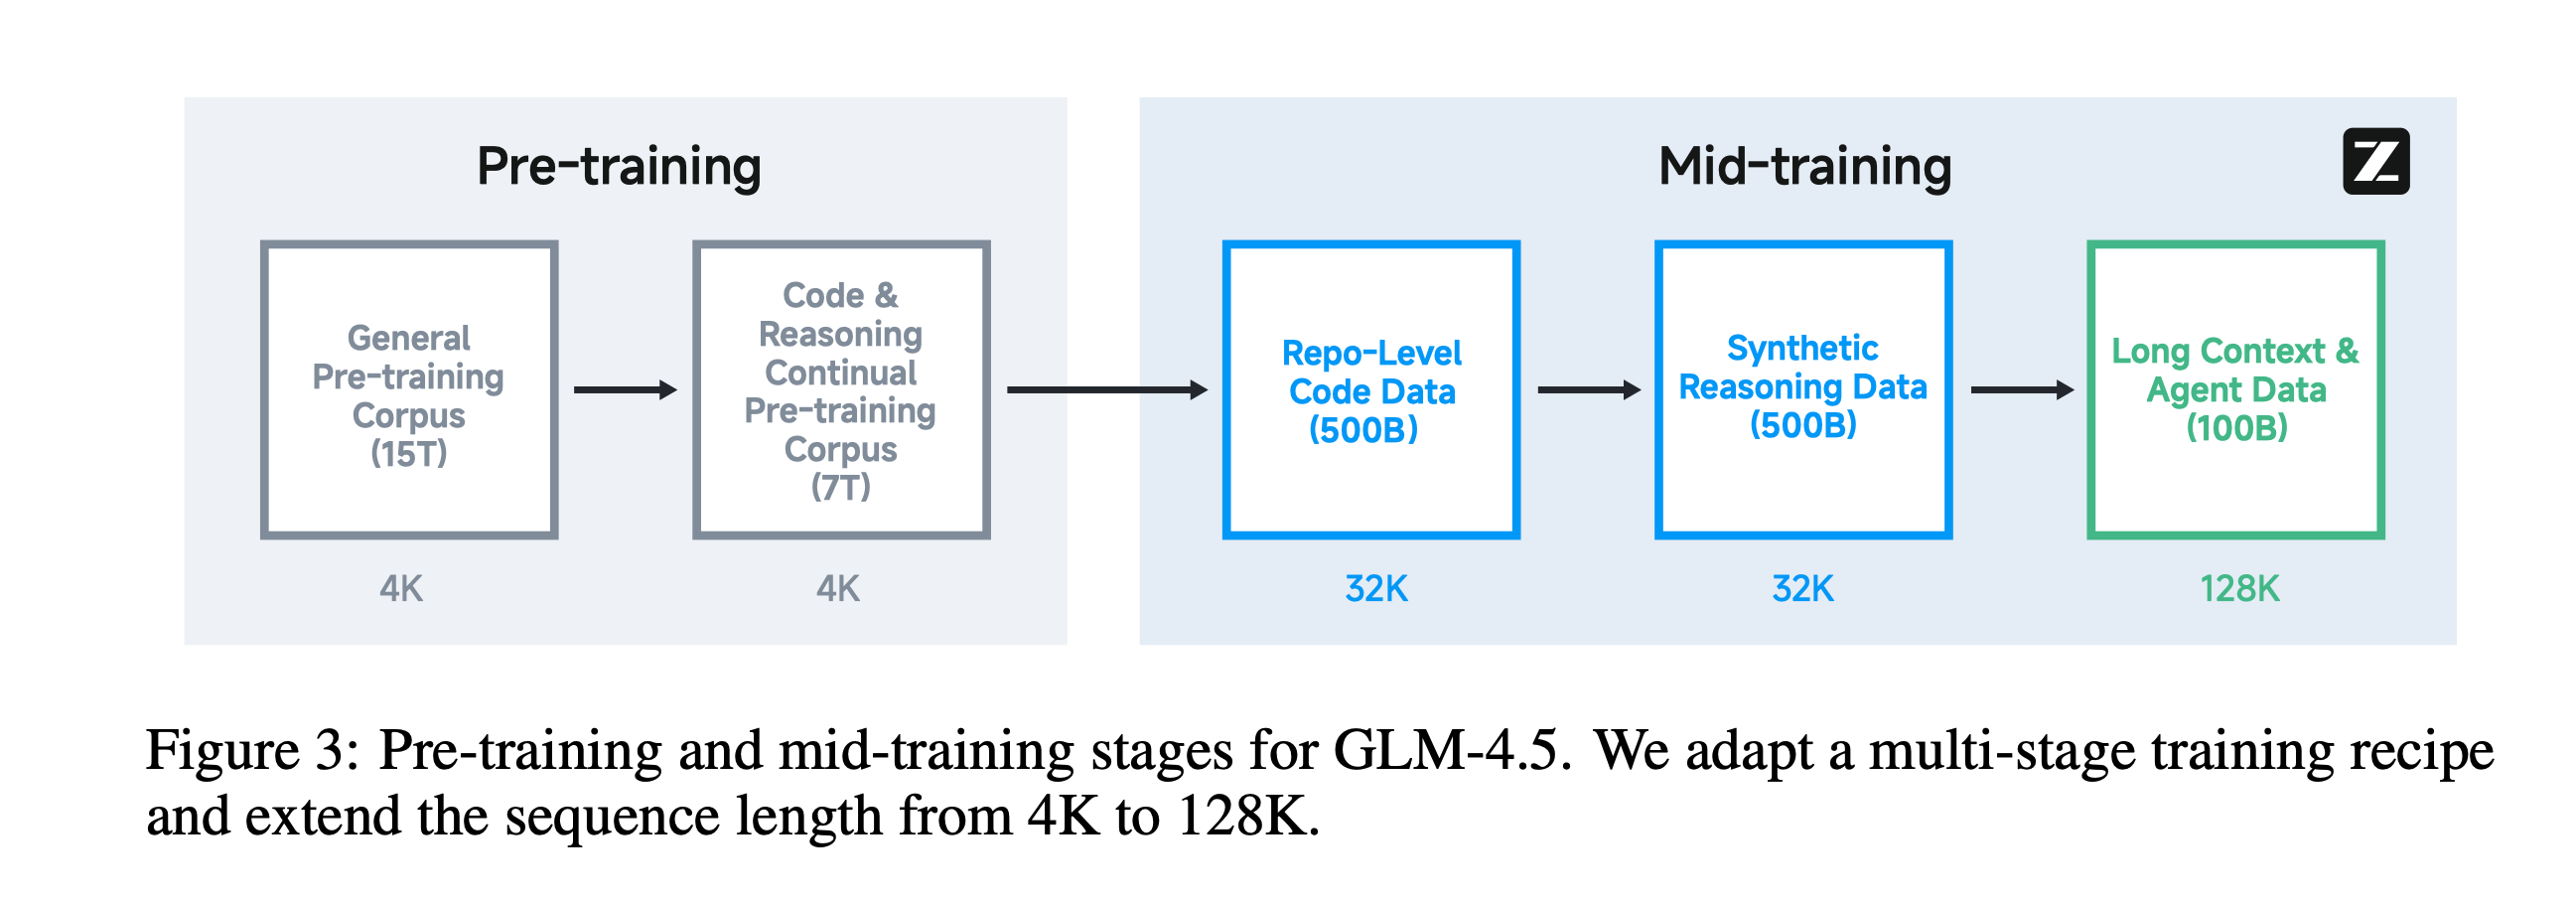
2阶段预训练
  • 阶段1:通用数据,做训练
  • 阶段2:上采样代码/数学/科学等数据,做训练

Mid-Training ​

Mid-Training

背景

  • 增强特定领域能力:使用特定领域数据(包括指令数据),量少但质量高,注入结构化知识和长逻辑。
  • 为后续SFT和RL打下基础。

Repo-Level Code训练

  • 学习跨文件依赖关系:拼接多个代码文件,
  • 提高SWE能力:学习代码如何被修改的。学习diff,上下文(Issue+PR+Code)
  • 4k -> 32k

合成推理数据 训练

  • 使用强推理模型,合成数学/科学/代码推理过程。
  • 32k, 500B

长上下文和agent 训练

  • 上采样长文档、大规模合成agent轨迹。
    • 尽量把完整文档塞进一个Batch,避免截断关键逻辑。Best-fit Packing。
  • 32k -> 128k, 100B

超参 ​

预训练超参

Muon 优化器

  • 特点:基于Newton-Schulz迭代,具有二阶优化器的特性
    • 收敛快:比AdamW更快降低loss;大batch友好:承受极大batchsize,64M tokens。
  • 优化embedding, bias 和RMSNorm之外的所有参数。
  • 超参:迭代步数N=5,动量μ=0.95,缩放的rms=0.2

学习率

  • 放弃Warmup-Stable-Decay,回归Cosine Decay

  • 学习率:0,预热到2.5e-4,衰减到2.5e-5,直到mid-train结束

Batch Size

  • 前500B token,16M token,后期 64M token 保持不变。

序列长度

  • 序列长度:最初 4k,mid-train 32k -> 128k
  • RoPE:base 由1w -> 100w,扩展上下文。

MoE 路由

  • loss-free balance routing
    • 前15T token,有偏置更新,偏差更新率设为0.0001,强制负载均衡。
    • 其余:设为0。模型专家分工形成后,停止人为干预偏置。
  • 辅助的序列级loss:极小权重0.0001,保底防止极端情况的负载崩塌

MTP loss

  • 前15T token,λ=0.3,其余token λ=0.1

PostTraining ​

PostTraining
  • 阶段1 :Expert Training, 构建3个领域专家模型,推理、agent、通用聊天
  • 阶段2:统一训练,采取自蒸馏技术 整合多个专家,最终交付一个综合模型。

SFT (多阶段/自动数据构造等) ​

SFT

SFT 目的

  • 阶段1(专家训练):冷启动,后期被RL进一步提升。
  • 阶段2(统一训练):蒸馏各专家模型,到一个混合通用模型。

冷启动SFT

  • 少量CoT数据做SFT,确保每个专家在RL之前 有足够的基础能力。

综合SFT

  • 数据:推理任务、通用聊天、agent任务、长上下文理解任务。答案从各专家模型蒸馏而来。
  • 模型:base model,长度:128k
  • 混合推理模式:混合思考和直接回答的两种数据。难题做思考,简单任务直接回答。
一些关键点

XML 工具调用模板

  • 由json改成XLM,避免太多转义字符,降低模型负担,更好支持agentic能力。

拒绝采样

  • 从专家模型采样,采取多阶段过滤机制
    • 过滤重复、超短、截断、不符合推理格式的。
    • 客观验证:过滤数学/代码 答案不正确的。
    • 主观过滤:使用RM过滤主观低分答案的样本。
    • 工具过滤:工具调用要格式正确、真正解决问题。

Prompt选择和ResponseScaling

  • 过滤困难prompt + 过滤滤回复长度太短的prompt,约过滤50%
  • 仅用50%数据训练,但在数学和科学任务山给提升2%-4%

自动 Agentic SFT 数据构造

  • Agent框架和收集工具
    • 收集一套agent框架、真实API和MCP Server,以及使用LLM 自动构建工具
  • 合成任务:基于框架和工具,来合成单步或多步任务
    • 对于成熟框架:使用LLM理解功能,自动生成query或任务。
    • 对于零散工具:选择一个工具子集,使用LLM构建关于该子集的任务。
  • 轨迹生成:对每个合成任务
    • 使用LLM生成工具调用轨迹,LLM模拟用户。
    • 使用多个judge-agent 来评估任务是否完成,仅保留成功轨迹。

Reasoning RL (数学+代码+科学) ​

Reasoning RL

背景

  • 专注于数学/代码/科学等领域,有明确奖励信号。
  • 算法:GRPO + 去掉KL Loss。
  • 核心解决:训练效率、样本多样性和数据质量等问题。

基于难度的2阶段课程学习

  • 背景:太简单或太难,会导致梯度为0,无优势。
  • 阶段1:中等难度数据,rollout=16。
  • 阶段2:高难度数据,rollout=512,严格具有正确答案的样本。
    • AIME24:81.8 -> 83.4

直接使用最大长度64K

  • 不用多阶段扩展长度,因为SFT已经学过长输出了,限制逐渐扩展反而效果不好。

动态采样温度

  • 温度低:缺乏探索;温度高:引入低质量噪声样本,影响训练效率。
  • 动态调整温度:维持探索和利用平衡。
    • 平均奖励稳定:提升采样温度鼓励探索。
    • 基于质量选择高温:在性能不下降1%的情况下,所能选的最大温度。

代码RL

  • Token-level Loss:梯度信号更稳定,收敛更快,解决长度偏差问题。

科学RL

  • 数据质量和类型很重要:仅使用专家验证的多选题训练,效果比混合质量数据好。

Agentic RL (WebSearch + SWE RL) ​

AgenticRL

任务

  • web-search, 代码生成 ,答案可验证。

数据收集合成

  • web搜索:需要搜索零散信息,数据合成pipeline
    • 知识图谱法(多条推理):利用知识图谱,找到较远的实体,生成问A和D关系的问题,必须A->B->C->D
    • 捉迷藏方法:人工选择网页,把关键信息抹掉,模型必须依赖这些信息才能回答问题。
  • 软件工程
    • 收集Github PR + Issue,构建prompt + 单元测试
    • 加固沙箱:不会搞坏宿主机

算法优化

  • GRPO:LLM-response才计算,环境返回被mask掉。
  • 奖励信号:
    • 搜索-最终结果ACC;SWE-单元测试通过率。
    • 过程格式惩罚:在轨迹生成过程中,只要工具格式错误,就立即停止,并给0分。
  • 自蒸馏迭代优化:SFT -> RL -> SFT -> RL ...
    • 使用RL模型预测结果,替换冷启动数据,得到更强SFT模型,再进行RL,如此迭代。
  • 效果
    • 搜索 + SWE RL提升,会使其他工具调用/Terminal-Bench也提升。
    • 环境交互次数增加,效果也会增加

General RL (综合+指令跟随+函数调用+问题RL) ​

General RL

背景

  • 提升模型整体性能,修复一些问题,加强关键能力。
  • 3种反馈信号:Rule-based, RLHF, RLAIF。
    • 更鲁棒的训练信号,更好使用每一种数据。
Holistic RL

Holistic RL

  • 目标:泛领域效果提升。
  • 数据集:5000prompt,覆盖7个一级、33个二级、139个三级分类。
  • 2种反馈信号:更可靠效果更好
    • 人类反馈信号:在偏好数据训练RewardModel,基于指令遵循、安全性、事实正确性等多维度评估。
    • AI反馈信号:设计评分准则。
Instruction Following RL

指令跟随 RL

  • 目标:复杂指令。
  • 数据集:专门构建的有挑战数据集,覆盖7类和151个细分类别。
  • 3种反馈信号:非常鲁棒,避免RewardHacking,带来效果提升。
    • 规则验证:
    • 奖励模型:
    • Critic模型:
Function Calling RL

Step-Wise Rule RL

  • 对固定流程任务,标注每一轮的GT工具调用。
  • 奖励信号:完全匹配GT结果,才得1;其余为0。

端到端 多轮 RL

  • 开放性任务
    • 单轮多步任务:多步工具调用。
      • 数据:基于MCP合成的数据+ 有运行环境的开源agent数据 (AgentGym等)
    • 多轮多步任务:
      • 多步工具执行 + 多轮用户交互。LLM模拟用户
  • 奖励信号:格式正确且任务完成,才为1;其余为0.
Pathology RL

背景

  • 后期存在语言混合、过度重复、格式错误等问题。
  • 通用RL难以解决:发生概率<1%,样本效率低

方法

  • 识别高危prompt,构建专有数据集
  • 再跑一轮RL,使用极大负奖励做惩罚,降低错误。

算法实验 ​

实验设置 ​

✍️实验设置

实验设置

基础模型

  • GLM-4.5 (355B Total / 32B Active)
  • GLM-4.5-Air (106B Total / 12B Active)

训练任务/数据

  • 预训练:23T tokens,包含网页、书籍、论文、GitHub 代码。
  • Mid训练:32K 到 128K 上下文扩展,Repo 级代码,合成推理数据。
  • 后训练:SFT(冷启动+专家蒸馏),RL(GRPO 算法,针对推理、Agent、通用任务的不同策略)。

评测任务/数据

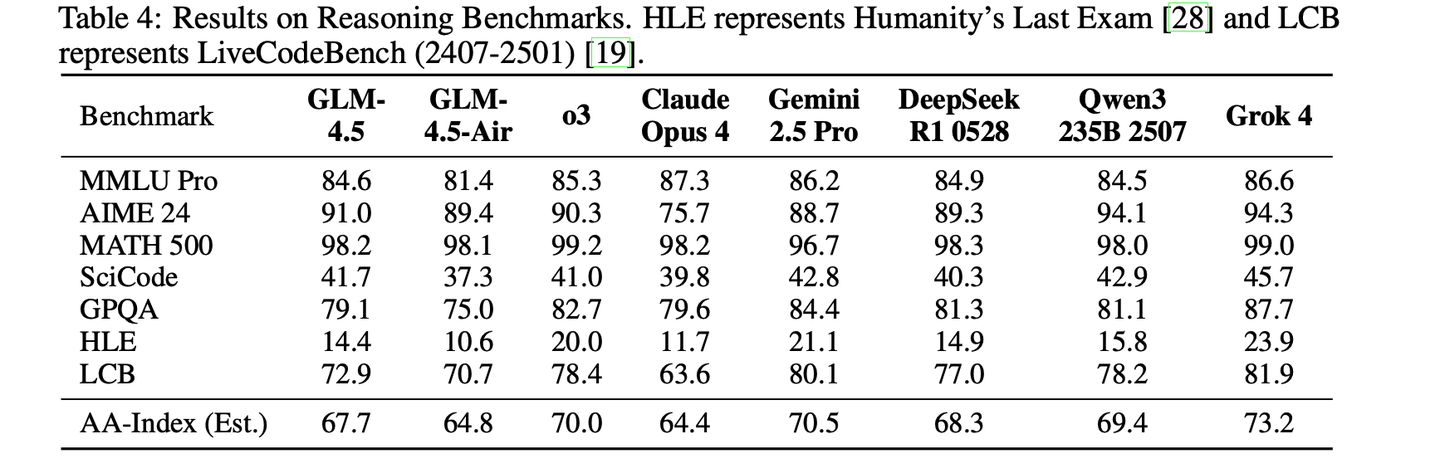
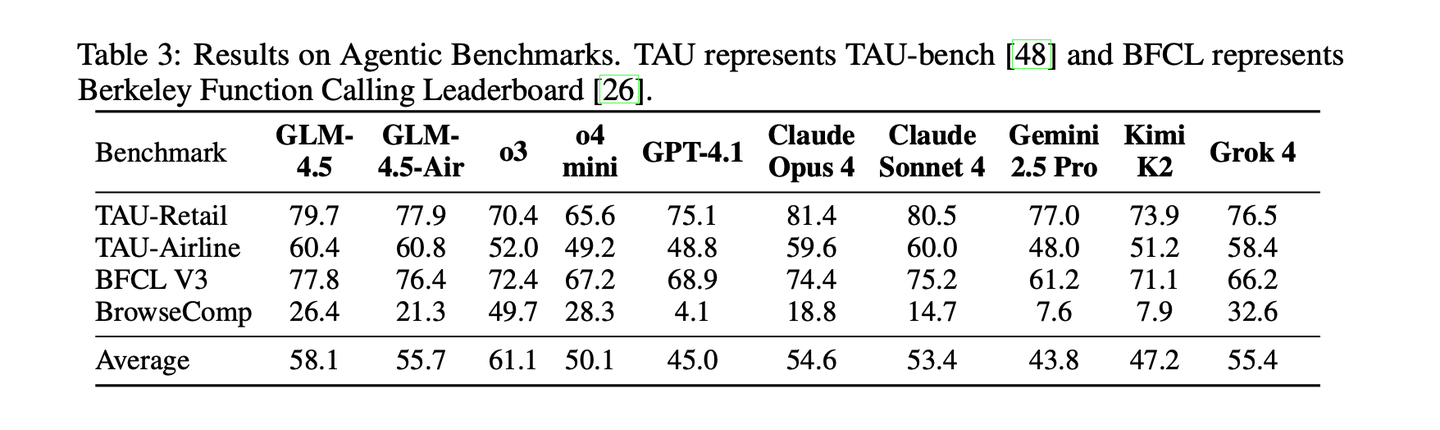
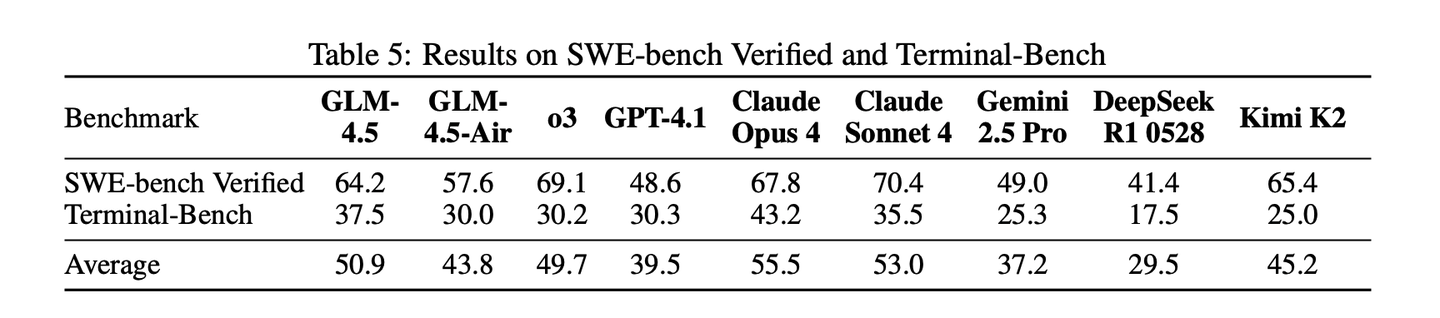
  • ARC 基准 (12个):Agentic (TAU-Bench, BFCL V3, BrowseComp), Reasoning (MMLU-Pro, AIME 24, MATH-500, SciCode, GPQA, HLE, LCB), Coding (SWE-Bench Verified, Terminal-Bench)。
  • 通用基准:MMLU, SimpleQA, IFEval, SysBench。
  • 人工评测:SafetyBench, CC-Bench (基于 Claude Code 的编码 Agent 评测), 翻译能力评测。

算法/策略

  • 2阶段预训练:通用数据 + 上采样高质量数据训练
  • MidTrain:仓库级 + 合成推理数据 + 长上下文,上采样+逐步扩展长度
  • 多阶段SFT:冷启动+统一训练,混合推理模式。
  • 多种RL训练:ReasonRL 难度课程学习;Agentic RL:自蒸馏迭代优化;General RL:3种反馈信号。

超参

  • 优化器:Muon
  • 学习率调度:Cosine decay (而非 WSD)
  • 最大序列长度:128K (Post-training)

关键结果 ​

🍑关键结果

关键结果
  • 总体排名:在 ARC 任务上,GLM-4.5 总体排名第 3,GLM-4.5-Air 排名第 6。GLM-4.5 在 Agentic 任务上排名第 2(仅次于 OpenAI o3),在 Coding 任务上排名第 3(接近 Claude Sonnet 4)。
  • 参数效率:GLM-4.5 在 SWE-bench Verified 上位于帕累托前沿,以 DeepSeek-R1 一半的参数量实现了与之相当甚至更好的性能。
  • Agent 能力:在 TAU-Bench 上得分 70.1%,在 BFCL v3 上得分 77.8%,与 Claude Sonnet 4 持平。在 Web 浏览任务 BrowseComp 上明显优于 Claude Opus 4。
  • 推理能力:AIME 24 得分 91.0%(优于 o3),MATH-500 得分 98.2%。
  • 编码能力:SWE-bench Verified 得分 64.2%,Terminal-Bench 得分 37.5%,优于 GPT-4.1 和 Gemini-2.5-Pro。
  • 工具调用可靠性:在 CC-Bench 实测中,工具调用成功率高达 90.6%,高于 Claude Sonnet 4 (89.5%) 和 Kimi K2 (86.2%)。

预训练评估

后训练评估

Agent 评估

SWE 评估

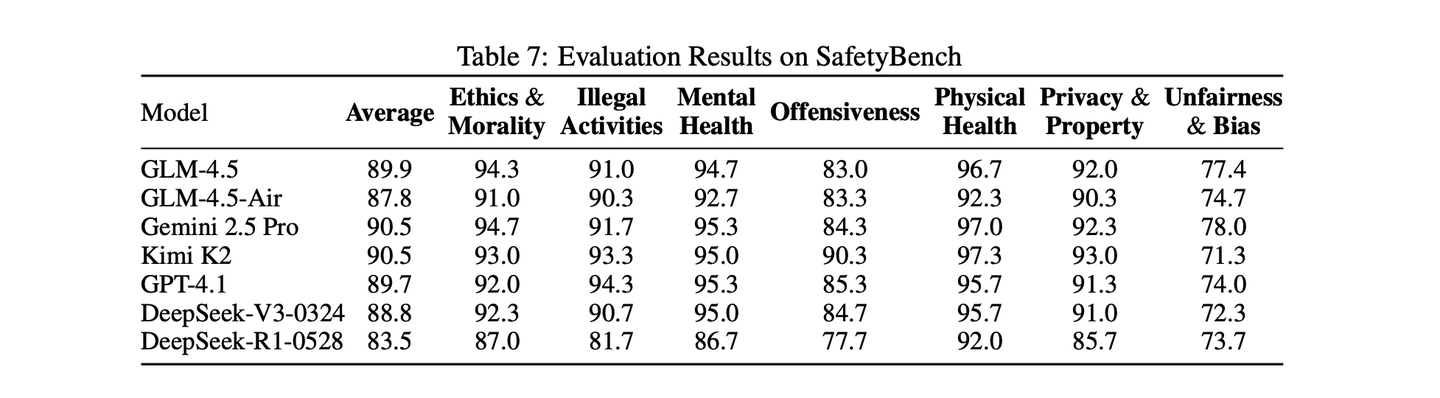
安全评估

未来方向 ​

⛳ 未来方向

未来方向
  • 解决偏见:虽然安全性得分高(Ethics, Safety),但不公平与偏见(Unfairness & Bias)仍有改进空间。
  • 统一能力的深化:把Agent+Reasoning+Coding能力更深层次地融合到一个统一模型,不依赖分离的专家。
  • 开源生态:释放模型权重和 glm-simple-evals 评测工具,推动复杂推理和Agent方面的研究。

(2406) ChatGLM / GLM-4 (10T 预训练、长上下文、All Tools) ​

🌺 论文摘要

ChatGLM / GLM-4 论文摘要

参考链接

问题背景

  • 中英双语模型需要同时改善知识、指令遵循、长上下文与实际工具执行。
  • 从 ChatGLM 的对话能力,扩展到能规划、调用工具并利用反馈的 Agent。

核心方法

  • 预训练与架构:约 10T tokens,数据去重、过滤与来源重加权;GQA 降低 KV Cache。
  • 长上下文与对齐:位置扩展、长文本继续训练与 LongAlign,结合 SFT、RLHF。
  • All Tools:在 GLM-4 上进一步对齐,联合浏览器、Python、绘图与自定义函数。

模型效果(GLM-4-0520)

  • 相对 GLM-4-0116,MATH 47.9 → 61.3,HumanEval 72.0 → 78.5。
  • LongBench-Chat 中文 84.0、英文 87.3;AgentBench 综合 3.79。

重要结论

  • Function Call 总分不随规模单调增长;API 实际执行得分随规模更稳定地提升。

核心贡献

  • 开放 GLM-4-9B、长上下文与视觉版本,形成中英双语、工具与长文本训练路线。

未来方向

  • 改善真实代码任务、高交互 Agent 与数学推理,继续研究数据质量和选择原则。

问题背景 ​

对话、长文本与执行能力
  • 长输入难以有效利用:扩大窗口之外,还需训练模型遵循长文中的任务要求。
  • 单轮回答不能完成复合任务:搜索、计算、生成图像需要工具选择与多轮反馈。
  • 函数题不能代表真实开发:HumanEval 难度与用户代码需求不同,需加入真实任务评测。

核心方法 ​

预训练数据与高效架构 ​

10T 中英多语言预训练

数据构建

  • 来源包括网页、Wikipedia、书籍、代码和论文;以中英为主,另含 24 种语言。
  • 先做精确与模糊去重,再过滤噪声网页、占位内容与不合适文本。
  • 对来源重新加权,提高书籍、Wikipedia 等高质量、教育性内容的比例。

Tokenizer

  • 分别学习中文和多语言 BPE,再与 cl100k_base 合并,词表约 150K。
  • 减少同一文本所需 token,提高训练与上下文利用效率。
架构与长上下文

架构调整

  • 使用 RMSNorm、SwiGLU、RoPE;除 QKV 外去掉 bias。
  • GQA 减少 KV Cache,将节省的参数移到 FFN,维持整体模型规模。

上下文扩展

  • 系列窗口由 2K → 32K → 128K,另提供实验性 1M 版本。
  • 结合位置编码扩展、长文本继续训练与 LongAlign 长上下文对齐。
  • GLM-4-9B 以 8K 长度预训练,再使用与 GLM-4-0520 相同的后训练流程和数据。

SFT 与人类偏好对齐 ​

真实交互数据与 RLHF

SFT 数据

  • 优先真实人类提示与交互,减少对固定模板的依赖。
  • 结合内部标注与外部采购数据,对样本执行质量控制。

偏好训练

  • 标注安全性、事实性、相关性、有用性与人类偏好。
  • SFT 学习基本交互;RLHF 改善拒答、双语混杂与多轮连贯性。
  • 长文本对齐、数学自批评与 AgentInstruct 轨迹分别强化相应任务能力。

All Tools 多工具交互 ​

规划、执行与反馈

执行流程

  • 理解用户任务 → 分解步骤 → 选择工具 → 读取反馈 → 继续执行。
  • 工具包括浏览器、Python、CogView 绘图,以及用户自定义函数和 API。
  • 例如先搜索历年人口数据,再用 Python 计算增长率,最后组织回答。

训练与应用

  • 在 GLM-4 上进一步对齐,使模型自主判断何时使用工具、如何组合多个工具。
  • GLMs 可附加知识库与自定义能力,支持面向具体场景的 Agent。

实验设置(GLM-4 / Air / 9B) ​

模型与评测任务

模型

  • 主测 GLM-4-0520、GLM-4-Air-0605 与 GLM-4-9B-Chat,部署采用 BF16。
  • 对照包含 GLM-4-0116、GPT-4/Turbo、Claude 3 Opus 与 Gemini 1.5 Pro。

任务与协议

  • 通用:MMLU、GSM8K、MATH、BBH、GPQA、HumanEval;数学与 BBH 使用 CoT 提示。
  • IFEval:541 条提示,分别报告中英、严格/宽松和提示/指令级准确率。
  • LongBench-Chat:10K–100K 输入,覆盖文档问答、摘要和代码,多次评测取平均。
  • NaturalCodeBench:真实中英代码需求,分别评测 Python 与 Java。
  • BFCL:2K 问题,区分 AST、API 执行与无关工具识别。
  • AgentBench:使用 7 个环境,排除交互耗时较长的 Digital Card Game。

关键结果(GLM-4-0520 与 All Tools) ​

推理、长上下文与实际代码

版本迭代

  • GLM-4-0116 → 0520:MATH 47.9 → 61.3,HumanEval 72.0 → 78.5。
  • MMLU 达 83.3;数学与代码提升更明显,知识指标变化相对较小。

长上下文与中文对齐

  • LongBench-Chat 中文 84.0,高于表中 GPT-4-Turbo 的 82.1;英文 87.3。
  • AlignBench 综合 8.00,与表中 GPT-4-Turbo 相当,中文逻辑与语言理解较强。

真实开发仍有差距

  • NaturalCodeBench 为 47.1,低于 GPT-4-Turbo 的 53.8。
  • 函数生成与真实需求的排名、差距不同,需要分别观察。
工具与 Agent

Function Call

  • GLM-4 的 BFCL 综合 81.76,GLM-4-9B-Chat 为 81.00,小模型已接近大模型。
  • API 执行得分则为 84.40 → 85.93 → 87.78,随 9B、Air、GLM-4 规模提升。

任务执行

  • AgentBench 综合 3.79,数据库、家庭操作与网页购物表现较强。
  • 操作系统、知识图谱与高交互推理仍有差距,综合得分不能代替分环境分析。
  • All Tools 的 Python 辅助 MATH 为 63.60,与同表 GPT-4 Web 的 65.00 接近。

未来方向 ​

作者指出的改进方向
  • 数据选择:继续研究数据质量、多样性和清洗配比的有效原则。
  • 真实代码与 Agent:改进代码数据和训练策略,补足系统操作与高交互任务。
  • 数学推理:利用自批评等训练方法缩小复杂数学任务差距。
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026