Skip to content

Word2vec之公式推导笔记

📅 发表于 2017/11/02
🔄 更新于 2025/07/23
👁️ — 次访问
📝 1271 字
⏳ 5 分钟
自然语言处理
#word2vec
#深度学习

cs224n word2vec 简介和公式推导

Word meaning ​

词意 ​

词的意思就是idea,如下:

  • 词汇本身表达的意义
  • 人通过词汇传达的想法
  • 在写作、艺术中表达的意思
  • signifier - signified(idea or thing) - denotation

传统离散表达 ​

传统使用分类学去建立一个WordNet,其中包含许多上位词is-a和同义词集等。如下:

上义词同义词
entity, physical_entity,object, organism, animalfull, good; estimable, good, honorable, respectable

离散表达的问题:

  • 丢失了细微差别,比如同义词:adept, expert, good, practiced, proficient, skillful
  • 不能处理新词汇
  • 分类太主观
  • 需要人力去构建和修改
  • 很难去计算词汇相似度

每个单词使用one-hot编码,比如hotel=[0,1,0,0,0],motel=[0,0,1,0,0]。 当我搜索settle hotel的时候也应该去匹配包含settle motel的文章。 但是我们的查询hotel向量和文章里面的motel向量却是正交的,算不出相似度。

分布相似表达 ​

通过一个单词的上下文去表达这个单词。

You shall know a word by the company it keeps. --- JR. Firth

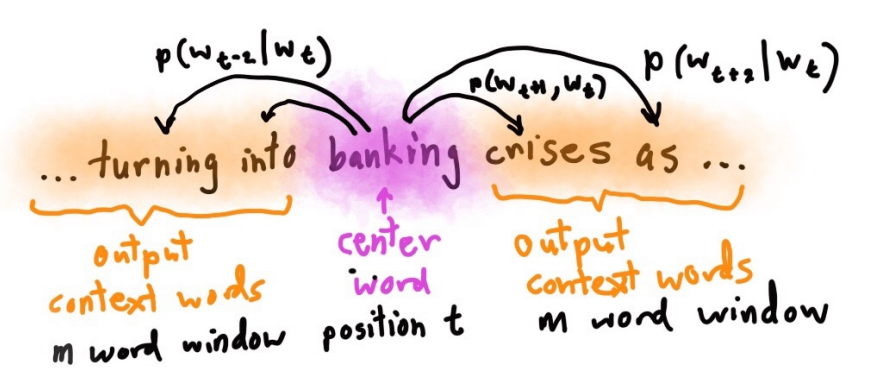
例如,下面用周围的单词去表达banking :

government debt problems turning into banking crises as has happened in ​ saying that Europe needs unified banking regulation to replace the hodgepodge

稠密词向量

一个单词的意义应该是由它本身的词向量来决定的。这个词向量可以预测出的上下文单词。

比如lingustics的词向量是[0.286,0.792,−0.177,−0.107,0.109,−0.542,0.349]

词嵌入思想 ​

构建一个模型,根据中心单词wt,通过自身词向量,去预测出它的上下文单词。

p(context∣wt)=⋯

损失函数如下,w−t表示wt的上下文(负号通常表示除了某某之外),如果完美预测,损失函数为0。

J=1−p(w−t∣wt)

Word2Vec ​

在每个单词和其上下文之间进行预测。

有两种算法:

  • Skip-grams(SG): 给目标单词,预测上下文
  • Continuous Bag of Words(CBOW):给上下文,预测目标单词

两个稍微高效的训练方法:

  • 分层softmax
  • 负采样

课上只是Naive softmax。两个模型,两种方法,一共有4种实现。这里是word2vec详细信息。

Skip-gram ​

对于每个单词wt,会选择一个上下文窗口m。 然后要预测出范围内的上下文单词,使概率P(wt+i∣wt)最大。

目标函数

θ是我们要训练的参数,目标函数就是所有位置预测结果的乘积,最大化目标函数:

J′(θ)=∏t=1T∏−m≤j≤mp(wt+j∣wt;θ),t≠j

一般使用negative log likelihood :负采样教程。

要最大化目标函数,就得得到损失函数。对于对数似然函数,取其负对数就可以得到损失函数,再最小化损失函数,其中T是文本长度,m是窗口大小:

J(θ)=−1T∑t=1T∑−m≤j≤mlog⁡P(wt+j∣wt)
  • Loss 函数 = Cost 函数 = Objective 函数
  • 对于softmax概率分布,一般使用交叉熵作为损失函数
  • 单词wt+j是one-hot编码
  • negative log probability

Word2vec细节 ​

词汇和词向量符号说明:

  • u 上下文词向量,向量是d维的
  • v 词向量
  • 中心词汇t,对应的向量是vt
  • 上下文词汇j ,对应的词向量是uj
  • 一共有V个词汇

计算p(wt+j∣wt), 即:

p(wj∣wt)=softmax(ujT⋅vt)=exp⁡(ujT⋅vt)∑i=1Vexp⁡(uiT⋅vt)

两个单词越相似,点积越大,向量点积如下:

uT⋅v=∑i=1Mui×vi

softmax之所以叫softmax,是因为指数会让大的数越大,小的数越小。类似于max函数。下面是计算的详细信息:
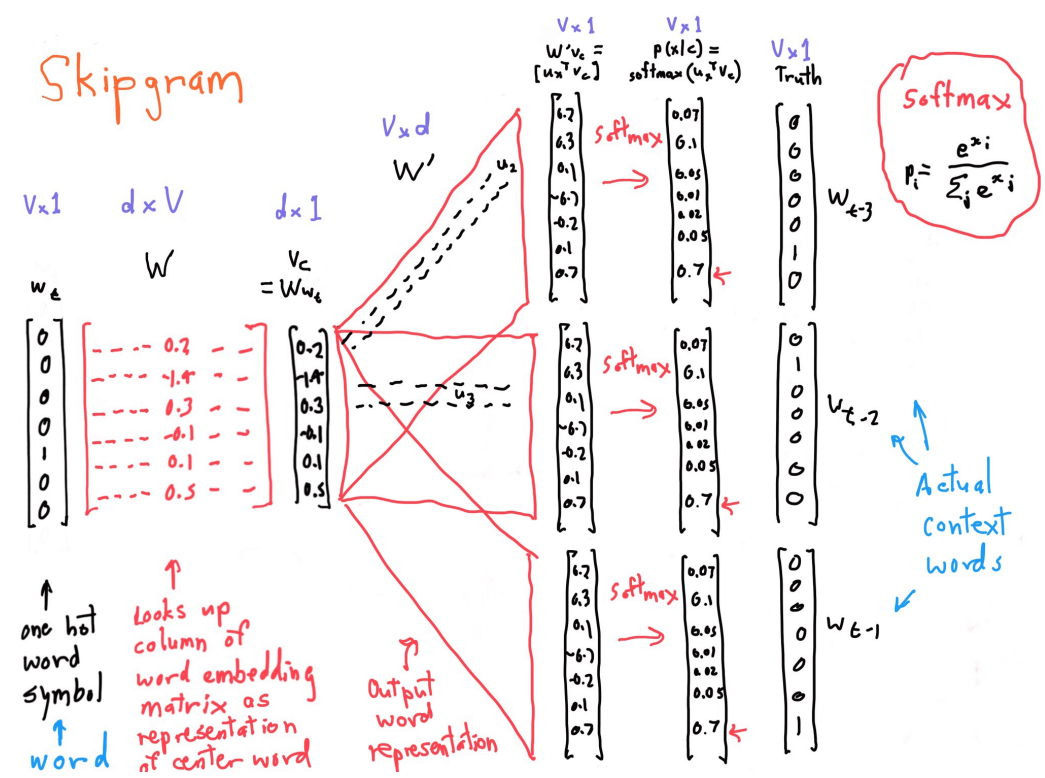
一些理解和解释:

  • wt是one-hot编码的中心词汇,维数是(V,1)
  • W是词汇表达矩阵,维数是(d,V),一列就是一个单词
  • Wwt=vt 相乘得到词向量vt ,(d,V)⋅(V,1)→(d,1), 用d维向量去表达了词汇t
  • W′, W′⋅vt=s,(V,d)⋅(d,1)→(V,1) , 得到 语义相似度向量s
  • 再对s进行softmax即可求得上下文词汇
  • 每个单词有两个向量,作为center单词向量和context单词向量

偏导计算 ​

设o是上下文单词,c是中心单词,条件概率如下:

P(o∣c)=exp⁡(uoT⋅vc)∑i=1Vexp⁡(uiT⋅vc)

这里只计算log⁡P对vc向量的偏导。

用θ向量表示所有的参数,有V个单词,d维向量。每个单词有2个向量。参数个数一共是2dV个。

向量偏导计算公式,x,a 均是向量

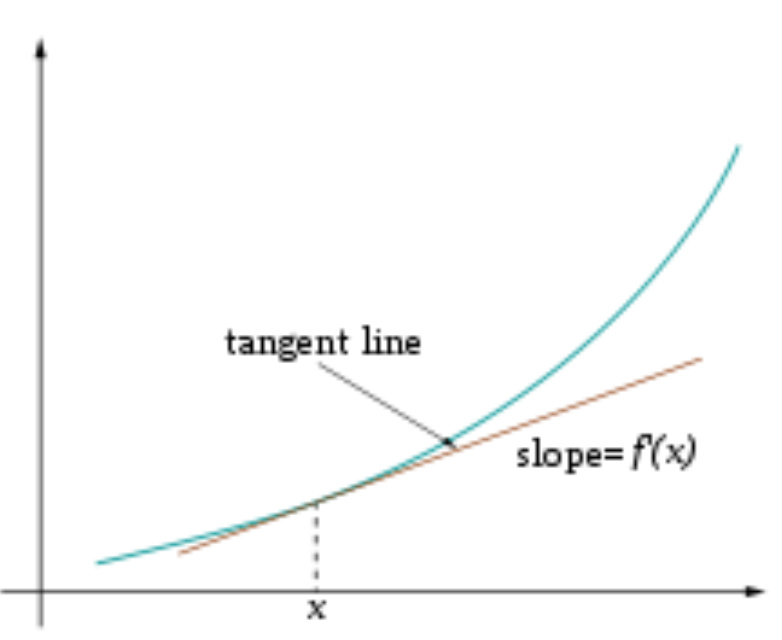
∂xTa∂x=∂aTx∂x=a

函数偏导计算,链式法则,y=f(u),u=g(x)

dydx=dydududx

最小化损失函数:

J(θ)=−1T∑t=1T∑−m≤j≤mlog⁡P(wt+j∣wt),j≠m

这里只计算vc的偏导,先进行分解原式为2个部分:

∂∂vclog⁡P(o∣c)=∂∂vclog⁡exp⁡(uoT⋅vc)∑i=1Vexp⁡(uiT⋅vc)=∂∂vclog⁡exp⁡(uoT⋅vc)⏟1−∂∂vclog⁡∑i=1Vexp⁡(uiT⋅vc)⏟2

部分1推导

∂∂vclog⁡exp⁡(uoT⋅vc)=∂∂vcuoT⋅vc=uo

部分2推导

∂∂vclog⁡∑i=1Vexp⁡(uiT⋅vc)=1∑i=1Vexp⁡(uiT⋅vc)⋅∂∂vc∑x=1Vexp⁡(uxT⋅vc)=1A⋅∑x=1V∂∂vcexp⁡(uxT⋅vc)=1A⋅∑x=1Vexp⁡(uxT⋅vc)∂∂vcuxT⋅vc=1∑i=1Vexp⁡(uiT⋅vc)⋅∑x=1Vexp⁡(uxT⋅vc)ux=∑x=1Vexp⁡(uxT⋅vc)∑i=1Vexp⁡(uiT⋅vc)⋅ux=∑x=1VP(x∣c)⋅ux

所以,综合起来可以求得,单词o是单词c的上下文概率log⁡P(o∣c) 对center向量vc的偏导:

∂∂vclog⁡P(o∣c)=uo−∑x=1VP(x∣c)⋅ux=观察到的−期望的

实际上偏导是,单词o的上下文词向量,减去,所有单词x的上下文向量乘以x作为c的上下文向量的概率。

总体梯度计算 ​

在一个window里面,对中间词汇vc求了梯度, 然后再对各个上下文词汇uo求梯度。 然后更新这个window里面用到的参数。

比如句子We like learning NLP。设m=1:

  • 中间词汇求梯度 vlike
  • 上下文词汇求梯度 uwe 和 ulearning
  • 更新参数

梯度下降 ​

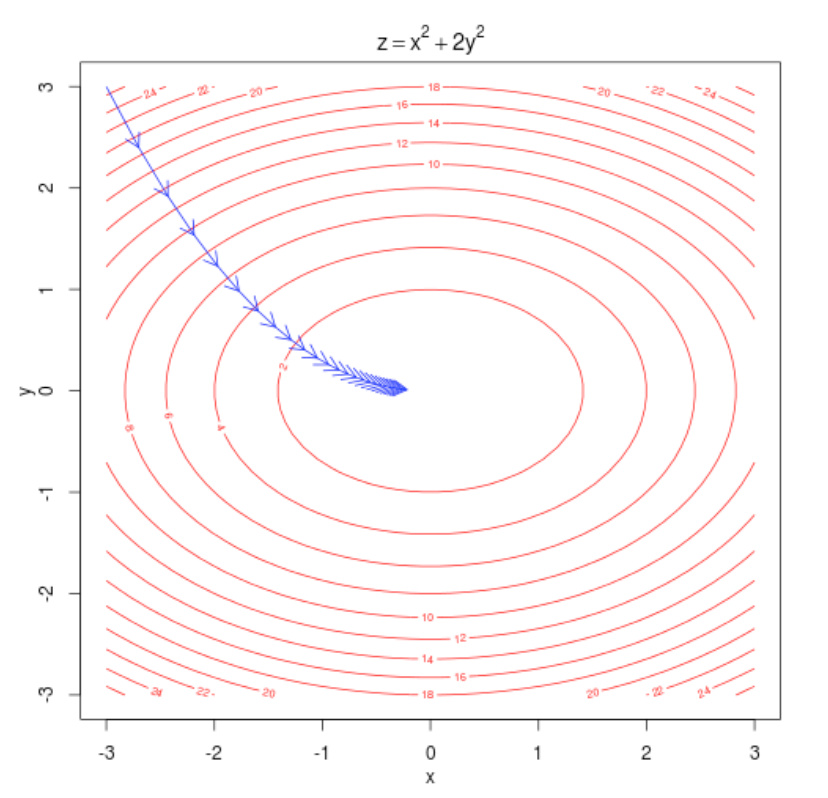
有了梯度之后,参数减去梯度,就可以朝着最小的方向走了。机器学习梯度下降

θnew=θold−α∂∂θoldJ(θ),θnew=θold−αΔθJ(θ)

随机梯度下降

预料会有很多个window,因此每次不能更新所有的。只更新每个window的,对于window t:
θnew=θold−αΔθJt(θ)
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026