Skip to content

Word2vec之数学模型

📅 发表于 2017/11/02
🔄 更新于 2025/07/23
👁️ — 次访问
📝 2336 字
⏳ 8 分钟
自然语言处理
#word2vec
#自然语言处理

Word2vec有两种模型:CBOW和Skip-gram,有两种训练方法:Hierarchical Softmax和Negative Sampling。偏数学公式推导

背景介绍 ​

符号 ​

  • C :语料Corpus,所有的文本内容,包含重复的词。
  • D:词典,D是从C中取出来的,不重复。
  • w:一个词语
  • m:窗口大小,词语w的前后m个词语
  • Context(w)=Cw: 词w的上下文词汇,取决于m
  • v(w): 词典D中单词w的词向量
  • k:词向量的长度
  • iw:词语w在词典D中的下标
  • NEG(w) : 词w的负样本子集

常用公式:

log⁡(anbm)=log⁡an+log⁡bm=nlog⁡a+mlog⁡blog⁡∏i=1aib1−i=∑i=1log⁡ai+log⁡b1−i=∑i=1i⋅log⁡a+(i−1)⋅log⁡b

目标函数 ​

n-gram模型。当然,我们使用神经概率语言模型。

P(w∣Cw) 表示上下文词汇推出中心单词w的概率。

对于统计语言模型来说,一般利用最大似然,把目标函数设为:

∏w∈Cp(w∣Cw)

一般使用最大对数似然,则目标函数为:

L=∑w∈Clog⁡p(w∣Cw)

其实概率P(w∣Cw)是关于w和Cw的函数,其中θ是待定参数集,就是要求最优 θ∗,来确定函数F:

p(w∣Cw)=F(w,Cw;θ)

有了函数F以后,就能够直接算出所需要的概率。 而F的构造,就是通过神经网络去实现的。

神经概率语言模型 ​

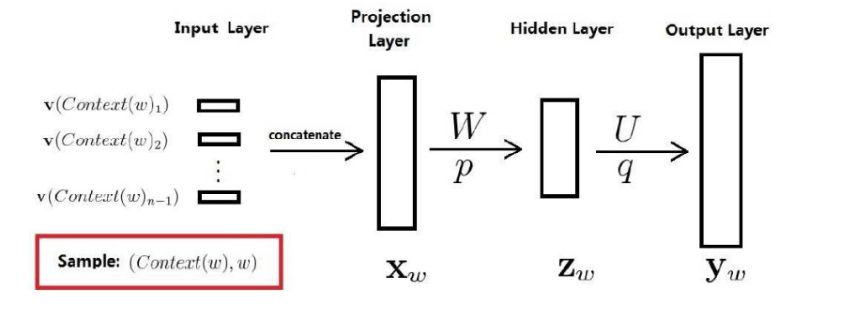
一个二元对(Cw,w)就是一个训练样本。神经网络结构如下,W,U是权值矩阵,p,q是对应的偏置。

但是一般会减少一层,如下图:(其实是去掉了隐藏层,保留了投影层,是一样的)
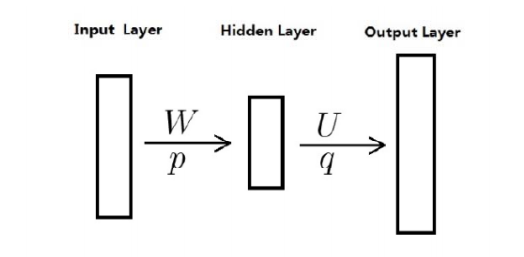
窗口大小是m,Context(w)包含2m个词汇,词向量长度是k。可以做拼接或者求和(下文是)。拼接得到长向量2mk, 在投影层得到xw,然后给到隐藏层和输出层进行计算。

zw=tanh(Wzw+p)→yw=Uzw+q

再对yw=(y1,y2,⋯,yK) 向量进行softmax即可得到所求得中心词汇的概率:

p(w∣Cw)=eyiw∑i=1Keyi

优点

  • 词语的相似性可以通过词向量来体现
  • 自带平滑功能。N-Gram需要自己进行平滑。

词向量的理解 ​

有两种词向量,一种是one-hot representation,另一种是Distributed Representation。one-hot太长了,所以DR中把词映射成为相对短的向量。不再是只有1个1(孤注一掷),而是向量分布于每一维中(风险平摊)。再利用欧式距离就可以算出词向量之间的相似度。

传统可以通过LSA(Latent Semantic Analysis)和LDA(Latent Dirichlet Allocation)来获得词向量,现在也可以用神经网络算法来获得。

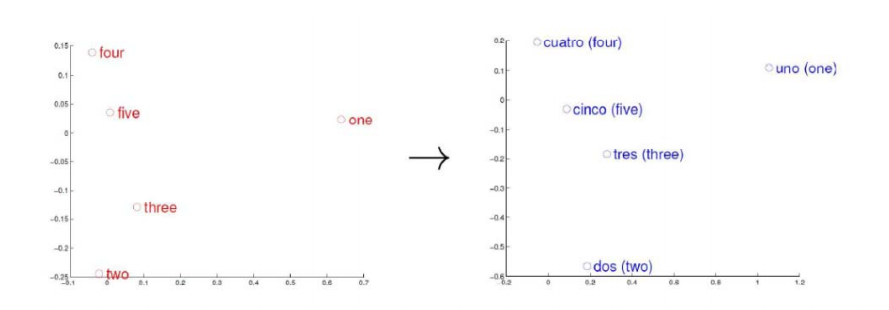
可以把一个词向量空间向另一个词向量空间进行映射,就可以实现翻译。
Hierarchical Softmax ​

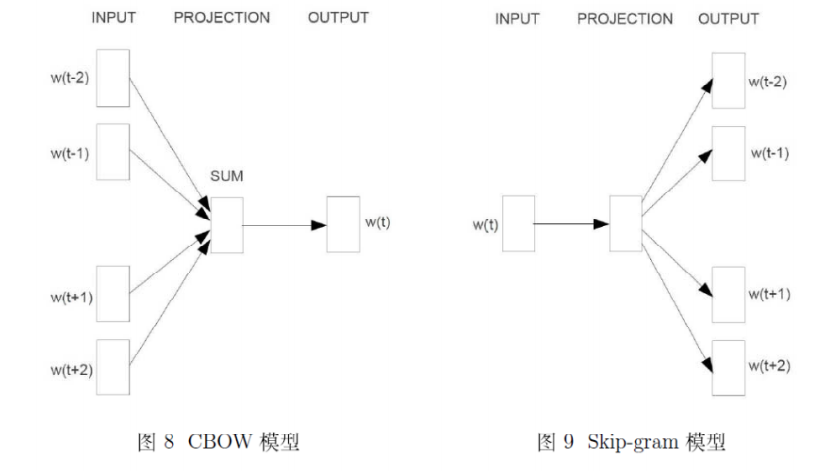
两种模型都是基于下面三层模式(无隐藏层),输入层、投影层和输出层。没有hidden的原因是据说是因为计算太多了。

CBOW和Skip-gram模型:
CBOW模型 ​

一共有|C|个单词。CBOW是基于上下文context(w)=cw去预测目标单词w,求条件概率p(w∣cw),语言模型一般取目标函数为对数似然函数:

L=∑w∈Clog⁡p(w∣cw)

窗口大小设为m,则cw是w的前后m个单词。

输入层 是上下文单词的词向量。(初始随机,训练过程中逐渐更新)

投影层 就是对上下文词向量进行求和,向量加法。得到单词w的所有上下文词cw的词向量的和xw,待会儿参数更新的时候再依次更新回来。

输出层 从C中选择一个词语,实际上是多分类。这里是哈夫曼树层次softmax。

因为词语太多,用softmax太慢了。多分类实际上是多个二分类组成的,比如SVM二叉树分类:
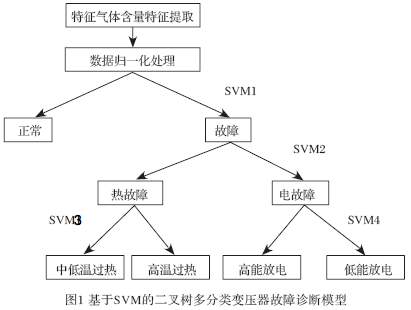
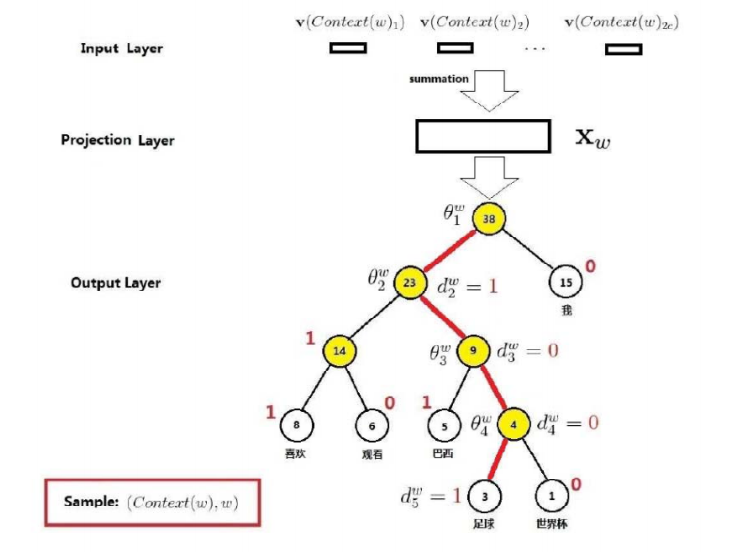
这是一种二叉树结构,应用到word2vec中,被称为Hierarchical Softmax。CBOW完整结构如下:
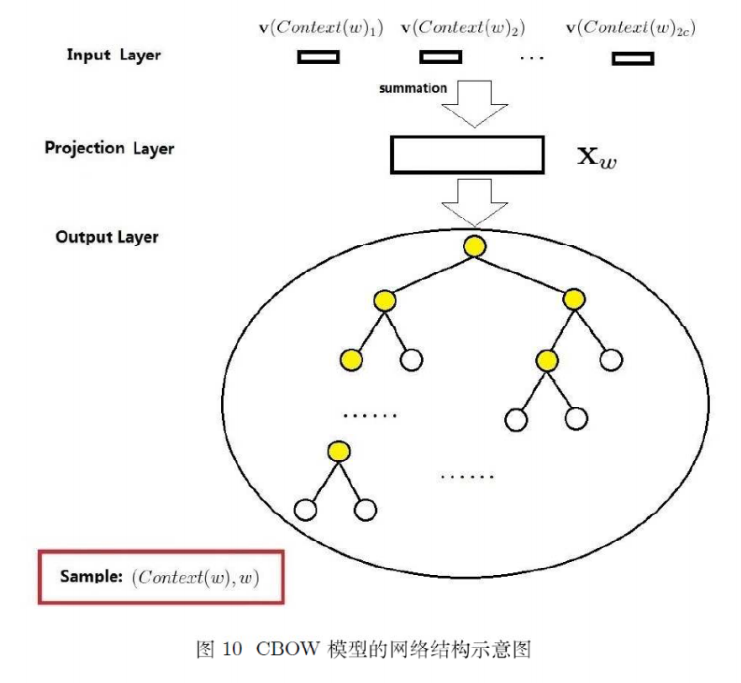
每个叶子节点代表一个词语w,每个词语被01唯一编码。

哈夫曼编码 ​

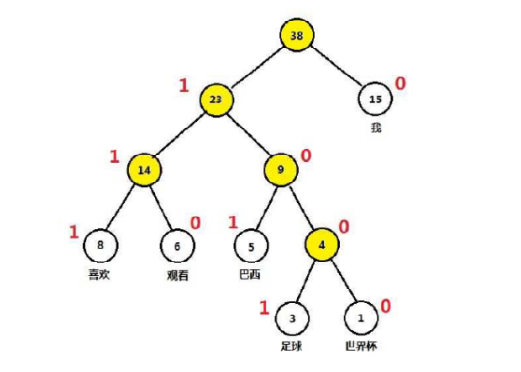
哈夫曼树很简单。每次从许多节点中,选择权值最小的两个合并,根节点为合并值;依次循环,直到只剩一棵树。

比如“我 喜欢 看 巴西 足球 世界杯”,这6个词语,出现的次数依次是15, 8, 6, 5, 3, 1。建立得到哈夫曼树,并且得到哈夫曼编码,如下:
CBOW足球例子 ​

引入一些符号:

  • pw :从根节点到达w叶子节点的路径
  • lw : 路径pw中节点的个数
  • p1w,⋯,plww :依次代表路径中的节点,根节点-中间节点-叶子节点
  • d2w,⋯,dlww∈{0,1}:词w的哈夫曼编码,由lw−1位构成, 根节点无需编码
  • θ1w,⋯,θlw−1w:路径中非叶子节点对应的向量, 用于辅助计算。
  • 单词w是足球,对应的所有上下文词汇是cw, 上下文词向量的和是xw

看一个例子:

约定编码为1是负类,为0是正类。即左边是负类,右边是正类。

每一个节点就是一个二分类器,是逻辑回归(sigmoid)。其中θ是对应的非叶子节点的向量,一个节点被分为正类和负类的概率分别如下:

σ(xwTθ)=11+e−xwTθ,1−σ(xwTθ)

那么从根节点到达足球的概率是:

p(足球∣c足球)=∏j=25p(djw∣xw,θj−1w)

CBOW总结 ​

目标函数

从根节点到每一个单词w都存在一条路径pw,路径上有lw−1个分支节点,每个节点就是一个二分类,每次产生一个概率 p(djw∣xw,θj−1w), 把这些概率乘起来就得到了p(w∣cw)。

其中每个节点的概率是,与各个节点的参数和传入的上下文向量和xw相关。

p(djw∣xw,θj−1w)={σ(xwTθj−1w),djw=01−σ(xwTθj−1w),djw=1

写成指数形式是

p(djw∣xw,θj−1w)=[σ(xwTθj−1w)]1−djw⋅[1−σ(xwTθj−1w)]djw

则上下文推中间单词的概率,即目标函数:

p(w∣cw)=∏j=2lwp(djw∣xw,θj−1w)

对数似然函数

对目标函数取对数似然函数是:

L=∑w∈Clog⁡p(w∣cw)=∑w∈Clog⁡∏j=2lw[σ(xwTθj−1w)]1−djw⋅[1−σ(xwTθj−1w)]djw=∑w∈C∑j=2lw((1−djw)⋅log⁡σ(xwTθj−1w)+djw⋅log⁡(1−σ(xwTθj−1w)))=∑w∈C∑j=2lw((1−djw)⋅log⁡A+djw⋅log⁡(1−A)))

简写:

L(w,j)=(1−djw)⋅log⁡σ(xwTθj−1w)+djw⋅log⁡(1−σ(xwTθj−1w))L=∑w,jL(w,j)

怎样最大化对数似然函数呢,可以最大化每一项,或者使整体最大化。尽管最大化每一项不一定使整体最大化,但是这里还是使用最大化每一项L(w,j)。

sigmoid函数的求导:

σ′(x)=σ(x)(1−σ(x))

L(w,j)有两个参数:输入层的xw 和 每个节点的参数向量θj−1w 。 分别求偏导并且进行更新参数:

∂θj−1wL(w,j)=[1−djw−σ(xwTθj−1w)]⋅xw→θj−1w=θj−1w+α⋅∂θj−1wL(w,j)∂xwL(w,j)=[1−djw−σ(xwTθj−1w)]⋅θj−1w→v(w^)+=v(w^)+α⋅∑j=2lw∂xwL(w,j),w^∈cw

注意:xw是所有上下文词向量的和,应该把它的更新平均更新到每个上下文词汇中去。w^ 代表cw中的一个词汇。

Skip-Gram模型 ​

Skip-gram模型是根据当前词语,预测上下文。网络结构依然是输入层、投影层(其实无用)、输出层。如下:
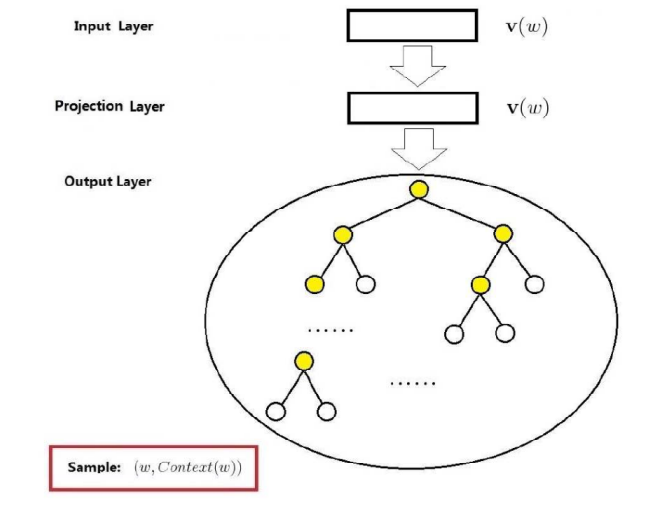
输入一个中心单词的词向量v(w),简记为vw,输出是一个哈夫曼树。单词u是w的上下文单词cw中的一个。这是一个词袋模型,每个u是互相独立的。

目标函数

所以cw是w的上下文词汇的概率是:

p(cw∣w)=∏u∈cwp(u∣w)

与上面同理,p(u∣w) 与传入的中心单词向量v(w)和路径上的各个节点相关:

p(u∣w)=∏j=2lwp(dju∣vw,θj−1u)p(dju∣vw,θj−1u)=[σ(vwTθj−1u)]1−dju⋅[1−σ(vwTθj−1u)]dju

下文vwTθj−1w简记为vwθj−1w,要记得转置向量相乘就可以了。

对数似然函数

L=∑w∈Clog⁡p(cw∣w)=∑w∈Clog⁡∏u∈cw∏j=2lw[σ(vwTθj−1u)]1−dju⋅[1−σ(vwTθj−1u)]dju=∑w∈C∑u∈cw∑j=2lw((1−dju)⋅log⁡σ(vwTθj−1u)+dju⋅log⁡(1−σ(vwTθj−1u)))

同样,简写每一项为L(w,u,j)

L(w,u,j)=(1−dju)⋅log⁡σ(vwTθj−1u)+dju⋅log⁡(1−σ(vwTθj−1u))

然后就是,分别对vw和θj−1u求梯度更新即可,同上面的类似。得到下面的更新公式

θj−1u=θj−1u+α⋅[1−dju−σ(vwt⋅θj−1u)]⋅v(w)vw=vw+α⋅∑u∈cw∑j=2lw∂L(w,u,j)∂vw

Negative Sampling ​

背景知识介绍 ​

Negative Sampling简称NEG,是Noise Contrastive Estimation(NCE)的一个简化版本,目的是用来提高训练速度和改善所得词向量的质量。

NEG不使用复杂的哈夫曼树,而是使用随机负采样,大幅度提高性能,是Hierarchical Softmax的一个替代。

NCE 细节有点复杂,本质上是利用已知的概率密度函数来估计未知的概率密度函数。简单来说,如果已知概率密度X,未知Y,如果知道X和Y的关系,Y也就求出来了。

在训练的时候,需要给正例和负例。Hierarchical Softmax是把负例放在二叉树的根节点上,而NEG,是随机挑选一些负例。

CBOW ​

对于一个单词w,输入上下文Context(w)=Cw,输出单词w。那么词w是正样本**,**其他词都是负样本。 负样本很多,该怎么选择呢?后面再说。

定义Context(w)的负样本子集NEG(w)。对于样本(Cw,w),xw依然是Cw的词向量之和。θu为词u的一个(辅助)向量,待训练参数。

设集合Sw=w⋃NEG(w) ,对所有的单词u∈Sw,有标签函数:

bw(u)={1,u=w0,u≠w

单词u是Cw 的中心词的概率是:

p(u∣Cw)={σ(xwTθu),u=w正样本1−σ(xwTθu),u≠w负样本

简写为:

p(u∣Cw)=[σ(xwTθu)]bw(u)⋅[1−σ(xwTθu)]1−bw(u)

要最大化目标函数g(w)=∑u∈Swp(u∣Cw):

g(w)=∏u∈Sw[σ(xwTθu)]bw(u)⋅[1−σ(xwTθu)]1−bw(u)=σ(xwTθu)∏u∈NEG(w)(1−σ(xwTθu))

观察g(w)可知,最大化就是要:增大正样本概率和减小化负样本概率。

每个词都是这样,对于整个语料库的所有词汇,将g累计得到优化目标,目标函数如下:

L=log⁡∏w∈Cg(w)=∑w∈Clog⁡g(w)=∑w∈Clog⁡(∏u∈Sw[σ(xwTθu)]bw(u)⋅[1−σ(xwTθu)]1−bw(u))=∑w∈C∑u∈Sw[buw⋅σ(xwTθu)+(1−buw)⋅(1−σ(xwTθu))]

简写每一步L(w,u):

L(w,u)=buw⋅σ(xwTθu)+(1−buw)⋅(1−σ(xwTθu))

计算L(w,u)对θu和xw的梯度进行更新,得到梯度(对称性):

∂L(w,u)∂θu=[bw(u)−σ(xwTθu)]⋅xw,∂L(w,u)∂xw=[bw(u)−σ(xwTθu)]⋅θu

更新每个单词的训练参数θu :

θu=θu+α⋅∂L(w,u)∂θu

对每个单词更新词向量v(u) :

v(u)=v(u)+α⋅∑u∈Sw∂L(w,u)∂xw

Skip-gram ​

H给单词w,预测上下文向量Context(w)=Cw。 输入样本(w,Cw)。

中心单词是w,遍历样本中的上下文单词wo∈Cw,为每个上下文单词wo生成一个包含负采样的集合So=w⋃NEG(o) 。即So里面只有w才是o的中心单词。

下面wo简写为o,要注意实际上是当前中心单词w的上下文单词。

So中的u是实际的w就为1,否则为0。标签函数如下:

bw(u)={1,u=w0,u≠w

So​中的u​是o​的中心词的概率是

p(u∣o)={σ(voTθu),u=w↔bw(u)=11−σ(voTθu),u≠w↔bw(u)=0

简写为

p(u∣o)=[σ(voTθu)]bw(u)⋅[1−σ(voTθu)]1−bw(u)

对于w的一个上下文单词o来说,要最大化这个概率:

∏u∈Sop(u∣o)

对于w的所有上下文单词Cw来说,要最大化:

g(w)=∏o∈Cw∏u∈Sop(u∣o)

那么,对于整个预料,要最大化:

G=∏w∈Cg(w)=∏w∈C∏o∈Cw∏u∈Sop(u∣o)

对G取对数,最终的目标函数就是:

L=log⁡G=∑w∈C∑o∈Cwlog⁡∏u∈Sop(u∣o)=∑w∈C∑o∈Cwlog⁡∏u∈So[σ(voTθu)]bw(u)⋅[1−σ(voTθu)]1−bw(u)=∑w∈C∑o∈Cw∑u∈So(buw⋅σ(voTθu)+(1−buw)⋅(1−σ(voTθu)))

取w,o,u简写L(w, o, u):

L(w,o,u)=buw⋅σ(voTθu)+(1−buw)⋅(1−σ(voTθu))

分别对θu、vo求梯度

∂L(w,o,u)∂θu=[buw−σ(voTθu)]⋅vo,∂L(w,o,u)∂vo=[buw−σ(voTθu)]⋅θu

更新每个单词的训练参数θu :

θu=θu+α⋅∂L(w,o,u)∂θu

对每个单词更新词向量v(o) :

v(o)=v(o)+α⋅∑u∈So∂L(w,u)∂vo
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026