Skip to content

Word2vec之总体介绍

📅 发表于 2017/11/12
🔄 更新于 2025/07/23
👁️ — 次访问
📝 1081 字
⏳ 4 分钟
自然语言处理
#word2vec
#cbow
#skip-gram
#负采样

cs224n笔记,word2vec总体介绍,包括CBOW和Skip-gram,负采样训练

Word2vec ​

简介 ​

把词汇变成词向量。

类别1类别2
算法CBOW,上下文预测中心词汇Skip-gram,中心词汇预测上下文
训练方法负采样哈夫曼树

语言模型 ​

两种句子:

  • 正常的句子:The cat jumped over the puddle。 概率高,有意义。
  • 没意义的句子:stock boil fish is toy 。概率低,没意义。

二元模型

一个句子,有n个单词。每个词出现的概率由上一个词语来决定。则整体句子的概率如下表示:

P(w1,w2,⋯,wn)=∏i=2nP(wi∣wi−1)

缺点

  • 只考虑单词相邻传递概率,而忽略句子整体的可能性。
  • context size=1,只学了相邻单词对的概率
  • 会计算整个大数据集的全局信息

CBOW ​

给上下文The cat _ over the puddle ,预测jump 。对于每个单词,学习两个向量:

  • v :输入向量 ,(上下文单词)
  • u: 输出向量 , (中心单词)

符号说明 ​

  • V :词汇表,后面用V代替词汇表单词个数
  • wi :词汇表中第i个单词
  • d :向量的维数
  • Vd×|V|:输入矩阵,也可以用W来表达
  • vi :V的第i列,wi的输入向量表达
  • U|V|×d :输出矩阵,可以用W′来表达
  • ui :U的第i行, wi的输出向量表达

输入与输出

  • x(c), 输入2m个上下文单词,上下文词汇的one-hot向量
  • yc: 真实标签
  • y^(c), 输出一个中心单词,中心词汇的one-hot向量

步骤 ​

1 上下文单词onehot向量

one-hot向量的表达:(x(c−m),⋯,x(c−1),x(c+1),x(c+m)∈RV)

2 上下文单词向量

(vc−m,vc−m+1,⋯.vc+m∈Rd), 其中,vc−m=Vx(c−m), 即输入矩阵乘以one-hot向量就找到所在的列

3 平均上下文词向量

v^=vc−m+⋯+vc+m2m∈Rd

4 输出单词与上下文计算得分向量

z=Uv^∈RV 。点积,单词越相似,得分越高

5 得分向量转为概率

$\hat y = \mathrm{softmax}(z) \in \mathbb R^V $

6 真实预测概率对比

预测的概率向量y^与唯一真实中心单词one-hot向量y,进行交叉熵比较算出loss。

目标函数 ​

使用交叉熵计算loss,损失函数如下:

H(y^,y)=−∑j=1|V|yjlog⁡(y^j)

由于中心单词y是one-hot编码,只有正确位置才为1,其余均为0,所以只需计算中心单词对应的位置概率的loss即可:

H(y^,y)=−yclog⁡(y^c)=−log⁡(y^c)

交叉熵很好是因为

  • −1⋅log⁡(1)=0,预测得好
  • −1⋅log⁡(0.01)=4.605​, 预测得不好

最终损失函数:

minimizeJ=−log⁡P(wc∣wc−m,…,wc−1,wc+1,…,wc+m)=−log⁡P(uc∣v^)=−log⁡exp⁡(ucTv^)∑j=1|V|exp⁡(ujTv^)=−ucTv^+log⁡∑j=1|V|exp⁡(ujTv^)

再使用SGD方法去更新相关的两种向量uc,vj 。

Skip-gram ​

给中心单词 jump,预测上下文The cat _ over the puddle 。

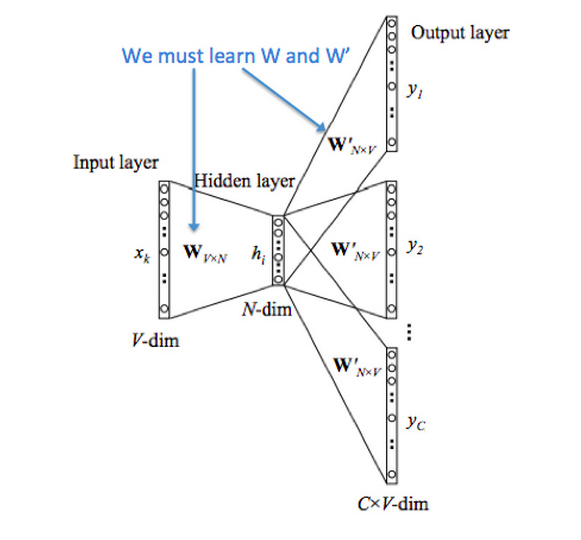
输入中心单词x, 输出上下文单词y 。与CBOW正好输入输出相反,但同样有两个矩阵U,V 。符号说明同CBOW。

步骤 ​

1 中心单词onehot向量

x∈R|V|

2 中心单词词向量

vc=Vx∈Rd

3 中心词与其他词的得分向量

z=Uvc∈R|V|

4 得分向量转为概率

概率 y^=softmax(z), y^c−m,…,y^c+m 是目标上下文单词是中心单词的上下文的预测概率。

5 预测真实概率对比

预测概率y^ 与2m 个真实上下文onehot向量yc−m,…,yc+m进行交叉熵对比,算出loss

目标函数 ​

与CBOW不同的是,Skip-gram做了一个朴素贝叶斯条件假设,所有的输出上下文单词都是独立的。

minimizeJ=−log⁡P(wc−m,…,wc−1,wc+1,…,wc+m∣wc)=−log⁡∏j=0,j≠m2mP(wc−m+j∣wc)=−log⁡∏j=0,j≠m2mexp⁡(uc−m+jT⋅vc)∑k=1|V|exp⁡(ukT⋅vc)=−∑j=0,j≠m2m(log⁡exp⁡(uc−m+jT⋅vc)−log⁡∑k=1|V|exp⁡(ukT⋅vc))=−∑j=0,j≠m2muc−m+jTvc+2m⋅log⁡∑k=1|V|exp⁡(ukT⋅vc)

一样,使用SGD去优化U和V。

损失函数实际上是2m个交叉熵求和,求出的向量y^与2m个onehot向量yc−m+j 计算交叉熵:

J=−∑j=0,j≠m2mlog⁡P(uc−m+j∣vc)=∑j=0,j≠m2mH(y^,yc−m+j)

负采样训练 ​

每次计算都会算整个|V|词表,太耗时了。 可以从噪声分布Pn(w)中进行负采样,来代替整个词表。当然单词采样概率与其词频相关。只需关心:目标函数、梯度、更新规则。

标签函数 ​

对于一对中心词和上下文单词(w,c) ,设标签如下:

  • P(l=1∣w,c), (w,c) 来自于真实语料
  • P(l=0∣w,c) ,(w,c)来自于负样本,即不在语料中

用sigmoid表示标签函数:

P(l=1∣w,c;θ)=σ(uwTvc)=11+e−uwTvcP(l=0∣w,c;θ)=1−σ(uwTvc)=11+euwTvc

目标函数 ​

选取合适的θ=U,V ,去增大正样本的概率,减小负样本的概率。设D为正样本集合,D¯为负样本集合。

θ=argmaxθ⁡∏(w,c)∈DP(l=1∣w,c,θ)∏(w,c)∈D¯P(l=0∣w,c,θ)=argmaxθ⁡∏(w,c)∈DP(l=1∣w,c,θ)∏(w,c)∈D¯(1−P(l=1∣w,c,θ))=argmaxθ⁡∑(w,c)∈Dlog⁡P(l=1∣w,c,θ)+∑(w,c)∈D¯log⁡(1−P(l=1∣w,c,θ))=argmaxθ⁡∑(w,c)∈Dlog⁡11+exp⁡(−uwTvc)+∑(w,c)∈D¯log⁡11+exp⁡(uwTvc)=argmaxθ⁡∑(w,c)∈Dlog⁡σ(uwTvc)+∑(w,c)∈D¯log⁡σ(−uwTvc)

最大化概率也就是最小化负对数似然

J=−∑(w,c)∈Dlog⁡σ(uwTvc)−∑(w,c)∈D¯log⁡σ(−uwTvc)

负采样集合选择 ​

为中心单词wc 从Pn(w) 采样K个假的上下文单词。表示为{u¯k∣k=1…K}

CBOW ​

给上下文向量v^=vc−m+⋯+vc+m2m 和真实中心词uc

原始loss

J=−ucTv^+log⁡∑j=1|V|exp⁡(ujTv^)

负采样loss

J=−log⁡σ(ucT⋅v^)−∑k=1Klog⁡σ(−u¯kT⋅v^)

Skip-gram ​

给中心单词vc, 和2m个真实上下文单词uc−m+j

原始loss

J=−∑j=0,j≠m2muc−m+jTvc+2m⋅log⁡∑k=1|V|exp⁡(ukT⋅vc)

负采样loss

J=−∑j=0,j≠m2mlog⁡σ(uc−m+jT⋅vc)−∑k=1Klog⁡σ(−u¯kT⋅vc)
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026