机器阅读(一)--整体概述
📅 发表于 2019/03/07
🔄 更新于 2025/07/23
👁️ — 次访问
📝 1781 字
⏳ 6 分钟
机器阅读
#机器阅读
#MRC发展历史
#MRC任务形式
#MRC数据集
#SQuAD
#RACE
#TriviaQA
#NarrativeQA
#HotpotQA
主要包含:机器阅读的起因和发展历史;MRC数学形式;MRC与QA的区别;MRC的常见数据集和关键模型
1) 词性分析 part-of-speech tagging :判断词性
2) 命名实体识别 named entity recognition 识别实体
3) 句法依存 sytactic parsing 找到词间关系、语法结构信息
4) 指代消解 coreference resolution
让机器理解人类语言是AI领域长期存在的问题
阅读理解能综合评估各项NLP任务,是一个综合性任务
阅读理解探索更加深层次的理解
回答问题是检测机器是否读懂文章最好的办法
1. QUALM系统 Lehnert,1977年
2. 早期数据集 Hirschman,1999年
3. Deep Read系统 Hirschman,1999年
rule-based bag-of-words,基于规则的词袋模型4. QUARC系统 Riloff and Thelen,2000年
还有3和4的结合(Charniak,2000年),准确率在30%-40%左右。
1. 三元组
(文章,问题,答案)
2. 两个数据集
MCTest:四选一;660篇科幻小说
ProcessBank:二分类;585问题,200个段落;生物类型文章;需要理解实体关系和事件
3. 传统规则方法
不使用训练数据集
1)启发式的滑动窗口方法
计算word overlap、distance information
2)文本蕴含方法
用现有的文本蕴含系统,把(问题,答案)对转化为一个statement。
3)max-margin 学习框架,使用了很多语言特征:
句法依存、semantic frames、 指代消解、 discourse relation和 词向量等特征。
4. 机器学习方法
机器学习方法比规则方法好,但是任然有很多不足:
1)依赖于现有语言特征工具
2)很难模拟人类阅读,难以构建有效特征
3)标记数据太少,难以训练出效果好的统计模型
深度学习火热于2015年,DeepMind的Hermann大佬提出了一种新型低成本构建大规模监督数据的方法,同时提出了attention-based LSTM。
神经网络效果较好,能更好地在词/句子上做match。
1) CNN/Daily-Mail数据集
2) SQuAD数据集
3) 深度学习的优点
阅读理解任务看作是一种监督学习任务,目的是学习一种映射关系:
根据答案类型,分为如下四种形式的机器阅读任务。
预测一个词汇,一般平均3.5个词汇长度。准确率评估。
从k个答案中选择一个,一般是一个词、一个短语和一个答案。准确率评估。
抽取式问答,预测答案在文章中start和end位置。
Exact Match 评估:准确率。测试集会有多个正确答案,EM匹配一个就好。
F1 score评估:句子单词之间的overlap,忽略字符和a an the。计算最优的F1。
自然语言回答,没有固定的形式free-form answer。没有明确统一的评估指标。有如下几个:
机器阅读理解是Question Answering的一个特例。
1) 相同点:问题形式、解决方法和评估方法
2) 不同点
问答系统在于:
机器阅读在于:
机器阅读的发展原因:大规模数据和端到端神经网络模型的出现。
数据集促进了模型,模型又进一步促进了数据集的发展。
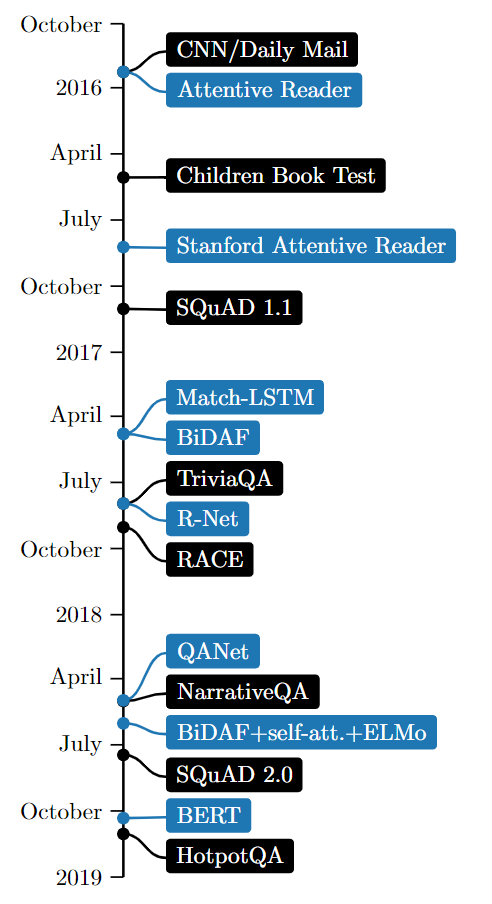
完型填空,名词
四选一,MCTest论文
span预测。SQuAD1.1有如下缺点:
优点:解决了SQuAD问题依赖于文章的问题缺点:不能保证文章一定包含该问题,这影响训练数据质量free-form答案形式。NarrativeQA和数据集论文
Span预测。加入no-answer。SQuAD 2.0和数据集论文
113k问答数据,可解释的多步推理问答。HotpotQA和数据集论文
supporting fact,系统能利用强大的监督知识去推理回答,并对结果作出解释