Skip to content

SWE 训练方法 系列

📅 发表于 2025/01/02
🔄 更新于 2026/08/05
👁️ — 次访问
📝 11759 字
⏳ 39 分钟
swe
#Self-play SWE-RL
#写Bug修Bug自我博弈JointRL
#SKyRL-Agent
#AST工具增强
#增加环境提示信息
#留一法估计优势
#InfoCode
#对抗生成代码和测试
#Kimi-Dev
#Agentless训练
#SWE-Agent适配
#MidTrain
#CodeEditRL
#SWE-Swiss
#3任务SFT
#2阶段课程RL
#NEBIUS-SWE
#Mask错误动作SFT
#DeepSWE
#GRPO++
#Devstral2
#Devstral
#SWE-RL
#Patch相似度奖励信号
#SWE-Agent
#ACI
#Agent-Computer-Interface
(2512) Self-Play SWE-RL (51.4分, Meta) ​

🌺 论文摘要

Self-Play SWE-RL 摘要

参考链接

核心方法

  • Self-Play SWE-RL框架
    • 给定仓库+环境,通过写Bug+修Bug 自我博弈联合RL训练。无需人工Issue
  • 仓库数据:未知
  • CWM scaffold:bash + search-replace 编辑器

模型效果(CWM-32B-sft)

  • 在SWE-V和SWE-Pro上,SSR方法都超过RL+人类Issue训练的模型,但也没高多少。
  • SWE-V达51.4分,SWE-P达28.9分。

重要结论

  • Self-Play RL比Repair/Injection-Only RL 性能更好,Inject-Only 效果最差。
  • 大幅删除代码的Bug更好比仅改一行代码的Bug的好。后者太简单,学习信号弱。
  • 由于共享1个Policy,Solver解决率信号 对训练效果影响不大。

关键贡献

  • Self-Play SWE-RL 思想,很有启发意义的工作。

问题背景 ​

❓问题背景

合成数据是静态的 ​

问题背景

RL 受限于人类天花板

  • 训练数据和环境 依赖人工:Issue、PR、环境、单元测试等。
  • 人类数据噪音多,不可靠,难扩展。
  • 导致RL本质:模仿和优化 人类写代码的过程。

当前合成数据存在局限性

  • 思想:LLM合成Bug,再去蒸馏数据。

  • 缺点:

    • 依赖人类:测试套件、解析器等。
    • 依赖TeacherModel:LLM去操作、LLM去蒸馏数据。
    • 扩展受限。
    • Bug是静态合成的:模型进化,但Bug却无法进化,导致系统无法持续自我改进。
  • 代表工作:SWE-smith/BugPilot.

Self-Play结合真实动态仓库 ​

Self-Play + 真实动态Repo

Self-Play

Zero Self-Play

  • 代表工作:
    • Absolute Zero:训单个推理模型。
      • 只和Python解释器交互,只能学到Python细节,无法学到真实知识经验。
    • R-Zero:共同进化挑战者和求解者。
    • LSP:自我博弈。
  • 缺点:无法获得 超出固定环境和模型现有储备之外的新知识。

想法

  • 基于真实动态Repo,Agent和代码环境交互来学习,不依赖人类训练数据。
  • Self-Play + 真实世界仓库

Self-Play SWE-RL ​

📕核心方法

核心思想 ​

Self-Play SWE-RL

核心思想

  • 沙盒环境 + 代码仓库 + 工具集(来自CWM, Bash+Editor)
    • 无需:单元测试、Issue描述、执行测试命令、特定语言先验知识等。
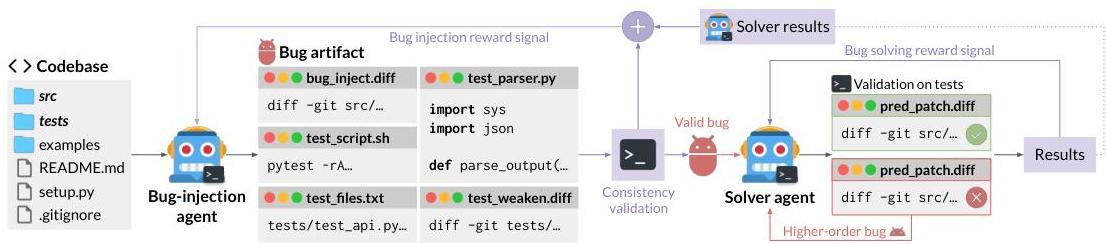
  • 1个LLM,2个角色(不同prompt),Injector-造Bug,Solver-修复Bug
  • 通过造Bug+修Bug,迭代式循环提升,共同对抗式-RL训练

优点

  • 通过self-play,模型生成多样化+有挑战+不断进化的课程。
  • 静态bug无法比拟。

高阶Bug

  • Solver失败的尝试,作为高阶Bug
  • 类似真实开发中多步骤、相互依赖的修改。

生成Bug(Injector) ​

Bug 套件

Bug本身

  • bug_inject.diff:向代码注入Bug

隐蔽手段

  • test_weaken.diff:移除或削弱测试,隐藏Bug。

防作弊手段

  • test_files.txt:测试文件列表,避免AI直接修改测试文件,每次测试时直接恢复。

验证工具

  • test_scripts.sh:运行测试套件,检测错误、验证修复
  • test_parser.py:解析测试输出结果,每个测试ID映射到结果。
Bug Injector Agent

目标

  • 探索仓库,生成高质量、适配Solver的Bug,并给到Bug Solver。

Bug制造策略

  • 代码移除
    • 删掉某个文件、删掉大段核心逻辑
    • 迫使Solver重写代码,功能开发。
  • 历史回滚
    • AI 去翻阅历史Git Log,找到以前的修改,撤销,重新引入旧 Bug
    • 利用人类程序员的历史智慧。
  • 高阶Bug
    • Injector制造Bug,Solver失败的解法,这个烂代码就变成新Bug 题目。
    • 优点:非常真实(人类就这样的),多样性好、覆盖全

约束和质量控制

  • 约束条件
    • 避免低级情况:直接删除某函数,直接报错缺乏xx函数
    • 删除函数后,需修改调用地方,保证代码能跑通,但结果是错的。
  • 质量控制
    • 设置最小文件更改数
    • 必须有测试失败(有bug),必须有测试通过(环境没崩)

一致性验证

  • 基础检查
    • 测试文件检查:AI指导的测试文件是否真存在,而不是幻觉。
    • 解析器检查:AI写的python解析脚本能不能跑。
    • 脚本检查:在源代码库上运行测试,必须通过。
  • Bug质量检查
    • 规模检查:修改的文件数量 不能太少(如5个)
    • Bug检查:注入Bug后,必须有测试Fail
  • 隐蔽性检查
    • 注入Bug,删掉部分测试,原报错消失
  • 逆向高级检查(无冗余检查)
    • 避免AI注水无关紧要的更改,剔除冗余代码。
    • 所有文件都改坏,然后逐个恢复,检查Bug是佛会减少。
Bug Injector 奖励学习信号

概览

  • 一致性反馈:生成正确可用的Bug。
  • Solver反馈
    • Solver 秒解决 - 题目太简单:Injector 得分低
    • Solver 解不开 - 题目太困难:Injector 得分低
    • 寻找处于Solver能力边界上的难题

公式

  • 权衡Bug一致性和Solver解决率(s),α=0.8超参rinject={−1,一致性验证失败−α,s∈{0,1}1−(1+α)⋅s,0<s<1

修复Bug(Solver) ​

Bug Solver Agent

Bug 代码构建

  • 注入Bug:应用bug_inject.diff

  • 掩盖测试:应用test_weaken.diff

  • 高阶Bug(可选):应用pred_patch.diff

  • 销毁证据:不能保留.git 历史,防止Solver查看git diff或 git log

Prompt 设计

  • Issue 很难写、数据少,因此不使用自然语言描述。
  • 给模型看代码差异:test_weaken.diff的反转版。
    • 请修复源代码,保证把这个测试加回去,代码能跑通。

修复过程

  • 输入:坏代码库 + 请修好它的初始Prompt
  • 过程:思考 -> 调用工具 -> 环境交互运行测试,迭代循环
  • 输出:pred_patch.diff

奖励设计

  • 所有测试都通过,得1分。rsolve={1,通过所有测试−1,其他

对抗奖励

  • Solver:受益于更高的解决率
  • Injector:受益于更低的解决率

实验设置(对抗联合学习RL) ​

✍️实验设置

实验设置

基础模型

  • CWM-sft-32B,没有RL训练过

训练任务/数据

  • Baseline:人类的Issue + RL,仓库可能是SWE-B-Verified + SWE-B-Pro里的。
  • Self-PlayRL:SSR

评测任务/数据

  • SWE-Bench-Verified, SWE-Bench-Pro
  • 超参:温度=1,topp=0.95

算法/策略

  • 对抗式联合RL训练。1个LLM,同时生成Bug和修复Bug。

  • 大Batch、尽量On-Policy (small-policy-staleness),让梯度更新更稳定

    • 去掉超过8 off-policy的数据
  • CWM scaffold:bash + search-replace 编辑器

超参

  • 512 H100,64卡训练,448卡Rollout
  • 128k
  • Global Batch Size:16M token,整体150步,2.5B tokens

关键结果(CWM-32B-sft + 对抗RL) ​

🍑关键结果

关键结果

模型效果(CWM-32B-sft)

  • 在SWE-V和SWE-Pro上,SSR方法都超过RL+人类Issue训练的模型,但也没高多少。
  • SWE-V达51.4分,SWE-P达28.9分。

重要结论

  • Self-Play RL比Repair/Injection-Only RL 性能更好,Inject-Only 效果最差。
  • 大幅删除代码的Bug更好比仅改一行代码的Bug的好。后者太简单,学习信号弱。
  • 由于共享1个Policy,Solver解决率信号 对训练效果影响不大。

关键贡献

  • Self-Play-RL思想,只需环境+代码, LLM自我博弈,写Bug+修Bug,联合RL训练。

未来方向 ​

⛳ 未来方向

未来方向

不足点

  • Solver可能会作弊,面向测试编程。因为读取了所有测试用例
    • Public Tests 给AI看, Private Tests实际测试。
  • 测试单一,仅靠单元测试。
    • 引入高级验证标准。
  • Injector和Solver是同1个模型,可能导致思维趋同。
    • 引入不同模型博弈,MoE等。

Self-Play 研究方向

  • 更聪明的出题方法。
    • 需要指定Seed,给Injector指定目标,避免随机重复写Bug,保证多样性。
  • 合成复杂的多步骤SWE任务。
    • 多上下文回放、上下文压缩、高阶Bug升级等。
  • 更高效的Long-Horizon SWE训练方法。
    • 目前很长+Outcome RL,存在信用分配问题。
    • 每跑一公里,就自我检查一下。
    • 给出结构化建议,比如某一步出错等。

(2511) SkyRL-Agent(39分) ​

🌺 论文摘要

SkyRL-Agent 论文摘要

参考链接

核心方法

  • SkyRL-Agent 框架:Tool-接口 + 异步Dispatcher + 桥接后端
  • SWE-RL实验:AST工具增强 鼓励检索 + 增加环境提示信息 + On-Policy + 留一法优势估计
  • 数据:4.5k R2E-Gym ,Scaffold:Simple ReAct Agent

模型效果(Qwen3-32B + RL)

  • 纯RL,SWE pass@1 达 39分,相比基模提升15pt。
  • 超过DeepSWE 36分 (报告42分),训练成本降一半。
  • 弱于蒸馏模型 SWE-Agent-LM-32B 38分。
  • 泛化性:Terminal-Bench(+2.5%), BrowseComp-Plus(+1.3%), WebArena(+1.2 turns)

重要结论

关键贡献

  • SKyRL-Agent 框架。SkyRL-Agent-SWE 开源实现。

(2511) InfCode(没训练模型) ​

🌺 论文摘要

InfCode 摘要

参考链接

核心方法

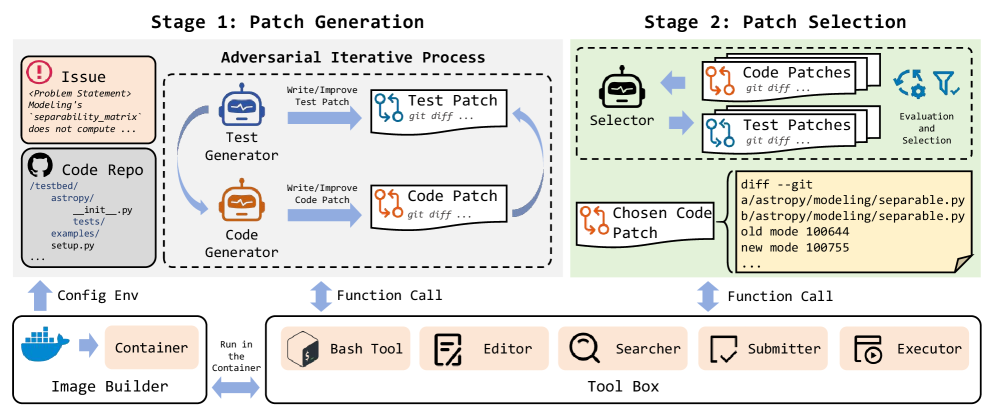
  • 框架:对抗式PatchGeneration + Patch Selection

    • 对抗生成代码和单元测试:TestGenerator + CodeGenerator,
  • 没有训练模型。

模型效果

  • Claude4.5 + InfCode:SWE-Verified 79.4分。不知尝试了多少次。
  • 轻微超过TRAE+DoubaoSeedCode 78.8分

重要结论

  • 对抗生成贡献4pt,选择贡献8pt。

关键贡献

  • 对抗Bug修复和测试生成的迭代修复框架。
  • 虽然没有训练模型,但思路挺好的。
  • 后来的Self-Play SWE-RL 就和其思路相同,但区别是使用了RL训练。

❓问题背景

问题背景

生成测试比较弱

  • 不仅依赖原测试,而依赖生成的测试。
  • 但生成测试:比较弱、无法覆盖边缘+核心情况、导致代码Genertor过拟合等。
  • 根本原因:把测试生成和Bug修复,作为2个分散的步骤,缺乏联系和验证。

📕核心方法

Patch Generation

Test Generator

  • 生成测试,找bug,找边缘/核心bug

Code Generator

  • 生成代码,修bug,迭代编辑代码

对抗式迭代修复

  • 当Code Patch通过测试用例时
    • Tes tGenerator:重新分析问题,识别边缘/不足的地方,生成更强的测试用例。
    • Code Generator:重新优化代码,以通过测试。
  • 迭代次数:设置上限
Patch Selection
  • Patch集合:选择所有阶段的Patch,并非只选择最后一个阶段的Patch
  • 验证方法:放到真实环境中去做执行。
  • 选择:通过原测试 + 通过加强版测试

✍️实验设置

实验设置

基础模型

  • DeepSeek-V3, Claude 4.5 Sonnet

训练任务/数据

  • 无需训练

评测任务/数据

  • SWE-Verified, SWE-light

算法/策略

  • Scaffold:agent-based, pipeline-based

超参

RL环境
  • 一个Issue 一个Docker环境
  • 工具箱集合
    • Bash:执行命令,实现任务自动化,运行测试、管理依赖、构建脚本等。
    • 编辑器:文件创建、内容插入、内容替换、指定行检索。
    • 搜索器:ripgrep 命令,高效迭代是目录搜索,支持正则表达式
    • Submitter:运行git diff 提取并提交补丁内容。
    • Executor:工具和Docker容器的接口,转发请求、管理输入输出。

🍑关键结果

关键结果

模型效果(Claude4.5)

  • Claude4.5 + InfCode:SWE-Verified 79.4分
  • 轻微超过TRAE+DoubaoSeedCode 78.8分

重要结论

  • InfCode带来提升:InfCode 40.3 > KGCompass 36.7 > Moatless 30。

    • 但是你尝试次数也多啊。
  • 对抗生成贡献4pt,选择贡献8pt

关键贡献

  • 对抗多智能体框架。
  • repo-aware的工具套件:增强理解、真实代码操作等。

⛳ 未来方向

未来方向

(2509) Kimi-Dev(48分) ​

🌺 论文摘要

Kimi-Dev 论文摘要

参考链接

核心方法

  • Agentless 训练(3阶段) + SWE-Agent适配(SFT)。

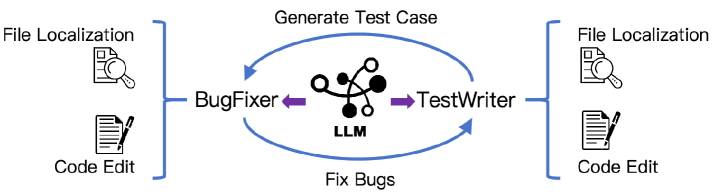
  • Agentless训练:BugFixer + TestWriter

    • MidTrain:Diff Patch + PR Commit + 定位推理合成数据 +agent交互合成数据
    • CoT SFT :DeepSeek-R1 蒸馏(SWE-Gym, SWE-bench-extra)
    • CodeEdit RL:执行结果奖励 + 难度课程学习 + 正样本强化
  • SWE-Agent适配:5.7k SWE-smith 轨迹数据 做SFT

  • 训练数据:是不可能开源的。

模型效果(Qwen2.5-72B-Base)

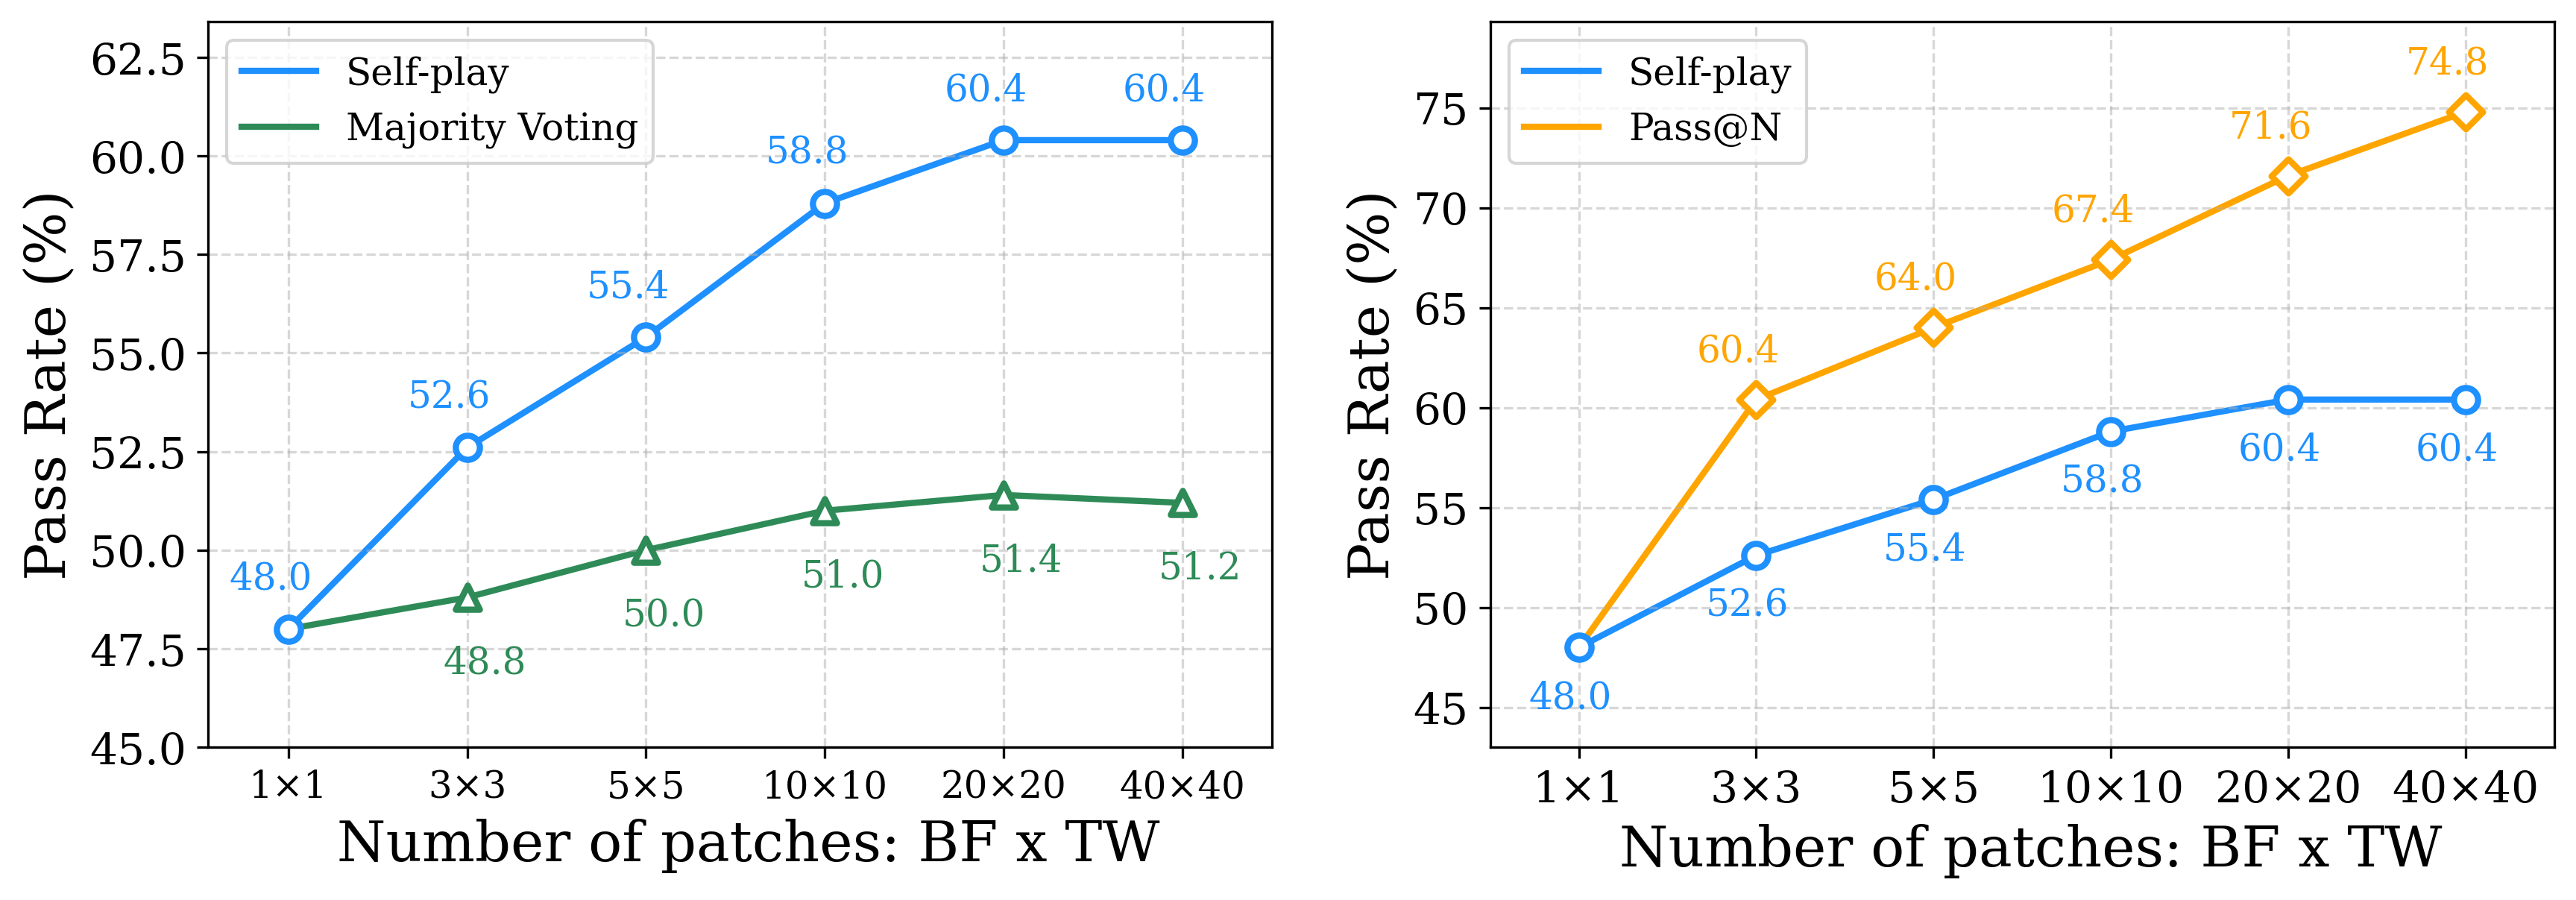
  • Agentless 训练 SWE-verified Pass@1 48分,TTS(40) 达60分。
  • SWE-Agent SFT适配
    • Pass@1 48分,优于SWE-Agent-LM-32B 40.2分;
    • Pass@10达74分,优于Agentless Pass@30 73.8分,推理次数仅1/3。

重要结论

  • Agentless训练可以带来Skill Priors,更好适配SWE-Agent
  • RL的先验最强:做SFT学的快好、做RL效果也更好。

关键贡献

  • 多阶段CodeAgent训练方法论
    • Agentless 训练(MT+SFT+RL) + SWE-Agent适配(SFT)。
    • 先从Agentless打基础,再逐步做Agent,模型不偏科、适应性强。

问题背景 ​

❓问题背景

问题背景

SWE 2条线路各有弊端

  • SWE-Agent/OpenHands:更灵活,端到端难训练

  • Agentless:流程模块化更好,更易RLVR训练。但探索空间灵活性有限。

Trade-off

  • 不从0开始训SWE-agent,先通过Agentless训练诱导出技能先验。
  • 先用Agentless打基础,再训SWE-agent

Agentless 训练框架(BugFixer+TestWriter) ​

Agentless 框架

BugFixer

  • 生成patch,解决bug

TestWriter

  • 生成单元测试,复现bug

成功标准

  • Patch(BugFixer) 通过 测试用例(TestWriter)。修复前:fail;修复后:成功。

依赖2个技能

  • 问题定位:修Bug找源文件;写测试找测试文件。
  • 代码编辑:修Bug改源文件;写测试插入新测试函数。

Mid-Training ​

MidTrain 概览 ​

Mid-Training

基础配置

  • 模型:Qwen2.5-72B-Base
  • 任务:Next Token Prediction

MidTrain 数据

  • 150B 高质量、真实数据。
  • 数据构成:包括:百万级的Github Issue + PR commit数据。
    • Diff Patch数据:50B,类似Agentless
    • PR commit 数据:20B,类似SWE-Agent
    • 推理交互 合成数据:20B,上采样4倍 即80B,包括思考推理、agent交互数据。

超参

  • Global batch size:256
  • 上下文长度:32k
  • 学习率:2e-5, cosine decay, 2e-6
  • Warmup:3B tokens, Decay:150B tokens
仓库和PR收集
  • 仓库过滤:低于5star、SWE-bench已包含的仓库。

  • PR 收集:GithubAPI 查询已合并的PR

    • 丢弃废弃、未审核、被替代的PR。
  • 代码变更2种格式

    • Natural Diff Patch + PR Commit Pack

Diff Patch 数据处理 (Agentless) ​

Diff Patch 数据

Diff Patch

  • Search-Replace 格式,模型最终输出,和Agentless一致。

Issue 描述

  • PR 关联的Issue内容 或 PR 标题。

PR 过滤规则

  • 仅保留py, md, rst文件修改的PR
  • 仅保留python的diff,重写为search-replace块
  • 删除文件新增和删除的PR。
  • 每个PR 修改的文件 不超过3个。
  • 每个PR的 search-replace 不超过5个。

4 类Prompt 模板 (Agentless)

  • BugFixer 定位和修复,TestWriter 定位和修复。
  • 作用:用于后续冷启动、RL、TTS。训练时:Prompt做Mask。

最终数据规模

  • 50B DiffPatch 数据

PR Commit Pack 数据处理 (SWE-agent) ​

PR Commit Pack

Commit Pack 说明

  • 人类的提交序列,每一步包含commit + 代码变更
  • 和SWE-Agent相似

处理逻辑

  • 仅保留py, md, rst文件修改的PR。
  • 每个PR 最多修改5个python文件
  • 过滤开发者签名和Github ID

最终数据规模

  • 20B Commit Pack 数据。

Agent推理数据 合成 ​

Agent推理数据 合成

背景

  • 有代码diff数据,但无思考过程,为什么修改这个文件?

方法

  • 使用LLM去预测修改文件,保留正确预测修改文件的数据。

  • LLM:Qwen2.5-72B-Instruct

    • 但需经过SFT微调提升推理质量
    • 微调数据:DeepSeekR1蒸馏的2k数据。
  • 数据:海量Github题目。

  • 筛选:仅保留推理正确的数据。

最终数据规模

  • 10B 推理合成数据

Agent交互数据 合成 ​

Agent交互数据 合成

背景

  • 目的:加强agent能力。
  • 方法:自定义工具,模拟agent-环境交互,不执行,模仿文件系统操作,降低成本。

文件定位 (Agentless Stage1)

  • 自定义模拟工具:
    • 仅允许文件查看和关键词搜索,禁止shell,无需实际执行。
    • 工具集放在SystemPrompt里。
  • Rollout模型:Qwen2.5-72B-Instruct。
  • 对应后续训练策略:
    • 仅对SystemPrompt做Loss Mask,轨迹的action和observation都做学习训练。
    • 一般环境返回是需要mask的。但这里保留,是为了学习理解环境返回结果。

代码编辑 (Agentless Stage2)

  • 定位结果来自stage1,现在进入stage2做代码编辑。
  • 负样本训练
    • 故意给出定位错误文件,手动注入Pattern:我意识到,不需要修改这个文件。
    • 增强模型反思能力。
  • PR Commit Pack 转换成轨迹形式
    • Commit:推理步骤。
    • Code Update:动作,str_replace、insert工具格式。
  • Rollout模型:Qwen2.5-72B-Instruct。

最终数据规模

  • 10B Agent交互数据。

LongCoT 冷启动 ​

冷启动

冷启动数据蒸馏

  • 任务:SWE-Gym, SWE-bench-extra
  • 角色:Bugfixer, TestWriter
  • 蒸馏模型:DeepSeek-R1-250120
  • 数据量:BugFixer大约2k?

SFT 效果

  • 获得推理技能:问题分析、方法规划、自我完善、探索替代方案等。

Code-Edit RL ​

RL 策略 ​

RL 策略

背景

  • 经过MidTrain+LongCoT SFT,模型已具有较强定位能力。
  • RL仅关注:代码编辑。

数据集

  • 数据源:SWE-Gym, SWE-bench-extra ?
  • 每1个Prompt均有1个环境。
  • 数据多样性:使用多种 Bug定位结果,作为LLM输入。
  • 数据难度(课程学习)
    • 难题标准:pass@16=0
    • 简单数据集:1.2k,
    • 难数据:除开简单的

RL策略(GRPO)

  • 奖励:只看执行结果,0、1,不看格式注释等内容。
    • BugFixer:通过所有测试得1
    • TestWriter:Fail2Pass。修复前: 有Bug;修复后:无Bug。
  • 课程学习
    • 先只学简单,待分数超过阈值,再逐渐加入难样本。
    • 每100step 加入500难样本。
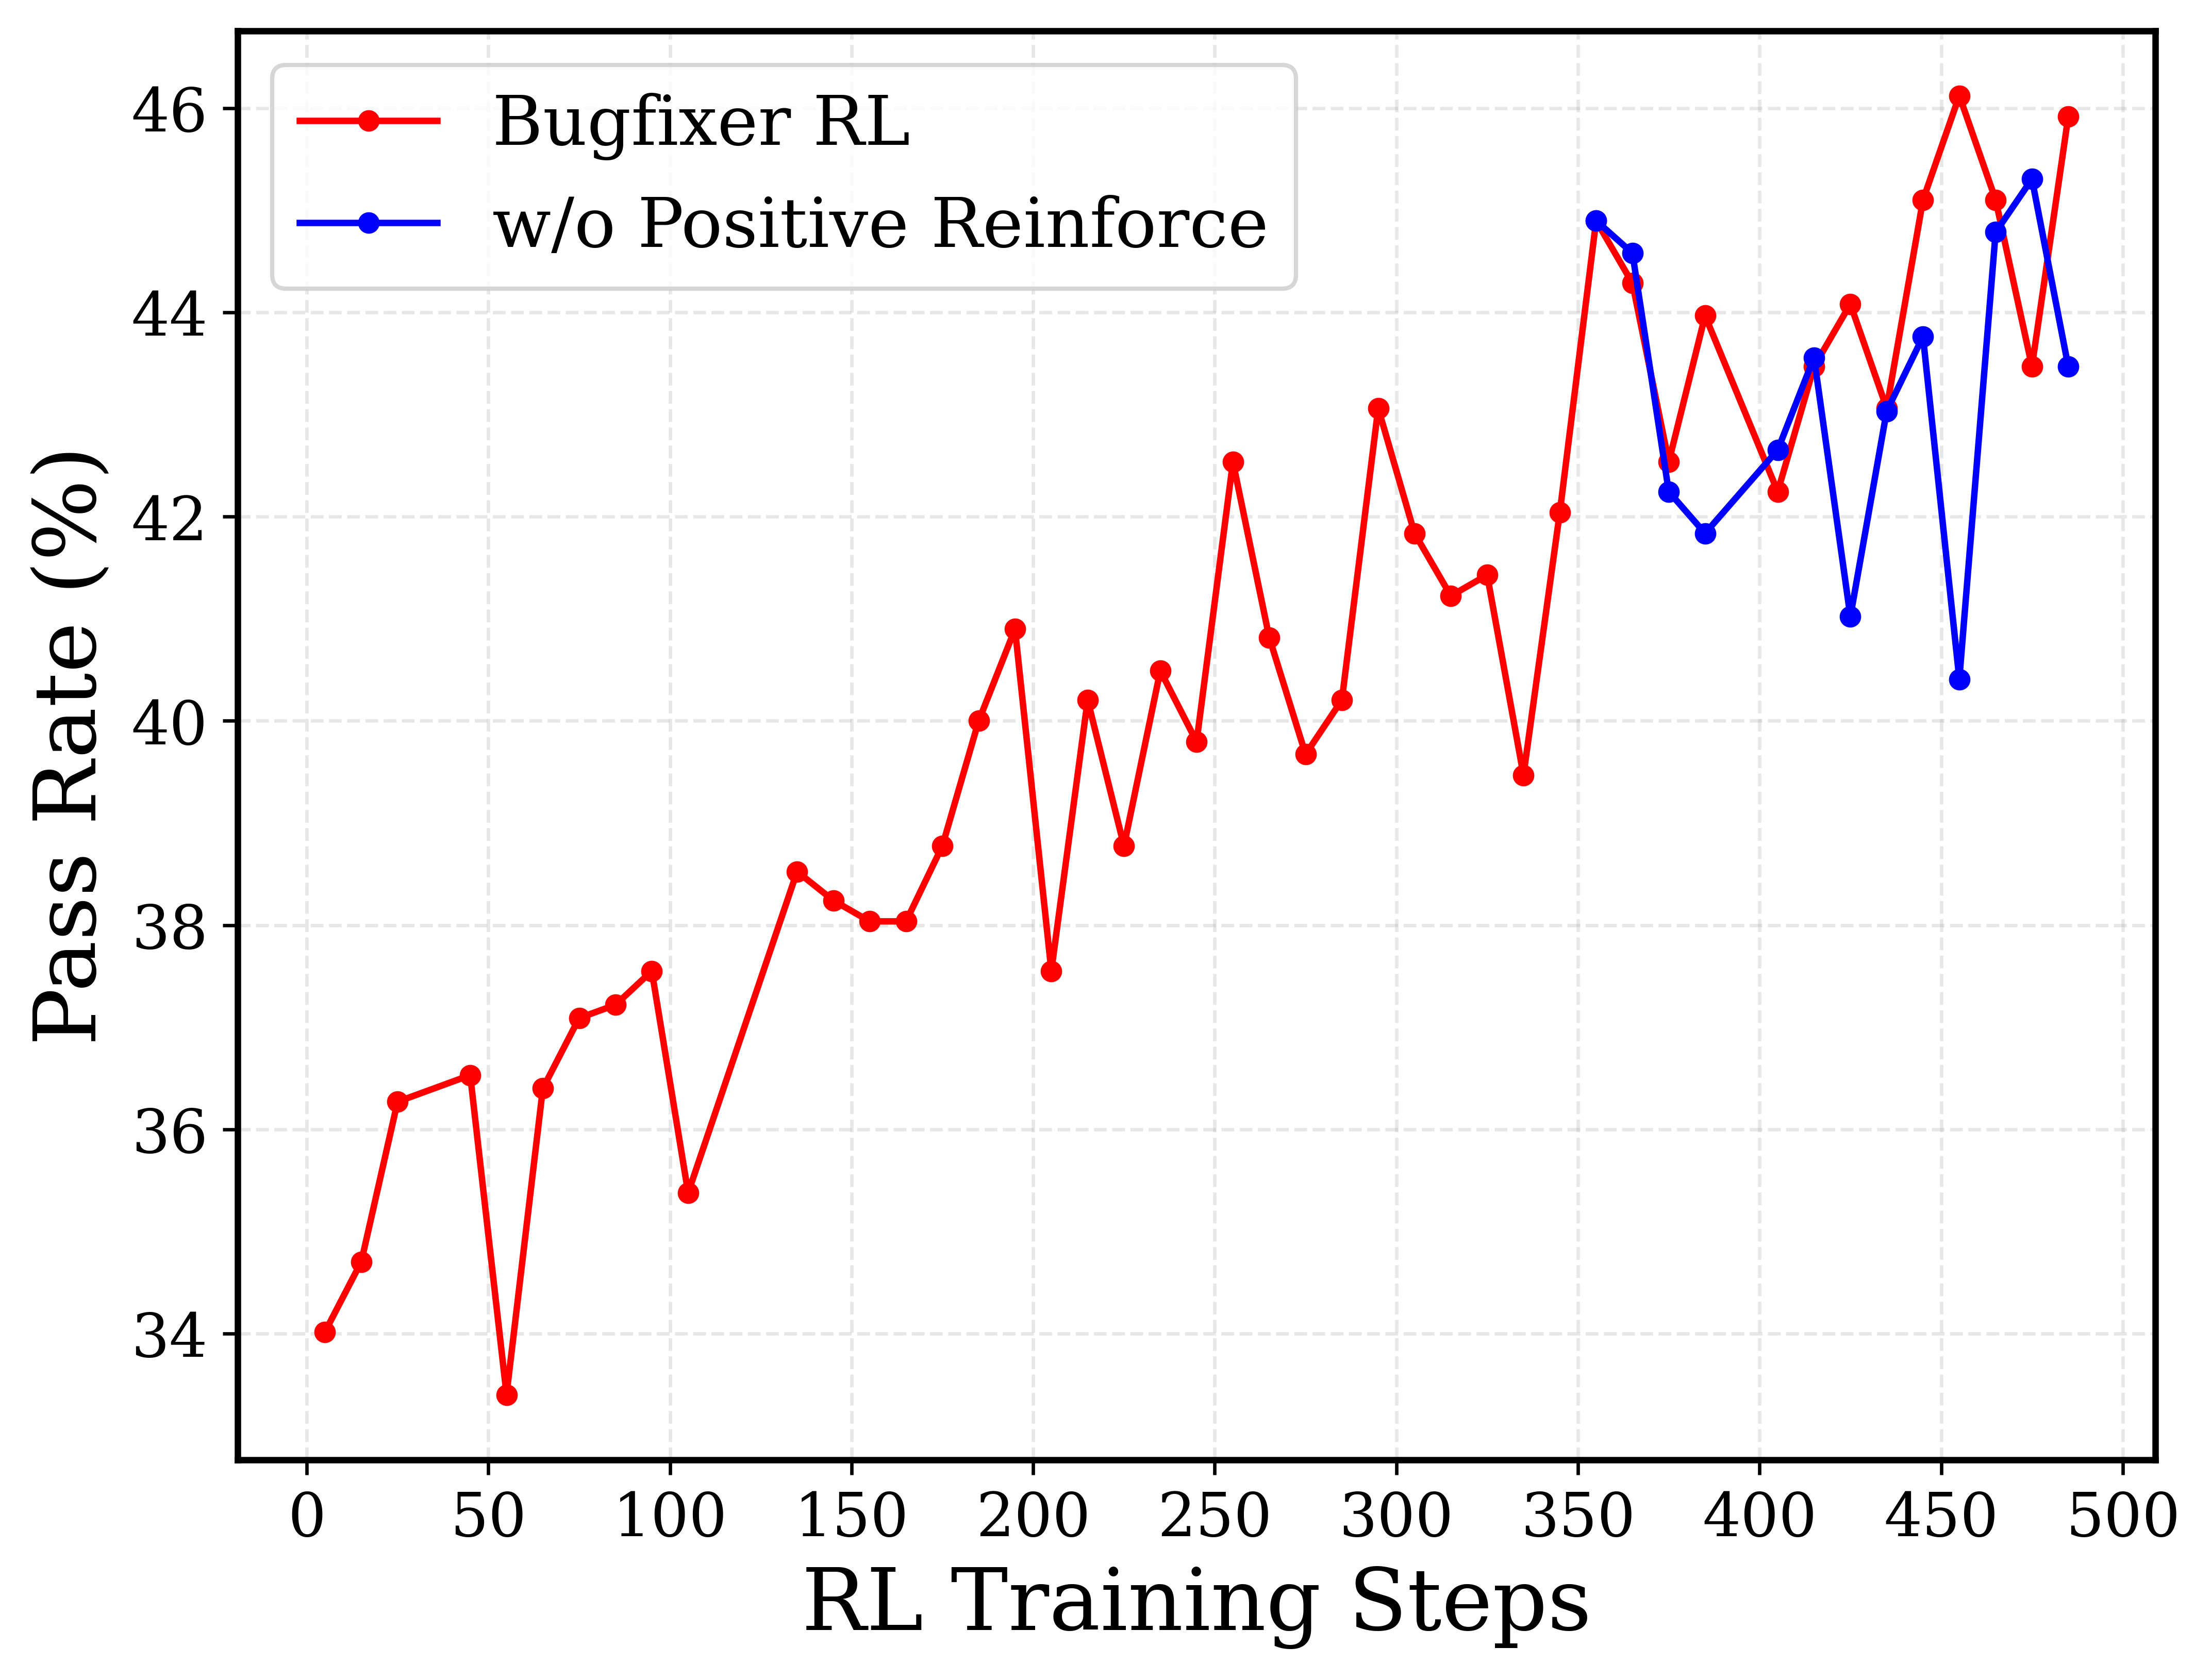
  • 正样本强化
    • 后期性能进入平台期,很难探索新解法。
    • 使用之前的正样本,加入迭代,做强化巩固记忆,冲刺效果。

正样本强化 后期训练要稳定一些。

RL 环境 ​

Sandbox

并发度

  • 支持1w 并发,2.5w docker镜像(来自各种数据集)

特点

  • Use-and-Destroy:沙盒只为1次执行,任务跑完后,立即摧毁。
  • 一套自动构建镜像的流水线。

技术栈 (K8s + Sdecar)

  • Kubernetes(K8s):行业标准,容器编排,管理2.5w docker
  • Sidecar Pattern:边车模式
    • 主容器:跑具体任务代码
    • Sidecar容器:辅助工作,收集日志等。

SWE-Agent 适配 ​

SFT 适配 ​

SWE-Agent 适配

背景

  • Kimi-Dev 基于Agentless训练,已有Skill Priors
  • 但SWE-Agent自由性更高,希望适配SWE-Agent

方法

  • SFT 数据集:SWE-smith 轨迹数据,5.7k (Claude蒸馏)
  • SFT 微调:64k
  • 推理时:128k + 100轮交互。

Skill Prior 验证 ​

技能先验

背景

  • 原则:先验越好,给一点数据,应该就快。
  • 测试方法,基于SWE-Agent
    • SFT实验:给不同数量数据做SFT。
    • RL实验:做1步SFT,然后做RL。
  • 对比:Base、MidTrain模型(MT先验)、SFT模型(SFT先验)、RL模型(先验)。

RL 模型 (RL先验)

  • RL先验最好,SFT训练 学的最快、效果最好。
  • 更擅长做长线任务:LongCot转化为Agent长交互能力。
    • RL 模型到70步,仍然可解新问题;对比Base止于50步。
  • RL实验上,RL先验也比SFT先验 好。RL自行悟出解题模式 ,不同于Claude。

Mid-Train 模型 (MT先验)

  • SFT 起步慢,但只要数据够,很快追上第一梯队。
  • 直接做RL,不会使用工具,没有正反馈,训练直接崩溃。说明:冷启动+RL是必要的。

SFT 模型 (SFT 先验)

  • Zero-Shot比RL强,但200条数据时,容易过拟合死记硬背。

Test-time self-play ​

Test-time self-play

背景

  • RL之后,模型已掌握BugFixer和TestWriter能力。
  • 测试时,使用self-paly来协调2种能力。

生成阶段

  • 遵循Agentless,为每个实例生成40个patch和40个测试。
  • BugFixer:第1个:贪婪解码;剩余39个:温度=1 采样,保证多样性。
  • TestWriter:独立生成40个测试。仅保留代码没修复时能报错的单元测试。
    • 过滤:去掉没有报错的测试。

验证阶段

  • 解法Patch集合:B;单元测试集合:T。

  • 每个Patch bi,去验证每1个单元测试 tj;针对有无补丁2种情况

    • 分别记录下报错数F(j)和通过数P(j)

    • 并计算Fail2Pass, Pass2Pass数量。

  • 最终Patch bi的得分:高FP率 + 高PP率,能修bug + 不会破坏原有功能。

    Si=∑jFP(i,j)∑jF(j)+∑jPP(j)∑jP(j)

Self-play 效果不如 Pass@N,优于投票。

实验设置(MidTrain+SFT+RL) ​

✍️实验设置

实验设置

基础模型

  • Qwen2.5-72B-Base

训练任务/数据

  • MidTrain:150B token,DiffPatch + PR Commit + 推理数据 + 交互数据
  • LongCoT SFT:2k+数据,SWE-Gym + SWE-Bench-extra
  • Code-Edit RL:1k数据,SWE-Gym + SWE-Bench-extra

评测任务/数据

  • SWE-Verified

算法/策略

  • Agentless 框架 :BugFixer + TestWriter,都依赖定位和编辑能力。
  • Mid-Train:NTP任务,Diff+PR+推理+交互模拟(文件定位和代码编辑)。
  • SFT:DeepSeekR1 + 2角色蒸馏,提升推理技能。
  • RL (GRPO):结果奖励 + 难度课程学习 + 后期正样本强化

超参

  • RL: rollout=10,64k

关键结果(Qwen2.5-72B-Base, MidTrain+SFT+RL) ​

🍑关键结果

关键结果

模型效果(Qwen2.5-72B-Base)

  • Agentless 训练:SWE-verified pass@1 48分,使用TTS(40)后,达60.4分。
  • SWE-Agent SFT适配:
    • SWE pass@1 48分,优于SWE-Agent-LM-32B 40.2分。
    • SWE Pass@10 74分,优于Agentless Pass@30 73.8分,推理次数仅1/3。

重要结论

  • Agentless训练可以带来Skill Priors,更好适配SWE-Agent
  • RL的先验最强:做SFT学的快好、做RL效果也更好。
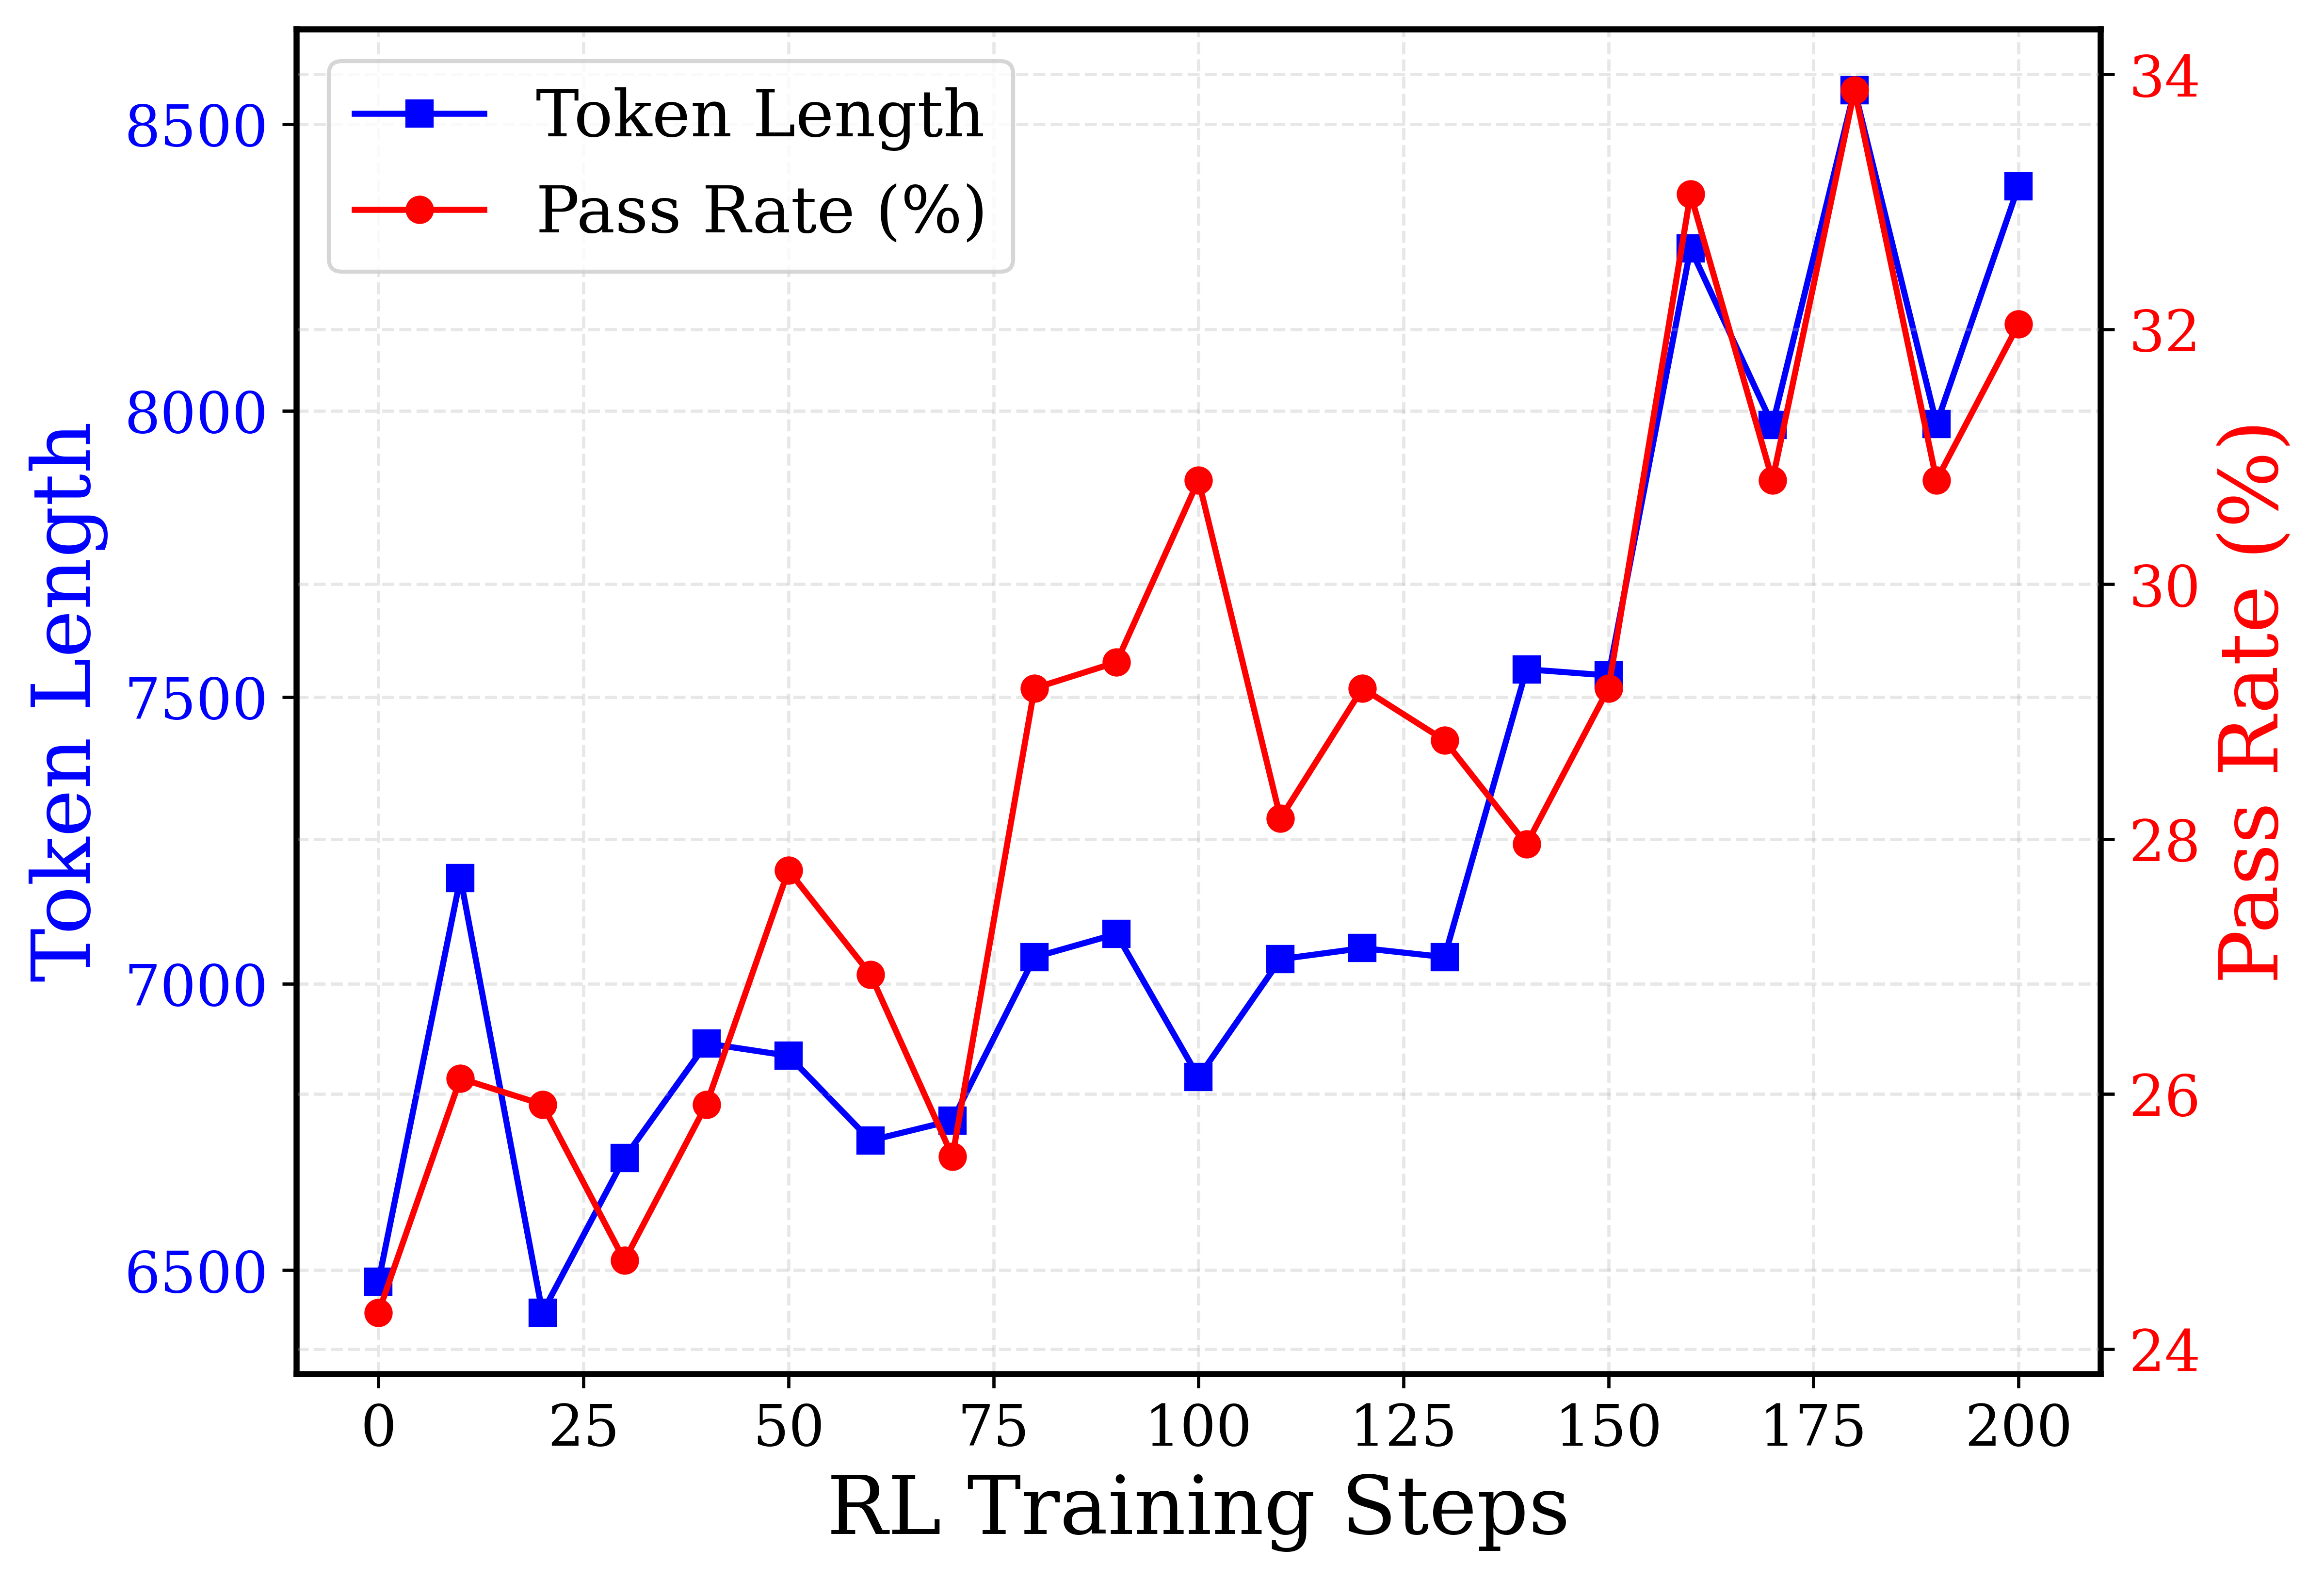
  • RL性能和回复长度正相关。

关键贡献

  • 多阶段CodeAgent训练方法论。Agentless 训练(MT+SFT+RL) + SWE-Agent适配(SFT)。
    • 先从Agentless打基础,再逐步做Agent,模型不偏科、适应性强。

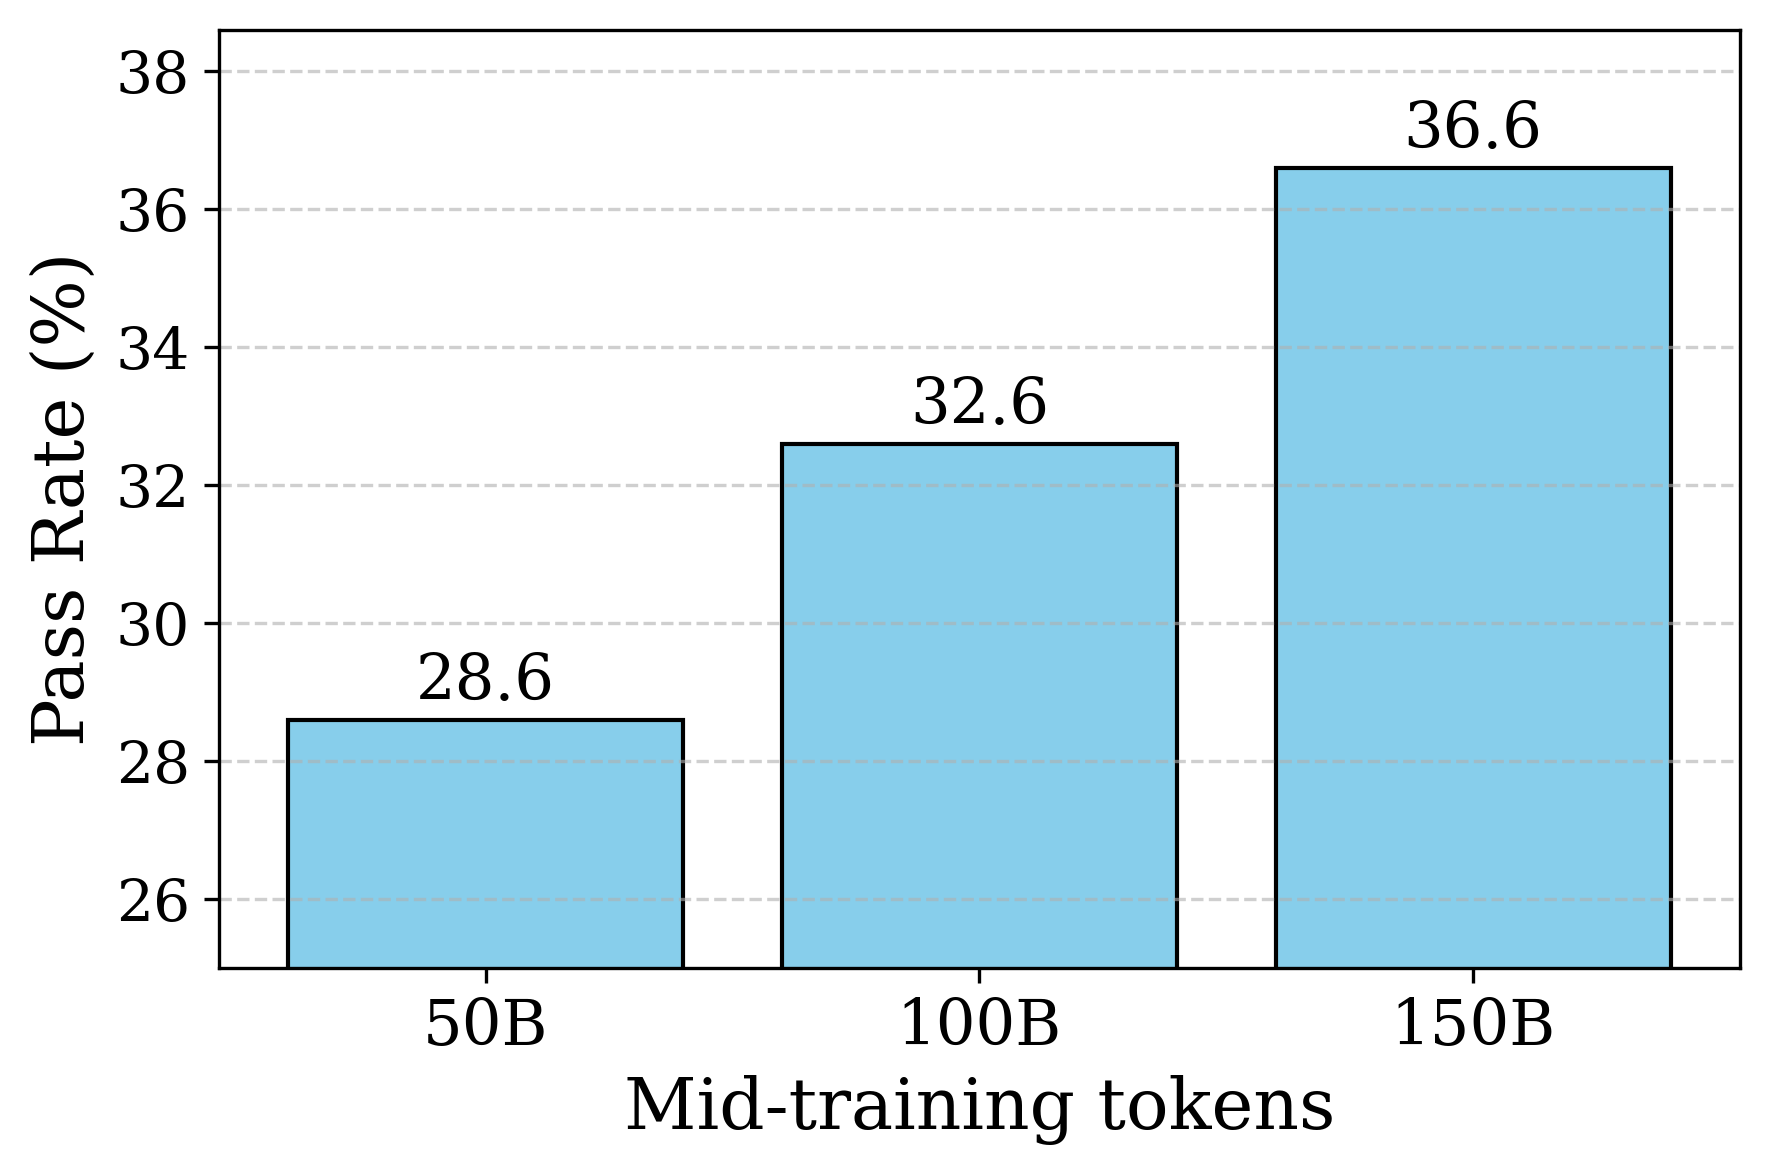
MidTrain各阶段,使用2k 冷启动数据后,评测SWE

RL 效果和训练长度有关。

未来方向 ​

⛳ 未来方向

未来方向
  • TestWriter 改进:目前生成测试不够全面,需提升质量。
  • 端到端SWE-Agent RL:目前Agent仅做了SFT,未来可做RL。
  • 环境扩展:利用合成环境进一步扩大训练数据规模。

(2508) SWE-Swiss(45分) ​

🌺 论文摘要

SWE-Swiss 论文摘要

参考链接

核心方法

  • 3任务SFT数据构建:问题定位+ 问题修复+ 测试生成
  • 2阶段训练方法:3任务SFT + 2阶段RL 课程学习,难样本:过滤正确率>90的数据。
  • 3任务-SFT 10k轨迹 (蒸馏DSR1),Bug修复-RL 12k,来自SWE-Gym,SWE-smith等。
  • TTS方法:EM + GT代码相似度。
  • Scaffold:Agentless,不是Agent

模型效果(Qwen2.5-32B-Instruct, SFT+RL)

  • SWE-Verified SFT达36,RL达45,RL提升9pt,增加TTS(best-120) 达60分。
  • 在通用任务、Math任务、代码生成任务上,均有提升。

重要结论

  • 虽然训练3任务用SFT,但也可用RL做定位,也很有效果,后续可以基于此。

关键贡献

  • 开源数据代码

❓问题背景

问题背景
  • Agentless 把SWE分解为固定workflow
  • 如何通过提升各子任务能力,来提升SWE效果?

📕核心方法

核心方法

核心思想

  • 提升3技能:定位、修复、单元测试生成。

  • 2阶段训练

    • 3任务SFT:分别构造SFT数据

    • 2阶段RL:通过执行反馈 提升修复能力

3任务SFT数据构建(定位+修复+测试生成) ​

定位+修复+测试生成 SFT数据构建

背景

  • 通过提升3任务能力,来提升SWE能力。
  • 模型:均使用DeepSeek-R1-0528做蒸馏模型。

问题定位

  • 数据源:SWE-Bench、SWE-Gym-Raw
  • 提取GT修改文件。
  • LLM预测修改文件。
    • 输入:Issue + 项目结构;输出:需要修改的文件
  • 筛选标准:recall=1 + 预测文件数<5
  • 最终:5.3k 定位数据。

问题修复

  • 数据+环境:SWE-gym、SWE-smith。
  • LLM预测Patch。
    • 输入: Issue + GT修改文件 + 相关文件;输出:Patch
  • 筛选标准:单元测试。保留通过的。
  • 最终:3.9k 修复数据。

测试生成

  • 数据源:SWE-gym、SWE-smith,同问题修复数据。
  • LLM生成单元测试。
  • 筛选标准:实际执行测试结果,需和原测试保持一致。
  • 最终:1k 单元测试生成数据。

2阶段训练(3任务SFT + 2阶段RL) ​

2阶段训练 (SFT + RL)

3任务SFT

  • 10k SFT数据集。
  • 把不同的多任务能力,训进一个单模型。

2阶段RL (课程学习)

  • 奖励设计:通过单元测试:1,其他:-1
  • 阶段1:训200步,全部数据。
  • 阶段2:训90步,过滤正确率超90%的样本。

测试和TTS ​

TTS

单Patch生成

  • 2阶段 定位 + 修复。
    • 定位模块:先预测相关文件
    • 修复模块:预测文件 + 检索文件 --> 生成修复Patch,检索使用text-embedding3-small

多Patch + TTS

  • 核心:生成多个patch + 过滤patch + 选择最优patch。

  • 过滤patch:原测试过滤 + 生成测试过滤

    • 生成测试:Issue+预测相关文件,生成测试用例。测试用例通过一致性选择过滤。
  • 最优patch选择:

    • 传统self-consistency:基于EM做投票选择,数学居多。

    • 增强self-consitency:除EM以外,增加与GT代码相似度得分。

      Score(c)=ScoreEM(c)+ScoreSim(c)

实验设置和结果(Qwen2.5-32B-Instruct+SFT+RL) ​

✍️实验设置

实验设置

基础模型

  • Qwen2.5-32B-Instruct

训练任务/数据

  • SFT(定位+修复+测试生成):10k 数据
  • RL(修复):SWE-Gym, SWE-smith

评测任务/数据

  • SWE-verified

算法/策略

  • Scaffold:Agentless
  • 3任务SFT + RL
  • DAPO技巧:no kl loss,clip_higher, 动态采样,token-level loss

超参

🍑关键结果

关键结果

模型效果(Qwen2.5-32B-Instruct, SFT+RL)

  • SWE-Verified SFT达36,RL达45,RL提升9pt。
  • 增加TTS后,Best-of-120:达60分。
  • 在通用任务、Math任务、代码生成任务上,均有提升。
    • Instruct < SFT < SFT + RL

重要结论

  • 虽然训练3任务用SFT,但也可用RL做定位,也很有效果,后续可以基于此。

关键贡献

  • 完全开源。

⛳ 未来方向

未来方向

(2508) NEBIUS SWE-Agent (39分, 筛选SWE-rebench数据) ​

🌺 论文摘要

NEBIUS-SWE论文摘要

参考链接

核心方法

  • SWE-rebench数据筛选:过滤有误数据+控制复杂度+LLM质量评估+确定性测试

  • 数据:7k任务 + 自蒸馏6.5k轨迹数据 + Verified-50做快速验证

  • RFT冷启动: Mask错误格式动作,仅学习有效动作。

  • 2阶段RL课程学习

    • 65k -> 131k,7k全部样本 -> 2k难度样本
    • 难样本:过滤阶段1 正确率 > 2/3、正确率=0的样本
  • DAPO技巧

    • 超长步数惩罚 + 去掉0优势样本 + Token-level Loss,阶段2减小CLIP-Higher
    • 步数惩罚:鼓励高效和惩罚死循环动作
  • Scaffold:SWE-Agent

模型效果 (Qwen2.5-72B-Inst, SFT+2RL)

  • 训练后,SWE pass@1达39分,pass@10达58分,持平DeeepSeek-V3-0324

重要结论

  • 不要过滤超长样本,要惩罚死循环。
  • 训推不一致:采样topk, topp导致词表被截断,解法:关闭filter。
  • 未来难题方向:长程信用分配问题、盲目自信问题。

SWE方法及挑战 ​

❓问题背景

目前SWE方法
SWE 存在挑战
  • Long-Horizon 多轮交互
  • 反馈复杂:反馈一大堆报错,可能看不懂
    • RFT 冷启动
  • 数据难以构建
    • 对策:使用rebench做清洗,一套清洗策略
  • 奖励稀疏
    • 对策:GRPO/DAPO,Token-Level Loss
  • 评估贵且有噪声:跑1次要几分钟,还学不到东西;
    • 对策:Verified-50子集、去掉Noisy不稳定数据

核心方法 ​

📕核心方法

筛选 SWE-rebench数据 ​

SWE-ReBench 数据筛选

SWE-ReBench

  • 原始:21k任务 + 3.4k python仓库
  • 筛选后:7.2k 任务

数据筛选策略

  • 过滤任务本身有误的数据:如属性错误、引用错误导致不能通过测试等。
  • 控制复杂度:修改文件数<7 + 修改代码数<500行
  • LLM评估质量:去掉问题描述不清楚、任务过于复杂、test patch有问题的数据。
  • 确定性测试:执行50次,需要结果一致,不一致则过滤。

评测集

  • Verified-50:从SWE-verified 随机选择 50个任务,做训练时验证。
  • SWE-rebench 5月和6月版:

环境动作空间 (SWE-Agent Scaffold + ReAct) ​

SWE-Agent Scaffold + ReAct

动作空间

  • 任意shell命令:ls, cat, grep等。
  • 编辑命令:新闻部替换指定行
  • 自定义搜索和查找:search_file、open、`goto
  • submit:终止

SWE Task

  • Issue描述、测试套件、sandbox 环境快照

RFT冷启动 (筛选正确轨迹+Mask错误动作) ​

Rejection Finetuning 冷启动

背景

  • Qwen2.5-72B-Instruct:SWE 仅11分,因为指令格式不遵循。

方法

  • 在选定的SWE-rebench任务上,Rollout 10次,仅保留成功的6.5k轨迹
  • SFT 1个epoch:Mask 错误格式动作,只学习有效动作。
  • 准确率由11提升至20分。

DAPO算法+2阶段RL训练 ​

GRPO 算法配置

奖励配置

  • 整体奖励:稀疏奖励 + 步数超长惩罚,全部正确才为1

    Rfinal(τ)=R(τ)+Rlength(τ)
  • 步数超长惩罚:惩罚死循环 + 鼓励高效方案

    Rlength(τ)={0,|τ|<LthrLthr−|τ|Tmax−Lthr,|τ|≥Lthr

GRPO 算法配置

  • 整体同DAPO:token-level-loss
  • Group-10 计算,但去掉优势为0的样本。
  • rollout=10
2阶段RL训练

2阶段RL训练

  • 阶段1:65k,40轮,7.2k问题,bs=128,clip=[0.2,0.3],构建baseline
  • 阶段2:131k,80轮,2k问题,bs=256,clip=[0.2,0.26],处理更复杂问题

阶段2优化

  • 降低clip上限:更新更稳定,防止模型跑偏,(2506) Magistral
  • 增加问题难度:(2506) 课程RL学习(E2H Reasoner)
    • 去掉成功率>2/3的任务
    • 去掉成功率一直为0的任务
  • 增大batch size:梯度计算更准确,(2505) Skywork-OR1
  • 减少每次迭代采样的实例数量:平衡开销。
  • 以上来自推理模型训练经验

实验设置(SFT+2阶段RL) ​

✍️实验设置

实验设置

基础模型

  • Qwen2.5-72B-Instruct

训练任务/数据

  • 从SWE-rebench清洗的7.2k 数据

评测任务/数据

  • SWE-verified

算法/策略

  • RFT 冷启动 +2阶段RL训练 (65k -> 131k上下文)
  • Scaffold:SWE-Agent

超参

  • 具体见RL算法配置
  • H200,8卡 * 16节点,每节点32核CPU、960GB CPU内存。

SWE环境

  • agent执行:Kubernetes集群,每个实例 0.5 CPU + 2GB内存
  • 评估:云平台 TractoAI

关键结果(Qwen2.5-72B-Inst + SFT+2阶段RL) ​

🍑关键结果

关键结果

模型效果 (Qwen2.5-72B-Instruct, RFT+2RL)

  • RFT 冷启动微调:SWE-verified 达20分
  • 2阶段 RL训练:pass@1达39分,pass@10达58分。
  • RFT+2RL后: 效果持平 DeepSeek-V3-0324,低于235b-Inst-2507,超过Qwen3-235B。

重要结论

  • 不要过滤丢弃超长样本:实际丢弃了超长负样本,导致死循环得不到惩罚。
  • 训推不一致导致训练崩溃

SWE 难题未来方向 ​

⛳ 未来方向

未来方向

稀疏奖励和信用分配问题

  • 背景:长轨迹难以分配奖励信号。

  • 未来方向:

    • Reward Shaping:设计中间奖励,通过部分测试用例、减少编译器保持数量等。

    • 训练辅助Critic:提供step-level的优势估计,实现细粒度更新

    • 前缀采样:从共享非空前缀开始进行多次Rollout,更好知道中间动作哪个动作更好

不确定性和风险感知(盲目自信)

  • 背景:稀疏二值奖励 鼓励agent提交patch:可能表现得很自信,但结果不正确
  • 现实:需要识别何时该放弃。
  • 方法:
    • 模型显示输出置信度分数
    • Agent自主决定是否重新尝试:自主 Best-of-N 选择

(2508) DeepSWE (42分, Agentic) ​

🌺 论文摘要

DeepSWE 摘要

参考链接

核心方法

  • Kubernates R2E环境集群 + R2E-Gym 4.5k数据 + 环境执行反馈
  • GRPO++算法:
    • DAPO技巧:Clip-Higher+去除KLloss+ 去除熵loss + compact过滤
    • Dr.GRPO技巧:优势不除以标准差 + 去掉序列内Token平均
    • RLOO技巧:留一法计算优势
  • Hybrid TTS:执行验证 + 免执行验证
  • SWE-Agent

模型效果(Qwen3-32B, RL)

  • Qwen3-32B 经GRPO++优化后,SWE-verified 达42分,TTS达59分。

重要结论

  • 用Claude蒸馏来SFT模型,SWE仅34分,低于SWE-Agent-LM 40分。
  • 用SWE-Smith和SWE-Gym数据做RL,提升有限。
  • R2E-Gym 很适合做RL,较好课程学习。

关键贡献

  • 开源。

问题背景 ​

❓问题背景

问题背景
  • Agent:通过工具调用和真实环境交互,环境给予反馈、奖励信号。
  • Code Agent:IDE工具(Bash+文件搜索+文件编辑 + 文件浏览)等。

Agent

Code Agent

核心方法 ​

📕核心方法

SWE环境(Kubernates集群) ​

SWE 环境扩展 -Kubernates集群

并发需求

  • 每次RL迭代:512个Docker容器,BS=64、8passes。
  • 并行RL实验:每时刻都有几千个容器在运行。

解决方法

  • Kubernates集群,每个节点:200 CPU + 6TB local NVME SSD。
  • 可扩展至1000 CPU 集群。

RL设置(动作空间+数据+稀疏奖励) ​

RL 环境和数据

动作空间

  • 执行Bash:执行命令,返回sdtout和sdterr
  • 搜索:在目录下或对单文件进行搜索
  • 文件编辑:查看、创建、替换字符串、插入、撤销修改等。
  • 完成/提交:LLM决定已经解决PR,结束

数据

  • R2E-Gym 4.5k数据集,过滤污染数据。

稀疏奖励

  • 1:测试用例全部通过,(Pass2Pass, Fail2Pass)
  • 0:超时或至少有1个未通过
  • 超时时间:5分钟,官方是30分钟。

GRPO++算法(DAPO+Dr.GRPO+RLOO) ​

GRPO++ (DAPO+Dr.GRPO+RLOO)

相关笔记

采用 DAPO 技巧

  • Clip-Higher:鼓励探索和防止熵崩塌

  • 移除KL Loss:避免LLM受原始SFT影响限制探索空间

  • 移除熵 Loss:会增加不稳定性,导致熵增加,训练崩溃。如果基模熵在0.3-1,就无需熵loss

  • Compact 过滤:对达最大长度、超时、达最大步数的数据,Mask Loss

采用Dr.GRPO 技巧

  • 优势不除以标准差:消除任务难度偏差

  • 去掉序列内平均,消除长度偏差,其实就是DAPO的Token-Level-Loss

采用RLOO 技巧

  • 留一法计算优势

Compact 过滤:

Hybrid TTS (DeepSWE-Verifier) ​

TTS 相关工作
Hybrid TTS方法

Hybrid TTS

  • 不执行验证
    • 不执行,由LLM选择最优轨迹。
    • DeepSWE Verifier:在正确和错误patch上,训练2epoch,识别正确和错误
  • 执行验证
    • 由LLM生成测试用例,用例通过最多则为最优轨迹
  • 混合方法。

TTS 参数

  • 上下文长度:16k -> 32k -> 128k,超过32k 收益就比较小
  • Rollout数量:8、16等

不执行和执行两种方法对比:

TTS 对比:

最大输出token对比

实验设置(GRPO++) ​

✍️实验设置

实验设置

基础模型

  • Qwen3-32B

训练任务/数据

评测任务/数据

  • SWE-verified,官方R2E-Gym代码库来评估
  • 超参:100步,64k上下文
  • 指标:pass@1 avg16, best@8, best@16
  • TTS策略:免执行方法 + 执行免执行混合方法

算法/策略

  • GRPO++ (多种策略),R2E-Gym Scaffold

超参

  • 上下文长度:16k -> 128k,其中32k效果很好了,后期收益不大
  • 训练:32k、50轮;测试:64k、100轮
  • Rollout:16、8等,做了多组实验
  • 64张H100,训练6天。

关键结果(Qwen3-32B + RL) ​

🍑关键结果

关键结果

模型效果(Qwen3-32B, RL, SWE-V指标)

  • GRPO++后,SWE pass@1 42.2分 ,pass@16 71分,TTS best@16 59分
  • DeepSWE-Preview-32B

重要结论

  • 使用Claude3-4蒸馏数据做SFT,仅34.4分,低于SWE-Agent-LM 40分。
  • 使用SWE-Smith和SWE-Gym数据集,但提升有限,训练中无解率很高
  • 相反R2E-Gym很适合RL,提供足够的课程学习,随时间推移解决越来越难的问题。

未来方向 ​

⛳ 未来方向

未来方向
  • 更大模型:比如DeepSeek-R1
  • 更长上下文:
  • 扩展到不同领域的agent

(2512) Devstral2(72.2分) ​

Devstral2 摘要

参考链接

模型效果

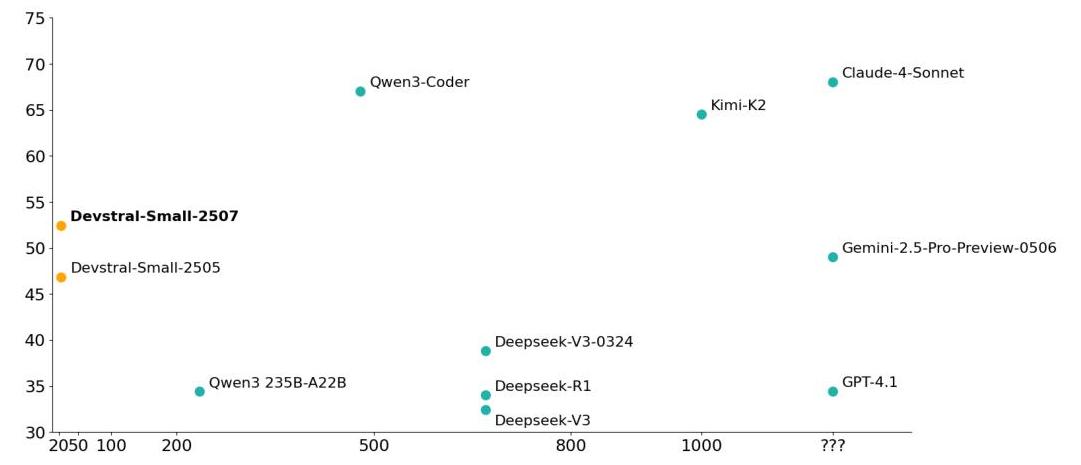
  • 模型小且效果好
    • 256k、Dense模型,比Kimi/DeepSeek都小很多。
    • Devstral2:123B,72.2 SWE-verified。
    • Devstral Small2:24B,68 SWE-verified。
  • 但仍落后于闭源模型。

关键结论

  • 支持探索代码库、跨文件协调更改、架构级上下文
  • 支持 Mistral Vibe CLI 工具。

(2505) Devstral(46分, tts3指标) ​

🌺 论文摘要

Devstral 摘要

参考链接

核心方法

  • SFT轨迹数据合成方法:基于环境探索+单元测试验证, 保留正确轨迹
  • Post-Training方法:简单过滤SFT、严格过滤SFT、RL训练。
  • OpenHands

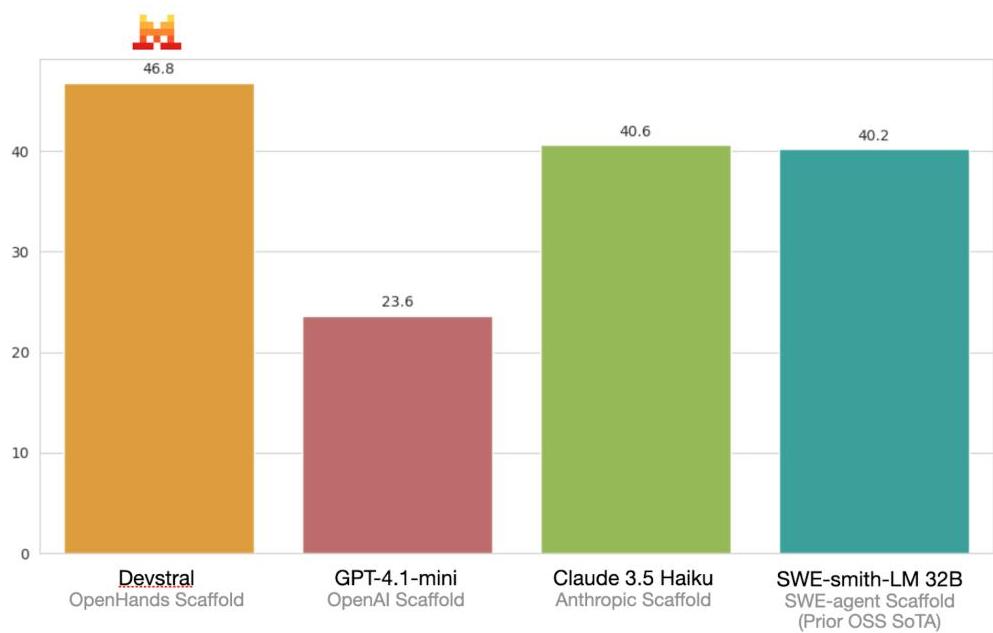
模型效果

  • Devstral-small-24B模型,SWE达46分,迭代式 Best-of-3指标。

❓问题背景

问题背景
  • 开源模型在代码片段生成效果好,但在复杂、多步骤SWE任务表现不好。
  • Coding Agent需要迭代开发、debug、集成软件工具等能力,大都依赖闭源模型。

核心方法(环境探索SFT数据+多阶段SFT+RL) ​

📕核心方法

核心方法

模型架构

  • 基于Mistral-Small3 开发:24B,40层,GQA,128k

基于环境探索构建SFT数据

  • 目标:Cot推理+code执行能力
  • Agent框架:OpenHands CodeAct scaffold;SWE环境:SWE-Gym
  • 模型基于以上环境去探索,基于单元测试验证,仅保留高质量正确轨迹数据。

Post-Train(SFT+RL)

  • SFT:大量数据微调(简单过滤),高质量数据微调(严格过滤)
  • RL:使用SFT模型生成新数据,再去做RL训练。
  • 论文不清楚。

实验设置(SFT+RL) ​

✍️实验设置

实验设置

基础模型

  • Mistral-Small3 24B

训练任务/数据

  • 没说

评测任务/数据 (SWE-Verified)

  • OpenHands Scaffold:安全的沙盒环境,代码、bash、网页浏览(本实验禁用)。

  • Best-of-3作为pass@1:第1次(温度=0),第2、3次(温度=0.1)

    • 一般做法:多次取avg 作为pass@1
  • 评测时的交互轮数:50轮效果好,100轮也没有提升。30轮低10个点。

算法/策略

  • SFT + RL
  • OpenHands

超参

  • 128k

关键结果(Devstral-small-24B + SFT+RL) ​

🍑关键结果

关键结果

模型效果

  • Devstral-small-24B SWE达46分,超越一众顶尖模型。
    • Qwen3-235B(25), DeepseekR1V3(40+), GPT-4.1-mini(23.6), Claude3.5-Haiku(40.6)。

重要结论

  • 评测交互轮数:50轮 效果好46分,30轮仅36分。
  • 温度0.1和0.4比较好,0.7和1.0反而Pass@4还低了。

⛳ 未来方向

未来方向
  • 新版本优化:2507比2505好
    • 优化数据生成和筛选过程:提升数据质量
      • 微调数据过滤机制:可能不仅看是否单元测试,还会看代码风格、步骤冗余度等。
    • 不同脚手架支持:构造伪脚手架.
    • 多格式训练:增加XML格式、原生函数调用格式等。

(2502) SWE-RL (Meta) ​

🌺 论文摘要

SWE-RL 摘要

参考链接

核心方法

  • GithubPR数据收集构建方法:仓库事件克隆 + PR聚合 + 预测相关文件 + 数据过滤
    • SWE-RL PR数据:27.3w
  • AgentSFT数据合成方法:PR种子筛选 + 定位数据合成 + 编辑数据合成
  • SWE-RL方法:LLama3-70B + GRPO,不执行环境,采用Patch相似度来做奖励信号
  • Agentless Scaffold

模型效果(LLaMA3-70B, RL, SWE-Verified)

  • LLama3-SWE-RL-70B:SWE-Verified 41分,在100B模型下效果最好,
  • SFT 达36.2分,效果也不错。
  • 未使用闭源LLM蒸馏技术,纯开源数据。

重要结论

  • RL比SFT效果好。
  • Best-of-N 越大越好,但后期逐渐收敛。
  • DenseReward 比Sparse Reward好。

整体流程如下

问题背景 ​

❓问题背景

问题背景

问题

  • SWE 进展:repo-level 代码生成、Issue Resolution(SWE Bench)。
  • SWE-Bench:主要依赖私有模型GPT-4o, Calude-3.5,开源模型很少。
    • DeepSeekR1 RuleRL很强,但是SWE任务效果不行。
  • 传统规则奖励难以直接应用到SWE任务。
    • 数学:EM匹配;
    • 代码:竞赛题,单代码文件、容易执行;SWE:有依赖,不是自包含的。

SWE 相关工作

  • (2411)Lingma-SWE-GPT:迭代开发过程,基于Qwen2.5-Coder-7B和Qwen2.5-72B-Instruct 构建。
  • (2412)SWE-gym:第一个用于开放训练的环境,提升Qwen2.5-Coder-7B/32B效果。
  • (2501)SWE-fixer:微调Qwen2.5 base,提升best@1性能。

GitHub PR数据收集构建方法 ​

Github PR 数据 概览
  • 最终:27.3w 高质量 Gihub PR
  • 每个PR包含:
    • Issue描述:问题
    • Code Context:所有相关文件 (需要修改 + 不需要修改的)
    • Oracle Patch:GT解决方法
Github PR数据收集构建方法

Github Events Clone

  • 目标PR数据:PR中的所有事件、PR之前的源代码。
  • 通过 GHAchive 拉取事件:1501-2412共10年数据
  • 通过GitClone 仓库:包含历史所有commit,共460w repo。

PR 数据聚合

  • 从PR出发,关联Github事件和代码库,仅保留已合并的PR,聚合以下内容
    • Issue、用户讨论、Review Comment、出事代码、Commits、代码变更。
  • 保存从merge base到 head commit所有的中间提交和代码变更
  • 扫描所有PR,识别Issue并与对应PR 匹配 (Prompt, Response)。累计 240w PR。

预测相关但未修改文件

  • 问题
    • 目前PR仅包含被修改过的文件,但实际预测会检索到很多无关文件
    • 如果训练时,只看修改文件,会产生bias。
  • 方法
    • 根据Issue+已修改文件,使用Prompt+LLM预测 相关但未被修改的文件列表
    • 把这部分 相关但未修改文件列表 加入数据集中。

数据过滤

  • 背景:PR有噪音,需剔除有害PR。但允许一定噪音,尽量召回高质量PR。
  • 过滤规则:
    • 过滤机器人PR
    • 过滤变更极大的PR
    • 细粒度过滤:检查每个代码块 Hunk (参考CodeLLaMA ),确保是在写代码,去掉版本、锁定等内容。
  • 最终:1100w PR -> 27.3w 高质量PR

AgentSFT 数据合成 ​

SFT 数据合成

PR 种子数据筛选

  • 收集高质量PR种子数据:启发式规则筛选

问题定位数据-合成

  • LLM合成
    • 输入:Issue描述 + 仓库结构 + 目标编辑文件 + 相关文件
    • 输出: CoT推理生成需要编辑的文件。
    • LLama-3.3-70B-Instruct
  • 过滤:仅保留推理正确的答案

代码编辑数据-合成

  • LLM 合成
    • 输入:标准答案和Patch,
    • 输出: Search/Replace格式的代码编辑数据。
  • 过滤:保留格式正确 且 search/replace内容正确 (能搜索到)的数据。

相关工作

核心方法 ​

任务Prompt 设计 ​

Prompt 设计

整体

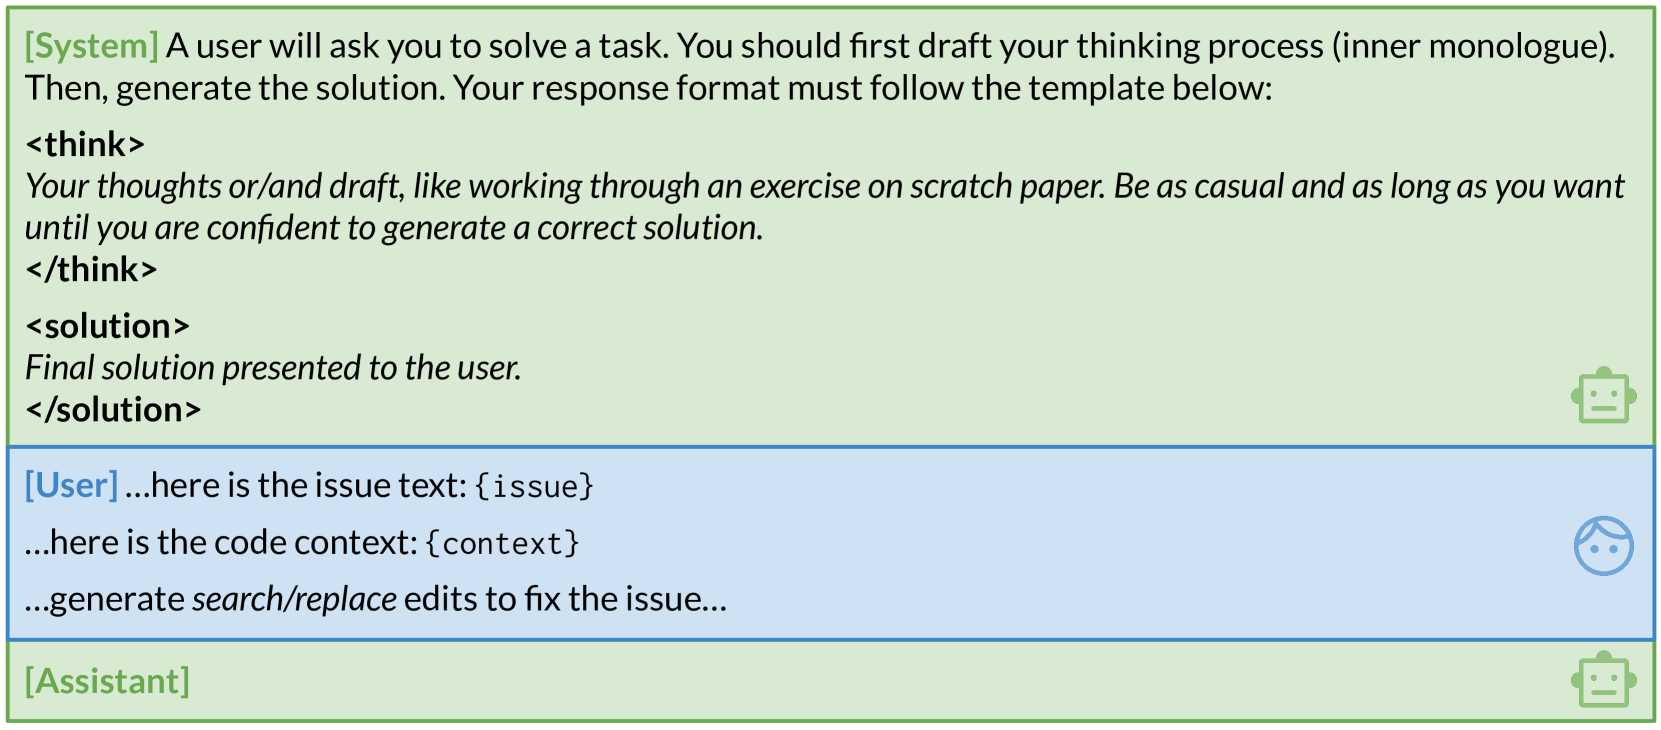
  • Reasoning + Tool Use 风格。prompts.py
  • THINKING_SYSTEM + AGENTLESS_REPAIR

THINKING_SYSTEM

  • 强调输出思考过程

AGENTLESS_REPAIR

  • --- BEGIN ISSUE ---:{problem_statement},Issue 定义
  • --- BEGIN FILE ---:{content},包含相关文件的全部源代码
  • 任务指令:先定位、再修复
  • 输出格式:Search/Replace 协议,严格的Diff格式
  • 样例:

输出样例

python
```python
### mathweb/flask/app.py
<<<<<<< SEARCH
from flask import Flask
=======
import math
from flask import Flask
>>>>>>> REPLACE
```

RL 设计 ​

📕核心方法

核心方法

任务

  • 给定Issue +上下文,进行推理,生成代码变更,把代码变更应用到Patch中。

奖励

  • 不去真正执行,而是对比Patch 相似度。Python.difflib.SequenceMatcher。reward={−1,格式不正确compare(patchpred,patchgt),格式正确

算法

  • GRPO + KLLoss

训练和测试存在不同点 ​

训练vs测试不同点

训练

  • 给出所有相关代码文件,隐式强迫模型先找Bug、再做修复。

评测时 (Agentless mini 框架)

  • 完整Pipeline
    • Step1 文件定位:bug在哪个文件?
    • Step2 测试生成:生成测试用例,来复现bug
    • Step3 回归测试:挑出哪些旧测试用例跑一遍,防止改坏了别的地方。
    • Step4 修复代码:请写出修复代码
  • SWE-RL 训练时仅有4,没有1、2、3。但在测试时,有泛化性。

实验设置(RL) ​

✍️实验设置

实验设置

基础模型

  • Llama-3.3-70B-Instruct

训练任务/数据

  • RL:27.3w 构建的PR数据
  • SFT(Baseline):合成代码编辑SFT数据 + LLama3代码SFT数据 + LLama3通用SFT数据

评测任务/数据

  • SWE-Bench-Verified。
  • 温度=1,每个问题生成500个patch
  • 使用top-30测试用例去测试排序,选择第1名的patch去报告 pass@1,其实是Best-of-N。

算法/策略

  • GRPO,混合SFT(Baseline)

Scaffolding

  • 基于Agentless开发的简化Agentless mini,专注于文件级定位

超参

  • 16k 上下文,batch_size=32,rollout=16,real_batch_size=512
  • 512 张H100,32小时。

关键结果(LLaMA-3-70B + RL) ​

🍑关键结果

关键结果

模型效果(LLaMA3-70B, RL, SWE-Verified)

  • LLama3-SWE-RL-70B:SWE-Verified 41分,在100B模型下效果最好,
  • SFT 达36.2分,效果也不错。
  • 未使用闭源LLM蒸馏技术,纯开源数据。

重要结论

  • 测试 Best-of-N N越大效果越好,后期逐渐收敛。20 -> 160 -> 500:33.6 -> 40 -> 41
  • DenseReward比Sparse 效果好一些,促进格式和修复。

未来方向 ​

⛳ 未来方向

未来方向
  • 奖励太僵硬:奖励仅靠GT相似度会限制模型探索其他方案,没有真正的执行奖励。
  • 定位粗糙:Agentless Mini 缺乏复杂上下文信息。
  • 流程割裂:Agentless 固定Pipeline,但理想Agent应该是E2E的。

(2405) SWE-agent ​

🌺 论文摘要

SWE-agent 摘要

参考链接

核心方法

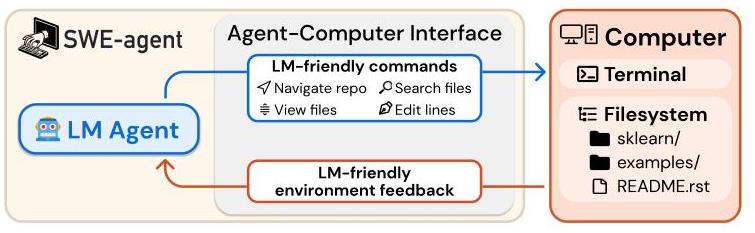
  • 设计Agent-Computer-Interface 范式

模型效果

  • 基于SWE-Agent框架,GPT4-Turbo,SWE-Full-12分,Light-18分
  • SWE-Agent比标准Shell提高7pt,比RAG提高16pt。

📕核心方法

ACI 接口 ​

Agent-Computer-Interface 范式

搜索和导航工具

  • find_file, search_file, search_dir ..

文件查看器

  • open, scroll_down, scroll_up, goto等

智能文件编辑器

  • edit:在单次操作中进行范围替换,启动自动静态代码检查等(flake8工具)

上下文管理

  • 采用ReAct框架,每个步骤模型给出思考和行动,
  • 仅保留最近5轮交互,历史观察折叠显示,降低上下文窗口压力。

实验设置 ​

✍️实验设置

实验设置

基础模型

  • GPT-4 Turbo (gpt-4-1106-preview)
  • Claude 3 Opus (claude-3-opus-20240229)

训练任务/数据

  • 无训练

评测任务/数据

  • SWE-bench (Full & Lite):真实Python问题,2.2k-Full, 300-Lite
  • HumanEvalFix:代码调试/修复任务。

算法/策略

  • SWE-agent:基于 ACI 的交互式 Agent。
  • Shell-only:基线 Agent,仅使用标准 Linux Shell。
  • RAG:基线方法,检索相关文件后直接生成补丁(非交互)。

超参

  • 上下文窗口限制:128k (GPT-4) / 200k (Claude 3)。
  • 预算限制:每个任务最多 $4.00 推理成本。

关键结果 ​

🍑关键结果

关键结果
  • SWE-Agent 通过ACI显著提升SWE分数,GPT4-Turbo分数如下:
    • SWE-Agent:Full-12分,Lite-18分。
    • 标准Shell:FUll-, Lite-11分。
    • RAG:Full-1.3分,Lite-2.67分。
  • SWE-Agent:HumanEvalFix 87.7% pass@1
  • 消融实验
    • Linter:移除编辑时语法检查,会下降3pt
    • 搜索工具:总结性工具比没有搜索工具或繁杂迭代搜索工具效果好。
    • 文件查看:显示100行 比 全部显示 或 仅显示30行 好。

未来方向 ​

⛳ 未来方向

未来方向
  • 工具扩展:引入更多开发工具,如网页浏览(用于查阅文档)或静态分析工具。
  • 自动化 ACI 设计:目前 ACI 是手动设计的,未来可探索自动化生成针对特定模型或领域最优的接口。
  • 跨领域应用:将 ACI 的设计原则(简化命令、压缩反馈、错误护栏)应用到数据分析、网页导航等其他 Agent 领域。
  • 安全性:研究在沙盒环境中限制 Agent 的行为,防止生成恶意代码或误删文件。
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026