cs231n线性分类器和损失函数
📅 发表于 2017/11/27
🔄 更新于 2025/07/23
👁️ — 次访问
📝 857 字
⏳ 4 分钟
cs231n
#cs231n
#线性分类
#svm
线性分类器,svm和交叉熵损失函数
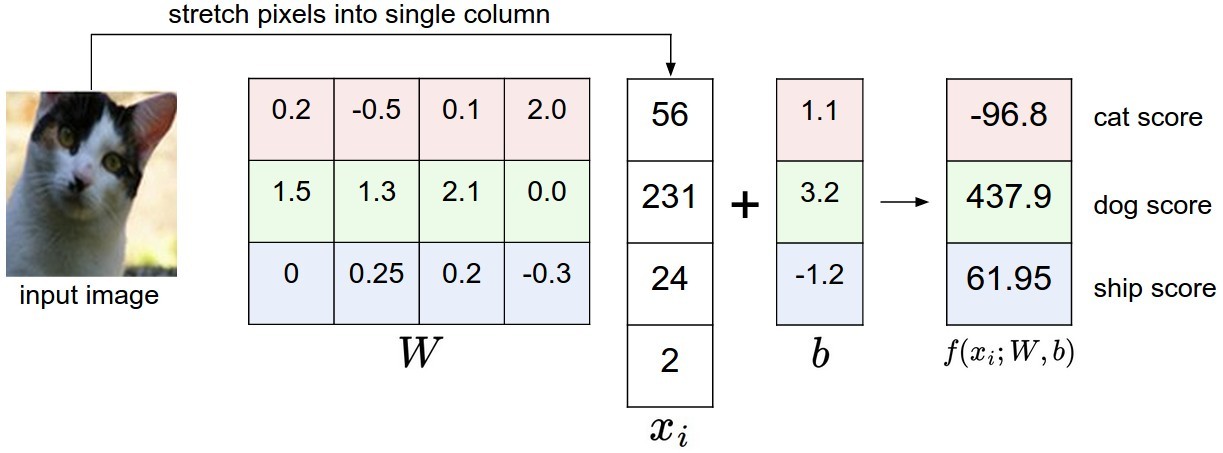
图片是三维数组,元素在0-255的整数。宽度-高度-3 ,3代表RGB颜色通道。 对图像进行零中心化。
输入图片
分析
score为x添加一维,
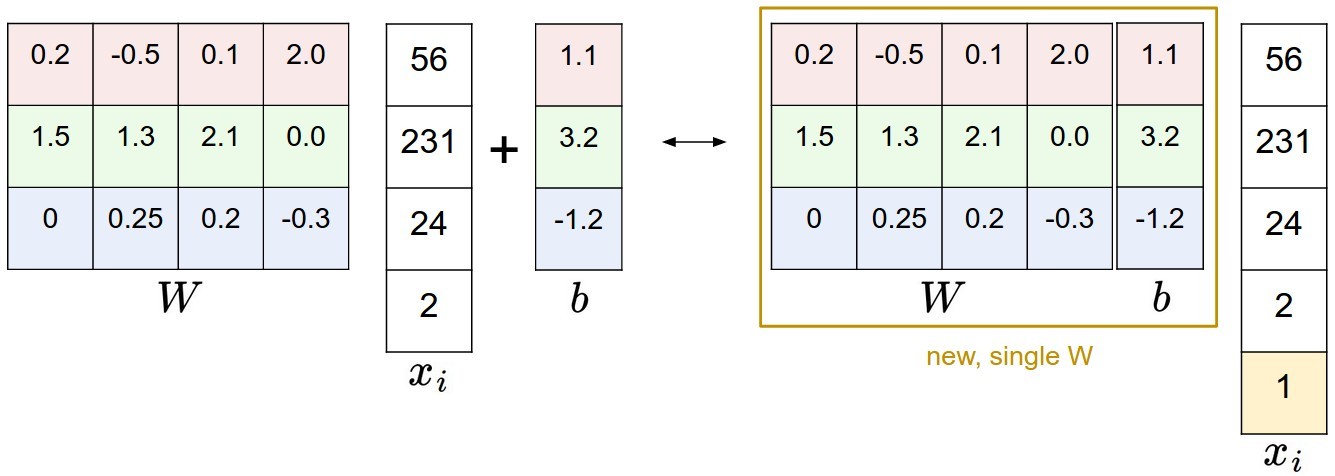
权重
输入4个像素,函数会根据权重对某些位置的某些颜色表现出喜好或者厌恶(正负)。
比如船类别,一般周围有很多蓝色的水,那么蓝色通道的权值就会很大(正)。绿色和红色就比较低(负)。那么如果出现绿色和红色的像素,就会降低是船的概率。
权重解释2
模板(原型), 用图像和模板去比较,计算得分(点积),找到最相似的模板。
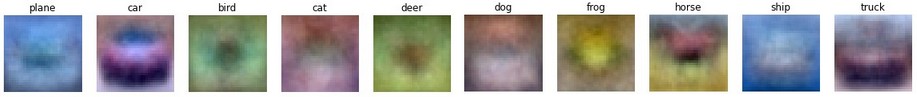
线性函数
实际上,每个输入点,线性函数就是对这些点进行边界决策分类。 与线的距离越大,得分越高。
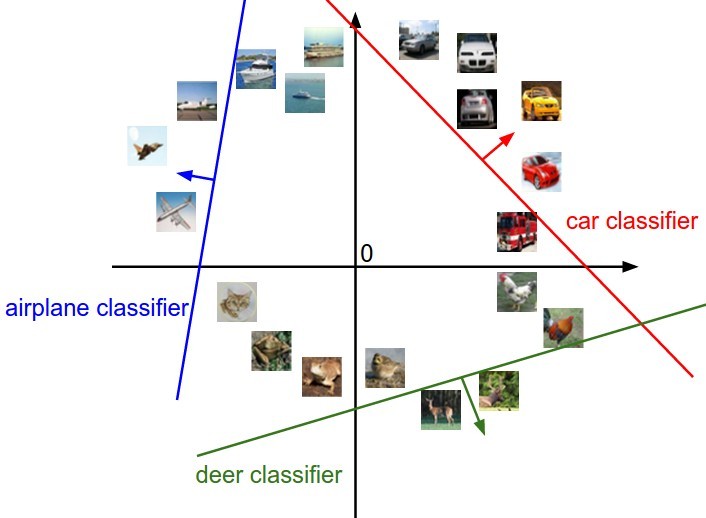
最常用两个分类器:SVM和Softmax。分别使用SVM loss和交叉熵loss。
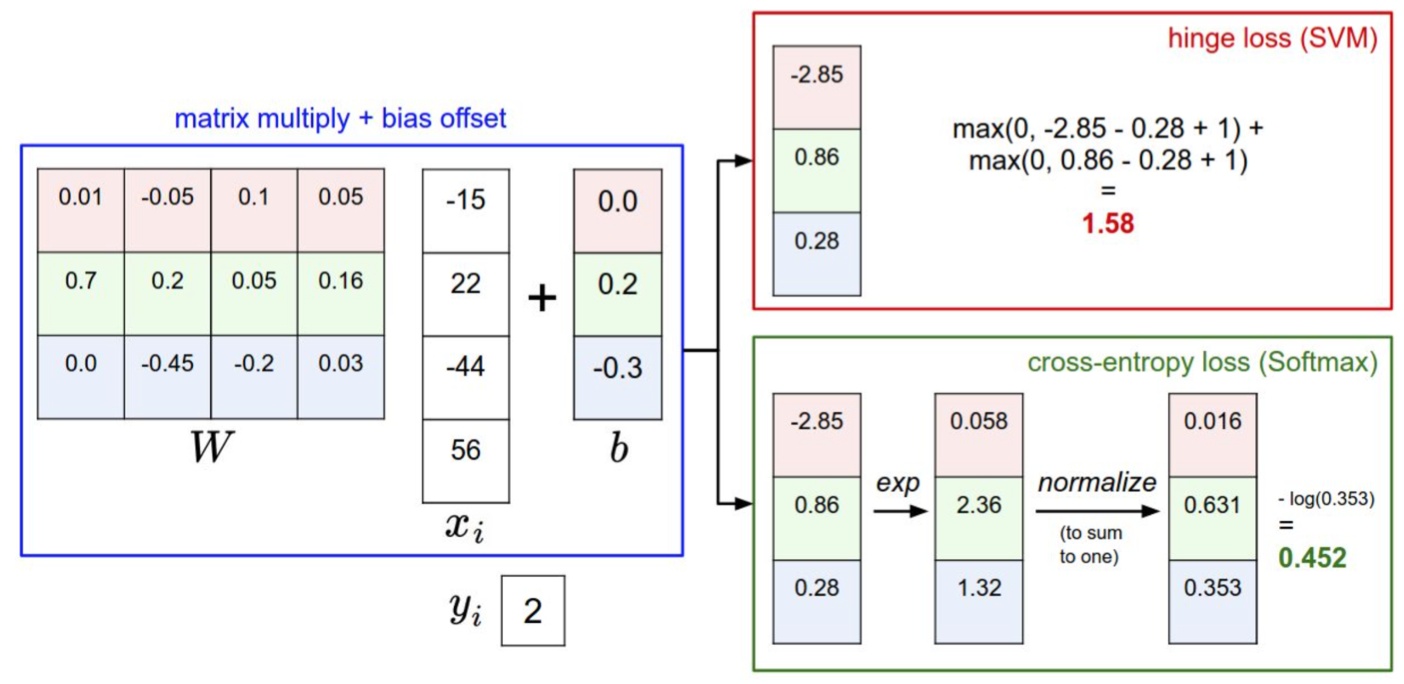
多类支持向量积损失(Multiclass Support Vector Machine)。正确分类比错误分类的得分高出一个边界值
记得分为折叶损失 hinge loss, 也称作max margin loss ,如下:
如果错误分类进入红色区域,就开始计算loss。
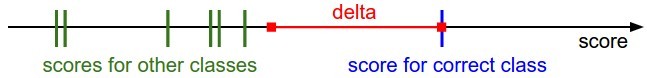
第
使用L2正则化,对正则化loss(正则化惩罚)如下:
最终loss就是数据损失+正则化损失, 正则化强度。
引入正则化以后,SVM就有了最大边界max margin 这一个良好性质。(不是很懂,后面再解决)
每个类别的得分
Softmax函数求得
单个数据的loss,就是取**其概率的负对数 ** :
从直观上看,最小化loss就是要最大化正确的概率(最小化正确分类的负对数概率),最小化其它分类的概率。
交叉熵的体现
程序会预测一个所有类别的概率分布
由于KL距离 。也就是说想要两个概率分布一样,即预测的所有概率密度都在正确类别上面。
结合正则化
结合正则化
最小化正确概率分类的负对数概率,就是在进行最大似然估计。正则化部分就是对W的高斯先验,这里进行的是最大后验估计。(不懂)
SVM loss:希望正确分类比其他分类的得分高出一个边界值。
Softmax 交叉熵loss:希望正确分类概率大,其它分类概率小。