Skip to content

神经网络基础-反向传播-激活函数

📅 发表于 2017/11/23
🔄 更新于 2025/07/23
👁️ — 次访问
📝 1826 字
⏳ 7 分钟
自然语言处理
#神经网络
#反向传播
#激活函数

cs224n神经网络基础,前向反向传播,激活函数等

神经网络基础 ​

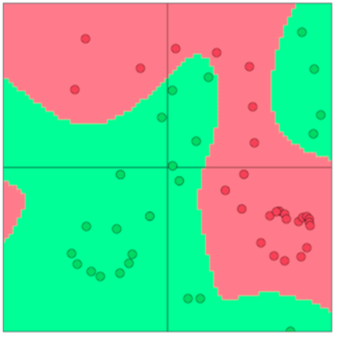
很多数据都是非线性分割的,所以需要一种非线性non-linear决策边界 来分类。神经网络包含很多这样的非线性的决策函数。
神经元 ​

神经元其实就是一个计算单元。

  • 输入向量 x∈Rn
  • z=wTx+b
  • a=f(z) 激活函数,sigmoid, relu等,后文有讲。

Sigmoid神经元

传统用sigmoid多,但是现在一定不要使用啦。大多使用Relu作为激活函数。
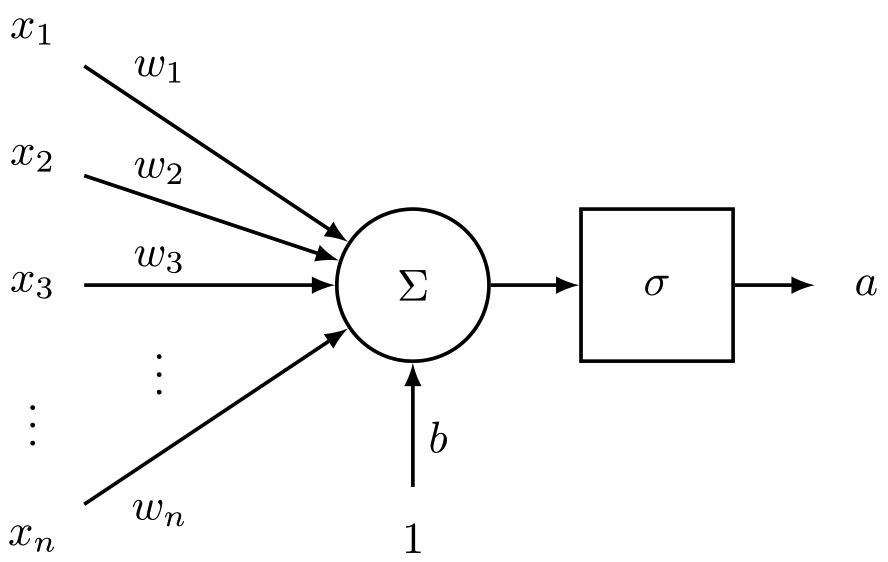
z=wTx+b,a=11+exp⁡(−z)

网络层 ​

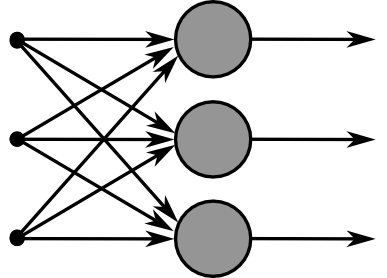
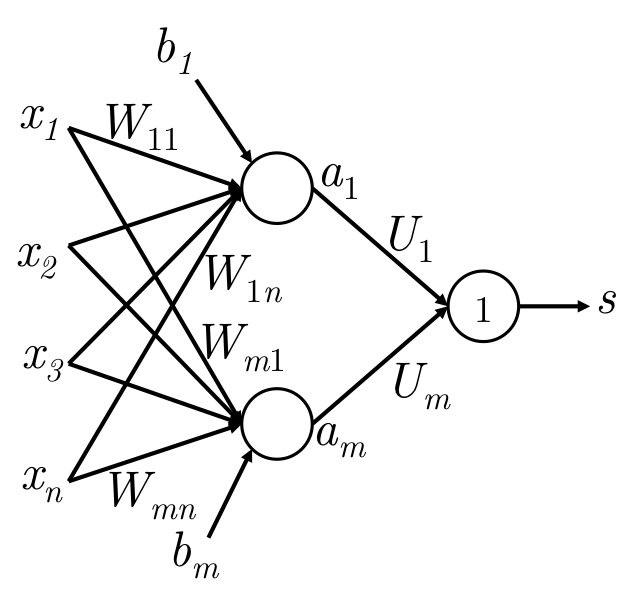
一个网络层有很多个神经元。输入x向量,会传递到多个神经元。如

输入是n维,隐层是m维,有m个神经元。则有

z=Wx+b,W∈Rm×n,x∈Rn,b∈Rma=f(z)a∈Rms=UTa一般会对a进行变换得到最终结果s

激活函数的意义

每个神经元

  • 输入z=wTx+b :对特征进行加权组合的结果
  • 激活a=f(z): 对z是否继续保留

最后会把所有的神经元的所有z的激活信息a综合起来,得到最终的分类结果。比如s=UTa。

前向计算 ​

输入x∈Rn, 激活信息a∈Rm。一般前向计算如下:

z=Wx+b,W∈Rm×n,x∈Rn,b∈Rma=f(z)a∈Rms=UTa一般会对a进行变换得到最终结果s

下面是一个简单的全连接,最后的圆圈里的1代表等价输出。

NER例子

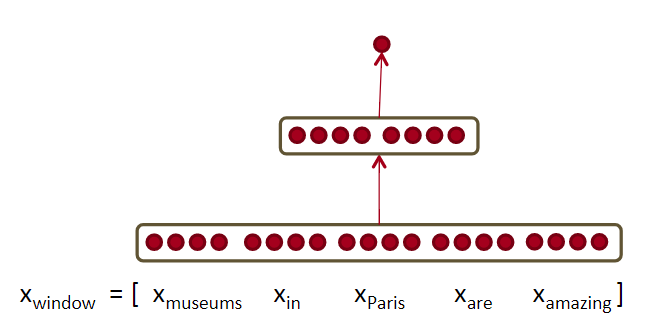
NER(named-entity recognition),命名实体识别。对于一个句子Museums in Paris are amazing。 要判断中心单词Paris是否是个命名实体。

既要看window里的所有词向量,也要看这些词的交互关系。比如:Paris出现在in的后面。 因为可能有Paris和Paris Hilton。这就需要non-linear decisions。

如果直接把input给到softmax,是很难获取到非线性决策的。所以需要添加中间层使用神经网络。如上图所示。

维数分析

每个单词4维,输入整个窗口就是20维。在隐层使用8个神经元。计算过程如下,最终得到一个分类的得分。

z=Wx+ba=f(z)s=UTa

维数如下:

x∈R20,W∈R8×20,U∈R8×1,s∈R

Max magin目标函数 ​

正样本s :Museums in Paris are amazing ,负样本sc: Not all museums in Paris 。

只关心:正样本的得分高于负样本的得分, 其它的不关注。即要s−sc>0:

maxmize(s−sc)↔minmize(sc−s)

优化目标函数如下:

minimizeJ=max(sc−s,0)={sc−s,s<sc0,s≥sc

上式其实有风险,更需要s−sc>Δ, 即s比sc得分大于Δ,来保证一个安全的间距。

minimizeJ=max(Δ+sc−s,0)

给具体间距Δ=1, 所以优化目标函数:详情见SVM。

minimizeJ=max(1+sc−s,0)

其中sc=UTf(Wxc+b),s=UTf(Wx+b) 。

反向传播训练 ​

梯度下降 ,或者SGD:

θ(t+1)=θ(t)−α⋅Δθ(t)J

反向传播 使用链式法则 来计算前向计算中用到的参数的梯度。

符号定义 ​

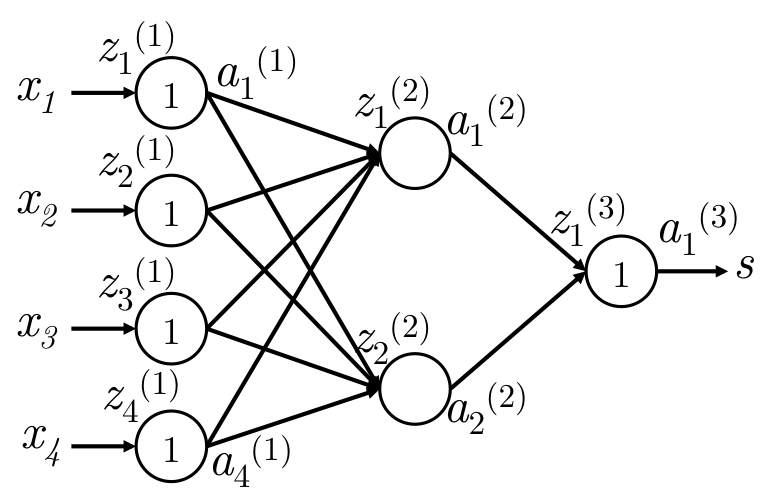
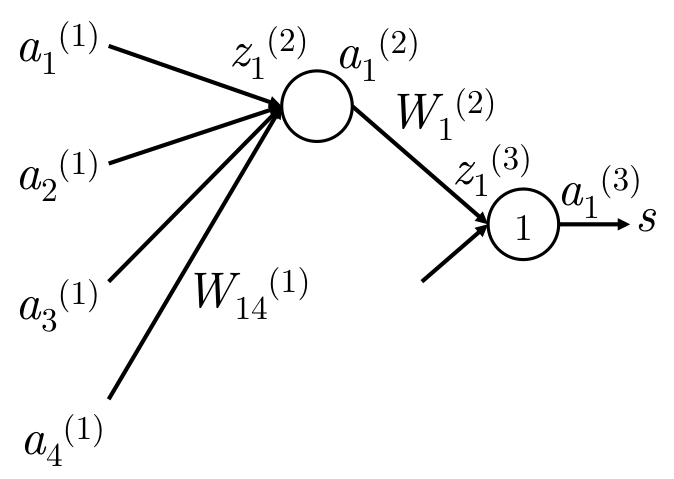
如下图,一个简单的网络:

网络在输入层和输出层是等价输入和等价输出,只有中间层会使用激活函数进行非线性变换。

符号意义
x网络输入,这里是4维
s网络输出,这里是1维,即一个数字
W(k)第k→k+1层的转移矩阵。W∈Rn×m。 k层m个神经元,k+1层n个神经元
Wij(k)k+1层的i 神经元 到 到k层j神经元的 的权值
bi(k)k→k+1 转移, k+1层的i 神经元的接收偏置
zj(k)第k层的第j个神经元的输入
计算输入zj(k+1)=∑iWji(k)⋅ai(k)+bj(k)
aj(k)第k层的第j个神经元的输入。a=f(z)
δj(k)BP时,在zj(k)处的梯度。即f′(zj(k))⋅g ,g是传递来的梯度

W梯度推导 ​

误差函数J=max(1+sc−s,0) ,当J>0的时候,J=1+sc−s要去更新参数W和b。

∂J∂s=−∂J∂sc=−1

反向传播时,必须知道参数在前向时所贡献所关联的对象,即知道路径。

这里是等价输出:

s=a1(3)=z1(3)=W1(2)a1(2)+W2(2)a2(2)

这里对Wij(1)的偏导进行反向传播推导:

∂s∂Wij(1)=∂W(2)a(2)∂Wij(1)=∂Wi(2)ai(2)∂Wij(1)=Wi(2)⋅∂ai(2)∂Wij(1)=Wi(2)⋅∂ai(2)∂zi(2)⋅∂zi(2)∂Wij(1)=Wi(2)⋅f′(zi(2))⋅∂∂Wij(1)(bi(2)+∑k4ak(1)Wik(1))=Wi(2)f′(zi(2))aj(1)=δi(2)⋅aj(1)

结果分析

我们知道zi(2)=∑k4ak(1)Wik(1)+bi(2)。 单纯zi(2)对Wij(2)的导数是aj(1)。反向时,在zi(2)处的梯度是δi(2)。

反向时,∂s∂Wij(1)=δi(2)⋅aj(1),是传来的梯度和当前梯度的乘积。这正好应证了反向传播。 传来的梯度也作error signal。 反向过程也是error sharing/distribution。
W元素实例 ​

W14(1) 只直接贡献于z1(2)和a1(2)

步骤梯度
s→a1(3)梯度g=1。开始为1。
a1(3)→z1(3)在z1(3)处的梯度g=1⋅1=δ1(3) 。localg=1 ,等价变换
z1(3)→a1(2)g=δ1(3)⋅W1(2)=W1(2) 。lg=w, z=wa+b
a1(2)→z1(2)g=W1(2)⋅f′(z1(2))=δ1(2)。 lg=f′(z1(2))
z1(2)→W14(1)g=W1(2)⋅f′(z1(2))⋅a4(1)=δ1(2)⋅a4(1)。 lg=a4(1) , 因为z=wa+b
z1(2)→b1(1)g=W1(2)⋅f′(z1(2))⋅1=δ1(2)⋅a4(1)。 lg=1 , 因为z=wa+b

对于上式的梯度计算,有两种理解方法,通过这两种思路去思考能更深入了解。

  • 链式法则
  • error sharing and distributed flow approach
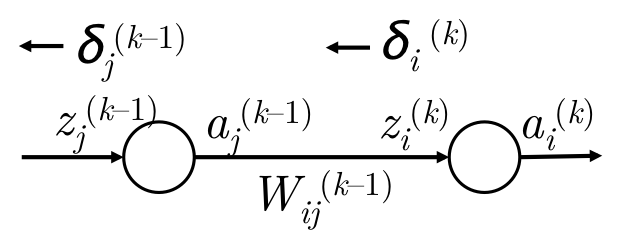
梯度反向传播 ​

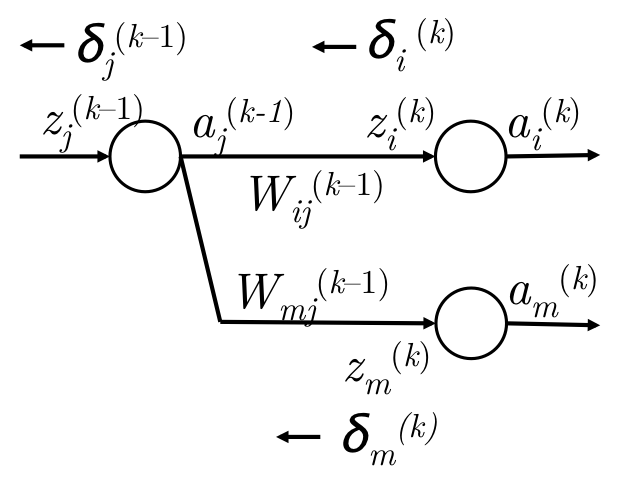
δi(k)→δj(k−1) 传播图如下:

但是更多时候,当前层的某个神经元的信息会传播到下一层的多个节点上,如下图:

梯度推导公式如下:

gw=δi(k)⋅aj(k−1)Wij(k−1)的梯度ga=∑iδi(k)Wij(k−1)aj(k−1)的梯度gz=δj(k−1)=f′(zj(k−1))⋅∑iδi(k)Wij(k−1)zj(k−1)的梯度

BP向量化 ​

很明显,不能一个一个参数地去更新element-wise。所以需要用矩阵和向量去表达,去一次性全部更新matrix-vector level。

梯度计算, Wij(k)的梯度是δi(k+1)⋅aj(k) 。向量表达如下:

ΔW(k)=[δ1(k+1)⋅a1(k)δ1(k+1)⋅a2(k)⋯δ2(k+1)⋅a1(k)δ2(k+1)⋅a2(k)⋯⋮⋮⋱]=δ(k+1)a(k)T

梯度传播,δj(k)=f′(zj(k))⋅∑iδi(k+1)Wij(k)。向量表达如下:

δ(k)=f′(z(k))∘(δ(k+1)W(k))

其中∘是叉积向量积element-wise,是各个位置相乘, 即RN×RN→RN。 点积和数量积是各个位置相乘求和。

计算效率

很明显,在计算的时候要把上一层的δ(k+1)存起来,去计算δ(k) ,这样可以减少大量的多余的计算。

神经网络常识 ​

梯度检查 ​

使用导数的定义来估计导数,去和BP算出来的梯度做对比。

f′(θ)≈J(θ(i+))−J(θ(i−))2ϵ

由于这样计算非常,效率特别低,所以只用这种办法来检查梯度。具体实现代码见原notes。

激活函数 ​

激活函数有很多,现在主要用ReLu,不要用sigmoid。

用ReLU学习率一定不要设置太大!同一个网络中都使用同一种类型的激活函数。

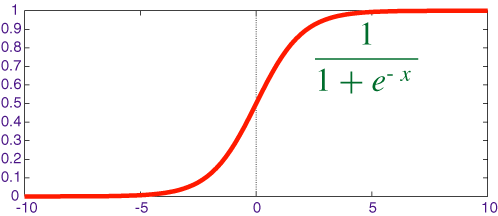
Sigmoid ​

数学形式和导数如下:

σ(z)=11+exp⁡(−z),σ(z)∈(0,1)σ′(z)=σ(z)(1−σ(z))

图像

优点是具有好的解释性,将实数挤压到(0,1)中,很大的负数变成0,很大的正数变成1 。但现在用的已经越来越少了。有下面2个缺点。

Sigmoid会造成梯度消失

  • 靠近0和1两端时,梯度会变成0。 BP链式法则,0×gfrom=0 ,后面的梯度接近0, 将没有信息去更新参数。
  • 初始化权重过大,大部分神经元会饱和,无法更新参数。因为输入值很大,靠近1了。f′(z)=0, 没法传播了。

Sigmoid输出不是以0为均值

  • 如果输出x全是正的,z=wx+b, 那么∂z∂w=x 梯度就全是正的
  • 不过一般是batch训练,其实问题也还好

Sigmoid梯度消失的问题最严重。

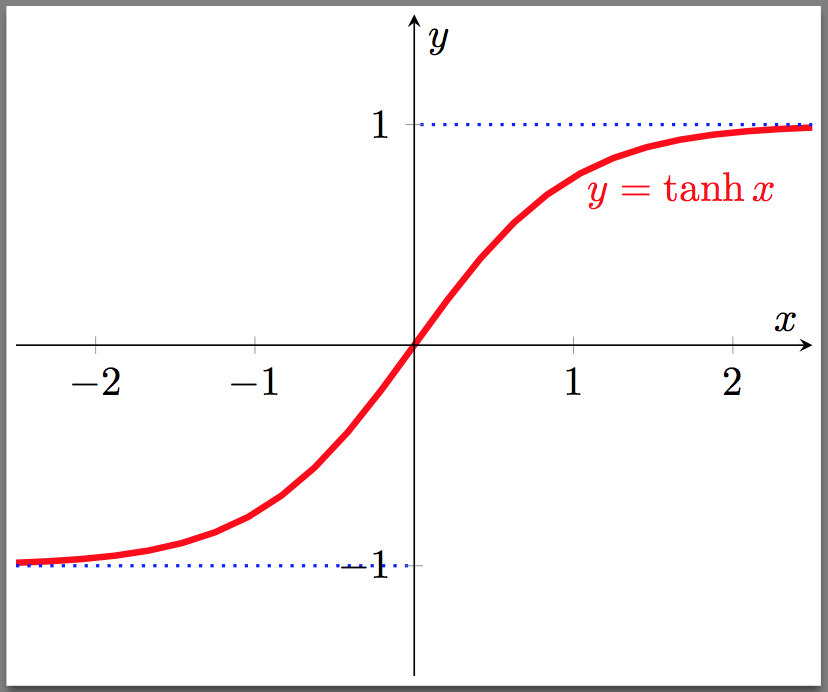
Tanh ​

数学公式和导数如下:

tanh⁡(z)=exp⁡(z)−exp⁡(−z)exp⁡(z)+exp⁡(−z)=2σ(2z)−1,tanh⁡(z)∈(−1,1)tanh′⁡(z)=1−tanh2⁡(z)

图像:

Tanh是Sigmoid的代替,它是0均值的,但是依然存在梯度消失的问题。

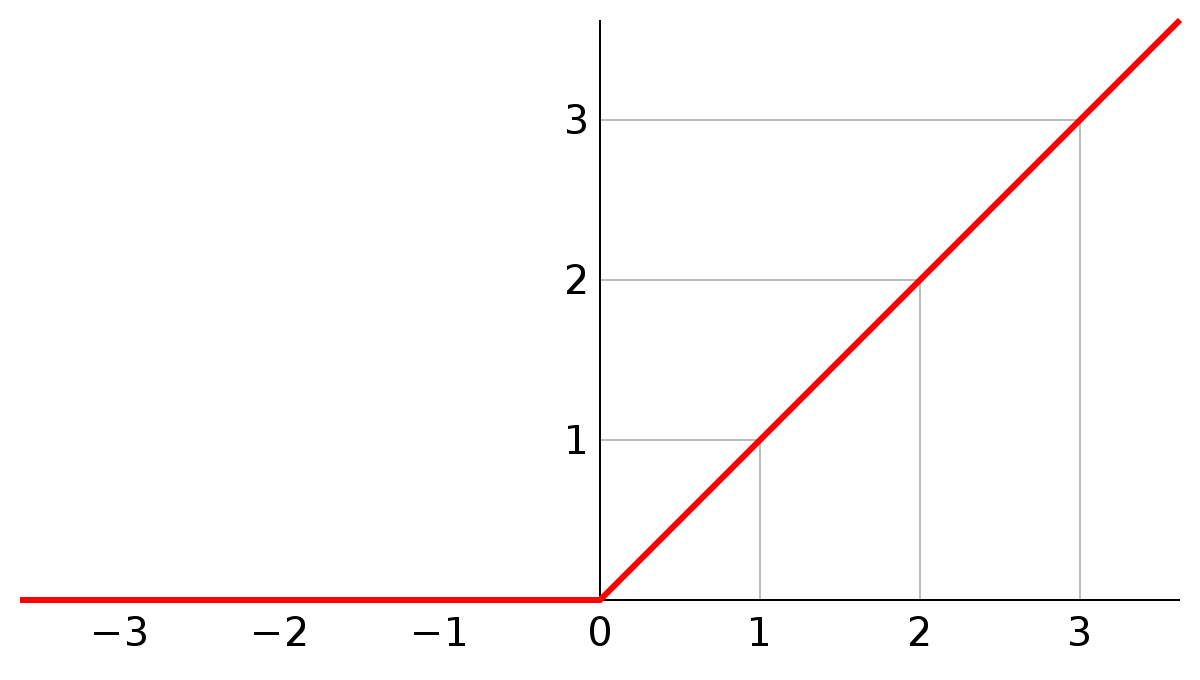
ReLU ​

ReLURectified Linear Unit 最近越来越流行,不会对于大值z就导致神经元饱和的问题。在CV取得了很大的成功。

rect(z)=max(z,0)rect′(z)={1,z>00,z≤0

其实ReLU是一个关于0的阈值,现在一般都用ReLU:

ReLU的优点

  • 加速收敛(6倍)。线性的,不存在梯度消失的问题。一直是1。
  • 计算简单

ReLU的缺点

训练的时候很脆弱

  • BP时,如果有大梯度经过ReLU,当前在z处的梯度δ(k+1)=1×gm 就很大
  • 对参数w的梯度 ΔW(k)=δ(k)a(k)T 也就很大
  • 参数w会更新的特别小 W(k)=W(k)−α⋅ΔW(k)
  • 前向时,z=wx+b≤0 也就特别小,激活函数就不会激活
  • 不激活,梯度就为0。
  • 再BP的时候,就无法更新参数了

总结也就是:大梯度→小参数w ,新小$z = wx+b \to $ ReLU不激活, 不激活梯度为0 → 不更新参数w了。

当然可以使用比较小的学习率来解决这个问题。

Maxout ​

maxout 有ReLU的优点,同时避免了它的缺点。但是maxout加倍了模型的参数,导致了模型的存储变大。

mo(x)=max(w1x+b1,w2x+b2)mo′(x)={w1,w1x+b1大w2,其它
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026