Skip to content

循环神经网络

📅 发表于 2017/10/18
🔄 更新于 2025/07/23
👁️ — 次访问
📝 1673 字
⏳ 7 分钟
深度学习
#RNN
#LSTM
#GRU

RNN, LSTM, GRU图文介绍,RNN梯度消失问题等

LSTM经典描述 ​

经典RNN模型 ​

模型

人类在思考的时候,会从上下文、从过去推断出现在的结果。传统的神经网络无法记住过去的历史信息。

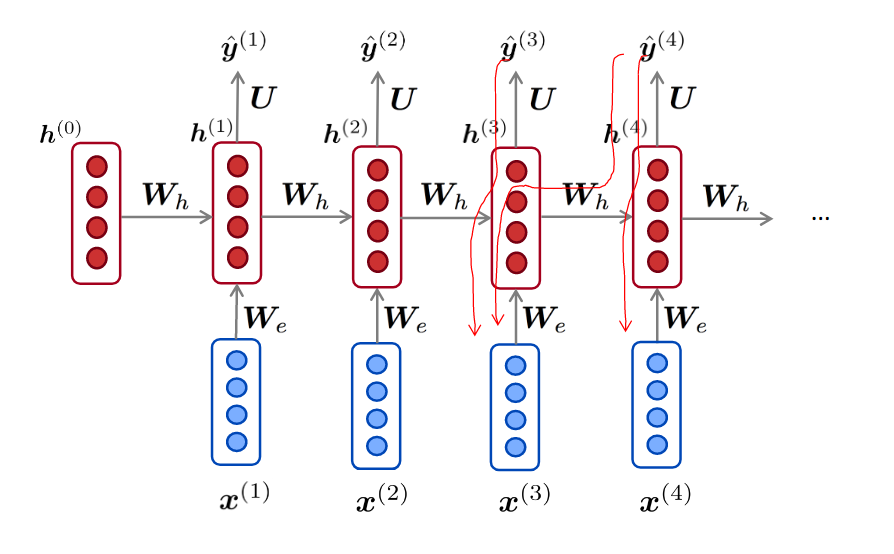
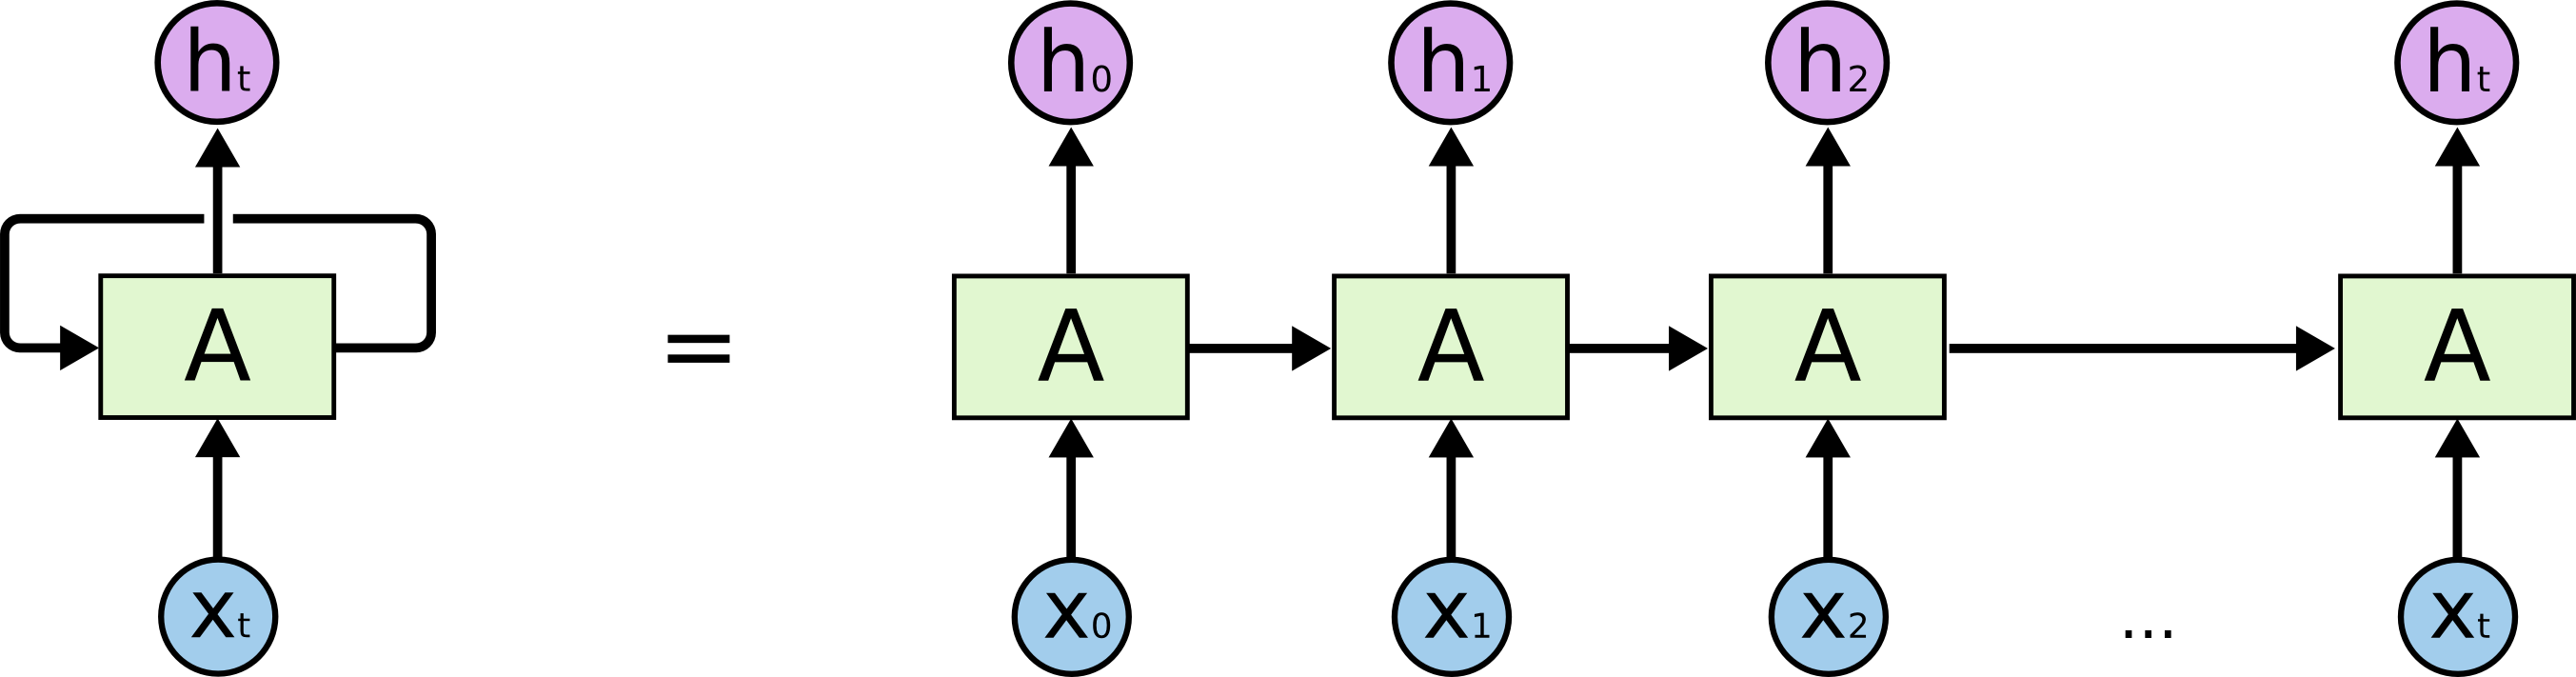
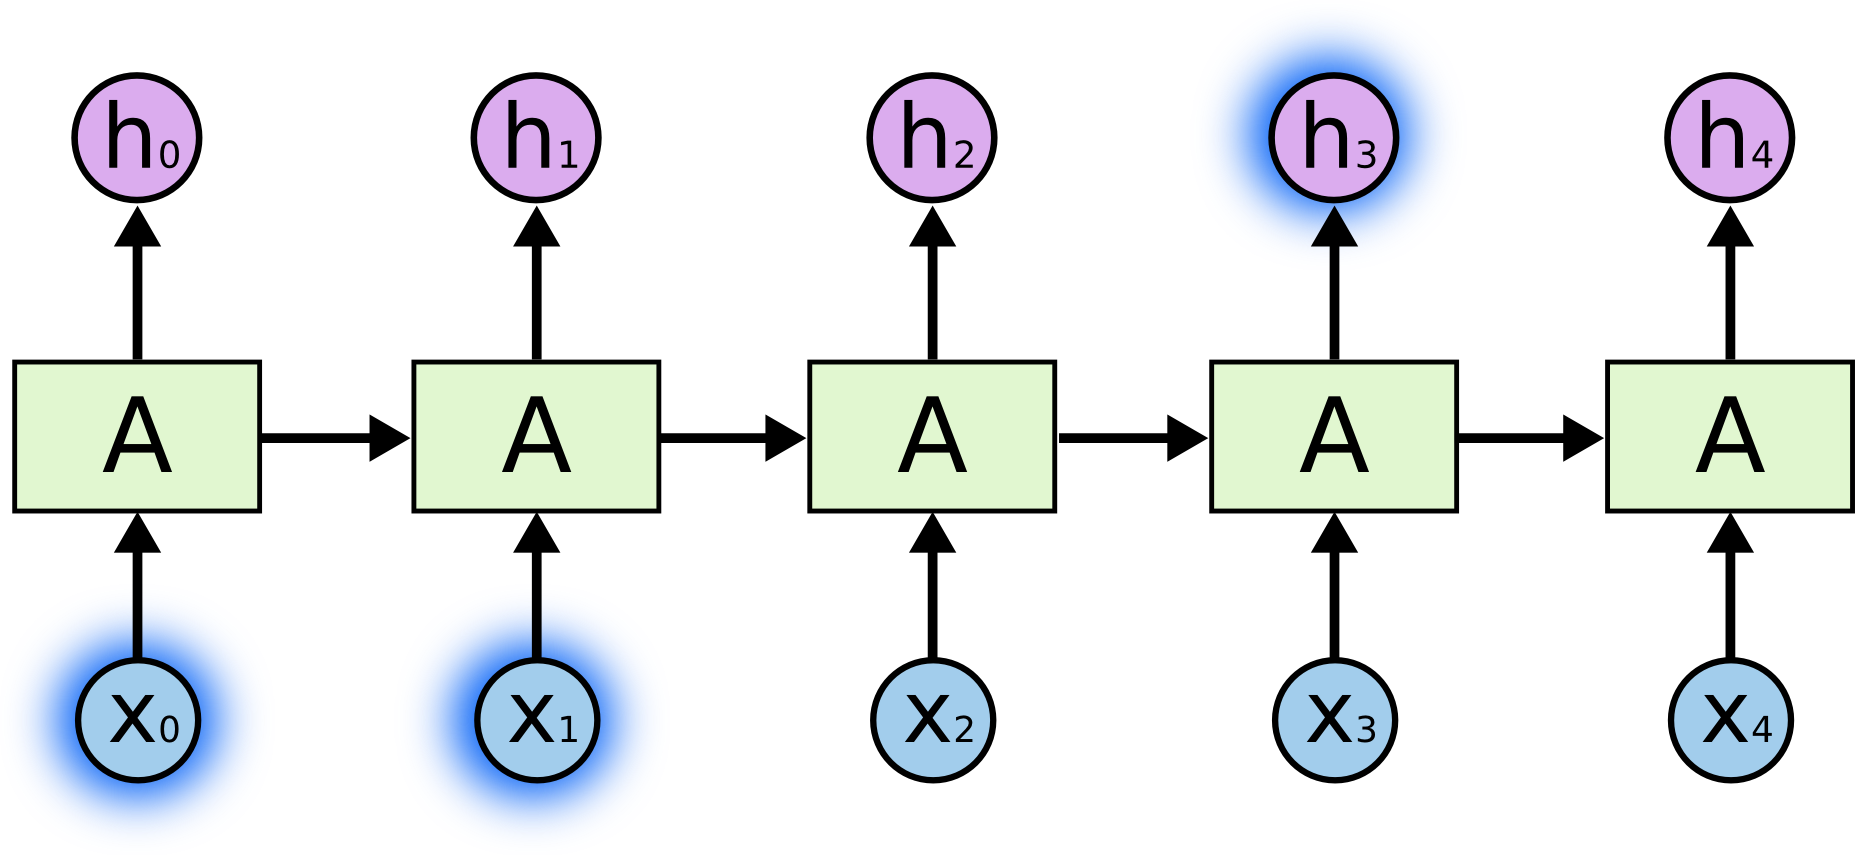
循环神经网络是指随着时间推移,重复发生的结构。它可以记住之前发生的事情,并且推断出后面发生的事情。用于处理时间序列很好。所有的神经元共享权值。如下图所示。
记住短期信息

比如预测“天空中有__”,如果过去的信息“鸟”离当前位置比较近,则RNN可以利用这个信息预测出下一个词为“鸟”
不能长期依赖

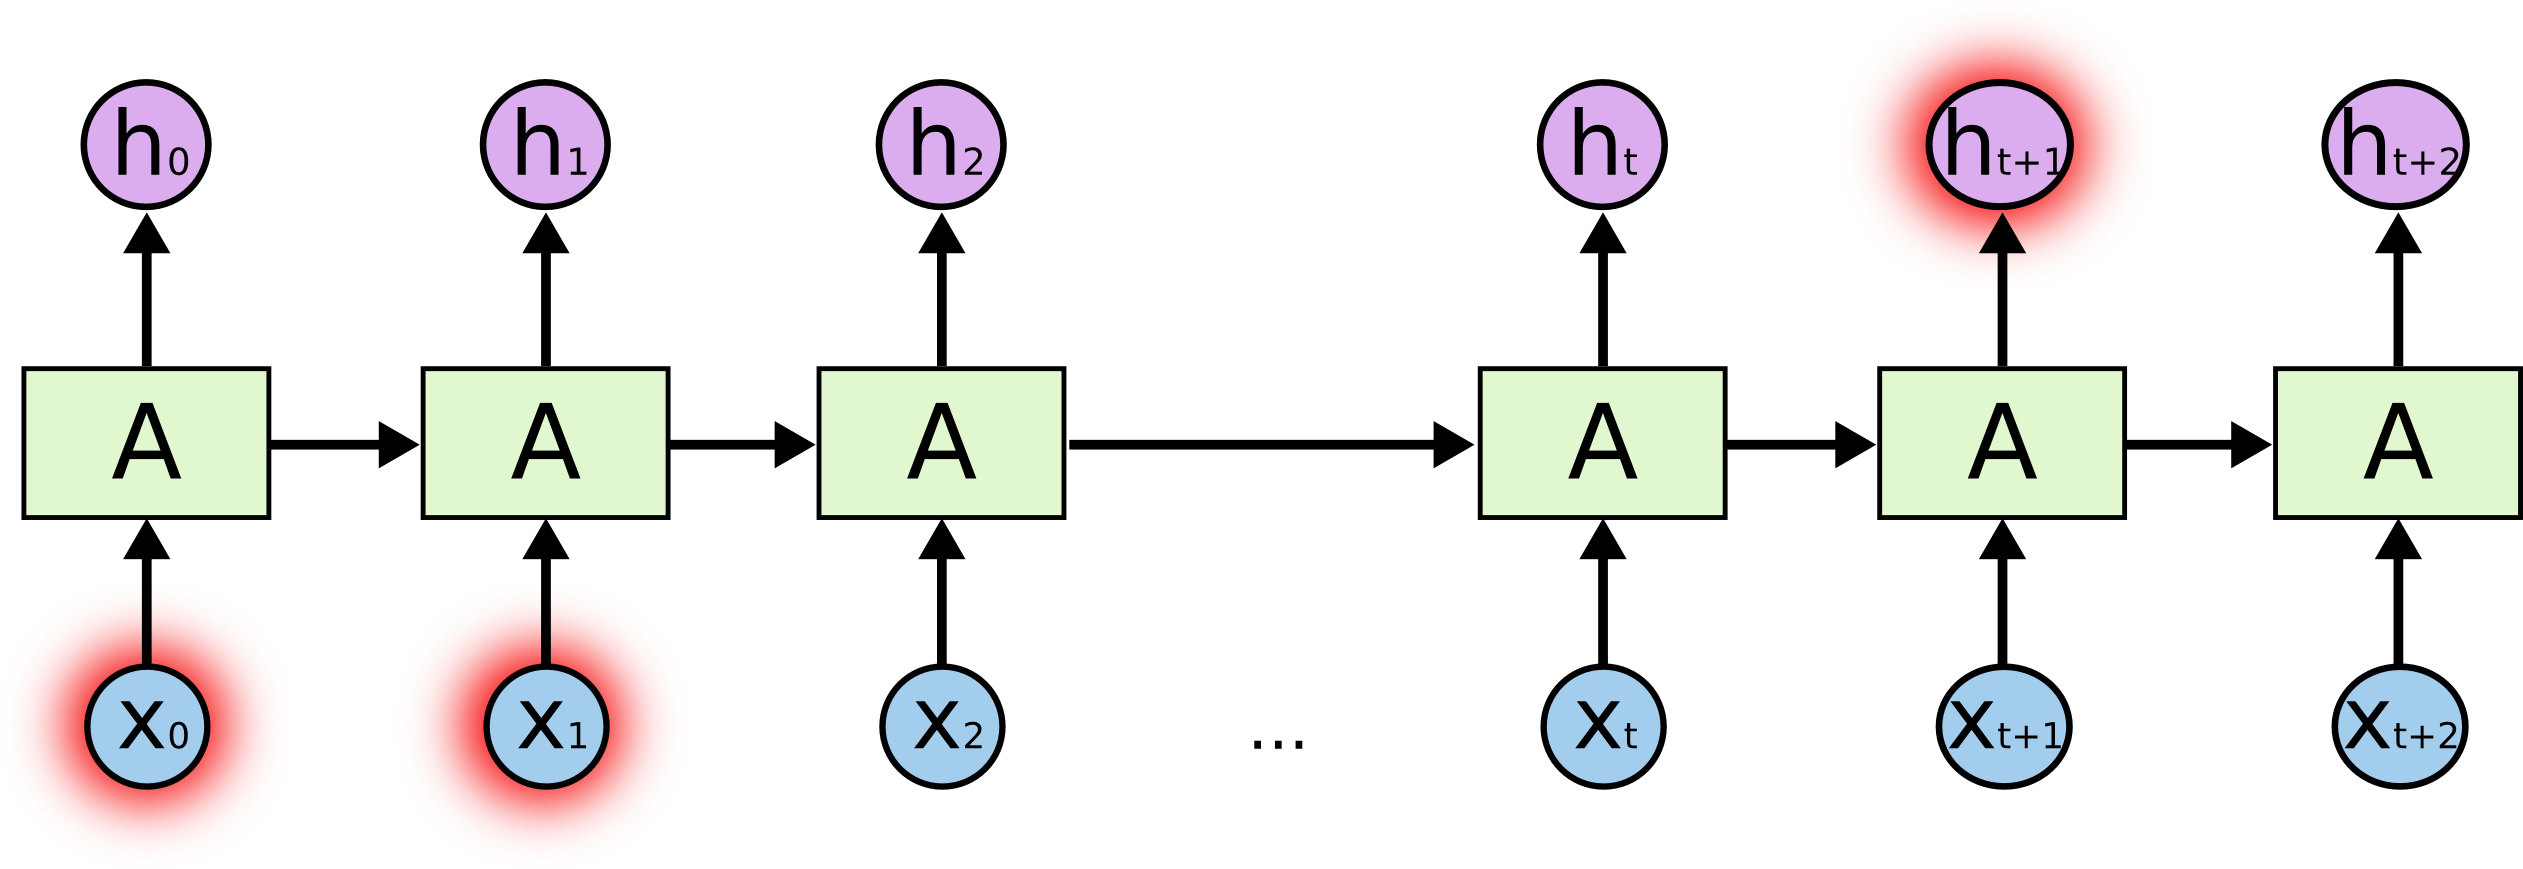
如果需要的历史信息距离当前位置很远,则RNN无法学习到过去的信息。这就是不能长期依赖的问题。
LSTM总览与核心结构 ​

  • LSTM可以记住一些记忆,捕获长依赖问题
  • 也可以让ERROR根据输入,依照不同强度流动

见后面GRU解决梯度消失

总览

所有的RNN有着重复的结构,如下图,比如内部是一个简单的tanh 层。
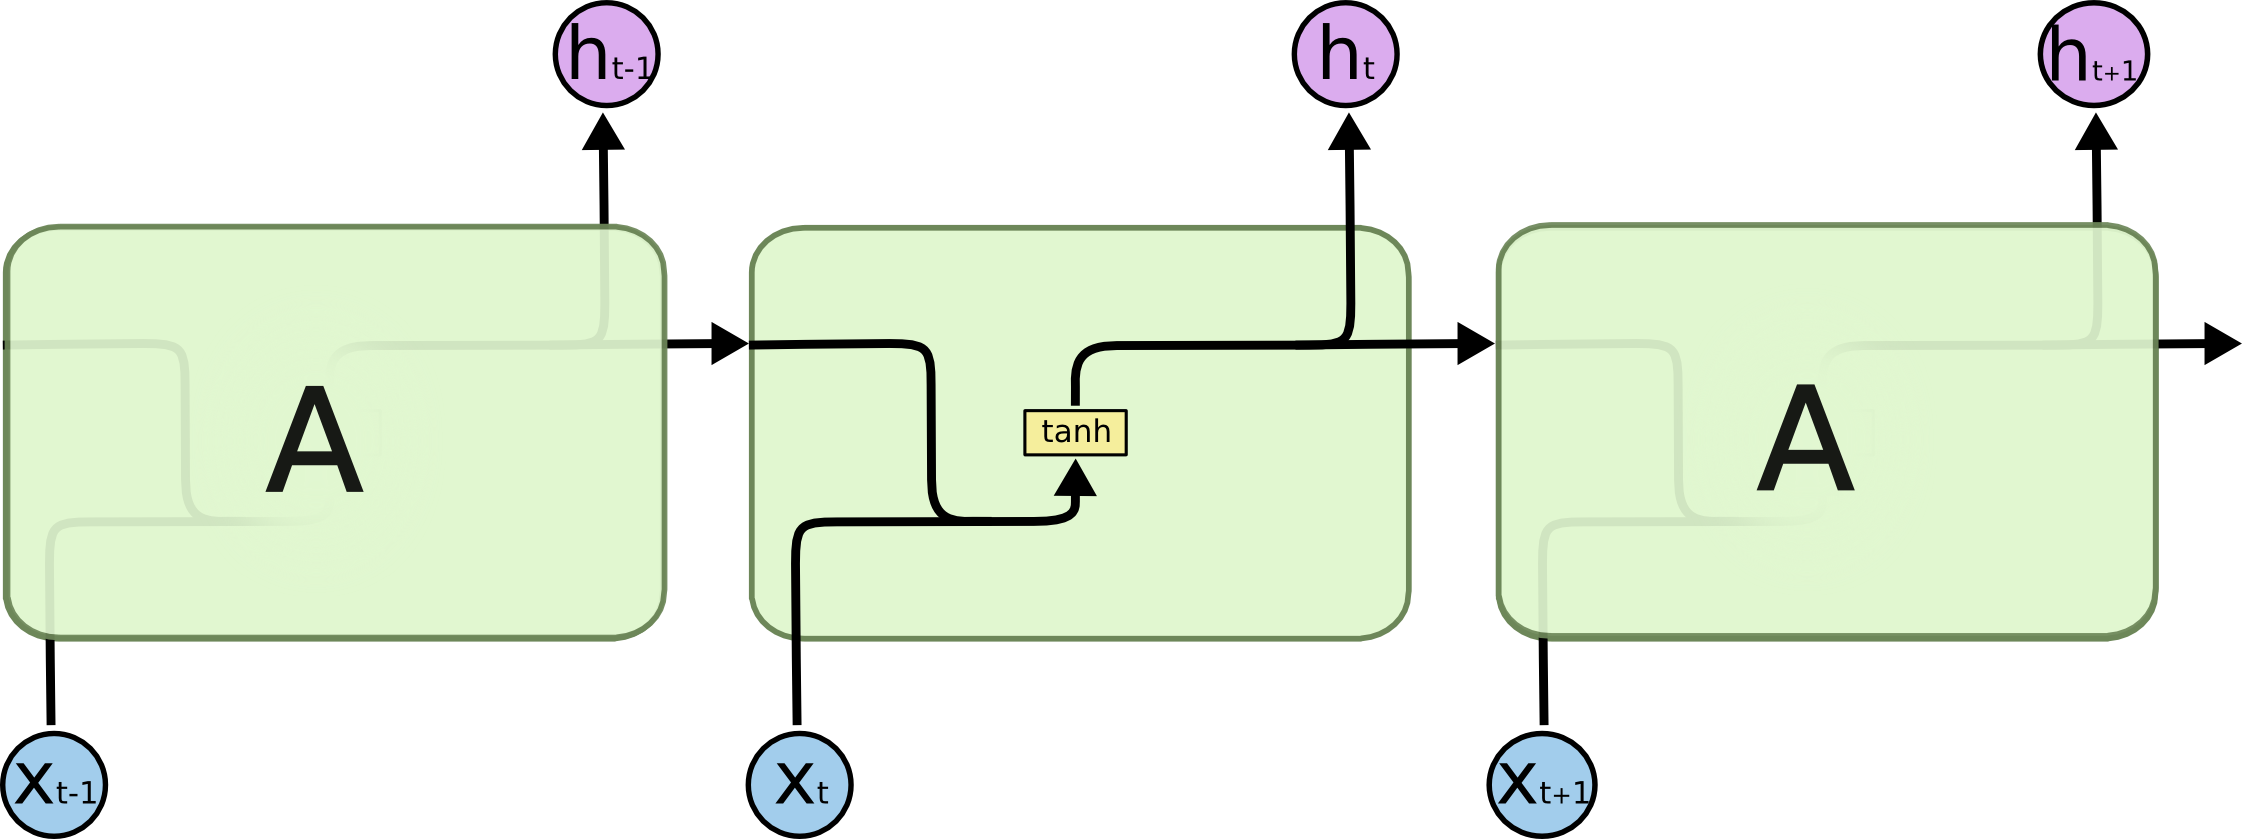
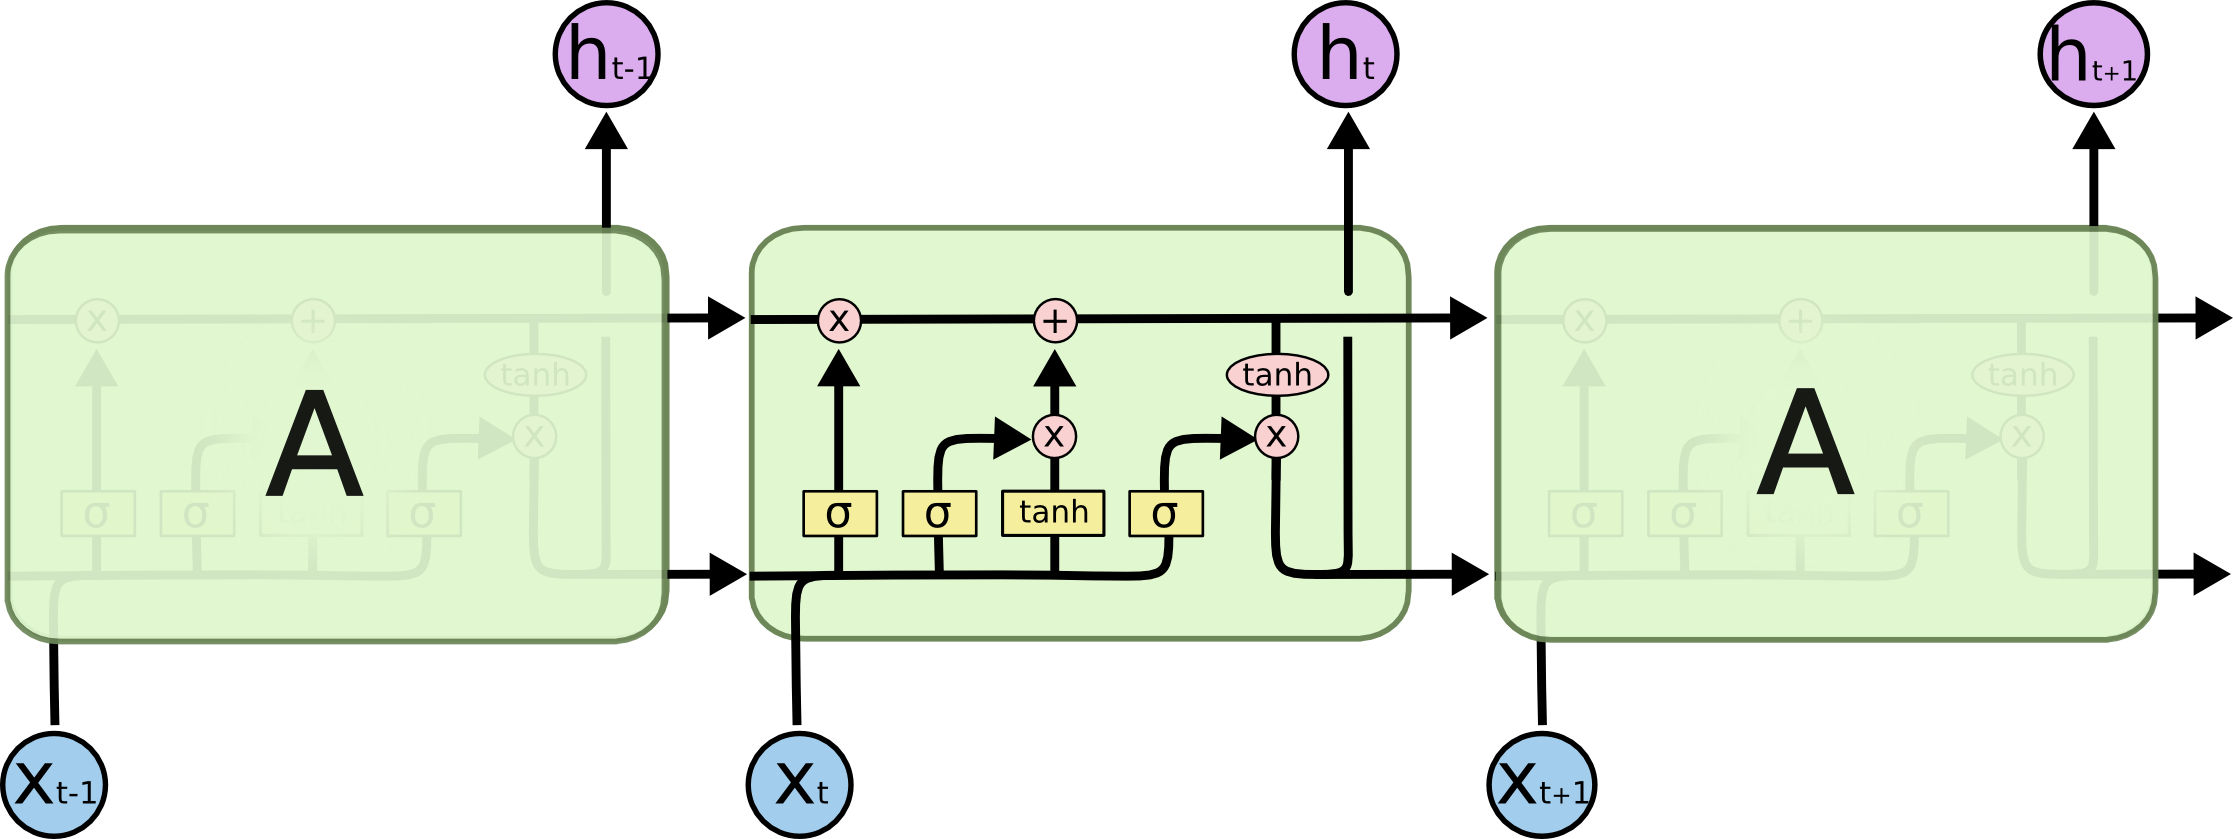
LSTM也是一样的,只不过内部复杂一些。
单元状态

单元状态像一个传送带,通过整个链向下运行,只有一些小的线性作用。信息就沿着箭头方向流动。
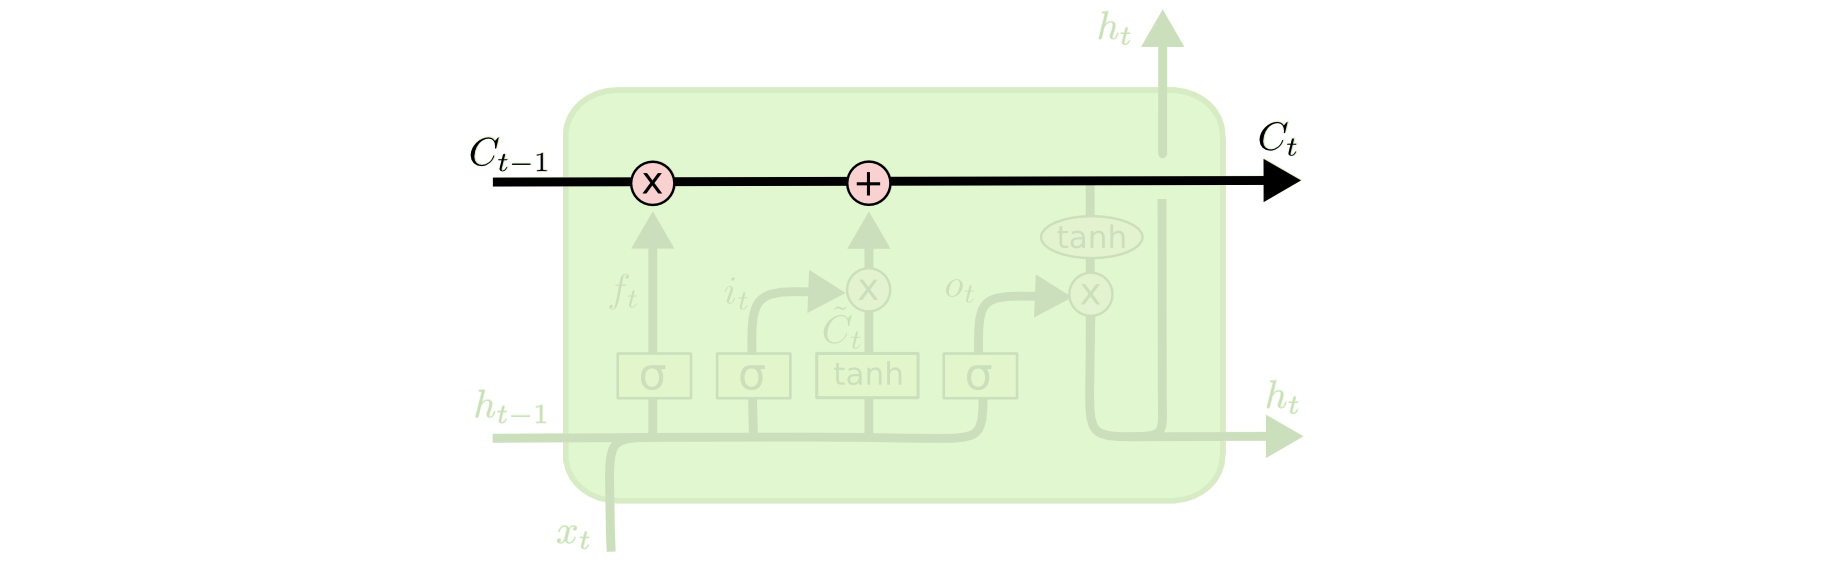
LSTM的门结构

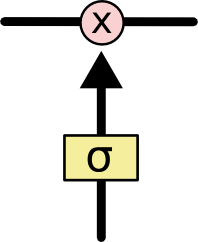
LSTM的门结构 可以添加或者删除单元状态的信息,去有选择地让信息通过。它由sigmoid网络层 和 点乘操作组成。输出属于[0,1]之间,代表着信息通过的比例。

LSTM细节解剖 ​

一些符号说明,都是t时刻的信息 :

  • Ct−1 : 的单元状态
  • ht : 隐状态信息 (也作单个神经元的输出信息)
  • xt : 输入信息
  • ot :输出信息 (输出特别的信息)

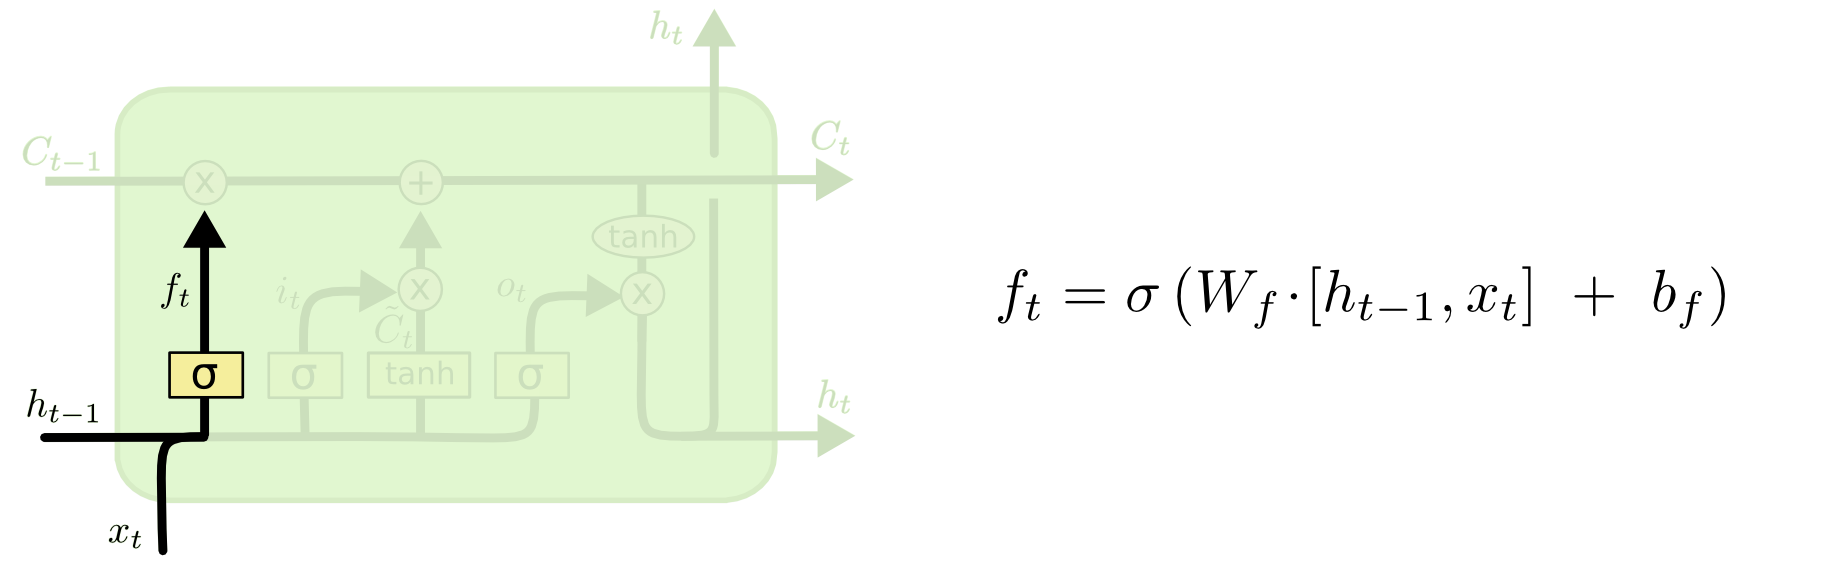
1 遗忘旧信息

对于Ct−1中的每一个数字, ht−1和xt会输出0-1之间的数来决定遗忘Ct−1中的多少信息。

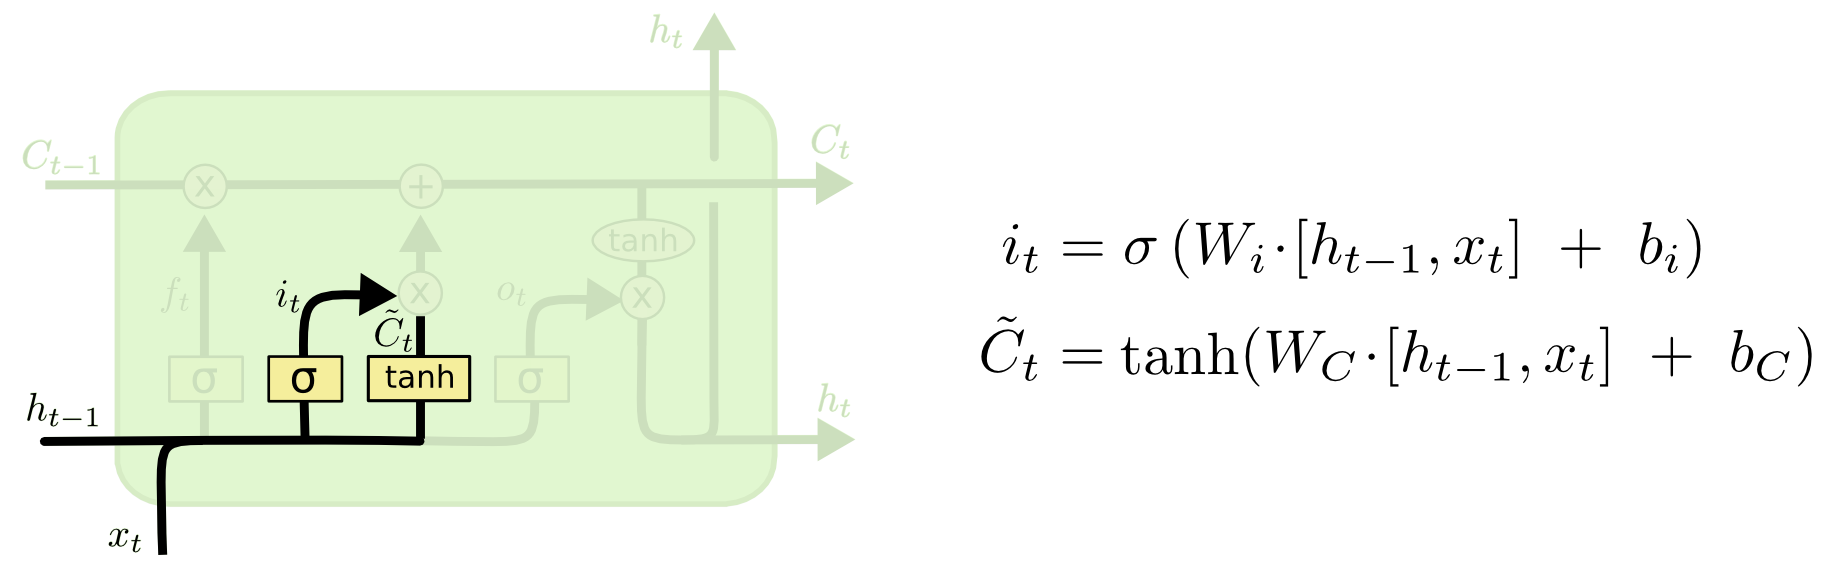
2 生成候选状态和它的更新比例

生成新的状态:tanh层创建新的候选状态C^t

输入门:决定新的状态哪些信息会被更新it,即候选状态C^t的保留比例。

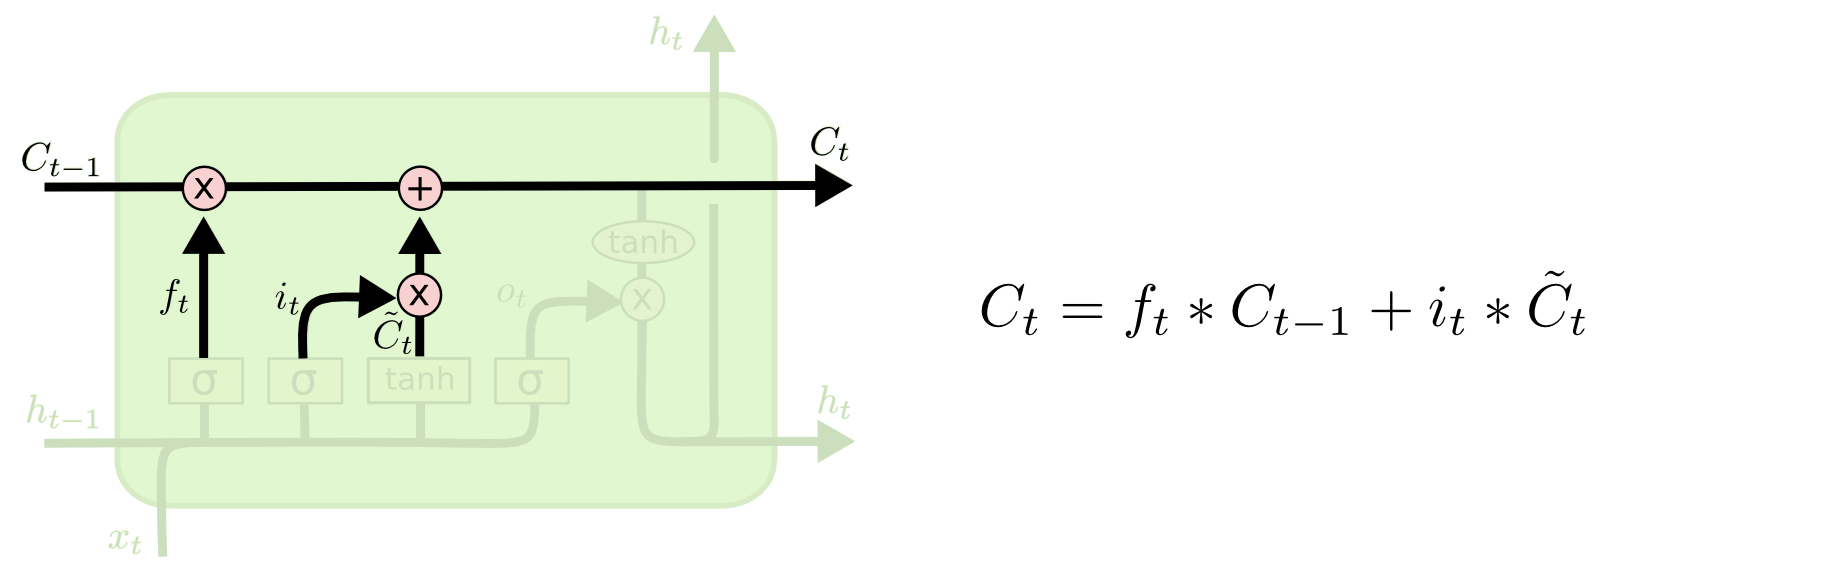
3 新旧状态合并更新

生成新状态Ct:旧状态Ct−1 + 候选状态C^t。

旧状态Ct−1遗忘不需要的, 候选状态C^t−1保留需要更新的,都是以乘积比例形式去遗忘或者更新。

4 输出特别的值

sigmoid:决定单元状态Ct的哪些信息要输出。

tanh: 把单元状态Ct的值变到[−1,1]之间。

LSTM总结 ​

核心结构如下图所示

要忘掉部分旧信息,旧信息Ct−1的遗忘比例ft

ft=σ(Wf⋅[ht−1,xt]+bf)

新的信息来了,生成一个新的候选C^t

C^t=tanh⁡(WC⋅[ht−1,xt]+bC)

新信息留多少呢,新候选C^t的保留比例it

it=σ(Wi⋅[ht−1,xt]+bi)

合并旧信息和新信息,生成新的状态信息Ct

Ct=ft∗Ct−1+it∗C^t

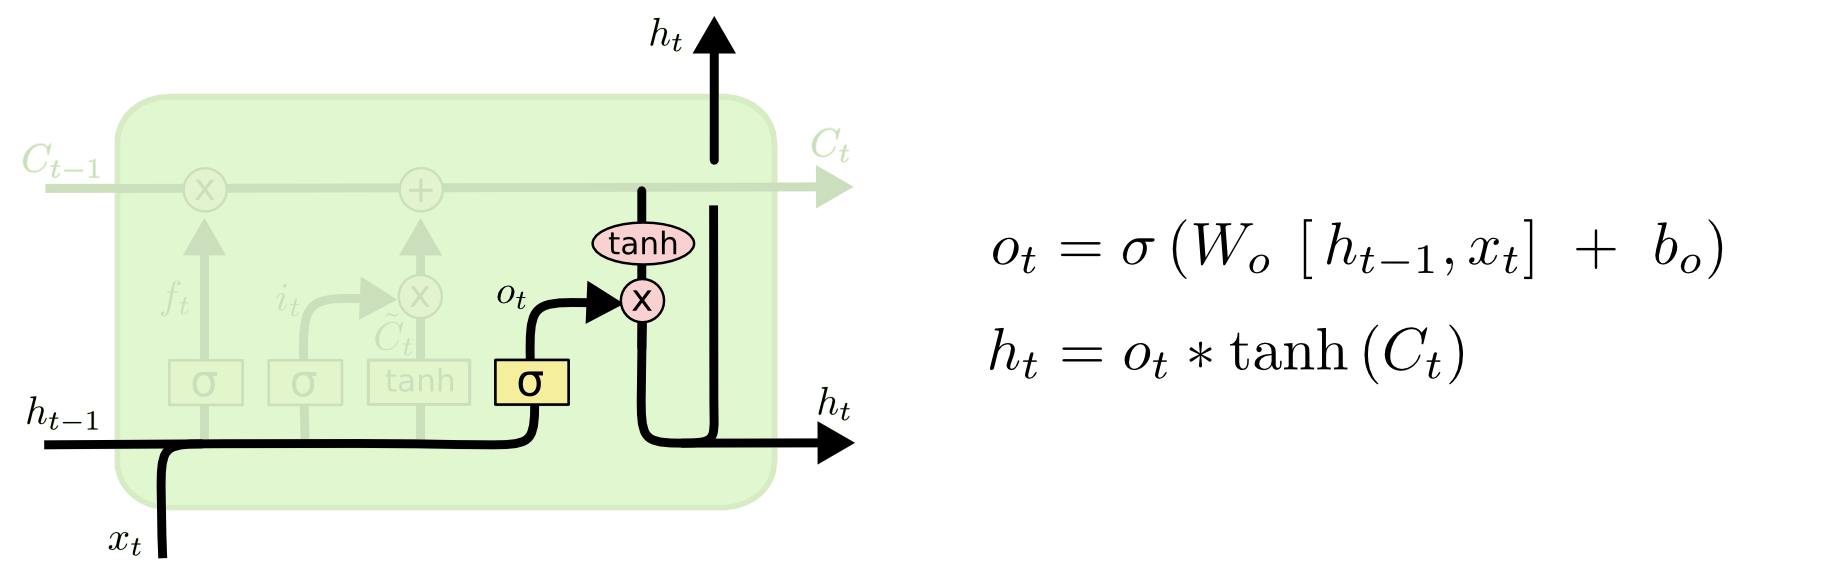
输出多少呢,单元状态Ct的输出比例ot

ot=σ(Wo⋅[ht−1,xt]+bo)

把Ct化到[−1,1]再根据比例输出

ht=ot∗tanh⁡(Ct)

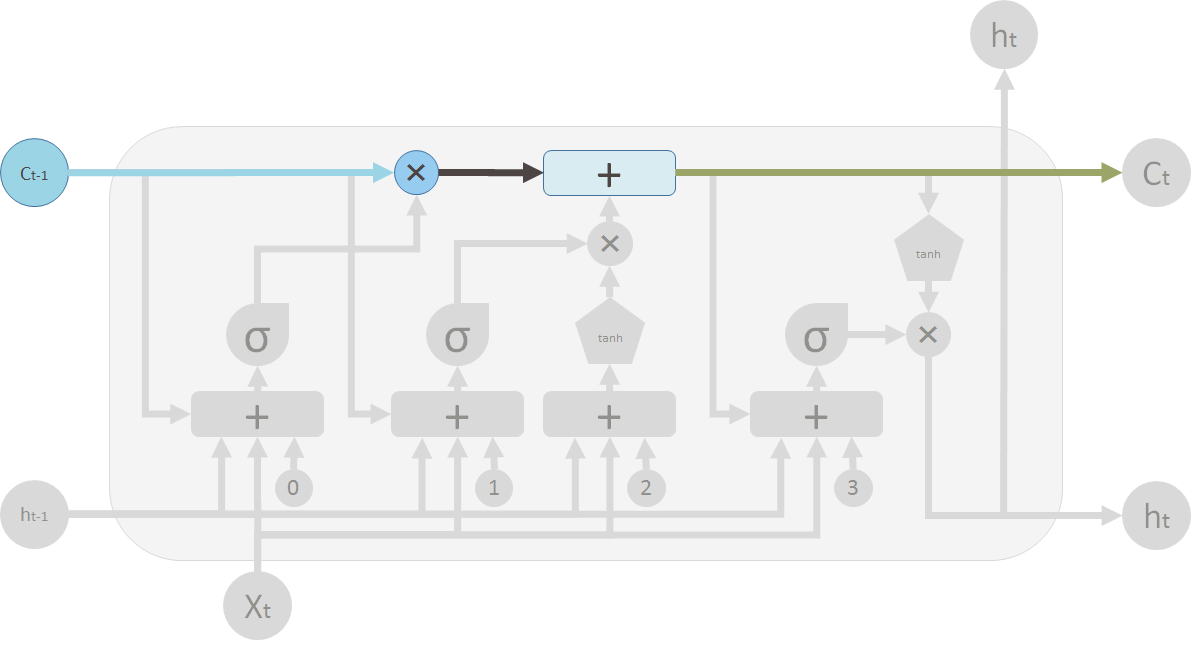
图文简介描述LSTM ​

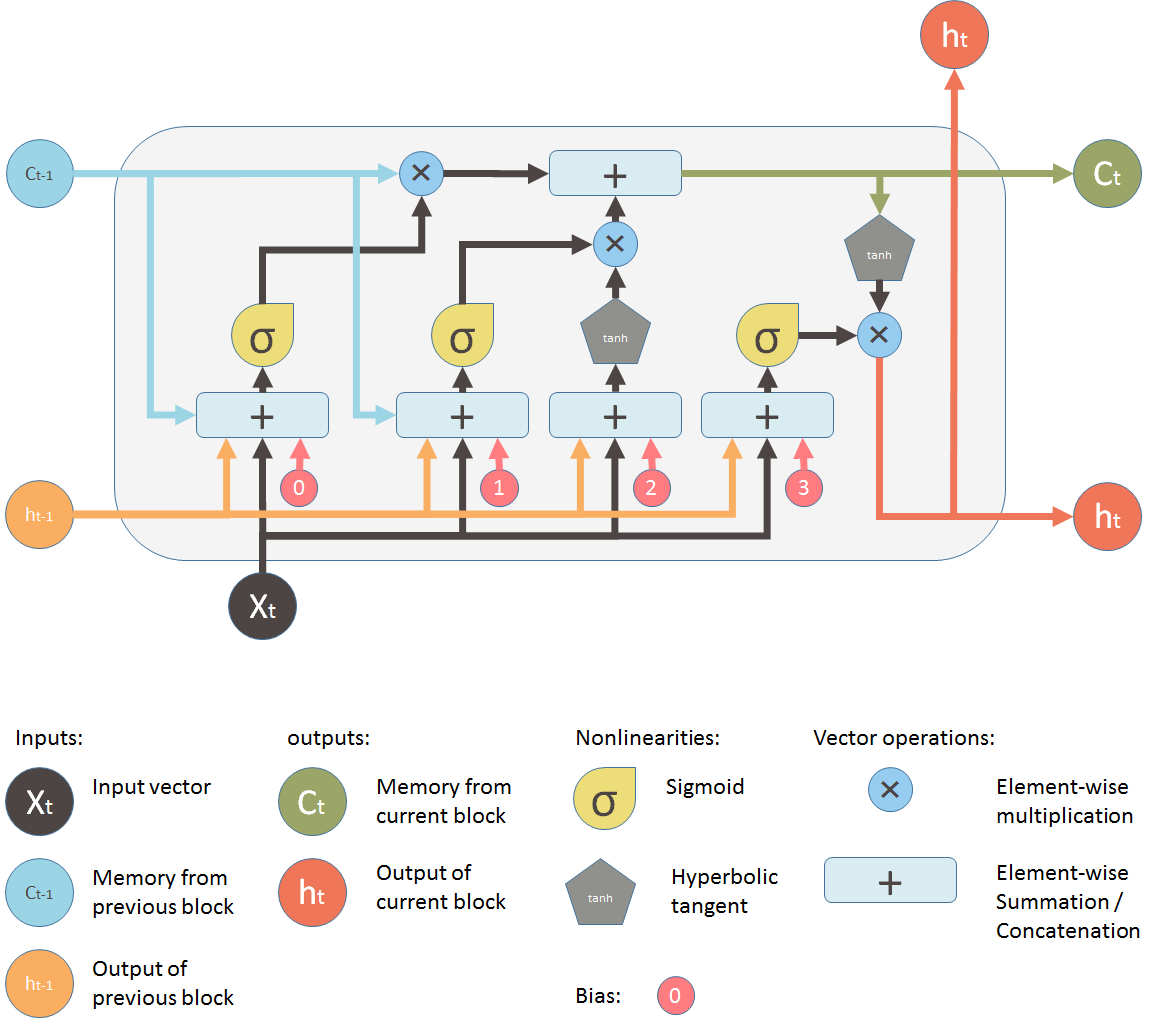
总体架构 ​

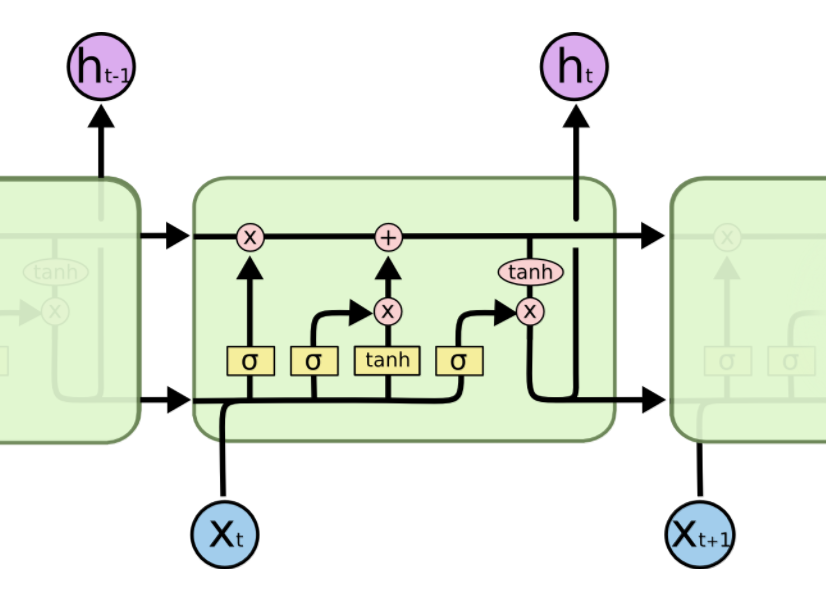
单元架构

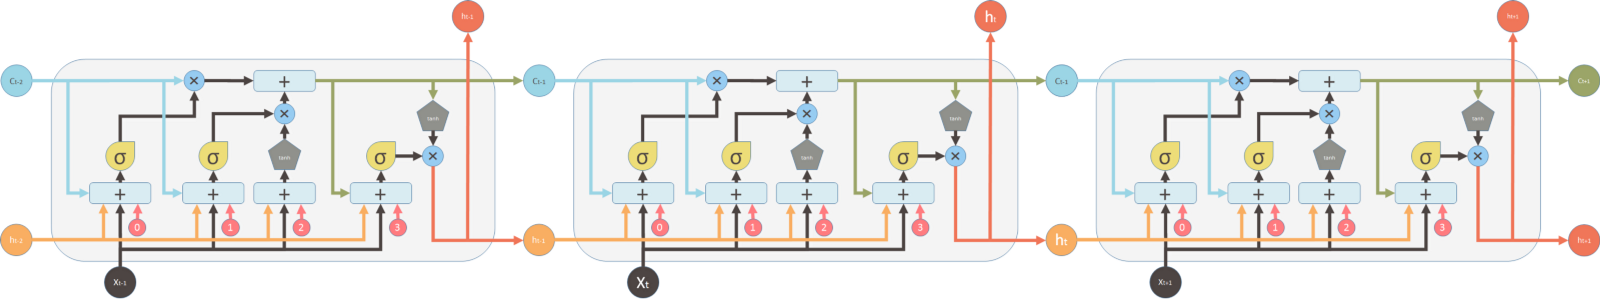
流水线架构

数据流动 ​

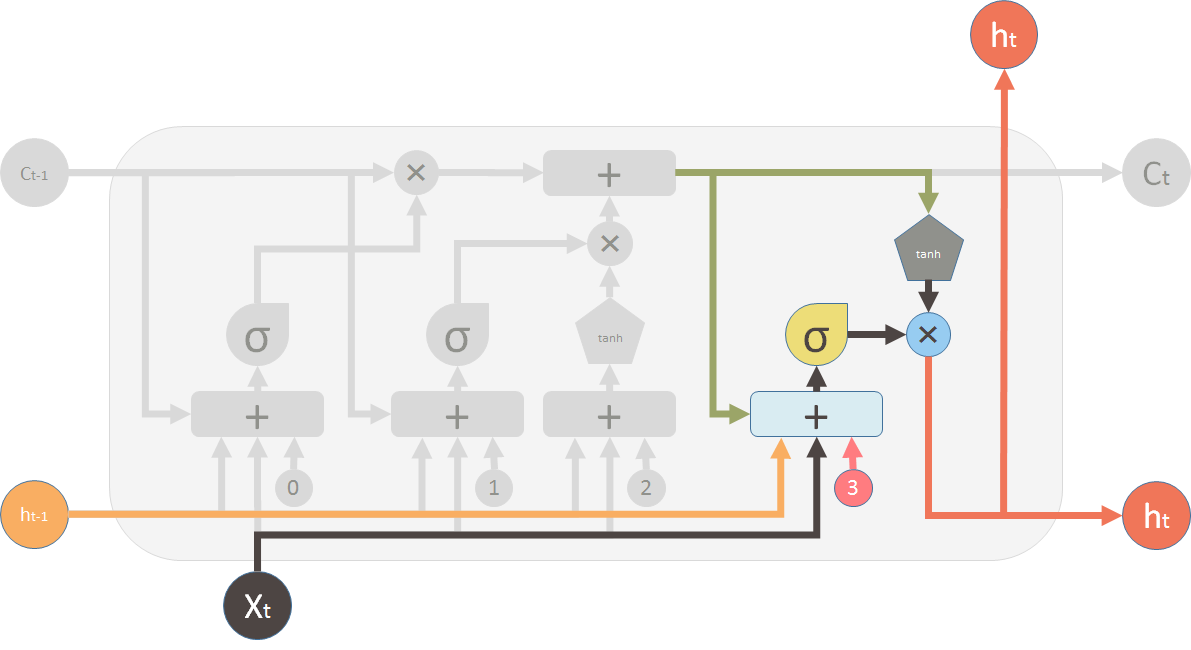
圆圈叉叉代表着遗忘Ct−1的信息。乘以向量来实现,向量各个值在[0,1]之间。 靠近0就代表着遗忘很多,靠近1就代表着保留很多。

框框加号代表着数据的合并。旧信息Ct−1和新候选信息C^t的合并。 合并之后就得到新信息Ct。

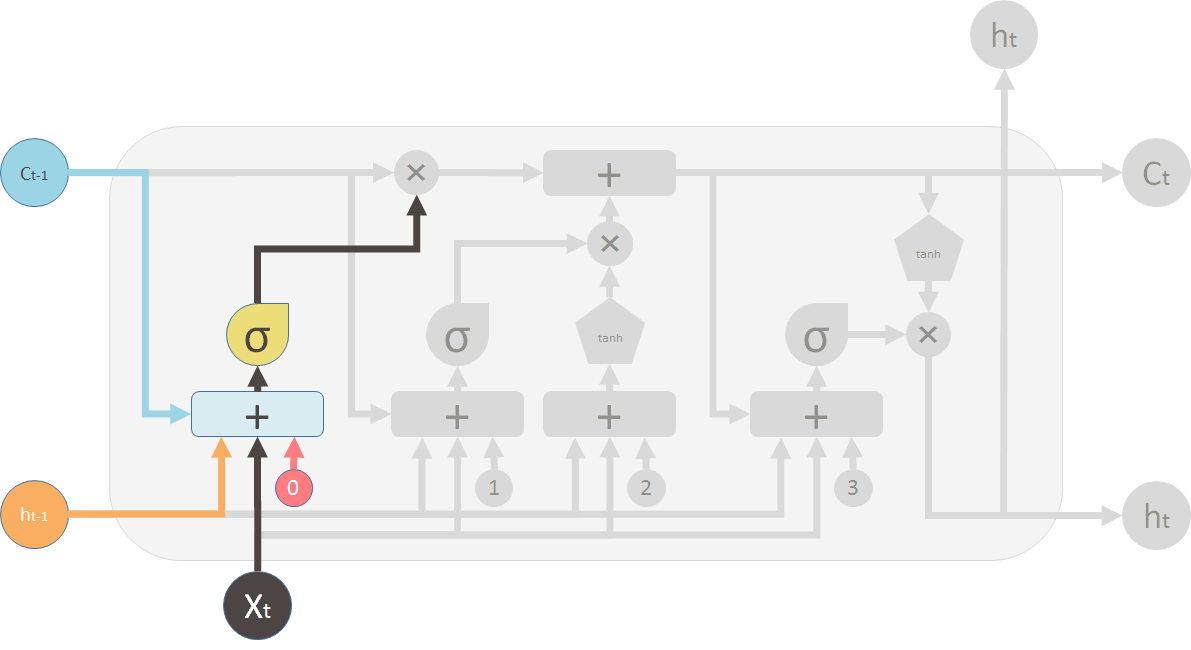
遗忘门 ​

上一个LSTM的输出ht−1 和 当前的输入xt,一起作为遗忘门的输入。 0是偏置b0, 一起做个合并,再经过sigmoid生成遗忘权值ft信息, 去遗忘Ct−1。

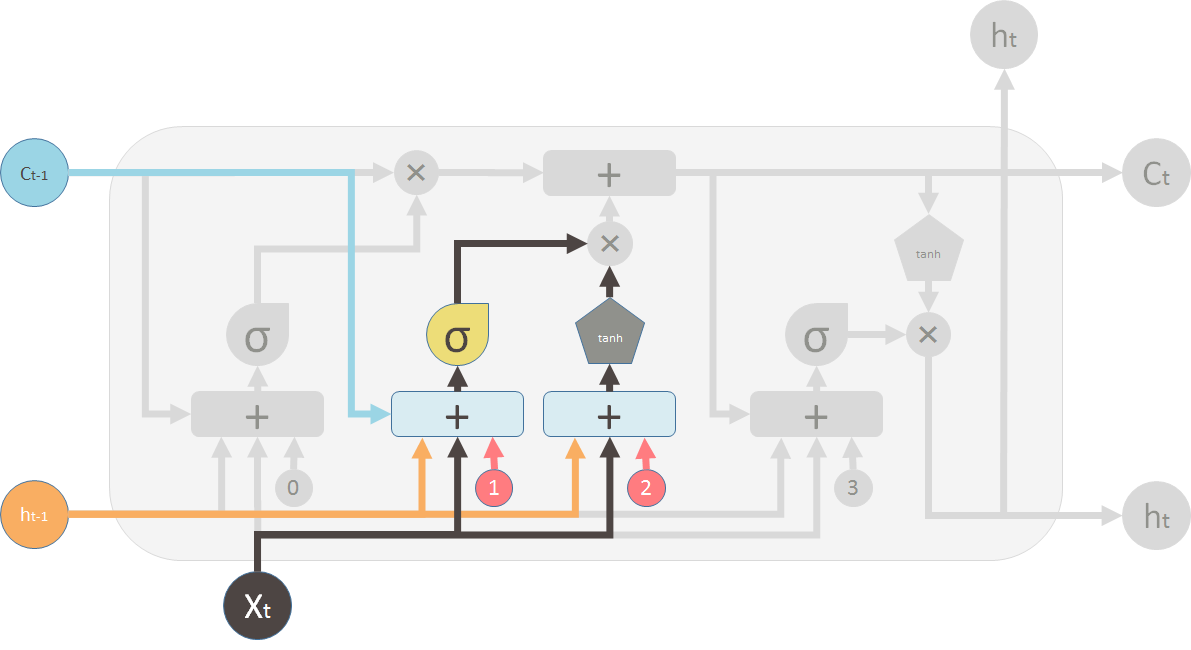
新信息门

新信息门决定着新信息对旧信息的影响力。和遗忘门一样ht−1和xt作为输入。

sigmoid:生成新信息的保留比例。tanh:生成新的信息。

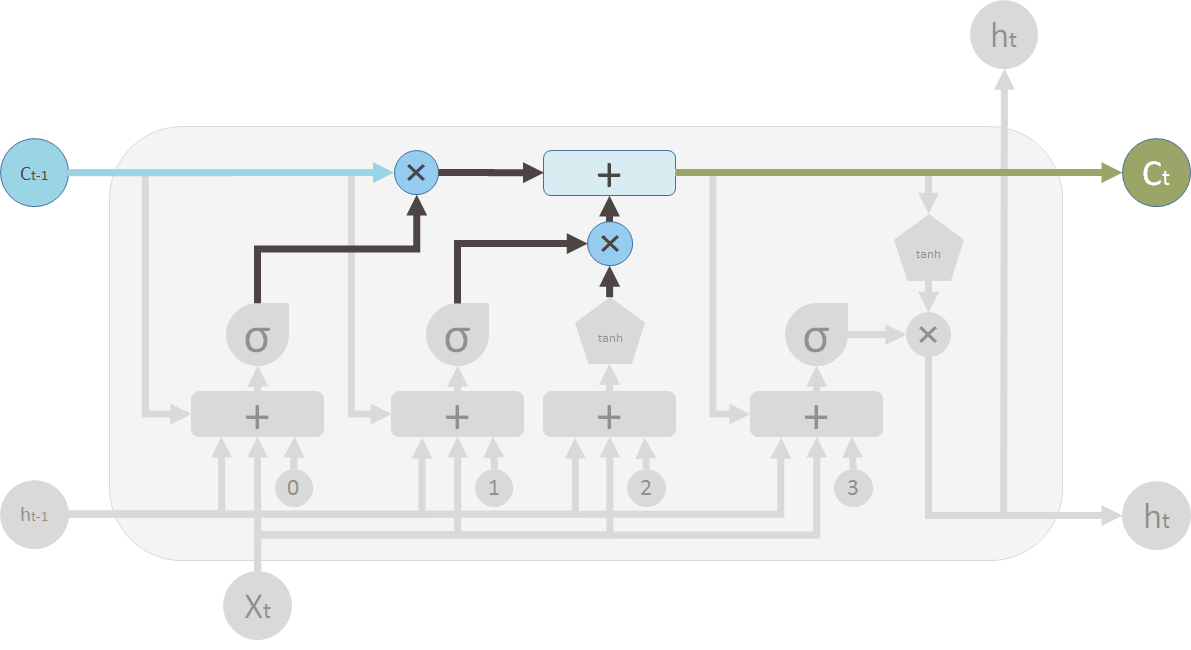
新旧信息合并 ​

旧信息Ct−1和新信息C^t合并,当然分别先过遗忘阀门和更新阀门。

输出特别的值 ​

把新生成的状态信息Ct使用tanh变成(−1,1)之间,然后经过输出阀门进行输出。

LSTM变体 ​

观察口连接 ​

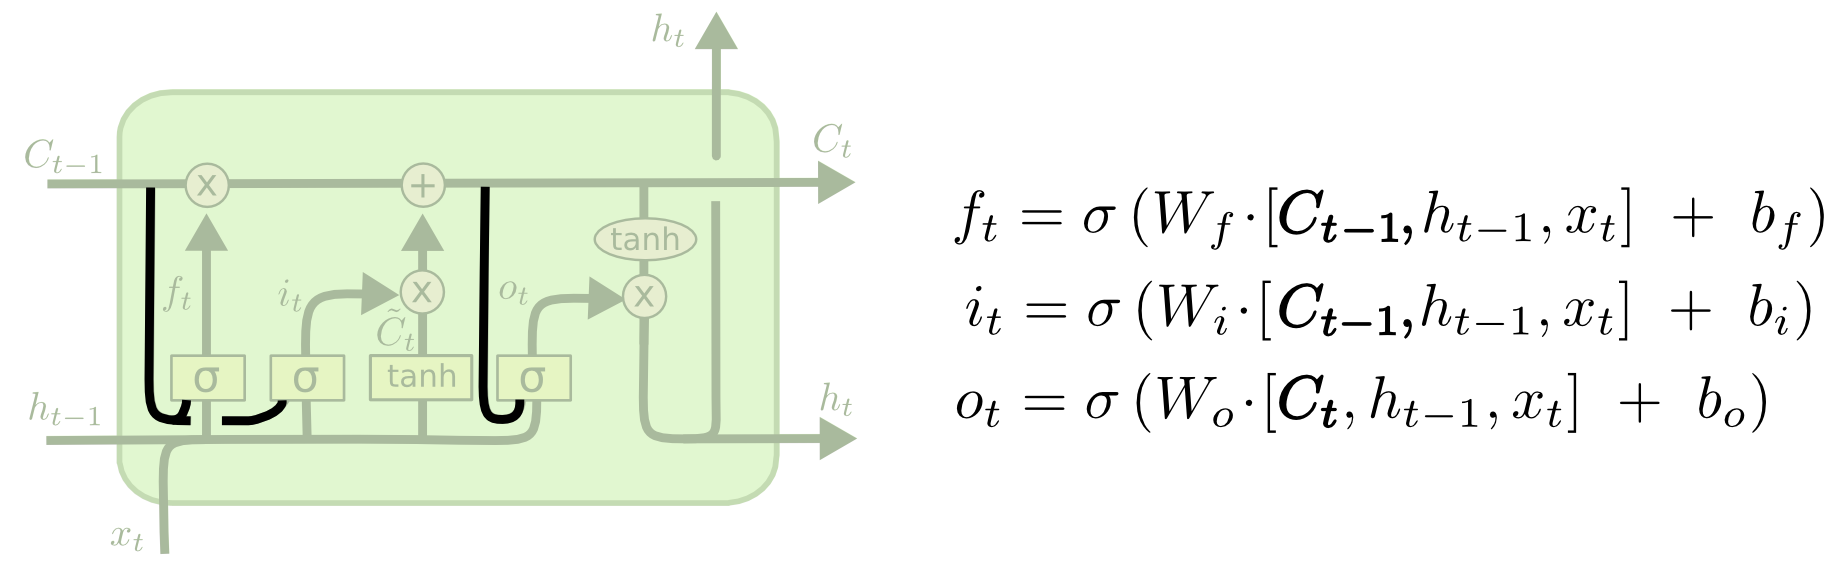
传统LSTM阀门值比例的计算,即更新、遗忘、输出的比例只和ht−1,xt有关。

观察口连接,把观察到的单元状态也连接sigmoid上,来计算。即遗忘、更新比例和Ct−1,ht−1,xt有关,输出的比例和Ct,ht−1,xt有关。

组队遗忘 ​

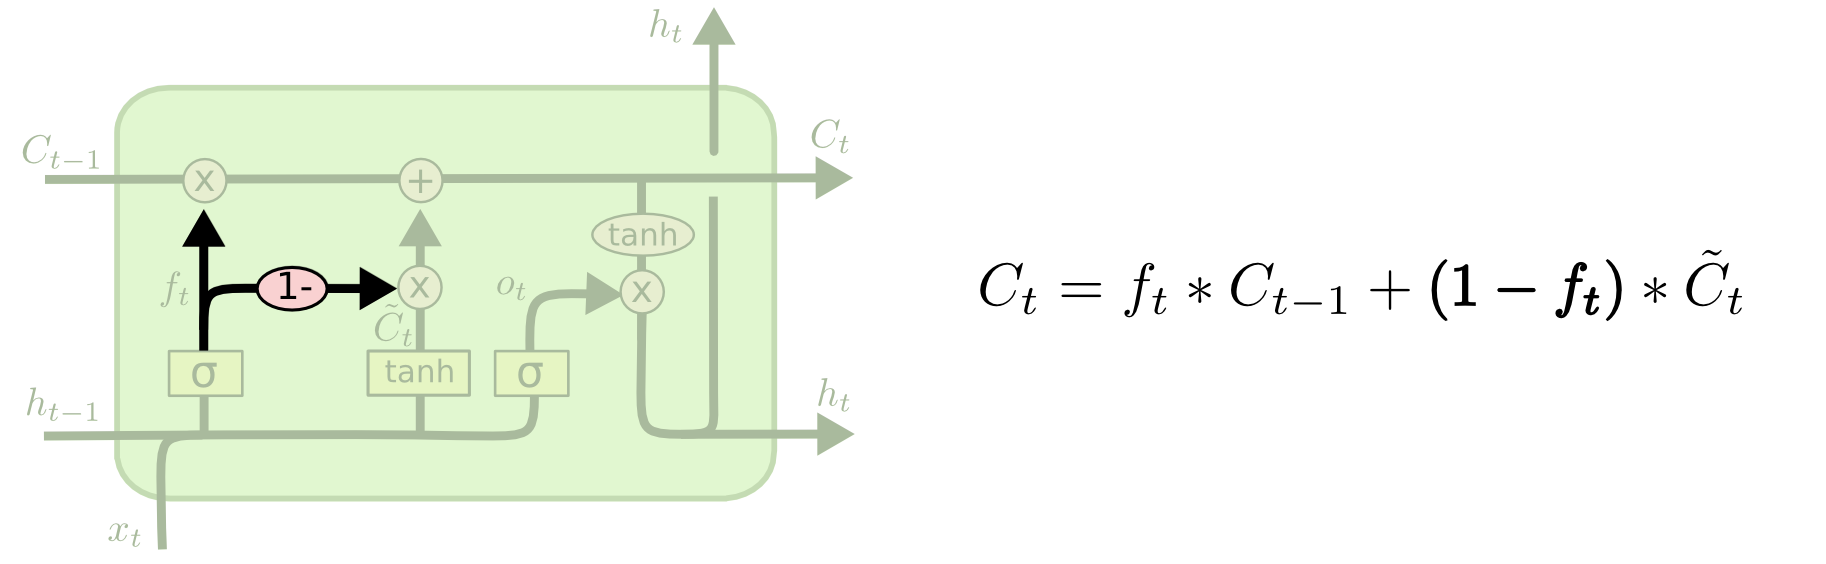
如下图所示,计算好Ct−1的遗忘概率it后,就不再单独计算新候选C^t的保留概率it。而是直接由1减去遗忘概率得到更新概率。即it=1−ft,再去更新。

GRU ​

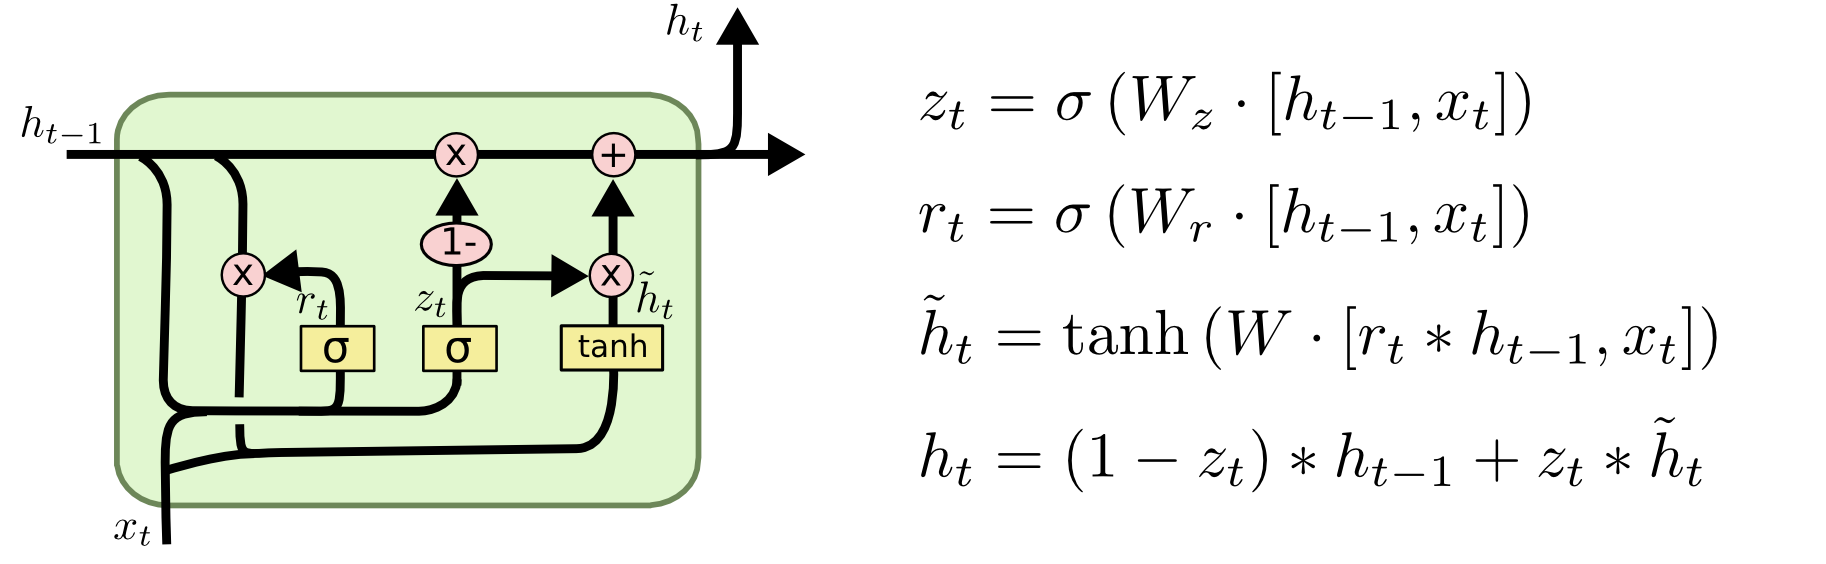
LSTM有隐状态ht和输出状态ot,而GRU只有ht,即GRU的隐状态和输出状态是一样的,都用ht表示。

更新门zt负责候选隐层h^t保留的比例, 1−zt负责遗忘旧状态信息ht−1的比例

zt=σ(Wz⋅[ht−1,xt])

候选隐藏层h^t的计算由ht−1和xt一起计算得到。所以计算h^t之前,要先计算ht−1的重置比例。

重置门rt负责**ht−1对于生成新的候选h^t的作用比例**

rt=σ(Wr⋅[ht−1,xt])

新记忆h^t的计算

h^t=tanh⁡(W⋅[rt∗ht−1,xt])

最终记忆ht由ht−1和h^t计算得到,分别的保留比例是1−zt和zt

ht=(1−zt)∗ht−1+zt∗h^t

更新门 zt:过去的信息有多重要。 z=1, 则过去信息非常重要,完全保留下来

重置门rt: 旧记忆对新记忆的贡献程度。r=0, 则当前新记忆和旧记忆不想关。

RNN梯度问题 ​

RNN梯度推导 ​

简单点

ht=Wht−1+W(hx)xty^t=W(s)f(ht)

总的误差是之前每个时刻的误差之和

∂E∂W=∑t=1T∂Et∂W

每一时刻的误差又是之前每个时刻的误差之和,应用链式法则

∂Et∂W=∂Et∂yt∂yt∂ht∑k=1t∂ht∂hk∂hk∂W∂Et∂W=∑k=1t∂Et∂yt∂yt∂ht∂ht∂hk∂hk∂W∂Et∂W=∑k=1t∂Ek∂yk∂yk∂hk∂hk∂hk−1∂hk−1∂W

而∂ht∂hk会变得非常大或者非常小!!

∂ht∂hk=∏j=k+1t∂hj∂hj−1=∏j=k+1tWT×diag[f′(jj−1)]

而导数矩阵雅克比矩阵

∂hj∂hj−1=[∂hj∂hj−1,1,⋯,∂hj∂hj−1,dh]=[∂hj,1∂hj−1,1⋯∂hj,1∂hj−1,dh⋮⋱⋮∂hj,dh∂hj−1,1⋯∂hj,dh∂hj−1,dh]

合并起来,得到最终的

∂E∂W=∑t=1T∑k=1t∂Et∂yt∂yt∂ht(∏j=k+1t∂hj∂hj−1)∂hk∂W

两个不等式

∥∂hj∂hj−1∥≤∥WT∥⋅∥diag[f′(hj−1)]∥≤βWβh

所以有,会变得非常大或者非常小。会产生梯度消失或者梯度爆炸问题。

∥∂ht∂hk∥=∥∏j=k+1t∂hj∂hj−1∥≤(βWβh)t−k

梯度 是过去对未来影响力的一个度量方法。如果梯度消失了不确定t和k之间是否有关系,或者是因为参数错误 。

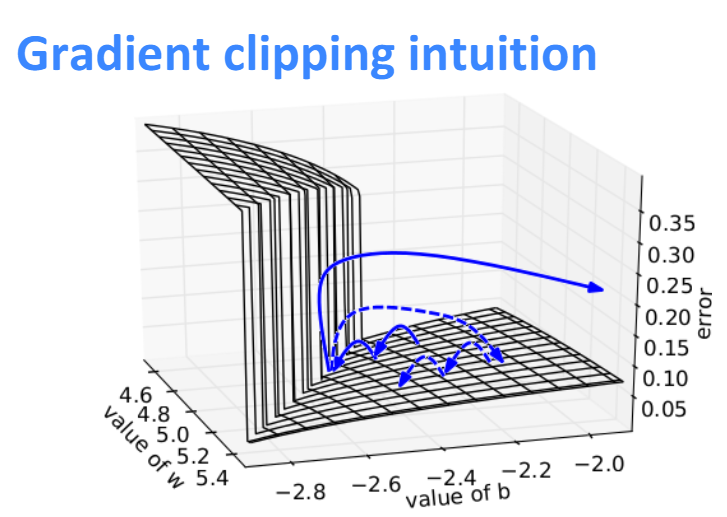
解决梯度爆炸 ​

原始梯度

g^=∂E∂W

如果g^>阈值, 则更新

g^=threshold∥g^∥g^

GRU解决梯度消失 ​

  • LSTM可以记住一些记忆,捕获长依赖问题
  • 也可以让ERROR根据输入,依照不同强度流动

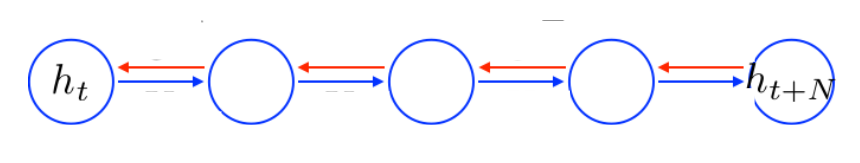
RNN的前向和反向传播,都会经过每一个节点

GRU可以自动地去创建一些短连接,也可以自动地删除一些不必要的连接。(门的功能)
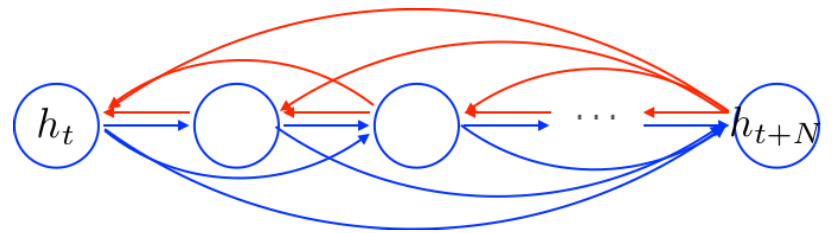
RNN会读取之前所有信息,并且更新所有信息。
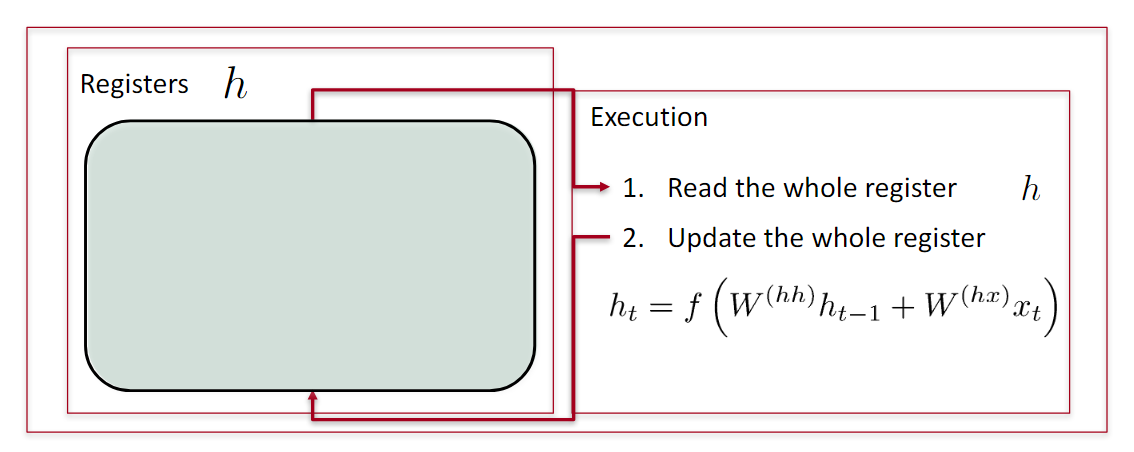
GRU
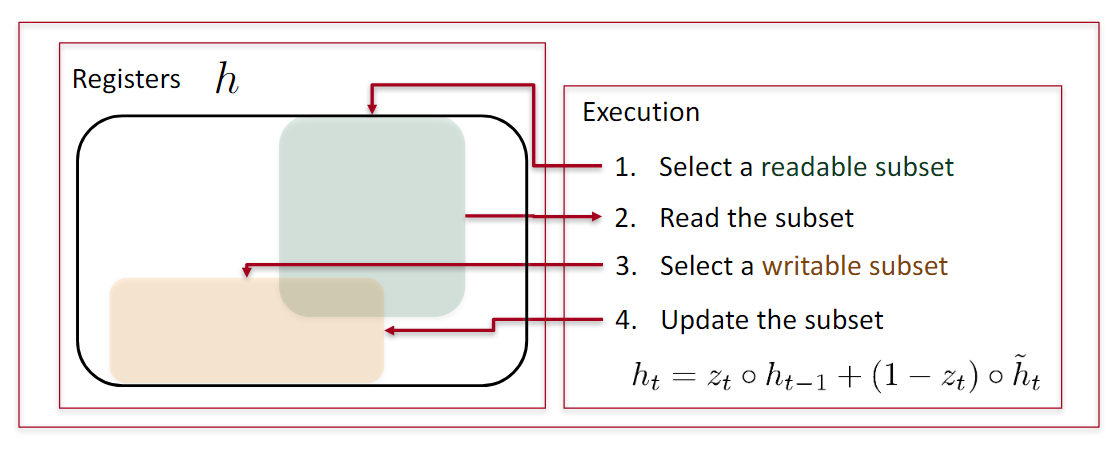
  • 选择可读部分,读取
  • 选择可写部分,更新
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026