Skip to content

SVM笔记

📅 发表于 2018/03/01
🔄 更新于 2025/07/23
👁️ — 次访问
📝 2799 字
⏳ 9 分钟
机器学习
#SVM
#机器学习
#拉格朗日对偶性
#对偶问题
#支持向量
#核函数
#感知机
#损失函数

Support Vector Machine简单笔记。 特征空间上的间隔最大的线性分类器。学习策略是间隔最大化,转化为一个凸二次规划问题的求解。

SVM概览 ​

线性分类器 ​

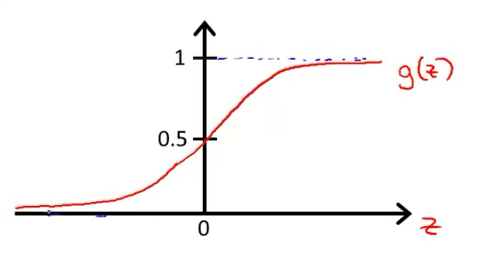
逻辑回归的图像和公式如下,预测的分类为1的概率。

$$ h_\theta(x) = g(\theta^Tx), \quad g(z) = \frac{1}{1+e^{-z}}, \quad g(z) = \begin{cases} 1, & z\ge 0 \\ -1, & z < 0 \\ \end{cases} $$ y={1,hθ(x)≥0.5,即θTx≥00,hθ(x)<0.5,即θTx<0

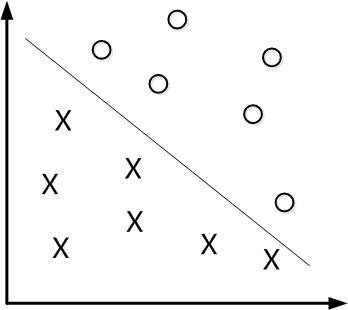
其中θTx=wTx+b=0 是一个超平面。 用分类函数表示f(x)=wTx+b 。 w是这个超平面的法向量。

即对于任意一个x,有如下预测类别:

y^={1,f(x)≥0−1,f(x)<0

函数间隔与几何间隔 ​

函数间隔

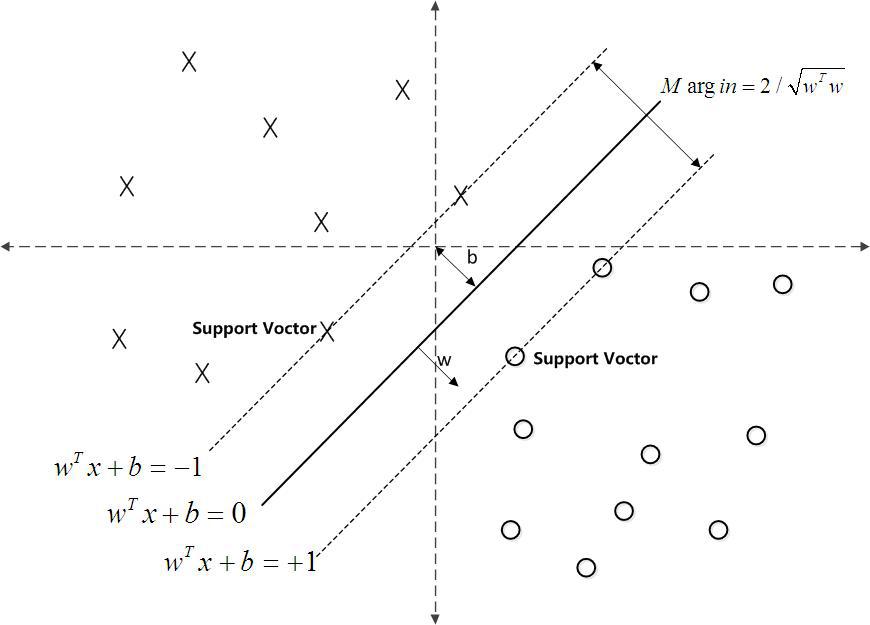
超平面wTx+b=0确定后, |w⋅x+b|表示点x到平面的距离,表示分类可靠性。距离越远,分类越可信。y与w⋅x+b的符号的一致性表示分类的正确性。

超平面(w,b)关于样本点(xi,yi)的**函数间隔γ^i**如下:

γ^i=yi(wT⋅xi+b)

超平面关于所有样本点的函数间隔γ^​ :

γ^=minγ^i

函数间隔的问题:w和b成比例改变,超平面未变,但函数间隔已变。

几何间隔

对函数间隔除以法向量的二范数,则得到超平面与点(xi,yi)的几何间隔γi :

γi=γ^i∥w∥=yi(wT⋅xi+b)∥w∥

超平面关于所有样本点的几何间隔:

γ=minγi

几何间隔才是直观上点到超平面的距离。

最大间隔分类器 ​

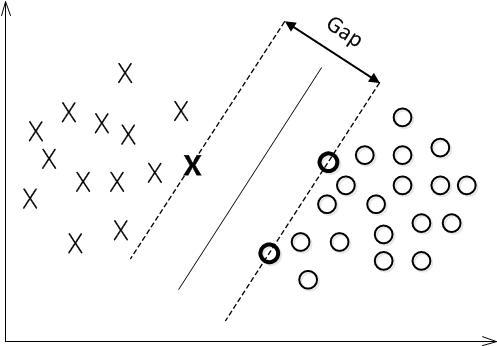
分类时,超平面离数据点的间隔越大,分类的确信度也越大。 所以要最大化这个几何间隔,目标函数如下:
L=maxw,bγ,s.t,γi≥γ

用函数间隔γ^描写为:

L=maxw,bγ^∥w∥,s.t,γ^i≥γ^, 其中 γ^i=yi(wT⋅xi+b)

函数间隔γ^​的取值并不会影响最优化问题的解。 λw,λb→λγ^​

目标函数

取函数间隔为1,γ^=1, 则有目标函数:

L=maxw,b1∥w∥,s.t,yi(wTxi+b)≥1

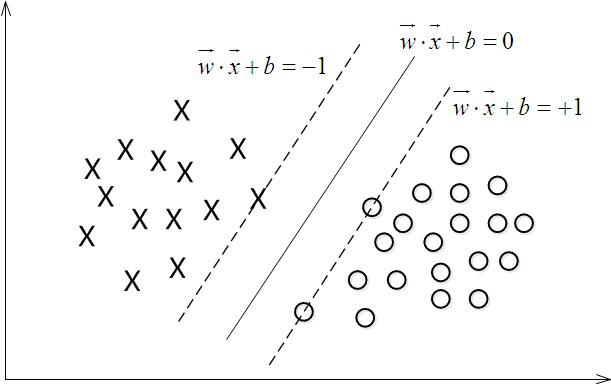
支持向量是虚线边界上的点,则有:

{yi(wTxi+b)=1,支持向量yi(wTxi+b)>1,其他点

分类

y^={1,f(x)≥0−1,f(x)<0

线性SVM ​

拉格朗日对偶性 ​

1 原始问题

f(x),ci(x),hj(x)都连续可微。

最优化:

minx∈Rf(x)

有很多个约束条件(不等式约束和等式约束):

ci(x)≤0,hj(x)=0

求解原始问题

将约束问题无约束化。

引入拉格朗日函数,其中αi(≥0)和βj是拉格朗日乘子

L(x,α,β)=f(x)+∑αici(x)+∑βjhj(x)

定义关于x的函数**θp(x)**:

θp(x)=maxα,β:αi≥0L(x,α,β)θp(x)={f(x),x满足约束+∞,其他

f(x)求最小,则对θp(x)求最小。

原始问题: 先固定x,优化出参数α,β,再优化x。

minxθp(x)=minxmaxα,β:αi≥0L(x,α,β)

所以原始最优化问题 变为 拉格朗日函数的极小极大问题。

定义原始问题的最优解p∗ :

p∗=minxθp(x)

2 对偶问题

定义关于α,β的函数θd(α,β)

θd(α,β)=minxL(x,α,β)

对偶问题:先固定参数α,β ,优化出x,再优化出参数。 先优化x。

maxα,β:αi≥0θd(α,β)=maxα,β:αi≥0minxL(x,α,β)

原始问题: 先固定x,优化出参数α,β,再优化x。先优化参数。

minxθp(x)=minxmaxα,β:αi≥0L(x,α,β)

定义对偶问题的最优值:

d∗=maxα,β:αi≥0θd(α,β)

3 原始问题与对偶问题的关系

因为:

θd(α,β)=minxL(x,α,β)≤maxα,β:αi≥0L(x,α,β)=θp(x)

定理1:如果原始问题与对偶问题均有最优值,则有:d∗≤p∗

d∗=maxα,β:αi≥0minxL(x,α,β)≤minxmaxα,β:αi≥0L(x,α,β)=p∗

推论1:如果d∗=p∗, 那么x∗,α∗,β∗分别是原始问题和对偶问题的最优解。

通过对偶问题,来解决原始问题。

4 KKT条件

满足什么条件,才能使d∗=p∗呢 ?

首先满足下面的大条件:

假设f(x)和ci(x)都是凸函数, hj(x)是仿射函数;假设不等式约束ci(x)是严格可行的。

定理2:则存在解,x∗是原始问题的最优解,α∗,β∗是对偶问题的最优解。 并且:

d∗=p∗=L(x∗,α∗,β∗)

KKT条件:则x∗是原始问题、α∗,β∗是对偶问题的最优解的充分必要条件是**x∗,α∗,β∗满足下面的KKT条件**:

偏导为0条件∇xL(x∗,α∗,β∗)=0∇αL(x∗,α∗,β∗)=0∇βL(x∗,α∗,β∗)=0约束条件ci(x∗)≤0hj(x∗)=0αi∗≥0KKT对偶互补条件αi∗ci(x∗)=0

由KKT对偶互补条件可知,若αi∗>0, 则ci(x∗)=0 。SVM推导会用到。

若αi>0, 则对应的xi是支持向量, 有yi(w∗⋅x+b∗)=1。 所有的非支持向量,都有αi=0。

原始问题到对偶问题 ​

先前的目标函数:

J=maxw,b1∥w∥,s.t,yi(wTxi+b)≥1

最大变为最小,则有原始问题如下。目标函数是二次的,约束条件是线性的。所以是个凸二次规划问题。

J=minw,b12∥w∥2,s.t,yi(wTxi+b)≥1

构造拉格朗日函数 :

L(w,b,λ)=12∥w∥2−∑i=1nαi(yi(wTxi+b)−1)

原始问题

θp(w,b)=maxλi≥0L(w,b,α)p∗=minw,bθp(w,b)=minw,bmaxλi≥0L(w,b,α)

对偶问题

θd(α)=minw,bL(w,b,α)d∗=maxαi≥0θd(α)=maxαi≥0minw,bL(w,b,α)

我们知道d∗≤p∗​, 有时相等。原始问题可以转化为对偶问题求解,好处是:近似解,好求解。

求解对偶问题 ​

拉格朗日函数:

L(w,b,λ)=12∥w∥2−∑i=1nαi(yi(wTxi+b)−1)

化简后:

L(w,b,λ)=12∥w∥2−∑i=1nαiyiwTxi−∑i=1nαiyib+∑i=1nαi

目标函数:

d∗=maxαi≥0θd(α)=maxαi≥0minw,bL(w,b,α)

主要是三个步骤:

  • 固定参数α, 求 极小化minw,bL(w,b,α)的w和b
  • 带入w和b,对L求参数α 的极大化
  • 利用SMO算法求解对偶问题中的拉格朗日乘子α

**1 极小求出w和b minw,bL(w,b,α) **

对w和b求偏导,使其等于0。

∂L∂w=w−∑i=1nαiyixi=令0→w=∑i=1nαiyixi∂L∂b=−∑i=1nαiyi=令0→∑i=1nαiyi=0

特别地范式求导:∂∥w∥2∂w=2w​

∂∥w∥2∂w=w

把上面两个结论,带入原式进行化简,得到:

L(w,b,α)=12wTw−∑i=1nαiyiwTxi−∑i=1nαiyib+∑i=1nαi=12wT∑i=1nαiyixi−wT∑i=1nαiyixi−b∑i=1nαiyi+∑i=1nαi(带入w,提出b,带入0)=−12(∑i=1nαiyixi)T(∑i=1nαiyixi)+∑i=1nαi(只有x是向量,直接转置)=−12(∑i=1nαiyixiT)(∑i=1nαiyixi)+∑i=1nαi=∑i=1nαi−12∑i=1n∑i=1nαiαjyiyjxiTxj

得到只用α表示的拉格朗日函数:

L(w,b,α)=∑i=1nαi−12∑i=1n∑i=1nαiαjyiyjxiTxj

2 求出对α​的极大 maxαi≥0θd(α)=maxαi≥0minw,bL(w,b,α)​

对偶问题 如下:

目标函数:

maxα∑i=1nαi−12∑i=1n∑i=1nαiαjyiyjxiTxj

约束条件:

αi≥0∑i=1nαiyi=0

利用SMO算法求出拉格朗日乘子α∗。

3 求出w和b,得到分离超平面和决策函数

根据前面的公式得到**w∗**:

w∗=∑i=1nαi∗yixi

选一个**αj∗>0对应的点**(xj,yj) 就是支持向量。由于支持向量**yj(w∗⋅x+b∗)−1=0** ,yj2=1

得到**b∗** :

b∗=yj−∑i=1nαi∗yi(xi⋅xj),(xi⋅xj是向量内积,后面同理)

通过公式可以看出,决定w和b的是支持向量, 其它点对超平面是没有影响的。

分离超平面

f(x)=∑i=1nαi∗yi(xi⋅x)+b∗=0

分类决策函数

f(x)=sign(∑i=1nαi∗yi(xi⋅x)+b∗)

简单总结 ​

目标函数

J=minw,b12∥w∥2,s.t,yi(wTxi+b)≥1

拉格朗日函数

L(w,b,λ)=12∥w∥2−∑i=1nαi(yi(wTxi+b)−1)

转化为对偶问题求解, 需要会求解过程、会推导公式。

maxαi≥0minw,bL(w,b,α)

主要是下面4个求解步骤:十分重要!!!

  1. 固定α, L对w和b求偏导,得到两个等式
  2. 结果带入L,消去w和b,得到只有α的L
  3. 利用SMO求出α∗
  4. 利用α∗和支持向量,算出w和b。得出分离超平面和分界函数。

求导后消去w和b,得到L

L(w,b,α)=∑i=1nαi−12∑i=1n∑i=1nαiαjyiyjxiTxj

利用SMO求得α∗后, 带回原式,得到w和b:

w∗=∑i=1nαi∗yixi,b∗=yj−∑i=1nαi∗yi(xi⋅xj),

实际上最重要是向量内积来进行决策

f(x)=sign(∑i=1nαi∗yi(xi⋅x)+b∗)

目标函数

maxαi≥0L(w,b,λ)=maxαi≥012∥w∥2−∑i=1nαi(yi(wTxi+b)−1)

两种数据点

  • 支持向量:红色为0,αi>0。 后面为0。
  • 其它点:红色大于1,αi=0。 后面为0。

非线性SVM ​

核函数 ​

问题

大部分数据不是线性可分的,前面的超平面根本不存在。可以用一个超曲面进行分离,这就是非线性可分问题。

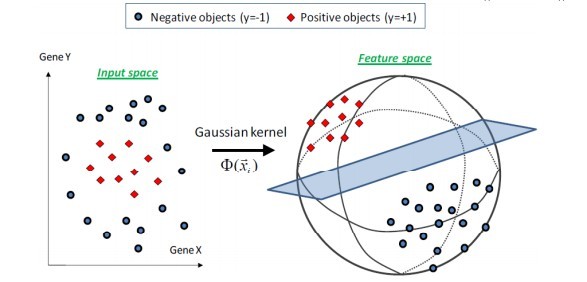
SVM可以通过核函数把输入映射到高维特征空间,最终在高维特征空间中构造最优分离超平面。
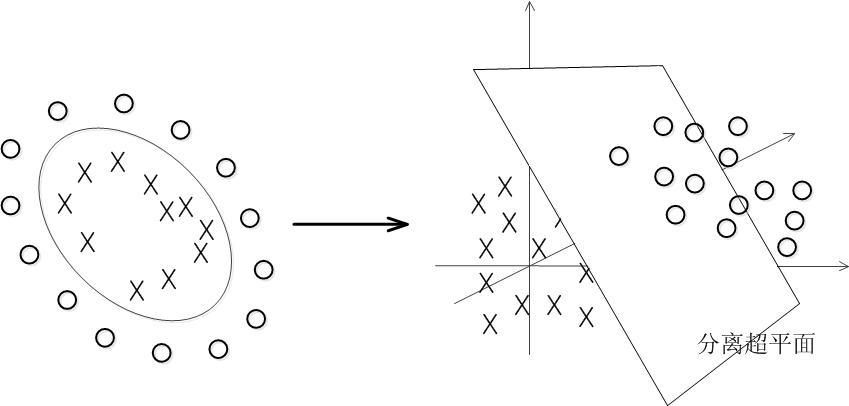
需要映射和学习线性SVM:

  • 把输入映射到特征空间F
  • 在特征空间F中使用线性学习器分类
f(x)=∑i=1nαi∗yi(ϕ(xi)⋅ϕ(x))+b∗

核函数的功能

核函数在特征空间中直接计算内积,就像在原始输入点的函数中一样,两个步骤合二为一:

K(x,z)=ϕ(x)⋅ϕ(z)

分类函数:

f(x)=∑i=1nαi∗yik(xi,x)+b∗

对偶问题:

maxα∑i=1nαi−12∑i=1n∑i=1nαiαjyiyjk(xi,x)s.t,αi≥0,∑i=1nαiyi=0

核函数处理非线性数据 ​

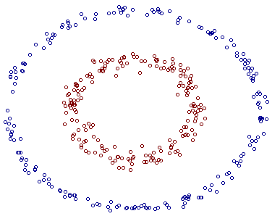
简单例子

上面的数据线性不可分,两个维度(a, b)。 应该用二次曲线(特殊圆)来区分:

w1a+w2a2+w3b+w4b2+w5ab+b=0

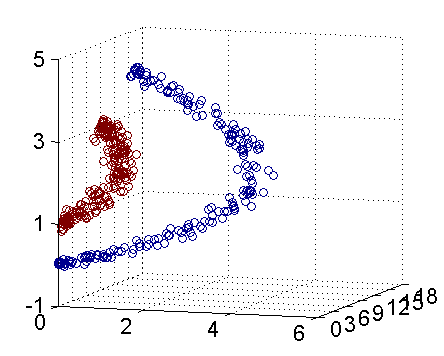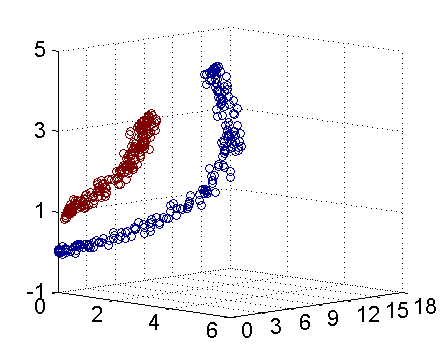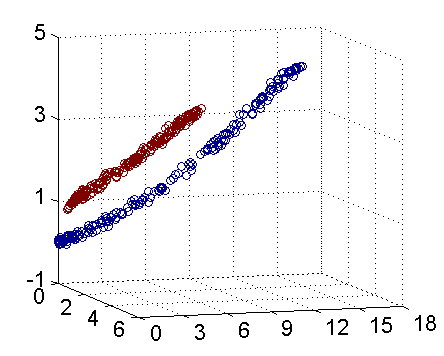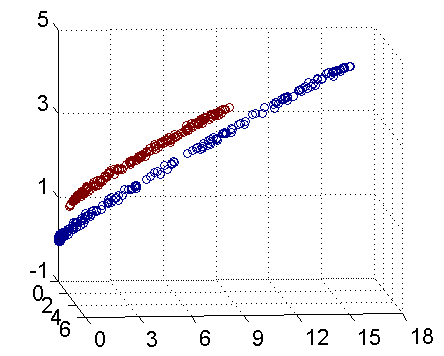
看做映射到了五维空间:

w1z1+w2z2+w3z3+w4z4+w5z5+b=∑i=15wizi+b=0

如下图:(实际映射到了三维空间的图),可以使用一个平面来分开:

问题

五维是由1维和2维进行组合,就可以解决问题。所以对输入数据无脑组合映射到高维可以吗?当然是不可以的。维数太高,根本没法计算,不能无脑组合映射。

核函数的功能

看核函数:

k(x1,x2)=(x1⋅x2+1)2

核函数和上面映射空间的结果是一样的!区别:

  • 映射计算:先映射到高维空间,然后根据内积进行计算
  • 核函数:直接在原来的低维空间中计算,而不需显示写出映射后的结果。避开了在高维空间中的计算!

常用核函数 ​

1 线性核

k(x1,x2)=x1⋅x2(原始空间的内积)

目的:映射前和映射后,形式上统一了起来。写个通用模板,再带入不同的核就可以了。

2 高斯核

k(x1,x2)=exp⁡(−∥x1−x2∥22σ2)

高斯核函数,非常灵活,应用很广泛。可以映射到无穷维。

σ 的选择

  • 太大:权重衰减快,相当于映射到低维子空间
  • 太小:将任意数据线性可分,容易陷入严重过拟合

3 多项式核

k(x1,x2)=((x1,x2)+R)d

核函数总结 ​

问题的出现

  • 数据线性不可分,要映射到高维空间中去
  • 不能无脑低维组合映射到高维空间,维度太大根本没法计算

核函数的功能

  • 将特征向由低维向高维的转换
  • 直接在低位空间中进行计算
  • 实际的分类效果却是在高维上
  • 避免了直接在高维空间中的复杂计算

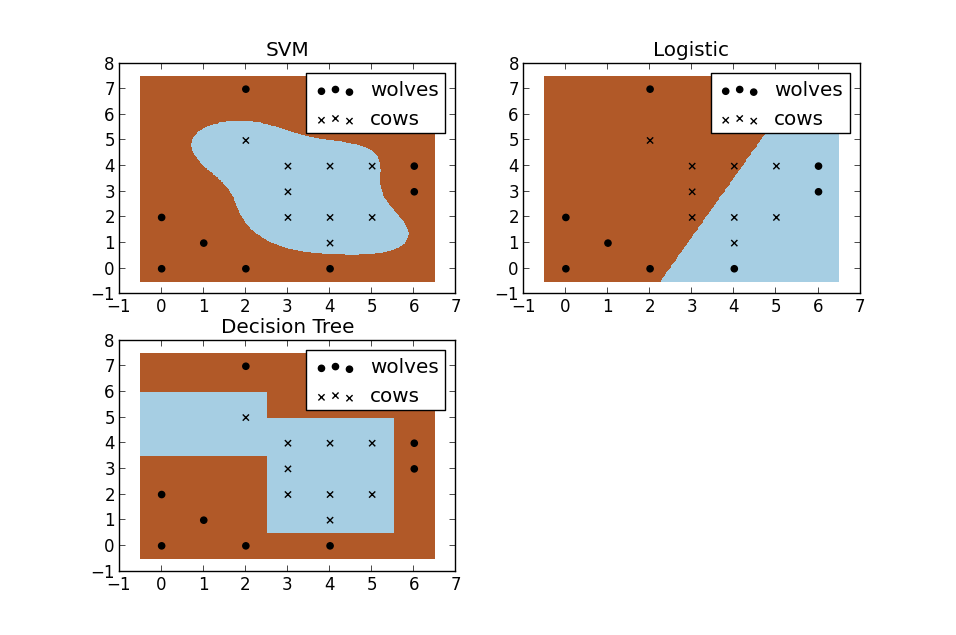
SVM曲线,逻辑回归和决策树是直线。SVM的效果好。

松弛变量软间隔最大化 ​

定义 ​

数据可能有一些噪声特异点outlier导致不是线性可分或者效果不好。 如果不处理outlier,则会非常影响SVM。因为本身支持向量就只有几个。
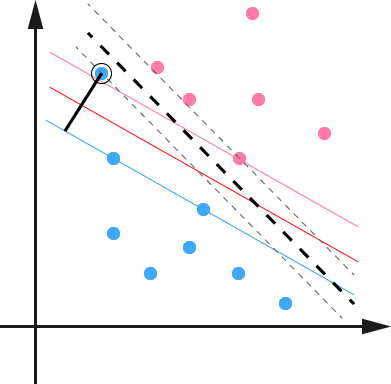
给每个数据点加上松弛变量ξi≥0, 使函数间隔+松弛变量大于等于1,即约束条件:

yi(w⋅xi+b)≥1−ξi,ξi≥0

为每个松弛变量ξi支付一个代价ξi, 新的目标函数和约束条件如下:

min12∥w∥2+C∑i=1nξis.t,yi(w⋅xi+b)≥1−ξi,ξi≥0

惩罚系数C是一个常数

  • C大时,对误分类的惩罚增大
  • C来调节权衡:使间隔尽量大;误分类点个数尽量少

求解 ​

定义新的拉格朗日函数:

L(w,b,ξ,α,r)=12∥w∥2+C∑i=1nξi−∑i=1nαi(yi(wTxi+b)−1+ξi)−∑i=1nriξi

和前面对偶问题求解一样,求导求解:

∂L∂w=0→w=∑i=1nαiyixi∂L∂b=0→∑i=1nαiyi=0∂L∂ξ=0→C−αi−ri=0

带入,得到新的L

maxαL=∑i=1nαi−12∑i=1n∑i=1nαiαjyiyj(xi⋅xj)

约束条件:

0≤αi≤C,∑i=1nαiyi=0

SVM的深层理解 ​

感知机算法 ​

感知机算法是一个二类分类的线性模型,也是找一个超平面进行划分数据:

f(x)=sign(w⋅x+b)

损失函数是所有误分类点到超平面的总距离:

minw,bL(w,b)=−∑xi∈Myi(w⋅xi+b)

可以使用SGD对损失函数进行优化。

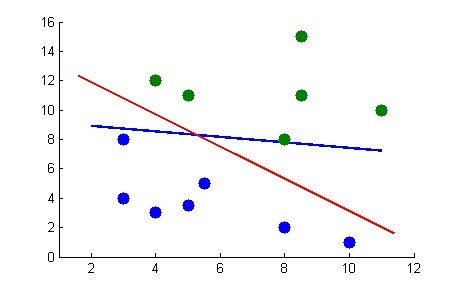
当训练数据集线性可分时,感知机算法是收敛的。可以在一定迭代次数上,找到一个超平面,有很多个解。

感知机的超平面不是最优效果,最优是SVM。
损失函数 ​

数据x, 预测值f(x)=y^, 真实值y。

常见损失

  1. 01损失
L(y,y^)={1,y≠y^0,y=y^
  1. 平方损失

    L(y,y^)=(y−y^)2
  2. 绝对损失

    L(y,y^)=|y−y^|
  3. 对数损失

    L(y,y^)=−log⁡P(yx^)

期望损失

期望损失也称为风险函数,需要知道联合概率分布P(X,Y), 一般不知道。

Rexp=Ep[L(y,y^)]=∫(x,y)L(y,y^)P(x,y)dxdy

经验损失

经验损失也成为经验风险 ,所以监督学习就是要经验风险最小化。

Remp(f)=1N∑i=1NL(yi,y^i)

结构风险最小化

样本数量太小时,容易过拟合。需要加上正则化项,也称为惩罚项。 模型越复杂,越大。

Rsrm(f)=1N∑i=1NL(yi,y^i)+λJ(f)

λ≥0 是系数,权衡经验风险和模型复杂度。 监督学习,就是要使结构风险最小化。

SVM也是最优化+损失最小。 可以从损失函数和优化算法角度去看SVM、boosting、LR,可能会有不同的收获。

SVM的合页损失函数 ​

从最优化+损失最小的角度去理解SVM。

最小二乘法 ​

最小二乘法,就是通过最小化误差的平方来进行数学优化。对参数进行求偏导,进行求解。

SMO ​

模型

min12∥w∥2+C∑i=1nξis.t,yi(w⋅xi+b)≥1−ξi,ξi≥0

序列最小最优化SMO (Sequential minimal optimization),解决求解α的问题:

minαL=12∑i=1n∑i=1nαiαjyiyjK(xi,xj)−∑i=1nαis.t,0≤αi≤C,∑i=1nαiyi=0

如果所有变量的解都满足KKT条件,则最优化问题的解已经得到。

思想

每次抽取两个乘子α1,α2,然后固定其他乘子,针对这两个变量构建一个子二次规划问题,进行求解。不断迭代求解子问题,最终解得原问题。

选择乘子

α1选择违反KKT条件最严重的,α2选择让α1变化最大的。

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026