Skip to content

马尔可夫模型

📅 发表于 2017/08/04
🔄 更新于 2025/07/23
👁️ — 次访问
📝 3464 字
⏳ 10 分钟
自然语言处理
#概率图模型
#自然语言处理
#马尔可夫链
#隐马尔科夫模型
#维特比算法
#前向算法
#后向算法,BW算法

本文包括概率图模型、马尔科夫模型和隐马尔可夫模型。重点是HMM的前后向算法、维特比算法和BW算法

概述 ​

产生式和判别式 ​

判别方法 由数据直接去学习决策函数Y=f(X) 或者P(Y∣X)作为预测模型 ,即判别模型

生成方法 先求出联合概率密度P(X,Y),然后求出条件概率密度P(Y∣X)。即生成模型P(Y∣X)=P(X,Y)P(X)

判别式生成式
原理直接求Y=f(X) 或P(Y∣X)先求P(X,Y),然后 P(Y∣X)=P(X,Y)P(X)
差别只关心差别,根据差别分类关心数据怎么生成的,然后进行分类
应用k近邻、感知机、决策树、LR、SVM朴素贝叶斯、隐马尔可夫模型

概率图模型 ​

概率图模型(probabilistic graphical models) 在概率模型的基础上,使用了基于图的方法来表示概率分布。节点表示变量,边表示变量之间的概率关系

概率图模型便于理解、降低参数、简化计算,在下文的贝叶斯网络中会进行说明。

贝叶斯网络 ​

贝叶斯网络 又称为信度网络或者信念网络(belief networks),实际上就是一个有向无环图。

节点表示随机变量;边表示条件依存关系。没有边说明两个变量在某些情况下条件独立或者说是计算独立,有边说明任何条件下都不条件独立。
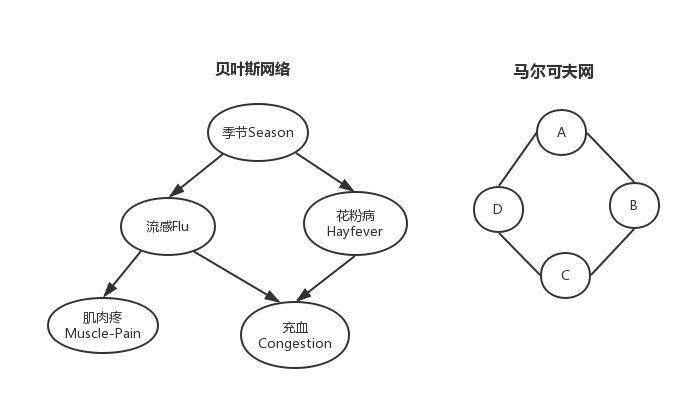
如上图所示,要表示上述情况的概率只需要求出4∗2∗2∗2∗2−1=63个参数的联合概率密度就行了,实际上这个太难以求得。我们可以考虑一下独立关系(F⊥H∣S)表示在S确定的情况下,F和H独立,所以有以下独立关系:

(F⊥H∣S)、(C⊥S∣F,H)、(M⊥H,C∣F)、(M⊥C|F)

所以我们得到如下的计算独立假设:

P(C∣FHS)=P(C∣FH),即假设C只与FH有关,而与S无关

又由P(AB)=P(A|B)P(B),所以得到联合概率分布:

P(SFHMC)=P(M∣SHFC)⋅P(SHFC)=P(M∣F)⏟计算独立性⋅P(C∣SHF)⋅P(SHF)⏟继续分解=P(M∣F)⋅P(C∣FH)⋅P(F∣S)⋅P(H∣S)⋅P(S)

P(S) 4个季节,需要3个参数;P(H∣S)时,P(Y∣Spring) 和 P(N∣Spring)只需要一个参数,所以P(H∣S)只需要4个参数即可,其他同理。

所以联合概率密度就转化成了上述公式中的5个乘积项,其中每一项需要的参数个数分别是2、4、4、4、3,所以一共只需要17个参数,这就大大降低了参数的个数。

马尔可夫模型 ​

简介 ​

马尔可夫模型(Markov Model) 描述了一类重要的随机过程,未来只依赖于现在,不依赖于过去。这样的特性的称为马尔可夫性,具有这样特性的过程称为马尔可夫过程。

时间和状态都是离散的马尔可夫过程称为马尔可夫链,简称马氏链,关键定义如下

  • 系统有N个状态S={s1,s2,⋯,sN},随着时间的推移,系统将从某一状态转移到另一状态
  • 设qt∈S是系统在t时刻的状态,Q={qq,q2,⋯,qT}系统时间的随机变量序列

一般地,系统在时间t时的状态sj取决于[1,t−1]的所有状态{q1,q2,⋯,qt−1},则当前时间的概率是

P(qt=sj∣qt−1=si,qt−2=sk,⋯)

在时刻m处于si状态,那么在时刻m+n转移到状态sj的概率称为转移概率,即从时刻m→m+n:

Pij(m,m+n)=P(qm+n=sj∣qm=si)

如果Pij(m,m+n)只与状态i,j和步长n有关,而与起始时间m无关,则记为Pij(n),称为n步转移概率。 并且称此转移概率具有平稳性,且称此链是齐次的,称为齐次马氏链,我们重点研究齐次马氏链。P(n)=[Pij(n)]称为n步转移矩阵。

Pij(m,m+n)=Pij(n)=P(qm+n=sj∣qm=si)

特别地,n=1时,有一步转移概率如下

pij=Pij(1)=P(qm+1∣qm)=aij

一阶马尔可夫 ​

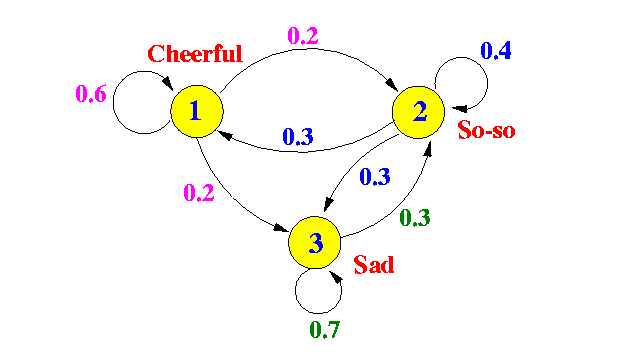
特别地,如果**t时刻状态只与t−1时刻状态有关**,那么下有离散的一阶马尔可夫链如下:

P(qt=sj∣qt−1=si,qt−2=sk,⋯)=P(qt=sj∣qt−1=si)

其中t−1​的状态si​转移到t​的状态sj​的概率定义如下:

P(qt=sj∣qt−1=si)=aij,其中i,j∈[1,N],aij≥0,∑j=1Naij=1

显然,N​个状态的一阶马尔可夫链有N2​次状态转移,这些概率aij​构成了状态转移矩阵。

A=[aij]=[a11a12⋯a1na21a22⋯a2n⋮⋮⋱⋮an1an2⋯ann]

设系统在初始状态的概率向量是 πi≥0 ,其中,∑i=1Nπi=1

那么时间序列Q={q1,q2,⋯,qT}出现的概率是

P(q1,q2,⋯,qT)=P(q1)P(q2∣q1)P(q3∣q2)⋯P(qT∣qT−1)=πq1⏟初态概率∏t=1T−1aqtqt+1

下图是一个例子

多步转移概率 ​

对于齐次马氏链,多步转移概率就是u+v时间段的状态转移,可以分解为先转移u步,再转移v步。则有CK方程的矩阵形式

P(u+v)=P(u)P(v)

由此得到n步转移概率矩阵是一次转移概率矩阵的n次方

P(n)=P(1)P(n−1)=PP(n−1)⟹P(n)=Pn

对于求矩阵的幂An,则最好使用相似对角化来进行矩阵连乘。

存在一个可逆矩阵P,使得P−1AP=Λ,A=PΛP−1,其中Λ是矩阵A的特征值矩阵

Λ=[λ1λ2⋱λn],其中λ是矩阵A的特征值

则有An=PΛnP−1

遍历性 ​

齐次马氏链,状态i向状态j转移,经过无穷步,任何状态si经过无穷步转移到状态sj的概率收敛于一个定值πj,即limn→∞Pij(n)=πj(与i无关) 则称此链具有遍历性。若∑j=1Nπj=1,则称π→=(π1,π2,⋯)为链的极限分布。

遍历性的充分条件:如果存在正整数m(步数),使得对于任意的,都有如下(转移概率大于0),则该马氏链具有遍历性

Pij(m)>0,i,j=1,2,⋯,N,si,sj∈S

那么它的极限分布π→=(π1,π2,⋯,πN)​,它是下面方程组的唯一解

π=πP,即πj=∑i=1Nπipij,其中πj>0,∑j=1Nπj=1

PageRank应用 ​

有很多应用,压缩算法、排队论等统计建模、语音识别、基因预测、搜索引擎鉴别网页质量-PR值。

Page Rank算法

这是Google最核心的算法,用于给每个网页价值评分,是Google“在垃圾中找黄金”的关键算法。

大致思想是要为搜索引擎返回最相关的页面。页面相关度是由和当前网页相关的一些页面决定的。

  • 当前页面会把自己的importance平均传递给它所指向的页面,若有k个,则为每个传递1k

  • 如果有很多页面都指向当前页面,则当前页面很重要,相关度高

  • 当前页面有一些来自官方页面的backlink,当前页面很重要

例如有4个页面,分别如下
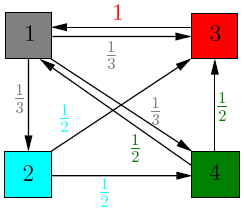
矩阵A是页面跳转的一次转移矩阵,q是当前时间每个页面的相关度向量,即PageRank vector。

A=[00112130001312012131200]初始时刻,q=[14141414]

A的一列是当前页面出去的所有页面,一行是进入当前页面的所有页面。设u表示第A的第i行,那么u∗q就表示当页面i接受当前q的更新后的rank值。

定义矩阵G=αA+(1−α)1nU,对A进行修正,G所有元素大于0,具有遍历性

  • α∈[0,1](α=0.85) 阻尼因子
  • A 一步转移矩阵
  • n 页面数量
  • U 元素全为1的矩阵

使用G进行迭代的好处

  • 解决了很多A元素为0导致的问题,如没有超链接的节点,不连接的图等
  • A所有元素大于0,具有遍历性,具有极限分布,即它的极限分布q会收敛

那么通过迭代就可以求出PR向量qnext=Gqcur,实际上q是G的特征值为1的特征向量。

迭代具体计算如下图(下图没有使用G,是使用A去算的,这是网上找的图[捂脸])
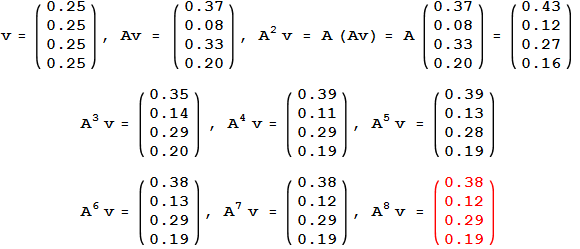
随着迭代,q会收敛,那么称为q就是PageRank vector。

我们知道节点1有2个backlink,3有3个backlink。但是节点1却比3更加相关,这是为什么呢?因为节点3虽然有3个backlink,但是却只有1个outgoing,只指向了页面1。这样的话它就把它所有的importance都传递给了1,所以页面1也就比页面3的相关度高。

隐马尔可夫模型 ​

定义 ​

隐马尔可夫模型(Hidden Markov Model, HMM)是统计模型,它用来描述含有隐含未知参数的马尔可夫过程。其难点是从可观察的参数中确定该过程的隐含参数,然后利用这些参数来做进一步的分析。大概形状如下
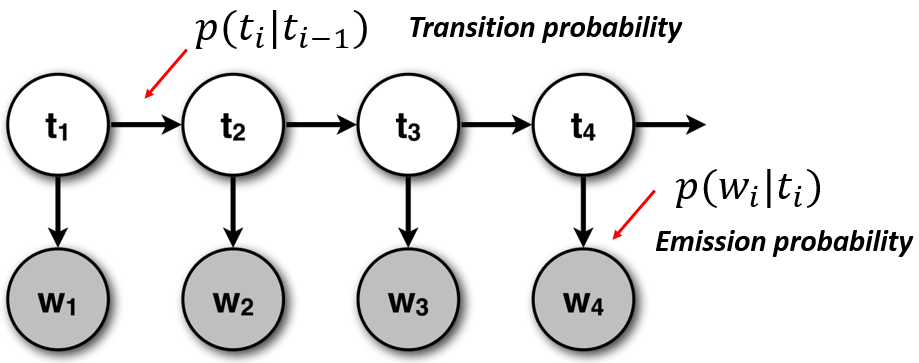
一个HMM由以下5个部分构成。

隐藏状态

  • 模型的状态,隐蔽不可观察
  • 有N种,隐状态种类集合S={s1,s2,⋯,sN}会相
  • 隐藏状态互相互转换,一步转移。si转移到sj的概率 aij=P(qt=sj∣qt−1=si)
  • qt=si 代表在t时刻,系统隐藏状态qt是si
  • 隐状态时间序列 Q={q1,q2,⋯,qt,qt+1⋯}

观察状态

  • 模型可以显示观察到的状态
  • 有M种,显状态种类集合K={v1,v2,⋯,vM}。不能相互转换,只能由隐状态产生(发射)
  • ot=vk​ 代表在t​时刻,系统的观察状态ot​是vk​
  • 每一个隐藏状态会发射一个观察状态。sj发射符号vk的概率bj(k)=P(ot=vk∣sj)
  • 显状态时间序列 O={o1,o2,⋯,ot}

状态转移矩阵A (隐--隐)

  • 从一个隐状si转移到另一个隐状sj的概率。A={aij}
  • aij=P(qt=sj∣qt−1=si),其中 1≤i,j≤N,aij≥0,∑j=1Naij=1

发射概率矩阵B (隐--显)

  • 一个隐状sj发射出一个显状vk的概率。B={bj(k)}
  • bj(k)=P(ot=vk∣sj),其中1≤j≤N;1≤k≤M;bjk≥0;∑k=1Mbjk=1

初始状态概率分布 π

  • 最初的隐状态q1=si的概率是πi=P(q1=si)
  • 其中1≤i≤N,πi≥0,∑i=1Nπi=1

一般地,一个HMM记作一个五元组μ=(S,K,A,B,π),有时也简单记作μ=(A,B,π)。一般,当考虑潜在事件随机生成表面事件的时候,HMM是非常有用的。

HMM中的三个问题

  • 观察序列概率 给定观察序列O={o1,o2,⋯,oT}和模型μ=(A,B,π),求当前观察序列O的出现概率P(O∣μ)
  • 状态序列概率 给定观察序列O={o1,o2,⋯,oT}和模型μ=(A,B,π),求一个最优的状态序列Q={q1,q2,⋯,qT}的出现概率,使得最好解释当前观察序列O
  • 训练问题或参数估计问题 给定观察序列O={o1,o2,⋯,oT},调节模型μ=(A,B,π)参数,使得P(O∣u)最大

前后向算法 ​

给定观察序列O={o1,o2,⋯,oT}和模型μ=(A,B,π),求给定模型μ的情况下观察序列O的出现概率。这是解码问题。如果直接去求,计算量会出现指数爆炸,那么会很不好求。我们这里使用前向算法和后向算法进行求解。

前向算法

前向变量αt(i)是系统在t时刻,观察序列为O=o1o2⋯ot并且隐状态为qt=si的概率,即

αt(i)=P(o1o2⋯ot,qt=si∣μ)

P(O∣μ) 是在t时刻,状态qt= 所有隐状态的情况下,输出序列O的概率之和

P(O∣μ)=∑i=1NP(O,qt=si∣μ)=∑i=1Nαt(i)

接下来就是计算αt(i),其实是有动态规划的思想,有如下递推公式

αt+1(j)=(∑i=1Nαt(i)aij)⏟所有状态i转为j的概率bj(ot+1)⏟状态j发射ot+1

上述计算,其实是分为了下面3步

  • 从1到达时间t,状态为si,输出o1o2⋯ot。αt(i)
  • 从t到达t+1,状态变化si→sj。aij
  • 在t+1时刻,输出ot+1。bj(ot+1)

算法的步骤如下

  • 初始化 α1(i)=πibi(o1),1≤i≤N
  • 归纳计算 αt+1(j)=(∑i=1Nαt(i)aij)bj(ot+1),1≤t≤T−1
  • 求和终结 P(O∣μ)=∑i=1NαT(i)

在每个时刻t,需要考虑N个状态转移到sj的可能性,同时也需要计算αt(1),⋯,αt(N),所以时间复杂度为O(N2)。同时在系统中有T个时间,所以总的复杂度为O(N2T)。

后向算法

后向变量 βt(i) 是系统在t时刻,状态为si的条件下,输出为ot+1ot+2⋯oT的概率,即

βt(i)=P(ot+1ot+2⋯oT∣qt=si,μ)

递推 βt(i)的思路及公式如下

  • 从t→t+1,状态变化si→sj,并从sj⟹ot+1,发射ot+1
  • 在qt+1=sj的条件下,输出序列ot+2⋯oT
βt(i)=∑j=1Naijbj(ot+1)βt+1(j)⏟si转sjsj发ot+1t+1时sj后面{ot+2,⋯}

上面的公式个人的思路解释如下(不明白公式再看)

  • 其实要从βt+1(j)→βt(i)
  • βt+1(j)是t+1时刻状态为sj,后面的观察序列为ot+2,⋯,oT
  • βt(i)是t时刻状态为si,后面的观察序列为ot+1,ot+2,⋯,oT
  • t→t+1 si会变成各种sj,βt(i)只关心t+1时刻的显示状态为ot+1,而不关心隐状态,所以是所有隐状态发射ot+1的概率和
  • aijbj(ot+1)βt+1(j),si转为sj的概率,在t+1时刻sj发射ot+1的概率,t+1时刻状态为sj 观察序列为ot+2,⋯,oT的概率
  • 把上述概率加起来,就得到了t时刻为si,后面的观察为ot+1,ot+2,⋯,oT的概率βt(i)

上式是把所有从t+1→t的概率加起来,得到t的概率。算法步骤如下

  • 初始化 βT(i)=1,1≤i≤N
  • 归纳计算 βt(i)=∑j=1Naijbj(ot+1)βt+1(j),1≤t≤T−1;1≤i≤N
  • 求和终结 P(O∣μ)=∑i=1Nπibi(o1)β1(i)

前后向算法结合

模型μ,观察序列O={o1,o2,⋯,ot,ot+1⋯,oT},t时刻状态为qt=si的概率如下

P(O,qt=si∣μ)=αt(i)×βt(i)

推导过程如下

P(O,qt=si∣μ)=P(o1⋯oT,qt=si∣μ)=P(o1⋯ot,qt=si,ot+1⋯oT∣μ)=P(o1⋯ot,qt=si∣μ)×P(ot+1⋯oT∣o1⋯ot,qt=si,μ)=αt(i)×P((ot+1⋯oT∣qt=si,μ)(显然o1⋯ot是显然成立的,概率为1,条件忽略)=αt(i)×βt(i)

所以,把qt等于所有si的概率加起来就可以得到观察概率P(O∣μ)

P(O∣μ)=∑i=1N αt(i)×βt(i),1≤t≤T

维特比算法 ​

维特比(Viterbi)算法用于求解HMM的第二个问题状态序列问题。即给定观察序列O=o1o2⋯oT和模型μ=(A,B,π),求一个最优的状态序列Q=q1q2⋯qT。

有两种理解最优的思路。

  • 使该状态序列中每一个状态都单独地具有最大概率,即γt(i)=P(qt=si∣O,μ)最大。但可能出现aqtqt+1=0的情况
  • 另一种是,使整个状态序列概率最大,即P(Q∣O,μ)最大。Q^=argmaxQP(Q∣O,μ)

维特比变量 δt(i)是,在t时刻,qt=si ,HMM沿着某一条路径到达状态si,并输出观察序列o1o2⋯ot的概率。

δt(i)=arg⁡maxq1⋯qt−1P(q1⋯qt−1,qt=si,o1⋯ot∣μ)

递推关系

δt+1(i)=maxj[δt(j)⋅aji]⋅bi(ot+1)

路径记忆变量 ψt(i)=k 表示qt=si,qt−1=sk,即表示在该路径上状态qt=si的前一个状态qt−1=sk。

维特比算法步骤

初始化

δ1(i)=πibi(o1),1≤i≤N,路径变量ψ1(i)=0

归纳计算

维特比变量 δt(j)=max1≤i≤N[δt−1(i)⋅aij]⋅bj(ot),2≤t≤T;1≤j≤N

记忆路径(记住参数i就行) ψt(j)=arg⁡max1≤i≤N[δt−1(i)⋅aij]⋅bj(ot),2≤t≤T;1≤j≤N

终结

QT^=arg⁡max1≤i≤N[δT(i)],P^(QT^)=max1≤i≤N[δT(i)]

路径(状态序列)回溯

qt^=ψt+1(q^t+1),t=T−1,T−2,⋯,1

Baum-Welch算法 ​

Baum-Welch算法用于解决HMM的第3个问题,参数估计问题,给定一个观察序列O=o1o2⋯oT,去调节模型μ=(A,B,π)的参数使得P(O∣μ)最大化,即argmaxμ⁡P(Otraining∣μ)。模型参数主要是aij,bj(k)和πi,详细信息见上文。

有完整语料库

如果我们知道观察序列O=o1o2⋯oT和状态序列Q=q1q2⋯qT,那么我们可以根据最大似然估计去计算HMM的参数。

设δ(x,y)是克罗耐克函数,当x==y时为1,否则为0。计算步骤如下

初始概率π¯i=δ(q1,s1)转移概率a¯ij=si→sj的次数si→all的次数=∑t=1T−1δ(qt,si)×δ(qt+1,sj)∑t=1T−1δ(qt,si)发射概率b¯j(k)=sj→vk的次数Q到达qj的次数=∑t=1Tδ(qt,si)×δ(ot,vk)∑t=1Tδ(qt,sj)

但是一般情况下是不知道隐藏状态序列Q​的,还好我们可以使用期望最大算法去进行含有隐变量的参数估计。主要思路如下。

我们可以给定初始值模型μ0,然后通过EM算法去估计隐变量Q的期望来代替实际出现的次数,再通过上式去进行计算新的参数得到新的模型μ1,再如此迭代直到参数收敛。

这种迭代爬山算法可以局部地使P(O∣μ)最大化,BW算法就是具体实现这种EM算法。

Baum-Welch算法

给定HMM的参数μ和观察序列O=o1o2⋯oT。

定义t时刻状态为si和t+1时刻状态为sj的概率是ξt(i,j)=P(qt=si,qt+1=sj∣O,μ)

ξt(i,j)=P(qt=si,qt+1=sj,O∣μ)P(O∣μ)=αt(i)aijbj(ot+1)βt+1(j)P(O∣μ)=αt(i)aijbj(ot+1)βt+1(j)⏞o1⋯ot,ot+1,ot+2⋯oT∑i=1N∑j=1Nαt(i)aijbj(ot+1)βt+1(j)⏟ξt(i,j)对ij求和,只留下P(O∣μ)

定义**t时刻状态为si的概率**是γt(i)=P(qt=si∣O,μ)

γt(i)=∑j=1Nξt(i,j)

那么有算法步骤如下(也称作前向后向算法)

1初始化

随机地给参数aij,bj(k),πi赋值,当然要满足一些基本条件,各个概率和为1。得到模型μ0,令i=0,执行下面步骤

2EM步骤

2.1E步骤 使用模型μi计算ξt(i,j)和γt(i)

ξt(i,j)=αt(i)aijbj(ot+1)βt+1(j)∑i=1N∑j=1Nαt(i)aijbj(ot+1)βt+1(j),γt(i)=∑j=1Nξt(i,j)

2.2M步骤 用上面算得的期望去估计参数

初始概率π¯i=P(q1=si∣O,μ)=γ1(i)转移概率a¯ij=∑t=1T−1ξt(i,j)∑t=1T−1γt(i)发射概率b¯j(k)=∑t=1Tγt(j)×δ(ot,vk)∑t=1Tγt(j)

3循环计算 令i=i+1,直到参数收敛

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026