Skip to content

最大期望算法

📅 发表于 2017/08/13
🔄 更新于 2025/07/23
👁️ — 次访问
📝 860 字
⏳ 3 分钟
机器学习
#机器学习
#最大期望算法
#Jensen不等式

本文简单记录了EM算法的思想和Jensen不等式

EM算法定义 ​

背景 ​

如果概率模型的变量都是观测变量,那么可以直接使用极大似然估计法或贝叶斯估计法去估计模型参数。

如果模型既有观测变量又有隐变量,就不能简单使用上述方法。

EM算法,期望极大算法,就是含有隐变量的概率模型参数的极大似然估计法或极大后验概率估计法,是一种迭代算法。每次迭代分为如下两步

  • E步:求期望(expectation)
  • M步:求极大(maximization)

三硬币模型 ​

有3枚硬币,记做ABC,每次出现正面的概率分别是π,p,q。先掷A,正面选B,反面选C。再掷B/C,得到正面1或反面0作为一次的结果。问:去估计参数θ=(π,p,q)

  • 观察变量:一次 实验得到的结果1或0,记做y
  • 隐变量:A的结果,即掷的是B还是C,记做z

对于一次实验,求出y的概率分布

P(y∣θ)=∑zP(y,z∣θ)⏟把所有z的y加起来=∑zP(z∣θ)P(y∣z,θ)⏟贝叶斯公式=πpy(1−p)1−y⏟z=1时+(1−π)qy(1−q)1−y⏟z=0时

设观察序列Y=(y1,y2,⋯,yn)T,隐藏数据Z=(z1,z2,⋯,zn)T,则观测数据的似然函数为

P(Y∣θ)=∑ZP(Z∣θ)P(Y∣Z,θ)=∏i=1n[πpyi(1−p)1−yi+(1−π)qyi(1−q)1−yi]

求模型参数θ=(π,p,q)的最大似然估计,即

θ^=argmaxθlog⁡P(Y∣θ)

这个问题不能直接求解,只有通过迭代的方法求解。EM算法就是解决这种问题的一种迭代算法。先给θ(0) 选择初始值,然后去迭代。每次迭代分为E步和M步。

EM算法 ​

基本概念

一些概念如下

  • Y 观测变量,Z 隐变量
  • 不完全数据:Y;概率分布:P(Y∣θ);对数似然函数:L(θ)=log⁡P(Y∣θ)
  • 完全数据:Y和Z合在一起;概率分布:P(Y,Z∣θ);对数似然函数:log⁡P(Y,Z∣θ)

EM算法通过迭代求L(θ)=log⁡P(Y∣θ)的极大似然估计。

概率论函数的期望

设Y是随机变量X的函数,Y=g(X),g是连续函数,那么

X是离散型变量,X的分布律为P(X=xi)=pi,i=1,2,3⋯,则有

E(Y)=E(g(X))=∑i=1∞g(xi)pi,左式收敛时成立

X是 连续型变量,X的概率密度为f(x),则有

E(Y)=E(g(X))=∫−∞+∞g(x)f(x)dx,左式绝对收敛成立

Q函数

Q(θ,θ(i))是EM算法的核心。它是完全数据的对数似然函数log⁡P(Y,Z∣θ)的期望,是关于未观测数据Z的条件概率分布P(Z∣Y,θ(i)),而Z的条件是在给定观测数据Y和当前参数θ(i)。(都是后置定语,不通顺)

Q(θ,θ(i))=EZ[log⁡P(Y,Z∣θ)∣Y,θ(i)]=∑Zlog⁡P(Y,Z∣θ)P(Z∣Y,θ(i))

下面是我具体的理解

  • θ(i)是第i次迭代参数θ的估计值

  • P(Z∣Y,θ(i))是以Y和当前参数θ(i)的条件下的分布律,简写为P(Z)。类似于上面的X

  • P(Y,Z∣θ) 是在以θ为参数的分布的联合概率密度,简写为P(Y,Z)。类似于上面的Y=g(X)

  • 求对数似然函数log⁡P(Y,Z)的期望,转移到隐变量Z上

  • 把目标函数映射到Z上,g(z)=log⁡P(Y,Z),E(g(z))=∑zlog⁡P(Y,Z)P(Z)

  • Q(θ,θ(i)) 是因为要找到一个新的θ优于之前的θ(i),是代表的分布优于

EM算法步骤

输入:Y 观测变量,Z 隐藏变量,P(Y,Z∣θ) 联合分布,条件分布 P(Z∣Y,θ)

输出:模型参数θ

步骤

  • 选择参数初始值θ(0),开始迭代
  • E步:第i+1次迭代, 求 Q(θ,θ(i))=∑Zlog⁡P(Y,Z∣θ)P(Z∣Y,θ(i))
  • M步:求使Q(θ,θ(i))极大化的θ,得到i+1次迭代新的估计值θ(i+1)=argmaxθ(Q(θ,θ(i)))
  • 重复E和M步,直到收敛

Jensen不等式 ​

凸函数与凹函数

从图像上讲,在函数上两点连接一条直线。直线完全在图像上面,就是凸函数 convex;完全在下面,就是凹函数 concave。
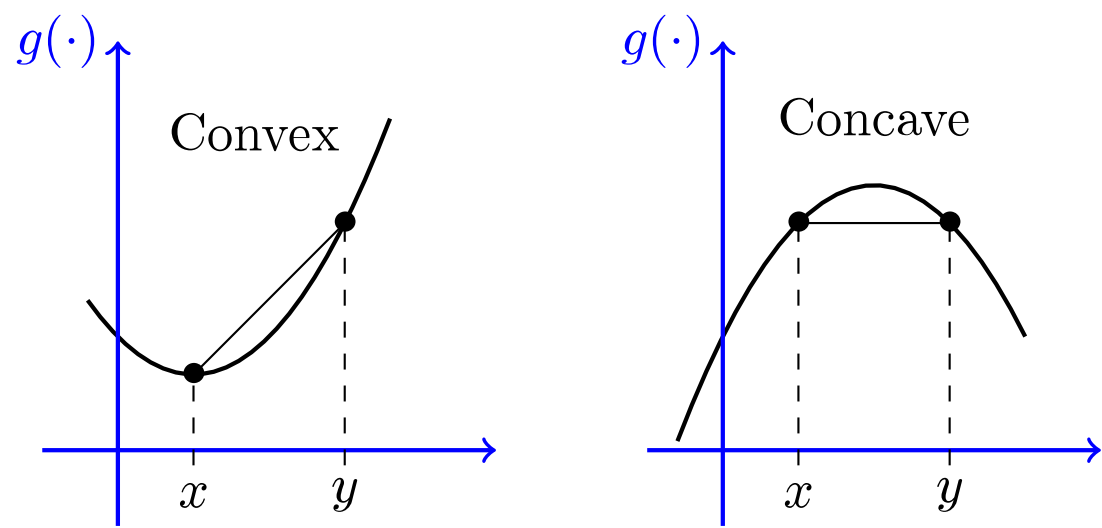
f′′(x)≥0⟹f(x)是凸函数;f′′(x)≤0⟹f(x)是凹函数

Jensen不等式

函数f(x)​,上有两点x1,x2​,对于任意λ∈[0,1]​

  • 如果f(x)是凸函数,f(λx1+(1−λ)x2)≤λf(x1)+(1−λ)f(x2)
  • 如果f(x)是凹函数,f(λx1+(1−λ)x2)≥λf(x1)+(1−λ)f(x2)

一般地,n个点x1,x2,⋯,xn和参数λ1+λ2+⋯+λn=1,对于凸函数,则有

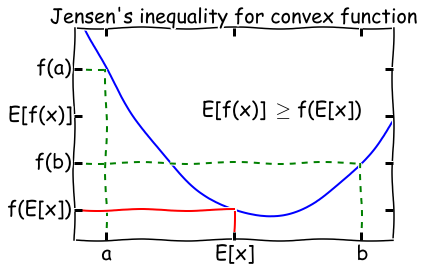
f(λ1x1+λ2x2+⋯+λnxn⏟E[X],总体是f(E[X]))≤f(λ1x1)+f(λ2x2)+⋯+f(λnxn)⏟E[f(X)],即f(∑i=1nλixi)≤∑i=1nf(λixi)

琴声不等式

  • 凸函数 f(E[X])≤E[f(X)],即f(∑i=1nλixi)≤∑i=1nf(λixi)
  • 凹函数 f(E[X])≥E[f(X)],即f(∑i=1nλixi)≥∑i=1nf(λixi)
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026