Skip to content

条件随机场

📅 发表于 2017/09/28
🔄 更新于 2025/07/23
👁️ — 次访问
📝 2906 字
⏳ 9 分钟
自然语言处理
#条件随机场
#概率无向图
#概率计算问题
#学习算法
#预测问题
#维特比
#前向后向
#迭代尺度法

条件随机场(Conditional Random Field, CRF)是给定一组输入随机变量条件下另一组输出随机变量的条件概率分布模型。常常用于标注问题。隐马尔科夫模型和条件随机场是自然语言处理中最重要的算法。CRF最重要的就是根据观测序列,把标记序列给推测出来。

概率无向图模型 ​

概率无向图模型又称为马尔科夫随机场,是一个可以由无向图表示的联合概率分布。一些类似内容。

有一组随机变量Y∈Γ,联合概率分布为P(Y),由图G=(V,E)表示。节点v代表变量Yv,节点之间的边代表两个变量的概率依赖关系。

定义 ​

马尔可夫性就是说,给定一些条件下,没有连接的节点之间是条件独立的。

成对马尔可夫性

设u和v是两个没有边连接的节点,其它所有节点为O。成对马尔可夫性是说,给定随机变量组YO的条件下,随机变量Yu和Yv是独立的。即有如下:

P(Yu,Yv∣YO)=P(Yu∣YO)P(Yv∣YO)

局部马尔可夫性

节点v,W是与v连接的所有节点,O是与v没有连接的节点。局部马尔可夫性认为,给定Yw的条件下,Yv和YO独立。即有:

P(Yv,YO∣YW)=P(Yv∣YW)P(YO∣YW)

全局马尔可夫性

节点集合A,B被中间节点集合C分隔开,即不相连。全局马尔可夫性认为,给定YC的条件下,YA和YB是独立的。即有:

P(YA,YB∣YC)=P(YA∣YC)P(YB∣YC)

上面的3个马尔可夫性的定义是等价的。

概率无向图模型

设有联合概率密度P(Y),由无向图G=(V,E)表示。节点表示随机变量,边表示随机变量之间的依赖关系。如果联合概率密度P(Y)满足马尔可夫性,那么就称此联合概率分布为概率图模型,或马尔可夫随机场。

实际上我们更关心怎么求联合概率密度,一般是把整体的联合概率写成若干个子联合概率的乘积,即进行因子分解。概率无向图模型最大的优点就是易于因子分解。

概率无向图因子分解 ​

团与最大团

团:无向图中的一个子集,任何两个节点均有边连接。

最大团:无向图中的一个子集,任何两个节点均有边连接。不能再加入一个节点组成更大的团了。
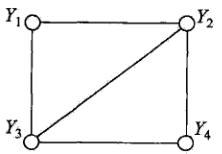
如{Y1,Y2},{Y1,Y2,Y3} 都是团,其中后者是最大团。而{Y1,Y2,Y3,Y4} 不是团,因为Y1和Y4没有边连接。

因子分解

有无向图模型G, C 是 G 上的最大团,有很多个。YC 是C 对应的随机变量。则联合概率分布P(Y) 可以写成多个最大团C 上的势函数的乘积。

P(Y)=1Z∏CΨC(YC),Z=∑Y∏CΨC(YC)

其中Z是规范化因子。ΨC(YC)是 势函数,是一个严格正函数。等式左右两端都取条件概率也是可以的。下文就是。

ΨC(YC)=exp⁡(−E(YC))

其中E(YC) 是能量函数。

条件随机场的定义与形式 ​

HMM的问题 ​

这里是HMM的讲解 。HMM有下面几个问题

  • 需要给出隐状态和观察符号的联合概率分布,即发射概率 bj(k),是生成式模型,也是它们的通病。
  • 观察符号需要是离散的,可以枚举的,要遍历所有观察符号。如果是一个连续序列,则不行。
  • 观察符号是独立的,没有观察相互之间的依赖关系。如一个句子的前后,都有关联才是。即输出独立性假设问题。
  • 无法考虑除了字词顺序以外的其它特征。比如字母为大小写,包含数字等。
  • 标注偏置问题。

标注偏置问题,举例,是说有两个单词"rib-123"和"rob-456","ri"应该标记为"12","ro"应该标记为"45"。
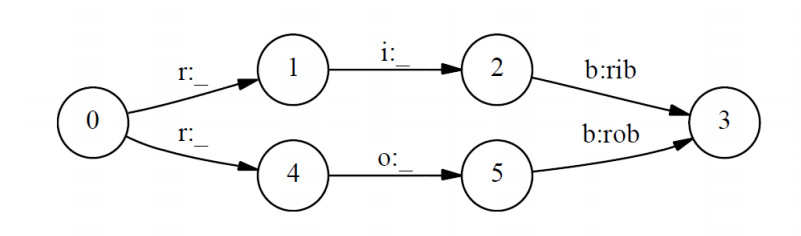
$$ \begin {align} & P(12 \mid ri) = P(1 \mid r)P(2 \mid i, r=1) = P(1 \mid r) \cdot 1 = P(1 \mid r) \\ & P(45 \mid ro) = P(4 \mid r)P(5 \mid o, r=4) = P(4 \mid r) \cdot 1 = P(4 \mid r) \\ \end {align} $$ 由上面计算概率可知,ri标为12和 ro标为45的概率最终变成r标为1和4的概率。但是由于语料库中"rob"的出现次数很多,所以$P(4 \mid r) > P(1 \mid r)$ ,所以可能会一直把"rib"中的"i"标记为1,会导致标记出错。这就是标记偏置问题。

定义 ​

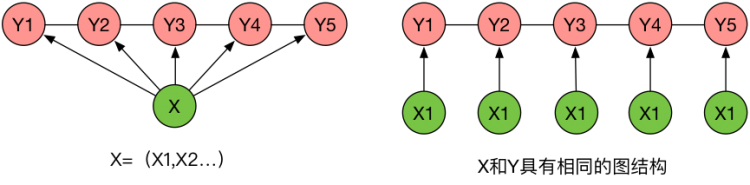
条件随机场是给定随机变量X条件下,随机变量Y 的马尔可夫随机场。我们主要关心线性链随机场,它可以用于标注问题。

条件随机场

X与Y是随机变量,条件概率分布P(Y∣X)。随机变量Y可以构成一个无向图表示的马尔可夫随机场。任意一节点Yv,YA是与v相连接的节点,YB是除了v以外的所有节点。若都有

P(Yv∣X,YB)=P(Yv∣X,YA)

则称P(Y∣X) 为条件随机场。并不要求X和Y 具有相同的结构。

线性链条件随机场

X和Y 有相同的线性结构。设X=(X1,X2,⋯,Xn),Y=(Y1,Y2,⋯,Yn)均为线性链表示的随机变量序列。每个最大团包含2个节点。

P(Y∣X) 构成条件随机场,即满足马尔可夫性

P(Yi∣X,Y1,⋯,Yi−1,Yi+1,⋯,Yn)=P(Yi∣X,Yi−1,Yi+1),i=1,⋯,n。(1和n时只考虑单边)

则称P(Y∣X)为线性链条件随机场。

HMM,每个观察状态只与当前的隐状态有关系,分离了关系。就像1个字1个字地向后讲。输出观察符号还需要条件独立。

线性链条件随机场, 每个状态都与整个序列有关系。即先想好了整句话,再依照相应的次序去说出来。更加直击语言模型的核心。X1,X2 不需要条件独立。

基本形式 ​

两种特征函数

状态转移特征函数t,只依赖与当前和前一个位置,即yi和yi−1。一般是01函数。

t(yi−1,yi,x,i)={1,满足某种条件,i∈[2,n].例如yi−1+yi=30,其他

状态特征函数s,只依赖与当前位置yi

s(yi,x,i)={1,满足某种条件,i∈[1,n].例如yi是偶数0,其他

基础形式

设有K1个状态特征转移函数,K2个状态特征函数。分别对应的权值是λk1和μk2。则线性链条件随机场参数化形式P(y∣x) 如下:

P(y∣x)=1Z(x)exp⁡(∑kK1λk∑i=2ntk(yi−1,yi,x,i)+∑kK2μk∑i=1nsk(yi,x,i))

其中Z(x)是规范化因子,如下

Z(x)=∑xexp⁡(∑kK1λk∑i=2ntk(yi−1,yi,x,i)+∑kK2μk∑i=1nsk(yi,x,i))

条件随机场完全由特征函数tk1 、sk2,和对应的权值λk1 和μk2 决定的。 特征函数实际上也是势函数。

简化形式 ​

有K=K1+K2个特征,特征函数如下:

fk(yi−1,yi,i)={tk(yi−1,yi,x,i)k=1,⋯,K1sk(yi,x,i)k=K1+l;l=1,⋯,K2

同一个特征函数,要在整个Y​序列的各个位置进行计算,可以进行求和,即转化为全局特征函数, **新的特征函数fk(y,x)​**如下:

fk(y,x)=∑i=1nfk(yi−1,yi,i),k=1,⋯,K

fk(y,x) 对应的**新的权值wk**如下

wk={λk,k=1,⋯,K1μk−K1,k=K1+1,K1+2,⋯,K

所以新的条件随机场形式如下:

P(y∣x)=1Z(x)exp⁡∑k=1Kwkfk(y,x),Z(x)=∑yexp⁡∑k=1Kwkfk(y,x)

可以看出,格式和最大熵模型很像。条件随机场最重要的就是,根据观察序列,把标记序列给推测出来。

向量形式 ​

向量化特征函数和权值

F(y,x)=(f1(y,x),⋯,fK(y,x))T,w=(w1,⋯,wK)T

可以写成向量内积的形式

Pw(y∣x)=1Z(x)exp⁡(w⋅F(y,x)),Z(x)=∑yexp⁡(w⋅F(y,x))

矩阵形式 ​

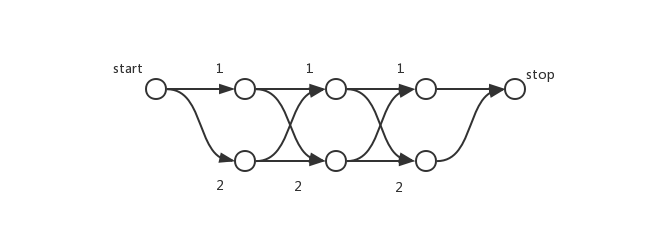
为状态序列Y设置起点和终点标记,y0=start 和yn+1=stop。从0→n+1中,有n+1次的状态转移。我们可以用n+1 个状态转移矩阵来表示状态转移的概率。

设Mi(x) 是i−1→i的转移矩阵,是m阶,m 是yi 取值的个数。表示了各种取值情况互相转化的概率。

M1(x)=[a01a0200],M2(x)=[b11b12b21b22],M3(x)=[c11c12c21c22],M4(x)=[1010]

要求什么样的路径概率,则相乘相应的数值概率即可。那么这些矩阵里面的数值是怎么来的呢。有下面的矩阵定义 :

g(yi−1,yi,x,i)=Mi(yi−1,yi∣x)=exp⁡∑k=1Kwkfk(yi−1,yi,i,x),Mi(x)=[g(yi−1,yi,x,i)]

每一步转移的时候,由于(yi−1,yi) 有m2 种情况,计算g时会得到多个值,即可得到一个矩阵。

其中g(yi−1,yi,x,i) 在计算的时候,会根据i 的不同,而选择不同的特征函数进行计算。不要忘记了fk函数的定义。

fk(yi−1,yi,i)={tk(yi−1,yi,x,i)k=1,⋯,K1sk(yi,x,i)k=K1+l;l=1,⋯,K2

所以非规范化条件概率可以通过矩阵的某些元素的乘积表示,有

Pw(y∣x)=1Zw(x)∏i=1n+1Mi(yi−1,yi∣x)

其中规范化因子 是**n+1的矩阵相乘的结果矩阵中,第(start,stop) 元素。例如第(0,0)。其中是(start,end) 是矩阵下标对应**。

条件随机场的概率计算问题 ​

主要问题是给定条件随机场P(Y∣X) ,给定输入序列x 和输出序列y,求P(Yi=yi∣x) 和P(Yi−1=yi−1,Yi=yi∣X), 以及相应的期望问题。

关键是求这些特征函数期望值,当模型训练好之后,去验证我们的模型。

前向后向算法 ​

yi 确定后, αi(yi∣x) 表示,从start→i,就是$y = (start, y_1, \cdots, y_i) $ 的概率,也就是从前面到位置yi 的概率。特别地

α0(y∣x)={1,y=start0,其他

而yi​ 的取值有m​ 种, 所以前向变量 αi(x)​ 到y​ 到第 i​ 个位置 的所有概率取值向量。

αiT(x)=αi−1T(x)⋅Mi(x),i=1,2,⋯,n+1

yi 确定后, βi(yi∣x) 表示,位置i的标记为yi ,并且后面为yi+1,⋯,yn,stop 的概率。同理一个是概率值。特别地

βn+1(y∣x)={1,y=stop0,其他

后向变量 βi(y∣x)​,是一个m维向量

βi(x)=Mi+1(x)⋅βi+1(x)

可以得到Z(x):

Z(x)=αnT(x)⋅1=1T⋅βi+1(x)

条件概率计算 ​

位置是i 标记yi 的条件概率P(Yi=yi∣x)是

P(Yi=yi∣x)=1Z(x)⋅αi(yi∣x)βi(yi∣x)

位置i−1,i 分别标记为yi−1,yi 的概率是

P(Yi−1=yi−1,Yi=yi∣x)=1Z(x)⋅αi−1(yi−1∣x)Mi(yi−1,yi∣x)βi(yi∣x)

特征期望值计算 ​

两个期望值和最大熵模型的约束条件等式 有点像。

特征函数fk 关于条件概率分布P(Y∣X) 的概率

EP(Y∣X)(fk)=∑yP(y∣x)fk(y,x)=∑i=1n+1∑yi−1yifk(yi−1,yi,x,i)P(yi−1,yi∣x)

特征函数fk 关于条件概率分布P(X,Y) 的概率,P^(x) 是经验分布

EP(X,Y)(fk)=∑x,yP(x,y)∑i=1n+1fk(yi−1,yi,x,i)=∑xP^(x)∑yP(y∣x)∑i=1n+1fk(yi−1,yi,x,i)

通过前向和后向向量可以计算出两个概率,然后可以计算出相应的期望值。就可以与我们训练出的模型进行比较。

学习算法 ​

条件随机场模型实际上是定义在时序数据上的对数线性模型,学习方法有极大似然估计和正则化的极大似然估计。具体的优化实现算法有:改进的迭代尺度法IIS、梯度下降法和拟牛顿法。

改进的迭代尺度法 ​

这里是最大熵模型中的改进的迭代尺度算法。每次更新一个δi 使得似然函数的该变量的下界增大,即似然函数增大。

已知经验分布P^(X,Y),和模型如下

P(y∣x)=1Z(x)exp⁡∑k=1Kwkfk(y,x),Z(x)=∑yexp⁡∑k=1Kwkfk(y,x)

对数似然函数和最大熵算法的极大似然函数很相似,如下:

L(w)=LP^(Pw)=log⁡∏x,yPw(y∣x)P~(x,y)=∑x,yP~(x,y)log⁡Pw(y∣x)

对数似然函数L(w)

L(w)=∑j=1N∑k=1Kwkfk(yj,xj)−∑j=1Nlog⁡Zw(xj)

数据(x,y) 中出现的特征总数T(x,y) :

T(x,y)=∑kfk(y,x)=∑k=1K∑i=1n+1fk(yi−1,yi,x)

输入:特征函数t1,t2,⋯,tK1和s1,s2,⋯,sK2 ;经验分布P^(x,y)

输出:模型参数w^,模型Pw^

步骤:

1 赋初值 wk=0

2 对所有k,求解方程,解为δk

∑x,yP^(x)P(y∣x)∑i=1n+1tk(yi−1,yi,x,i)exp⁡(δkT(x,y))=Ep^[tk],k=1,2,⋯,K1时∑x,yP^(x)P(y∣x)∑i=1n+1sl(yi−1,yi,x,i)exp⁡(δkT(x,y))=Ep^[sl],k=K1+l,l=1,2,⋯,K2时

3 更新wk+δk→wk ,如果还有wk未收敛,则继续2

算法S

对于不同的数据(x,y)的特征出现次数T(x,y) 可能不同,可以选取一个尽量大的数S作为特征总数,使得所有松弛特征s(x,y)≥0 :

s(x,y)=S−∑i=1n+1∑k=1Kfk(yi−1,yi,x,i)

所以可以直接解得δk ,当然fk 要分为tk和sk,对应的期望值计算也不一样。具体见书上。

δk=1Slog⁡EP^[fk]EP[fk]

算法T

算法S中S会选择很大,导致每一步的迭代增量会加大,算法收敛会变慢,算法T重新选择一个特征总数 T(x)

T(x)=maxyT(x,y)

使用前后向递推公式,可以算得T(x)=t 。

对于k∈[1,K1]的tk关于经验分布的期望:

EP^[tk]=∑t=0Tmaxak,tβkt

其中,ak,t是tk的期待值, δk=log⁡βk

对于k∈[1+K1,K]的sk关于经验分布的期望:

EP^[sk]=∑t=0Tmaxbk,tγkt

其中γkt是特征sk的期望值,δk=log⁡γk。当然,求根也可以使用牛顿法去求解。

拟牛顿法 ​

预测算法 ​

预测问题 ​

给定条件随机场P(Y∣X)和输入序列x,求条件概率最大的输出序列(标记序列)y∗,即对观测序列进行标注。

y∗=arg⁡maxyPw(y∣x)=arg⁡maxyexp⁡(w⋅F(y,x))Zw(x)=arg⁡maxy(w⋅F(y,x))

其中路径y表示标记序列,下面是参数说明

w=(w1,w2,⋯,wk)TF(y,x)=(f1(y,x),⋯,fK(y,x))T,w=(w1,⋯,wK)Tfk(y,x)=∑i=1nfk(yi−1,yi,x,i)Fi(yi−1,yi,x)=(f1(yi−1,yi,x,i),f2(yi−1,yi,x,i),⋯,fk(yi−1,yi,x,i))T

所以,为了求解最优路径,只需计算非规范化概率,即转换为下面的问题:

maxy∑i=1nw⋅Fi(yi−1,yi,x)

维特比算法 ​

HMM的维特比算法。

维特比变量δi(l),到达位置i, 标记为l∈[1,m] 的概率

δi(l)=max1≤j≤m{δi−1(j)+w⋅Fi(yi−1=j,yi=l,x)},j=1,2,⋯,m

记忆路径ψi(l)=a 当前时刻t标记为l, t−1时刻标记为a

ψi(l)==arg⁡max1≤j≤m{δi−1(j)+w⋅Fi(yi−1=j,yi=l,x)}

算法主体

输入:特征向量F(y,x)和权值向量w,观测向量x=(x1,x2,⋯.xn)

输出:最优路径y∗=(y1∗,y2∗,⋯,yn∗)

步骤如下

初始化

δ1(j)=w⋅F1(y0=start,y1=j,x),j=1,⋯,m

递推

δi(l)=max1≤j≤m{δi−1(j)+w⋅Fi(yi−1=j,yi=l,x)},j=1,2,⋯,mψi(l)=arg⁡max1≤j≤mδi(j),即上式的参数j

终止

maxy(w⋅F(y,x))=max1≤j≤mδn(j)yn∗=arg⁡max1≤j≤mδn(j)

返回路径

yi∗=ψi+1(yi+1∗),i=n−1,n−2,⋯,1

求得最优路径y∗=(y1∗,y2∗,⋯,yn∗)

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026