Skip to content

线性回归和逻辑回归

📅 发表于 2017/08/20
🔄 更新于 2025/07/23
👁️ — 次访问
📝 1888 字
⏳ 7 分钟
机器学习
#机器学习
#线性回归
#逻辑回归
#梯度下降

吴恩达线性回归、逻辑回归、梯度下降笔记

线性回归 ​

有m个样本(x(1),y(1)),(x(2),y(2)),⋯,(x(m),y(m)),假设函数有2个参数θ0,θ1,形式如下:

hθ(x)=θ0+θ1x

代价函数 ​

代价函数

J(θ0,θ1)=12m∑i=1m(hθ(x(i))−y(i))2

目标是要找到合适的参数,去最小化代价函数minJ(θ0,θ1)。

假设θ0=0,去描绘出J(θ1)和θ1的关系,如下面右图所示。

假设有3个样本(1,1),(2,2),(3,3),图中选取了3个θ1=1,0.5,0,其中J(θ1)在θ1=1时最小。

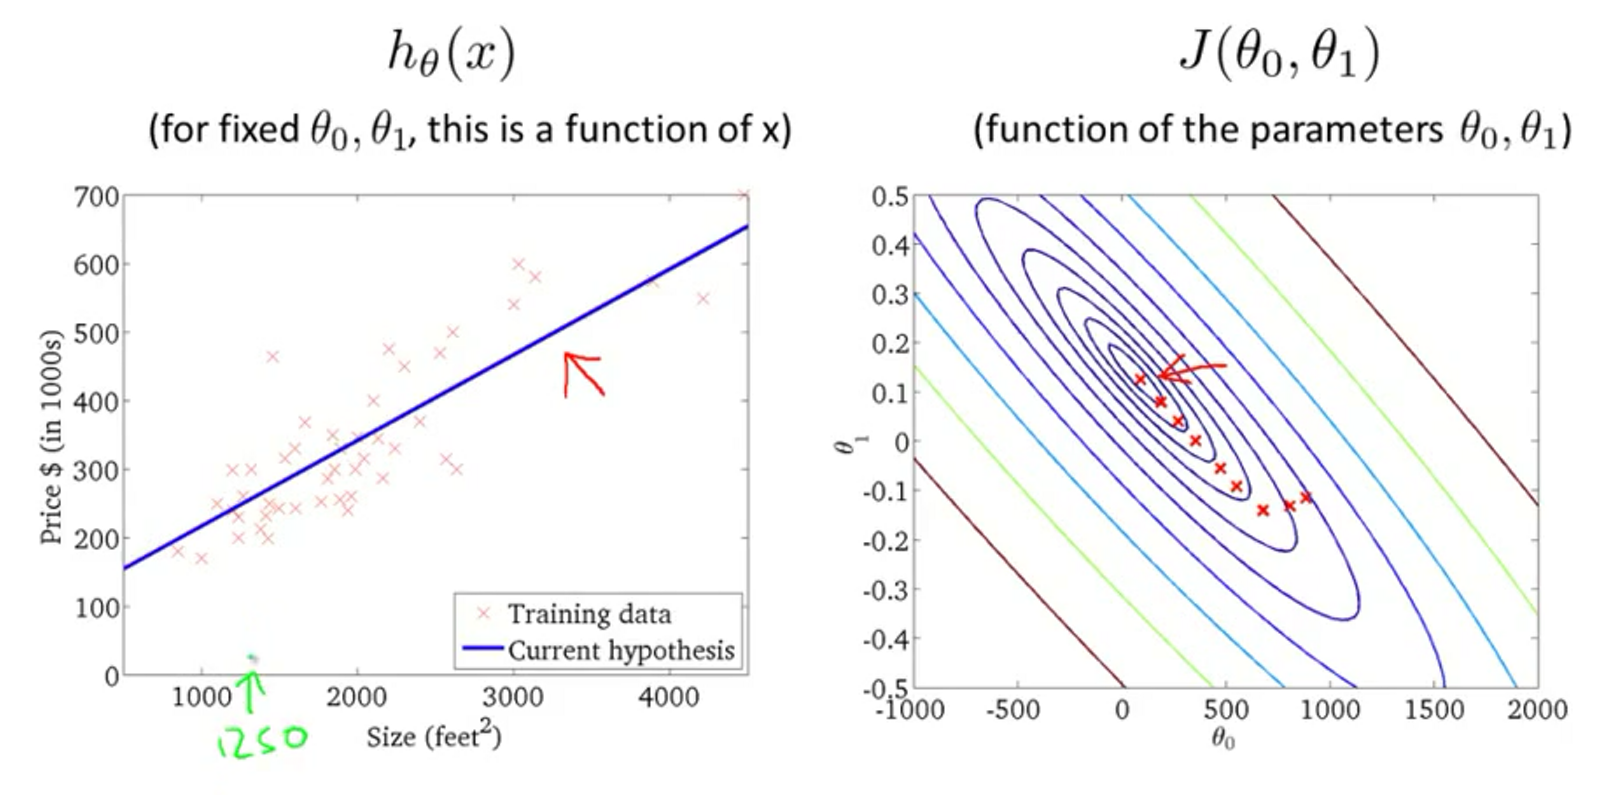
那么回到最初的两个参数hθ(x)=θ0+θ1x,如何去找minJ(θ0,θ1)呢?这里绘制一个等高图去表示代价函数,如下面右图所示,其中中间点是代价最小的。

梯度下降 ​

基础说明

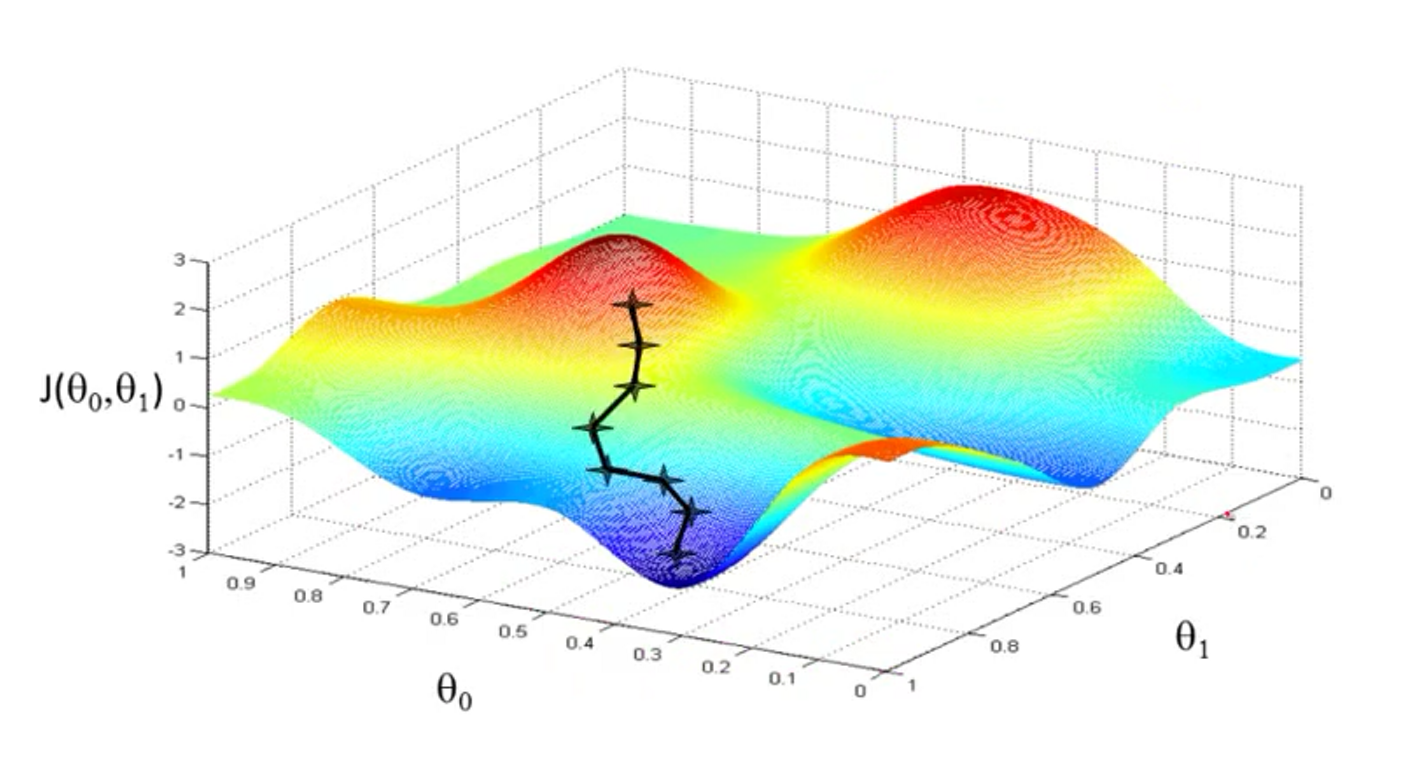
上文已经定义了代价函数J(θ0,θ1),这里要使用梯度下降算法去最小化J(θ0,θ1),自动寻找出最合适的θ。梯度下降算法应用很广泛,很重要。大体步骤如下:

  • 设置初始值θ0,θ1
  • 不停改变θ0,θ1去减少J(θ0,θ1)

当然选择不同的初始值,可能会得到不同的结果,得到局部最优解。

对于所有的参数θj进行同步更新,式子如下

θj=θj−α⋅∂∂θjJ(θ0,θ1)⏟学习率×偏导

上面公式中α是学习率(learning rate),是指一次迈多大的步子,一次更新的幅度大小。

例如上面的两个参数,对于一次同步更新(梯度下降)

t0=θ0−α∂∂θ0J(θ0,θ1),t1=θ1−α∂∂θ1J(θ0,θ1)→θ0=t0,θ1=t1

也有异步更新(一般指别的算法)

t0=θ0−α∂∂θ0J(θ0,θ1),θ0=t0→t1=θ1−α∂∂θ1J(θ0,θ1),θ1=t1

偏导和学习率

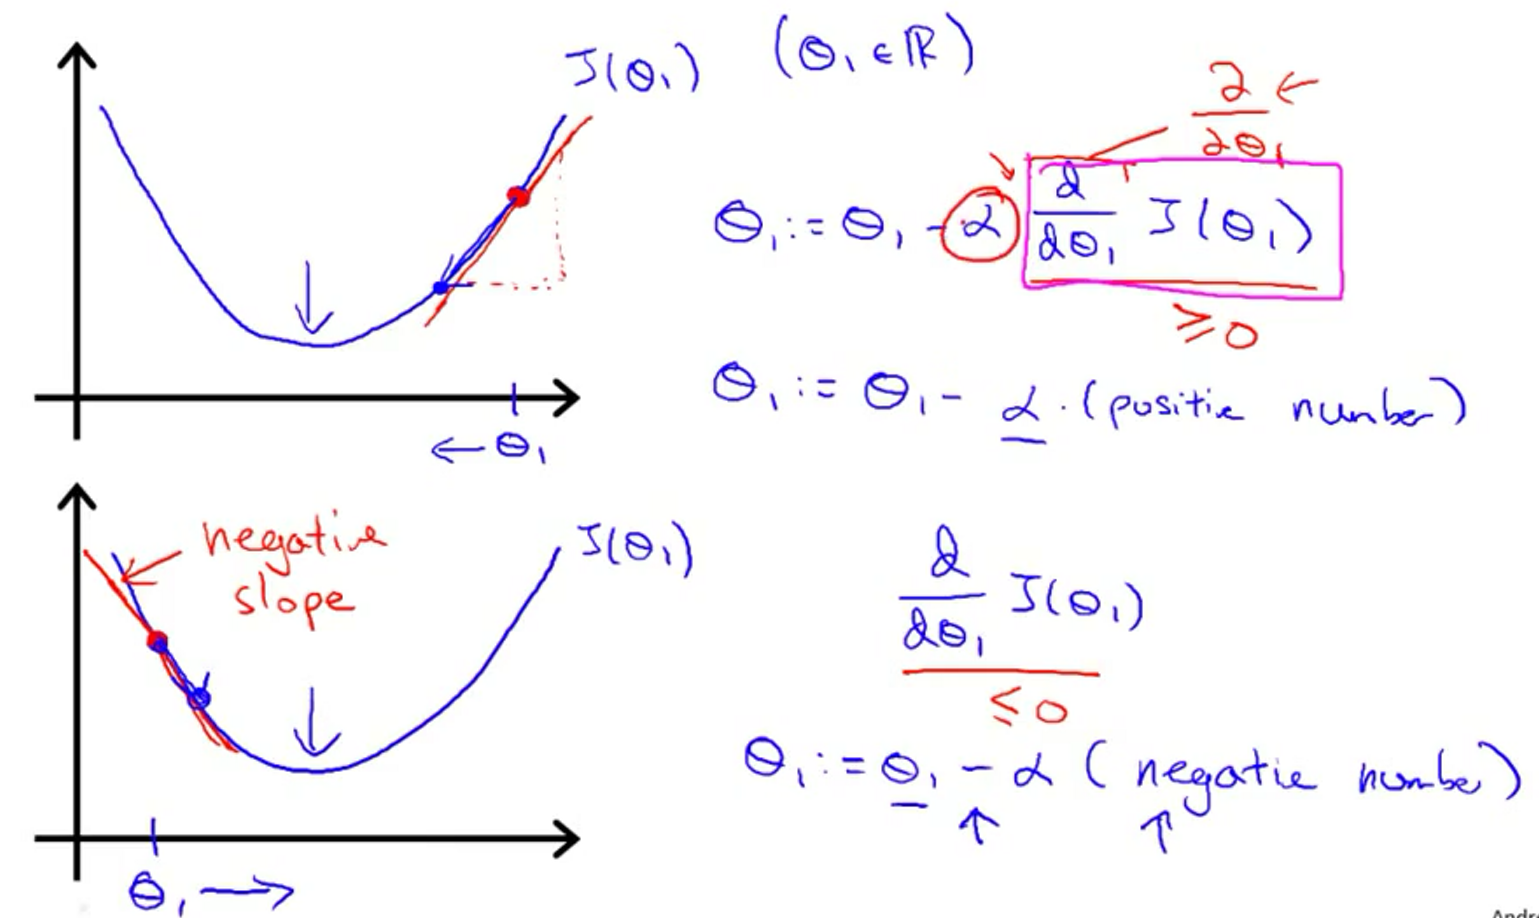
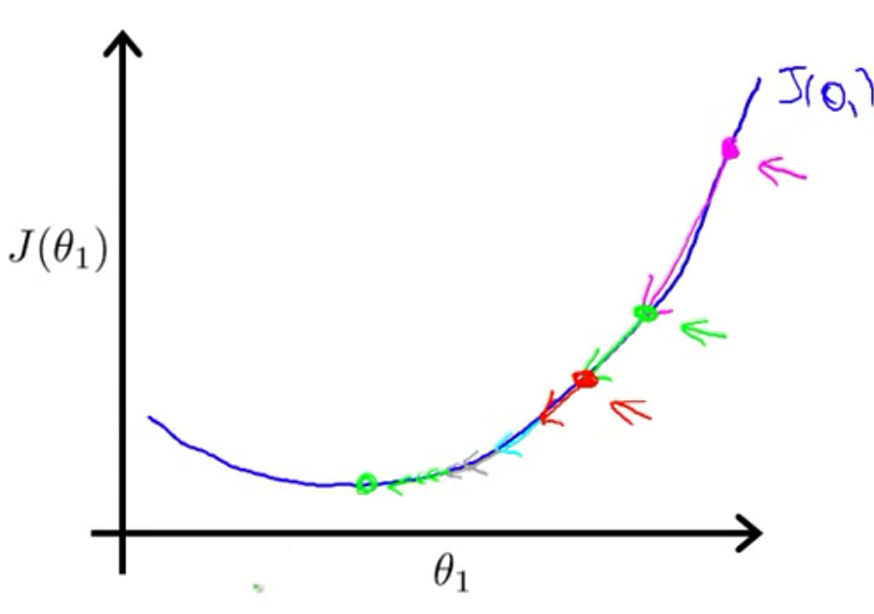
这里先看一个参数的例子,即J(θ1)。θ1=θ1−αddxJ(θ1)。当θ从左右靠近中间值,导数值(偏导/斜率)分别是负、正,所以从左右两端都会靠近中间值。

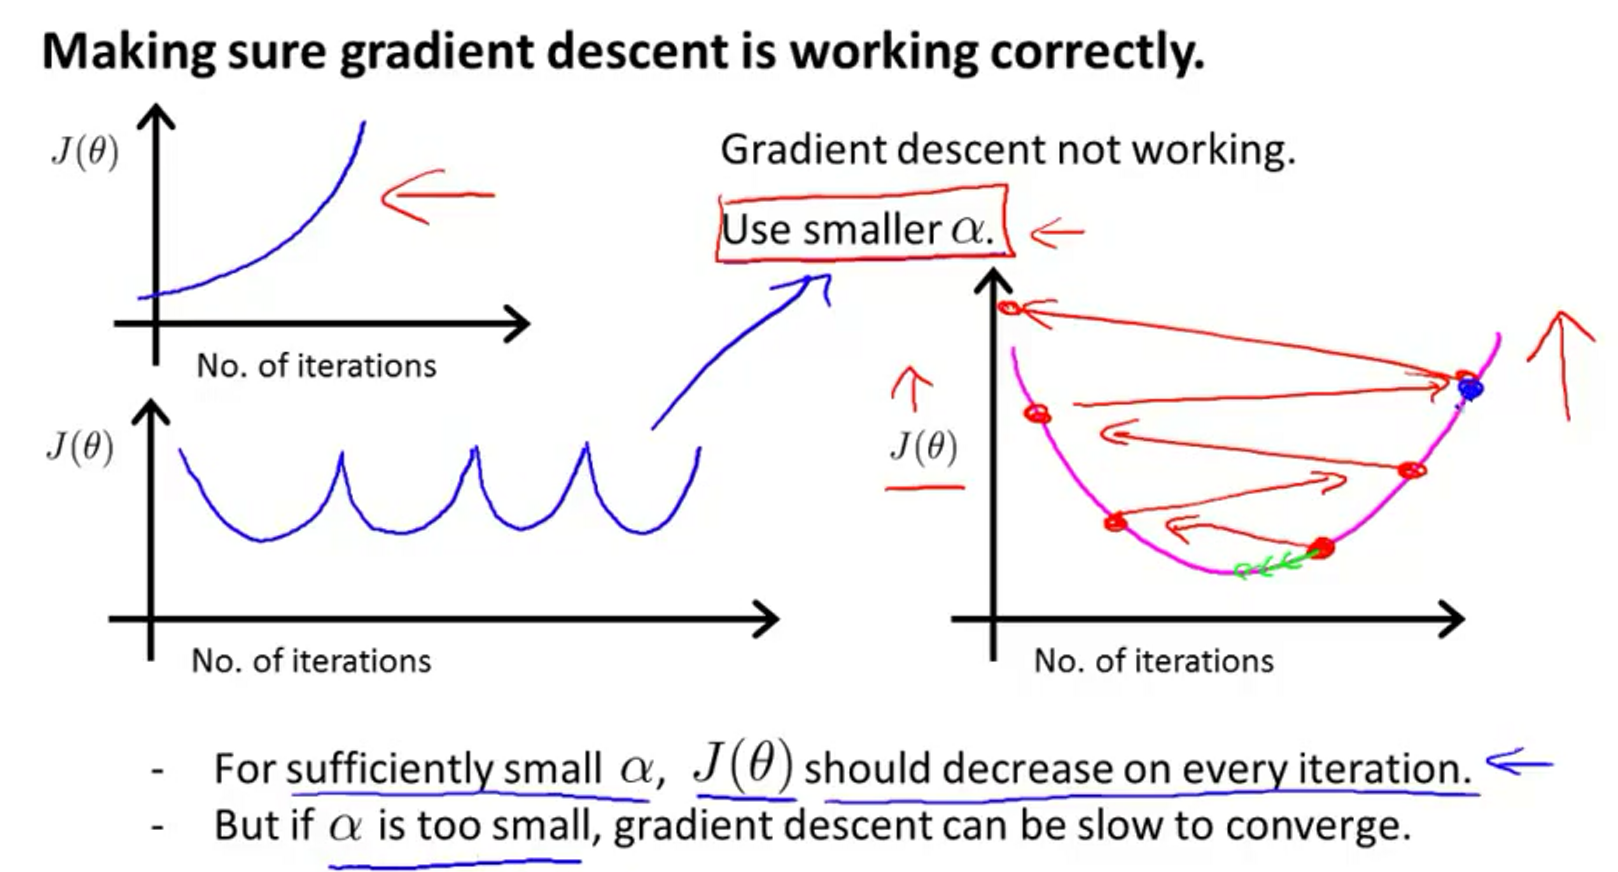
当学习率α太小,梯度下降会很缓慢;α太大,可能会错过最低点,导致无法收敛。

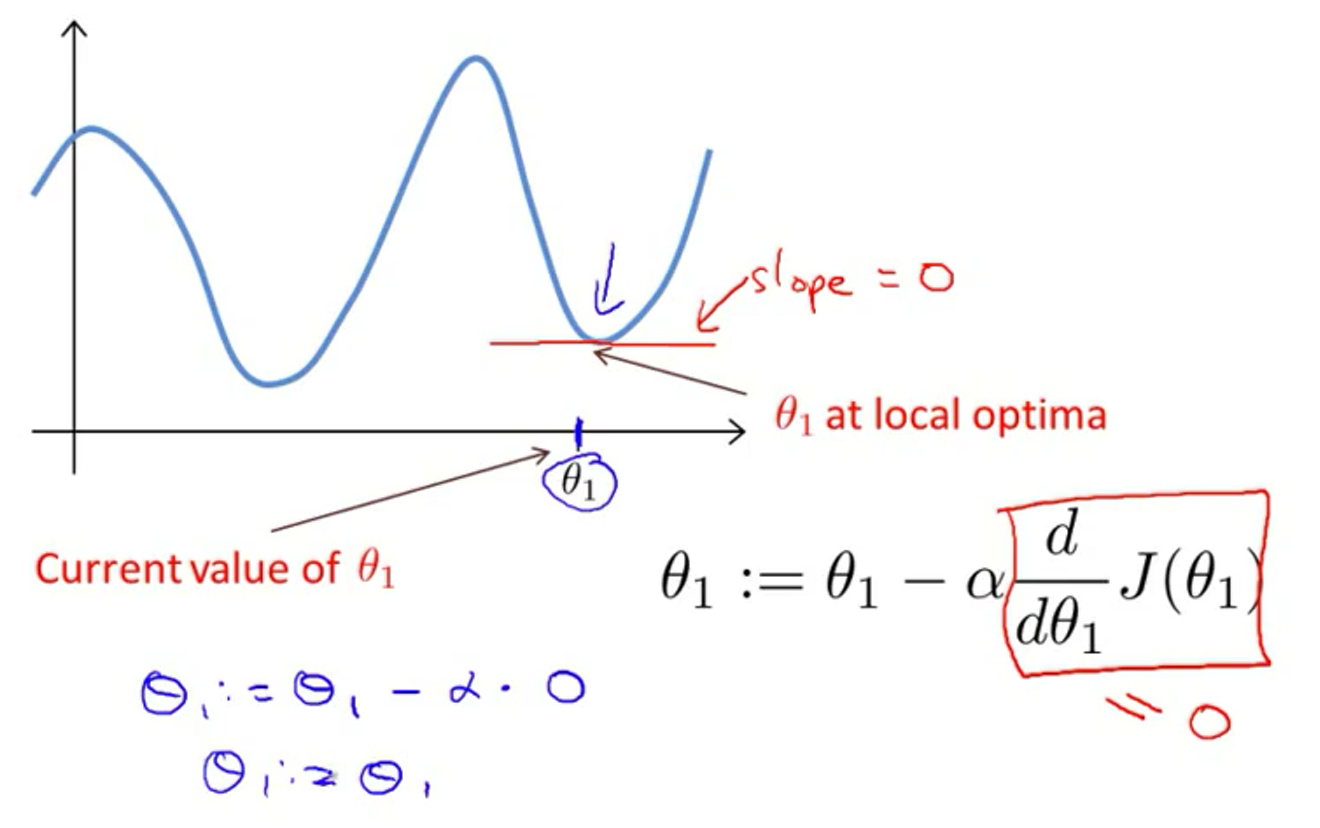
当已经处于局部最优的时候,导数为0,并不会改变参数的值,如下图

当逐渐靠近局部最优的时候,梯度下降会自动采取小步子到达局部最优点。是因为越接近,导数会越来越小。
在线性回归上使用梯度下降

代价函数

J(θ0,θ1)=12m∑i=1m(hθ(x(i))−y(i))2=12m∑i=1m(θ0+θ1x(i)−y(i))2

分别对θ0和θ1求偏导有

∂∂θ0J(θ0,θ1)=1m∑i=1m(hθ(x(i))−y(i)),∂∂θ1J(θ0,θ1)=1m∑i=1m(hθ(x(i))−y(i))⋅x(i)

那么使用梯度下降对θ0和θ1进行更新,如下

θ0=θ0−α1m∑i=1m(hθ(x(i))−y(i)),θ1=θ1−α1m∑i=1m(hθ(x(i))−y(i))⋅x(i)

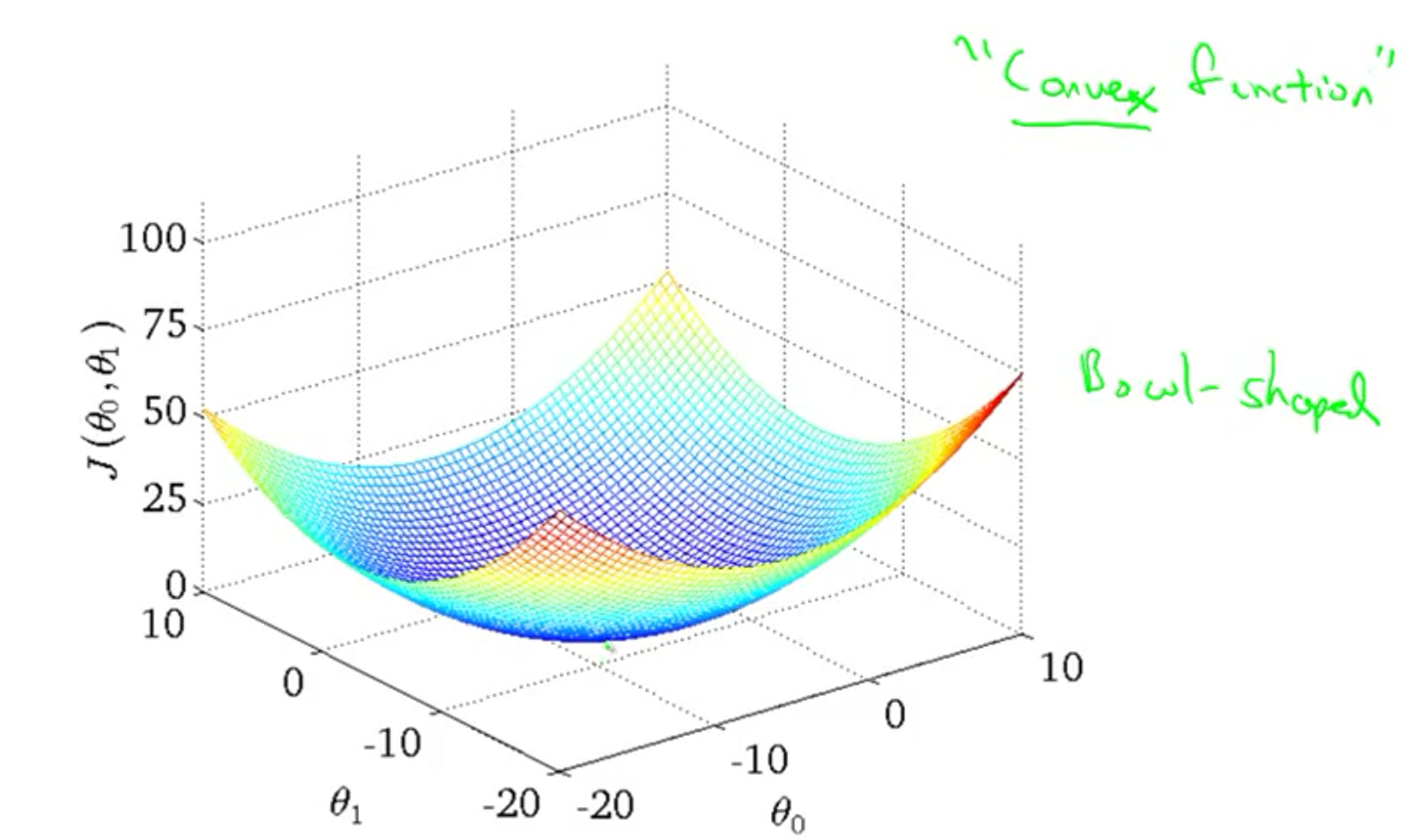
当前代价函数实际上是一个凸函数,如下图所示。它只有全局最优,没有局部最优。

通过不断地改变参数减小代价函数J(θ0,θ1),逼近最优解,最终会得到一组比较好的参数,正好拟合了我们的训练数据,就可以进行新的值预测。

梯度下降技巧 ​

特征缩放

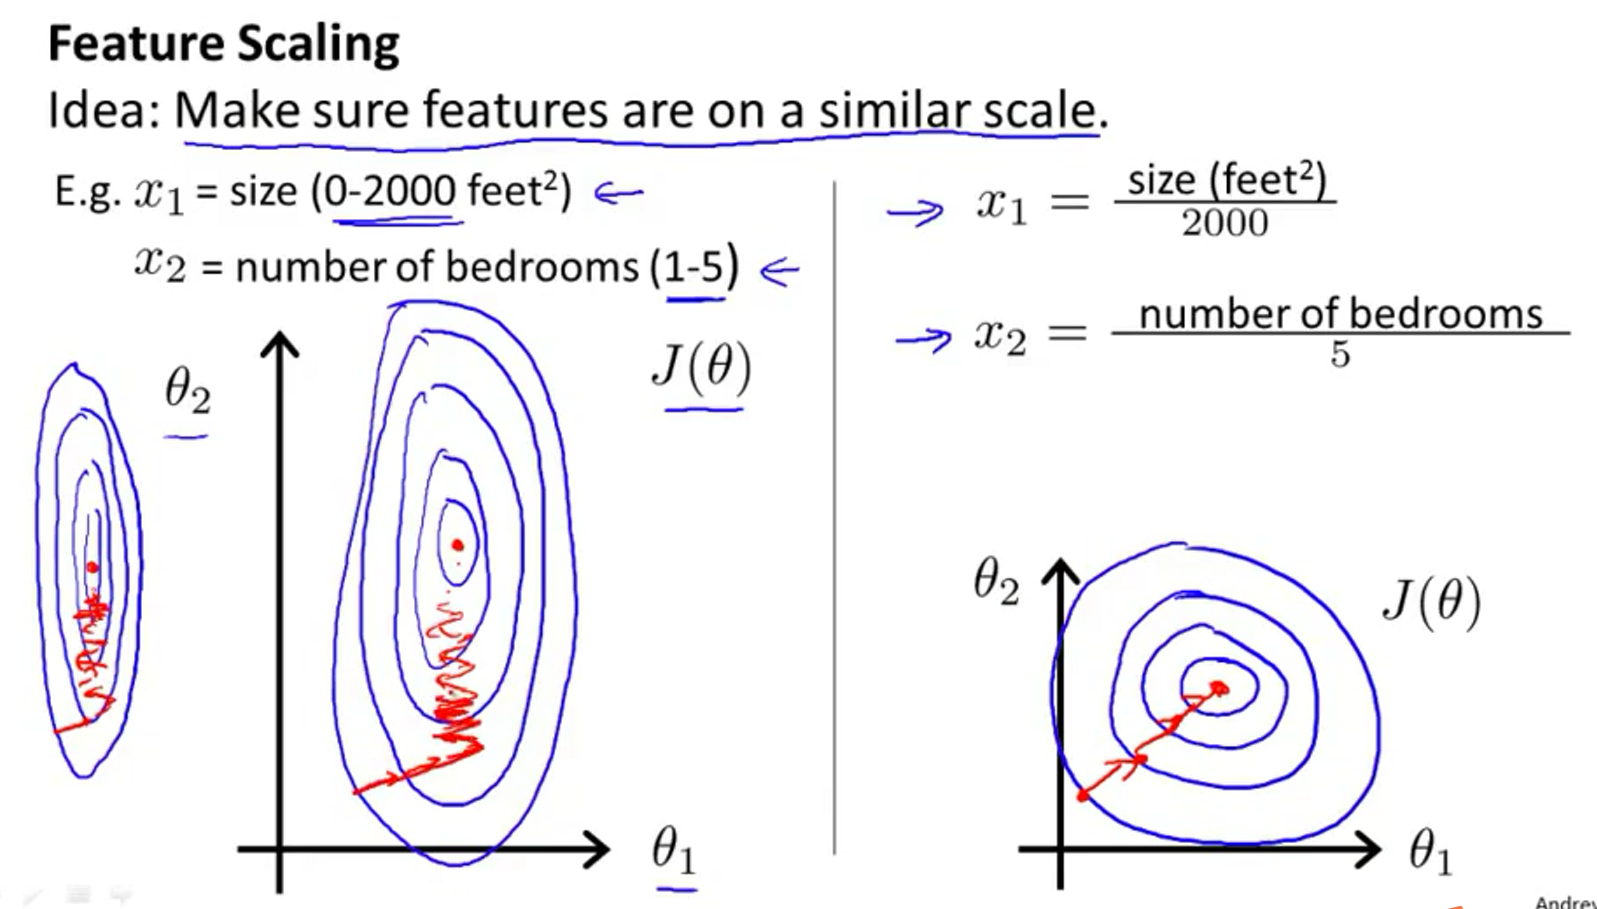
不同的特征的单位的数值变化范围不一样,比如x1∈(0,2000),x2∈(1,5),这样会导致代价函数J(θ)特别的偏,椭圆。这样来进行梯度下降会特别的慢,会来回震荡。

所以特征缩放是把所有的特征缩放到相同的规模上。得到的J(θ)就会比较圆,梯度下降能很快地找到一条通往全局最小的捷径。

特征缩放的数据规模不能太小或者太大,如下面可以的规模是

[−1,1],[0,3],[−2,0.5],[−3,3],[−13,13]都是可以的。而[−100,100],[−0.0001,0.0001]是不可以的

有一些常见的缩放方法

  • xi=xi−μmax−min, xi=xi−μs,其中μ是均值,s是标准差
  • xi=xi−minmax−min
  • xi=ximax

学习率的选择

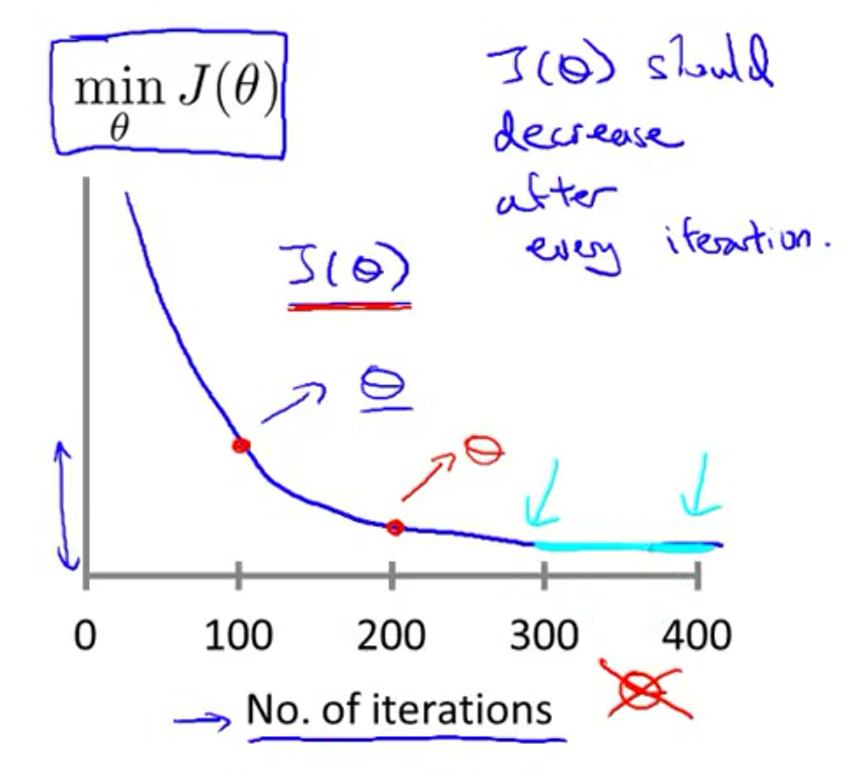
当梯度下降正确运行的时候,每一次迭代J(θ)都会减少,但是减少到什么时候合适呢?当然最好的办法就是画图去观察,当然也可以设定减小的最小值来判断。下图中, 迭代次数到达400的时候就已经收敛。不同的算法,收敛次数不一样。

当图像呈现如下的形状,就需要使用更小的学习率。理论上讲,只要使用足够小的学习率,J(θ)每次都会减少。但是太小的话,梯度下降会太慢,难以收敛。

学习率总结

  • 学习率太小,慢收敛
  • 学习率太大,J(θ)可能不会每次迭代都减小,甚至不会收敛
  • 这样去选择学习率调试: …,0.001,0.003,0.01,0.03,0.1,0.3,1,…

多变量线性回归 ​

数据有n个特征,如x(i)=(1,x1,x2,⋯,xn),其中x0=1。则假设函数有n+1个参数,形式如下

hθ(x)=θTx=θ0+θ1x1+θ2x2+⋯+θnxn

代价函数

J(θ)=12m∑i=1m(hθ(x(i))−y(i))2

梯度下降,更新每个参数θj

θj=θj−α⋅∂J(θ)∂θj=θj−α⋅1m∑i=1m(hθ(x(i))−y(i))⋅xj(i)

多项式回归 ​

有时候,线性回归并不能很好地拟合数据,所以我们需要曲线来适应我们的数据。比如一个二次方模型
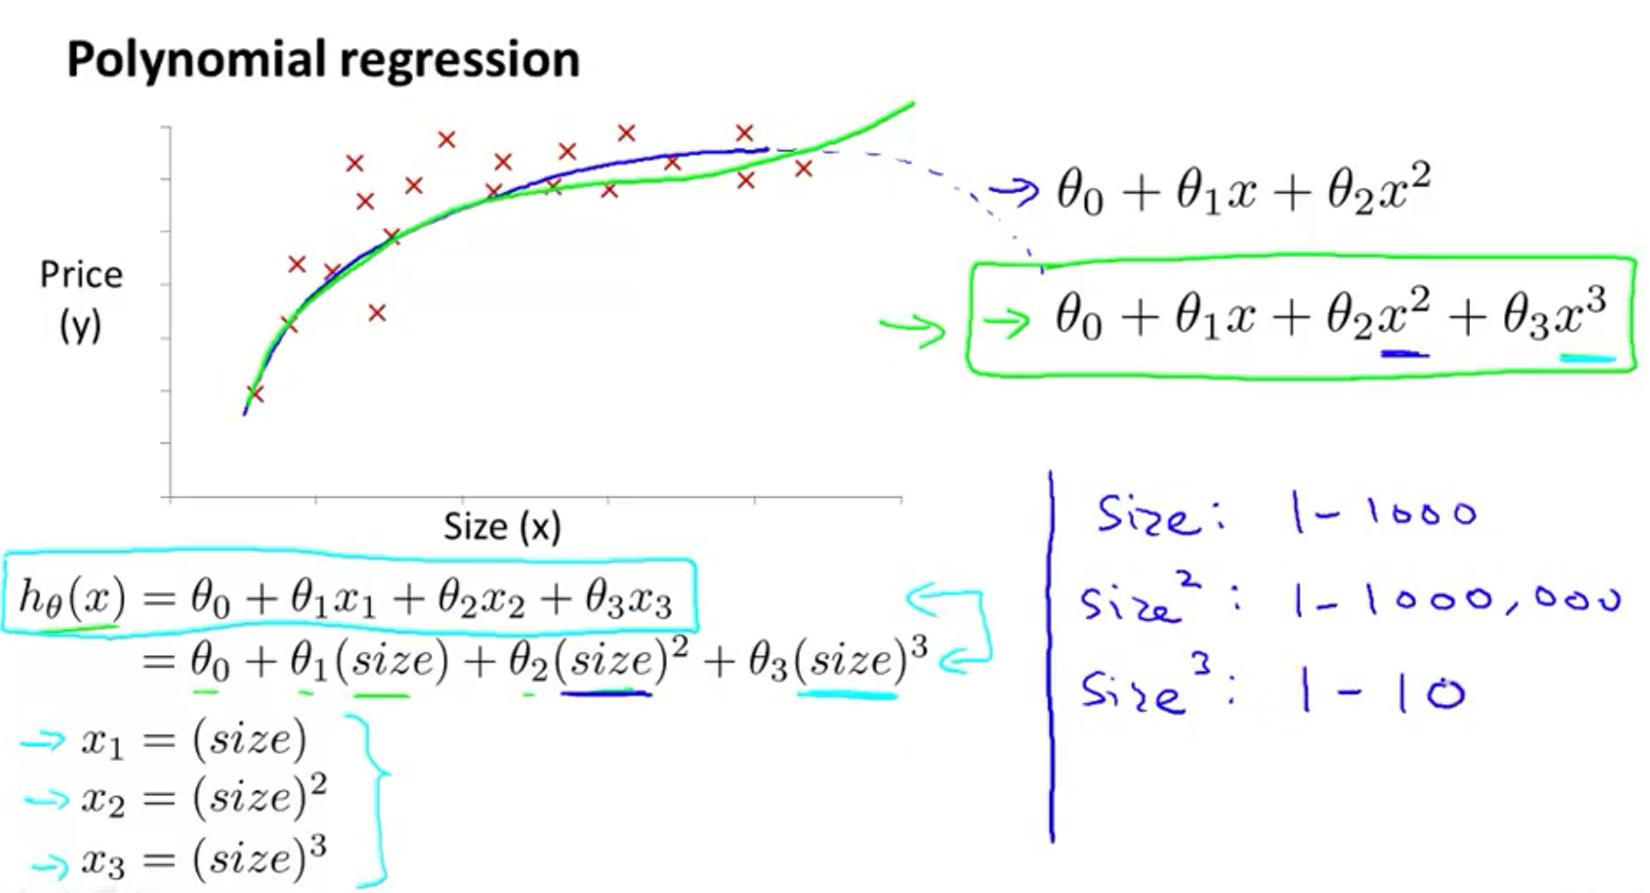
hθ(x)=θ0+θ1x1+θ2x22

当然可以用x2=x22,x3=x33来转化为多变量线性回归。如果使用多项式回归,那么在梯度下降之前,就必须要使用特征缩放。

正规方程 ​

对于一些线性回归问题,使用正规方程方法求解参数θ,比用梯度下降更好些。代价函数如下

J(θ0,θ1)=12m∑i=1m(hθ(x(i))−y(i))2

正规方程的思想是函数J(θ)对每个θj求偏导令其等于0,就能得到所有的参数。即∂J∂θj=0。

那么设Xm×(n+1)为数据矩阵(其中包括x0=1),y为标签向量。则通过如下方程可以求得θ

θ=(XTX)−1XTy

正规方程和梯度下降的比较

梯度下降正规方程
需要特征缩放不需要特征缩放
需要选择学习率α不虚选择学习率
需要多次迭代计算一次运算出结果
特征数量n很大时,依然适用n太大,求矩阵逆运算代价太大,复杂度为O(n3)。n≤10000可以接受
适用于各种模型只适用于线性模型,不适合逻辑回归和其他模型

逻辑回归 ​

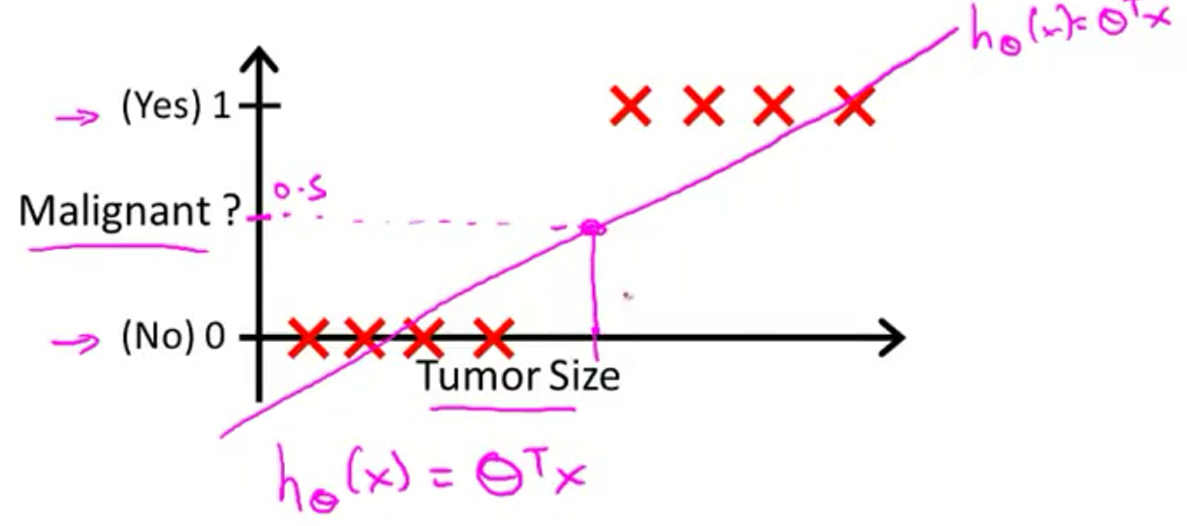
线性回归有2个不好的问题:直线难以拟合很多数据;数据标签一般是0,1,但是hθ(x)却可能远大于1或者远小于0。如下图。

基本模型 ​

逻辑回归是一种分类算法,使得输出预测值永远在0和1之间,是使用最广泛的分类算法。模型如下

hθ(x)=g(θTx),g(z)=11+e−z

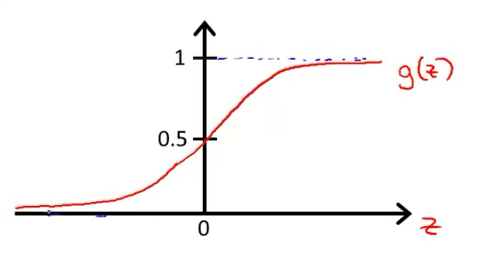
g(z)的图像如下,也称作Sigmoid函数或者Logistic函数,是S形函数。

将上面的公式整理后得到逻辑回归的模型

hθ(x)=11+e−θTx,其中0≤hθ(x)≤1

模型的意义是给出分类为1的概率,即hθ(x)=P(y=1∣x;θ)。例如hθ(x)=0.7,则分类为1的概率是0.7,分类为0的概率是1−0.7=0.3。

x的分类预测,y={1,hθ(x)≥0.5,即θTx≥00,hθ(x)<0.5,即θTx<0

逻辑回归就是要学到合适的θ,使得正例的特征远大于0,负例的特征远小于0。

决策边界 ​

线性边界

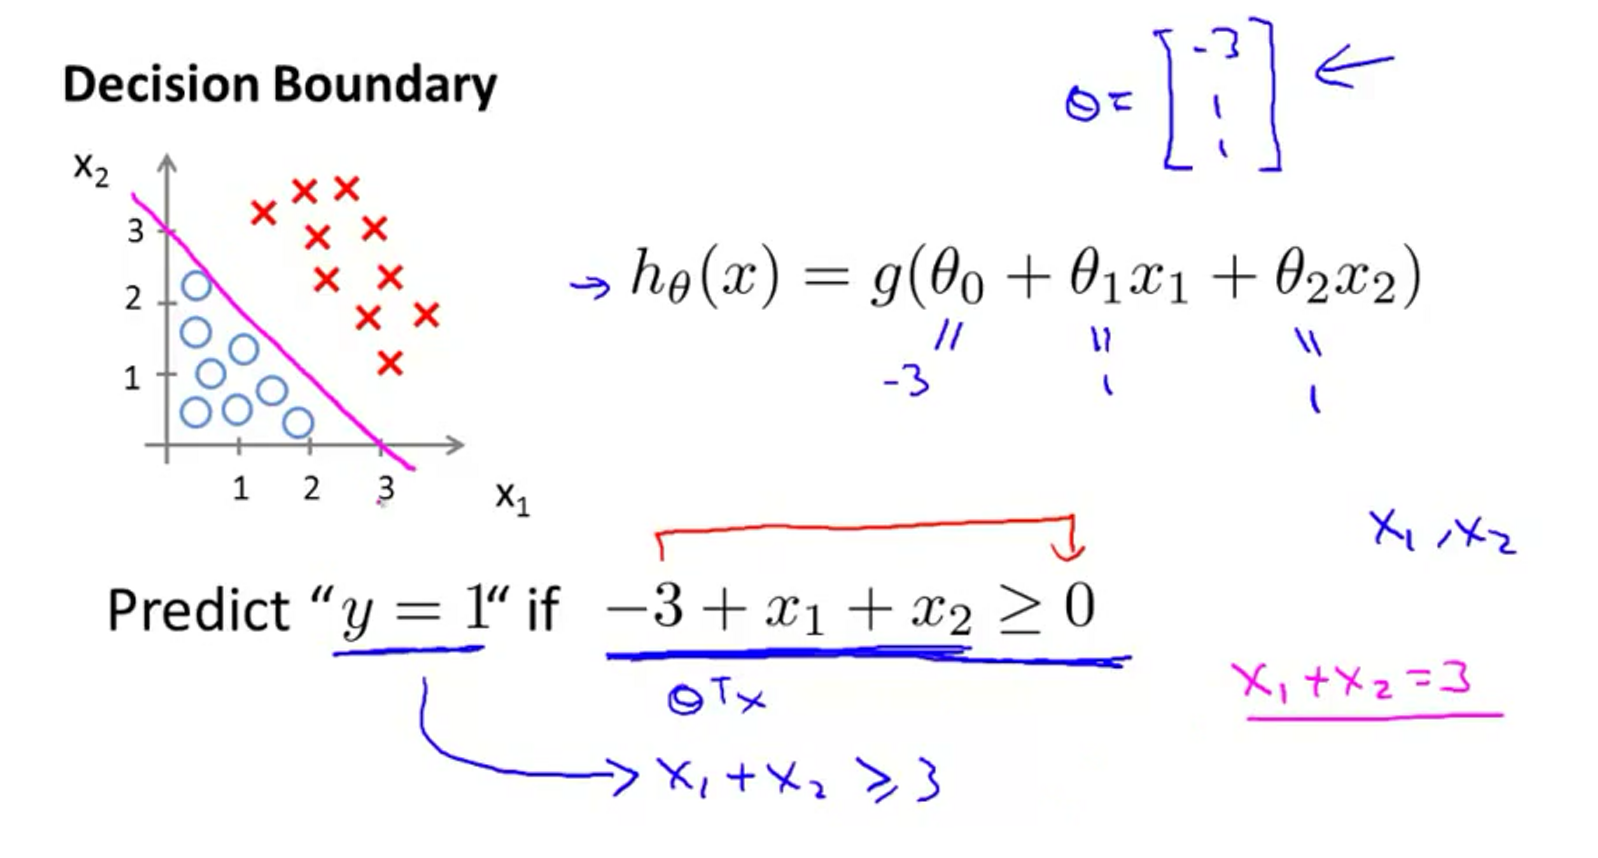
假设我们有一个模型hθ(x)=g(θ0+θ1x1+θ2x2),已经确定参数θ=(−3,1,1),即模型hθ(x)=g(−3+x1+x2),数据和模型如下图所示

由上可知,分类结果如下

y={1,x1+x2≥30,x1+x2<3

那么直线x1+x2=3就称作模型的决策边界,将预测为1的区域和预测为0的区域分隔开来。gg

非线性边界

先看下面的数据

使用这样的模型去拟合数据

hθ(x)=g(θ0+θ1x1+θ2x2+θ3x12+θ4x22),θ=(−1,0,0,1,1),即hθ(x)=g(−1+x12+x22)

对于更复杂的情况,可以用更复杂的模型去拟合,如x1x2,x1x22等

代价函数和梯度下降 ​

我们知道线性回归中的代价函数是J(θ0,θ1)=12m∑i=1m(hθ(x(i))−y(i))2,但是由于逻辑回归的模型是hθ(x)=11+e−θTx,所以代价函数关于θ的图像就是一个非凸函数,容易达到局部收敛,如下图左边所示。而右边,则是一个凸函数,有全局最小值。

代价函数

逻辑回归的代价函数

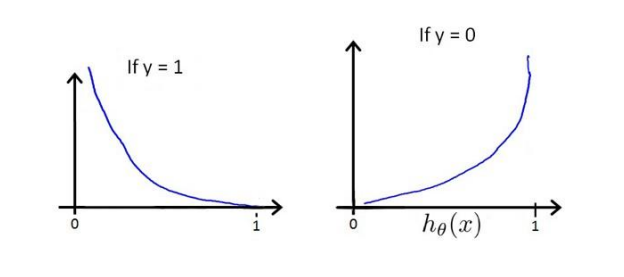
Cost(hθ(x),y)={−log⁡(hθ(x)),y=1−log⁡(1−hθ(x)),y=0

当实际上y=1时,若预测为0,则代价会无穷大。当实际上y=0时,若预测为1,则代价会无穷大。

整理代价函数如下

Cost(hθ(x),y)=−y⋅log⁡(hθ(x))−(1−y)⋅log⁡(1−hθ(x))

得到所有的J(θ)

J(θ)=−1m∑i=1m(y(i)log⁡hθ(x(i))+(1−y(i))log⁡(1−hθ(x(i))))

梯度下降

逻辑回归的假设函数估计y=1的概率 hθ(x)=11+e−θTx。

代价函数J(θ),求参数θ去minθJ(θ)

对每个参数θj,依次更新参数

θj=θj−α⋅1m∑i=1m(hθ(x(i))−y(i))⋅xj(i)

逻辑回归虽然梯度下降的式子和线性回归看起来一样,但是实际上hθ(x)和J(θ)都不一样,所以是不一样的。

总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026