变化点
2026.04 · InCoder-32B-Thinking
- 在 InCoder 上加入错误驱动 CoT,学习从工具报错中修正代码。
- ICWM 预测工业执行反馈,扩展可用训练经验。
2026.03 · InCoder-32B
- 以工业语料预训练,结合长上下文 MidTrain 与执行验证 SFT。
- 覆盖编译、仿真等工业代码任务与工具链。
2026.03 · IQuest-Coder-V1
- Code-Flow 引入代码演化信息,结合分阶段 MidTrain。
- LoopCoder 通过重复计算扩展模型推理深度。
InCoder 为北航、IQuest Research 等机构合作工作,在本页与 IQuest-Coder 一起记录;不是 Meta 早期同名 InCoder 系列。
(2604) InCoder-32B-Thinking (ECoT, ICWM)
🌺 论文摘要
参考链接
问题背景
- 工业代码需要理解硬件限制、编译诊断与执行结果;通用代码数据缺少完整的错误分析与修复过程。
- 真实 GPU、EDA 与仿真工具执行成本高,限制多轮纠错数据的规模。
核心方法
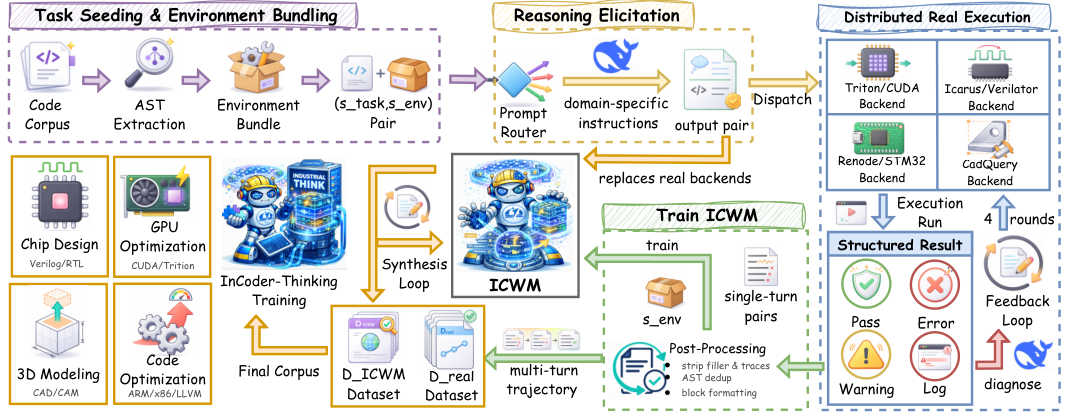
- ECoT:DeepSeek-V3.2 根据真实执行日志反复修改代码,将报错、诊断与修复整理为 Thinking 数据。
- ICWM:学习
环境描述 + 代码 → 执行反馈,用反馈预测扩充纠错轨迹,再进行真实执行验证。 - Thinking 训练:在 InCoder-32B 基础上学习约
540M tokens的推理数据;核心是执行反馈驱动的数据合成与监督训练。
模型效果(InCoder-32B → Thinking)
- LiveCodeBench v5:
53.3 → 81.3;EmbedCGen:35.2 → 47.9;SuperCoder 加速比:1.30× → 3.93×。 - SWE-bench Verified:
74.8 → 70.4;推理增强并未同步提高所有代码与 Agent 任务。
重要结论
- 真实错误能够形成具体的推理监督;不同工业任务需要的思考深度差异很大。
- 扩大 Thinking 数据改善多数工业指标,复杂 kernel 优化仍存在平台期。
核心贡献
- 将真实工业执行、错误驱动 CoT 与反馈预测结合,构建可扩展的工业代码推理数据链路。
未来方向
- 提高几何、硬件边界条件的反馈预测精度,并兼顾 Thinking 能力与通用 Agent 表现。
问题背景
硬件与工具链约束
- CUDA 代码可能算法正确,却因 grid 维度、共享内存或调度方式而运行失败。
- Verilog 需要同时满足仿真与综合要求;CAD 脚本需要生成有效几何体,而不只是通过 Python 语法检查。
训练数据缺口
- 最终正确代码无法说明错误原因,也缺少从执行日志定位问题的示范。
- 将每轮
代码 → 工具反馈 → 原因分析 → 修改保留下来,才能监督具体的纠错策略。
核心方法
执行反馈推理数据
任务输入
- 复用 InCoder-32B 的工业任务,将需求与运行环境一起输入生成模型。
- Verilog 包含 testbench 与综合脚本;STM32 包含头文件、内存布局与 linker script。
领域提示与工具
- 按领域选择提示:GPU 关注线程与内存,RTL 关注组合路径与时钟,CAD 关注几何约束。
- 执行后端包括
CUDA / Triton、Yosys / Icarus、Renode与CadQuery。 - 返回执行状态、报错日志和必要的数值结果,区分编译失败、运行错误与测试通过。
轨迹生成
- 初始生成:DeepSeek-V3.2 根据任务与环境生成推理过程和候选代码。
- 真实执行:工具编译、运行或仿真候选代码,返回具体失败信息。
- 反馈修复:将日志放回上下文,生成错误分析与下一版代码,最多进行
4轮修正。 - 结束条件:全部检查通过,或达到纠错预算。
训练内容
- 保留中间失败、诊断依据与修改过程,将多轮交互整理为连贯的 Thinking 示例。
- 对轨迹去重、清理无效文字并统一代码格式,形成真实执行数据
D_real。 - 例如 CUDA 启动失败:根据 grid 限制诊断索引方式,再改为合法的维度映射。
工业反馈预测模型
输入与输出
- 输入:环境描述、领域标记与当前代码;输出:执行状态、诊断信息或数值差异。
- 将真实轨迹拆成单轮执行记录,训练反馈预测模型。
- 统一模型覆盖多类工业后端,使用领域模板约束反馈格式。
两个模型角色
- ICWM:预测这段代码运行后会发生什么,用于扩充训练数据。
- InCoder-32B-Thinking:学习诊断与修复轨迹,最终负责生成工业代码。
生成与校准
- 使用 ICWM 的单次预测代替大量中间执行,驱动生成模型继续诊断、修改代码。
- 定期调用真实工具检查预测反馈,将偏差样本用于更新 ICWM。
- 最终 Coder 训练使用真实产生或真实验证过的轨迹,组合
D_real与扩充数据。
典型错误
- CAD 的几何退化可能只在内核执行时出现,例如相切圆柱产生零厚度边缘。
- 此时语法合理的代码仍可能失败,真实验证用于拦截反馈模型误判的成功样本。

实验设置(Thinking 数据与工业评测)
基础模型与训练数据
- 基础模型:
InCoder-32B;数据生成教师:DeepSeek-V3.2。 - Thinking 数据规模:
180M / 360M / 540M tokens,比较不同训练规模的 checkpoint。 - ECoT 最多
4轮修正;反馈预测训练使用真实工具产生的单轮记录。
评测任务
- 通用代码:
14项benchmark,覆盖生成、推理、SQL、SWE、Terminal 与 Tool Use。 - 工业代码:
9项benchmark,覆盖芯片设计、GPU kernel、嵌入式、代码优化与 CAD。 - 区分编译成功、功能正确和性能优化,例如 CAD 编译率与几何 IoU 分别统计。
ICWM 对照实验
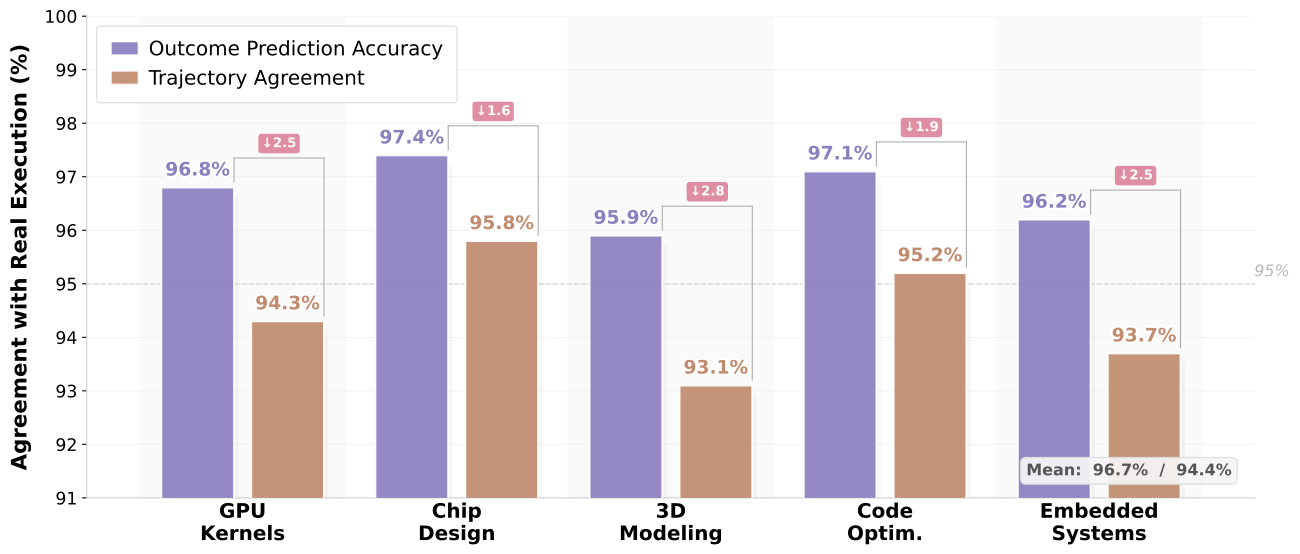
- 每个领域使用
2000条留出的真实执行记录,对比预测反馈与工具结果。 - 同时检查单次执行结果和多轮轨迹的一致性。
关键结果(InCoder-32B-Thinking,ECoT + ICWM SFT)
推理型任务提升明显
- LiveCodeBench v5:
53.3 → 81.3;v6:49.1 → 77.1,复杂解题受益于 Thinking 数据。 - CruxEval 输出推理:
73.9 → 95.5,执行语义推断能力同步改善。
工业收益集中在诊断与优化
- EmbedCGen:
35.2 → 47.9;VeriRepair:80.0 → 83.3,嵌入式生成与 RTL 修复有所改善。 - SuperCoder 正确率:
91 → 93,加速比:1.30× → 3.93×,收益不只体现在代码能否运行。 - CAD 编译率:
82 → 84,但几何 IoU:53.5 → 48.6;可执行与符合设计目标需要分别评估。
Agent 与部分代码任务存在回退
- SWE-bench Verified:
74.8 → 70.4;Terminal-Bench 2.0:22.5 → 21.6。 - BIRD:
55.4 → 47.9,说明工业推理增强没有自动转化为所有代码任务的收益。
Thinking 数据规模
- 从
180M增至540M tokens,VeriScope:61.8 → 75.4;KernelBench L2:16.0 → 38.0。 - KernelBench L3 保持
12.0,更难的优化任务需要更有针对性的策略与数据。
思考长度随任务变化
- 数据中 Agent 单步思考中位数为
91字符,GPU kernel 为约19K字符。 - Agent 推理分散在多轮交互中;kernel 单次修复需要更深入的硬件分析。
ICWM 预测质量
- 平均执行结果准确率
96.7%,轨迹一致率94.4%;多轮使用会累积单步预测误差。 - 因此反馈预测适合扩大候选轨迹规模,真实执行仍负责最终质量控制。
未来方向
工业反馈精度
- 补充几何退化、硬件边界与低频工具报错,提高 ICWM 对关键失败模式的覆盖。
- 根据预测不确定性选择真实执行,减少无效校验,同时控制多轮误差积累。
能力平衡与训练数据
- 平衡工业 Thinking、SQL 与 SWE 数据,减少专项训练造成的能力回退。
- 为复杂 kernel 优化增加性能诊断与策略示范,避免仅增加同类轨迹数量。
(2603) InCoder-32B (15T, 工业执行验证SFT)
🌺 论文摘要
参考链接
问题背景
- 通用代码语料偏向 Web 与应用开发,工业代码的硬件语义、时序约束和专用 API 覆盖不足。
- 工业任务还要求仿真、综合与性能验证;代码能编译,只是正确性的第一层。
核心方法
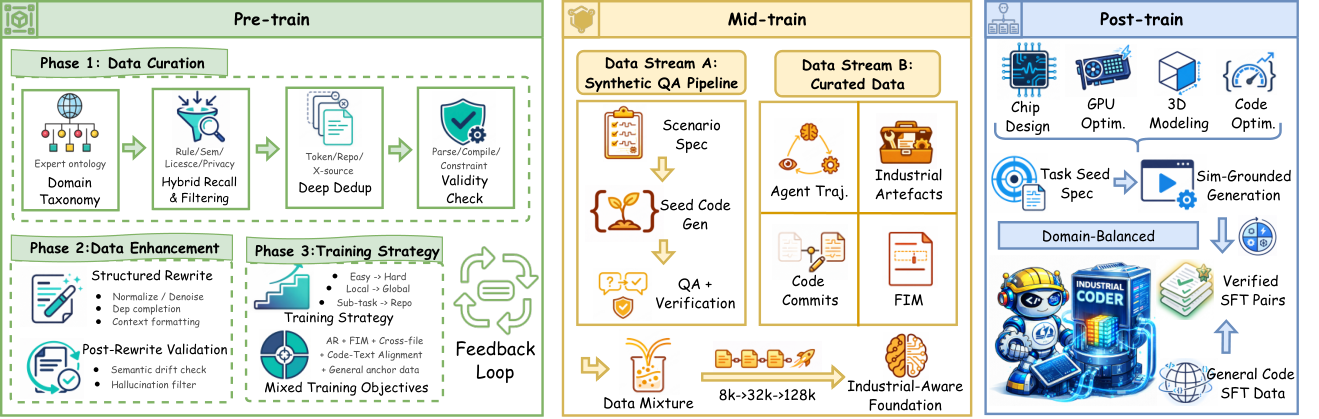
- 工业预训练:规则、FastText 与语义检索召回工业代码,结合技术手册与工具链资料,训练
15T tokens。 - MidTrain:
8K → 32K → 128K,加入工业推理 QA、Agent 轨迹、commit 和工程附属文件。 - 执行验证 SFT:构建
2.5M样本,覆盖直接实现、缺陷修复与性能优化。 - 验证环境:统一 RTL 仿真、GPU 执行、CAD 几何与嵌入式工具链,为合成数据提供真实反馈。
模型效果(32B Dense)
- SWE-bench Verified:
74.8;RealBench 模块 Func@1:62.7。 - CAD-Coder 编译率
82.0、IoU53.5;KernelBench L2fast₁=36.0。
重要结论
- 工业专项数据与执行验证可以形成较强的领域能力;数据需要覆盖运行条件和诊断过程。
- 编译、功能与性能是不同层次;模型仍容易在稀有 API、硬件语义和速度优化上失败。
核心贡献
- 将多个工业代码领域纳入同一基模的预训练、MidTrain 与 SFT,形成完整的数据和训练路线。
未来方向
- 增加稀有工业 API 与硬件约束数据,加强验证反馈训练和低层性能推理。
问题背景
领域知识
- Verilog、CUDA、Triton 与嵌入式代码在通用语料中占比低,部分低层代码难以靠文件后缀识别。
- 同一算法落到硬件后,还要处理位宽、时序、寄存器、内存布局与资源限制。
验证要求
- RTL 需要 testbench 与综合工具;GPU kernel 需要数值验证和计时;CAD 需要检查几何体。
- 例如 CUDA 的 grid 维度超限会导致启动失败,需要调整线程映射,而不是修改数学公式。
32B Dense Transformer
64层,hidden size5120,FFN size27648;40个query heads 与8个KV heads。- 使用 GQA、SiLU 与 RoPE;词表
76800,最大上下文128K。 - 训练路线:通用及工业预训练 → 工业 MidTrain → 执行验证 SFT。
核心方法
工业环境与预训练数据
芯片设计
- Icarus / Verilator 负责 RTL 编译与行为仿真;Yosys 检查可综合性并生成面积、时序信息。
- 输入源代码与 testbench,输出编译状态、仿真结果和综合报告。
GPU 与嵌入式
- CUDA / Triton 在
A100上编译执行,检查数值结果,并通过 CUDA events 计时。 - STM32F407 使用交叉编译器、CMSIS 与 linker script,随后进入 Renode 仿真。
- 仿真保留外设寄存器与中断行为,检查固件是否能完成目标操作。
CAD 与代码优化
- CadQuery / OpenCascade 将脚本转换为实体,检查生成是否成功以及与参考几何的重合程度。
- x86-64 优化同时检查语义等价与执行性能,避免只奖励形式上的代码改写。
工业代码召回
- 规则召回:利用后缀、目录与关键词识别 Verilog、CUDA、HLS 等显式工业代码。
- 分类召回:人工标注种子训练 FastText,补充规则没有命中的代码。
- 语义召回:检索设备驱动与硬件相关 C/C++,覆盖语法接近普通应用的工业样本。
- OCR 提取手册、技术书籍中的代码;补充厂商文档、论坛和工程报告。
清洗与增强
- 进行文件、近重复、仓库 fork 与跨来源去重,过滤无效样本。
- 统一格式,补充跨文件依赖、平台限制与函数/模块说明。
- 修改后的代码通过 AST 对比与重新编译,减少清洗引入的语义变化。
训练目标
- 自回归目标学习完整代码分布;FIM 学习给定前后文补全中间代码。
- 样本从函数、单文件逐渐过渡到多文件与项目,增加依赖关系的复杂度。
数据配比
- 持续保留通用代码和文本,避免工业数据完全替代通用能力训练。
- 根据留出工业任务的表现调整采样权重,提高薄弱领域的覆盖。
工业 MidTrain
工业推理 QA
- 由工程场景确定目标约束,再构造种子代码,生成根因分析、性能诊断与修改方案。
- 使用执行、静态分析和一致性检查过滤错误推理。
- 例如 GPU 访存优化:给定 kernel 与 profiling 信息,分析访存模式并提出改写。
真实工程上下文
- Agent 轨迹记录
Thought → Action → Observation,学习从工具输出继续操作。 - commit 关联开发意图、修改前代码与修改后代码,补充演进过程。
- 保留 testbench、时序约束、综合脚本、profiling 与内存检查日志。
- FIM 按 AST 边界遮盖函数或代码块,避免截断 RTL always block 等完整结构。
32K 阶段
- 重点训练完整模块、kernel 函数和 testbench,直接扩展到
32K。 - 数据比例:QA
40%、轨迹20%、commit15%、工程文件15%、FIM10%。
128K 阶段
- 训练长调试过程、跨模块依赖与多文件重构,增加轨迹与 FIM 的占比。
- 前四分之一训练过程中,长于
32K的样本比例由10%逐渐增至50%。 - 回放
5%–10%的上一阶段数据,保留文件级任务能力。 - 学习率重新启动后做 cosine decay,配合长样本逐步进入训练。
执行验证 SFT
任务与候选生成
- 将需求、接口、目标平台、依赖和验证脚本统一为结构化任务。
- 候选来自参考实现改写、模板扰动、跨语言迁移、检索增强和强模型生成。
- 多种生成途径增加实现方式与优化方案的多样性。
验证与修复
- 每个候选进入相应的编译、仿真、测试与性能检查。
- 失败时保留报错、反例、波形差异或性能瓶颈,生成修改后的代码并再次验证。
- 训练材料包含失败尝试、反馈与修复结果,使模型学习具体的调试过程。
最终样本
- 按可执行性、重复运行稳定性与信息量筛选,降低简单重复样本权重。
- 直接实现:需求到正确代码;缺陷修复:失败到修正;性能优化:正确代码到更优实现。
- 验证反馈用于构建与筛选 SFT 数据,这篇工作的主体路线是预训练、MidTrain 与 SFT。

实验设置(15T预训练与工业SFT)
预训练
32B Dense从零训练;4096张 GPU;总量约15T tokens。- 学习率
3e-4,global batch size2048;目标为 AR 与 FIM。
MidTrain 与 SFT
- 上下文
8K → 32K → 128K;两阶段使用工业推理与工程轨迹数据。 - SFT 构建
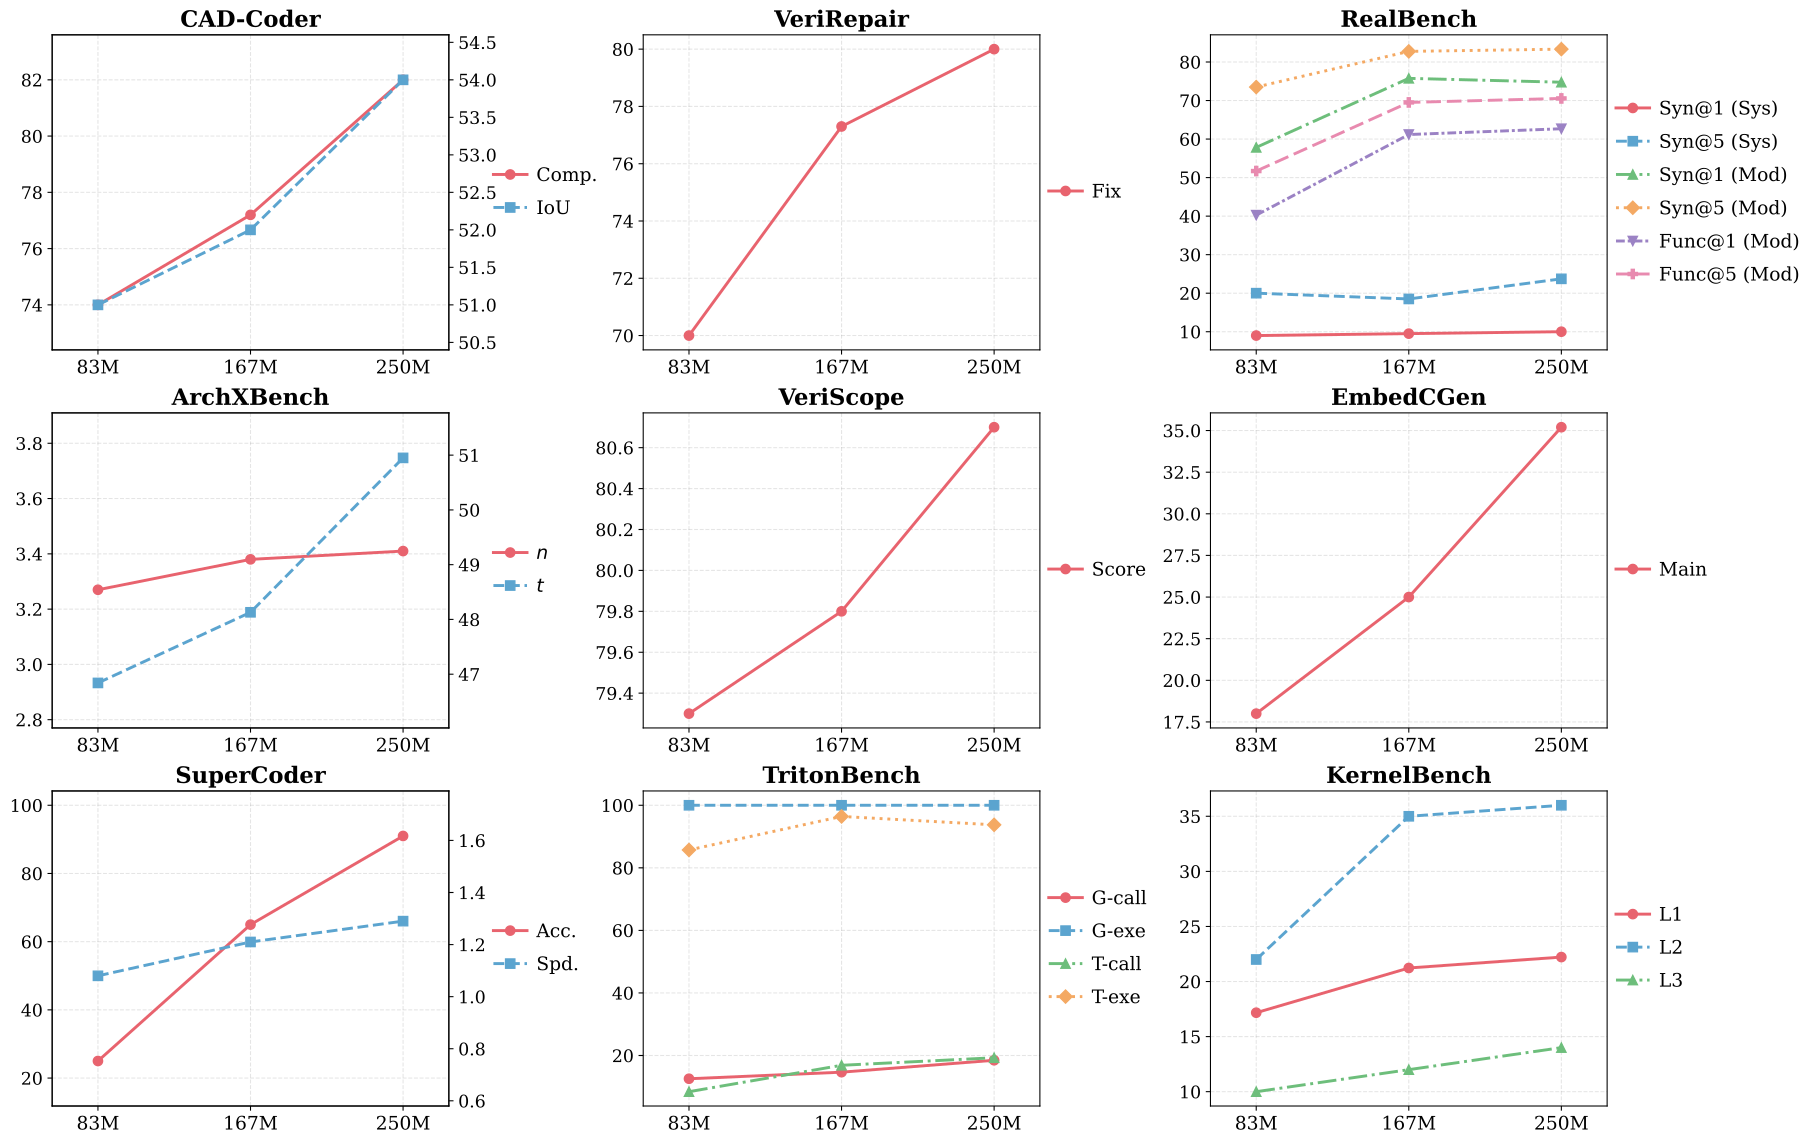
2.5M样本,约4.9K步,global batch size512。 - 数据规模分析比较
83M / 167M / 250M tokens三个工业 SFT checkpoint。
评测任务与协议
14项通用代码 benchmark;9项工业 benchmark,覆盖 RTL、GPU、嵌入式、代码优化与 CAD。- RealBench 分模块与系统任务,分别评估可综合性
Syn@k和功能正确性Func@k,k=1/5。 - KernelBench
fast₁要求结果正确且快于参考实现;CAD 同时统计编译成功率与几何 IoU。
关键结果(InCoder-32B,工业预训练 + SFT)
通用代码仍有竞争力
- SWE-bench Verified 达
74.8;LiveCodeBench v6 为49.1;BFCL 为61.0。 - 说明工业专项训练能够与通用编程能力共存,但代码推理仍弱于更强的 Thinking 模型。
工业优势集中在功能实现
- RealBench 模块
Syn@1=74.8、Func@1=62.7,编译通过后仍有功能正确性的缺口。 - CAD-Coder 编译率
82.0、IoU53.5;对照 Claude-Sonnet-4.6 为77.0 / 32.4。 - KernelBench L1/L2/L3 为
22.2 / 36.0 / 14.0,在报告所列对照中表现较强。
正确性与优化能力需要区分
- SuperCoder 正确率
91.0,但加速比只有1.3×,高正确率并不代表善于性能优化。 - EmbedCGen 为
35.2,显著弱于部分更大模型,工业能力在不同领域之间仍不均衡。
工业 SFT 扩展
- 从
83M增至250M tokens,多数工业指标持续改善;少数验证子指标较早趋于饱和。 - 领域数据有效,但需要根据失败类型调整内容,而不只扩大样本数。
1882个失败案例
- RealBench 失败多为语法与编译问题;EmbedCGen 常见缺失或错误的 HAL/CMSIS API。
- VeriRepair 的失败中
79%是编译通过但功能错误,单靠语法修复不足以解决任务。 - KernelBench 失败中约
33%是正确但不够快,需要显式学习硬件性能诊断。
未来方向
数据与验证
- 补充低频工业 API、精确类型与硬件语义,减少链接错误、位宽错误和不合法配置。
- 将更丰富的仿真、反例与性能反馈用于训练,提高功能推理与低层优化能力。
任务难度与能力均衡(笔记整理)
- 从模块级生成扩展到完整系统和长调试流程,强化跨模块约束与长期状态管理。
- 分别跟踪可编译、功能正确与性能收益,避免单一成功率掩盖工业任务的真实瓶颈。
(2603) IQuest-Coder-V1 (Code-Flow, LoopCoder)
🌺 论文摘要
参考链接
问题背景
- 静态代码主要提供最终实现,缺少需求变化、修改过程与失败修复的监督。
- 长程 Code Agent 需要跨文件理解、持续规划与反馈纠错,同时受到部署参数规模限制。
核心方法
- Code-Flow:关联旧仓库、patch 与新仓库,将软件演进过程加入预训练。
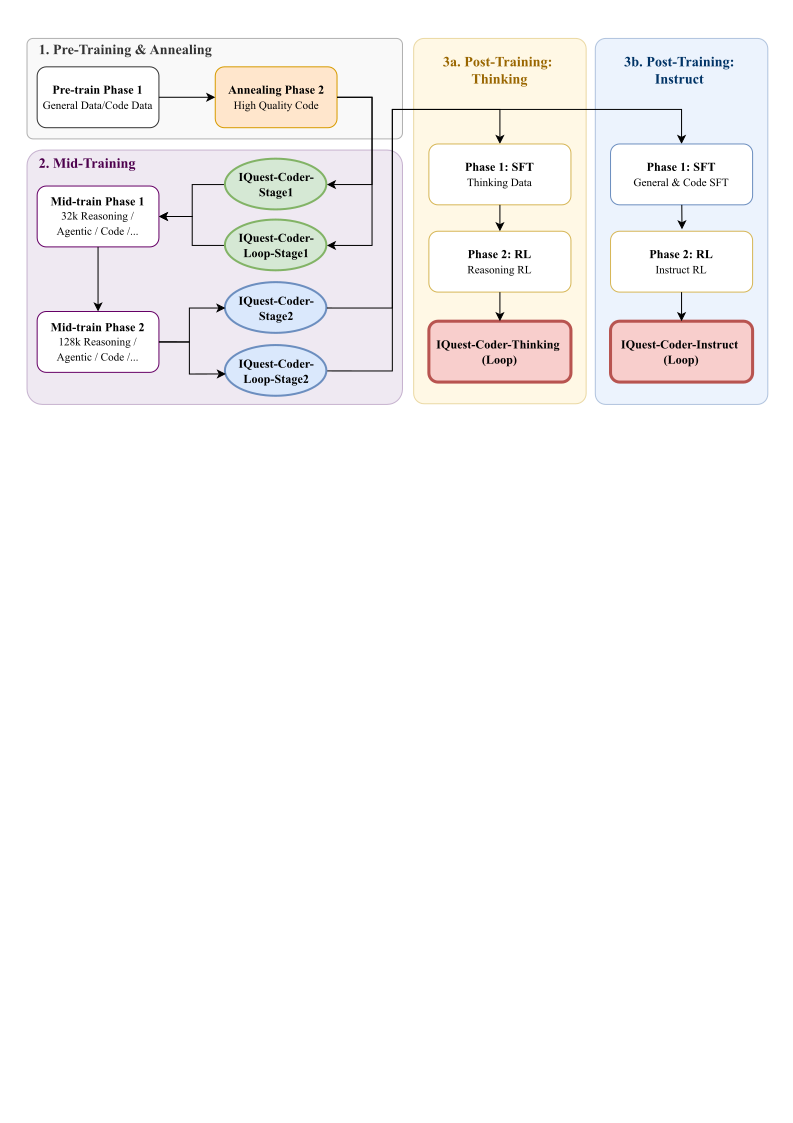
- 两阶段 MidTrain:
32K推理与 Agent 轨迹 →128K仓库级上下文。 - 双路线后训练:Thinking 与 Instruct 均采用
SFT + RL,分别侧重深度求解与日常指令任务。 - LoopCoder:同一组 Transformer 参数运行两轮,通过跨轮 attention 与门控增加计算深度。
模型效果
40B-Loop-Instruct:SWE-bench Verified76.2、Terminal-Bench 2.033.0。40B-Loop-Thinking:LiveCodeBench v681.1;普通40B-Instruct的 FullStackBench 达71.4。
重要结论
- 训练对象从代码文本扩展到修改与交互过程,有助于覆盖完整开发任务。
- Thinking 与 Loop 的收益依任务而异,不能只按单一榜单选择模型。
核心贡献
- 提供代码演进训练、Agent MidTrain、双路线后训练与参数复用架构的完整 Code 模型系列。
未来方向
- 优化循环计算的延迟收益,并提升长任务中的恢复能力与跨任务稳定性。
问题背景
训练信息缺口
- 代码快照说明当前实现,但没有完整呈现修改意图、变更依赖与验证过程。
- Code Agent 还需要根据命令输出和测试错误调整计划,不能只学习一次生成最终答案。
模型系列
- Dense 模型覆盖
7B / 14B / 40B,另外提供40B-Loop参数复用版本。 - 开放不同训练阶段 checkpoint,用于研究 MidTrain 与后训练带来的能力变化。
核心方法
Code-Flow 与 MidTrain
质量筛选
- 通用语料以 Common Crawl 等来源为基础,进行清洗、近重复过滤与 benchmark 去污染。
- 为文本、代码和数学训练质量分类器,依据较大模型标注筛选高信息量数据。
- 使用 AST 检查代码结构,结合不同编程语言的相似性组织采样。
代码事实知识
- 引入
66M条 CodeSimpleQA-Instruct,补充明确、客观的技术事实问答。 - 重点覆盖可验证的代码知识,避免含糊、多解或容易随时间改变的问题。
代码补全
- 文件级 FIM 使用前缀与后缀预测中间内容;仓库级 FIM 额外提供相关文件上下文。
- 混合随机字符/行切分与 AST 切分,覆盖表达式、语句和函数等粒度。
训练样本
- 构造
(R_old, P, R_new):修改前仓库、patch、修改后仓库。 - 从项目生命周期中相对成熟的阶段选取起点,再寻找具有实际开发意义的后续变更。
- 保留变更的时间顺序与项目上下文,使模型学习修改前提、代码变化与结果之间的关系。
与静态快照的区别
- 快照提供“最终实现是什么”;状态转移进一步提供“哪些代码因修改而发生变化”。
- 例如接口变更同时涉及调用方、实现与测试,完整变更比孤立文件更能呈现依赖关系。
32K 阶段
- 在高质量代码退火后加入数学、代码、逻辑 QA,学习拆解任务与一致性检查。
- 加入完整 Agent 轨迹:命令、日志、错误、测试结果与后续修改。
- 混合 commit 和文件/仓库 FIM,连接推理过程与代码操作。
128K 阶段
- 扩展到
128K序列,学习长仓库、多文件依赖与持续调试过程。 - 延续推理、轨迹和补全数据类型,增加真正需要长上下文的仓库样本。
- MidTrain 已经接触环境反馈,后训练再强化任务完成与行为选择。
循环共享架构
参数复用
- 同一组 Transformer blocks 固定执行
2轮,第二轮继续处理第一轮形成的表示。 - 模型仍为
40B参数;增加的是计算深度,不是新增一套独立权重。
第二轮 Attention
- 跨轮读取:第二轮 query 访问第一轮产生的 KV,利用上一轮表示。
- 轮内读取:读取第二轮中的前序 token,保留当前轮的因果依赖。
- learned gate 根据 query 混合两路 attention 输出,调整跨轮信息与轮内信息的比例。
计算与显存
- 融合 gated attention kernel,减少中间数据搬运。
- 使用 Context Parallelism,在设备之间传输 KV 分片,支持长上下文训练。
训练可靠性
- 确定性重算与 tensor fingerprint 检查静默硬件错误。
- 循环架构增加推理计算,参数占用与生成延迟需要分别评估。
SFT 与多目标 RL
任务覆盖
- 包含 API 调用、全栈开发、竞赛代码、SQL、代码编辑、Terminal、SWE 与 GUI Agent。
- 结合任务扰动、测试驱动合成、逆向构建和自动环境搭建生成候选样本。
验证与训练
- 客观任务使用沙箱执行与符号验证;主观任务结合规则、reward model 与多 Agent 评估。
- 使用 sequence packing 和跨样本 mask,提高利用率并隔离样本。
- 课程从基础指令逐步过渡到复杂与对抗样本,配合 cosine decay 和较长的低学习率阶段。
后训练分工
- Thinking:推理轨迹 SFT → reasoning RL,强调复杂代码求解。
- Instruct:通用与代码指令 SFT → instruction RL,强调协助与指令遵循。
- 使用 replay、动态数据混合与任务组合,减少专项训练对通用能力的影响。
代码 RL
- 竞赛代码采用 GRPO 与 Clip-Higher,以测试通过率提供奖励,不额外加入 KL penalty。
- SWE 使用可扩展云端沙箱,Agent 多轮调用工具、修改代码并运行测试。
- SWE 奖励结合测试通过与效率约束,支持并行 rollout。
实验设置(多规模与双路线后训练)
模型配置
7B / 14B / 40B分别使用14 / 28 / 80层,hidden size 均为5120。40个query heads、8个KV heads,GQA,词表76800,最大上下文128K。- 比较 Base、Instruct、Thinking 及 Loop 版本,区分架构与后训练路线。
训练路线
- 通用及代码预训练 → 高质量代码退火 →
32K / 128KMidTrain → SFT + RL。 - 训练数据包括代码事实、仓库状态转移、FIM、推理和 Agent 轨迹。
评测任务
- Base:CrossCodeEval 跨文件补全,覆盖 Python、Java、TypeScript 和 C#。
- 后训练:EvalPlus、BigCodeBench、FullStackBench、LiveCodeBench、CruxEval、Mercury 与 SQL。
- Agent:SWE-bench Verified、Terminal-Bench、Mind2Web、BFCL 与 τ-bench 系列。
- 安全性:同时评估有害请求拒绝与正常请求误拒绝,使用 Tulu 3 评测集合。
关键结果(IQuest-Coder-V1,SFT + RL)
Loop-Instruct 的 Agent 能力
40B-Loop-Instruct的 SWE-bench Verified 为76.2,普通40B-Instruct为70.4。- Terminal-Bench 2.0 两者均为
33.0,Loop 的收益没有覆盖所有长程任务。 - BFCL:
51.7 → 73.9,工具调用能力也呈现明显差异。
Thinking 更侧重竞赛推理
- 普通 40B 在 LiveCodeBench v6 上,Instruct 为
46.9,Thinking 为77.7。 - Loop-Thinking 进一步达到
81.1,体现推理训练与额外计算的组合收益。 - 14B 的同一指标从 Instruct
40.0到 Thinking66.3,这一差异不只存在于最大模型。
常规开发任务需要独立比较
- FullStackBench:普通
40B-Instruct=71.4,Loop-Instruct 为68.3,Thinking 为54.8。 - BIRD:普通 Instruct
70.5,Thinking53.6;较强的长推理不等于更好的 SQL 生成。 - 因此模型选择应同时看推理、交互、开发与效率,避免由单项峰值推断整体能力。
未来方向
循环计算效率
- 比较相同显存、延迟与总计算预算下的 Loop 和普通模型,明确参数复用的适用场景。
- 探索按任务难度调整循环深度,减少简单任务的额外计算。
长期交互与训练配比
- 加强错误恢复、跨文件状态与长轨迹监督,改善 Terminal 等复杂交互任务。
- 平衡 Thinking 与常规开发数据,减少推理增强后 SQL、全栈任务的能力损失。