SWE 自进化
📅 发表于 2026/09/16
🔄 更新于 2026/09/16
👁️ — 次访问
📝 2073 字
⏳ 7 分钟
🌺 论文摘要
参考链接
核心方法
Self-Play SWE-RL框架仓库+环境,通过写Bug+修Bug 自我博弈联合RL训练。无需人工Issue仓库数据:未知CWM scaffold:bash + search-replace 编辑器模型效果(CWM-32B-sft)
SSR方法都超过RL+人类Issue训练的模型,但也没高多少。SWE-V达51.4分,SWE-P达28.9分。重要结论
Self-Play RL比Repair/Injection-Only RL 性能更好,Inject-Only 效果最差。大幅删除代码的Bug更好比仅改一行代码的Bug的好。后者太简单,学习信号弱。Solver解决率信号 对训练效果影响不大。关键贡献
Self-Play SWE-RL 思想,很有启发意义的工作。❓问题背景
RL 受限于人类天花板
训练数据和环境 依赖人工:Issue、PR、环境、单元测试等。人类数据噪音多,不可靠,难扩展。导致RL本质:模仿和优化 人类写代码的过程。当前合成数据存在局限性
Self-Play
Zero Self-Play
Absolute Zero:训单个推理模型。 只和Python解释器交互,只能学到Python细节,无法学到真实知识经验。无法获得 超出固定环境和模型现有储备之外的新知识。想法
真实动态Repo,Agent和代码环境交互来学习,不依赖人类训练数据。Self-Play + 真实世界仓库📕核心方法
核心思想
沙盒环境 + 代码仓库 + 工具集(来自CWM, Bash+Editor) 无需:单元测试、Issue描述、执行测试命令、特定语言先验知识等。1个LLM,2个角色(不同prompt),Injector-造Bug,Solver-修复Bug造Bug+修Bug,迭代式循环提升,共同对抗式-RL训练优点
多样化+有挑战+不断进化的课程。静态bug无法比拟。高阶Bug
Solver失败的尝试,作为高阶Bug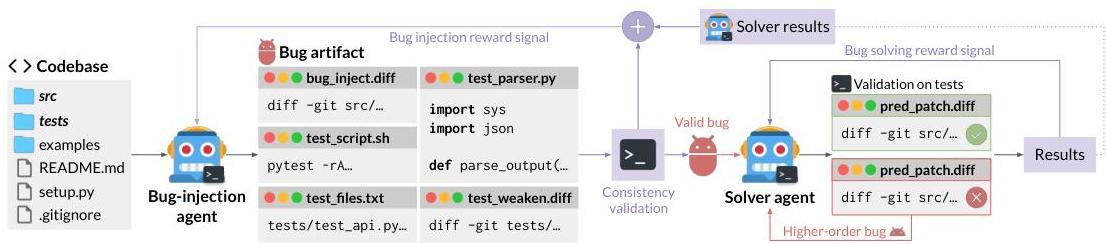
Bug本身
bug_inject.diff:向代码注入Bug隐蔽手段
test_weaken.diff:移除或削弱测试,隐藏Bug。
正常情况
遇到一个隐藏bug,才去去写单元测试,去修复它。这里
隐藏对应单元测试去隐藏Bug,避免直接状态检测机制不通过、无法合并等情况。防作弊手段
test_files.txt:测试文件列表,避免AI直接修改测试文件,每次测试时直接恢复。验证工具
test_scripts.sh:运行测试套件,检测错误、验证修复test_parser.py:解析测试输出结果,每个测试ID映射到结果。目标
高质量、适配Solver的Bug,并给到Bug Solver。Bug制造策略
代码移除删掉某个文件、删掉大段核心逻辑历史回滚重新引入旧 Bug高阶Bug制造Bug,Solver失败的解法,这个烂代码就变成新Bug 题目。非常真实(人类就这样的),多样性好、覆盖全约束和质量控制
约束条件避免低级情况:直接删除某函数,直接报错缺乏xx函数修改调用地方,保证代码能跑通,但结果是错的。质量控制最小文件更改数有测试失败(有bug),必须有测试通过(环境没崩)一致性验证
基础检查测试文件检查:AI指导的测试文件是否真存在,而不是幻觉。解析器检查:AI写的python解析脚本能不能跑。脚本检查:在源代码库上运行测试,必须通过。修改的文件数量 不能太少(如5个)必须有测试Fail隐蔽性检查删掉部分测试,原报错消失逆向高级检查(无冗余检查) 概览
一致性反馈:生成正确可用的Bug。Solver反馈题目太简单:Injector 得分低题目太困难:Injector 得分低处于Solver能力边界上的难题公式
Bug一致性和Solver解决率(s),Bug 代码构建
注入Bug:应用bug_inject.diff
掩盖测试:应用test_weaken.diff
高阶Bug(可选):应用pred_patch.diff
销毁证据:不能保留.git 历史,防止Solver查看git diff或 git log
Prompt 设计
不使用自然语言描述。test_weaken.diff的反转版,直接展示对应Bug的单元测试。 请修复源代码,保证把这个测试加回去,代码能跑通。修复过程
思考 -> 调用工具 -> 环境交互运行测试,迭代循环pred_patch.diff奖励设计
对抗奖励
Solver:受益于更高的解决率Injector:受益于更低的解决率✍️实验设置
基础模型
没有RL训练过训练任务/数据
评测任务/数据
算法/策略
对抗式联合RL训练。1个LLM,同时生成Bug和修复Bug。
大Batch、尽量On-Policy (small-policy-staleness),让梯度更新更稳定
CWM scaffold:bash + search-replace 编辑器
超参
64卡训练,448卡Rollout128k16M token,整体150步,2.5B tokens🍑关键结果
模型效果(CWM-32B-sft)
SSR方法都超过RL+人类Issue训练的模型,但也没高多少。SWE-V达51.4分,SWE-P达28.9分。重要结论
Self-Play RL比Repair/Injection-Only RL 性能更好,Inject-Only 效果最差。大幅删除代码的Bug更好比仅改一行代码的Bug的好。后者太简单,学习信号弱。Solver解决率信号 对训练效果影响不大。关键贡献
Self-Play-RL思想,只需环境+代码, LLM自我博弈,写Bug+修Bug,联合RL训练。⛳ 未来方向
不足点
Solver可能会作弊,面向测试编程。因为读取了所有测试用例 Public Tests 给AI看, Private Tests实际测试。测试单一,仅靠单元测试。 高级验证标准。不同模型博弈,MoE等。Self-Play 研究方向
更聪明的出题方法。 复杂的多步骤SWE任务。