Skip to content

强化学习

📅 发表于 2018/04/01
🔄 更新于 2025/07/23
👁️ — 次访问
📝 1621 字
⏳ 5 分钟
强化学习
#智能体
#环境
#值函数
#贝尔曼方程
#V函数
#Q函数

强化学习的基础知识。基本要素、轨迹、值函数、V函数和Q函数、贝尔曼方程。

强化学习定义 ​

概览 ​

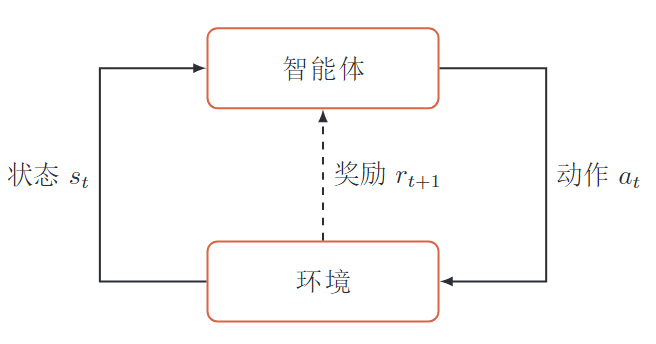
强化学习是指一个智能体从与环境的交互中不断学习去完成特定的目标。

强化学习不需要给出正确策略作为监督信息,只需要给出策略的(延迟)回报,并通过调整策略来取得最大化的期望回报。

  1. 智能体、环境
  2. 环境状态s,智能体的动作a,智能体的策略π(a∣s),状态转移概率p(st+1∣st,at),即使奖励r(s,a,s′)

智能体和环境 ​

智能体

  • 感知环境的状态和反馈的奖励,进行学习和决策
  • 决策 :根据 -- 环境状态 -- 做出不同的动作
  • 学习: 根据 -- 反馈奖励 -- 调整策略

环境

  • 智能体外部的所有事物
  • 收到 -- 智能体的动作 -- 改变状态
  • 给 -- 智能体 -- 反馈奖励

5个基本要素 ​

状态s

环境的状态,状态空间S, 离散/连续

动作a

智能体的行为,动作空间A, 离散/连续

策略π(a∣s)

智能体 根据 -- 环境状态s -- 决定下一步的动作a 的函数

状态转移概率p(s′∣s,a)

根据 -- 当前状态s和智能体的动作a -- 环境状态变为s′的概率

即时奖励r(s,a,s′)

环境给智能体的奖励,标量函数。根据 -- 环境当前状态 、智能体执行的动作、环境新状态

智能体的策略 ​

π(a∣s) 智能体根据环境状态决定下一步的动作。分为确定性策略和随机性策略。

π(a∣s)≜p(a∣s),∑a∈Aπ(a∣s)=1

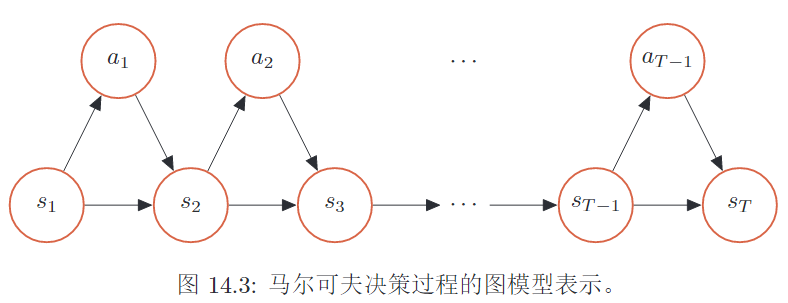
马尔科夫决策过程 ​

  1. 马尔可夫过程,p(st+1∣st)
  2. 马尔可夫决策过程,p(st+1∣st,at)
  3. 轨迹,给初始状态,智能体与环境的一次交互过程

马尔可夫过程 ​

状态序列s0,s1,⋯,st具有马尔可夫性,st+1只依赖于st

p(st+1∣st,⋯,s0)=p(st+1∣st)

马尔可夫决策过程 ​

st+1依赖于st和at, 即环境新状态依赖于当前状态和当前智能体的动作。

p(st+1∣st,at,⋯,s0,a0)=p(st+1∣st,at)

智能体与环境的交互是一个马尔可夫决策过程。

轨迹 ​

给定策略π(a∣s), 轨迹是智能体与环境的一次交互过程,是一个马尔可夫决策过程,如下:

τ=s0,a0,s1,r1,⋯,sT−1,aT−1,sT,rT

其中rt=r(st−1,at−1,st)是时刻t的即时奖励。

轨迹的概率

  • 初始状态
  • 所有时刻概率的乘积
  • 智能体执行动作,环境更新状态
p(τ)=p(s0)∏t=0T−1π(at∣st)p(st+1∣st,at)

目标函数 ​

  1. 一个轨迹的总回报。G(τ)=∑t=0T−1rt+1
  2. 一个策略的期望回报。Eτ∼p(τ)[G(τ)]。 所有轨迹的回报的期望
  3. 强化学习的目标。学一个策略πθ(a∣s), 最大化这个策略的期望回报

轨迹的总回报 ​

1. 某一时刻的奖励

rt=r(st−1,at−1,st)是t时刻, 环境给智能体的奖励。

给定策略π(a∣s), 智能体与环境一次交互过程(回合,试验)为轨迹τ

2. 一条轨迹的总回报

总回报是一条轨迹所有时刻的累积奖励和。

G(τ)=∑t=0T−1r(st−1,at−1,st)=∑t=0T−1rt+1

3. 一条轨迹的折扣回报

折扣回报引入折扣率,降低远期回报的权重(T无限大时)。

G(τ)=∑t=0T−1γtrt+1,γ∈[0,1]

折扣率γ

  • γ∼0, 在意短期回报
  • γ∼1, 在意长期回报

策略的期望回报 ​

给一个策略π(a∣s), 有多个轨迹。

一个策略的期望回报:该策略下所有轨迹总回报的期望值。

Eτ∼p(τ)[G(τ)]=Eτ∼p(τ)[∑t=0T−1rt+1]

强化学习的目标 ​

强化学习的目标是学习到一个策略πθ(a∣s)​,来最大化这个策略的期望回报。希望智能体能够获得更多的回报。

J(θ)=Eτ∼pθ(τ)[∑t=0T−1γtrt+1]

值函数 ​

  1. 状态值函数。Vπ(s), 初始状态为s,执行策略π得到的期望回报。
  2. 贝尔曼方程迭代计算值函数
  3. 状态-动作值函数。Qπ(s,a), 初始状态为s,进行动作a,执行策略π得到的期望回报
  4. V函数与Q函数的关系。Vπ(s)=Ea∼π(a∣s)[Qπ(s,a)]
  5. 值函数的作用。评估策略π(a∣s), 对好的动作a(Qπ(s,a)大 ),增大其概率π(a∣s)

状态值函数 ​

状态值函数Vπ(s)是初始状态为s,执行策略π得到的期望回报。(因为有多个轨迹,每个轨迹的初始状态都是τs0=s)

Vπ(s)=Eτ∼p(τ)[∑t=0T−1rt+1∣τs0=s]

贝尔曼方程计算值函数 ​

当前状态的值函数,可以通过下个状态的值函数进行递推计算。

核心:Vπ(s)∼r(s,a,s′)+Vπ(s′)。 有动态规划的意思

  • 关键在于状态转移:s∼s′
  • 选动作、选新状态 : s∼a, s,a∼s′
  • 策略π(a∣s) 和状态转移概率p(s′∣s,a)
  • 对这两层可能性的所有值函数,求期望即可

给定策略π(a∣s)、状态转移概率p(s′∣s,a)、奖励r(s,a,s′), 迭代计算值函数:

Vπ(s)=E[r(s,a,s′)+γVπ(s′)]

V函数的贝尔曼方程

Vπ(s)=Ea∼π(a∣s)Es′∼p(s′∣s,a)[r(s,a,s′)+γVπ(s′)]

状态-动作值函数 ​

状态-动作值函数是 初始状态为s并进行动作a, 执行策略π得到的期望总回报。 也称为Q函数。

Qπ(s,a)=Es′∼p(s′∣s,a)[r(s,a,s′)+γVπ(s′)]

Q函数的贝尔曼方程

Qπ(s,a)=Es′∼p(s′∣s,a)[r(s,a,s′)+γEa′∼π(a′∣s′)[Qπ(s′,a′)]]

V函数与Q函数 ​

  • V(s)函数要 先确定动作s∼a, 再确定新状态s,a∼s′

  • Q(s,a)函数是确定动作a后的V函数

V函数是所有动作a的Q函数的期望

Vπ(s)=Ea∼π(a∣s)[Qπ(s,a)]

值函数的作用 ​

值函数用来对策略π(a∣s)进行评估。

如果在状态s,有一个动作a使得Qπ(s,a)>Vπ(s)

  • s状态,执行动作a 比 s状态 所有动作的期望,都要好。状态a高于所有状态的平均值
  • 说明执行动作a比当前策略π(a∣s)好
  • 调整参数使π(a∣s)的概率增加

贝尔曼和贝尔曼最优方程 ​

  1. V(s)函数和Q(s,a)函数
  2. 贝尔曼方程(选择所有可能的均值)
  3. 贝尔曼最优方程(直接选择最大值)

V函数与Q函数 ​

V函数:以s为初始状态,执行策略π得到的期望回报(所有轨迹回报的均值)

Vπ(s)=Eτ∼p(τ)[∑t=0T−1rt+1∣τs0=s]

Q函数:以s为初始状态,执行动作a,执行策略π得到的期望回报

Qπ(s,a)=Es′∼p(s′∣s,a)[r(s,a,s′)+γVπ(s′)]

利用V函数去计算Q函数

Qπ(s,a)=Es′∼p(s′∣s,a)[r(s,a,s′)+γVπ(s′)]

贝尔曼方程 ​

V(s)的贝尔曼方程,选择所有a的期望回报, 也是Q函数的均值,V(s)=Ea[Q(s,a)]

Vπ(s)=Ea∼π(a∣s)Es′∼p(s′∣s,a)[r(s,a,s′)+γVπ(s′)]Vπ(s)=Ea∼π(a∣s)[Qπ(s,a)]

Q(s,a)函数的贝尔曼方程

Qπ(s,a)=Es′∼p(s′∣s,a)[r(s,a,s′)+γEa′∼π(a′∣s′)[Qπ(s′,a′)]]

贝尔曼最优方程 ​

V(s)函数的贝尔曼最优方程,实际上是直接选择所有a中的最大回报 :

V∗(s)=maxaEs′∼p(s′∣s,a)[r(s,a,s′)+γV∗(s′)]

Q(s,a)函数的贝尔曼最优方程

Q∗(s,a)=Es′∼p(s′∣s,a)[r(s,a,s′)+γmaxa′Q∗(s′,a′)]

深度强化学习 ​

有些任务的状态和动作非常多,并且是连续的。普通方法很难去计算。

可以使用更复杂的函数(深度神经网络)使智能体来感知更复杂的环境状态,建立更复杂的策略。

深度强化学习

  • 强化学习 -- 定义问题和优化目标
  • 深度学习 -- 解决状态表示、策略表示等问题
总访客数:— · 总访问量:—
PLM's Blog @ 2016 - 2026